基于FashionMnist数据集的自监督学习(判别式自监督学习)
目录
一,自监督学习
1.1 自监督学习的简介
自监督学习是机器学习的一个重要分支,属于无监督学习的范畴,但与传统无监督学习(如聚类、降维)不同,它通过利用数据本身的结构信息自动生成监督信号,从而实现 “自己监督自己” 的学习过程。其核心思想是:从无标注数据中挖掘潜在的监督信息,将数据本身转化为训练标签,避免了对大量人工标注数据的依赖。
1.2 自监督学习的分类
根据代理任务的设计方式,自监督学习主要分为三大类
1.2.1 生成式自监督学习
原理:通过数据重构或生成任务,利用数据本身的 “完整性” 构建监督信号,迫使模型学习数据的潜在结构和分布规律。其核心假设是:若模型能从压缩的隐层表征中还原原始输入,则隐层必然捕获了数据的关键语义信息。
工作流程:
- 数据预处理与掩码:对输入数据(如图像、文本)进行部分遮挡或掩码(如随机掩盖图像块、替换文本词汇)。
- 编码与解码:通过编码器将原始数据(或未掩码部分)压缩为低维隐向量,再通过解码器基于隐向量重构完整数据(如补全图像缺失区域、预测掩码词汇)。
- 损失优化:以重构误差(如像素级均方差、词汇预测交叉熵)为损失函数,驱动模型优化编码器参数,使隐层表征能高效还原原始输入。
典型场景:BERT 的掩码语言模型(MLM)通过预测句子中被掩码的词汇学习语义;图像领域的 MAE(掩码自动编码器)通过重建掩码图像块提取视觉特征。
说人话:让模型自己跟自己 “较劲”,用数据本身当 “老师”。比如给它一张打了码的图片(比如遮住一半或涂掉一块),让它猜被遮住的部分长啥样;或者给一段打乱顺序的文字,让它复原成通顺的句子。模型要完成这些任务,就得先 “理解” 数据的内在规律 —— 比如衣服的纹理怎么搭配、句子的前后逻辑是什么。它会把输入数据压缩成一个 “隐藏版” 的特征(就像把一本书浓缩成大纲),然后再根据这个大纲 “复原” 出完整的数据。如果模型能把残缺的图片补得跟原图差不多,或者把乱序的文字排得明明白白,说明它抓住了数据的核心特点(比如 T 恤是圆领、牛仔裤有口袋)这种靠 “复原完整数据” 来逼模型学规律的方法,就是生成式自监督学习的核心逻辑。
1.2.2 对比式自监督学习
原理:通过对比样本间的相似性与差异性,强制模型学习能够区分 “同类样本”(正例)和 “非同类样本”(负例)的特征空间。其核心逻辑是:若模型能将同一样本的不同增强视图(正例)的特征拉近,将不同样本的视图(负例)的特征推远,则特征必然蕴含样本的本质属性。
工作流程:
- 数据增强与正负样本构造:对单个原始样本进行多重变换(如裁剪、旋转、颜色抖动)生成多个正样本对;从其他样本中随机选取视图作为负样本。
- 特征编码:通过编码器将所有样本(正、负例)映射到特征空间,得到高维特征向量。
- 对比损失优化:利用对比损失函数(如 InfoNCE)计算损失 —— 要求正样本对的特征余弦相似度高于负样本对,通过反向传播更新编码器参数。
典型场景:图像领域的 SimCLR 通过对比同一图像的不同增强视图学习视觉表征;NLP 中的 Sentence-BERT 通过对比句子对的语义相似度生成句向量。
说人话:让模型学会 “找相同和找不同”,就像玩找茬游戏一样。比如,拿一张 T 恤的图片,先给它 “化化妆”—— 旋转一下角度、调调亮度、裁剪一部分,这些变化后的图片还是同一件 T 恤,属于 “正例”;再找一张牛仔裤的图片,作为 “负例”。模型的任务是:把同一件 T 恤的不同 “化妆照”(正例)的特征变得很像(比如都能认出是圆领、纯色),把 T 恤和牛仔裤(负例)的特征变得很不一样(比如一个是衣服面料,一个是裤子版型)。怎么实现呢?就像老师罚学生站队:长得像的(同类)站近点,长得不像的(不同类)站远点。模型通过不断调整特征的 “距离”,慢慢就能抓住每个样本的本质 —— 比如 T 恤和牛仔裤的关键区别在哪,同一 T 恤怎么变样都还是 T 恤。这种靠 “拉近正例、推远负例” 来逼模型学本质特征的方法,就是对比式自监督学习的核心逻辑,简单来说就是 “近朱者赤,近墨者黑,同类抱团,异类远离”。
1.2.3 判别式自监督学习
原理:将自监督任务转化为分类或回归等判别问题,通过设计 “代理任务”(Pretext Task)让模型预测数据内部的隐藏结构或伪标签,间接学习数据的语义或结构特征。其核心在于:代理任务的求解依赖数据的内在规律,模型通过解决代理任务可捕获这些规律。
工作流程:
- 代理任务设计:根据数据特性定义预测目标,例如:
- 图像:预测图像块的相对位置(如将图像分割为多块,预测某块是否位于另一块的左侧)。
- 文本:判断两个句子是否连续(如 BERT 的 Next Sentence Prediction 任务)。
- 特征编码与预测:编码器提取输入数据的特征,通过分类头(如全连接层)预测代理任务的标签(如位置关系、句子连贯性)。
- 判别损失优化:以代理任务的预测准确率为目标,通过交叉熵损失等优化编码器参数,使特征能有效支持判别任务。
典型场景:图像自监督中,模型通过预测图像块的旋转角度(如 0°、90°、180°)学习视觉特征;NLP 中,GPT 通过预测下一个单词(自回归任务)学习语言结构。
说人话:判别式自监督学习的原理就是:给模型布置一个 “假任务”,让它在完成假任务的过程中,偷偷学会数据的真实规律。比如,拿一张 T 恤的图片,先不告诉模型这是 “T 恤”,而是让它猜 “这张图片被旋转了多少度?”(比如 0 度、90 度、180 度)。模型为了猜对旋转角度,就得观察图片里的图案方向、领口形状等特征 —— 这些特征其实就是区分 T 恤和其他衣服的关键。再比如,给一段文字,让模型判断 “第二个句子是不是第一个句子的下文?”。模型为了答对,就得理解句子之间的逻辑关系,而这种逻辑理解能力,正是后续做文本分类、翻译等真实任务的基础。这里的 “旋转角度预测”“句子连贯性判断” 就是 “代理任务”,它们就像模型的 “练习题”。虽然模型表面上在做练习题,但实际上通过解决这些问题,它学会了数据的内在结构(如图像的方向、文本的语义)。等遇到真实任务(如分类 T 恤和牛仔裤)时,这些偷偷学到的特征就能派上用场了。简单来说,就是 “醉翁之意不在酒”—— 模型做的是代理任务,学的却是真正有用的底层规律,用假任务当 “跳板”,跳到真实的特征学习上。
1.2.4 三类自监督学习的对比
| 维度 | 生成式自监督学习 | 对比式自监督学习 | 判别式自监督学习 |
|---|---|---|---|
| 核心原理 | 通过重构或生成数据学习潜在结构 | 通过对比样本相似性学习判别性特征 | 通过解决代理判别任务间接学习语义特征 |
| 监督信号来源 | 数据本身的完整性(如掩码恢复、序列生成) | 样本间的相对关系(正例 vs 负例) | 人工设计的代理任务标签(如图像旋转角度) |
| 损失函数 | 重构误差(如 MSE、交叉熵) | 对比损失(如 InfoNCE、NT-Xent) | 判别损失(如交叉熵、回归损失) |
| 建模方式 | 编码器 - 解码器架构(自动编码器、Transformer) | 单编码器 + 对比学习头 | 单编码器 + 判别分类头 |
| 特征目标 | 学习数据分布的生成能力,捕获语义连贯性 | 学习区分样本的判别能力,使同类特征聚集 | 学习解决特定任务的特征表示,适用于下游任务 |
| 数据利用方式 | 关注单个样本内部的结构关系(如掩码与预测) | 关注样本间的相对关系(增强视图 vs 其他样本) | 关注样本与代理任务标签的映射关系 |
| 典型模型 | BERT(MLM 任务)、MAE(图像补全)、VAE | SimCLR、MoCo、DINO | BERT(NSP 任务)、DeepCluster、旋转预测模型 |
| 优势 | 直接学习数据生成规律,适用于生成任务 | 训练效率高,特征判别性强,适用于分类 / 检索 | 任务设计灵活,可针对特定下游任务定制代理任务 |
| 局限性 | 计算复杂度高,生成质量评估困难 | 依赖大量负样本,特征可能偏向对比任务而非语义 | 代理任务设计需经验,可能与真实任务存在偏差 |
| 应用场景 | 生成任务(如文本生成、图像修复) | 表征学习(如图像检索、聚类) | 判别任务(如分类、检测、分割) |
生成式更关注数据的 “内在结构”,通过重构 / 生成任务学习语义连贯性,适合需要理解数据分布的场景。
对比式通过样本间的 “相对关系” 学习强判别性特征,训练效率高,在图像和文本表征学习中广泛应用。
判别式通过设计特定代理任务间接学习特征,灵活性强,可针对下游任务定制,但依赖任务设计的质量。
实际应用中,三者可能结合使用(如同时优化对比损失和生成损失),以综合提升模型性能。
二,Fashion-MNIST 数据集简介
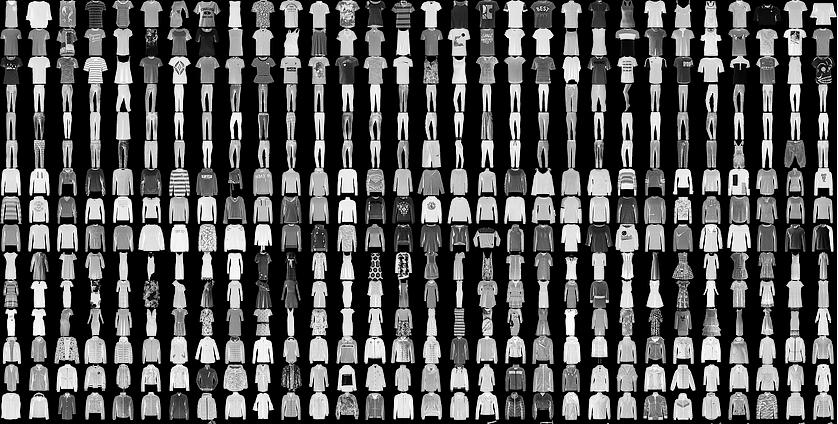
Fashion-MNIST 是由 Zalando 研究部门发布的图像数据集,作为 MNIST 手写数字数据集的替代品,旨在为机器学习和计算机视觉领域提供更具挑战性的任务。该数据集包含 70000 张 28×28 像素的单通道灰度图像,其中 60000 张用于训练、10000 张用于测试,涵盖 T 恤、牛仔裤、套衫、裙子、外套、凉鞋、衬衫、运动鞋、包、短靴共 10 个类别的时尚单品,每个类别在训练集和测试集中分别有 6000 个和 1000 个样本,属于平衡数据集。其数据大小、格式及训练集 / 测试集划分与 MNIST 完全一致,便于研究人员直接替代 MNIST 进行算法性能对比,而图像中服饰物品的特征比手写数字更复杂,更贴近实际应用场景,因此更具挑战性,自 2017 年发布以来被广泛应用于图像分类、异常检测、聚类等学术研究。
三,自监督学习部分
3.1 数据处理:构造代理任务与伪标签
通过旋转图像 + 角度分类生成自监督信号,将无标签数据转化为带 “伪标签” 的监督数据。
class RotationSelfSupervisedDataset(Dataset):
    def __init__(self, base_dataset):
        self.base_dataset = base_dataset
        self.angles = [0, 90, 180, 270]  # 4种旋转角度,对应4个类别

    def __getitem__(self, idx):
        img, _ = self.base_dataset[idx]  # 忽略原始标签(0-9的类别)
        angle_idx = np.random.randint(0, 4)  # 随机选择旋转角度索引(0-3)
        rotated_img = transforms.functional.rotate(img, self.angles[angle_idx])
return rotated_img, angle_idx # 返回旋转图像及其角度标签(伪标签)伪标签生成:将旋转角度索引(0-3)作为监督信号,无需人工标注,完全依赖数据自身的几何变换。
任务设计目的:迫使模型学习图像的旋转不变性特征(如形状、边缘方向),这些特征对下游分类任务(如区分 T 恤和牛仔裤)具有通用性。
3.2 模型设计:特征提取与分类头
通过卷积神经网络(CNN)提取图像特征,并用分类头预测旋转角度,间接学习可迁移的视觉特征。
class SimpleSelfSupervisedModel(nn.Module):
    def __init__(self, num_classes=4):
        super().__init__()
        # 特征提取层:3层卷积+池化,逐步提取抽象特征
        self.conv_layers = nn.Sequential(
            nn.Conv2d(1, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),  # 14x14
            nn.Conv2d(16, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),  # 7x7
            nn.Conv2d(32, 64, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2)   # 3x3
        )
        # 分类头:将特征映射到4个旋转角度类别
        self.fc_layers = nn.Sequential(
            nn.Flatten(),  # 3x3x64 → 576
            nn.Linear(576, 128), nn.ReLU(), nn.Dropout(0.5),
            nn.Linear(128, num_classes)
        )

    def forward(self, x):
        x = self.conv_layers(x)  # 提取特征
        x = self.fc_layers(x)    # 分类预测
return x特征提取逻辑:卷积层通过局部感知野和下采样,逐步提取从低级边缘(第 1 层)到高级形状(第 3 层)的特征。例如,第 3 层的 64 通道特征图可能捕获 “圆领”“纽扣” 等服饰关键部件。
分类头作用:分类头将特征映射到旋转角度类别,其训练过程迫使卷积层学习与旋转相关的特征(如方向敏感的边缘模式)。
3.3 训练目标:通过分类损失优化特征
以旋转角度分类准确率为目标,优化模型参数,使卷积层提取的特征能够区分不同旋转角度。
criterion = nn.CrossEntropyLoss()  # 多分类损失函数
optimizer = optim.Adam(model.parameters(), lr=0.001)

def train_self_supervised(model, dataloader, epochs=10):
    model.train()
    for epoch in range(epochs):
        total_loss = 0
        for images, labels in dataloader:
            images, labels = images.to(device), labels.to(device)
            outputs = model(images)
            loss = criterion(outputs, labels)  # 计算预测角度与真实角度的损失
            loss.backward()
            optimizer.step()
            total_loss += loss.item()
print(f'Epoch {epoch+1}, Loss: {total_loss/len(dataloader):.4f}')损失函数意义:交叉熵损失要求模型对旋转角度的预测概率尽可能接近真实标签(如输入 90° 旋转图像时,模型输出的第 1 个类别概率趋近于 1)。
隐式特征学习:模型为了降低损失,必须学会捕获与旋转相关的特征(如垂直边缘 vs 水平边缘),而这些特征恰好是区分不同服饰类别的关键(如 T 恤的垂直纹理 vs 牛仔裤的水平纹理)。
3.4 迁移逻辑:从自监督到下游任务
冻结自监督训练好的卷积层(特征提取器),仅替换并训练分类头,将学到的通用特征迁移到 FashionMNIST 分类任务。
class DownstreamClassifier(nn.Module):
    def __init__(self, pretrained_model):
        super().__init__()
        self.conv_layers = pretrained_model.conv_layers  # 复用预训练的特征提取器
        for param in self.conv_layers.parameters():
            param.requires_grad = False  # 冻结卷积层参数
        # 新分类头:映射到10个服饰类别
        self.fc_layers = nn.Sequential(
            nn.Flatten(),
            nn.Linear(64*3*3, 128), nn.ReLU(), nn.Dropout(0.5),
            nn.Linear(128, 10)
)特征复用原理:自监督训练中学习到的特征(如边缘方向、形状)对下游分类任务具有语义一致性。例如,区分 T 恤和衬衫的关键特征(领口形状)可能已在旋转预测任务中被捕获。
参数冻结意义:避免在下游任务训练中破坏预训练好的特征提取器,仅通过新分类头适配具体类别标签,减少过拟合风险。
四,测试结果
4.1 测试结果
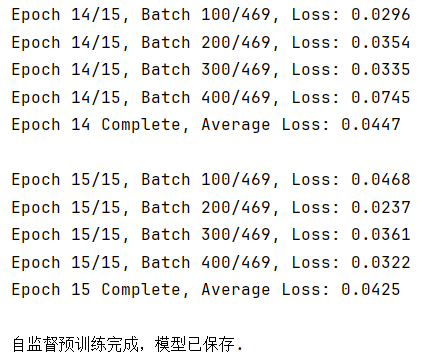
上游训练任务结果测试:
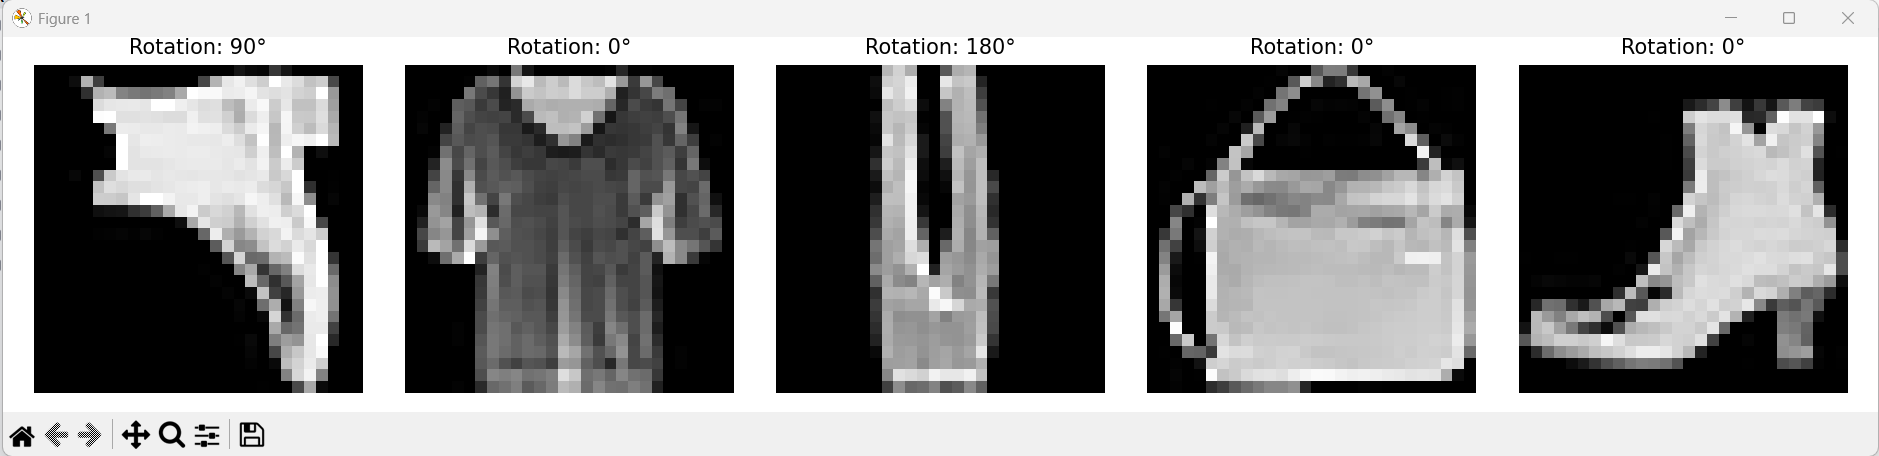
上游训练任务的损失:
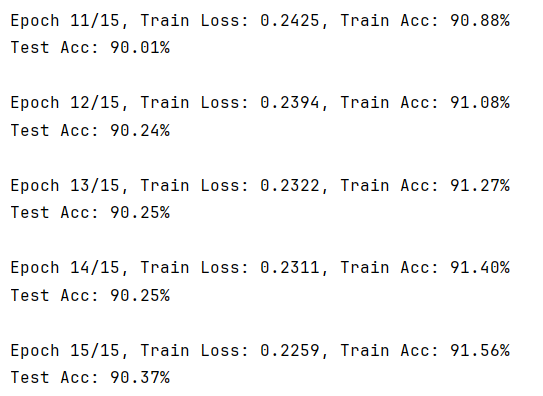
下游分类任务的精确度:
4.2 总结
代码实现了基于判别式自监督学习的图像特征学习与迁移,核心流程为:首先通过自定义数据集对 FashionMNIST 图像进行随机旋转(0°、90°、180°、270°),生成以旋转角度为伪标签的自监督训练数据;然后利用简单 CNN 模型(含三层卷积 - 池化模块和全连接分类头)学习预测旋转角度,迫使模型提取图像的方向不变性特征(如边缘、形状);预训练完成后,冻结卷积层参数,仅替换并训练新的全连接分类头,将学到的特征迁移到 FashionMNIST 的 10 类分类任务中。该方法通过 “旋转预测代理任务” 实现无人工标注的特征学习,有效提升了下游分类任务的泛化能力,体现了自监督学习利用数据内在结构构建监督信号的核心思想。
在 FashionMNIST 上达到 91% 准确率,主要受限于数据集特性、模型架构与训练策略:FashionMNIST 类间差异细微(如 T 恤与衬衫)且图像分辨率低,自监督旋转预测任务虽能学习方向不变性特征,但对部分类别区分力不足;模型采用浅层 CNN(3 层卷积),特征提取能力有限,且预训练轮次(15 epoch)和数据增强(仅旋转)不够充分。此外,下游任务微调时冻结全部卷积层可能限制特征适应性。可通过加深网络(如 ResNet)、增加数据增强(如裁剪、翻转)、延长预训练或逐层微调卷积层进一步提升性能。
五,完整代码
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms
from torch.utils.data import DataLoader, Dataset
import numpy as np
import matplotlib.pyplot as plt

# 设置随机种子确保结果可复现
torch.manual_seed(42)
np.random.seed(42)
# 设置设备
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
# =====================
# 1. 自监督学习部分
# =====================

# 数据预处理 - 将图像转换为张量并标准化(使用FashionMNIST的全局均值和标准差)
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.1307,), (0.3081,))
])

# 加载FashionMNIST训练集(仅使用图像,忽略原始标签)
# 自监督学习不需要人工标注,完全依赖数据自身的结构
train_dataset = datasets.FashionMNIST(
    root='./data',  # 数据存储路径
    train=True,  # 使用训练集
    download=True,  # 自动下载(如果数据不存在)
    transform=transform  # 应用预处理
)


# 自定义数据集类 - 为每张图像生成旋转任务的自监督标签
class RotationSelfSupervisedDataset(Dataset):
    def __init__(self, base_dataset):
        self.base_dataset = base_dataset  # 原始FashionMNIST数据集
        self.angles = [0, 90, 180, 270]  # 定义四种旋转角度(对应四个类别)

    def __len__(self):
        return len(self.base_dataset)  # 数据集大小

    def __getitem__(self, idx):
        # 获取原始图像并忽略其标签(-1到10的类别)
        img, _ = self.base_dataset[idx]

        # 随机选择一种旋转角度(0-3的整数)
        angle_idx = np.random.randint(0, 4)
        angle = self.angles[angle_idx]

        # 对图像应用选定的旋转
        rotated_img = transforms.functional.rotate(img, angle)

        # 返回旋转后的图像及其对应的角度标签
        return rotated_img, angle_idx


# 创建自监督学习数据集和数据加载器
self_sup_dataset = RotationSelfSupervisedDataset(train_dataset)
dataloader = DataLoader(
    self_sup_dataset,  # 自监督数据集
    batch_size=128,  # 每批次处理的样本数
    shuffle=True  # 打乱数据顺序
)


# 定义用于自监督学习的简单CNN模型
class SimpleSelfSupervisedModel(nn.Module):
    def __init__(self, num_classes=4):  # 默认4个类别(对应四种旋转角度)
        super().__init__()

        # 特征提取网络 - 使用卷积层提取图像特征
        self.conv_layers = nn.Sequential(
            # 第一个卷积块:1通道 -> 16通道
            nn.Conv2d(1, 16, kernel_size=3, stride=1, padding=1),
            nn.ReLU(),  # ReLU激活函数引入非线性
            nn.MaxPool2d(kernel_size=2, stride=2),  # 降采样

            # 第二个卷积块:16通道 -> 32通道
            nn.Conv2d(16, 32, kernel_size=3, stride=1, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2),

            # 第三个卷积块:32通道 -> 64通道
            nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2)
        )

        # 分类网络 - 将提取的特征映射到旋转角度类别
        self.fc_layers = nn.Sequential(
            nn.Flatten(),  # 将多维特征展平为一维向量

            # 全连接层:64*3*3特征 -> 128特征
            # 注意:3*3是28x28图像经过三次池化后的尺寸
            nn.Linear(64 * 3 * 3, 128),
            nn.ReLU(),
            nn.Dropout(0.5),  # 防止过拟合

            # 输出层:128特征 -> 4个旋转类别
            nn.Linear(128, num_classes)
        )

    def forward(self, x):
        # 前向传播:特征提取 -> 分类
        x = self.conv_layers(x)
        x = self.fc_layers(x)
        return x


# 初始化模型、损失函数和优化器
model = SimpleSelfSupervisedModel().to(device)  # 模型移至GPU(如果可用)
criterion = nn.CrossEntropyLoss()  # 多分类交叉熵损失函数
optimizer = optim.Adam(model.parameters(), lr=0.001)  # Adam优化器


# 自监督训练函数
def train_self_supervised(model, dataloader, epochs=10):
    model.train()  # 设置为训练模式

    for epoch in range(epochs):
        total_loss = 0

        # 遍历数据批次
        for batch_idx, (images, labels) in enumerate(dataloader):
            # 将数据移至GPU(如果可用)
            images, labels = images.to(device), labels.to(device)

            # 前向传播:计算模型预测
            outputs = model(images)
            loss = criterion(outputs, labels)  # 计算损失

            # 反向传播:计算梯度并更新参数
            optimizer.zero_grad()  # 清除上一步的梯度
            loss.backward()  # 反向传播计算梯度
            optimizer.step()  # 更新模型参数

            total_loss += loss.item()

            # 打印训练进度
            if (batch_idx + 1) % 100 == 0:
                print(f'Epoch {epoch + 1}/{epochs}, Batch {batch_idx + 1}/{len(dataloader)}, Loss: {loss.item():.4f}')

        # 计算并打印每个epoch的平均损失
        avg_loss = total_loss / len(dataloader)
        print(f'Epoch {epoch + 1} Complete, Average Loss: {avg_loss:.4f}\n')

    return model


# 执行自监督训练
print("开始自监督预训练...")
pretrained_model = train_self_supervised(model, dataloader, epochs=15)
torch.save(pretrained_model.state_dict(), 'fashionmnist_rotation_pretrained.pth')
print("自监督预训练完成,模型已保存.")

# =====================
# 2. 下游分类任务部分
# =====================

# 加载FashionMNIST真实标签数据集(用于下游分类任务)
downstream_train_dataset = datasets.FashionMNIST(
    root='./data',
    train=True,
    download=True,
    transform=transform
)
downstream_test_dataset = datasets.FashionMNIST(
    root='./data',
    train=False,
    download=True,
    transform=transform
)

# 创建下游任务的数据加载器
downstream_train_loader = DataLoader(downstream_train_dataset, batch_size=128, shuffle=True)
downstream_test_loader = DataLoader(downstream_test_dataset, batch_size=128, shuffle=False)


# 定义下游分类模型 - 复用自监督学习中训练好的特征提取层
class DownstreamClassifier(nn.Module):
    def __init__(self, pretrained_model):
        super().__init__()

        # 复用预训练模型的卷积层(特征提取部分)
        self.conv_layers = pretrained_model.conv_layers

        # 冻结卷积层参数,只训练新的分类头
        # 这样可以利用自监督学习学到的通用特征
        for param in self.conv_layers.parameters():
            param.requires_grad = False

        # 定义新的分类头(针对FashionMNIST的10个类别)
        self.fc_layers = nn.Sequential(
            nn.Flatten(),
            nn.Linear(64 * 3 * 3, 128),
            nn.ReLU(),
            nn.Dropout(0.5),
            nn.Linear(128, 10)  # 输出10个类别
        )

    def forward(self, x):
        # 前向传播:特征提取(冻结) -> 分类(训练)
        x = self.conv_layers(x)
        x = self.fc_layers(x)
        return x


# 初始化下游模型并加载预训练权重
downstream_model = DownstreamClassifier(pretrained_model).to(device)
downstream_optimizer = optim.Adam(downstream_model.fc_layers.parameters(), lr=0.001)
downstream_criterion = nn.CrossEntropyLoss()


# 下游任务训练函数
def train_downstream(model, train_loader, test_loader, epochs=5):
    model.train()  # 设置为训练模式

    for epoch in range(epochs):
        total_loss = 0
        correct = 0
        total = 0

        # 训练阶段
        for images, labels in train_loader:
            images, labels = images.to(device), labels.to(device)

            # 前向传播
            outputs = model(images)
            loss = downstream_criterion(outputs, labels)

            # 反向传播和优化
            downstream_optimizer.zero_grad()
            loss.backward()
            downstream_optimizer.step()

            # 统计训练准确率
            total_loss += loss.item()
            _, predicted = torch.max(outputs.data, 1)
            total += labels.size(0)
            correct += (predicted == labels).sum().item()

        # 计算并打印训练准确率
        train_acc = 100. * correct / total
        print(
            f'Epoch {epoch + 1}/{epochs}, Train Loss: {total_loss / len(train_loader):.4f}, Train Acc: {train_acc:.2f}%')

        # 评估阶段
        model.eval()  # 设置为评估模式
        test_correct = 0
        test_total = 0

        with torch.no_grad():  # 不计算梯度,节省内存和计算资源
            for images, labels in test_loader:
                images, labels = images.to(device), labels.to(device)
                outputs = model(images)
                _, predicted = torch.max(outputs.data, 1)
                test_total += labels.size(0)
                test_correct += (predicted == labels).sum().item()

        # 计算并打印测试准确率
        test_acc = 100. * test_correct / test_total
        print(f'Test Acc: {test_acc:.2f}%\n')

        model.train()  # 恢复训练模式,为下一个epoch做准备


# 执行下游分类任务训练
print("开始下游分类任务...")
train_downstream(downstream_model, downstream_train_loader, downstream_test_loader, epochs=15)


# =====================
# 3. 可视化辅助函数(可选)
# =====================

def visualize_rotations(dataset, num_samples=5):
    """可视化旋转后的图像样本"""
    fig, axes = plt.subplots(1, num_samples, figsize=(15, 3))
    angles = ['0°', '90°', '180°', '270°']

    for i in range(num_samples):
        idx = np.random.randint(0, len(dataset))
        img, label = dataset[idx]
        img_np = img.squeeze().numpy()  # 转换为numpy数组

        axes[i].imshow(img_np, cmap='gray')
        axes[i].set_title(f'Rotation: {angles[label]}')
        axes[i].axis('off')  # 关闭坐标轴

    plt.tight_layout()  # 自动调整布局
    plt.show()

# 取消注释以下行以可视化旋转样本
visualize_rotations(self_sup_dataset)
北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 39
 0
- 0


 已为社区贡献13条内容

所有评论(0)