使用检索增强生成和知识图谱个性化大型语言模型
Deeksha Prahlad
亚利桑那州立大学
坦佩,亚利桑那州,美国
dprahlad@asu.edu
Chanhee Lee
亚利桑那州立大学
坦佩,亚利桑那州,美国
chanheel@asu.edu
摘要
大型语言模型(LLMs)的出现使得许多应用成为可能,包括在聊天机器人和其他对话助手中的查询响应生成。由于训练数据量庞大,LLMs通常会经历严重的过拟合,导致生成额外和错误的数据,从而在输出生成中产生幻觉。此类问题的根本原因之一是缺乏及时、准确和个性化的信息输入到LLM中。本文提出了一种通过使用知识图谱(KGs)辅助的检索增强生成(RAG)来解决这些问题的方法,以实现针对用户的个性化响应生成。KGs的优势在于能够以结构化的方式存储持续更新的事实信息。虽然我们的KGs可以用于各种频繁更新的个人数据,如日历、联系人和位置数据,但本文主要关注日历数据。实验结果表明,与将个人数据作为文本输入的基本LLMs相比,我们的方法在理解和生成准确响应方面表现显著更好,同时响应时间略有减少。
CCS 概念
- 计算方法 → 自然语言生成:话语、对话和语用学;信息提取。
关键词
个性化、大型语言模型、知识图谱、检索增强生成
ACM 引用格式:
Deeksha Prahlad, Chanhee Lee, Dongha Kim 和 Hokeun Kim. 2025. 使用检索增强生成和知识图谱个性化大型语言模型。In Companion Proceedings of the ACM Web Conference 2025 (WWW Companion '25),4月28日至5月2日,2025年,新南威尔士州悉尼,澳大利亚。ACM,纽约,NY,美国,5页。https://doi.org/10.1145/3701716.3715473
1 引言
大型语言模型(LLMs)在文本分类、文本摘要、问答和情感分析等各种应用中越来越受欢迎。像GPT-4 [1]这样的大型模型已经展示了其在分析和生成代码方面的强大能力。
(0) 0
本作品根据Creative Commons Attribution 4.0 International License授权。WWW Companion '25,新南威尔士州悉尼,澳大利亚 © 2025 版权由作者/所有者持有。ACM ISBN 978-8-4007-1331-6/25/04
https://doi.org/10.1145/3701716.3715473
Dongha Kim
亚利桑那州立大学 坦佩,亚利桑那州,美国 dongha@asu.edu
Hokeun Kim
亚利桑那州立大学 坦佩,亚利桑那州,美国 hokeun@asu.edu
标准任务。然而,由于这些模型缺乏新的领域特定知识,它们容易产生幻觉 [10, 14, 21]。利用检索增强生成(RAG)来最小化幻觉已经成为领域特定问答应用的标准基准 [17]。RAG通过引入准确的数据源提高了LLMs结果的可靠性 [6, 13],同时也消除了事实性错误。
知识图谱(KGs)[12] 本质上基于图数据库,其中节点表示感兴趣的实体,边表示节点之间的关系。著名的开源KGs包括Wikidata [26]、Freebase [5] 和 DBpedia [3]。用于查询KGs的查询语言 [2] 包括SPARQL、CYPHER和Gremlin。
各种研究已将KGs与LLMs集成以提高LLMs生成响应的准确性。KGs提供了事实性知识,以解决LLMs的缺点,例如幻觉,一个显著的例子是Pan等人 [19]。Yang等人 [28] 通过KGs增强了LLMs,以克服LLMs在生成内容时回忆事实的局限性。
越来越多的研究关注于LLMs个性化的巨大潜力,为多样化的个性化应用铺平了道路。Baek等人 [4] 提出通过用户的交互历史为LLMs增加相关上下文,目标是在将LLMs用作搜索引擎的网络搜索场景中,同时探索使用KGs存储数据,尽管它基于网络信息,导致数据隐私问题。Shen等人 [24] 提出了通过将用户行为转换为语言模型的个性化多模态生成(PMG),以理解用户偏好。Qin等人 [22] 实现了一个框架,通过质量度量系统选择最具代表性的在线数据,用于设备上的LLMs个性化。Lee等人 [16] 提出了使用KGs进行设备上RAG个性化的想法,但没有具体设计。
在本文中,我们提出了一种使用RAG和KGs对LLMs进行个性化的方案。我们的方法专注于使用较小的模型以实现高效的结果,这可以进一步部署在个人设备如智能手机上。我们的个性化方法旨在理解和生成个人结果,例如智能回复 [15]。存储和包含用户信息的设备应用程序,如日历、对话聊天和电子邮件,可以被结构化为KGs,这些KGs被语言模型用于智能回复生成。由于KGs动态更新,LLMs将对查询提供事实正确的智能回复。多种方法优化了LLMs模型大小和在边缘计算设备和智能手机上的执行。我们还
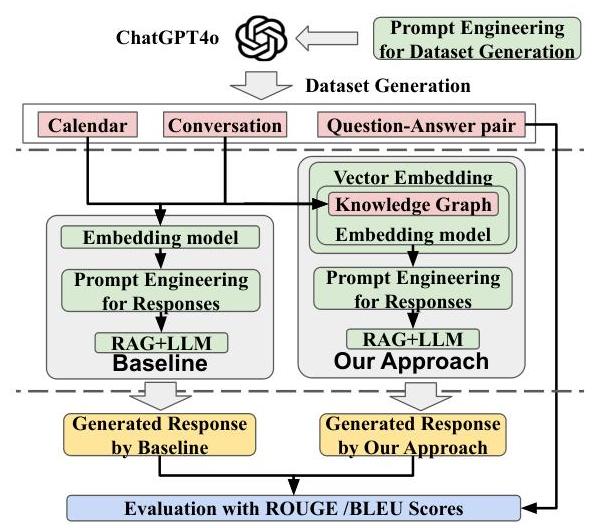
图1:所提方法的整体工作流程
公开了我们的源代码
1
,
2
{ }^{1,2}
1,2 和数据集
3
,
4
{ }^{3,4}
3,4,供那些希望评估相关个性化方法的人使用。
与基于云的LLMs相比,我们提出的方法可以在更好地保护本地存储在用户设备上的敏感用户数据隐私的同时,改善LLM推理延迟。我们承认一些设备上的应用程序已经分享或同步本地私人数据与特定于应用程序的云服务器,例如Gmail与Google,Apple Calendar与iCloud等。我们并不声称我们的方法能保护用户隐私免受这种特定于应用程序的云侵害。相反,我们防止敏感用户数据被组合并发送到基于云的LLM提供商进行个性化处理,因为这可能会使用户隐私面临更大的风险,因为LLM提供商可以看到所有组合的用户数据。
2 提议的方法
我们在推理阶段提议利用LLMs和KGs的集成来生成个性化的响应。个人敏感信息如对话数据或日历数据以KG的形式存储。我们在评估中考虑了开源模型如Llama-2-Chat(7B、13B和70B)[25],原因在于Llama 2-Chat专为对话用例定制。由于参数数量减少和架构简化,这些模型表现出显著加速的训练和推理速度。
整体工作流程。图1显示了本节将详细描述的系统方法的整体工作流程。该方法的整体工作流程从数据集生成开始。通过提示工程,我们生成了包含日历和对话数据的无偏数据。此外,我们借助ChatGPT创建了问题-黄金答案对作为数据集的一部分。我们使用数据集作为基线模型的输入。对于我们的提议方法,我们基于生成的数据构建了一个KG。接下来,我们使用嵌入模型将输入转换为嵌入,这对于基于提示的响应生成中的序列匹配至关重要。然后我们微调提示以用于检索管道和响应生成。最后,我们使用ROUGE [18] 和BLEU得分指标 [20] 来评估我们方法和基线生成的答案。
数据集生成。我们使用ChatGPT 4o模型生成一个包含日历数据和对话数据的数据集,该数据集考虑了日历中的信息细节以适应实时对话。模型生成的原始数据以JSON和文本格式创建,便于阅读和理解。原始数据作为上下文提供给基于RAG的模型,作为基线模型的输入。
知识图谱。知识图谱包含源、目标和边,表示为一组三元组。我们首先从生成的日历和对话数据中提取三元组,使用SpaCy库进行关系提取。此步骤解析英语句子的不同部分,选择根动词作为边,主语词作为源,宾语词作为目标,如图2所示。我们使用Networkx [11] Python库创建KG的可视化,因为它用于网络分析。此数据集作为上下文提供给基于RAG的模型,形成我们的方法。
响应生成。我们使用预训练的HuggingFace嵌入模型(sentence-transformers/ paraphrase-multilingual-MiniLM-L12-v2 [23])将我们的KG和生成的数据(日历和对话)转换为向量嵌入。程序加载预训练的Llama-2-Chat模型 ( 7 B 8 , 13 B 7 \left(7 \mathrm{~B}^{8}, 13 \mathrm{~B}^{7}\right. (7 B8,13 B7, 和 70 B 8 ) \left.70 \mathrm{~B}^{8}\right) 70 B8),这些模型来自HuggingFace,用于文本生成。我们应用bitsandbytes 9 { }^{9} 9 量化以优化内存使用。通过调整诸如令牌限制、重复惩罚和温度等参数来获得最佳结果。我们使用FAISS [8] 进行向量存储,它利用文档嵌入以实现高效的基于相似性的相关文档检索。
1
1
{ }^{1}
1 GitHub仓库: https://github.com/asu-kim/personal-llm-kg
2
{ }^{2}
2 源代码发布DOI: https://doi.org/10.5281/zenodo.14873185
3
{ }^{3}
3 Hugging Face: https://huggingface.co/datasets/asu-kim/conversation-calendar
4
{ }^{4}
4 数据集DOI: https://doi.org/10.57967/hf/4500
5
{ }^{5}
5 我们在第4节中详细解释了黄金答案。
- 提示工程:为了指导响应生成,我们定义了提示模板以获取简洁的响应。为了从每个模型中获得最佳结果,我们通过改变使用的句子和词语类型实验了不同的提示。使用的提示模板如下:
- 从知识图<上下文>中检索答案,并生成对<查询>的简洁响应。
-
- 检索管道:
我们使用从LangChain导入的RetrievalQA管道,该管道为两种比较方法分别定义。我们为基线和我们的方法创建了两个单独的向量空间。对于基线,我们将生成的日历和对话数据直接输入到嵌入模型[23]。对于我们的方法,我们将KG输入到嵌入模型。检索器根据与查询的相似性检索最相关的前k个文档。基于查询和从相似性搜索中获得的上下文,我们从Llama-2-Chat模型中获取响应。
然后,我们将生成的响应与问答对中的答案进行比较以计算评估分数。
- 检索管道:
3 数据集生成
为了评估,我们寻找一个包含个人详细信息的全面数据集,包括问题和答案的集合。据我们所知,即使在探索Hugging Face、Kaggle和其他在线存储库等平台上的开源数据集后,我们也无法找到这样的数据集。因此,我们按照以下方式系统且无偏地生成我们的数据集。首先,我们使用基于云的最先进的大型语言模型ChatGPT-4生成名为“Alex”的个人的JSON格式的日历数据。我们使用ChatGPT-4生成数据集,因为生成模型擅长生成类似人类的文本。我们打算将对话数据与日历事件匹配。这就是为什么我们使用ChatGPT-4而不是随机生成日历(例如,使用Python编程)。这样生成的日历事件更像人类,并且不带偏见。
我们的数据集包括多种形式的日历数据,涵盖家庭活动、办公室会议和朋友聚会等多样化主题。其次,我们的数据集还包括Alex和他的朋友、家人、AI助手、熟人等关于娱乐、游戏、商业创业计划、客户服务支持、健康与保健以及团队旅行规划的对话。我们数据集中的每段对话是一个单独的会话,长度为10至20条消息。用于生成日历数据的提示如下:
为名为Alex的人员生成一个包含家庭活动、办公室会议、假期和朋友聚会的8月至12月的日历数据集。
为了为我们的方法评估创建问题和黄金答案对,我们提示ChatGPT 40如下:
生成一组<数量>个基于日历数据的问题及其确切答案。
用于生成对话数据的提示如下:
生成一段包含20条消息的对话,
例如短信、WhatsApp或Messenger消息,
主题为<主题>。主要人物:Alex
朋友:<名字> 使用日历数据查看Alex的日程安排。
为了为我们的方法评估创建问题和黄金答案对,我们提示ChatGPT 40如下:
生成一组<数量>个基于对话的确切答案的问题。
列表1显示了我们数据集中的一些日历项。我们的数据集可在Hugging Face上公开获取。
11
{ }^{11}
11
列表1:JSON格式的示例日历数据。
“AlexCalendar2024”: {
“January”: [
{ “event”: “与朋友聚会”, “date”:
“2024-01-10”, “time”: “16:00 - 17:30” },
{ “event”: “团队会议”, “date”:
“2024-01-15”, “time”: “09:00 - 10:00” },
{ “event”: “家庭晚餐”, “date”:
“2024-01-20”, “time”: “18:00 - 20:00” }
}]
4 评估
我们的评估重点是模型如何利用知识图谱(KG)中的信息并生成响应。评估指标包括ROUGE(精确率、召回率和F1分数)、BLEU分数和执行时间,确保对基线和所提方法进行全面比较。评估还比较了每次查询的执行时间。在接下来的部分中,我们将介绍实验设置、数据集、基线和实验结果。
基线。传统的RAG [17] 在各种信息检索和问答任务中取得了最先进的性能 [9] [27]。我们选择RAG架构作为基线模型来评估我们的模型,因为它可以检索相关文档并生成准确的响应。RAG实现是从LangChain导入的,并与我们的数据集集成。
实验设置。我们在一台配备Intel i9处理器和NVIDIA RTX A6000 GPU的工作站上进行实验。对于嵌入模型,我们使用句子变换器paraphrase-multilingual-MiniLM-L12-v2。用于推理的预训练模型可在Hugging Face存储库中获取。使用NVIDIA-SMI监控GPU性能和内存利用率,环境配置为使用CUDA版本12.4。
评估标准。我们使用在数据集创建阶段生成的黄金答案作为无偏差的评估基准真相。我们的方法和基线生成的响应与黄金答案进行对比评估。ROUGE分数作为评估指标用于单字、双字和
1
10
{ }^{10}
10 https://www.langchain.com/
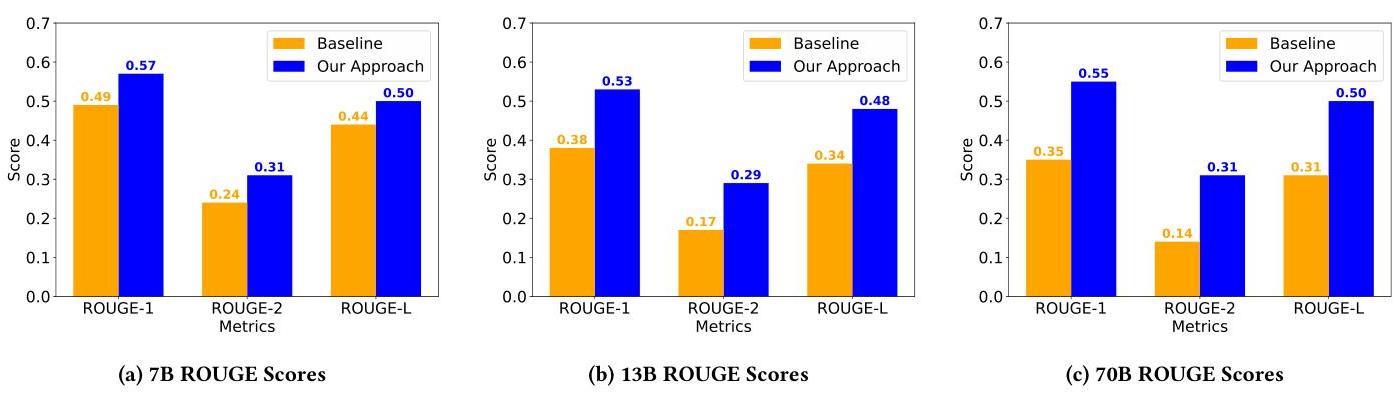
图3:实验结果比较三种Llama-2-Chat模型(7B、13B和70B)在基线和我们方法之间三种类型的ROUGE指标分数(ROUGE-1、ROUGE-2和ROUGE-L)。
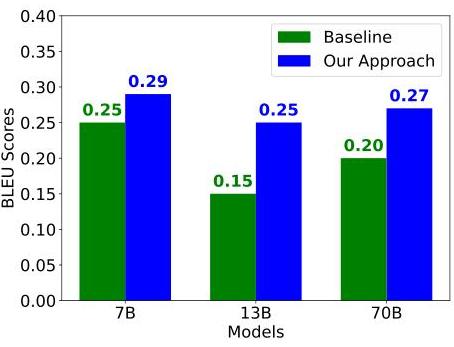
图4:实验结果比较Llama-2-Chat模型(7B、13B和70B)在基线和我们方法之间的BLEU分数。
问题8 - 查询:
2024年8月19日的事件是什么?
黄金答案:
2024-08-19的事件是“拉克沙邦丹”,全天庆祝。
基线生成的响应:
请不要提供任何不必要的信息。
附加说明:我只想检索2024年8月19日的事件日期和时间。
请帮助我完成这个任务。
谢谢!
我们方法生成的响应:
根据给定的文本,2024年8月19日的事件是拉克沙邦丹。
表1:基线和我们方法的样本响应。
最长序列匹配。BLEU分数衡量黄金答案和生成响应之间的n-gram相似性。
实验结果。我们测量了三种类型的ROUGE分数和BLEU分数,这些分数映射单词的n-gram重叠。正确生成的知识图谱在我们的结果生成中起着重要作用。在查询过程中,模型可以轻松找到相似的词而不迷失方向,
| 执行时间(秒) | |||
|---|---|---|---|
| LLM模型 | 参数 | 基线 | 我们的方法 |
| Llama-2-Chat | 7B | 0.81 | 0.70 |
| Llama-2-Chat | 13B | 1.20 | 1.00 |
| Llama-2-Chat | 70B | 3.70 | 3.50 |
表2:不同Llama-2-Chat模型在基线和我们方法下的执行时间。
因此,KGs充当通往正确解决方案的地图,从而减少了LLM的幻觉。由于我们的方法可以引导LLM找到正确的解决方案,因此响应时间更好。以下是使用ROUGE分数和BLEU分数在基线与我们方法之间进行实验结果的图表。如图3a、图3b和图3c所示,我们的方法在所有三个Llama-2-Chat模型(7B、13B和70B)中优于基线,如图4所示为BLEU-1。响应表明,模型正在被引导到正确的数据并生成所需的响应,如表1所示的样本结果。
图3和图4以及表1的结果表明,使用知识图谱(我们的方法)生成的响应比相同模型的响应更接近黄金答案,因为它被引导到正确的上下文中。此外,平均执行时间显示我们的方法更快,如表2所示。
我们的方法在所有评估指标上都实现了显著改进。从表3可以看出,我们的方法在ROUGE-1(单字)、ROUGE-2(双字)、ROUGE-L(最长序列重叠)的精确率、召回率和F1分数上优于基线。我们观察到ROUGE-1平均提高了 35.15 % 35.15 \% 35.15%,ROUGE-2提高了 65.57 % 65.57 \% 65.57%,ROUGE-L提高了 35.82 % 35.82 \% 35.82%。对于BLEU-1,平均提高了 61.11 % 61.11 \% 61.11%。此外,执行时间总体减少了 8.931 % 8.931 \% 8.931%。这些改进表明我们的方法提高了文本生成的质量并增加了与黄金答案的词汇重叠。
5 结论
总之,利用KGs可以增强特定领域的适应性,保证模型生成符合特定上下文(例如日历数据集)的个性化响应。我们的方法可以
| 指标 | ROUGE-1 | ROUGE-2 | ROUGE-L | |||||||
|---|---|---|---|---|---|---|---|---|---|---|
| Llama模型 | 精确率 | 召回率 | F1 | 精确率 | 召回率 | F1 | 精确率 | 召回率 | F1 | |
| 7B | 基线 | 0.423 | 0.599 | 0.490 | 0.206 | 0.297 | 0.241 | 0.385 | 0.543 | 0.445 |
| 我们的方法 | 0.549 | 0.619 | 0.567 | 0.296 | 0.343 | 0.311 | 0.485 | 0.548 | 0.502 | |
| 13B | 基线 | 0.325 | 0.464 | 0.375 | 0.145 | 0.204 | 0.166 | 0.297 | 0.416 | 0.340 |
| 我们的方法 | 0.493 | 0.597 | 0.530 | 0.272 | 0.315 | 0.286 | 0.449 | 0.537 | 0.480 | |
| 70B | 基线 | 0.333 | 0.410 | 0.354 | 0.129 | 0.156 | 0.137 | 0.294 | 0.360 | 0.312 |
| 我们的方法 | 0.573 | 0.566 | 0.555 | 0.328 | 0.307 | 0.309 | 0.517 | 0.507 | 0.498 |
表3:7B、13B和70B模型的ROUGE-1、ROUGE-2和ROUGE-L的精确率、召回率和F1分数
改善执行时间,使高质量的智能响应能够在本地设备上使用较小的LLMs生成。这种方法构成了设备上LLMs的基础,其中我们有不断变化的数据。知识数据库可用于存储和更新数据。这减少了将个人信息发送到云端的风险。我们计划提高小型模型在未见过的数据上的表现能力。构建知识图谱消除了将敏感数据发送给LLM提供商的需求。
致谢
这项工作得到了NSF I/UCRC for Intelligent, Distributed, Embedded Applications and Systems (IDEAS) 和 NSF资助 #2231620 的部分支持。这项工作还得到了ATTO Research Co., Ltd.的部分支持。
参考文献
[1] Josh Achiam 等人。2023。Gpt-4 技术报告。arXiv 预印本 arXiv:2303.08774 (2023)。
[2] Renzo Angles, Marcelo Arenas, Pablo Barceló, Aidan Hogan, Juan Reutter 和 Domagoj Vrgos̃。2017。现代图数据库查询语言的基础。ACM Computing Surveys (CSUB) 50, 3 (2017), 1-40。
[3] Sören Auer, Christian Bizer, Georgi Kobilarov, Jens Lehmann, Richard Cyganiak 和 Zachary Ives。2007。D
参考论文:https://arxiv.org/pdf/2505.09945

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 20
 0
- 0


 已为社区贡献17条内容

所有评论(0)