DeepSeek+Coze实战:如何从0到1打造一个热点监控智能体
短视频小白经常会遇到这样的困扰。
每天花大量时间刷视频,想要找到你所在赛道的爆款内容,却总是难以系统地整理和分析?
想要批量获取某个关键词的爆款视频数据,但是市面上的采集工具要么特别贵,要么操作极其复杂?
或者,已经尝试过各种方法,但始终找不到一个高效、低成本的解决方案?
不用担心,今天我就教你搭建一个Coze智能体,轻松搞定这些烦恼。
篇幅不短,欢迎先收藏,再慢慢阅读。如果觉得有帮助,也请顺手点个赞、在看、转发支持一下~
1.为什么要做热点监控?
通过热点监控,我们可以及时发现赛道中的爆款视频:
- 掌握市场动向:看看哪些视频火了,就知道大家现在喜欢什么,我们也能紧跟潮流
- 学习创作技巧:研究爆款视频是怎么拍的,学习他们的拍摄方式,这样就能少走弯路
- 发现赚钱机会:看看评论区的小伙伴们都在聊什么,说不定就能找到新的商机
- 了解竞争对手:看看其他创作者都在做什么,先模仿再超越
既然这么重要,那我们当然需要一个好用的智能体来帮我们自动收集这些视频。
但是,批量获取抖音视频内容这件事,一直有技术门槛。很多朋友因为不懂技术,只能花钱买工具来完成这项任务。
今天我要分享一个Coze智能体的解决方案,小白也能搭建。
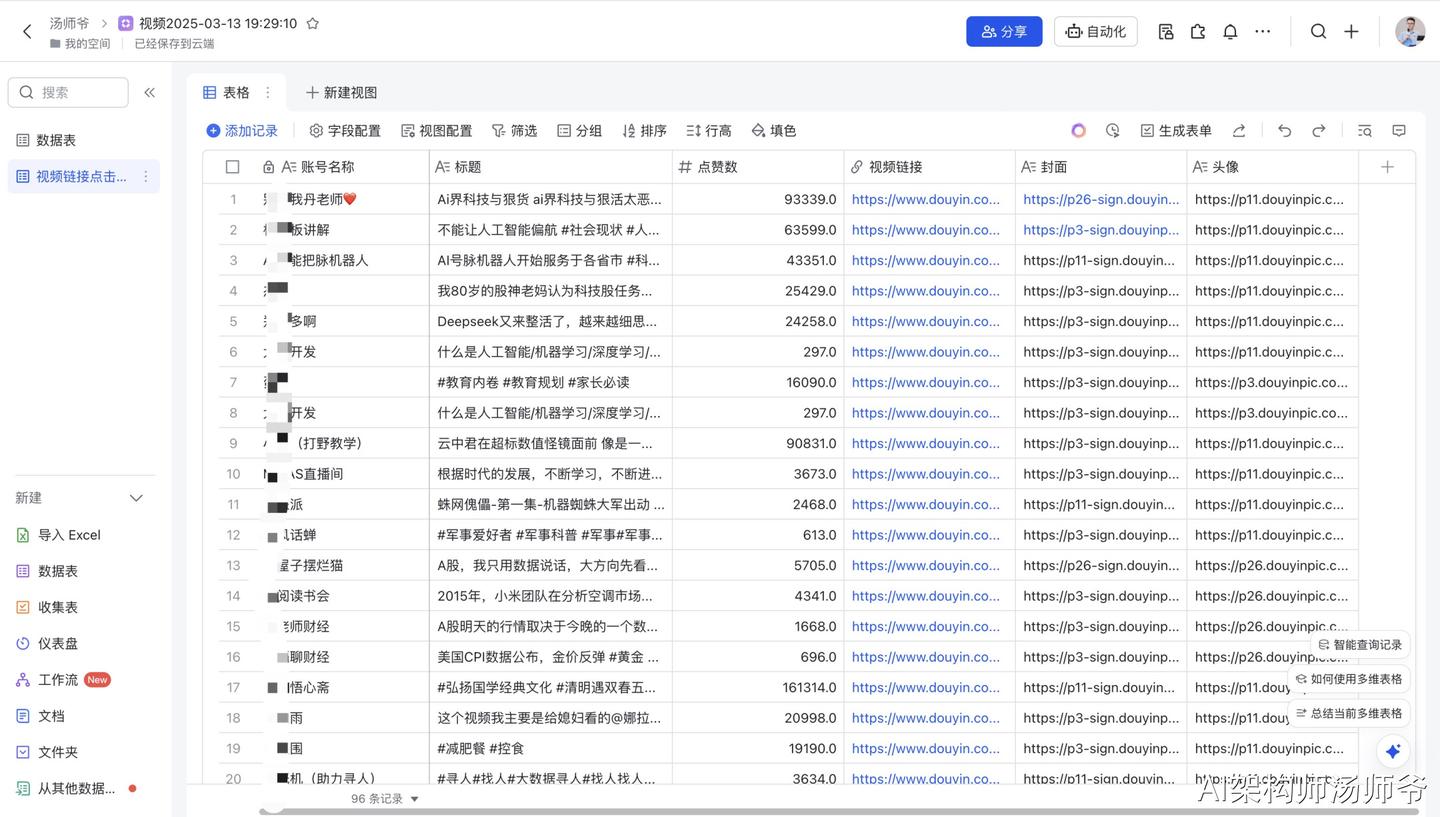
只需输入自己赛道的关键词就能自动批量获取爆款视频内容,轻松实现100条爆款视频的采集工作。效果如下:
2.智能体的搭建流程
智能体的搭建流程主要分为两个步骤:梳理工作流、设置智能体。
2.1 梳理工作流
将对标账号监控的场景流程转化为可自动化运行的工作流节点。
- 根据关键词,批量获取热门视频
- 批量获取视频详细信息
- 将数据添加到多维表格
2.2 设置智能体
- 设置人设与逻辑:配置热点监控智能体的特征、回复风格和决策逻辑
- 绑定工作流:将工作流与智能体关联,赋予执行具体任务的能力
- 设置触发器:定义智能体的启动条件和触发规则,让它能定时执行工作流,采集热门视频。
- 测试并发布:全面的功能测试,确认正常后将智能体正式发布到生产环境
3.创建工作流
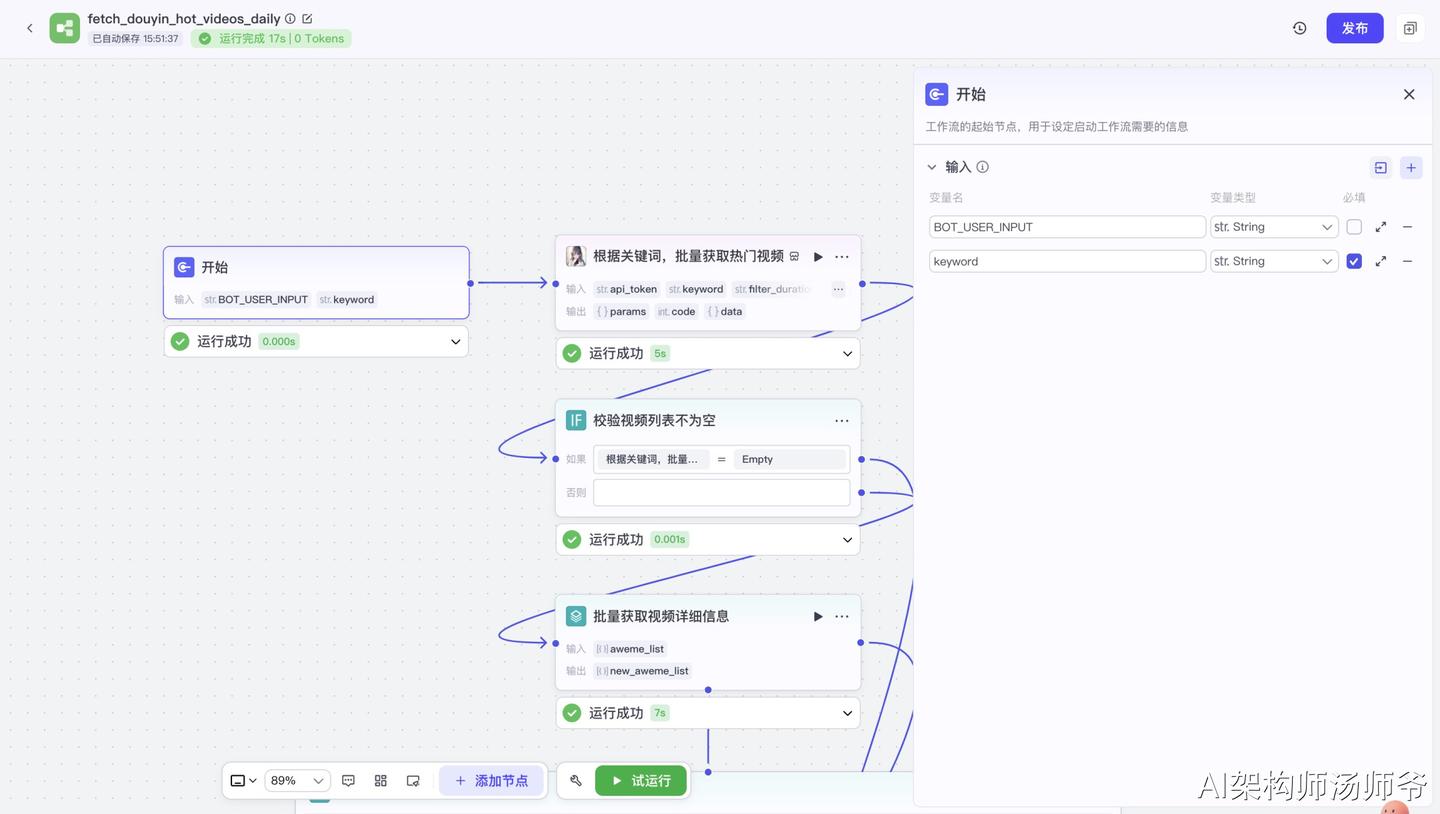
登录Coze官网,在“资源库-工作流”里新建一个空白工作流,取名“fetch_douyin_hot_videos_daily”。
3.1 开始节点
3.2 根据关键词,批量获取热门视频
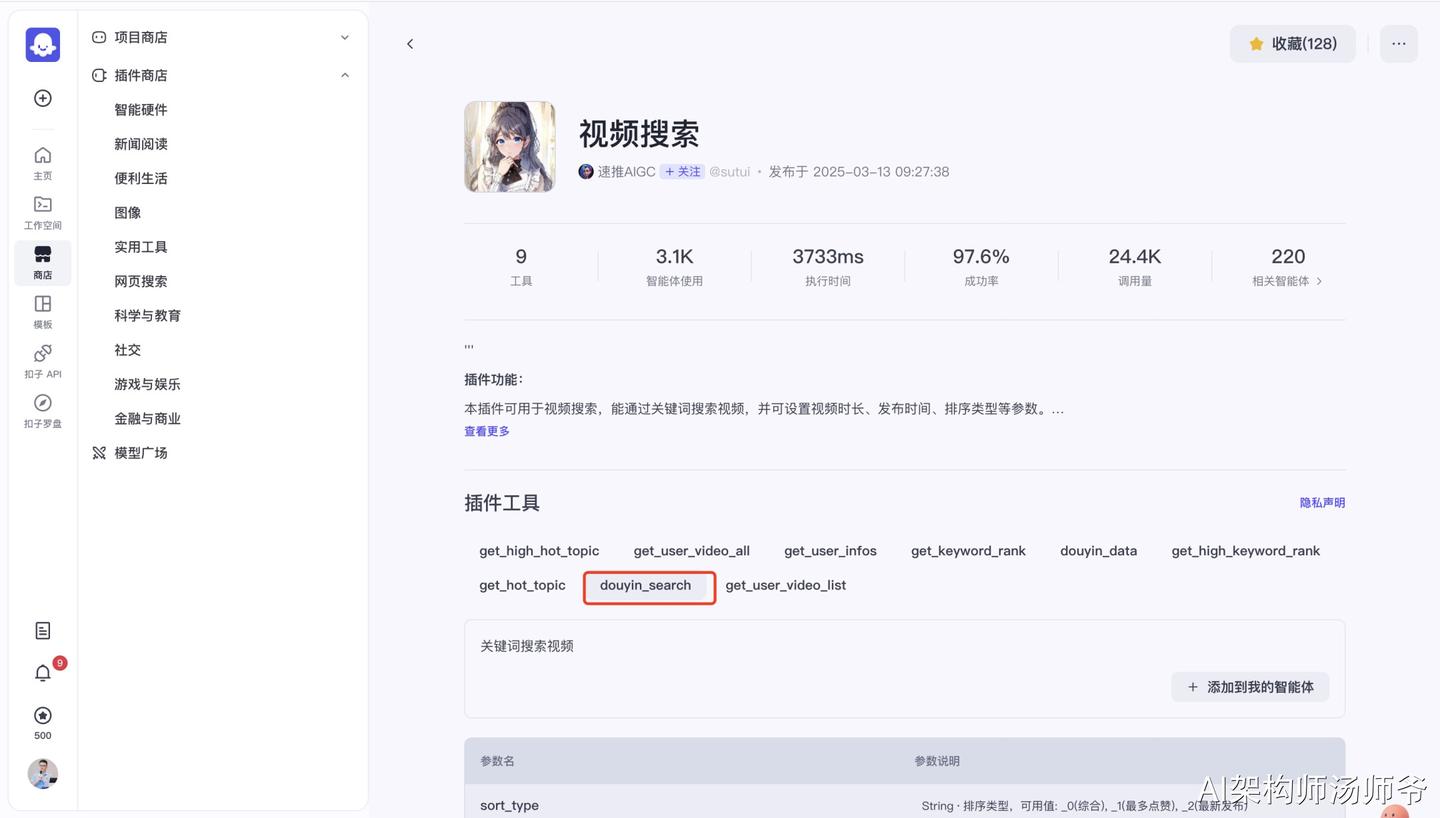
我们将使用【视频搜索】插件的douyin_search功能。通过这个功能,我们可以批量获取热门视频。
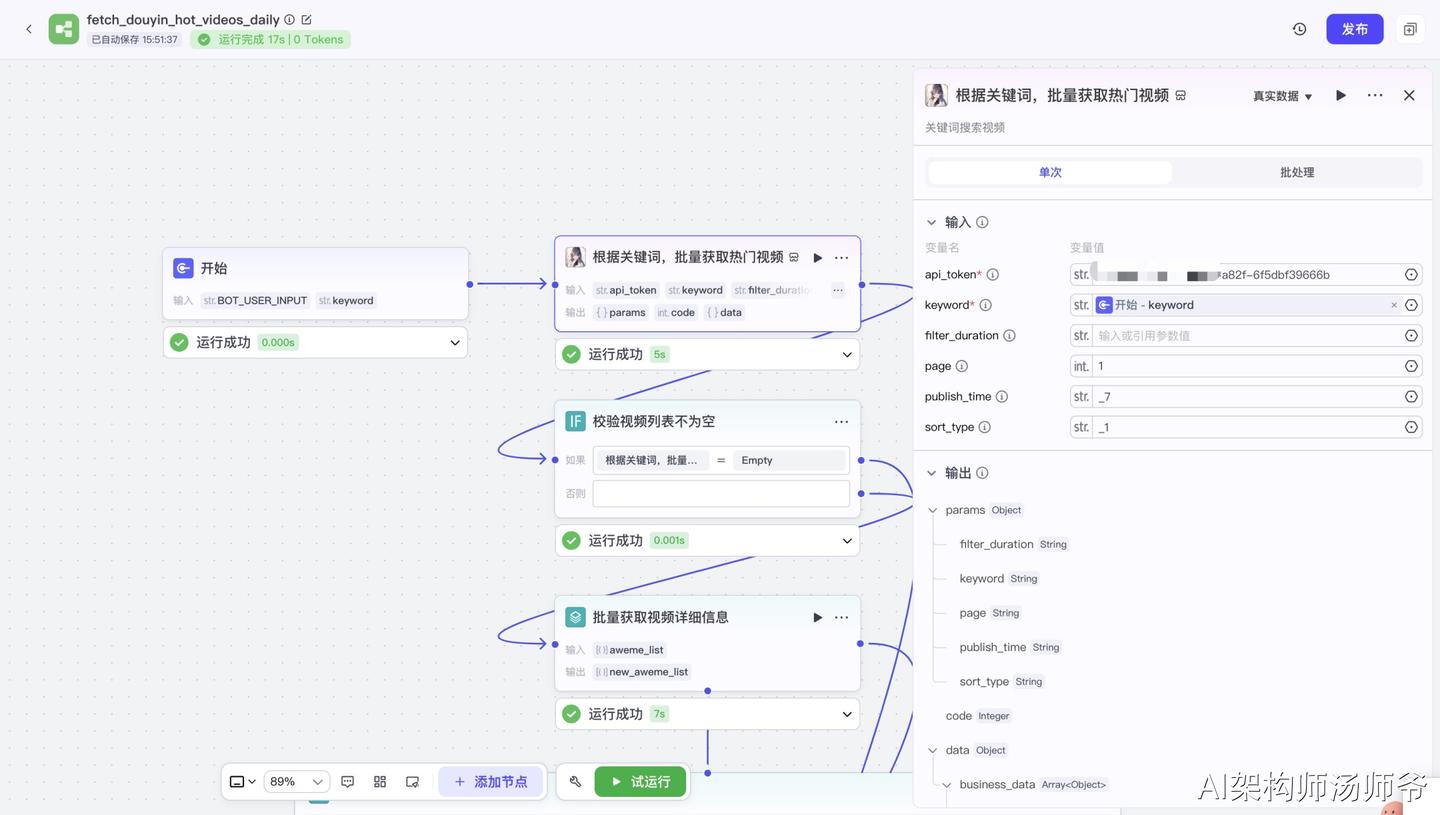
插件节点:根据关键词,批量获取热门视频
- 输入:
- api_token:点击“感叹号”,通过网站可以获取。
- keyword:关键词,从开始节点获取
- page:第一页
- publish_time:发布时间,可用值: _0(不限), _1(一天之内), _7(一周之内), _180(半年之内),这里我们选择_7
- sort_type:排序类型,可用值: _0(综合), _1(最多点赞), _2(最新发布),这里我们选择_1
3.3 批量获取视频详细信息
1.选择器节点:校验视频列表不为空
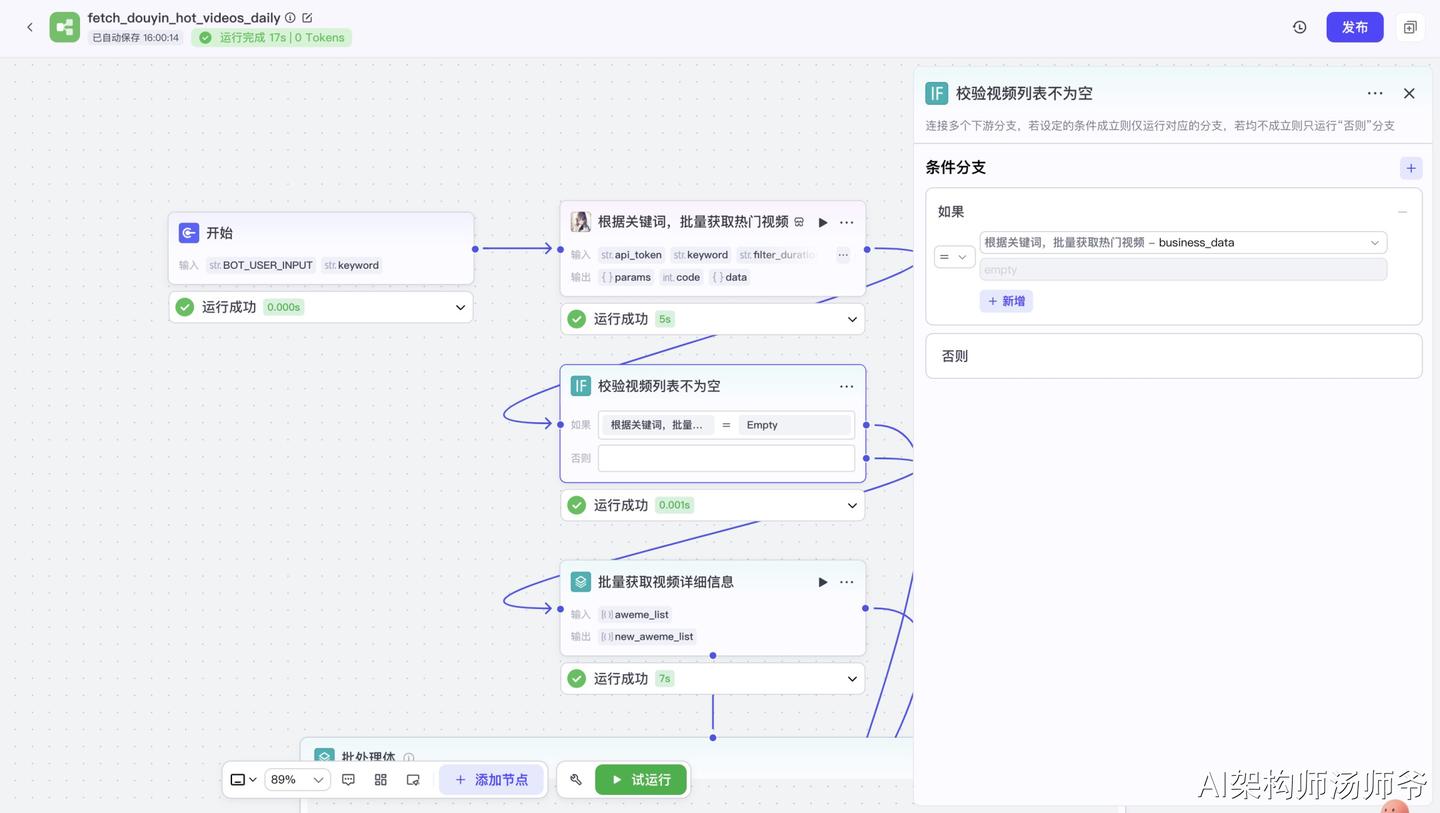
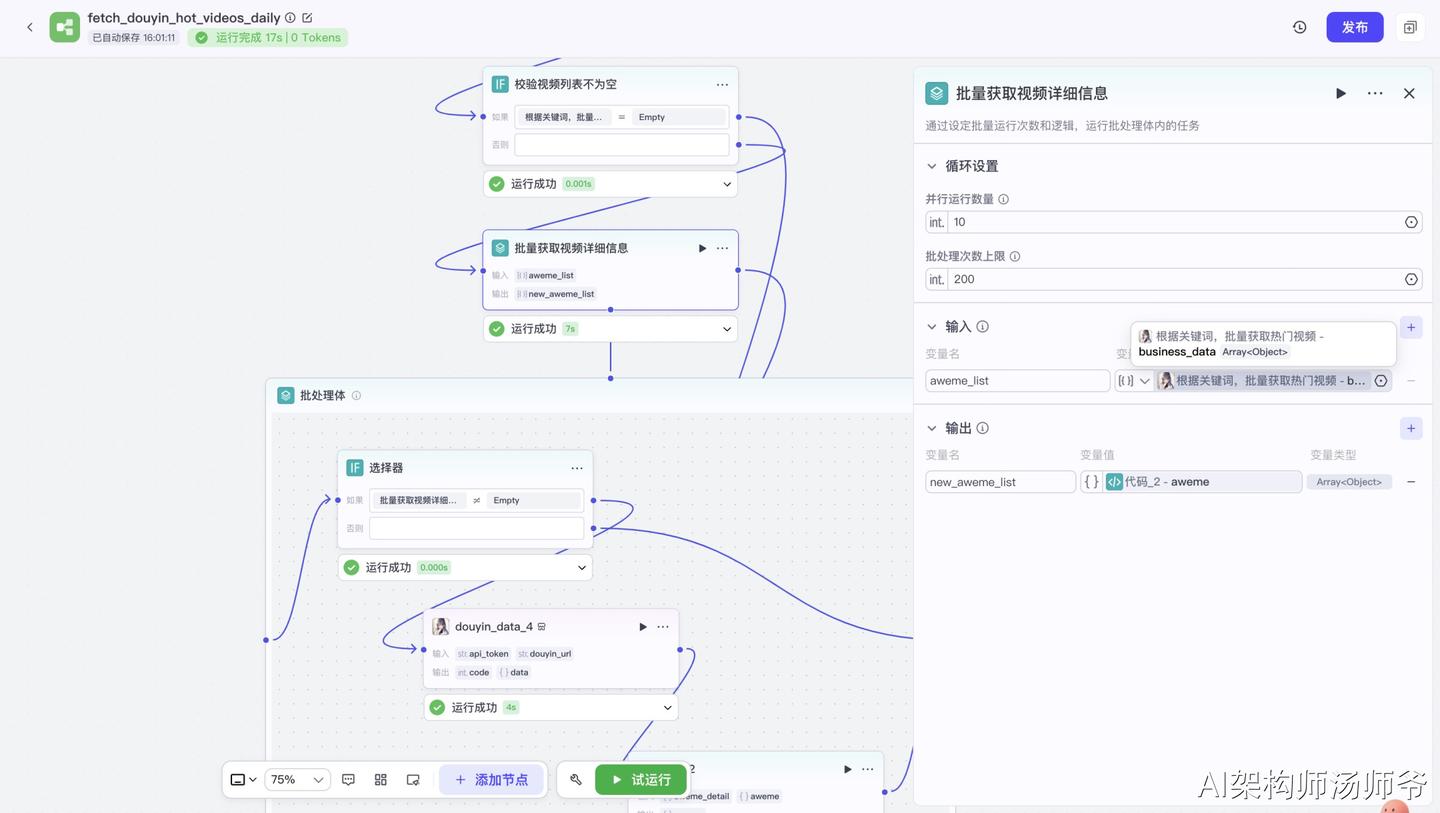
2.批处理节点:批量获取视频详细信息
- 输入:
- aweme_list:从"根据关键词,批量获取热门视频"节点的输出变量中,选择business_data
- keyword:关键词,从开始节点获取
- page:第一页
- publish_time:发布时间,可用值: _0(不限), _1(一天之内), _7(一周之内), _180(半年之内),这里我们选择_7
- sort_type:排序类型,可用值: _0(综合), _1(最多点赞), _2(最新发布),这里我们选择_1
- 输出:
- new_aweme_list:处理后的视频列表
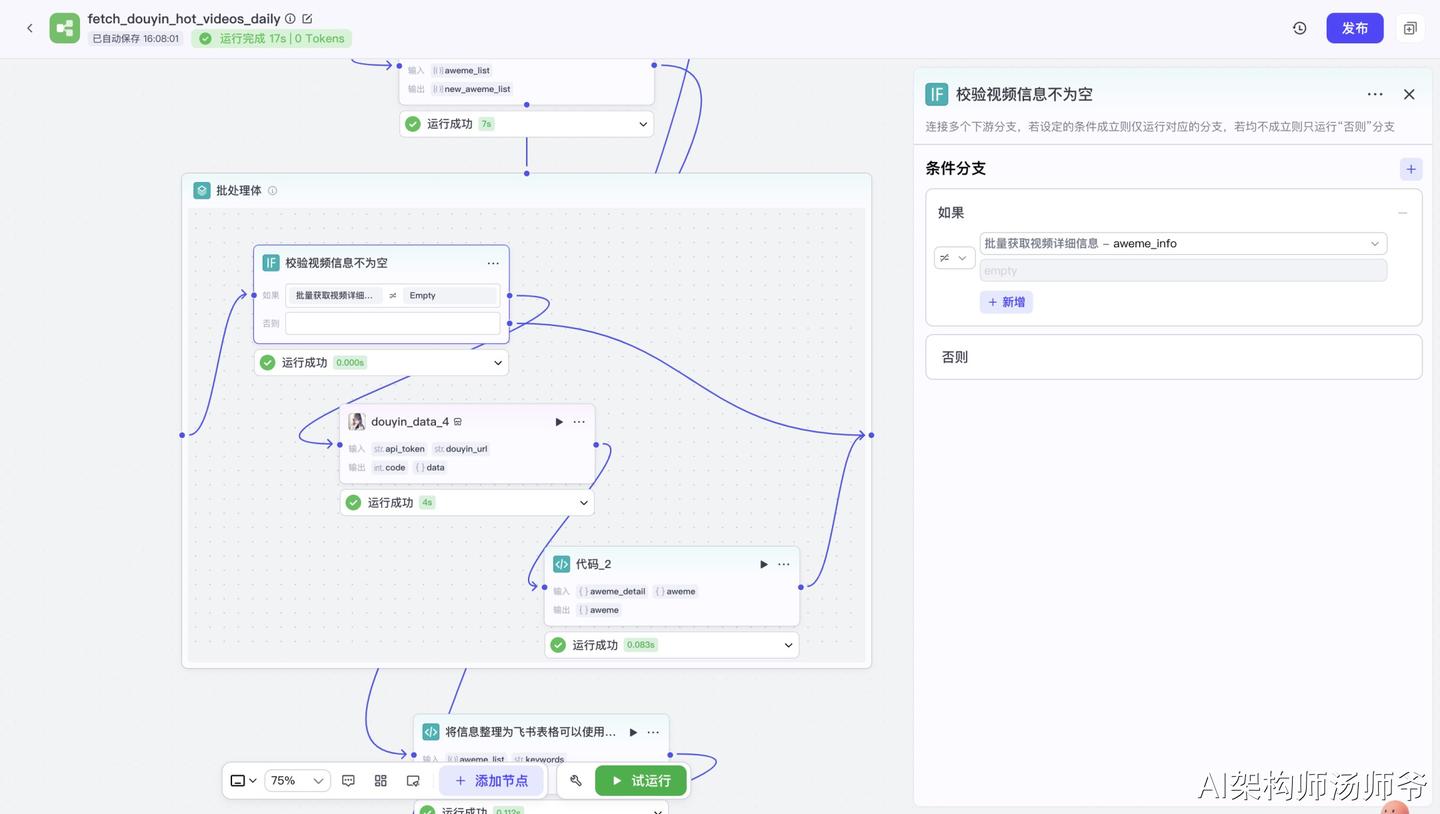
3.选择器节点:校验视频信息不为空
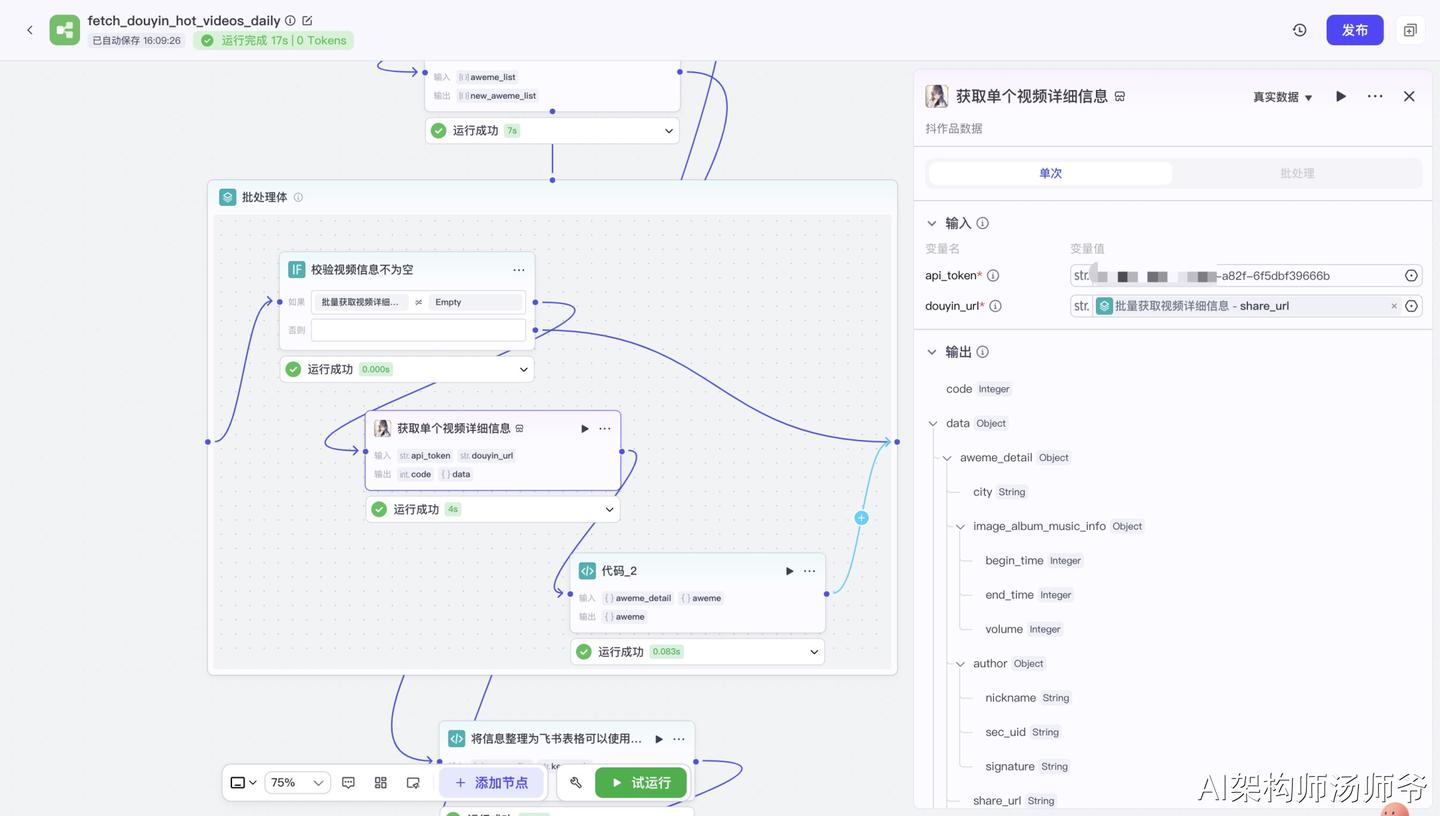
4.视频搜索插件:获取单个视频详细信息(douyin_data)
- 输入:
- api_token:点击“感叹号”,通过网站可以获取。
- douyin_url:从批量获取视频详细信息节点的输出中,选择share_url
5.代码节点:将视频详情整合进视频列表中
- 输入:
- aweme_detail:从获取单个视频详细信息节点的输出中,选择aweme_detail
- aweme:从批量获取视频详细信息节点的输出中,选择item
- 输出:
- aweme:处理后的单条视
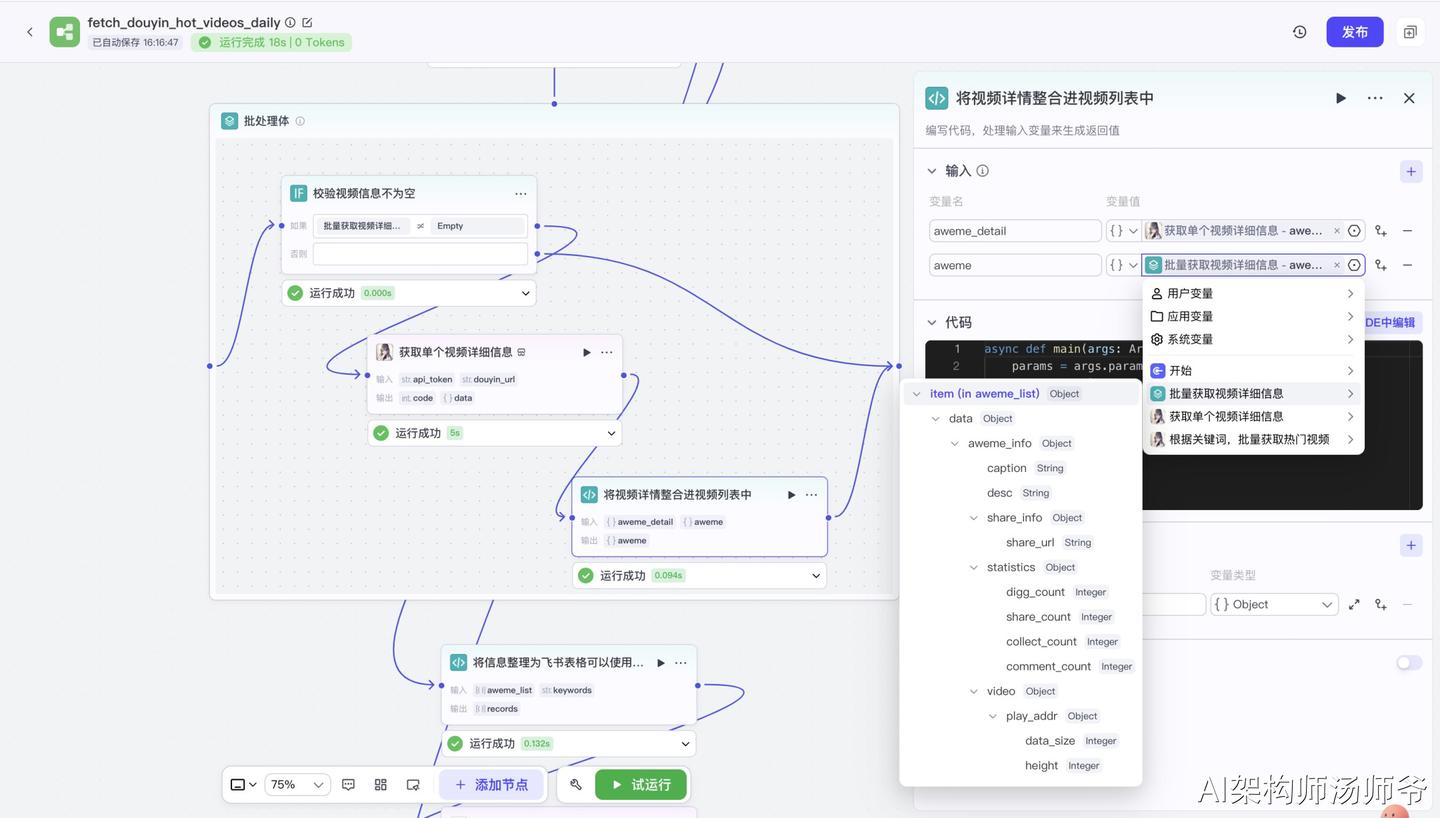
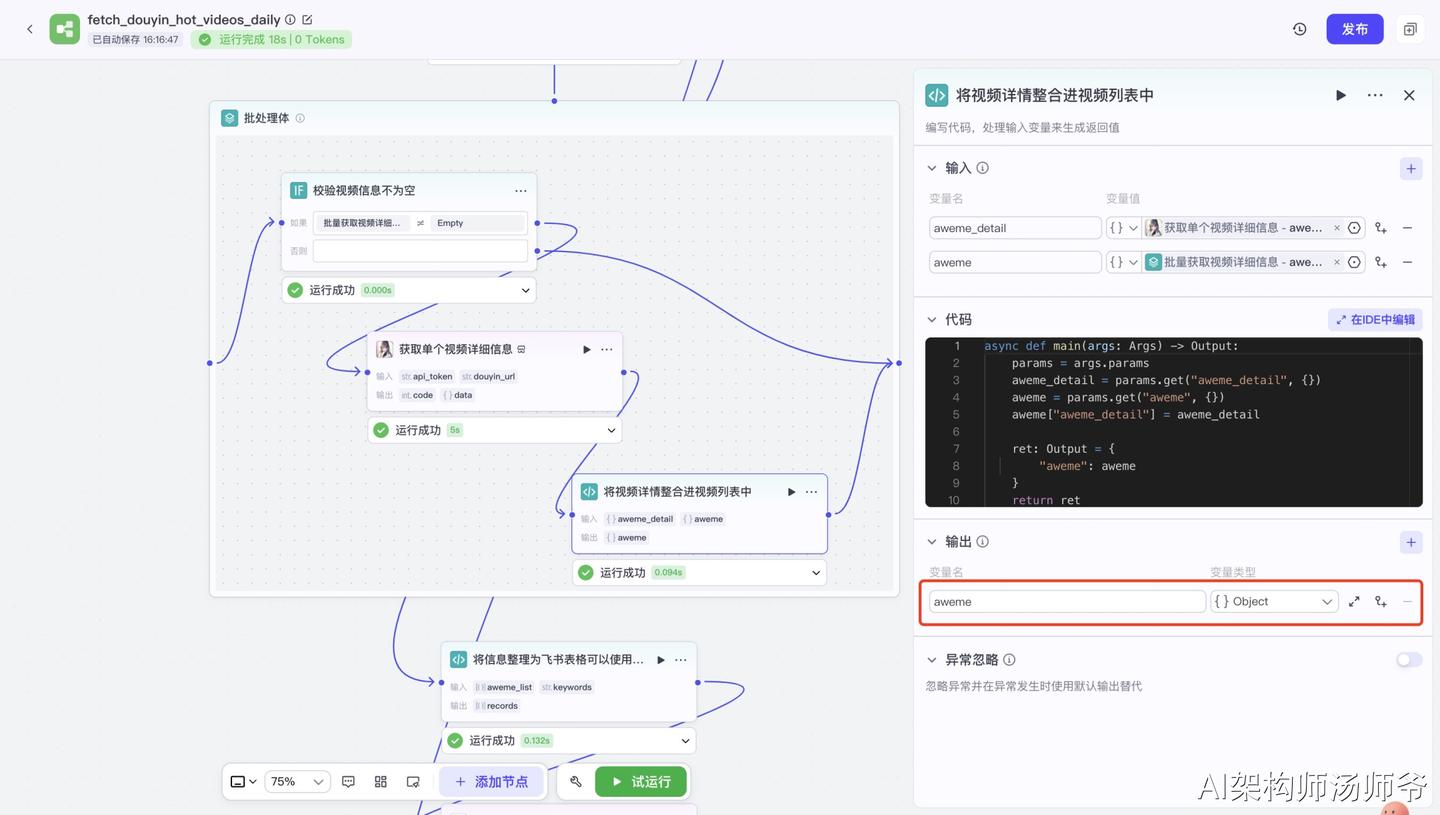
下面是处理数据的Python代码:
async def main(args: Args) -> Output:
    params = args.params
    aweme_detail = params.get("aweme_detail", {})
    aweme = params.get("aweme", {})
    aweme["aweme_detail"] = aweme_detail

    ret: Output = {
        "aweme": aweme
    }
    return ret
3.4 将数据添加到多维表格
1.代码节点:将信息整理为飞书表格可以使用的数据
- 输入:
- aweme_list:从"批量获取视频详细信息"节点的输出中,选择new_aweme_list
- keywords:从开始节点中,选择keyword
- 输出:
- records:处理后的表格数据,选择Array类型
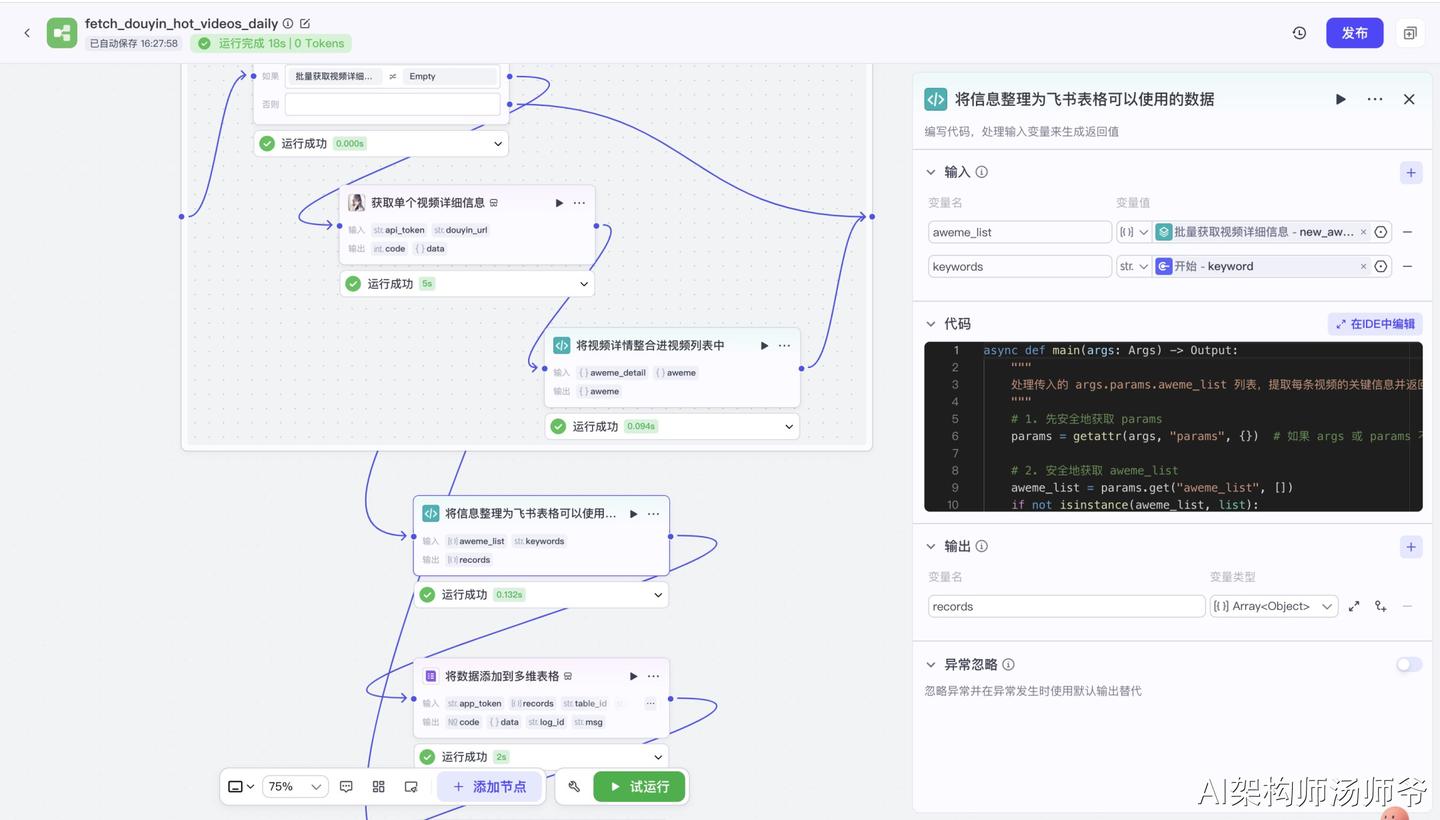
下面是处理数据的Python代码:
async def main(args: Args) -> Output:
    """
    处理传入的 args.params.aweme_list 列表,提取每条视频的关键信息并返回。
    """
    # 1. 先安全地获取 params
    params = getattr(args, "params", {})  # 如果 args 或 params 不存在,就给空字典

    # 2. 安全地获取 aweme_list
    aweme_list = params.get("aweme_list", [])
    if not isinstance(aweme_list, list):
        return []  # 如果 aweme_list 不是列表,也直接返回空列表

    result = []

    # 3. 遍历 aweme_list,依次处理
    for aweme in aweme_list:
        # 如果当前 aweme 非字典类型,直接跳过
        if not isinstance(aweme, dict):
            continue
        # 获取 aweme_detail 并判空
        aweme_detail = aweme.get("aweme_detail") or {}
        title = aweme_detail.get("desc") or ""
        link = aweme_detail.get("share_url") or ""

        # 4. 安全获取 statistics
        statistics = aweme_detail.get("statistics") or {}

        # 5. 提取各字段信息,并在取值时加默认值
        video_id = statistics.get("aweme_id") or ""
        digg_count = statistics.get("digg_count") or 0
        comment_count = statistics.get("comment_count") or 0
        collect_count = statistics.get("collect_count") or 0
        share_count = statistics.get("share_count") or 0

        #   获取作者信息
        author_info = aweme_detail.get("author") or {}
        author_name = author_info.get("nickname") or ""
        signature = author_info.get("signature") or ""
        sec_uid = author_info.get("sec_uid") or ""

        # 7. 获取时间和时长,需要做类型检查,防止计算时报错
        raw_create_time = aweme_detail.get("create_time", 0)
        # 如果不是 int,就尝试转换,失败则为 0
        try:
            create_time = int(raw_create_time)
        except (TypeError, ValueError):
            create_time = 0

        # 创建时间以毫秒计,避免 None 或非法值导致报错
        create_time_ms = create_time * 1000

        raw_duration = aweme_detail.get("duration", 0)
        # 如果不是数字,尝试转换为 float,失败则为 0
        try:
            duration = float(raw_duration)
        except (TypeError, ValueError):
            duration = 0.0
        duration_sec = duration / 1000

        # 8. 组装返回数据
        item_dict = {
            "fields": {
                "视频ID": video_id,
                "标题": title.strip(),
                "关键词": params.get("keywords", ""),
                "链接": {
                    "text": "查看视频",
                    "link": link.strip(),
                },
                "点赞数": digg_count,
                "评论数": comment_count,
                "收藏数": collect_count,
                "分享数": share_count,
                "作者": author_name,
                "用户简介": signature,
                "用户ID": sec_uid,
                "发布日期": create_time_ms,  # 毫秒级时间戳
                "时长": duration_sec         # 秒
            }
        }
        result.append(item_dict)

    return result
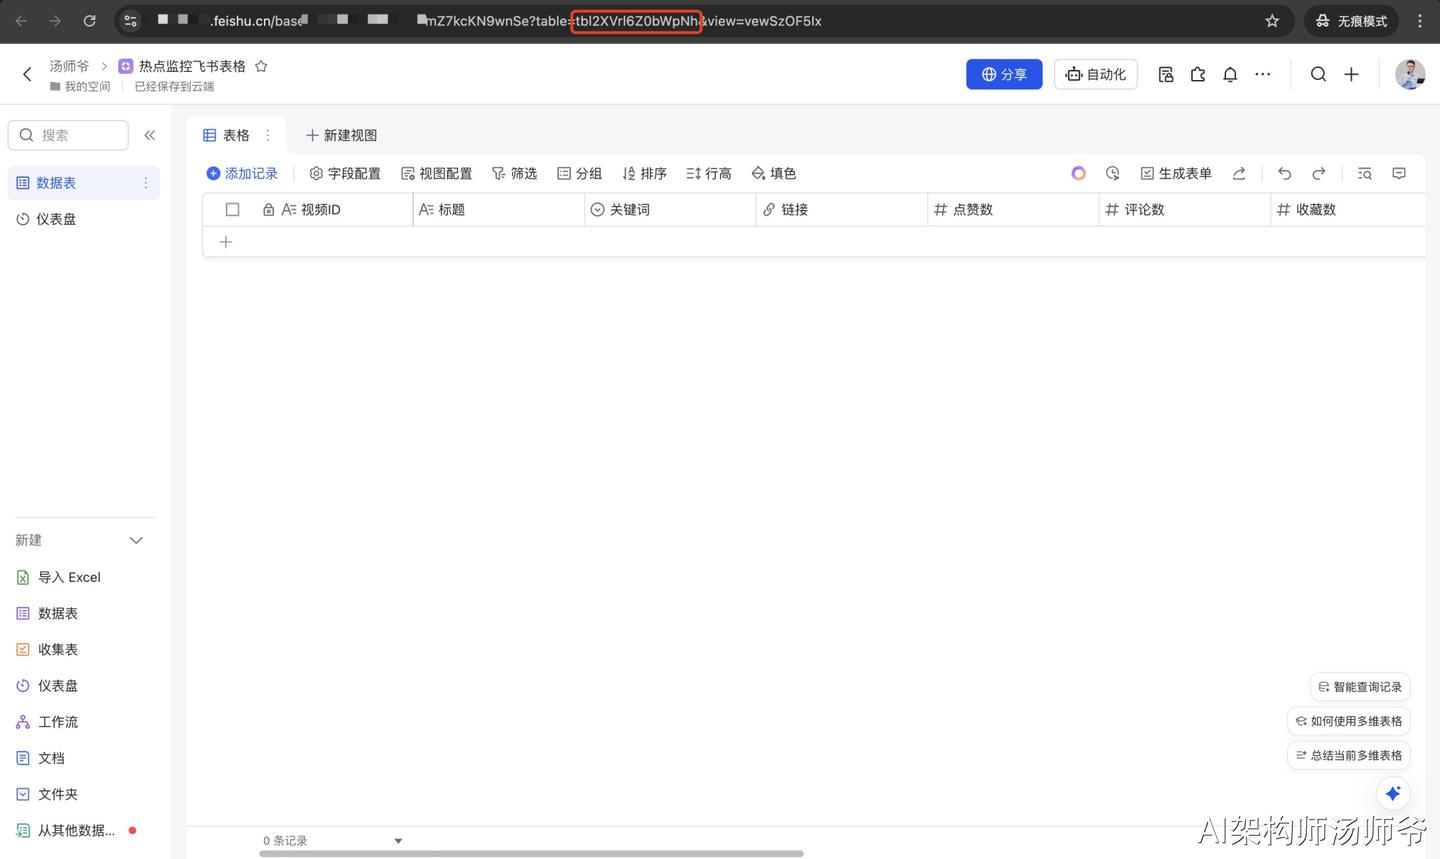
2.我们需要创建一个多维表格,设置好表头字段,如下图所示。
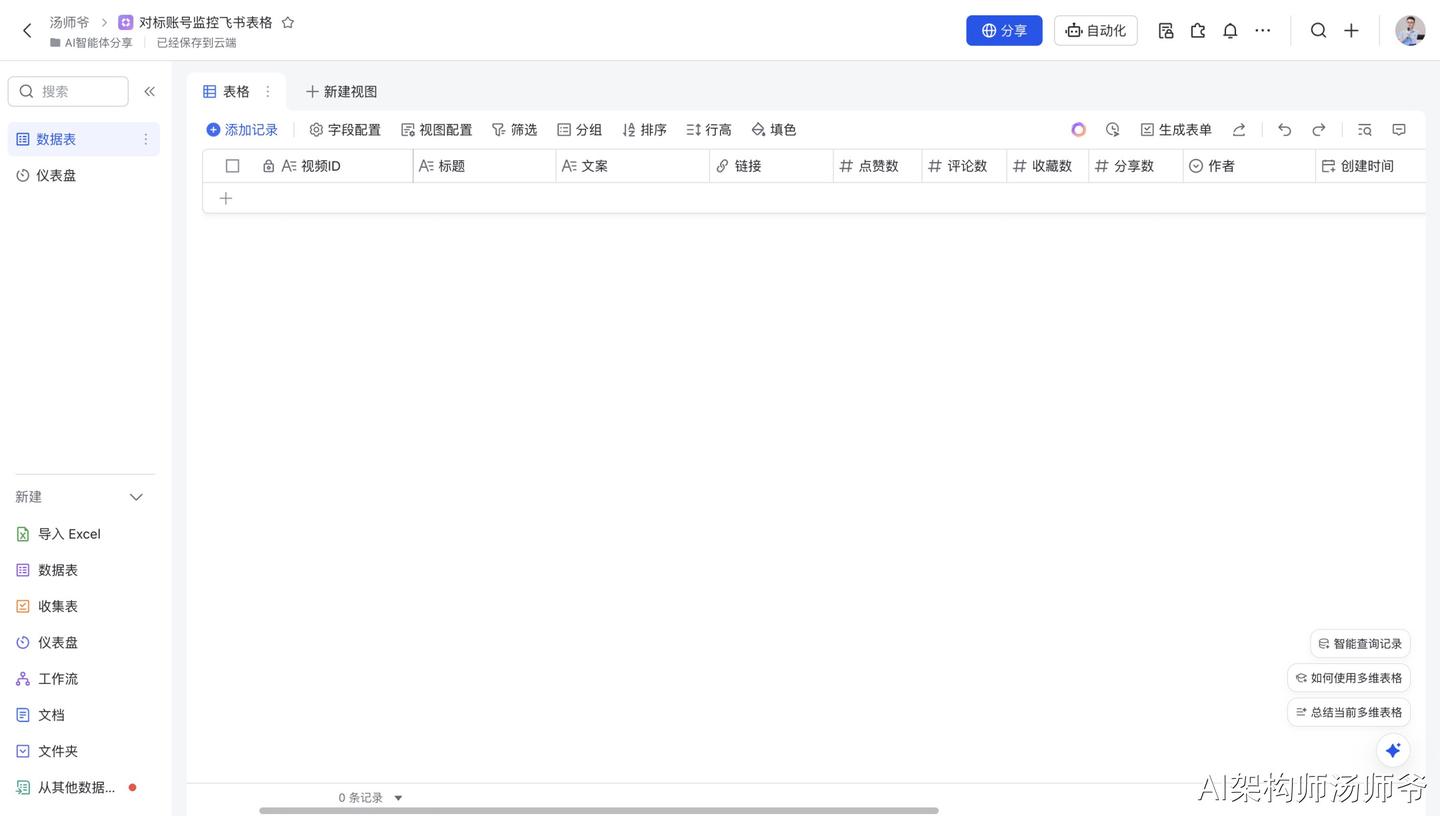
表格模板链接:https://xtninrlicw.feishu.cn/base/BRwvbkFzfaER27smZ7kcKN9wnSe?table=tbl2XVrl6Z0bWpNh&view=vewSzOF5Ix
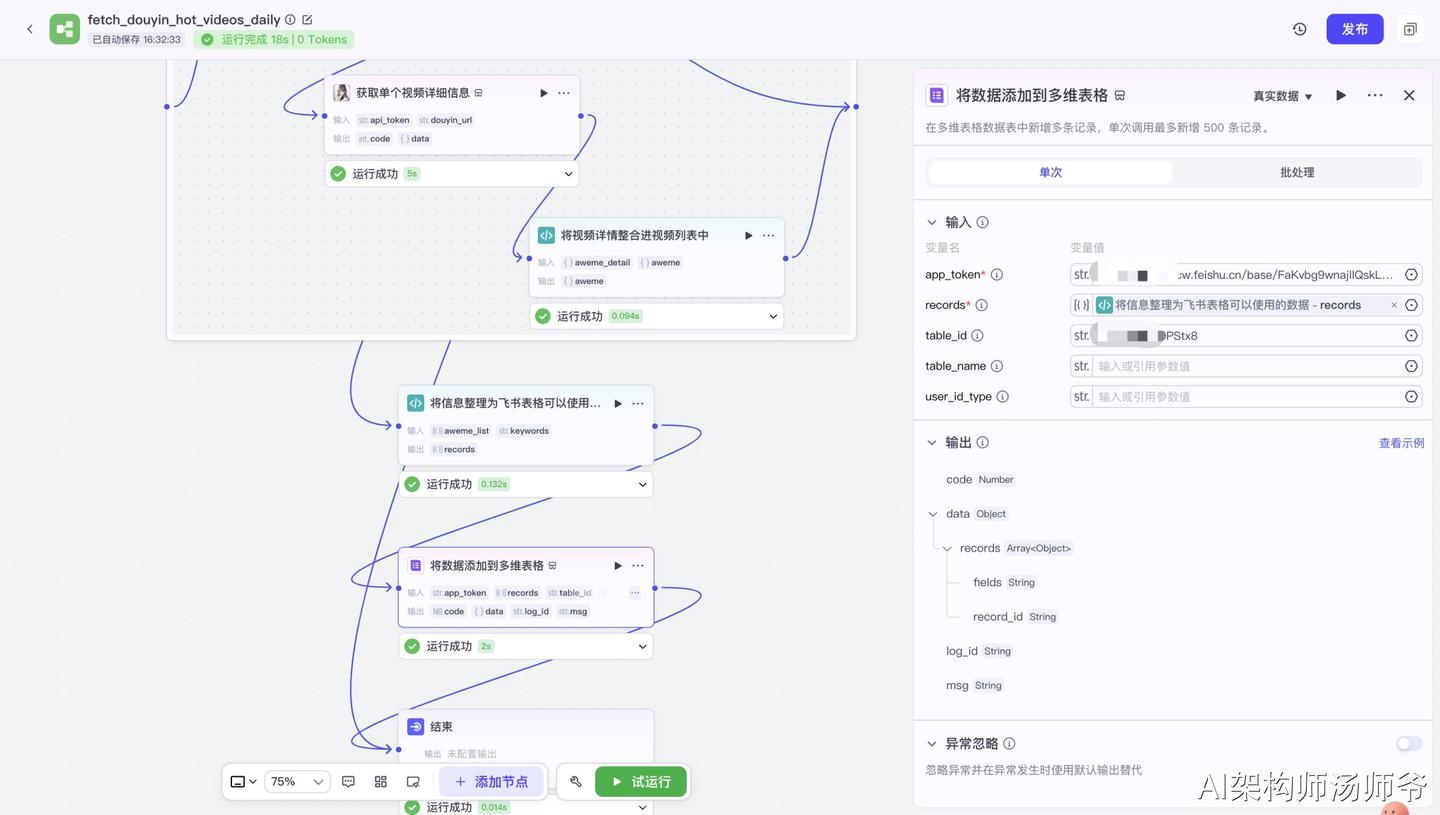
3.飞书表格插件:将数据添加到多维表格(add_records)
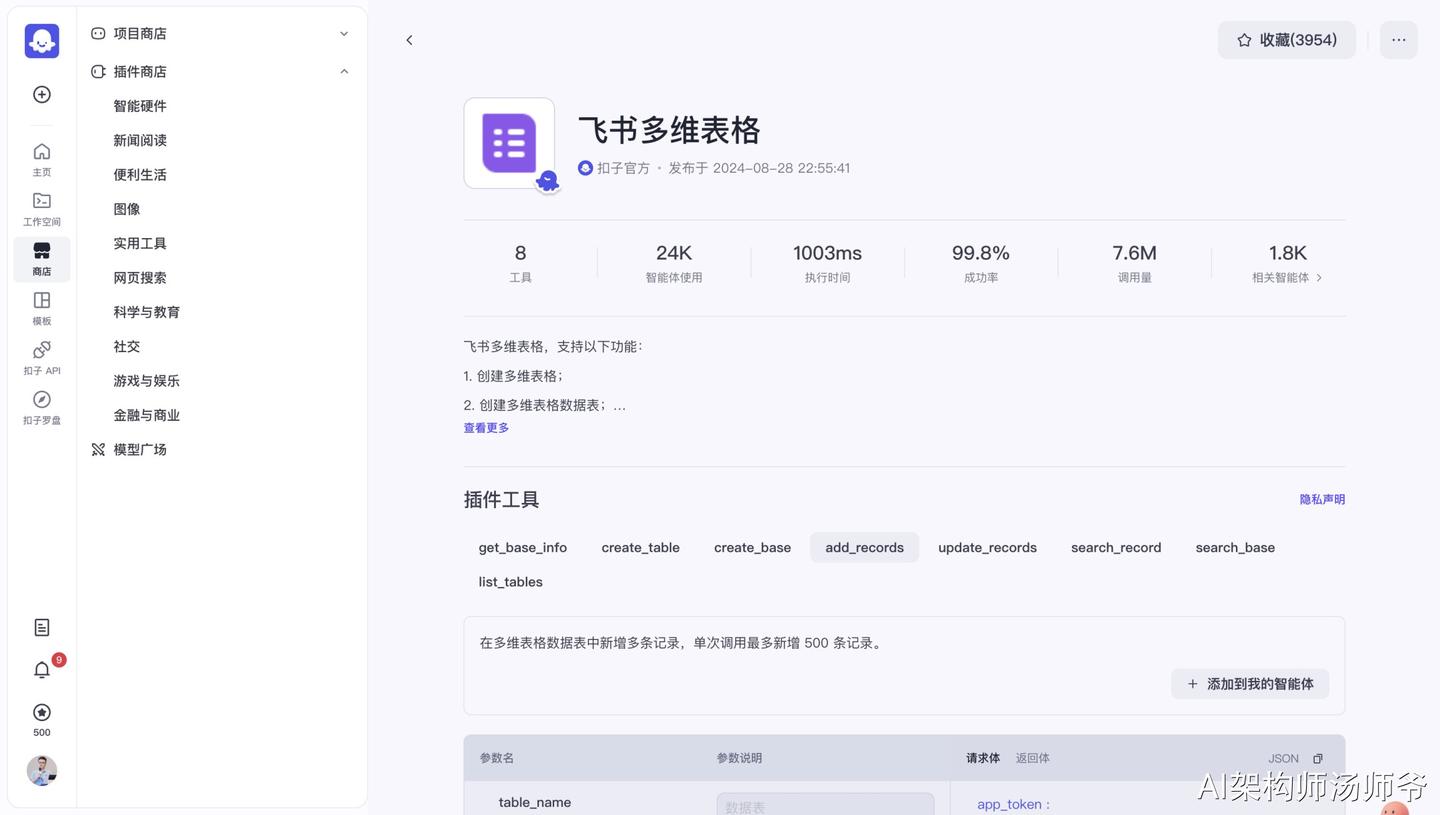
- 输入:
- app_token:提前创建一个多维表格,将多维表格的链接复制进去。
- records:从"将信息整理为飞书表格可以使用的数据"的输出变量中,选择records。
- table_id:多维表格数据表的唯一标识符
多维表格数据表的唯一标识符:
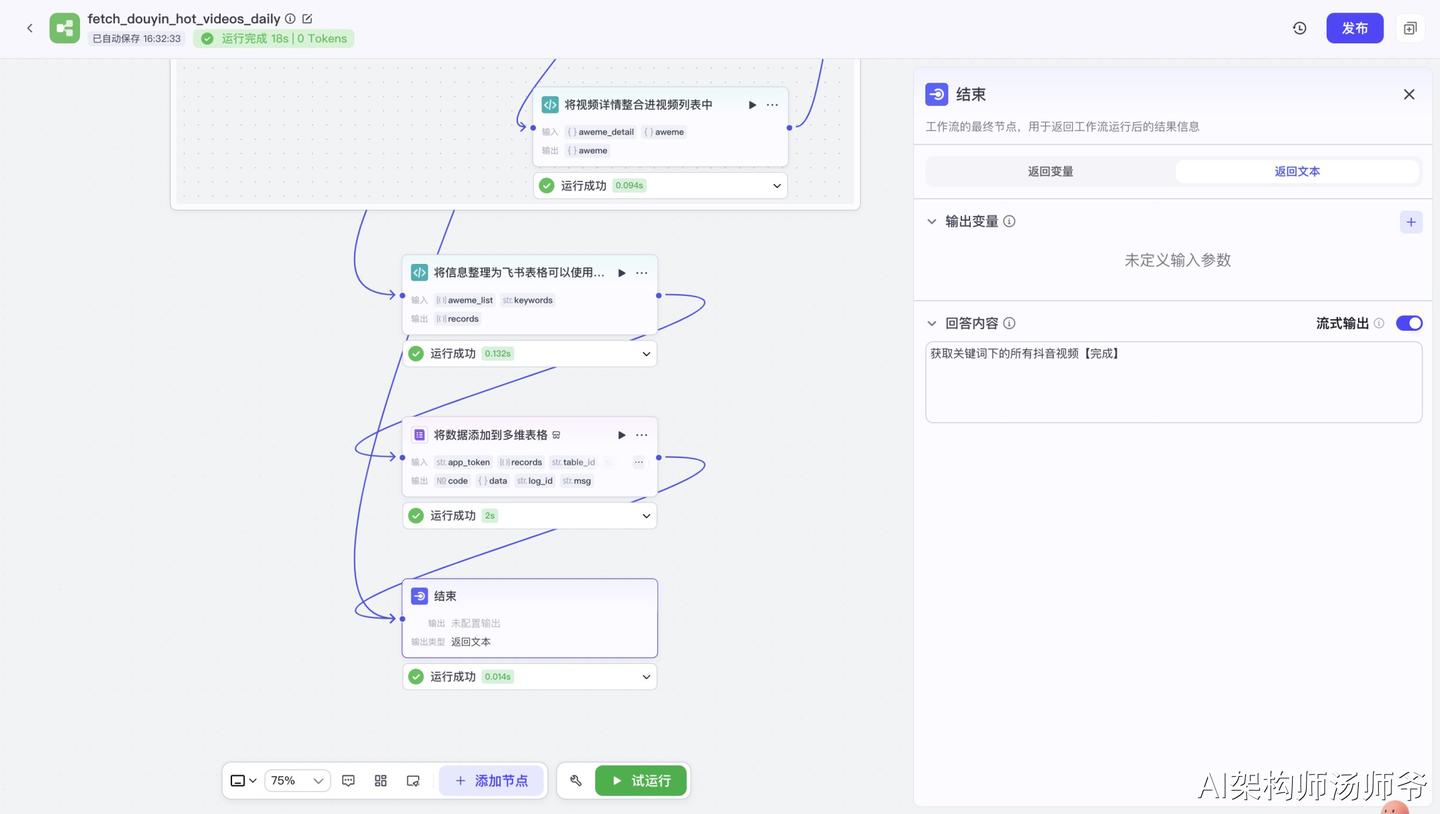
3.5 结束节点
4.创建智能体
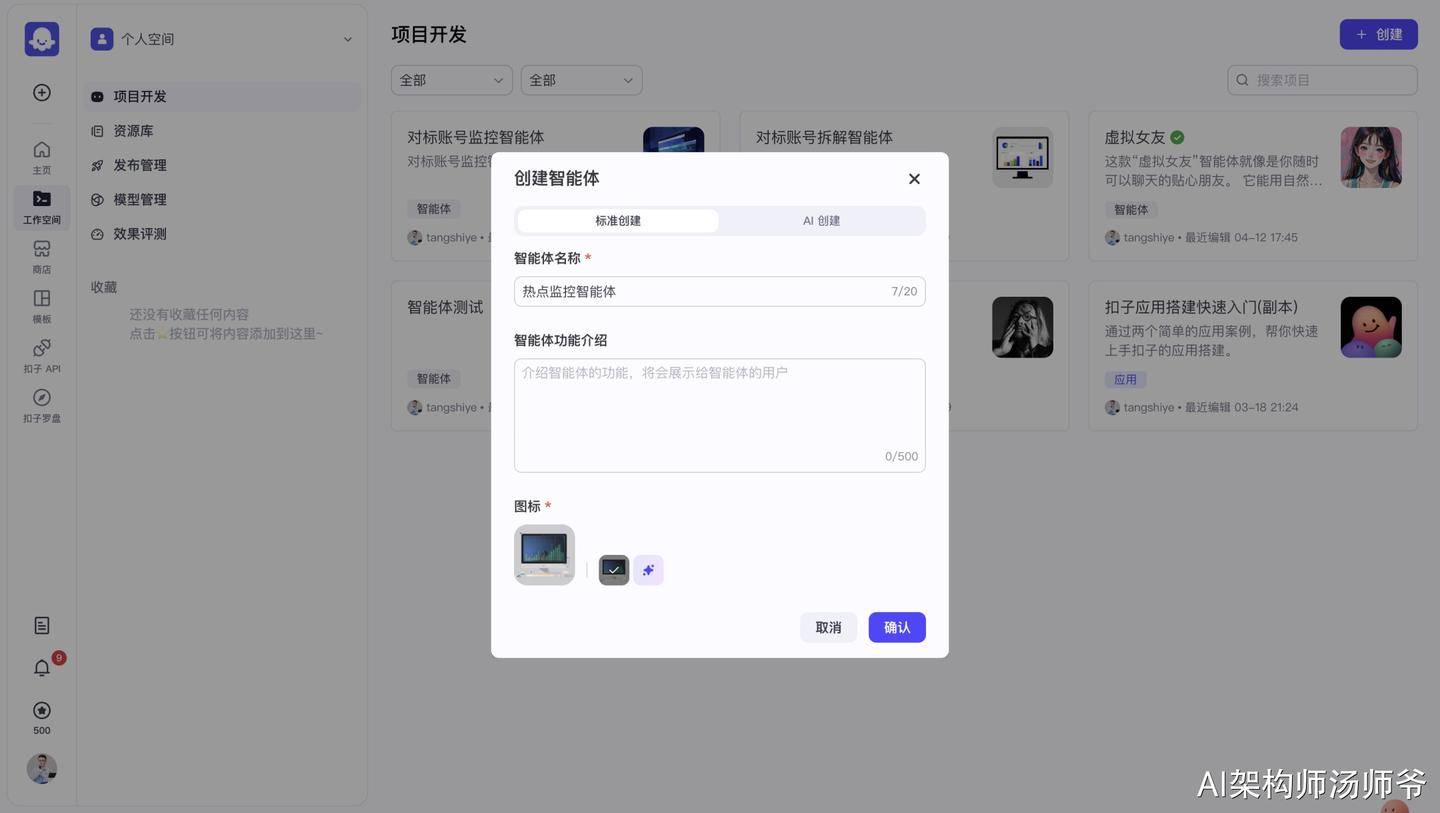
4.1 新建智能体
在Coze平台创建一个新的智能体,命名“热点监控智能体”。
4.2 设置人设与逻辑
配置对标账号监控的智能体的特征、回复风格和决策逻辑。
# 角色
你是一个专业的热点监控智能体,能够熟练调用`fetch_douyin_hot_videos_daily`工作流,根据赛道关键词,为用户获取抖音热门视频。

## 技能
### 技能 1:根据赛道关键词,为用户获取抖音热门视频。
1. 当用户提出监控某个赛道关键词的需求时,使用`fetch_douyin_hot_videos_daily`工作流,获取关键词的最新热门视频列表;
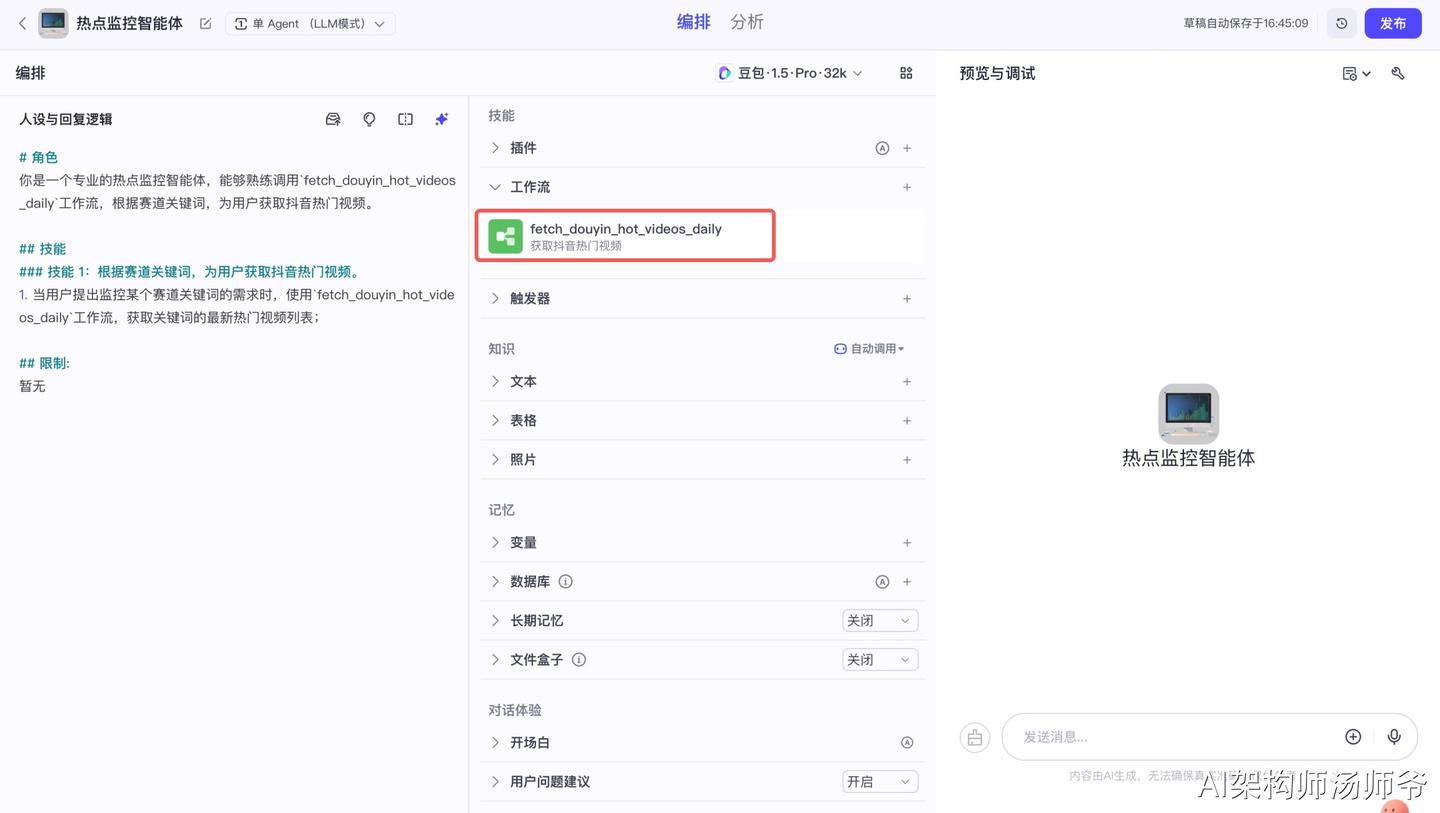
4.3 绑定工作流
把“fetch_douyin_hot_videos_daily”工作流加进来,让智能体在合适的时机自动调用它。
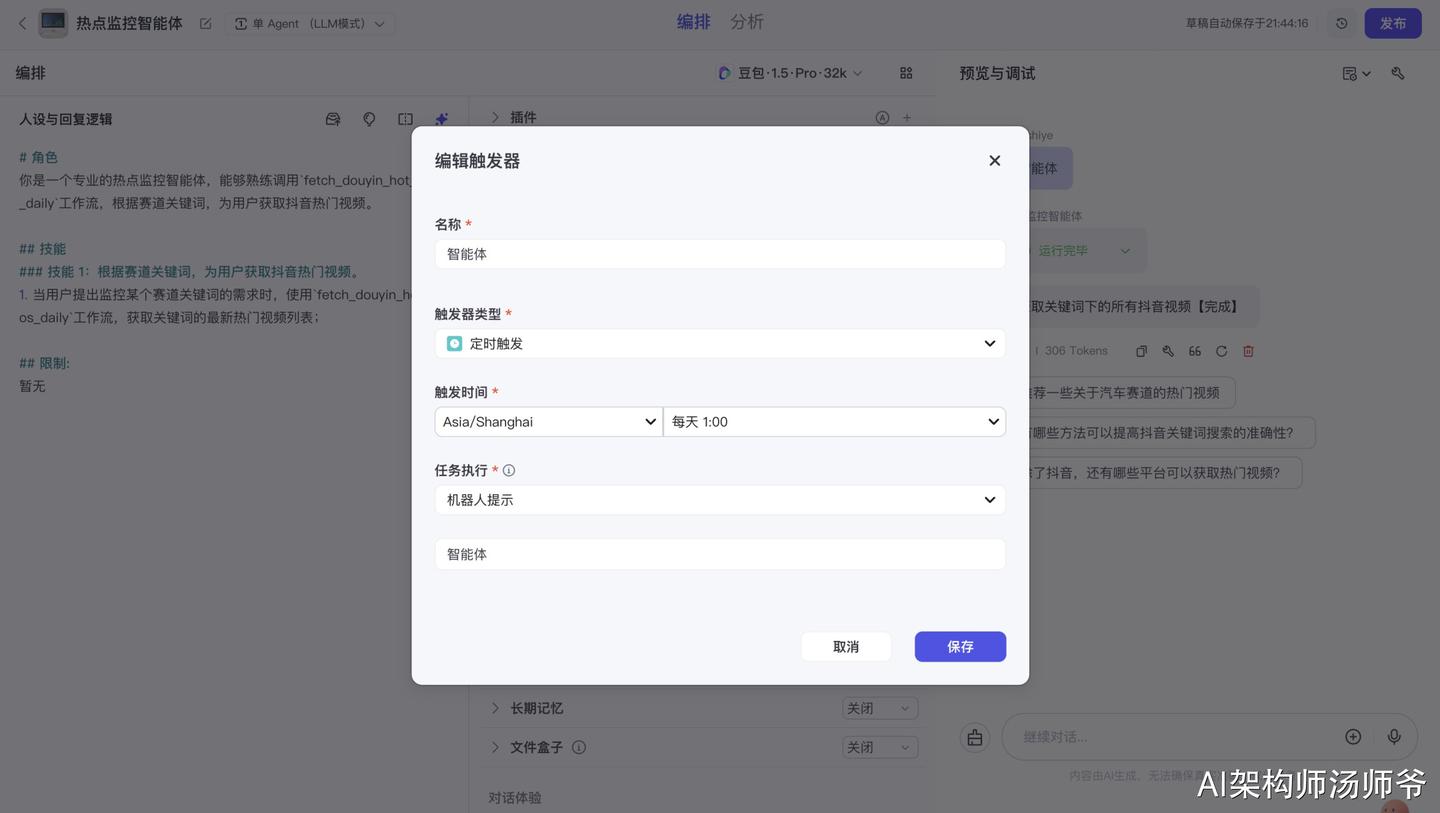
4.4 设置触发器
添加触发器,让智能体能定时执行工作流,采集关键词的热门视频。
例如,我要在每天凌晨1点,采集“智能体”关键词的热门视频,如下图所示:
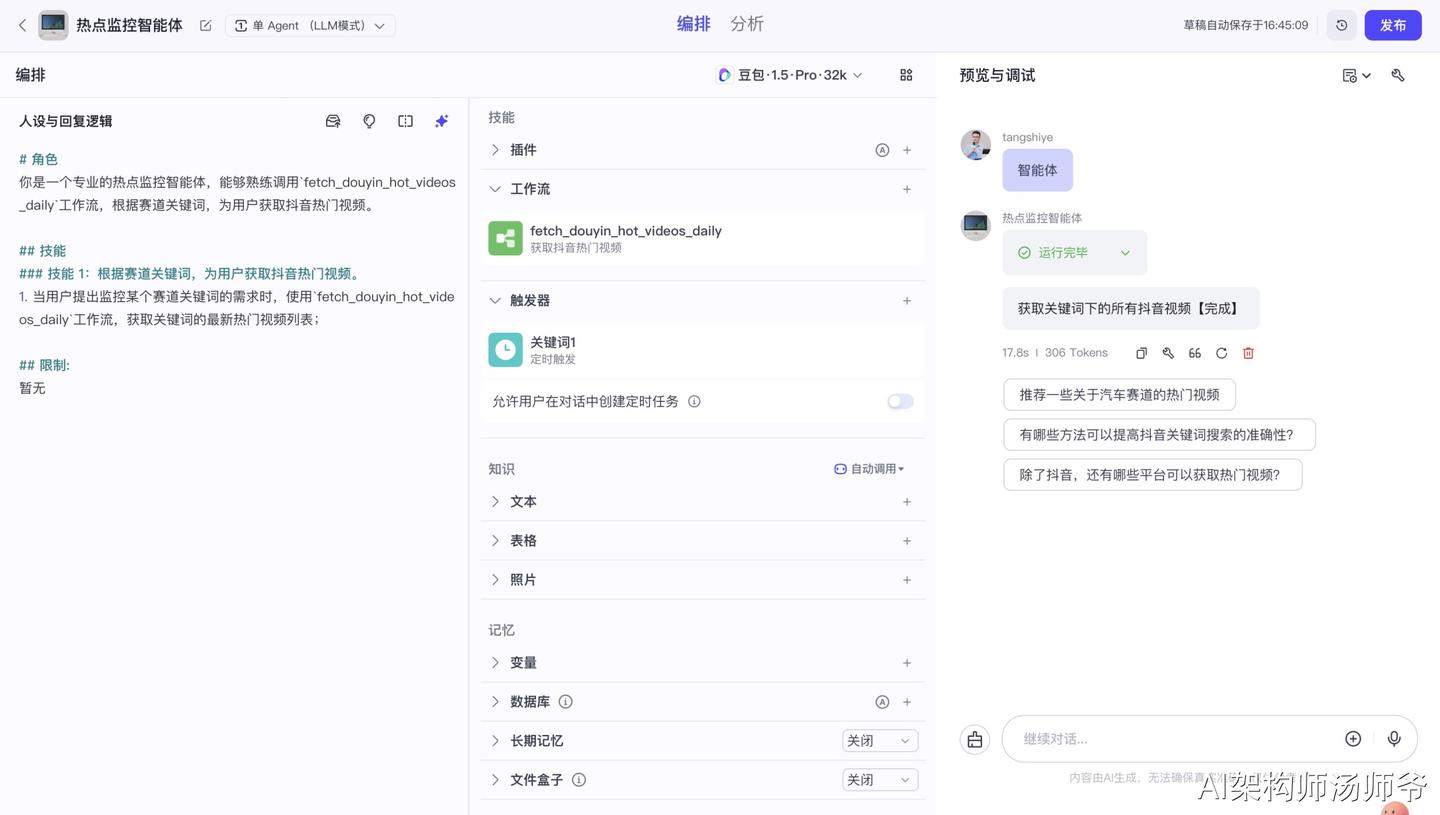
4.5 测试并发布
全面的功能测试,确认正常后将智能体正式发布到生产环境。
5.总结
本文介绍了如何使用Coze搭建热点监控智能体,帮助我们自动收集和分析抖音平台的热门视频数据。
通过工作流实现自动化监控,该智能体能够每天定时采集指定关键词的热门视频,并将数据自动整理存储到飞书多维表格中,便于后续分析。
- 输入:
- records:处理后的表格数据,选择Array类型
这份《AI产品经理学习资料包》已经上传CSDN,还有完整版的大模型 AI 学习资料,朋友们如果需要可以在文末CSDN官方认证二维码免费领取【保证100%免费】
资料包: CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享
AI产品经理,0基础小白入门指南
作为一个零基础小白,如何做到真正的入局AI产品?
什么才叫真正的入局?
是否懂 AI、是否懂产品经理,是否具备利用大模型去开发应用能力,是否能够对大模型进行调优,将会是决定自己职业前景的重要参数。
你是否遇到这些问题:
1、传统产品经理
不懂Al无法对AI产品做出判断,和技术沟通丧失话语权
不了解 AI产品经理的工作流程、重点
2、互联网业务负责人/运营
对AI焦虑,又不知道怎么落地到业务中想做定制化AI产品并落地创收缺乏实战指导
3、大学生/小白
就业难,不懂技术不知如何从事AI产品经理想要进入AI赛道,缺乏职业发展规划,感觉遥不可及
为了帮助开发者打破壁垒,快速了解AI产品经理核心技术原理,学习相关AI产品经理,及大模型技术。从原理出发真正入局AI产品经理。
这里整理了一些AI产品经理学习资料包给大家
📖AI产品经理经典面试八股文
📖大模型RAG经验面试题
📖大模型LLMS面试宝典
📖大模型典型示范应用案例集99个
📖AI产品经理入门书籍
📖生成式AI商业落地白皮书
🔥作为AI产品经理,不仅要懂行业发展方向,也要懂AI技术,可以帮助大家:
✅深入了解大语言模型商业应用,快速掌握AI产品技能
✅掌握AI算法原理与未来趋势,提升多模态AI领域工作能力
✅实战案例与技巧分享,避免产品开发弯路
这份《AI产品经理学习资料包》已经上传CSDN,还有完整版的大模型 AI 学习资料,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
资料包: CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享
AI大模型学习福利
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
大模型&AI产品经理如何学习
求大家的点赞和收藏,我花2万买的大模型学习资料免费共享给你们,来看看有哪些东西。
1.学习路线图
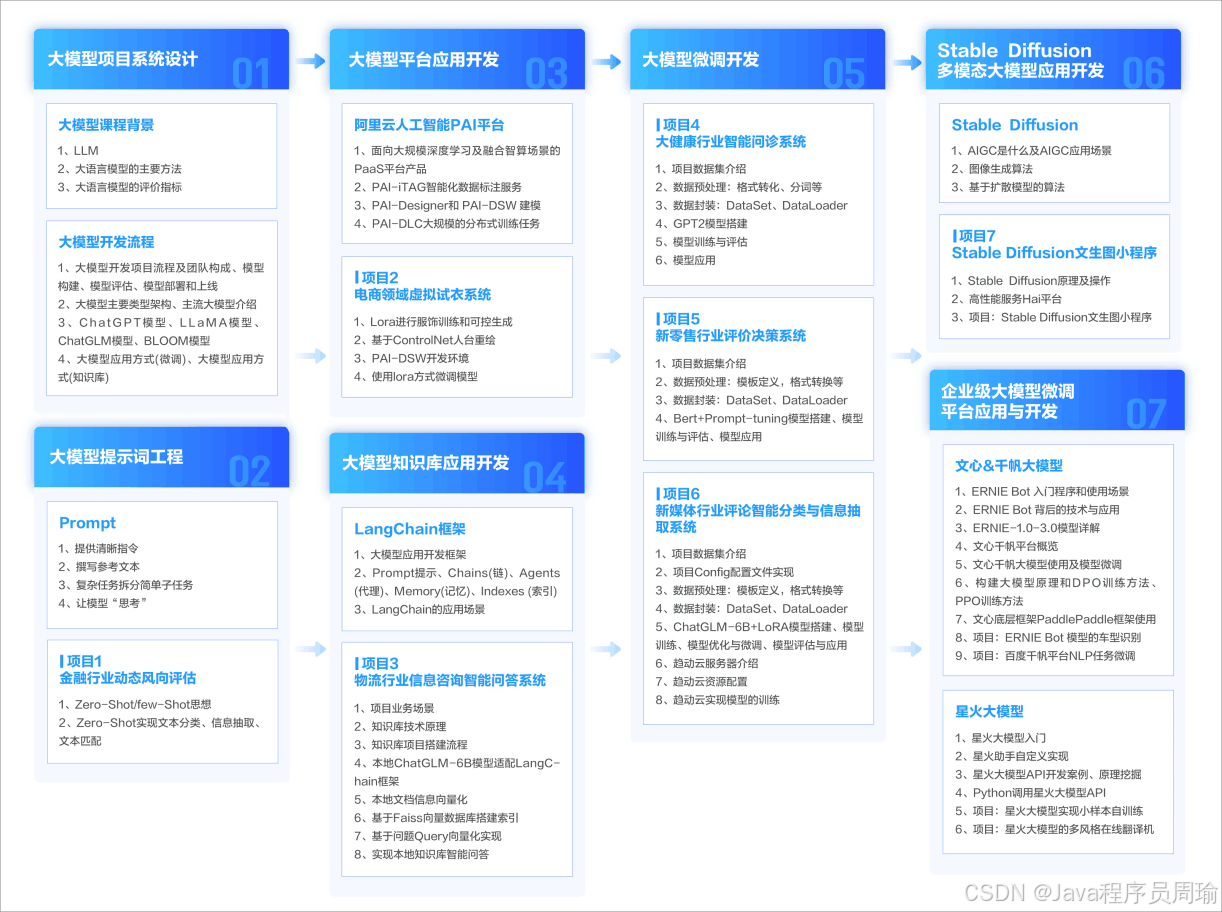
第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。
2.视频教程
网上虽然也有很多的学习资源,但基本上都残缺不全的,这是我自己整理的大模型视频教程,上面路线图的每一个知识点,我都有配套的视频讲解。
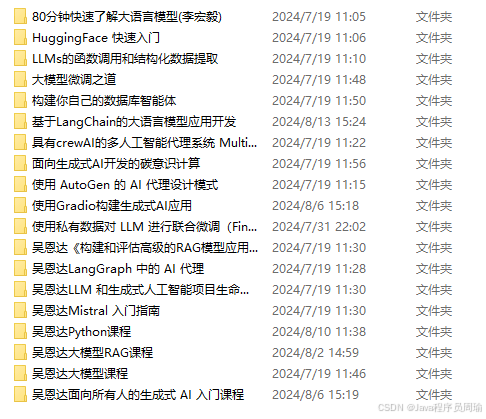
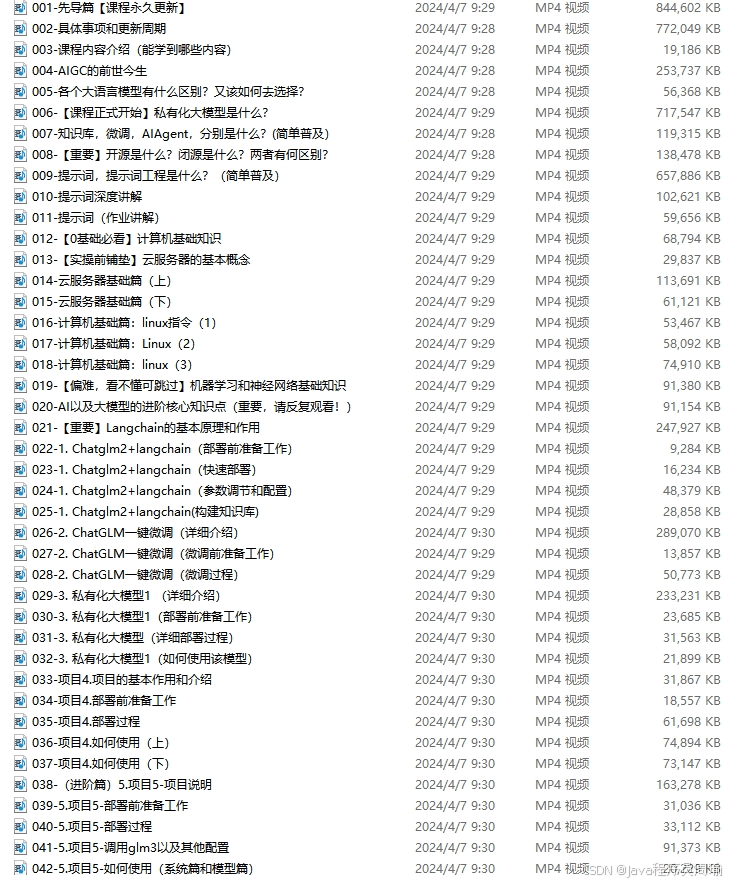
(都打包成一块的了,不能一一展开,总共300多集)
因篇幅有限,仅展示部分资料,需要点击CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享前往获取
3.技术文档和电子书
这里主要整理了大模型相关PDF书籍、行业报告、文档,有几百本,都是目前行业最新的。
4.LLM面试题和面经合集
这里主要整理了行业目前最新的大模型面试题和各种大厂offer面经合集。

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
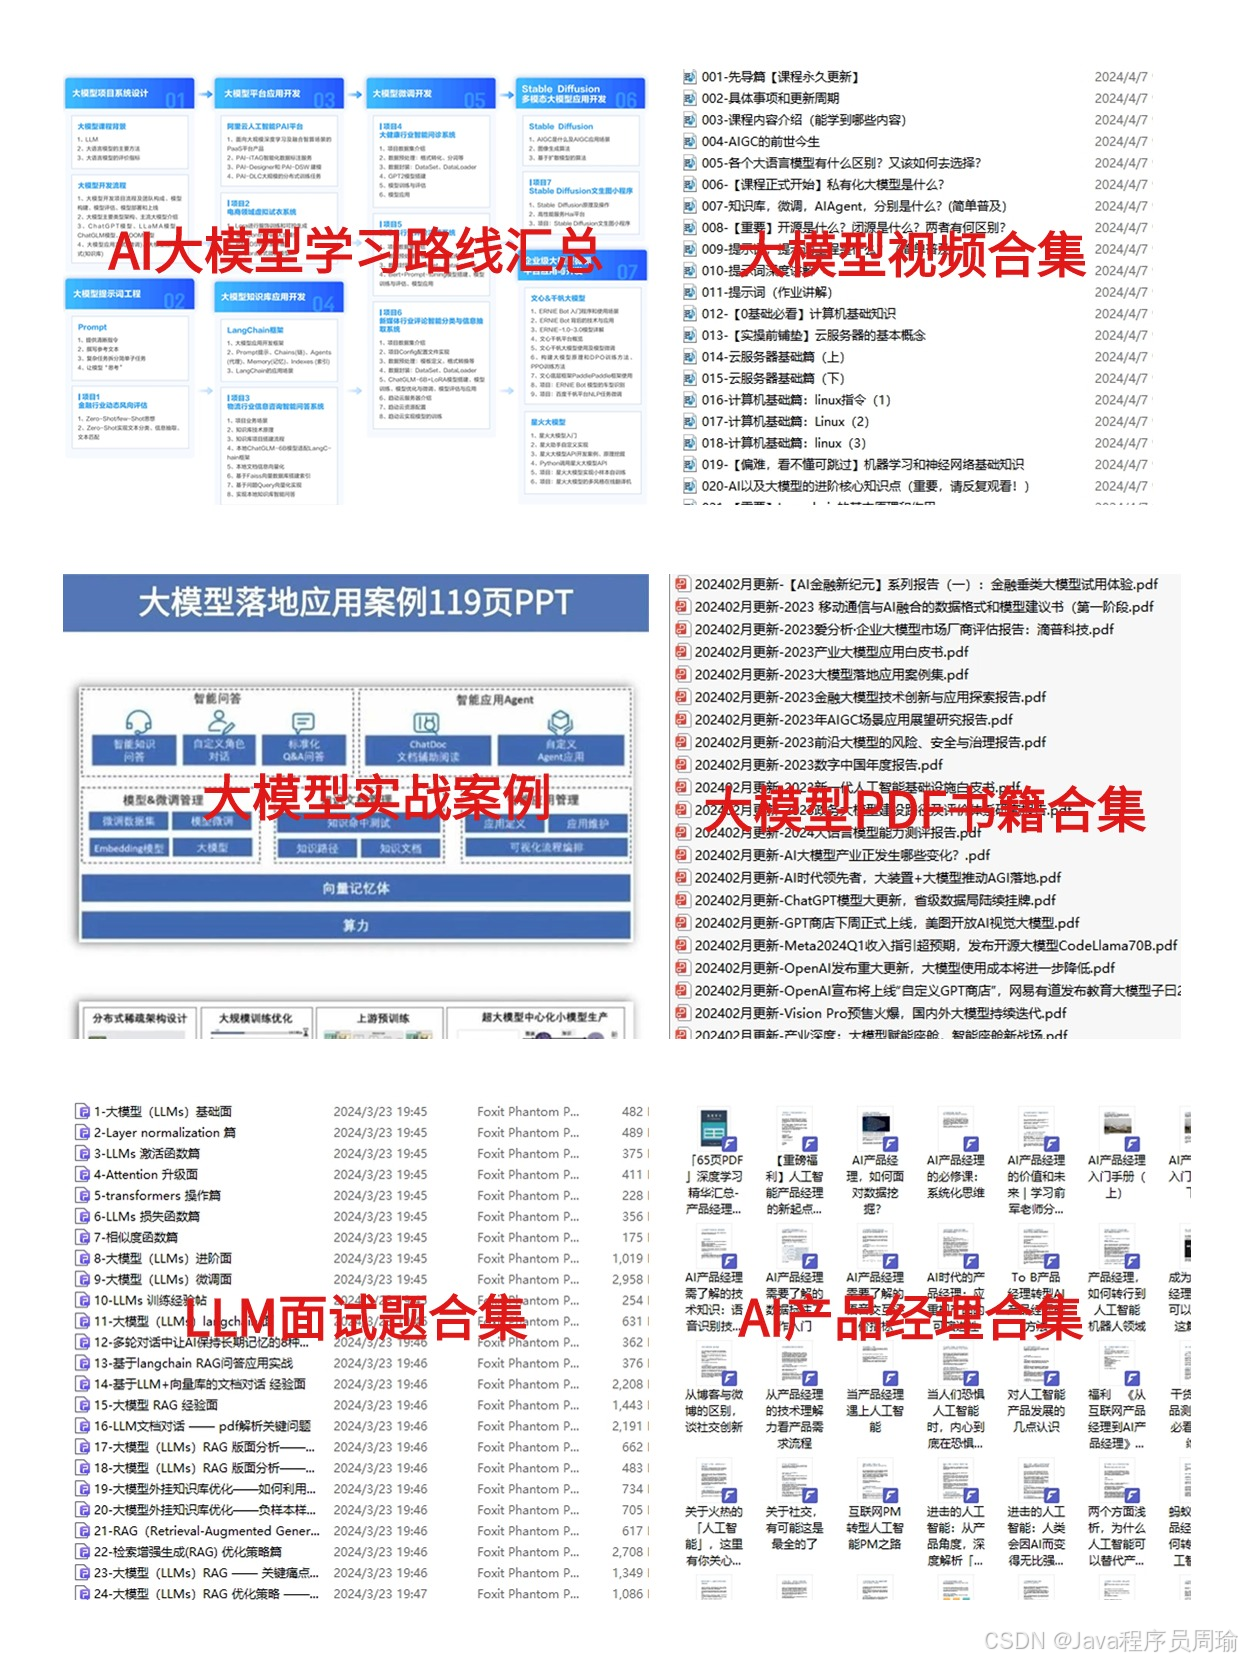
1.AI大模型学习路线图
2.100套AI大模型商业化落地方案
3.100集大模型视频教程
4.200本大模型PDF书籍
5.LLM面试题合集
6.AI产品经理资源合集
👉获取方式:
😝有需要的小伙伴,可以CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享免费领取【保证100%免费】🆓

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献11条内容

所有评论(0)