迈向高真实感数字人:3D高斯建模与智能交互技术解析|达摩链接
数字人建模的挑战
在影视、游戏、广告营销在内的数字内容创作领域,创作内容最大的虚拟 3D 对象是人物。因为人体是非刚性动态对象,通常有多样的服装。传统上需要有丰富经验的美工和大量手工操作,才能制作出较为真实的虚拟人物形象。
使用 AIGC 方法生成的 3D 人物模型往往欠缺真实感,而这种方法生成的 2D 数字人又存在与场景其他物体交互形式单一、人物动作受限等问题。因此,行业一直在追求通过智能生成的方式,输出高真实感、强交互、友好可控的数字人形象。
早期的一种数字人生成技术是使用多视角摄像机阵列,捕捉真人在真实场景的动作,再对捕捉到的人物形象进行处理,更换新的动作和视角放到真实场景中合成。
近年来,随着 3D 高斯泼溅和 NeRF 等端到端表征技术的发展,上述的数字人生成方法就可以得到很好的优化,从而更方便地使用捕捉到的原始形象生成多视点、多动作、多表情的多维度输出结果。
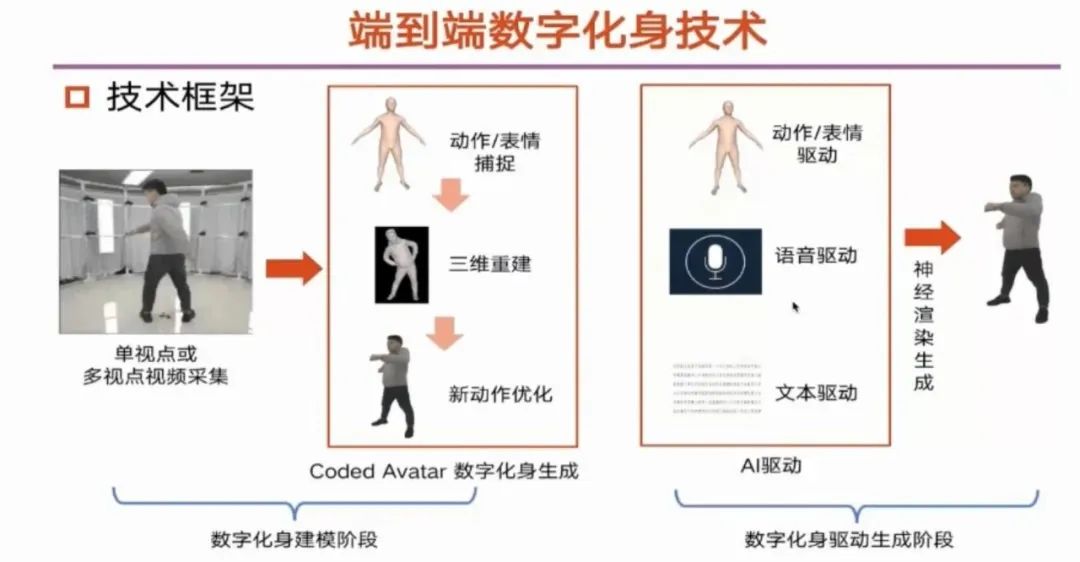
用新方法建模而成的数字化身可以使用动作、表情、语音、文本来驱动,解决了传统数字人建模技术真实感不足、建模成本高、交互受限等问题。
三维数字化身建模
身体建模
在这一领域,团队的第一个工作是动画化高斯建模,核心思想是对单帧人物图像参数化建模,将人物图像投影出正面和背面,用正面和背面的每一个像素定义一个 3D 高斯球,之后通过 3D 高斯球的优化来逼近拍摄的图像。
这里使用的模型会将实拍视频中给定动作的画面,映射到数字人像素 3D 高斯球上,用这种方法让模型学习整个动作。每个动作都使用一段两分钟左右的真人 16 视点视频来训练。
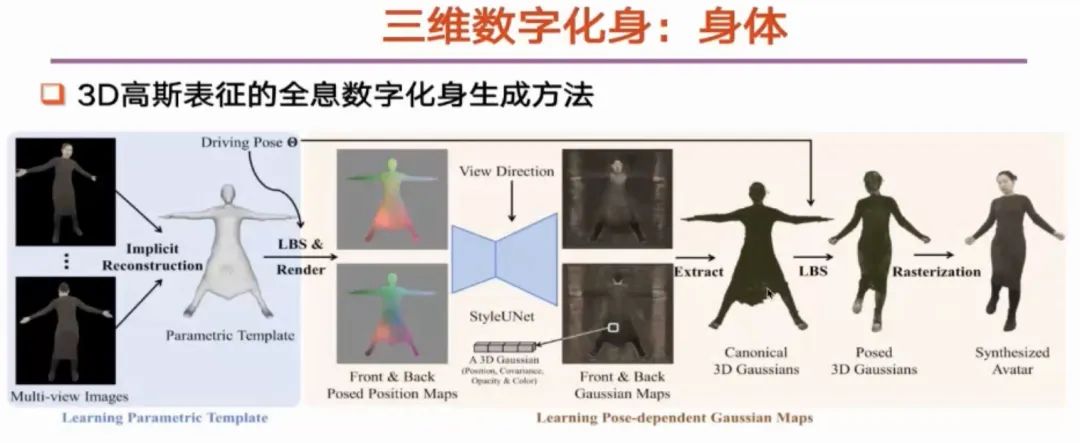
论文:Li et al. Animatable Gaussians: Learning Pose-dependent Gaussian Maps for High-fidelity Human Avatar Modeling, CVPR 2024
这种方法可以模拟较为真实的人物动作与人物身上的服装动态,且使用单张 4090 训练一个化身需要两天左右时间。
头部建模
第二项工作是针对头部的数字化身建模,通过六到八个视点捕捉人物正脸动态,从而建模人头的数字化身。头部建模是用表情参数驱动的,因为人头拓扑较为固定,所以不需要背面投影图像。
论文:Xu et al. Gaussian Head Avatar: Ultra High-fidelity Head Avatar via Dynamic Gaussians, CVPR 2024
该方法在人头的 3D 模型上优化模型顶点的 3D 高斯球,数字模型学习人头不同表情的表征,还加入了一些超分辨率优化,从而生成较为真实的头部表情,单个化身的训练时间是一到两天。
头部 + 身体建模
将头部与身体的建模结合,就可以生成完整的数字人,生成的数字人可以支持灵活的动作、表情,并实时调整摄像机视点等。
论文:Zheng et al. AvatarRex: Real-time Expressive Full-body Avatars, ACM TOG 2023
动态头发建模
由于头发的动态受头部位置和头部运动速度的影响,因此,建模头发时需要考虑当前帧前后多帧的变化。数字模型需要学习头发与头部速度矢量的关系。
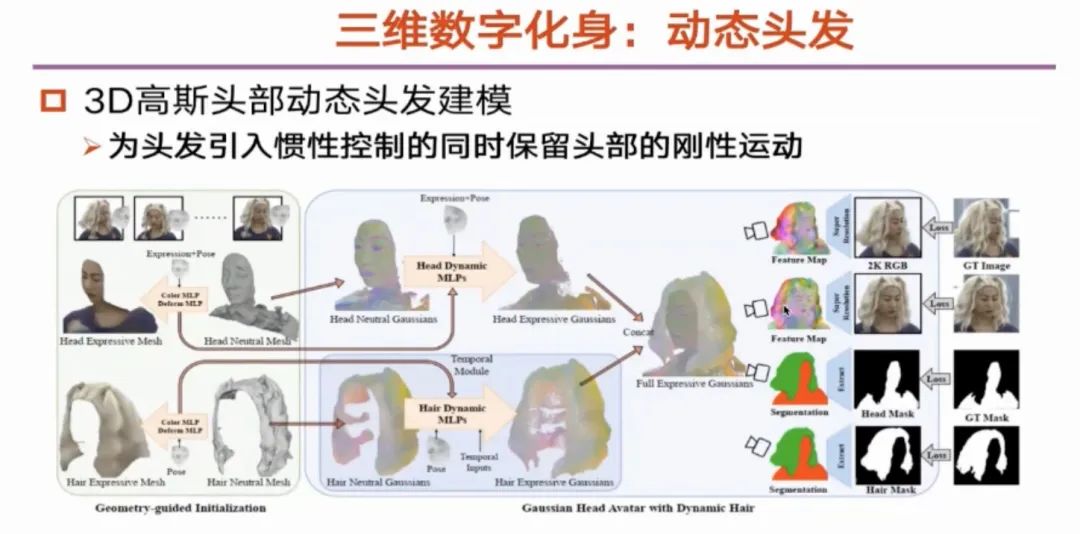
论文:Liao et al., HHAvatar: Gaussian Head Avatar with Dynamic Hairs, Arxiv 2024
重光照建模
数字化身建模的另一个问题是创建出来的化身在新的环境中需要与环境光照条件匹配。
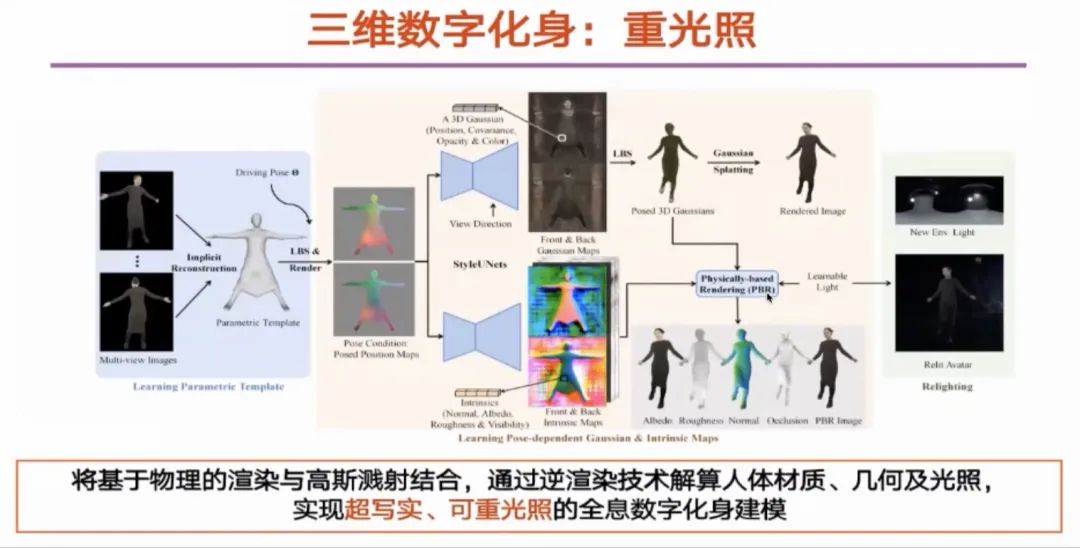
3D 高斯球可以加入很多通道,通过这一特性加入光照相关的通道,让数字模型学习不同真实光照条件下高斯球的相关通道的变化。
论文:Li et al. Animatable and Relightable Gaussians for High-fidelity Human Avatar Modeling, Arxiv 2024
头部模版(ID 可泛化)
数字化身还要做到 ID 可泛化,所以数字模型要学习大量 3D 人头视频,要采集足够的多视点人头表情视频供学习,得到人头参数化模版。该模版可以支持稀疏条件下 3D 人头化身建模。
论文:Xu et al. 3D Gaussian Parametric Head Model, ECCV 2024|
论文:Xu et al. GPHM: 3D Gaussian Parametric Head Model for Monocular Head Avatar Reconstruction, Arxiv 2024
通过这种方法可以对生成的 3D 人头模版进行 ID 插值,确保人头动态图像的 ID 是一致的。这样就可以用很少的图像来建模出真实人头的模型,实现类似于换脸的效果。
上述建模方式都是通过人体的 3D 表征信息来建模数字化身,另一种方法是基于多视点视频来建模数字化身。
人体视点可控视频生成
基于视频生成数字化身的方法,第一种是以 3D 高斯为表征,通过现有的视频来优化模型。

论文:Huang et al., HumanNorm: Learning Normal Diffusion Model for High-quality and Realistic 3D Human Generation,CVPR 2024
第二种是利用视频大模型的可扩展能力,直接将 4D 人体模版转换为视点可控的人体视频。

论文:Shao et al., Human4DiT: Free-view Human Video Generation with 4D Diffusion Transformer, SIGGRAPH Asia 2024, Journal Track
第二种方法结合了视频与 3D 模型的数据,需要收集很多人物数据进行视频模型训练。该方法引入了基于 diffusion transformer 的网络框架,可充分高效地利用收集的数据集,还提出了图像/视角/时序 transformer 块,能够以级联形式控制多种条件。
具体来说,用于训练的每一个样本视频都要提取人体信息,并利用同一时刻的多视点视频图像来学习空间信息,确保视角和空间的一致性;利用多帧序列图像来学习图像的时序关系;将参考的人体图像嵌入到图像块和每个 cross attention 中,确保人体身份一致性;利用位置编码方式将相机参数和时序参数嵌入视角和时序块中,确保视角和时序一致性。
这种方法可以使用给定的单图像来生成多视角、多动态的人物视频,效果较好。
将上述工作进一步拓展,收集 1 万小时的人体视频,其中包括多视点、3D 人体数据。然后利用 SMPL token 和图像 token 对齐与注意力机制,训练了参数 70 亿的人体视频生成模型,该模型支持 1440p 渲染,支持可控视点和动作。
该模型只需给出一张人体图像与动作、相机的参数,就能生成一段人物动作视频。通过这一方法,可以在全息视频生成流程中显著减少所需的相机数量。
人体-对象交互运动生成
涉及到人体与物体交互运动的视频生成时,可以通过两阶段来生成视频。
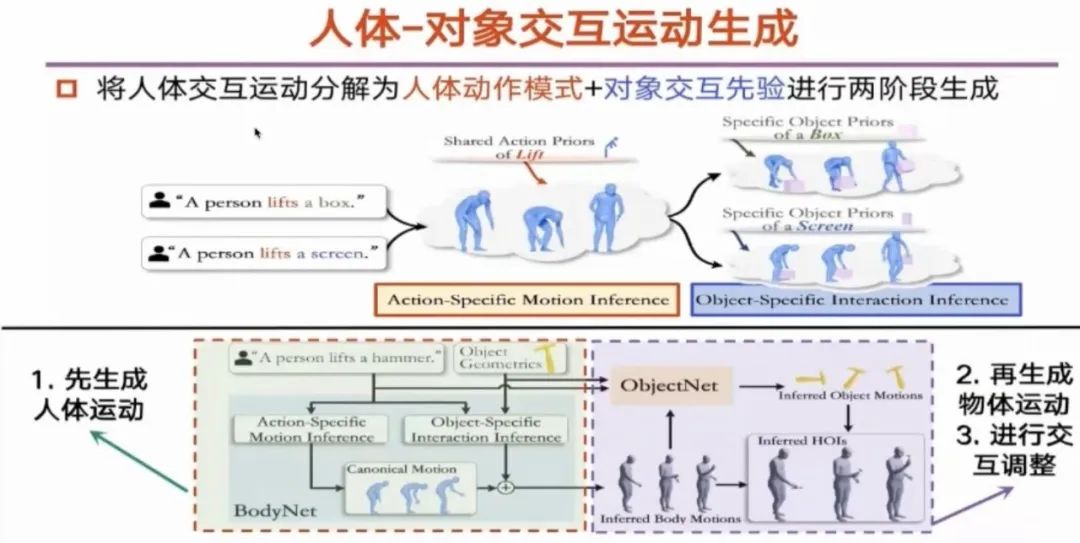
论文:Xuchao Gao, et al. EigenActor: Variant Body-Object Interaction Generation Evolved from Invariant Action Basis Reasoning. Arxiv 2024.
这样的方法可以有效感知给定的文本约束和模型本身的动作约束,从而生成不容易穿模的人体与物体交互视频。
手物交互运动生成
在生成手物交互运动时,可以定义手部的连续语义图,获取物体与手部不同位置交互的信息,从而学习生成结果。
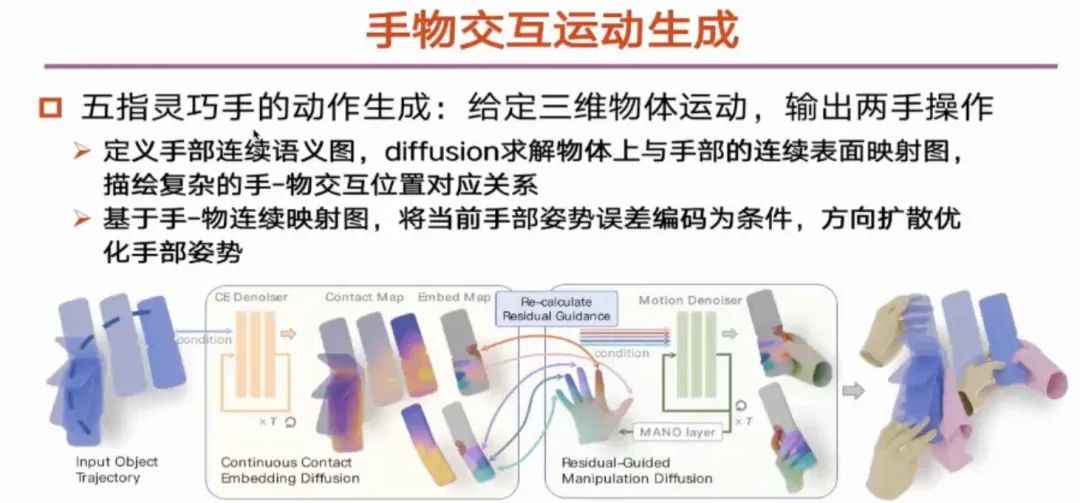
论文:Zhang et al. ManiDext: Hand-Object Manipulation Synthesis via Continuous Correspondence Embedding and Residual-Guided Diffusion, Arxiv 2024
手物交互视频生成
已有的手物交互生成方法只关注图像生成,而新的视频生成方法利用了上面的工作,可以生成不容易穿模,手物接触合理,可以有效应对手物遮挡情况的视频。
论文:Pang et al., ManiVideo: Generating Hand-Object Manipulation Video with Dexterous and Generalizable Grasping, Arxiv 2024
这个工作的第一个挑战是手物交互的高灵活度和高自由度,以及复杂的遮挡关系。应对方法是提出分层的遮挡表达,利用手物分割图将手物信息分层独立渲染为多张完整的法线图,从而将 2D 信息转为 3D 信号,同时利用手物遮挡置信图提供遮挡程度信息,有利于从分层的 3D 信号中学习遮挡/可见区域的关系。
还可以利用条件扩散视频生成模型来输出手物交互视频。这里的输入是手物原始信号,处理时模型构造分层遮挡表达和物体与人体的外观参考图像,输出和手物驱动信号一致的真实交互视频。
总结
-
3D 高斯建模方法已经突破了数字人的恐怖谷效应,为全自动端到端高真实感数字化身提供了表征基础;
-
在面向个体对象(ID不可泛化)的人体、人头、人手、头发、服装方面,3D 高斯建模方法展现出了初步潜力;
-
在 ID 可泛化方面,目前仅人头、人手化身展现出较好效果,人体的可泛化 3D 高斯模版难度极大,是当前研究热点;
-
结合视频生成的 3D 数字化身是未来潜在解决难题的方法之一;
-
人与场景的智能交互与化身绘制是当前重要的问题及发展方向。
【达摩链接】生态系列内容
“达摩链接”生态系列讲座作为连接达摩院与学术界、产业界的社区活动,通过组织内外部的沙龙、讲座等形式,旨在促进前沿技术的分享交流,推动技术成果的转化、合作与应用落地。
为了让更多开发者、学术研发人员能够深入了解“达摩链接”生态系列讲座的分享内容,我们现将精彩要点整理成文。本文为分享人观点/研究数据,仅供参考,不代表本账号观点和研究内容。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献3条内容

所有评论(0)