公司来了个大神,把GPU算力榨干了...
你的 GPU 是不是一张卡有多个任务,利用率是不是高到上不去了?
那么福利来了,不管你是训练还是推理,不用修改代码,你的速度还有可能更快,就是让 GPU 进入“多任务模式”。
MPS(Multi-Process Service)是一种支持多任务模式的方法,它跟网络、框架(PyTorch/Tensorflow/others)无关,只跟任务数量以及硬件相关,由于尝试成本比较低,那就试一下吧,收获还不小,简单聊一点。
01
使用
先来看一下,为什么说尝试成本低,请看使用方法(bash 命令,用 root 权限运行):
# ====== 启动 =========export CUDA_VISIBLE_DEVICES=0 # 这里以GPU0为例,其他卡类似nvidia-smi -i 0 -c EXCLUSIVE_PROCESS # 让GPU0变为独享模式。nvidia-cuda-mps-control -d # 开启mps服务# ====== 查看 =========ps -ef | grep mps # 启动成功后能看到相应的进程# ====== 停止 =========nvidia-smi -i 0 -c DEFAULT # 让GPU恢复为默认模式。echo quit | nvidia-cuda-mps-control # 关闭mps服务
就这么简单。先查看启动成功了没有,跑任务时会多出一个服务进程,其中"独享模式"可以不打开,但建议开启。
nvidia-smi 查看,如下图所示:
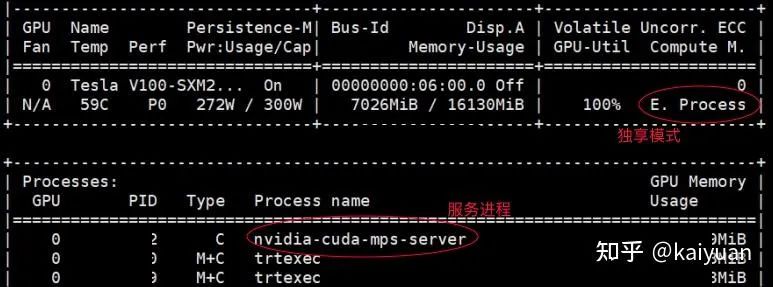
启动成功了,你就直接跑任务就行了,该怎么训练就怎么训练,该怎么推理怎么推理,之后的任务类型 Type 都是“M+C”,说明 MPS 用上了。
你会发现,在多任务的情况下,速度变快了,尤其是在 GPU 利用率已很高的情况下,给你带来的收益更多。
接下来,说点有意思的事情:
02
你真的理解 GPU 利用率是什么吗?
在运行任务时,大部分人通过“nvidia-smi”来查看 GPU 的利用率“Volatile GPU Util", (当然还可以用“nvidia-smi pmon”看得更细)。
关于这个利用率,容易产生两个误区:
-
误区一:GPU 的利用率 = GPU 内计算单元干活的比例。 利用率越高,算力就必然发挥得越充分。
-
误区二:同条件下,利用率越高,耗时一定越短。
真的不是这样”一定“,请先看理论解释,搬上 NVIDIA 官方对利用率(utilization)的原话[3]:
Percent of time over the past sample period during which one or more kernels was executing on the GPU.The sample period may be between 1 second and 1/6 second depending on the product.
翻译一下:采样时间段内,1 个及其以上的核(kernel)运行的时间的占比。这个采样时间段取多长,跟产品相关,可能值 1/6s~1s。
划重点:“one or more kernels”。这个意味着里面只要有 1 个 kernel 在执行,你的 GPU 利用率也可以很高。 而 1 个 kernel 不是一定让 GPU 内部的运算单元(core)都工作的。
kernel 和 core 是 CUDA 编程相关的概念[4],暂时不理解没关系。只要记住一个事实:GPU 利用率 99%,并不能说明你的 GPU 就使出了 99% 的力气。
这个利用率只能说明,有 kernel 在运算,至于算得怎么样,算力发挥出来了没有,光看这个利用率是判断不出来的。
进一步,并不是利用率越高,耗时就会越短,反之亦然。举个例子,用了 MPS 后,利用率降低了,训练反而更快了(请看后面说的“一个神奇的事情”)。
所以在同条件下,应该是 GPU 算力用得越充分,耗时才会越短。
03
常规的提升算力消耗的方式你都用了吗?
本文推荐的 MPS 方式是继续压榨 GPU,常规压榨你都试了吗?没有的话先试试。大部分情况下,提升 GPU 利用率是有利于算力的发挥地。
提升利用率的方法可以从任务本身着手,比如增加数据大小(更大的 batch_size、网络),缩减 I/O 时间, 提前加载数据等手段;
另外就是同时送入多个任务给 GPU,多个任务操作互补(有些操作不需要 GPU 工作),让 GPU 运算不闲着。
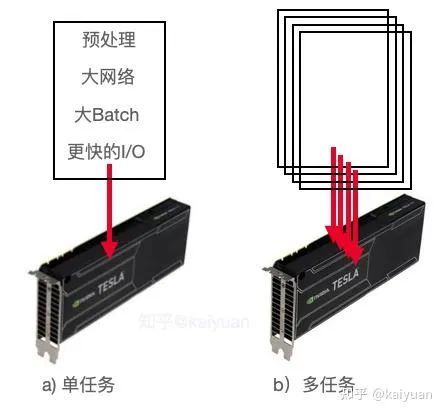
这些方法都是在宏观维度从时间以及空间上压榨算力,接下来说个微观维度的手段:多任务模式。
04
多任务模式-MPS
如果你的 GPU 有两个及以上的任务一起运行,那么你就可以考虑用多任务模式来继续压榨 GPU 算力,目前我们能接触的工具 NVIDIA MPS。
简单介绍一下原理,一般 GPU 上运行多个任务,都是采用"单任务"的工作模式,既同一个时刻只有一个任务(用不同的 context 区分)在 GPU 中运行。
通俗一点,假如你起了两个任务 A 和 B(训练和推理无所谓,python 起来的独立进程就行),单任务模式下,A 和 B 是排队干活的,(“我怎么感受不到这个排队过程?” 这个时间非常小,是一种并发的操作,感觉在好像在一起工作);
另一种是多任务模式,就是 A 和 B 可以同时干活, 请看下图:
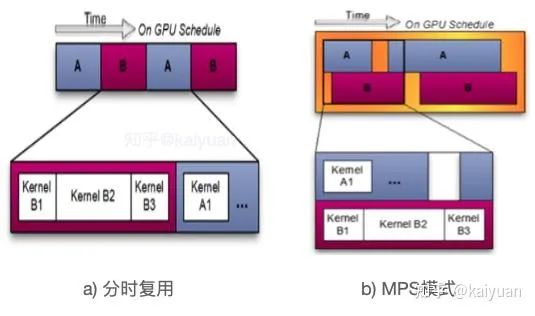
由于共用了 context,同一时刻两个可以一起跑。这样更加充分的利用了 GPU 的算力,MPS 的详细原理文末附上[1]。
有了 MPS,原来偷懒的 core 就被调用起来了,这样 GPU 的算力发挥得更充分了。
05
一个神奇的事情
在部分情况下,用了 MPS 后出现了利用率降低的现象,但训练的时间却变短了。
例子:GPU 里面跑了两个 ImageNet 的分类训练的任务,GPU 利用率维持在了稳定的 86% 左右。
请看如下对比数据:
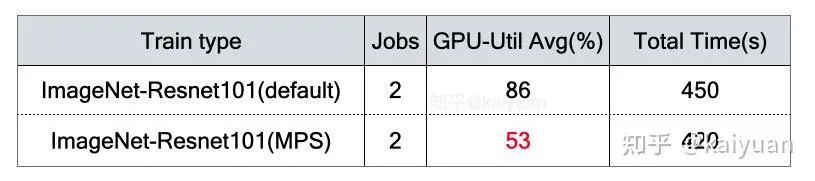
没错,MPS 让利用率变低了,86%→53%,为什么会降低,结合上面对 GPU 利用率的解释不难理解,在共享模式下,由于两个任务可以同时干活,所以反而对 GPU 的占用时间变小了,nvidia-smi 上看到的利用率就变低了。
这个测试比较好复现,只要是两个及以上的任务,而且总的利用率不要超出 90%,基本上都能看到这样的结果。
当然,不是所有条件下的任务都是这么神奇,比如任务数量只有一个,或者任务数量多(单个任务的利用率都很高)的时候结论又不是这样了,读者可以自行测试。
06
需要注意的事项(坑)
MPS 的 service 下,只要里面一个任务出错/失败,可能使得所有在里面的任务都运行失败,原因可以详细的看一下[1]中内容。
虽然 CUDA 层触发的 CUDA_Error 是没有这个问题的,但 driver 层错误就不一定,比如 core dump(暂不详细展开)。
这个问题需要注意的地方就是,对于多人(或者不同性质的作业)共用一张卡时,需要避免底层错误。(对于个人研发而言,如果不会处理,先用着吧,挂了就重来呗)
07
写在最后
对于”单任务模式“和”多任务模式“这两个名词,其实是对 NVIDIA GPU 的任务处理的方式的一种理解性翻译。
国内有些文章中翻译成了”分时复用“、”共享模式“,感觉也可以,但不那么直观。若要更好的理解,推荐好好阅读一下[1]中内容。
这份《AI产品经理学习资料包》已经上传CSDN,还有完整版的大模型 AI 学习资料,朋友们如果需要可以在文末CSDN官方认证二维码免费领取【保证100%免费】
资料包: CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享
AI产品经理,0基础小白入门指南
作为一个零基础小白,如何做到真正的入局AI产品?
什么才叫真正的入局?
是否懂 AI、是否懂产品经理,是否具备利用大模型去开发应用能力,是否能够对大模型进行调优,将会是决定自己职业前景的重要参数。
你是否遇到这些问题:
1、传统产品经理
不懂Al无法对AI产品做出判断,和技术沟通丧失话语权
不了解 AI产品经理的工作流程、重点
2、互联网业务负责人/运营
对AI焦虑,又不知道怎么落地到业务中想做定制化AI产品并落地创收缺乏实战指导
3、大学生/小白
就业难,不懂技术不知如何从事AI产品经理想要进入AI赛道,缺乏职业发展规划,感觉遥不可及
为了帮助开发者打破壁垒,快速了解AI产品经理核心技术原理,学习相关AI产品经理,及大模型技术。从原理出发真正入局AI产品经理。
这里整理了一些AI产品经理学习资料包给大家
📖AI产品经理经典面试八股文
📖大模型RAG经验面试题
📖大模型LLMS面试宝典
📖大模型典型示范应用案例集99个
📖AI产品经理入门书籍
📖生成式AI商业落地白皮书
🔥作为AI产品经理,不仅要懂行业发展方向,也要懂AI技术,可以帮助大家:
✅深入了解大语言模型商业应用,快速掌握AI产品技能
✅掌握AI算法原理与未来趋势,提升多模态AI领域工作能力
✅实战案例与技巧分享,避免产品开发弯路
这份《AI产品经理学习资料包》已经上传CSDN,还有完整版的大模型 AI 学习资料,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
资料包: CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享
AI大模型学习福利
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
大模型&AI产品经理如何学习
求大家的点赞和收藏,我花2万买的大模型学习资料免费共享给你们,来看看有哪些东西。
1.学习路线图
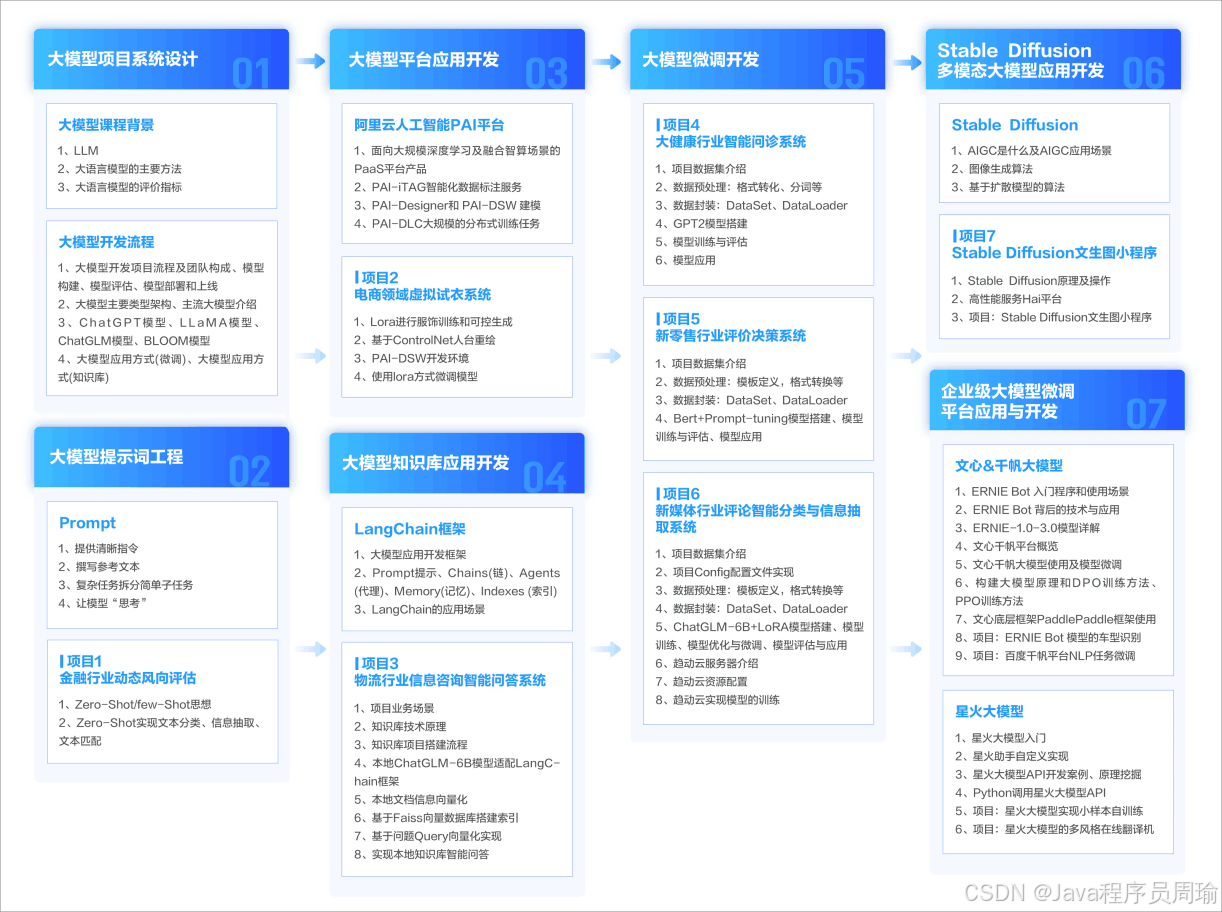
第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。
2.视频教程
网上虽然也有很多的学习资源,但基本上都残缺不全的,这是我自己整理的大模型视频教程,上面路线图的每一个知识点,我都有配套的视频讲解。
(都打包成一块的了,不能一一展开,总共300多集)
因篇幅有限,仅展示部分资料,需要点击CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享前往获取
3.技术文档和电子书
这里主要整理了大模型相关PDF书籍、行业报告、文档,有几百本,都是目前行业最新的。
4.LLM面试题和面经合集
这里主要整理了行业目前最新的大模型面试题和各种大厂offer面经合集。

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
1.AI大模型学习路线图
2.100套AI大模型商业化落地方案
3.100集大模型视频教程
4.200本大模型PDF书籍
5.LLM面试题合集
6.AI产品经理资源合集
👉获取方式:
😝有需要的小伙伴,可以CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享免费领取【保证100%免费】🆓

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献11条内容

所有评论(0)