人工智能共民族志学者:自动化能在多大程度上推动质性研究?
法比安·雷特科斯基 1{ }^{1}1,安德烈亚斯·苏德曼 2{ }^{2}2,亚历山大·瓦伊贝尔 1,3{ }^{1,3}1,3
1{ }^{1}1 卡尔斯鲁厄理工学院,德国
2{ }^{2}2 波恩大学,德国
3{ }^{3}3 卡内基梅隆大学,美国
{retkowski, waibel}@kit.edu / asudmann@uni-bonn.de
摘要
质性研究通常涉及难以扩展同时保持分析深度的劳动密集型过程。本文介绍了人工智能共民族志学者(AICoE),这是一种为质性研究开发的新颖端到端管道,旨在超越单纯自动编码分配的限制,提供更集成的方法。AICoE 组织整个过程,涵盖开放编码、编码整合、编码应用,甚至模式发现,从而对质性数据进行全面分析。
1 引言
质性数据分析是人文学科、文化研究和社会科学中的关键研究方法,侧重于对非数值数据(如文本、图像或音频文件)进行共时和历时分析与解释,以深入了解复杂的社会现象、文化表达和个人经验(Creswell 和 Poth, 2017; Denzin 等, 2023)。编码是这一过程的核心,通过系统地将具有分析意义的概念分配给文本段落或其他数据形式,来结构化和解释研究材料,例如访谈、田野笔记或小组讨论(Holton, 2007; Bernard, 2011; Harding, 2013; Bernard 等, 2016)。
尽管编码为数据分析提供了正式化的结构,其应用仍然具有上下文特定性和灵活性,适应研究问题和主题的细微差别(Elliott, 2018)。在许多情况下,特别是在民族志方法中,编码本质上是迭代的,并且与收集和反思数据的持续过程紧密相关。代码通过研究人员与数据互动、识别模式和细化概念理解的过程动态演变,可能包括合并、调整、添加或替换。此过程可能涉及开放式编码或轴心式编码,演绎或归纳,定量或定性,并且可以围绕解释或描述展开。(Ritchie 等, 2014; Creswell, 2015; Saldana, 2015)。
然而,手动编码面临显著的局限性。当研究人员遇到需要大量时间和资源才能有效编码的较大数据集时,可扩展性仍然是一个关键挑战(Miles 等, 2019)。它还增加了内部和外部编码者不可靠性的风险,仅提及一些典型挑战。这些限制促使过去十年间跨学科努力实现编码过程的自动化。自动语音识别(ASR)已成为这一领域的重要推动者,允许研究人员高效转录大量访谈数据并准备进一步分析和处理(Nguyen 等, 2021)。相关的质性数据处理任务,如文本摘要(Hori 等, 2002; Retkowski 和 Waibel, 2024b; Zhang 等, 2024)、问答(Singhal 等, 2025)和主题分割(Zechner 和 Waibel, 2000; Retkowski 和 Waibel, 2024a)同样受益于计算技术的进步,为研究人员提供了浓缩信息和识别主题边界的工具。
最近,大型语言模型(LLMs)展示了标注研究数据的新认识能力,但存在一定局限性,例如理解代码的更广泛背景的能力有限(Tuschling 等, 2023; Fischer 和 Biemann, 2024; Rasheed 等, 2024; Ziems 等, 2024)。与此同时,代理型 LLMs 的概念已经出现,旨在以目标导向行为自主运行(Xi 等, 2023)。例如,AI 科学家(Lu 等, 2024)展示了一个端到端自动化工作流程,用于撰写科学论文,从假设生成、实验设计到手稿起草。这项工作说明了自主代理管理复杂多阶段研究过程的潜力。受这些进展的启发,我们的方法寻求探索类似自动化在质性研究领域的应用,也是 MaxQDA 等专有系统的 AI 辅助数据分析的替代方案。
通过人工智能共民族志学者(AICoE),我们介绍了一种新颖的端到端管道,超越了传统关注代码分配的焦点。AICoE 是更广泛的人工智能辅助知识生产基础设施的一部分,整合了多种质性分析方法,从开放编码到模式发现。虽然以前的研究主要集中在自动化将代码映射到文本段落,我们的方法涵盖了更全面的质性分析过程。该管道扩展了超出预定义代码的演绎应用能力。至关重要的是,它还启用了归纳代码开发和应用,这是一个从数据本身直接开发新代码而不是预先定义的过程。
2 相关研究
LLM 的发展激发了跨学科努力以自动化学术工作,特别是质性文本分析(Morgan, 2023; PetersenFrey 等, 2023; Fischer 和 Biemann, 2024; Lu 等, 2024; Franken 和 Vepřek, 2025),包括专注于民族志研究的研究(Dippel 和 Sudmann, 2023)。这建立在质性研究中计算方法的丰富历史基础上,从早期工具如 General Inquirer(Stone 和 Hunt, 1963)和 Salton 的向量空间模型(Salton 等, 1975),到基于机器学习的注释(Sebastiani, 2002),以及开源平台如 WordFreak(Morton 和 LaCivita, 2003)和 WebAnno(Yimam 等, 2014)。最近,Spinoso-Di Piano 等(2023)引入了定性编码建议(QCS)任务,通过为给定文本段落提供预定义代码的排名列表来协助编码。为了评估 QCS,作者提出了 CVDQuoding,这是一个关于心血管疾病高危女性的访谈注释数据集。人类评估显示他们的系统提供了相关建议,突显了其作为辅助工具的潜力。然而,仍存在局限性,包括专注于代码分配而非完整代码手册开发,以及缺乏在应用研究环境中的评估。同样,Ziems 等(2024)评估了 LLMs 在自动化社会科学任务方面的潜力,重点在于其零样本能力。他们的研究结果表明,LLMs 在分类和解释方面表现出色,表明其增强社会科学研究流程的能力。然而,作者不推荐 LLMs 作为传统方法的替代品。
3 方法论
人工智能共民族志学者由支持 LLMs 的综合管道组成,旨在自动化关键的质性研究过程,同时力求保留民族志的核心解释深度。基于 LLMs 最近的进展,系统反映了质性分析的几个阶段(见图 1):开放编码、代码整合、代码应用和模式发现。这种方法使大规模质性数据的分析既可扩展又一致,同时模仿民族志研究实践。
3.1 开放编码
第一步可以称为开放编码,其中单个访谈由 LLM 单独处理。通过隔离每个访谈的分析,所选研究设计解决了 LLMs 的上下文窗口限制以及保持与原始数据紧密联系的民族志原则。系统可能为每个访谈建议多达 NNN 个代码,平衡描述性和解释性编码方法,从而自动化质性分析的时间消耗元素。
3.2 代码整合
代码整合阶段转向全局视角,将所有访谈中的发现综合成统一的代码手册。合成过程分析代码重叠并合并相似概念,最终形成最多 MMM 个整合代码。这一阶段代表了个体叙述与更广泛理论发展之间的关键桥梁,类似于手动轴心式编码但计算规模更大。
3.3 代码应用
管道回到局部视角,在代码应用阶段,每个整合代码系统地应用于单个访谈记录。与现有方法仅处理有限文本片段不同(Spinoso-Di Piano 等, 2023),我们的系统处理每个代码的整个访谈,确保
1{ }^{1}1 我们注意到这种方法允许缓存提示以更高效地应用代码。
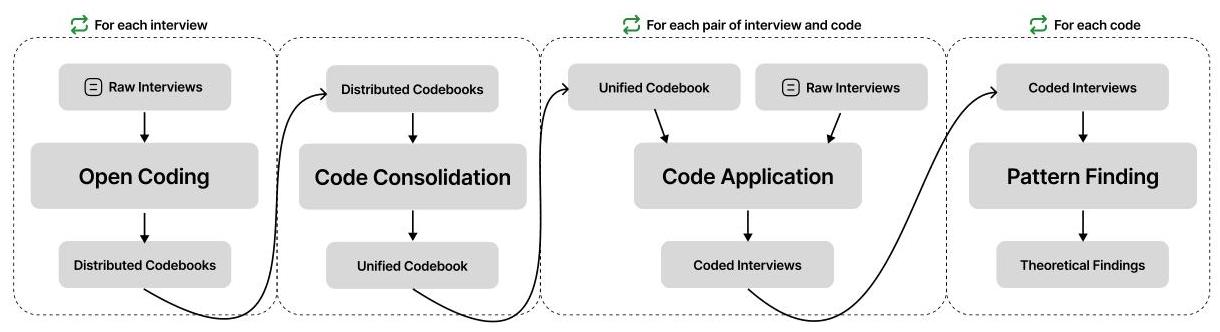
图 1:人工智能共民族志学者管道的概念插图
完整的对话上下文用于识别相关段落。这保留了陈述发生的时间和地点的关键民族志背景。系统通过提取的文本段落保持代码与输入数据之间的连接,这些段落可以通过唯一的确切匹配或子字符串匹配回溯到原始访谈。在较罕见的情况下,如果没有这样的匹配,我们则依赖于使用 ROUGE(Lin, 2004)测量的足够大的单词重叠,满足系统分析的技术需求和民族志对上下文基础的要求。
3.4 模式发现
最后,模式发现阶段回到整体视角,分析整个访谈集合中编码段落之间的关系以识别见解。此阶段检查共现、上下文关系和主题模式,自动从编码过渡到广泛的理论和解释性理解。
3.5 提示工程
开发的提示(见附录 A)旨在模拟质性研究的标准程序,特别是在民族志背景下。每个提示对应于分析的一个阶段,并被结构化以确保方法论的严谨性。草稿本很重要,因为它允许模型阐述其逐步推理过程,从而使其透明。通过强调逐字文本提取和每个提取段落与原始访谈行之间的严格对应关系,我们旨在实现高评分者间可靠性及透明度。此外,在代码手册开发过程中加入可选的代码描述以增强清晰度,而可选的上下文帮助指导研究方向。max_codes 参数是一个技术限制,以避免提示过长,但在实践中可以根据模型的
上下文长度、在长上下文中保持性能的能力以及访谈数量进行调整。虽然这些提示以民族志访谈为例,但精确的基于代码的文本提取原则很容易扩展到其他质性研究方法。
4 实验与结果
系统利用 Llama-3.3-70B(Dubey 等, 2024)作为 LLM,尽管模块化管道设计允许与任何现代 LLM 集成。我们在 CVDQuoding 和 HiAICS 数据集中各选取三个访谈进行模型评估,后者是我们作为民族志分析的一部分对人工智能研究人员进行访谈的集合。研究参与者包括在科学学科中实际应用人工智能的研究人员,以及对人工智能在研究中的使用提供理论和批判性分析的研究人员。访谈使用 Nguyen 和 Waibel(2025)的带说话人属性的 ASR 系统转录。2{ }^{2}2
4.1 代码手册的语义关联性
为了评估不同质性代码手册之间的语义关联性,我们开发了一个新的框架,系统地比较代码分类法,具体规定以下代码之间的语义关系:
- ( MMM ) 匹配 (1:1) - 定义跨代码手册捕获大致相似概念的代码,尽管它们可能使用不同的术语
-
- © 包含 (1:n) - 表示一个代码代表一个更广的概念,涵盖另一个方案中的一个或多个代码
-
- ( PPP ) 部分重叠 (1:1) - 表示共享部分意义但仍保持独特元素的代码
2{ }^{2}2 我们在 https://codeberg.org/hiaics/interviews 下发布 HiAICS 访谈。
- (U) 未匹配 - 表示完全独特的方面,不存在于另一个代码手册中
这些关系的视觉演示可以在附录中的图 3 中找到。基于这些关系,我们还开发了一种评分方法对其进行量化。我们将 n:1\mathrm{n}: 1n:1 包含归一化为原子 1:11: 11:1 关系,并为语义相关性分配权重:匹配的 wm=1.0w_{m}=1.0wm=1.0,包含的 wc=0.7w_{c}=0.7wc=0.7,重叠的 wp=0.5w_{p}=0.5wp=0.5。对于每个代码 xxx,令 R(x)R(x)R(x) 表示其关系集。个体得分 s(x)s(x)s(x)、代码手册得分 τi\tau_{i}τi 和最终得分计算如下:
s(x)=max({wr:r∈R(x)}∪{0})τi=1∣i∣∑x∈is(x) 对于 i∈{A,B}τsem =τA+τB2 \begin{aligned} s(x) & =\max \left(\left\{w_{r}: r \in R(x)\right\} \cup\{0\}\right) \\ \tau_{i} & =\frac{1}{|i|} \sum_{x \in i} s(x) \quad \text { 对于 } i \in\{A, B\} \\ \tau_{\text {sem }} & =\frac{\tau_{A}+\tau_{B}}{2} \end{aligned} s(x)τiτsem =max({wr:r∈R(x)}∪{0})=∣i∣1x∈i∑s(x) 对于 i∈{A,B}=2τA+τB
其中 AAA 和 BBB 表示代码手册中的两组完整代码。
| 方案 1 | 方案 2 | MMM | CCC | PPP | UUU | τsem \tau_{\text {sem }}τsem |
|---|---|---|---|---|---|---|
| 编码员 A | 编码员 B | 0.216 | 0.346 | 0.251 | 0.187 | 0.584\mathbf{0 . 5 8 4}0.584 |
| 编码员 A | AICoE | 0.206 | 0.480 | 0.191 | 0.123 | 0.638\mathbf{0 . 6 3 8}0.638 |
| 编码员 B | AICoE | 0.081 | 0.573 | 0.125 | 0.221 | 0.545\mathbf{0 . 5 4 5}0.545 |
表 1:来自 HiAICS 数据集的代码手册比较的关系类型分布。图 5 提供了视觉并排比较,详细结果见附录中的表 4。
4.2 代码分配的相关性
为了独立于上游阶段评估代码到文本的相关性,我们向系统提供了从先前手动分析中得出的人类策划的代码手册 3{ }^{3}3。这种受控设置孤立了代码应用机制。几位专家评估了人工分配和 AI 分配的代码是否与相应文本段落相关或无关,盲评来源。
4.3 理论发现的质量
为了评估生成发现的质量,我们进行了人类评价,使用三个标准:
-
(G) 基础(数据基础、证据支持与准确性):发现必须准确、可靠,并得到访谈的良好支持。理想情况下,提到或提供了多个编码段落。
表 2:来自人类和 AI 编码员的平均相关代码分配;每位评估者的详细结果见附录中的表 5 -
( RRR ) 相关性(与代码和研究目标的一致性):发现应解决研究目标和分配的代码。
-
- (I) 洞察力(洞察力、新颖性与非平凡性):发现应揭示深刻、非显而易见的智力价值见解,避免表面层次观察或琐碎之处。
对于 HiAICS 数据集,要求三位专家在阅读访谈后根据这些维度对每个发现进行五点李克特量表评分。%HQ 指标(高质量发现的百分比)反映了在专家和标准之间平均评分达到 4.00 或更高的代码比例。
- (I) 洞察力(洞察力、新颖性与非平凡性):发现应揭示深刻、非显而易见的智力价值见解,避免表面层次观察或琐碎之处。
| 平均值 | 标准差 | % HQ | |
|---|---|---|---|
| 基础 | 3.42 | 0.61 | - |
| 相关性 | 3.76 | 0.41 | - |
| 洞察力 | 3.29 | 0.46 | - |
| 整体质量 | 3.49\mathbf{3 . 4 9}3.49 | 0.38\mathbf{0 . 3 8}0.38 | 32.25\mathbf{3 2 . 2 5}32.25 |
表 3:AICoE 在 HiAICS 上的评估分数,涵盖 31 个代码(总计 151 个发现),详细结果见附录中的表 7,示例高质量发现见图 4,均在附录中。
5 讨论
代码手册的一致性、差距与新视角。代码手册一致性(表 1)表明,AICoE 与任一人类编码手册相比,并没有显著更大的差异。然而,手动检查代码手册显示,AICoE 倾向于优先考虑主题概念,而人类编码员有时会添加反映个别受访者经验的代码(例如,“传记背景”或“个人工作”)。值得注意的是,所有三份代码手册都包含了与其他代码手册不匹配的独特代码,强调了 AICoE 潜在补充人类分析的能力,提供替代视角以帮助研究人员完善和扩展其代码手册。
3{ }^{3}3 具体来说,对于 CVDQuoding 数据集,已发表带有两个代码手册的数据集,我们采用了编码员 2 的代码手册。对于我们的 HiAICS 数据集,我们采用了其中一位专家注释员(编码员 1)开发的代码手册。
编码性能差异。HiAICS (Δ=0.180)(\Delta=0.180)(Δ=0.180) 中人类与 AI 编码的性能差距大于 CVDQuoding (Δ=0.046)(\Delta=0.046)(Δ=0.046),这很可能源于数据固有的特性。首先也是最重要的是,CVDQuoding 包括带有预定义问题的结构化访谈,可能提供更清晰的主题边界,便于更一致的编码。其次,HiAICS 中的访谈平均每篇包含大约两倍的词数(10,663 对 5,163 词),增加了模型维持上下文连贯性的复杂性。这与先前证据一致,即随着上下文长度增加,LLM 性能通常会下降(Liu 等, 2024)。最后,HiAICS 中的 ASR 转录引入了通过转录伪影和口语不流畅性产生的语言噪声。
数据中的意义。表 3 的结果显示,AICoE 可靠地识别出理论上相关的模式,总体质量得分为 3.49,32.25% 的代码产生了高质量发现(≥4.00\geq 4.00≥4.00)。基础(3.42)和相关性(3.76)优于洞察力(3.29),反映出在将发现扎根于数据并与研究目标对齐方面的优势,同时也凸显了自动化解释深度的难度。评分者间相关性(见附录 B.3.1)显示基础评分更为一致(E2-E3: r=0.6471r=0.6471r=0.6471),但相关性和洞察力评分一致性较低(最大 r=0.1194r=0.1194r=0.1194 和 0.2478),表明评估主题一致性和发现新颖性时更具主观性。
AI 增强的民族志。虽然我们的方法提出了一种质性分析的系统管道,但它不应仅仅被视为自动化的代名词。相反,该框架拥抱人类专业知识,并允许在每个阶段进行关键干预。特别是统一的代码手册充当“检查点”,研究人员可以在其中审查、完善和调整整合后的代码,然后继续进行代码应用和模式发现。重要的是,我们的框架还支持演绎编码方法,允许研究人员跳过开放编码和代码整合阶段,直接应用现有的或理论驱动的代码手册。这种灵活性贯穿整个管道——研究人员可以多次迭代各个阶段,运行平行样本,或按需修改中间输出。模式发现阶段作为最后一步,体现了这种合作,其中计算分析协助而非取代人类洞察。
工具、伙伴还是认知媒介?基于这些考虑,至关重要的是明确人工智能共民族志学者既不是单纯的工具,也不是类人的代理。我们必须谨慎避免拟人化和人类中心主义的框架,并同样警惕将其简化为静态、预定的技术人工物。相反,我们认为人工智能共民族志学者是一种认知媒介,促进和支持知识的产生,同时仍需接受批判性反思。作为这种媒介,人工智能共民族志学者丰富了支撑民族志研究乃至更广泛的质性研究的研究基础设施。
多模态和数据异质性。未来的研究必须解决与质性数据分析相关的科学过程的固有多模态和数据异质性问题。虽然我们的管道专注于文本数据(访谈记录),但科学活动远超文本范围。它涵盖各种多模态输入或媒体:口语(访谈、讲座、会议)、视觉元素(幻灯片、图形、视频)和学科特定的传感器数据(Yang 等, 1998; Bett 等, 2000)。科学讨论,例如,体现了这种多模态,整合了口语互动、非言语线索如手势和注视,或视觉材料的呈现。实现对科学过程更广泛、更快、更情境化的理解,需要开发处理、解释和综合这些多样跨模态信号的方法。
6 结论
人工智能共民族志学者展示了人工智能支持的质性研究的潜力和局限性。我们的评估揭示了稳健的代码手册开发、合理的代码分配以及生成有意义发现的能力。这代表了质性研究的一个有希望的方向,能够处理大量数据的同时保持分析深度。超越作为简单工具的功能,AICoE 在研究过程中扮演了认知媒介的角色。
局限性
关于质性研究的民族志方法能够在多大程度上实现自动化或将任务委托给 AI 系统的争论仍在继续。然而,只有借助相应的系统,才能分析大量的民族志数据。在我们的研究背景下,质性数据分析的每个阶段都内在地与民族志经验和对人类主体的观察紧密相连。对我们框架的未来改进可以优先考虑民族志数据分析中的特殊性,并将其置于这一认知渠道的核心。例如,我们可以考虑更细致地综合访谈记录和观察记录,如田野笔记。然而,我们认为,这种提出的认知渠道在超出纯民族志背景的质性研究数据注释和解释方面提供灵活支持是一种资产,而非缺陷。因此,它有可能重塑未来人工智能如何支持跨学科质性研究。
伦理
使用 LLMs 对研究材料进行自动编码和质性分析涉及与数据隐私、算法偏见和透明度相关的伦理挑战。研究人员应确保参与者的数据得到充分保护,并获得其对 AI 辅助分析的知情同意。必须批判性评估 LLM 生成的注释和解释中的潜在偏见,并确保 AI 在分析过程中的作用透明。明确的作者身份和问责制指南对于 LLM 辅助的质性分析至关重要。最后,平衡利用 AI 处理海量数据集的能力与保持严格的伦理研究标准非常重要。
致谢
本研究得到了项目“AI 如何改变科学?学习算法时代的研究”(HiAICS)的支持,该项目由大众基金会资助。我们感谢 Matthias Ernst、Christine Hämmerling、Birte Luisa Kuhle、Markus Ramsauer、Johanna Maria Toussaint 和 Charmaine Voigt 在注释和评估方面的贡献。
参考文献
H. Russell Bernard, Amber Wutich, and Gery W. Ryan. 2016. 分析质性数据:系统方法。SAGE Publications. Google-Books-ID: yAi1DAAAQBAJ.
Harvey Russell Bernard. 2011. 人类学研究方法:定性和定量方法。Rowman Altamira.
Michael Bett, Ralph Gross, Hua Yu, Xiaojin Zhu, Yue Pan, Jie Yang, and Alex Waibel. 2000. 多模态会议跟踪器。RIAO,第 32-45 页。法国巴黎。
John W. Creswell. 2015. 质性研究者必备技能 30 条。SAGE Publications. Google-Books-ID: fkJsCgAAQBAJ.
John W. Creswell 和 Cheryl N. Poth. 2017. 质性探究与研究设计:选择五种方法,第四版。SAGE Publications, Inc.
Norman K. Denzin, Yvonna S. Lincoln, Michael Donald Giardina, 和 Gaile S. Cannella. 2023. SAGE 质性研究手册,第六版。SAGE Publications, Inc, 洛杉矶伦敦新德里新加坡华盛顿特区墨尔本。
Anne Dippel 和 Andreas Sudmann. 2023. AI 人类学。Simon Lindgren 编辑,《人工智能批判研究手册》,第 826-844 页。Edward Elgar Publishing.
Abhimanyu Dubey, Abhinav Jaubri, Abhinav Pandey, Abhishek Kadian, Ahmad Al-Dahle, Aiesha Letman, Akhil Mathur, Alan Schelten, Alex Vaughan, Amy Yang, Angela Fan, Anirudh Goyal, Anthony Hartshorn, Aobo Yang, Archi Mitra, Archie Sravankumar, Artem Korenev, Arthur Hinsvark, Arun Rao, …, 和 Zhiyu Ma. 2024. 骆驼 3 系列模型。arXiv 预印本。ArXiv:2407.21783 [cs].
V. Elliott. 2018. 质性数据分析中思考编码过程。质性报告,23(11)。出版商:Nova Southeastern University。
Tim Fischer 和 Chris Biemann. 2024. 探索大型语言模型在质性数据分析中的应用。第四届自然语言处理在数字人文国际会议论文集,第 423-437 页,美国迈阿密。计算语言学协会。
Lina Franken 和 Libuše Hannah Vepřek. 2025. 质性研究中的人工智能。Heidrun Friese, Marcus Nolden 和 Miriam Schreiter 编辑,《社会实践与数字化日常世界手册》,第 1-9 页。Springer Fachmedien, Wiesbaden。
Jamie Harding. 2013. 质性数据分析从头到尾。SAGE。Google-Books-ID: 9YÚQAgAAQBAJ.
Judith A. Holton. 2007. 编码过程及其挑战。扎根理论手册,3:265-289。
Chiori Hori, Sadaoki Furui, Rob Malkin, Hua Yu, 和 Alex Waibel. 2002. 自动语音摘要应用于英语广播新闻语音。2002 IEEE 国际声学、语音和信号处理会议,卷 1,第 I-9 页。IEEE
Chin-Yew Lin. 2004. ROUGE:自动摘要评估包。文本摘要分支,第 74-81 页,西班牙巴塞罗那。计算语言学协会。
Nelson F. Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni, 和 Percy Liang. 2024. 迷失在中间:语言模型如何使用长上下文。计算语言学协会交易,12:157-173。地点:马萨诸塞州剑桥 出版社:MIT Press。
Chris Lu, Cong Lu, Robert Tjurko Lange, Jakob Foerster, Jeff Clune, 和 David Ha. 2024. 人工智能科学家:迈向完全自动化的开放式科学发现。arXiv 预印本。ArXiv:2408.06292 [cs]。
Matthew B. Miles, A. Michael Huberman, 和 Johnny Saldana. 2019. 质性数据分析:方法源书。SAGE Publications. Google-BooksID: Bt0uuQEACAAJ。
David L. Morgan. 2023. 探索人工智能在质性数据分析中的应用:ChatGPT 案例。国际质性方法杂志,22:16094069231211248。出版商:SAGE Publications Inc.
Thomas Morton 和 Jeremy LaCivita. 2003. WordFreak:一种开放的语言注释工具。HLTNAACL 2003 - 演示的会议论文集附录,第 17-18 页。
Thai-Binh Nguyen 和 Alexander Waibel. 2025. MSA-ASR:高效的多语言演讲归属冻结 ASR 模型。arXiv 预印本。ArXiv:2411.18152 [cs]。
Thai-Son Nguyen, Sebastian Stüker, 和 Alex Waibel. 2021. 在线低延迟对话语音识别的超人类表现。Interspeech 2021,第 1762-1766 页。ISSN: 29581796 。
Fynn Petersen-Frey, Tim Fischer, Florian Schneider, Isabel Eiser, Gertraud Koch, 和 Chris Biemann. 2023. 从质性到定量研究:数字人文学科中的半自动化注释扩展。第 19 届自然语言处理会议论文集(KONVENS 2023),第 52-62 页,德国英戈尔施塔特。计算语言学协会。
Zeeshan Rasheed, Muhammad Waseem, Aakash Ahmad, Kai-Kristian Kemell, Wang Xiaofeng, Anh Nguyen Duc, 和 Pekka Abrahamsson. 2024. 大型语言模型能否充当数据分析师?质性数据分析的多代理辅助方法。arXiv 预印本。ArXiv:2402.01386 [cs]。
Fabian Retkowski 和 Alexander Waibel. 2024a. 从文本分段到智能章节:一种用于结构化视频转录的新基准。第 18 届欧洲计算语言学协会会议论文集(第一卷:长论文),第 406-419 页,马耳他圣朱利安。计算语言学协会。
Fabian Retkowski 和 Alexander Waibel. 2024b. 零样本策略用于长度可控的摘要。arXiv 预印本。ArXiv:2501.00233 [cs]。
Jane Ritchie, Jane Lewis, Carol McNaughton Nicholls, 和 Rachel Ormston. 2014. 质性研究实践:社会科学学生和研究人员指南。SAGE Publications. Google-Books-ID: zkITlwEACAAJ。
Johnny Saldana. 2015. 质性研究人员的编码手册。SAGE. Google-Books-ID: ZhxiCgAAQBAJ.
G. Salton, A. Wong, 和 C. S. Yang. 1975. 自动索引的向量空间模型。ACM 通信,18(11):613-620。
Fabrizio Sebastiani. 2002. 自动文本分类中的机器学习。ACM Computing Surveys, 34(1):1-47.
Karan Singhal, Tao Tu, Juraj Gottweis, Rory Sayres, Ellery Wulczyn, Mohamed Amin, Le Hou, Kevin Clark, Stephen R. Pfohl, Heather Cole-Lewis, Darlene Neal, Qazi Mamunur Rashid, Mike Schaekermann, Amy Wang, Dev Dash, Jonathan H. Chen, Nigam H. Shah, Sami Lachgar, Philip Andrew Mansfield, …, 和 Vivek Natarajan. 2025. 使用大型语言模型实现接近专家水平的医学问题解答。自然医学,第 1-8 页。出版商:Nature Publishing Group.
Cesare Spinoso-Di Piano, Samira Rahimi, 和 Jackie Cheung. 2023. 质性编码建议:以人为中心的质性编码方法。计算语言学协会会议论文集:EMNLP 2023 找到的结果,第 14887-14909 页,新加坡。计算语言学协会。
Philip J. Stone 和 Earl B. Hunt. 1963. 内容分析的计算机方法:使用通用查询系统的研究。1963年5月21日至23日春季联合计算机会议论文集 - AFIPS '63 (Spring),第 241 页,底特律,密歇根。ACM Press.
Anna Tuschling, Andreas Sudmann, 和 Bernhard J. Dotzler,编辑。2023. ChatGPT 和其他“胡言乱语机”:与人工智能的对话。transcript Verlag. 接受日期:2024-0202T16:04:26Z.
Zhiheng Xi, Wenxiang Chen, Xin Guo, Wei He, Yiwen Ding, Boyang Hong, Ming Zhang, Junzhe Wang, Senjie Jin, Enyu Zhou, Rui Zheng, Xiaoran Fan, Xiao Wang, Limao Xiong, Yuhao Zhou, Weiran Wang, Changhao Jiang, Yicheng Zou, Xiangyang Liu, …, 和 Tao Gui. 2023. 基于大型语言模型的代理的兴起与潜力:调查。arXiv 预印本。ArXiv:2309.07864 [cs].
Jie Yang, Rainer Stiefelhagen, Uwe Meier, 和 Alex Waibel. 1998. 多模态人机交互中的视觉跟踪。CHI 会议论文集上的人类因素在计算系统中的应用,第 140-147 页。
Seid Muhie Yimam, Chris Biemann, Richard Eckart De Castilho, 和 Iryna Gurevych. 2014. WebAnno 中的自动注释建议和自定义注释层。第 52 届计算语言学年会论文集:系统演示,第 91-96 页。
Klaus Zechner 和 Alex Waibel. 2000. DIASUMM:不受领域限制的自发对话灵活摘要。COLING 2000 第二卷:第 18 届国际计算语言学会议。
Tianyi Zhang, Faisal Ladhak, Esin Durmus, Percy Liang, Kathleen McKeown, 和 Tatsunori B. Hashimoto. 2024. 新闻摘要的大规模语言模型基准测试。计算语言学协会交易,12:39-57。地点:马萨诸塞州剑桥 出版社:MIT Press。
Caleb Ziems, William Held, Omar Shaikh, Jiaao Chen, Zhehao Zhang, 和 Diyi Yang. 2024. 大型语言模型能否变革计算社会科学?计算语言学,50(1):237-291.
管道提示
开放编码
您是一位人工智能助手,任务是为民族志访谈记录建议相关代码。在民族志中,编码是为质性数据段分配标签或类别的过程,以识别主题和模式。这是分析访谈数据的关键步骤。
您将收到一份民族志访谈记录。您的任务是为此记录建议一组相关的代码。请记住,您不是为特定句子分配代码,而是提出可用于分析此记录的代码列表。
以下是记录:
<记录>
<记录>
</</</ 记录>
请分析此记录并建议一组可用于对访谈中的主题进行分类和理解的代码。遵循以下指南:
- 代码应简洁,通常由一至三个单词组成
-
- 代码应捕捉记录中的关键概念、主题或想法
-
- 力求结合描述性代码(正在发生什么)和解释性代码(潜在含义)
-
- 考虑记录中的显性内容和隐性含义
-
- 避免过于宽泛或模糊的代码
-
- 根据记录的复杂性和长度,您可以自由建议最多 <max_codes> 个代码
-
- 为每个代码提供简短描述(最多 20 字),以澄清其含义和应用,区分它与其他代码的不同之处。
您将获得可以并且应该考虑的上下文。
<上下文>
<上下文>
</</</ 上下文>
- 为每个代码提供简短描述(最多 20 字),以澄清其含义和应用,区分它与其他代码的不同之处。
可选
在提供最终代码列表之前,请使用 来思考您的过程:
- 识别访谈中讨论的主要话题
-
- 注意任何反复出现的主题或想法
-
- 考虑上下文和任何潜在含义
-
- 思考访谈者的经历、态度和行为
-
- 反思这些元素如何分类为代码
- 现在,请提供您为此记录建议的代码列表
- <suggested_codes>
- 代码 1 | 描述解释代码 1 的含义和上下文,最多 20 字
-
- 代码 2 | 描述解释代码 2 的含义和上下文,最多 20 字
- …ed_codes>
- 请记住,这些代码应与给定记录相关,并对民族志研究中的进一步分析有用。不要在 或 <suggested_codes> 外写内容。
参数
您是一位人工智能助手,任务是根据多个民族志访谈生成一套综合代码。您的目标是创建一个连贯且包容的代码集,涵盖所提供所有访谈的主题。
您将获得可以并且应该考虑的上下文。
<上下文>
<上下文>
<<< 上下文>
您将收到从多个访谈生成的代码集。这些代码包含在以下变量中:
<interview_codes>
<interview_codes>
<<< interview_codes>
分析这些代码集并创建一个单一的综合代码集,涵盖所有访谈的主题。遵循以下指南:
-
仔细审查所有代码集,识别常见主题和独特概念。
-
- 合并不同访谈中的相似代码,选择最描述性和清晰的措辞。
-
- 在适当的情况下概括代码,以捕捉出现在多个访谈中的更广泛主题。
-
- 保留代表个别访谈重要主题的独特代码。
-
- 确保最终代码集平衡,涵盖原始代码集中所有主要主题。
-
- 力求使最终代码清晰简洁,通常每个代码使用一至三个单词。
-
- 为每个代码提供简短描述(最多 20 字),以澄清其含义和应用,区分它与其他代码的不同之处。
在提供最终代码列表之前,请使用 来思考您的过程:
- 为每个代码提供简短描述(最多 20 字),以澄清其含义和应用,区分它与其他代码的不同之处。
-
识别跨所有访谈反复出现的代码和主题
-
- 注意代表重要个人视角的独特代码
10.3. 考虑如何合并相似代码而不丢失细微差别
- 注意代表重要个人视角的独特代码
-
反思可能涵盖多个代码的更广泛类别
11.5. 确保原始代码集中所有主要主题都得到体现
现在,请提供基于所有访谈的综合代码集。以以下格式呈现您的代码:
<comprehensive_codes>
- 代码 1 | 描述解释代码 1 的含义和上下文,最多 20 字
-
- 代码 2 | 描述解释代码 2 的含义和上下文,最多 20 字
-
- 代码 3 | 描述解释代码 3 的含义和上下文,最多 20 字
- …
- </comprehensive_codes>
- 请记住,您的最终集合不应超过 <max_codes> 个代码。确保这些代码与民族志研究中的进一步分析相关、清晰且有用。不要在 或 <comprehensive_codes> 外写内容。
参数
您是一位人工智能助手,任务是分析一份民族志访谈并提取与给定分类法中特定代码相对应的相关部分。请仔细遵循以下指示:
- 首先,您将看到访谈的完整文本:
- </</</ interview>
-
- 接下来,您将收到带有不同区分描述的分类法代码:
- <<< taxonomy>
- <set_of_codes>
- </</</ taxonomy>
-
- 您将专注于此分类法中的一个特定代码:
10.
<specific_code>

</</</ code>
- 您将专注于此分类法中的一个特定代码:
- 您的任务是仔细阅读访谈文本,找出与指定代码最相关或显著的部分。这些部分应证明为何将该代码分配给这些访谈部分。
11.5. 找到相关内容后,请按以下格式列出:
- 访谈中的确切文字
-
- 访谈中的另一段确切文字
-
- (继续此格式列出所有找到的相关部分)
重要注意事项:
- 不要以任何方式更改提取部分的内容。
-
- 仅包括最重要和最相关的部分。质量比数量更重要。
-
- 确保每个提取部分对应于原始访谈中的正好一行。不要合并多行或提取部分行。
-
- 确保提取的部分整体上为分配指定代码提供了明确的理由。
- 如果无法找到与指定代码相关的访谈部分,请回复:
无
请记住,您的目标是提供准确且重点突出的分析,帮助理解指定代码如何适用于本次访谈。彻底检查但选择相关部分时要谨慎。仅以列表形式呈现您的发现或“无”如果未找到相关内容。
参数
您是一位人工智能助手,任务是自动化民族志管道的最后阶段:模式发现。您的目标是分析来自多个访谈的编码段落,并基于这些初级编码数据生成理论发现。
您将收到与特定代码相关的访谈编码段落。这些段落包含在以下变量中:
<coded_segments>
<coded_segments>
</</</ coded_segments>
这些段落所关联的具体代码是:
<<< code>
</</</ code>

您的任务是仔细分析这些编码段落,识别有意义的模式、主题或理论发现。请遵循以下指南:
-
彻底阅读所有编码段落,注意反复出现的想法、矛盾和独特视角。
-
- 寻找不同段落之间的联系,可能会揭示更深的见解或模式。
-
- 力求生成 3−53-53−5 个重要的发现或模式。注重质量而非数量。
-
- 优先非琐碎的发现,超越表面层次观察。
-
- 每个发现尽可能由多个编码段落支持。
在展示最终发现之前,请使用 来思考您的分析:
- 每个发现尽可能由多个编码段落支持。
-
识别跨编码段落反复出现的主题或想法
-
- 注意任何矛盾或分歧观点
-
- 考虑这些段落如何与特定代码及研究的整体背景相关
-
- 反思数据的潜在深层意义或影响
10.5. 初步形成发现或模式的想法
现在,请以以下格式展示您的发现:
<<< findings>
- 反思数据的潜在深层意义或影响
-
发现简短标题
11.[详细解释发现,包括来自编码段落的支持证据] -
发现简短标题
12.[详细解释发现,包括来自编码段落的支持证据] -
[继续此格式列出所有发现]
13.</</</ findings>
请专注于生成富有洞察力、非琐碎的发现,为更深入理解研究主题做出贡献。确保您的发现有数据支持并与特定代码和整体研究背景相关。
参数
B. 1 代码手册的语义关联性
| KaTeX parse error: Expected 'EOF', got '#' at position 26: …hered} \text { #̲ 关系 } \\ N \end… | 关系分布 | ||||||
|---|---|---|---|---|---|---|---|
| MMM | C | PPP | UUU | τsem \tau_{\text {sem }}τsem | 平均 τsem \tau_{\text {sem }}τsem | ||
| 编码员 A - 编码员 B | |||||||
| 评估员 1 | 28 | 0.154 | 0.352 | 0.185 | 0.308 | 0.493 | |
| 评估员 2 | 49 | 0.154 | 0.386 | 0.445 | 0.015 | 0.647 | 0.584 |
| 评估员 3 | 47 | 0.339 | 0.301 | 0.122 | 0.238 | 0.611 | |
| 编码员 A - AI | |||||||
| 评估员 1 | 35 | 0.191 | 0.396 | 0.191 | 0.223 | 0.563 | |
| 评估员 2 | 45 | 0.064 | 0.522 | 0.382 | 0.032 | 0.620 | 0.638 |
| 评估员 3 | 101 | 0.364 | 0.523 | 0.000 | 0.113 | 0.730 | |
| 编码员 B - AI | |||||||
| 评估员 1 | 36 | 0.152 | 0.517 | 0.136 | 0.195 | 0.582 | |
| 评估员 2 | 72 | 0.030 | 0.688 | 0.222 | 0.060 | 0.623 | 0.545 |
| 评估员 3 | 36 | 0.061 | 0.515 | 0.016 | 0.409 | 0.429 |
表 4:注释者评估的人类编码员和 AICoE 的代码手册之间的关系分布
B. 2 代码分配的相关分数
| 访谈 ID | 人类 | AI | |
|---|---|---|---|
| 评估员 1 | 1 | 0.926 | 0.960 |
| 2 | 0.984 | 0.967 | |
| 3 | 0.994 | 0.992 | |
| 评估员 2 | 1 | 0.759 | 0.854 |
| 2 | 0.875 | 0.797 | |
| 3 | 0.872 | 0.671 | |
| 评估员 3 | 1 | 0.519 | 0.510 |
| 2 | 0.661 | 0.625 | |
| 3 | 0.667 | 0.461 | |
| 总平均值 | 0.806\mathbf{0 . 8 0 6}0.806 | 0.760\mathbf{0 . 7 6 0}0.760 |
(a) CVDQuoading 数据集的分数
| 访谈 ID | 人类 | AI | |
|---|---|---|---|
| 评估员 1 | 1 | 0.685 | 0.551 |
| 2 | 0.881 | 0.643 | |
| 3 | 0.966 | 0.935 | |
| 评估员 2 | 1 | 0.849 | 0.721 |
| 2 | 0.944 | 0.599 | |
| 3 | 0.896 | 0.673 | |
| 评估员 3 | 1 | 0.542 | 0.389 |
| 2 | 0.457 | 0.224 | |
| 3 | 0.444 | 0.263 | |
| 总平均值 | 0.740\mathbf{0 . 7 4 0}0.740 | 0.560\mathbf{0 . 5 6 0}0.560 |
(b) HiAICS 数据集的分数
表 5:每位访谈和评估员的人类和 AI 编码员的相关代码分配
B. 3 理论发现的评估
B.3.1 相关系数
| 标准 | E1-E2 | E1-E3 | E2-E3 |
|---|---|---|---|
| 基础 | -0.0430 | 0.0269 | 0.6471 |
| 相关性 | 0.0064 | 0.0603 | 0.1194 |
| 洞察力 | 0.0846 | -0.0384 | 0.2478 |
表 6:每位标准的评估者间相关系数
B.3.2 理论发现的质量
| 代码 | 基础 E1 E2 E3 | 平均 E1 \begin{aligned} & \text { 平均 } \\ & \text { E1 } \end{aligned} 平均 E1 | 相关性 E2 \begin{aligned} & \text { 相关性 } \\ & \text { E2 } \end{aligned} 相关性 E2 | 平均 E3 \begin{aligned} & \text { 平均 } \\ & \text { E3 } \end{aligned} 平均 E3 | 洞察力 E4 \begin{aligned} & \text { 洞察力 } \\ & \text { E4 } \end{aligned} 洞察力 E4 | 平均 E3 \begin{aligned} & \text { 平均 } \\ & \text { E3 } \end{aligned} 平均 E3 | 平均 E3 \begin{aligned} & \text { 平均 } \\ & \text { E3 } \end{aligned} 平均 E3 | 平均 E3 \begin{aligned} & \text { 平均 } \\ & \text { E3 } \end{aligned} 平均 E3 | 平均 E3 \begin{aligned} & \text { 平均 } \\ & \text { E3 } \end{aligned} 平均 E3 | 平均 E3 \begin{aligned} & \text { 平均 } \\ & \text { E3 } \end{aligned} 平均 E3 | 平均 E3 \begin{aligned} & \text { 平均 } \\ & \text { E3 } \end{aligned} 平均 E3 | 平均 E3 \begin{aligned} & \text { 平均 } \\ & \text { E3 } \end{aligned} 平均 E3 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Al Critique | 5 | 4 | 5 | 4.67 | 4 | 4 | 3 | 3.67 | 3 | 3 | 3 | 3.00 | 3.78 |
| 4 | 5 | 4 | 4.33 | 4 | 3 | 4 | 3.67 | 4 | 3 | 2 | 3.33 | 3.78 | |
| 4 | 5 | 4 | 3.73 | 4 | 3 | 4 | 4.33 | 3 | 5 | 4 | 4.00 | 4.22 | |
| 4 | 4 | 5 | 4.33 | 4 | 4 | 5 | 4.33 | 3 | 4 | 5 | 4.00 | 4.22 | |
| 3 | 2 | 1 | 2.00 | 4 | 2 | 4 | 3.33 | 4 | 3 | 4 | 3.67 | 3.00 | |
| Al for Science | 4 | 4 | 3 | 3.67 | 4 | 5 | 4 | 4.33 | 4 | 3 | 4 | 3.67 | 3.89 |
| 4 | 4 | 2 | 3.33 | 4 | 5 | 5 | 4.00 | 4 | 3 | 1 | 2.67 | 3.33 | |
| 4 | 5 | 5 | 4.67 | 5 | 5 | 4 | 4.00 | 4 | 3 | 3 | 3.33 | 4.00 | |
| 4 | 5 | 5 | 4.00 | 4 | 5 | 4 | 4.33 | 4 | 3 | 3 | 3.33 | 3.89 | |
| 3 | 4 | 4 | 3.67 | 4 | 5 | 4 | 4.33 | 4 | 4 | 3 | 3.67 | 3.89 | |
| Algorithm | 3 | 4 | 5 | 4.00 | 5 | 5 | 4 | 3.33 | 5 | 3 | 2 | 2.67 | 3.33 |
| 4 | 4 | 3 | 3.67 | 4 | 4 | 4 | 4.00 | 4 | 3 | 3 | 3.33 | 3.67 | |
| 4 | 3 | 3 | 3.33 | 4 | 3 | 4 | 3.67 | 4 | 3 | 4 | 3.67 | 3.56 | |
| 4 | 4 | 3 | 3.67 | 4 | 4 | 3 | 3.67 | 3 | 4 | 4 | 3.67 | 3.67 | |
| Algorithmic Biases | 4 | 5 | 5 | 4.67 | 4 | 5 | 4 | 4.33 | 4 | 5 | 3 | 4.00 | 4.33 |
| 4 | 5 | 5 | 4.00 | 4 | 5 | 4 | 4.33 | 3 | 4 | 4 | 3.67 | 4.00 | |
| 4 | 3 | 3 | 3.33 | 3 | 5 | 4 | 4.67 | 4 | 4 | 3 | 3.67 | 3.89 | |
| 4 | 4 | 4 | 4.00 | 4 | 3 | 3 | 3.33 | 4 | 3 | 3 | 3.33 | 3.55 | |
| 4 | 3 | 3 | 3.33 | 4 | 3 | 3 | 3.33 | 4 | 4 | 4 | 4.00 | 3.55 | |
| Autonomy & Agency | 3 | 3 | 4 | 3.33 | 4 | 3 | 3 | 3.00 | 4 | 2 | 2 | 2.67 | 3.00 |
| 4 | 3 | 3 | 3.33 | 4 | 2 | 3 | 3.00 | 4 | 2 | 3 | 3.00 | 3.11 | |
| 4 | 2 | 3 | 3.00 | 4 | 2 | 4 | 3.33 | 4 | 2 | 4 | 3.33 | 3.22 | |
| 3 | 2 | 3 | 2.67 | 3 | 3 | 3 | 3.00 | 3 | 2 | 2 | 2.33 | 2.67 | |
| 4 | 4 | 3 | 3.67 | 4 | 4 | 4 | 4.00 | 4 | 3 | 2 | 3.00 | 3.56 | |
| Biographical Context | 4 | 5 | 4 | 4.33 | 5 | 4 | 4 | 3.67 | 3 | 4 | 4 | 3.67 | 3.89 |
| 4 | 4 | 4 | 4.00 | 4 | 3 | 5 | 4.00 | 4 | 4 | 3 | 3.67 | 3.89 | |
| 3 | 3 | 3 | 3.00 | 3 | 4 | 4 | 3.67 | 3 | 3 | 3 | 3.00 | 3.22 | |
| 3 | 4 | 3 | 3.33 | 4 | 3 | 4 | 3.67 | 3 | 3 | 3 | 3.00 | 3.33 | |
| 4 | 3 | 3 | 3.33 | 3 | 3 | 4 | 3.33 | 3 | 3 | 4 | 3.33 | 3.33 | |
| Black Box | 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 3 | 3 | 2 | 2.67 | 3.45 |
| 4 | 2 | 3 | 3.00 | 4 | 3 | 4 | 3.67 | 4 | 4 | 3 | 3.67 | 3.45 | |
| 4 | 2 | 3 | 3.00 | 4 | 3 | 4 | 3.67 | 3 | 2 | 2 | 2.33 | 3.00 | |
| 2 | 2 | 3 | 2.33 | 4 | 4 | 4 | 4.00 | 3 | 3 | 4 | 3.33 | 3.22 | |
| Data | 4 | 4 | 4 | 4.00 | 3 | 3 | 4 | 3.33 | 2 | 3 | 3 | 2.67 | 3.33 |
| 4 | 3 | 3 | 3.33 | 4 | 4 | 5 | 4.33 | 4 | 4 | 3 | 3.67 | 3.78 | |
| 4 | 3 | 3 | 3.33 | 3 | 4 | 4 | 3.67 | 2 | 4 | 5 | 3.67 | 3.56 | |
| 3 | 4 | 4 | 3.67 | 3 | 4 | 4 | 3.67 | 3 | 3 | 3 | 3.00 | 3.45 | |
| Epoicenic and Intrastracional Media | 3 | 3 | 5 | 4.33 | 3 | 4 | 4 | 3.67 | 3 | 5 | 3 | 3.67 | 3.89 |
| 3 | 4 | 5 | 3.33 | 4 | 4 | 5 | 4.00 | 2 | 3 | 4 | 3.00 | 3.44 | |
| 4 | 3 | 3 | 3.33 | 4 | 4 | 5 | 4.33 | 3 | 4 | 4 | 3.67 | 3.78 | |
| 3 | 3 | 4 | 3.33 | 3 | 4 | 4 | 3.67 | 3 | 3 | 3 | 3.00 | 3.33 | |
| 3 | 2 | 2 | 2.33 | 3 | 4 | 5 | 4.00 | 3 | 3 | 5 | 3.67 | 3.33 | |
| Expert Systems | 4 | 4 | 4 | 4.00 | 4 | 4 | 5 | 4.33 | 4 | 4 | 3 | 3.67 | 4.00 |
| 3 | 4 | 3 | 3.33 | 4 | 4 | 4 | 4.33 | 3 | 3 | 3 | 3.00 | 3.55 | |
| 3 | 3 | 4 | 3.33 | 3 | 4 | 4 | 4.33 | 4 | 3 | 4 | 3.67 | 3.78 | |
| 4 | 3 | 3 | 3.33 | 4 | 4 | 5 | 4.33 | 4 | 3 | 4 | 3.67 | 3.78 | |
| Expertise | 3 | 4 | 4 | 3.67 | 4 | 4 | 4 | 4.33 | 4 | 4 | 3 | 3.67 | 3.67 |
| Compass. | 4 | 3 | 4 | 4.67 | 4 | 4 | 4 | 4.33 | 4 | 4 | 5 | 3.67 | 4.00 |
| 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.33 | 3 | 4 | 4 | 3.67 | 3.67 | |
| Visual Recognition | 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 3.67 | 4 | 3 | 4 | 3.67 | 3.56 |
| 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 3.67 | 3 | 3 | 4 | 3.67 | 3.67 | |
| Form | 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 4 | 3 | 3 | 3.33 | 3.67 |
| 3 | 4 | 4 | 4.00 | 4 | 2 | 4 | 3.33 | 4 | 4 | 4 | 4.00 | 3.78 | |
| Facial Recognition | 4 | 3 | 4 | 3.33 | 4 | 4 | 4 | 4.00 | 4 | 3 | 3 | 3.33 | 3.64 |
| 4 | 2 | 2 | 2.67 | 4 | 3 | 4 | 3.67 | 3 | 3 | 3 | 3.00 | 3.11 | |
| 3 | 2 | 2 | 2.33 | 3 | 4 | 3 | 3.33 | 3 | 2 | 2 | 2.33 | 2.66 | |
| 4 | 1 | 2 | 2.33 | 3 | 3 | 4 | 3.33 | 3 | 3 | 4 | 3.33 | 3.00 | |
| Generative AI | 4 | 5 | 4 | 4.33 | 4 | 4 | 4 | 4.00 | 4 | 4 | 4 | 4.00 | 4.11 |
| 3 | 3 | 3 | 3.00 | 3 | 4 | 4 | 4.33 | 3 | 3 | 3 | 3.00 | 3.22 | |
| 2 | 4 | 4 | 3.33 | 2 | 4 | 4 | 3.33 | 2 | 2 | 3 | 2.33 | 3.00 | |
| 3 | 3 | 3 | 3.00 | 3 | 4 | 4 | 3.67 | 3 | 3 | 4 | 3.33 | 3.33 | |
| 4 | 3 | 3 | 3.33 | 4 | 4 | 4 | 4.00 | 4 | 4 | 3 | 3.67 | 3.67 | |
| Algorithm | 3 | 4 | 5 | 4.00 | 5 | 5 | 4 | 3.33 | 5 | 3 | 2 | 2.67 | 3.33 |
| 4 | 4 | 3 | 3.67 | 4 | 4 | 4 | 4.33 | 4 | 3 | 3 | 3.33 | 3.67 | |
| 4 | 3 | 3 | 3.33 | 4 | 3 | 4 | 3.67 | 4 | 3 | 4 | 3.67 | 3.56 | |
| 4 | 4 | 3 | 3.67 | 4 | 4 | 5 | 4.33 | 4 | 3 | 4 | 3.67 | 3.78 | |
| Expertise | 3 | 4 | 4 | 3.67 | 4 | 4 | 4 | 4.33 | 4 | 4 | 3 | 3.67 | 3.67 |
| Compass. | 4 | 3 | 4 | 4.67 | 4 | 4 | 4 | 4.33 | 4 | 4 | 5 | 3.67 | 4.00 |
| 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.33 | 3 | 4 | 4 | 3.67 | 3.67 | |
| Visual Recognition | 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 3.67 | 4 | 3 | 4 | 3.67 | 3.56 |
| 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 3.67 | 3 | 3 | 4 | 3.67 | 3.67 | |
| Form | 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 4 | 3 | 3 | 3.33 | 3.67 |
| 3 | 4 | 4 | 4.00 | 4 | 2 | 4 | 3.33 | 4 | 4 | 4 | 4.00 | 3.78 | |
| Facial Recognition | 4 | 3 | 4 | 3.33 | 4 | 4 | 4 | 4.00 | 4 | 3 | 3 | 3.33 | 3.64 |
| 4 | 2 | 2 | 2.67 | 4 | 3 | 4 | 3.67 | 3 | 3 | 3 | 3.00 | 3.11 | |
| 3 | 2 | 2 | 2.33 | 3 | 4 | 3 | 3.33 | 3 | 2 | 2 | 2.33 | 2.66 | |
| 4 | 1 | 2 | 2.33 | 3 | 3 | 4 | 3.33 | 3 | 3 | 4 | 3.33 | 3.00 | |
| Generative AI | 4 | 5 | 4 | 4.33 | 4 | 4 | 4 | 4.00 | 4 | 4 | 4 | 4.00 | 4.11 |
| 3 | 3 | 3 | 3.00 | 3 | 4 | 4 | 4.33 | 3 | 3 | 3 | 3.00 | 3.22 | |
| 2 | 4 | 4 | 3.33 | 2 | 4 | 4 | 3.33 | 2 | 2 | 3 | 2.33 | 3.00 | |
| 3 | 3 | 3 | 3.00 | 3 | 4 | 4 | 3.67 | 3 | 3 | 4 | 3.33 | 3.33 | |
| 4 | 3 | 3 | 3.33 | 4 | 4 | 4 | 4.00 | 4 | 4 | 3 | 3.67 | 3.67 | |
| Format | 3 | 2 | 4 | 3.00 | 3 | 3 | 3 | 3.00 | 3 | 3 | 2 | 2.67 | 3.89 |
| 3 | 2 | 3 | 2.67 | 4 | 2 | 3 | 3.00 | 4 | 2 | 2 | 2.67 | 3.00 | |
| 4 | 3 | 3 | 3.67 | 4 | 4 | 4 | 4.33 | 4 | 4 | 3 | 3.67 | 3.56 | |
| Recognition | 4 | 2 | 3 | 3.00 | 4 | 2 | 4 | 3.33 | 4 | 2 | 4 | 3.33 | 3.22 |
| 3 | 2 | 3 | 2.67 | 3 | 3 | 3 | 3.300 | 3 | 2 | 2 | 2.33 | 2.67 | |
| 4 | 4 | 3 | 3.33 | 4 | 4 | 4 | 4.00 | 4 | 3 | 2 | 3.00 | 3.56 | |
| Political & Ecotoric | 4 | 5 | 4 | 4.33 | 3 | 4 | 4 | 4.33 | 4 | 5 | 3 | 4.00 | 4.33 |
| 4 | 4 | 4 | 4.00 | 4 | 3 | 4 | 4.33 | 3 | 4 | 4 | 3.67 | 3.89 | |
| 应用AI内容 | 3 | 3 | 3 | 3.00 | 3 | 4 | 4 | 4.33 | 3 | 3 | 3 | 3.00 | 3.22 |
| 3 | 4 | 3 | 3.33 | 3 | 3 | 4 | 3.33 | 3 | 3 | 3 | 3.00 | 3.33 | |
| 3 | 3 | 3 | 3.33 | 3 | 3 | 4 | 3.33 | 3 | 4 | 3 | 3.67 | 3.89 | |
| 3 | 4 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 4 | 3 | 3 | 3.33 | 3.67 | |
| 描述性AI | 3 | 4 | 4 | 4.00 | 4 | 2 | 4 | 3.33 | 4 | 4 | 4 | 3.67 | 3.89 |
| 4 | 3 | 3 | 3.00 | 4 | 3 | 4 | 3.33 | 3 | 4 | 4 | 3.67 | 3.89 | |
| 4 | 3 | 3 | 3.30 | 4 | 3 | 4 | 3.67 | 3 | 3 | 3 | 3.00 | 3.22 | |
| 3 | 2 | 2 | 2.33 | 4 | 4 | 4 | 4.00 | 3 | 3 | 4 | 3.33 | 3.22 | |
| 4 | 3 | 3 | 3.33 | 4 | 4 | 4 | 4.00 | 4 | 4 | 4 | 4.00 | 4.11 | |
| 3 | 3 | 4 | 3.33 | 3 | 4 | 4 | 3.67 | 3 | 4 | 3 | 3.33 | 3.44 | |
| 历史视角下的AI、ML、ANN | 3 | 3 | 4 | 3.33 | 4 | 4 | 4 | 4.00 | 4 | 4 | 3 | 4 | 3.67 |
| 3 | 3 | 3 | 3.00 | 3 | 3 | 4 | 3.33 | 3 | 3 | 2 | 2.67 | 3.00 | |
| 3 | 3 | 3 | 3.33 | 3 | 4 | 4 | 3.67 | 3 | 3 | 4 | 3.33 | 3.44 | |
| 3 | 4 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 4 | 3 | 2 | 3.00 | 3.56 | |
| 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 4 | 2 | 3 | 3.00 | 3.56 | |
| 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 4 | 3 | 4 | 3.67 | 3.78 | |
| 4 | 1 | 3 | 1.267 | 4 | 3 | 3 | 3.33 | 3 | 2 | 3 | 2.67 | 2.89 | |
| 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 4 | 3 | 3 | 3.33 | 3.67 | |
| 3 | 4 | 4 | 4.00 | 4 | 2 | 4 | 3.33 | 4 | 4 | 4 | 4.00 | 3.78 | |
| 4 | 3 | 2 | 3.00 | 4 | 4 | 4 | 4.00 | 4 | 3 | 3 | 3.33 | 3.44 | |
| 4 | 2 | 2 | 2.67 | 3 | 3 | 3 | 3.67 | 3 | 3 | 3 | 3.00 | 3.11 | |
| 3 | 2 | 2 | 2.33 | 3 | 4 | 3 | 3.33 | 3 | 2 | 2 | 2.33 | 2.66 | |
| 4 | 1 | 2 | 2.33 | 3 | 3 | 4 | 3.33 | 3 | 3 | 4 | 3.33 | 3.44 | |
| 专业意识形态 | 3 | 4 | 4 | 3.67 | 4 | 3 | 3 | 4.00 | 4 | 3 | 2 | 4 | 4.00 |
| 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 4 | 2 | 3 | 3.00 | 3.56 | |
| 4 | 3 | 4 | 3.67 | 2 | 4 | 4 | 4.33 | 2 | 2 | 3 | 3 | 2.67 | |
| 3 | 3 | 3 | 3.00 | 3 | 4 | 4 | 3.67 | 3 | 3 | 4 | 3.33 | 3.33 | |
| 4 | 3 | 3 | 3.33 | 4 | 4 | 4 | 4.00 | 4 | 4 | 3 | 3.67 | 3.67 | |
| 3 | 2 | 4 | 3.00 | 3 | 3 | 3 | 3.00 | 3 | 3 | 2 | 2.67 | 2.89 | |
| 3 | 2 | 3 | 2.67 | 4 | 2 | 3 | 3.00 | 3 | 2 | 4 | 3.00 | 2.89 | |
| 4 | 3 | 3 | 3.33 | 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 3.67 | |
| 4 | 2 | 3 | 3.00 | 4 | 3 | 4 | 3.67 | 3 | 3 | 4 | 3.33 | 3.33 | |
| 3 | 2 | 2 | 2.33 | 3 | 4 | 3 | 3.33 | 4 | 3 | 4 | 3.67 | 3.11 | |
| 2 | 5 | 4 | 3.67 | 3 | 4 | 4 | 3.67 | 3 | 4 | 3 | 3.33 | 3.56 | |
| AI 的使用… | 4 | 3 | 3 | 3.33 | 3 | 4 | 3 | 3.33 | 3 | 3 | 4 | 3.33 | 3.33 |
| 4 | 4 | 4 | 4.00 | 3 | 3 | 4 | 3.33 | 3 | 2 | 3 | 3.67 | 3.33 | |
| 3 | 2 | 2 | 2.33 | 3 | 4 | 3 | 3.33 | 3 | 2 | 2 | 2.33 | 2.66 | |
| 4 | 1 | 2 | 2.33 | 3 | 3 | 4 | 3.33 | 3 | 3 | 4 | 3.33 | 3.00 | |
| 4 | 3 | 4 | 4.33 | 4 | 4 | 4 | 4.00 | 4 | 3 | 4 | 4.00 | 4.11 | |
| 3 | 3 | 3 | 3.00 | 3 | 4 | 4 | 3.67 | 3 | 3 | 3 | 3.00 | 3.22 | |
| 2 | 4 | 4 | 3.33 | 2 | 4 | 4 | 3.33 | 2 | 2 | 3 | 3 | 2.67 | |
| 3 | 3 | 3 | 3.00 | 3 | 4 | 4 | 3.67 | 3 | 3 | 4 | 3.33 | 3.33 | |
| 4 | 3 | 3 | 3.33 | 4 | 4 | 4 | 4.00 | 4 | 4 | 3 | 3.67 | 3.67 | |
| 3 | 2 | 4 | 3.00 | 3 | 3 | 3 | 3.00 | 3 | 3 | 2 | 2.67 | 2.89 | |
| 3 | 2 | 3 | 2.67 | 4 | 2 | 3 | 3.00 | 3 | 2 | 4 | 3.00 | 2.89 | |
| 4 | 3 | 3 | 3.33 | 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 3.67 | |
| 4 | 2 | 3 | 3.00 | 4 | 3 | 4 | 3.67 | 3 | 3 | 4 | 3.33 | 3.33 | |
| 3 | 2 | 2 | 2.33 | 3 | 4 | 3 | 3.33 | 4 | 3 | 4 | 3.67 | 3.11 | |
| 2 | 5 | 4 | 3.67 | 3 | 4 | 4 | 3.67 | 3 | 4 | 3 | 3.33 | 3.56 | |
| AI 的使用… | 2 | 5 | 4 | 3.67 | 3 | 4 | 4 | 3.67 | 3 | 4 | 3 | 3.33 | 3.56 |
| 4 | 3 | 3 | 3.33 | 3 | 4 | 3 | 3.33 | 3 | 3 | 4 | 3.33 | 3.33 | |
| 4 | 4 | 4 | 4.00 | 3 | 3 | 4 | 3.33 | 3 | 2 | 3 | 3.67 | 3.33 | |
| 3 | 2 | 2 | 1.7200 | 3 | 4 | 3 | 3.33 | 3 | 3 | 2 | 2.67 | 2.67 | |
| 4 | 3 | 3 | 3.33 | 4 | 5 | 4 | 4.33 | 4 | 3 | 4 | 4.00 | 4.11 | |
| 3 | 3 | 3 | 3.00 | 3 | 4 | 4 | 3.67 | 3 | 3 | 3 | 3.00 | 3.22 | |
| 2 | 4 | 4 | 3.33 | 2 | 4 | 4 | 3.33 | 2 | 2 | 3 | 3 | 2.67 | |
| 3 | 3 | 3 | 3.00 | 3 | 4 | 4 | 3.67 | 3 | 3 | 4 | 3.33 | 3.33 | |
| 4 | 3 | 3 | 3.33 | 4 | 4 | 4 | 4.00 | 4 | 4 | 3 | 3.67 | 3.67 | |
| 3 | 2 | 4 | 3.00 | 3 | 3 | 3 | 3.00 | 3 | 3 | 2 | 2.67 | 2.89 | |
| 3 | 2 | 3 | 2.67 | 4 | 2 | 3 | 3.00 | 3 | 2 | 4 | 3.00 | 2.89 | |
| 4 | 3 | 3 | 3.33 | 4 | 3 | 4 | 3.67 | 4 | 4 | 4 | 4.00 | 3.67 | |
| 4 | 2 | 3 | 3.00 | 4 | 3 | 4 | 3.67 | 3 | 3 | 4 | 3.33 | 3.33 | |
| 3 | 2 | 2 | 2.33 | 3 | 4 | 3 | 3.33 | 4 | 3 | 4 | 3.67 | 3.11 | |
| AI 的使用… | 2 | 5 | 4 | 3.67 | 3 | 4 | 4 | 3.67 | 3 | 4 | 3 | 3.33 | 3.56 |
| 4 | 3 | 3 | 3.33 | 3 | 4 | 3 | 3.33 | 3 | 3 | 4 | 3.33 | 3.33 | |
| 4 | 4 | 4 | 4.00 | 3 | 3 | 4 | 3.33 | 3 | 2 | 3 | 3.67 | 3.33 | |
| 3 | 2 | 2 | 1.7200 | 3 | 4 | 3 | 3.33 | 3 | 3 | 2 | 2.67 | 2.67 | |
| 4 | 3 | 3 | 3.33 | 4 | 5 | 4 | 4.33 | 4 | 3 | 4 | 3.67 | 3.78 | |
| 平均值 | 3.64 | 3.22 | 3.41 | 3.42 | 3.66 | 3.75 | 3.86 | 3.76 | 3.41 | 3.19 | 3.27 | 3.29 | 3.49 |
表 7:所有发现的评估结果,涵盖所有三位评估员和标准
C 示例输出
C. 1 代码手册
代码手册比较
编码员 1
-
AI 批判
-
- 科学中的 AI
-
- 算法
-
- 算法偏差
-
- 自主性与能动性
-
- 生平背景
-
- 黑箱
-
- 数据
-
- 媒体认知与基础设施
-
- 专家系统
-
- 专业知识与能力
-
- 人脸识别
-
- 与 AI 的初次接触
-
- 格式
-
- 生成型 AI
-
- AI、机器学习、人工神经网络的历史视角
-
- 图像
-
- 机构
-
- 机器学习、人工神经网络、深度学习
-
- 媒体研究 - 图像科学 视觉文化研究
-
- 模式识别
-
- (应用)AI 的政治与经济背景
-
- 项目描述
-
- 出版物
-
- 研究兴趣、挑战、局限性
-
- 传感器、基础设施与平台
-
- AI 的推测、意识形态、想象
-
- 条款与定义
-
- 工具与方法
-
- 信任
-
- AI 的用途…
编码员 2
- AI 的用途…
-
AI 批判
-
- AI 历史
-
- 工作自动化
-
- 商业化
-
- 研究连续性
-
- 数据可用性
-
- 数据实践
-
- 学科定义
-
- AI 描绘
-
- 专业知识
-
- 未来研究领域
-
- 气候科学历史
-
- 学科历史
-
- 人脸识别历史
-
- 摄影历史
-
- 物理学历史
-
- 访谈技术细节
-
- 大型语言模型
-
- AI 局限性
-
- AI 带来的新问题
-
- 模式识别
-
- 个人对 AI 的方法
-
- AI 的哲学含义
-
- 基础设施的政治
-
- 可能的 AI 应用
-
- 气候科学中的实践
-
- 预测
-
- 编程实践
-
- 研究近期发展
-
- 最近的个人工作
-
- 最近的出版物
-
- 研究实践
-
- 基于规则的 AI
-
- AI 引发的断裂
AICoE
- AI 应用
-
- AI 批判
-
- 自动化
-
- 影像科学
-
- 黑箱问题
-
- 气候科学
-
- 批判理论
-
- 数据质量
-
- 数字素养
-
- 认识论问题
-
- 认识论
-
- 伦理
-
- 提取主义
-
- 人脸识别
-
- 未来方向
-
- 不确定性
-
- 生成型 AI
-
- 人机交互
-
- 图像操控
-
- 基础设施
-
- 跨学科
-
- 机器学习
-
- 媒体影响
-
- 模型局限性
-
- 新殖民主义
-
- 神经网络
-
- 模式识别
-
- 预测挑战
-
- 风格转换
-
- 监控资本主义
-
- 不确定性
-
- 视觉文化
图 2:两位人类编码员和 AICoE 系统用于分析 HiAICS 数据时开发的代码手册的并排比较。该比较突显了重叠主题、不同的编码方法以及技术概念、历史视角、伦理考量和个人访谈者经历等类别的不同侧重点。
- 视觉文化
C. 2 代码手册关系
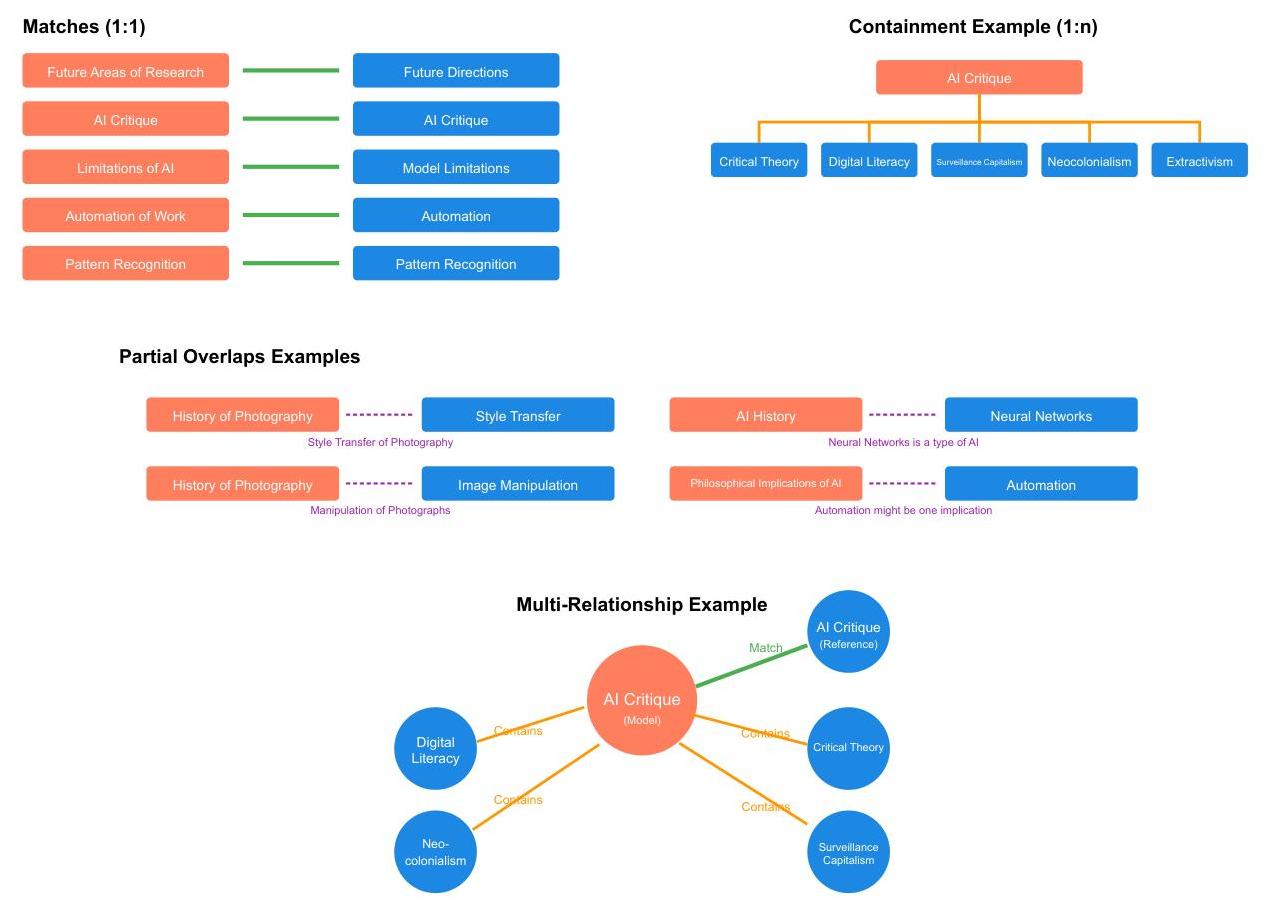
图 3:由我们的一位专家注释员标注的人工开发代码手册与 AICoE 代码手册之间选定关系的示例可视化
C. 3 发现
发现 1 质量评分:4.33
算法偏差的普遍性
编码段落表明算法偏差并非局限于特定领域,而是广泛影响各种 AI 和机器学习应用的问题。例如,在 20240905 的访谈中,发言者 0 讨论了当系统遇到新数据时,偏差如何导致气候建模中的错误预测。同样,发言者 0 在 20241016 的访谈中强调了面部识别技术中持续存在的偏差问题。这种普遍性凸显了需要一种全面的方法来解决偏差,考虑每个领域的独特挑战和影响。
发现 2 质量评分:4.33
跨学科方法应用于视觉文化
编码段落表明将图像科学(关注单一、自主的图像)与媒体研究(考虑图像经济和基础设施)相结合,可以更全面地理解 AI 对视觉文化的影响。这在发言者 0 在 20241016 的访谈中的评论中很明显,他们提到需要结合图像科学与媒体研究的方法来处理历史上的单一图像和更广泛的图像生态。这种整合对于导航视觉内容生产和分析不断变化的格局至关重要,特别是在 AI 生成图像出现的情况下。
发现 3 质量评分:4.00
专家系统的演变
专家系统的概念经历了显著的演变,从依赖基于规则的系统和知识工程到采用更多数据驱动的方法。这种转变在发言者 1 在 20141016 的讨论中显而易见,他们提到,“今天,如果你想构建一个类似的概念,一个专家系统,而不是采访专家、医生,请告诉我这些症状和疾病等等,你会使用数据,原始数据。” 这种演变表明转向利用机器学习,并可能涉及生成型 AI 模型,正如在同一访谈中提到“生成预训练变压器”所暗示的那样。
图 4:AI 共民族志学者从 HiAICS 数据集中生成的高质量发现,由三位评估员评分。质量评分(1.00-5.00)代表所有评估员和标准的平均值。
D 人类评估界面
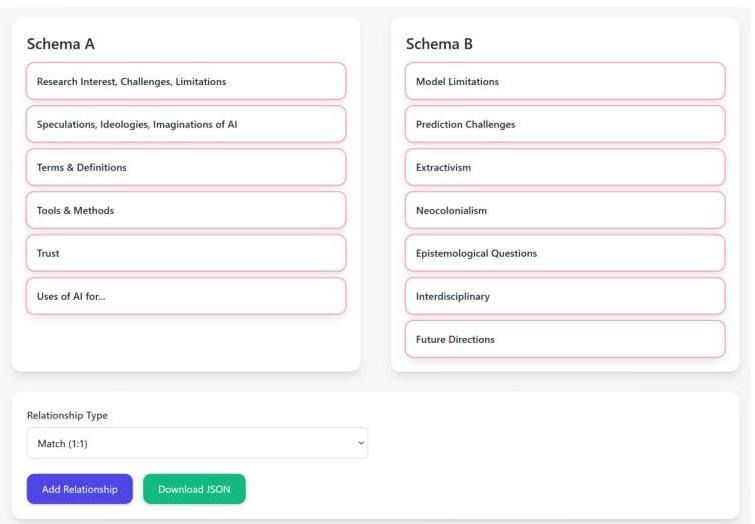
图 5:允许人类注释员指定不同代码手册之间关系的评估界面
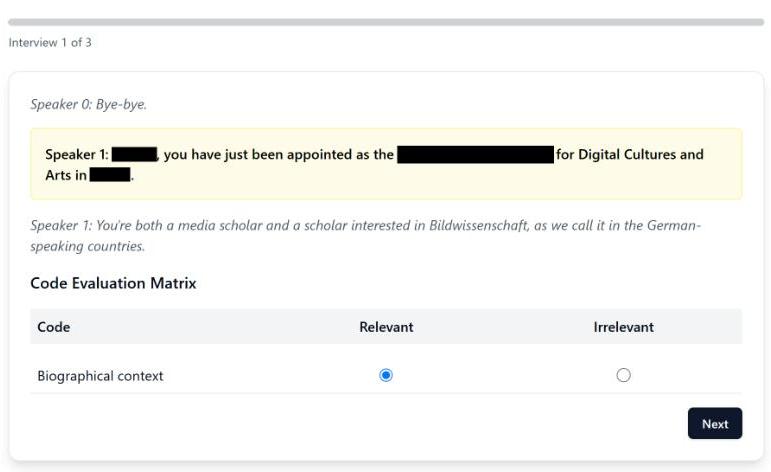
图 6:人类注释员用来评估代码分配相关性的评估界面
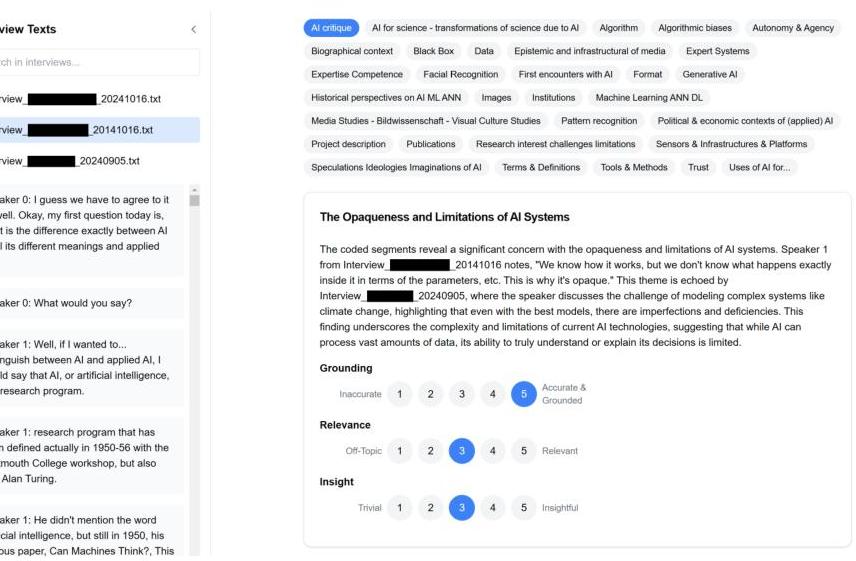
图 7:人类注释员用来评估 AICoE 生成的理论发现的评估界面
参考论文:https://arxiv.org/pdf/2505.00012

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 19
 0
- 0


 已为社区贡献17条内容

所有评论(0)