论文阅读——基于Transformer的仿强化学习多机器人路径规划(IF==11.7)
·
原文链接
贡献
1)提出了一种基于Transformer结构的新型策略神经网络。通过该网络从观测状态中提取的特征表示不仅编码了机器人之间的隐含关系,而且与有效且无冲突的导航信号建立了强相关性。据我们所知,首次引入Transformer结构来解决MRPP问题
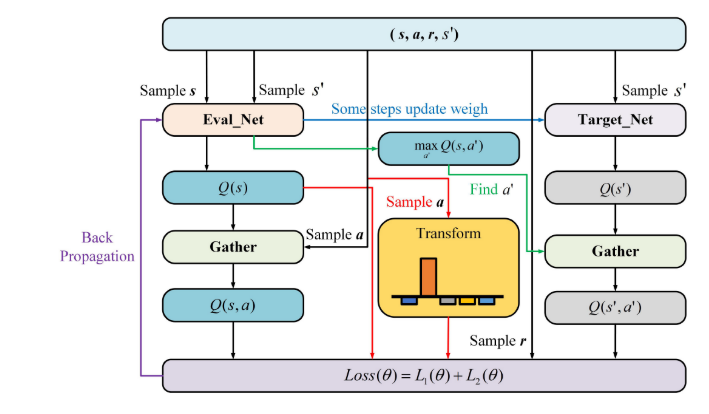
2)将对比学习和强化学习相结合,提出了一个模仿强化学习框架。它解决了在引入Transformer结构后,训练深度策略神经网络的困难,特别是当来自强化学习的弱奖励提供监督信号时
3)在仿真环境中对所提出的策略进行了综合评估,并在机器人之间没有通信的情况下取得了最佳的性能
动作空间
离散动作
奖励:
碰撞-0.5
到达目标+3
基于Transformer的模仿强化学习
基于transformer的策略网络
提出了一种基于Transformer结构的动态神经网络。它映射了当前对其周围环境和动作的观察,并已被用来近似机器人在部分可观察的网格世界中的策略

观察数据包含以机器人本身为中心的静态障碍物和其他机器人位置信息。
观测数据的通道数为6个,每个通道的大小为9 × 9。观测数据隐含着机器人之间的协作信息,包括以机器人为中心的远、近障碍物坐标。
根据前、后、左、右、左前、右前、左后、右后八个方向上的远近障碍物信息,将观测数据o ∈ R9×9×6分为九个部分oi p ∈ R3×3×6(i ∈ [1,9])。

输入 → 分块展平 → MLP映射 → 拼接o_action → 位置编码 → [Transformer块 × L] → 输出模仿强化学习方法

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献2条内容

所有评论(0)