Langchain-构建向量数据库和检索器
·
向量数据库安装
pip install langchain-chroma
文档》向量存储》向量数据库。
和0416 提示词工程相同。
初始化
import os

from langchain_chroma import Chroma
from langchain_community.chat_message_histories import ChatMessageHistory
from langchain_core.documents import Document
from langchain_core.messages import HumanMessage
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables import RunnableWithMessageHistory, RunnableLambda, RunnablePassthrough
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langserve import add_routes

os.environ['http_proxy'] = '127.0.0.1:7890'
os.environ['https_proxy'] = '127.0.0.1:7890'

os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_PROJECT"] = "LangchainDemo"
os.environ["LANGCHAIN_API_KEY"] = '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'

# 聊天机器人案例
# 创建模型
model = ChatOpenAI(model='gpt-4-turbo')
测试文档数据:
# 准备测试数据 ,假设我们提供的文档数据如下:
documents = [
    Document(
        page_content="狗是伟大的伴侣,以其忠诚和友好而闻名。",
        metadata={"source": "哺乳动物宠物文档"},
    ),
    Document(
        page_content="猫是独立的宠物,通常喜欢自己的空间。",
        metadata={"source": "哺乳动物宠物文档"},
    ),
    Document(
        page_content="金鱼是初学者的流行宠物,需要相对简单的护理。",
        metadata={"source": "鱼类宠物文档"},
    ),
    Document(
        page_content="鹦鹉是聪明的鸟类,能够模仿人类的语言。",
        metadata={"source": "鸟类宠物文档"},
    ),
    Document(
        page_content="兔子是社交动物,需要足够的空间跳跃。",
        metadata={"source": "哺乳动物宠物文档"},
    ),
]
向量数据库构建
Chroma.from_documents:返回一个向量空间。
vector_store.similarity_search_with_score( ‘xxx’ ) :返回相似度分数排序,分越低,越相似。
vector_store.similarity_search():直接返回相似搜索,不计算分数。
Chain的链接对象,必须是Runnable对象,但Chroma.from_documents不是;因此要,RunnableLamb生成检索器对象retriever;并通过.bind(k=1)取相似度最高的。
retriever.batch([ 'xxx' , 'xxx' ]):通过batch进行批量处理多个输入请求。
## 0416中,SemanticSimilarityExampleSelector直接从示例集中进行相似度选择;但俩者不同——本处是构建向量数据库,0416是示例集。
# 实例化一个向量数空间
vector_store = Chroma.from_documents(documents
    , embedding=OpenAIEmbeddings())

# 相似度的查询: 返回相似的分数, 分数越低相似度越高
# print(vector_store.similarity_search_with_score('咖啡猫'))

# 检索器: bind(k=1) 返回相似度最高的第一个
# 将vector_store.similarity_search方法转换为可执行对象,会自动调用获取返回。
retriever = RunnableLambda(vector_store.similarity_search).bind(k=1)

# print(retriever.batch(['咖啡猫', '鲨鱼']))


resp = chain.invoke('请介绍一下猫?')

print(resp.content)

检索器+模型
这里message中,还需要question、context参数,因此chain中需要先传参;
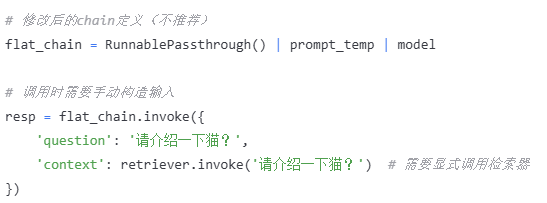
# 由于要根据用户输入进行检索,通过RunnablePassthrough允许我们将用户的问题稍后再 传递给prompt和model。这样用户只需要 输入,不需要处理上下文获取(模块越多,RunnablePassthrough越高效)。
## 按下图这种,需要显示调用检索器。
# 提示模板
# 这边是相当于,把message拿出来单写
message = """
使用提供的上下文仅回答这个问题:
{question}
上下文:
{context}
"""

prompt_temp = ChatPromptTemplate.from_messages([('human', message)])

# RunnablePassthrough允许我们将用户的问题之后再传递给prompt和model。
chain = {'question': RunnablePassthrough()
    , 'context': retriever} | prompt_temp | model

resp = chain.invoke('请介绍一下猫?')

print(resp.content)


北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献3条内容

所有评论(0)