python面试总结
目录
3、什么是默认参数?什么是可变参数(*args 和 **kwargs)
4、什么是递归函数?如何使用 lambda 函数?请给出示例。
8、如何使用 map()、filter() 、reduce()和zip 函数?
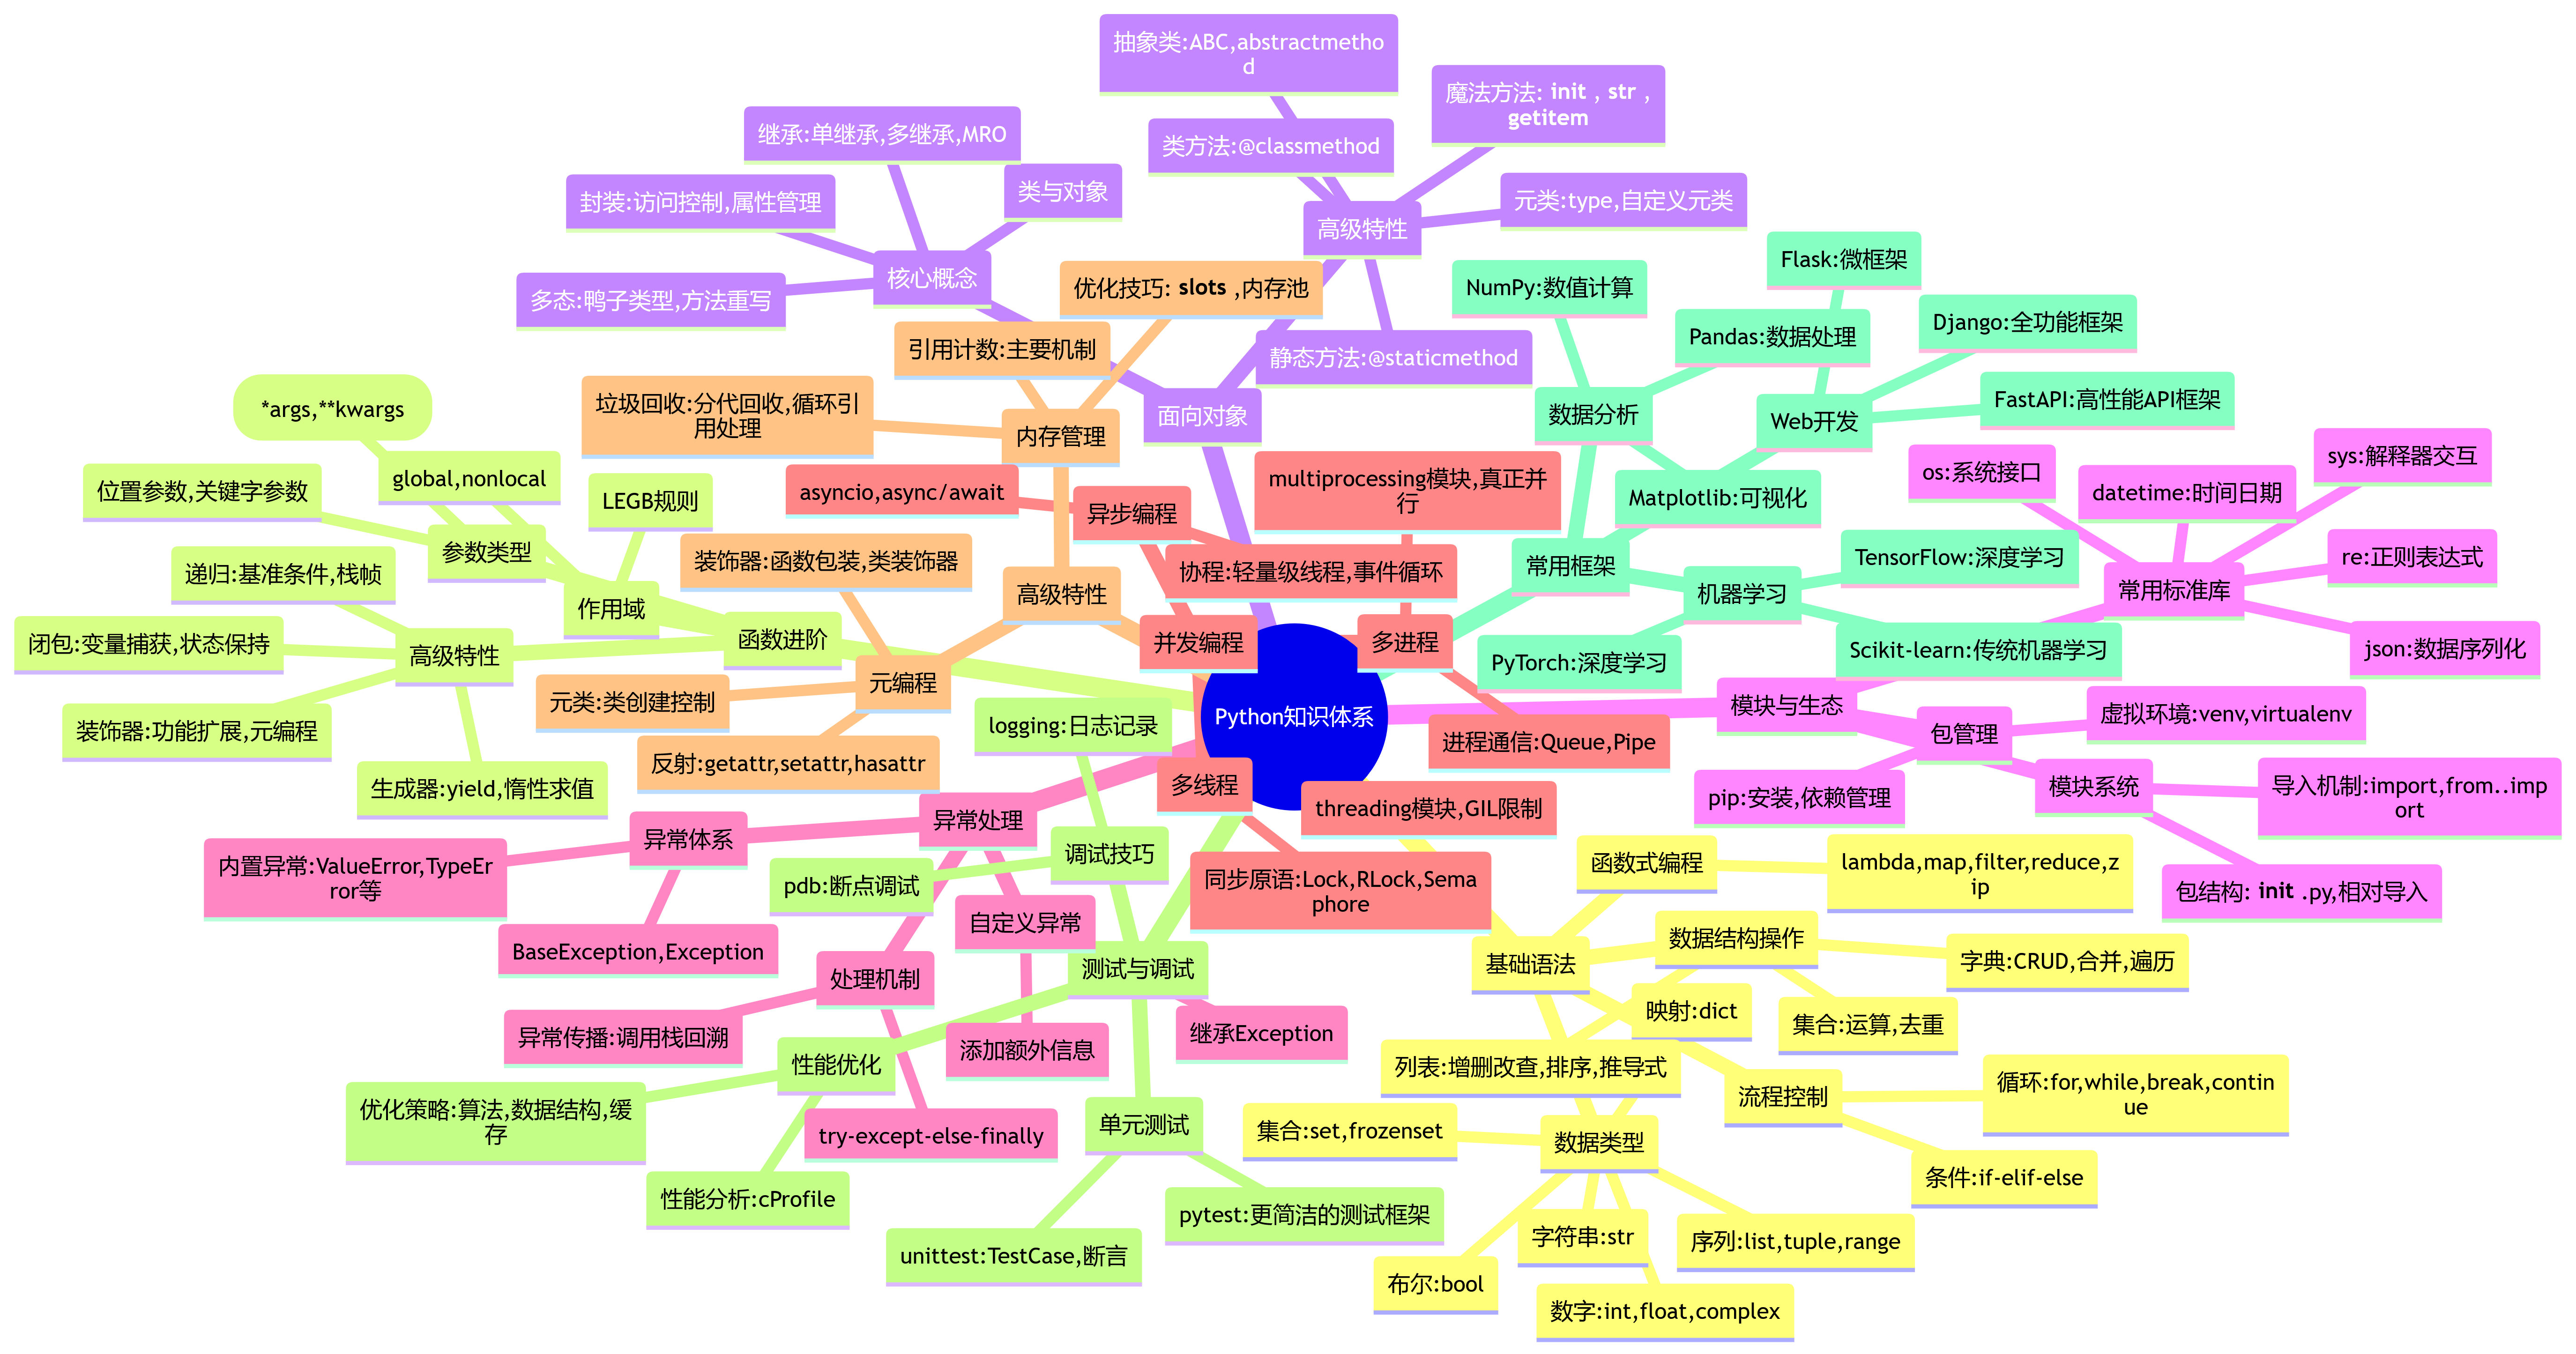
Python基础
1、python及其特点
Python 是一种由 Guido van Rossum 于 1991 年发布的高级、解释型、交互式、面向对象的脚本语言。它具有清晰简洁的语法、丰富的标准库和强大的社区生态,常用于 Web 开发、数据分析、人工智能、自动化运维、科学计算等领域。Python 强调可读性和简洁性,让开发者能用更少的代码完成更多的工作;
特点如下:简洁易读:通过强制缩进(Indentation)来组织代码块,避免了冗长的括号和关键字。动态类型:变量在运行时才绑定类型,代码更灵活。丰富的标准库(“Batteries included”):内置模块涵盖文件 I/O、网络通信、正则、数据库、XML、测试等各方面。多范式支持:支持过程式、面向对象、函数式编程。跨平台:同一份代码可在 Windows、macOS、Linux 等平台运行。可扩展性:可通过 C/C++/Java 等语言编写扩展模块,提升性能或复用已有代码。自动内存管理:垃圾回收机制(GC)和引用计数,减少内存泄漏风险。强大的社区和第三方生态:PyPI 上有超过 40 万个包,几乎涵盖所有应用场景。
2、动态类型和静态类型?
动态类型(Dynamic Typing):变量在运行时才绑定类型,类型检查在运行时进行,赋值时可改变类型。
静态类型(Static Typing):变量在编译时就确定类型,类型不易改变,编译器会在编译阶段进行类型检查。
| 特性 | 静态类型语言 | 动态类型语言 |
|---|---|---|
| 类型检查时间 | 编译时 | 运行时 |
| 变量声明 | 需要指定类型 | 不需要指定类型 |
| 灵活性 | 较低 | 较高 |
| 错误发现时间 | 编译阶段 | 运行阶段 |
| 典型语言 | Java、C++、Go | Python、JavaScrip |
3、变量命名规则是什么?
1)、由字母(A–Z、a–z)、数字(0–9)和下划线(_)组成;2)、不能以数字开头;区分大小写(myVar ≠ myvar);3)、不能使用 Python 保留关键字(如 if、for、class 等);4)、推荐遵循 PEP8 风格:模块和函数使用 snake_case,类使用 CamelCase。尽量语义化命名,避免单字符(除循环索引等常见场景)。
4、基本数据类型有哪些?
数值:int(任意精度整数)、float(双精度浮点)、complex(复数)
布尔:bool(True/False)、文本:str(Unicode 字符串)
二进制:bytes(不可变)、bytearray(可变);序列:list(可变)、tuple(不可变)、range
集合:set(可变)、frozenset(不可变)
映射:dict(键值对)、特殊:NoneType(仅有值 None)
Python中列表list于元组tuple的区别
| 特性 | 列表 (list) | 元组 (tuple) |
|---|---|---|
| 可变性 | 可变(mutable) | 不可变(immutable) |
| 语法 | [1, 2, 3] | (1, 2, 3) 或 1,2,3 |
| 适用场景 | 需要频繁增删改 | 固定数据、可做字典键 |
| 性能 | 稍慢,内存稍大 | 稍快,内存稍小 |
| 方法 | append, pop, ... | 仅 count, index |
| 类型 | 特点 | 使用场景 |
|---|---|---|
| 列表 | 有序、可变、允许重复 | 需要有序存储且频繁修改元素时 |
| 元组 | 有序、不可变、允许重复 | 不希望数据被修改的场景 |
| 集合 | 无序、不重复、可变 | 去重、集合运算 |
| 字典 | 无序、键值对存储、可变 | 需要快速查找和映射关系时 |
可变类型与不可变类型
可变类型(Mutable):对象的值可以被修改,修改后对象的内存地址不变。不可变类型(Immutable):对象的值不能被修改,任何修改都会创建新的对象,其引用不变。
| 类型 | 是否可变 | 说明 |
|---|---|---|
| 整数(int) | 不可变 | 数值一旦创建不可更改 |
| 浮点数(float) | 不可变 | 同上 |
| 字符串(str) | 不可变 | 字符串内容不能被修改 |
| 元组(tuple) | 不可变 | 元素不可变,整体不可修改 |
| 列表(list) | 可变 | 可以修改、添加、删除元素 |
| 字典(dict) | 可变 | 可以修改键值对 |
| 集合(set) | 可变 | 可以添加或删除元素 |
a = [1, 2, 3]
b = a        # b 引用同一对象
a.append(4)  # 原地修改
print(b)     # [1, 2, 3, 4]

x = "hi"
y = x
x += "!"
print(y)     # "hi"(原字符串未改,x 指向新对象)
列表中添加元素、删除元素、反转列表,找到列表最大最小值,列表排序、列表推导式?
| 添加元素 | append(x):列表末尾添加单个元素; extend(iterable):列表末尾添加可迭代对象中的所有元素; insert(i,x)在索引i处插入元素x extend 相当于多次调用 append,但底层做了优化 |
| 删除元素 | pop([i]):移除并返回索引 i 处的元素,默认最后一个。 remove(x):移除第一个值为 x 的元素。 del lst[i:j]:删除切片或单个元素。 clear():清空整个列表 |
| 反转列表 | reverse():原地反转,返回 None。 切片:lst[::-1],返回一个新的反转列表。 reversed():返回一个迭代器,可用于遍历或 list() 转换 |
| 查找 | max(lst) / min(lst):返回列表中的最大/最小元素。 key 参数:可接收函数,如 max(lst, key=lambda x: abs(x-10)) |
| 列表排序 | lst.sort(key=…, reverse=…):原地排序,返回 None sorted(lst, key=…,reverse=…):返回新排序列表不改变原列表 key 参数:接收函数,如 key=lambda x: x.lower()。 reverse=True:降序。 |
| 列表推导 | 在一行内用表达式和循环/条件生成列表,语法简洁、可读性高,通常比 map/filter 更 Pythonic |
st = [1, 2, 3]
lst.append(4)              # [1, 2, 3, 4]
lst.extend([5, 6])         # [1, 2, 3, 4, 5, 6]
lst.insert(0, 0)           # [0, 1, 2, 3, 4, 5, 6]
lst = [0, 1, 2, 3, 4, 5, 6]
x = lst.pop()              # x=6, lst=[0,1,2,3,4,5]
y = lst.pop(0)             # y=0, lst=[1,2,3,4,5]
lst.remove(3)              # lst=[1,2,4,5]
del lst[1:3]               # lst=[1,5]
lst.clear()                # lst=[]
lst = [1, 2, 3, 4]
lst.reverse()              # lst=[4,3,2,1]
rev = lst[::-1]            # rev=[1,2,3,4]  # 新列表
for x in reversed(lst):    # 迭代:4,3,2,1
    print(x)
lst = [3, 1, 4, 1, 5, 9]
mx = max(lst)                      # 9
mn = min(lst)                      # 1
# 按距离 6 最近来找最大
mx2 = max(lst, key=lambda x: -abs(x-6))
# 相当于找距离 6 最远的元素
fruits = ['banana', 'Apple', 'cherry']
# 原地排序(区分大小写)
fruits.sort()                 # ['Apple','banana','cherry']
# 不区分大小写
fruits.sort(key=str.lower)    # ['Apple','banana','cherry']
desc = sorted(fruits, reverse=True)  # 降序
#列表推导式
squares = [x*x for x in range(10)] #平方
evens   = [x for x in range(20) if x % 2 == 0] #带条件
pairs   = [(i, j) for i in 'ABC' for j in range(3)] #嵌套循环
5、Python 中字典?
| 创建字典 | 字面量:{key1: value1, key2: value2} 构造函数:dict() 或 dict([(k1, v1), (k2, v2)]) 推导式:{k: v for k, v in iterable} fromkeys:用相同的默认值创建多个键 |
| 字典合并 | {**d1, **d2}(Python 3.5+):优雅解包,新字典中后者覆盖前者。 d1.update(d2):原地更新 d1,返回 None。 ChainMap:collections.ChainMap(d1, d2),创建视图,不复制。 |
| 遍历键和值 | for key in d::遍历键。 for key, val in d.items()::遍历键-值对。 |
d1 = {'name': 'Alice', 'age': 30} # 字面量

# 构造函数
d2 = dict(name='Bob', age=25)
d3 = dict([('x', 1), ('y', 2)])

nums = [1,2,3]
squares = {n: n*n for n in nums}  # {1:1,2:4,3:9}  # 推导式

# fromkeys
keys = ['a','b','c']
d4 = dict.fromkeys(keys, 0)       # {'a':0,'b':0,'c':0}
d1 , d2= {'a': 1, 'b': 2} d2 = {'b': 3, 'c': 4}

merged = {**d1, **d2}   # {'a':1,'b':3,'c':4}
d1.update(d2)           # d1={'a':1,'b':3,'c':4}
from collections import ChainMap
view = ChainMap(d2, d1) # lookup 顺序 d2 -> d1

for k in d:   #键
    print(k, d[k])
for k, v in d.items():   #键值对
    print(k, v)
for v in d.values():  #值
    print(v)
6、集合set是什么?有什么特点?
集合:无序、元素唯一的可变容器,底层基于哈希表。
特点:自动去重; 支持高效的并集、交集、差集、对称差集运算;
元素必须可哈希(immutable); 常用于去重、成员测试、数学集合运算。
7、python的字符串格式化
百分号老式格式化:name = "Alice"; age = 30 s = "Name: %s, Age: %d" % (name, age)
Str.format() (推荐于python3.0)
s="Name:{},Age:{}".format(name,age) s="Name:{n},Age: {a}".format(n=name, a=age)
f-字符串(f-strings,Python 3.6+,最简洁高效):
s = f"Name: {name}, Age: {age}" # 支持表达式和格式说明
pi = 3.14159 s2 = f"Pi ≈ {pi:.2f}"
函数
1、什么是函数?如何定义一个函数?
可重复使用的代码单元,封装特定功能(封装性),python的函数是类的一等对象,意思它可以像基本类型一样的待遇和特性。可以嵌套定义、可作为参数传递、携带状态(通过闭包或类装饰器)
def fun_name(parame: type_hint)->returntype:
    """Docstring (PEP 257规范)"""
 # 函数体
    return  expression
类型注解(Type Hints)提升代码可读性,文档字符串自动生成API文档(可通过_doc__访问),返回None时可省略return语句
2、什么是参数和返回值,如何在函数中返回多个值?
参数是传递给函数的数据,可以在函数定义时指定多个参数,这些参数在函数执行时提供输入
返回值是函数执行后的结果通过return返回结果,无return语句时隐式返回None;协程函数(async def)返回coroutine对象
形参:位置参数、默认参数、关键字参数; 实参:解包操作符*和** 参数传递方式位对象引用(共享传参; 返回多个值实质是返回元组(tuple packing/unpacking)x, y = fun_name()
参数顺序规则:1、位置参数;2、默认参数;3、*args;4、关键字参数;5、**kwargs
3、什么是默认参数?什么是可变参数(*args 和 **kwargs)
默认参数是在函数定义时给参数指定的默认值。如果调用函数时未提供该参数,函数会使用默认值
*args:用于传递任意数量的位置参数,这些参数会被包装成一个元组。原理:收集多余位置参数为元组,星号解包可用于函数调用
**kwargs:用于传递任意数量的关键字参数,这些参数会被包装成一个字典。原理:收集关键字参数为字典,双星号解包字典为关键字参数
def greet(name, greeting="Hello"):
    return f"{greeting}, {name}!"

print(greet("Alice"))      # 输出: Hello, Alice!
print(greet("Bob", "Hi"))  # 输出: Hi, Bob!

def sum_numbers(*args):
    return sum(args)

sum_numbers(1,2,3)  # 6

def config_logger(**settings):
    level = settings.get('level', 'INFO')
    # ...

config_logger(level='DEBUG', format='json')
4、什么是递归函数?如何使用 lambda 函数?请给出示例。
递归函数是函数在其自身的定义中调用自身。递归通常用于分治问题,比如计算阶乘、斐波那契数列等。递归函数必须有一个基准条件,用于终止递归。
def factorial(n): #通过调用自身来计算阶乘
    if n == 0:  # 基准条件
       return 1
    else:
        return n * factorial(n - 1)
print(factorial(5))  # 输出: 120
lambda 函数是一个匿名函数,它可以有任意数量的参数,但只能有一个表达式。lambda 函数通常用于需要一个简单函数的场景,如函数式编程和内联计算。add = lambda x, y: x + y (创建匿名函数,接收两个参数并返回他们的和) print(add(2, 3)) # 输出: 5
5、什么是装饰器?请给出示例。
**装饰器(Decorator)**是一个函数,它可以动态地修改另一个函数的功能。装饰器通常用于函数的扩展、日志记录、权限检查等场景
def decorator_function(original_function):
    def wrapper_function():
        print("Wrapper executed before the function.")
        return original_function()
    return wrapper_function

@decorator_function
def display():
    return "Display function executed"

print(display())  # 输出: Wrapper executed before the function. Display function executed
decorator_function是一个装饰器它接收一个函数作为参数返回一个修改后的函数 wrapper_function
高级技巧:1、带参数的装饰器(需要嵌套三层);2、类装饰器(实现__call__方法);3、使用functools.wraps保留元数据;4、装饰器链(多个装饰器堆叠应用)
import functools
#缓存装饰器
def memoize(func):
    cache = {}
    @functools.wraps(func)
    def wrapper(*args):
        if args not in cache:
            cache[args] = func(*args)
        return cache[args]
    return wrapper

@memoize
def fib(n):
    return n if n < 2 else fib(n-1) + fib(n-2)

print(fib(35))  # 有缓存加速
6、如何处理函数中的异常?请给出示例。
在 Python 中,可以使用 try...except 块来处理函数中的异常,防止程序因错误而崩溃。finally 可以用来执行无论是否发生异常都要执行的代码。
def divide(a, b):
    try:
        return a / b
    except ZeroDivisionError:
        return "Cannot divide by zero!"
    finally:
        print("Execution completed.")

print(divide(10, 2))  # 输出: 5.0
print(divide(10, 0)) # 输出: Cannot divide by zero!注意:精确捕获异常类型(避免裸露的except);使用raise from保留原始堆栈信息;自定义异常继承Exception基类;上下文管理器处理资源清理
7、什么是闭包(closure)?
**闭包(Closure)**是一个函数,它能够记住并访问定义时的作用域,即使在其外部被调用。闭包通常用于实现工厂函数、回调函数等。
def outer(msg):
    def inner():
        return f"Message: {msg}"
    return inner

closure = outer("Hello, World!")
print(closure())  # 输出: Message: Hello, World!
inner 函数是一个闭包,它访问并记住了 outer 函数中的 msg 变量,即使 outer 函数已经执行完毕,inner 仍然能访问 msg。
技术细节:通过__closure__属性访问捕获变量;变量存储于cell对象中;
应用:装饰器实现;回调函数;实现私有变量(伪封装)
| 方面 | 普通函数 | 闭包 |
|---|---|---|
| 变量作用域 | 只能访问全局或局部变量 | 可以访问外部函数的局部变量 |
| 变量生命周期 | 外部函数执行完毕变量销毁 | 外部函数变量被内部函数“记住” |
| 使用场景 | 一般函数调用 | 需要保持状态或数据封装时使用 |
8、如何使用 map()、filter() 、reduce()和zip 函数?
map(func, iterable):对可迭代对象每个元素应用 func,返回迭代器。
filter(func, iterable):保留 func(x) 为 True 的元素,返回迭代器。
reduce(fun, iterable[, init]):累计地将fun应用于序列元素来自 functools
zip:将多个可迭代对象“压缩”成元组序列,长度为最短输入的长度。
zip(*iterables):加 * 可解压。
enumerate():用于遍历可迭代对象时,自动提供元素的索引和值。
from functools import reduce

nums = [1, 2, 3, 4]
# map: 平方
sq = list(map(lambda x: x*x, nums))      # [1,4,9,16]
# filter: 偶数
ev = list(filter(lambda x: x%2==0, nums))# [2,4]
# reduce: 求和
sm = reduce(lambda a, b: a + b, nums)    # 10
#zip
names = ['Alice', 'Bob', 'Charlie']
ages  = [25, 30, 35]
cities= ['NY', 'LA', 'SF']
for name, age, city in zip(names, ages, cities):
    print(name, age, city)
# Alice 25 NY
# Bob 30 LA
# Charlie 35 SF

# 解压
pairs = list(zip(names, ages))
names2, ages2 = zip(*pairs)9、解释 global 与 nonlocal
global:在函数内部声明变量是全局变量,直接操作全局作用域的变量,模块级全局遍量。
nonlocal:在函数内部声明变量是外部(但非全局)变量,用于嵌套函数中修改外部作用域的变量
# global 示例
x = 10
def modify_global():
    global x
    x = 20
modify_global()
print(x)  # 20

# nonlocal 示例
def outer():
    x = 10
    def inner():
        nonlocal x
        x = 20
    inner()
    print(x)  # 20
outer()
10、join()、dir()、vars()、locals()、globals()
字符串拼接,字符串不可变意味着每次拼接都会创建新对象,效率低,使用join()可以避免反复创建新对象(使用 io.StringIO() 或 array 模块处理特别大的字符串拼接)
| 函数 | 返回内容 | 作用域 | 返回类型 | 备注 |
|---|---|---|---|---|
dir() | 对象的属性和方法名列表 | 对象或当前作用域 | 列表 | 只列名称,不含值 |
vars() | 对象的属性字典或当前局部变量 | 对象或当前局部 | 字典 | 需要对象有 __dict__ 属性 |
locals() | 当前局部变量字典 | 局部作用域 | 字典 | 函数内为局部变量,模块顶层为全局 |
globals() | 当前全局变量字典 | 全局作用域 | 字典 | 模块级别变量 |
11、常用内建函数
len():返回对象的长度。max() / min():返回最大/最小值。sum():返回可迭代对象的总和。
sorted():返回排序后的列表。map()、filter()、reduce():对可迭代对象进行函数操作。
zip():将多个可迭代对象“打包”为元组。any() / all():判断是否有任一/所有元素满足条件
repr() 与 str() 的区别
str():主要用于生成用户友好的字符串表示,常用于打印。
repr():返回对象的官方字符串表示,尽量生成合法的 Python 表达式,用于调试和开发。
面向对象
1、类和对象基本定义,如何定义一个类?
类:创建对象的蓝图,包含属性和方法的逻辑模板(class是type类的实例)对象:类的具体实例,包含实际数据和操作能力(Python中所有对象都是object的派生)
class Car:
    def __init__(self, brand, model):
        self.brand = brand
        self.model = model

    def display_info(self):
        return f"Car brand: {self.brand}, Model: {self.model}"

# 创建对象
car1 = Car("Tesla", "Model S")
print(car1.display_info())  # 输出: Car brand: Tesla, Model: Model S
元类编程:通过__metaclass__或继承type类控制类创建过程,
__prepare__方法:控制类命名空间的创建(Python 3.0+)
__slots__优化:限制实例属性以节省内存
2、构造函数(__init__)?封装?继承?多态?
__init__方法本质:实际是初始化方法,并非真正的构造函数;对创建实例进行属性赋值
__new__:真正的对象创建由__new__方法完成,返回对象实例负责分配内存
class A:
    def __new__(cls, *args, **kwargs):
        instance = super().__new__(cls)
        print("Allocating memory")
        return instance

    def __init__(self, x):
        print("Initializing instance")
        self.x = x

a = A(10)
# Allocating memory
# Initializing instance
__new__:控制不可变类型(如int/str)的实例创建;__init__:标准对象初始化操作
封装
封装是面向对象编程中的一个重要概念,它将数据(属性)和方法(行为)组合在一起,并对外部提供受控的访问。封装的一个重要特点是通过访问修饰符(如私有属性和方法)来控制外部访问权限。
如何实现封装:使用私有属性(在属性名或方法名前加上双下划线 __)来保护对象的内部数据。提供 getter 和 setter 方法来访问或修改私有属性。
_protected_var:单下划线约定保护成员;__private_var:双下划线触发名称修饰(name mangling)
class Account:
    def __init__(self):
        self.__balance = 0  # 存储为_Account__balance
    @property
    def balance(self):  # 只读属性
        return self.__balance

    @balance.setter
    def balance(self, value):  # 可控修改
        if value >= 0:
            self.__balance = value
私有属性和方法:通过将类的属性和方法前加上双下划线(__),可以使其变为私有。Python 会将这些私有成员名称修改为 _ClassName__attribute,以防止外部访问
名称修饰原理:
class AccessControl:
    def __public(self):
        print("双下划线方法")

    def call_private(self):
        self.__public()

obj = AccessControl()
obj.call_private()       # 正常调用
obj._AccessControl__public()  # 强制访问
"We are all consenting adults here"(Python社区理念);通过__dict__仍可访问所有成员;
主要依赖开发者约定而非强制约束
继承:
继承是面向对象编程中的一个重要特性,它允许一个类继承另一个类的属性和方法,从而实现代码的复用和扩展。
class Animal:    # 单继承
    def speak(self):
        raise NotImplementedError

#多继承于C3线性化
class Dog(Animal):
    def speak(self):  # 方法重写
        return "Woof!"

class A: pass
class B(A): pass
class C(A): pass
class D(B, C): pass  # MRO: D -> B -> C -> A -> object
print(D.mro())  # 查看方法解析顺序
MRO算法原理:基于拓扑排序的C3算法; super()本质:根据MRO链寻找下一个类
多态:
多态是面向对象编程的一种特性,指的是同一个方法或操作作用于不同类型的对象时,可以表现出不同的行为。通常通过方法重写(Overriding)实现多态
class Animal:
    def speak(self):
        return "Animal speaks"
class Dog(Animal):
    def speak(self):
        return "Woof!"
class Cat(Animal):
    def speak(self):
        return "Meow!"
animals = [Dog(), Cat()]
for animal in animals:
    print(animal.speak())  # 输出: Woof! Meow!
Python多态的实现哲学:鸭子类型;设计理念:"If it walks like a duck and quacks like a duck..."
协议概念:通过__iter__等魔法方法实现隐式接口
class PDFExporter:
    def export(self):
        print("Exporting PDF")

class HTMLExporter:
    def export(self):
        print("Exporting HTML")
def save_report(exporter):  # 不依赖类型声明
    exporter.export()
3、什么是类方法和静态方法
类方法(@classmethod):绑定到类而不是实例上,接收类作为第一个参数 cls。通常用于操作类级别的属性或作为工厂方法。
静态方法(@staticmethod):既不接收实例 (self),也不接收类 (cls),通常用于不依赖于类或实例状态的工具函数。
| 方法类型 | 装饰器 | 首个参数 | 可修改类状态 | 典型应用场景 |
| 实例方法 | 无 | self | 是 | 访问实例数据 |
| 类方法 | @classmethod | cls | 是 | 工厂模式、备选构造器 |
| 静态方法 | @staticmethod | 无 | 否 | 工具函数 |
4、如何使用 super() 函数?
super() 函数用于调用父类的方法。它通常在子类中重写父类方法时使用,用来确保父类的逻辑不被完全覆盖,或者用来调用父类的构造方法。
class Animal:
    def speak(self):
        return "Animal speaks"

class Dog(Animal):
    def speak(self):
       return super().speak() + " and Woof!"

d = Dog()
print(d.speak())  # 输出: Animal speaks and Woof!
#协作式多重继承
class Base:
    def __init__(self):
        print("Base init")
        super().__init__()

class MixinA(Base):
    def __init__(self):
        print("MixinA init")
        super().__init__()

class MixinB(Base):
    def __init__(self):
        print("MixinB init")
        super().__init__()

class Combined(MixinA, MixinB):
pass  # 自动协调初始化顺序
#动态参数传递
class Proxy:
    def __init__(self, obj):
        self._obj = obj

    def __getattr__(self, name):
        return getattr(self._obj, name)
5、什么是抽象类和接口
抽象类(Abstract Class):抽象类不能直接实例化,它为子类提供一个模板,定义了子类必须实现的抽象方法。通过 abc 模块实现。
from abc import ABC, abstractmethod

class Renderer(ABC):
    @abstractmethod
    def render(self, data):
        pass

class SVGRenderer(Renderer):
    def render(self, data):  # 必须实现
        return f"<svg>{data}</svg>"
接口(Interface):Python 本身没有显式的接口关键字,但可以通过抽象类来模拟接口,接口只是方法声明而没有实现。
from typing import Protocol
class Serializable(Protocol):
    def serialize(self) -> bytes: ...
    @classmethod
    def deserialize(cls, data: bytes) -> object: ...
6、魔法方法
魔法方法(Magic Methods),也称为特殊方法,是 Python 中以双下划线 __ 开头和结尾的一类方法。它们定义了对象的特定行为,使得对象能够响应内置函数、运算符和语法结构的调用,从而实现运算符重载、对象定制等高级功能。
| 魔法方法 | 作用描述 | 示例说明 |
|---|---|---|
__init__(self, ...) | 对象初始化方法,构造函数 | 创建对象时自动调用,初始化属性 |
__str__(self) | 定义 str(obj) 和 print(obj) 输出 | 返回用户友好的字符串表示 |
__repr__(self) | 定义 repr(obj),调试输出 | 返回开发者友好的字符串表示 |
__add__(self, other) | 实现加法运算符 + | 支持对象间的加法操作 |
__len__(self) | 定义 len(obj) | 返回对象长度 |
__getitem__(self, key) | 支持索引访问 obj[key] | 使对象表现得像序列或映射 |
__setitem__(self, key, value) | 支持索引赋值 obj[key] = value | 修改对象内部数据 |
__call__(self, ...) | 使对象可调用,像函数一样使用 | obj() 调用时触发 |
__eq__(self, other) | 实现等于比较 == | 定义对象相等的判断标准 |
__enter__(self) 和 __exit__(self, exc_type, exc_val, exc_tb) | 支持上下文管理协议(with 语句) | 管理资源的获取和释放 |
魔法方法的作用
- 定制对象的创建、初始化、销毁行为(如
__init__、__new__、__del__)。 - 定义对象的字符串表示(如
__str__、__repr__)。 - 支持运算符重载(如
__add__、__sub__)。 - 支持容器类型行为(如
__getitem__、__setitem__、__len__)。 - 支持上下文管理(如
__enter__、__exit__)。
7、元类
定义:元类是用来创建类的“类”,即类的类。作用:控制类的创建过程,决定类的行为和属性。关系:对象是类的实例,类是元类的实例。默认元类是 type。
元类的作用:动态修改类的属性和方法;实现类的自动注册、接口检查、单例模式等设计模式;控制类的创建流程,增强类的功能。
MyClass = type('MyClass', (object,), {'x': 5, 'hello': lambda self: print('hello')})

obj = MyClass()
print(obj.x)  # 输出 5
obj.hello()   # 输出 hello
自定义元类
class MyMeta(type):
    def __new__(cls, name, bases, attrs):
        print(f"创建类 {name}")
        attrs['id'] = 123  # 动态添加属性
        return super().__new__(cls, name, bases, attrs)

class MyClass(metaclass=MyMeta):
    pass

print(MyClass.id)  # 输出 123
当定义类时,Python 会调用元类的 __new__ 方法创建类对象;__new__ 接收类名、父类元组、类属性字典作为参数;可以在 __new__ 中修改类属性、添加方法等。;返回修改后的类对象。
应用场景:ORM 框架:自动映射数据库表和类属性。接口检查:确保子类实现特定方法。自动注册:类注册到某个管理器或工厂。单例模式:通过元类控制类实例化。
模块与包
1、模块?
模块是一个包含 Python 定义和语句的文件。模块可以包含函数、类和变量,甚至可以包含可执行代码。模块使得代码的组织、复用变得更加容易。
技术本质:包含Python定义和语句的.py文件(或C扩展); 核心作用:代码复用、命名空间隔离、代码组织单元; 身份标识:通过__name__属性获取模块全名(__main__表示当前执行模块)
如何导入模块:可以使用 import 语句来导入模块。Python 中有两种常见的导入方式:1、导入整个模块import math print(math.sqrt(16));2、导入特定函数和变量from math import sqrt print(sqrt(16)) # 输出: 4.0
# 导入流程: 1. 检查math.modules缓存; 2. 搜索math.path中的路径; 3. 编译字节码(生成.pyc文件) ; 4. 执行模块代码; 5. 创建模块对象
模块加载后会缓存到 sys.modules 字典中,后续导入直接从缓存获取,避免重复加载。强制重新加载模块可以使用 importlib.reload()。
2、包
包是一个包含多个模块的文件夹。包允许组织更大规模的应用。每个包目录下必须有一个 __init__.py 文件,标识该目录为一个 Python 包。
创建包的步骤:1、创建一个目录,作为包的名称。2、在该目录下添加 Python 文件作为模块。
3、在该目录下添加 __init__.py 文件(即使文件为空,也要存在)。
__init__.py
文件用于标识一个目录为 Python 包,并允许在导入包时执行初始化代码。它可以是空文件,也可以包含初始化代码。当你导入包时,Python 会执行 __init__.py 文件中的代码。
传统作用:标记Python 3.3之前的包目录;执行包级初始化代码;定义__all__列表控制from package import *的行为
现代用法
# 显式导出API
__all__ = ['submodule1', 'submodule2']
# 包级别配置
print(f"Initializing {__name__}")
# 简化导入路径
from .submodule1 import important_func
包的导入:from . import sibling # 相对导入(同一包内);from ..parent import func # 上级包导入;import pkg.module # 绝对导入(推荐)
3、pip安装
pip 是 Python 包管理工具,用于安装和管理 Python 库。你可以通过 pip 安装第三方库
| pip install package==1.0.0 # 精确版本安装 | pip install -r requirements.txt # 批量安装 |
| pip freeze > requirements.txt # 导出依赖 | pip show package # 查看包信息 |
| pipdeptree # 展示依赖关系 | pip list --format=freeze # 标准格式输出 |
| poetry show # 使用Poetry工具 | 依赖隔离:pip install --user(用户级安装) |
安装模式:pip install -e .(可编辑模式) | |
镜像源加速:pip config set global.index-url httpedu.cn/simple
常用标准库
| 模块名 | 功能描述 |
|---|---|
os | 操作系统接口 |
sys | 解释器相关操作 |
math | 数学函数 |
datetime | 日期和时间处理 |
json | JSON 编码和解码 |
re | 正则表达式 |
subprocess | 进程管理 |
threading | 线程支持 |
logging | 日志管理 |
4、常用模块
sys、os模块
sys 模块提供了与 Python 解释器交互的功能,允许你访问与 Python 运行时环境相关的参数和操作。常用于获取命令行参数、修改模块搜索路径、控制解释器的退出等。
常见功能和使用方法:
| sys.argv:获取命令行传递的参数 | sys.exit():退出 Python 程序 |
| sys.path:模块搜索路径 | sys.version:Python 解释器的版本 |
| sys.platform:操作系统平台的标识符 |
os 模块提供了操作系统接口,允许你访问文件系统、环境变量、创建和删除目录、执行系统命令等操作。常用于与操作系统进行交互,处理文件和目录等任务。
常见功能和使用方法:os.environ:获取环境变量
| os.getcwd():获取当前工作目录 | os.chdir(path):改变当前工作目录 |
| os.listdir(path):列出指定目录中的文件和目录 | os.mkdir(path):创建一个新目录 |
| os.remove(path):删除指定文件 | os.rename(src, dst):重命名文件或目录 |
5、__name__=="__main__"
__name__ 是 Python 中的内置变量。当模块作为主程序运行时,__name__ 被设置为 "__main__"。如果模块被导入,则 __name__ 为模块名。用于确保模块既可以作为脚本运行,也可以作为导入的模块使用。
6、性能分析
使用 cProfile 模块统计每个函数调用次数与耗时;结合 pstats 或第三方工具可视化分析瓶颈。可使用 line_profiler 做逐行剖析;用 memory_profiler 分析内存使用。分析结果可帮助判断优化方向(算法、I/O、网络等)
python -m cProfile -o profile.out your_script.py
python - <<EOF
import pstats
ps = pstats.Stats('profile.out')
ps.sort_stats('cumtime').print_stats(10)
EOF
7、日志
使用标准库 logging,配置日志格式、级别、输出位置(控制台、文件等)。支持多模块、多级别日志管理。使用 logging.config 配置更复杂的日志策略。结合第三方库如 loguru 简化日志使用。
日志级别:DEBUG < INFO < WARNING < ERROR < CRITICAL,控制日志输出粒度。
日志轮转:避免日志文件过大,定期切割日志文件,常用 RotatingFileHandler 和 TimedRotatingFileHandler。
import logging

logging.basicConfig(
    level=logging.INFO,
    format='%(asctime)s - %(levelname)s - %(message)s',
    filename='app.log',
    filemode='a'
)

logging.info("This is an info message")
logging.error("This is an error message")
#轮转策略可按大小或时间。
#结合日志收集系统(ELK、Fluentd)实现集中管理。

from logging.handlers import RotatingFileHandler

handler = RotatingFileHandler('app.log', maxBytes=1024*1024, backupCount=3)
logger = logging.getLogger()
logger.setLevel(logging.INFO)
logger.addHandler(handler)
异常
1、异常?处理异常?
异常(Exception):在程序运行过程中,当发生错误或意外情况时,解释器会抛出一个异常。异常通常表示程序中的错误状态,例如除以零、文件不存在、索引越界等。Python 中所有的异常都是从 BaseException 类继承而来的。常见的异常类有 Exception、ValueError、IndexError、TypeError 等。
异常对象模型:技术本质:继承自BaseException的实例对象;核心类型:Exception:常规异常基类;SystemExit/KeyboardInterrupt:解释器级异常
目的:异常机制使得程序能够在遇到错误时不直接崩溃,而是通过捕获异常来进行适当的处理,保障程序的健壮性。
如何处理异常:EAFP原则:Easier to Ask Forgiveness than Permission
# LBYL风格(非Pythonic)
if os.path.exists("data.txt"):
    with open("data.txt") as f:
        content = f.read()

# EAFP风格(推荐)
try:
    with open("data.txt") as f:
        content = f.read()
except FileNotFoundError:
print("文件不存在")捕获异常:使用 try 和 except 块捕获可能抛出的异常,从而在错误出现时执行备用代码或输出提示信息。捕获异常信息:except ZeroDivisionError as e: 使用 as 关键字捕获异常对象; 如果不想影响程序使用通用异常捕获except Exception避免BaseException(如 KeyboardInterrupt)。在 except 块中处理异常,保证程序继续执行。
异常捕获顺序:
多个 except 块按顺序匹配异常类型,先匹配到的块执行。捕获顺序应从具体异常到通用异常,避免通用异常先捕获导致具体异常无法捕获,否则会导致异常处理不准确。
异常传播
异常传播指异常发生后,程序会沿调用栈向上查找匹配的异常处理器(except 块)。如果当前函数没有捕获异常,异常会传递给调用它的函数,直到被捕获或程序终止。这保证了异常可以被合适的层级处理。
如何设计一个健壮的异常处理框架?
1、明确异常分类,区分可恢复和不可恢复异常。2、统一异常处理入口,结合日志和告警。3、使用上下文管理器确保资源释放。支持异常链和异常传递。4、在多线程和异步环境中妥善处理异常。
| 方面 | Python | C++ |
|---|---|---|
| 异常类型 | 动态类型,所有异常继承自 BaseException | 静态类型,可以抛出任意类型 |
| 异常声明 | 无需声明 | 无需声明 |
| 异常捕获 | try-except | try-catch |
| 异常链支持 | 支持 raise ... from ... | 需手动实现 |
| 资源管理 | 上下文管理器 (with) | RAII(资源获取即初始化) |
2、异常控制实现机制
try-except-finally 执行模型
try 语句块:将可能产生异常的代码放入 try 块中,确保后续代码能进入异常处理流程。
except 语句块:用于捕获 try 块中抛出的特定异常,并提供相应的处理代码。可以指定捕获的异常类型,多个 except 块可以针对不同异常做出不同处理。
finally 语句块:无论是否发生异常,finally 中的代码都会执行。常用于释放资源、关闭文件等“清理”任务。
def exception_flow():
    try:
        print("执行区域")
        raise ValueError("示例错误")
    except TypeError:
        print("不会捕获")
    except ValueError as ve:
        print(f"捕获值错误: {ve}")
        raise  # 重新抛出
    else:
        print("无异常时执行")
    finally:
        print("始终执行")
# 执行输出:
# 执行区域
# 捕获值错误: 示例错误
# 始终执行
底层原理:字节码层面通过SETUP_FINALLY和WITH_CLEANUP_START指令实现
每个try块对应一个栈帧中的异常表(exception table)
异常链指一个异常在处理时又引发另一个异常,Python 3 支持异常链。使用 raise ... from ... 显式指定异常链。
常见的内置异常:ValueError:值错误; TypeError:类型错误;IndexError:索引超出范围;KeyError:字典键不存在;ZeroDivisionError:除零错误;AttributeError:属性不存在;ImportError:导入模块失败;FileNotFoundError:文件未找到;RuntimeError:运行时错误
3、自定义异常
针对特定业务逻辑或错误状态,自定义异常能使代码更具可读性与扩展性。你可以继承内置异常基类(如 Exception 或其子类)来自定义异常类
# 定义一个自定义异常类,继承自 Exception
class InvalidInputError(Exception):
    def __init__(self, message="输入无效"):
        self.message = message
        super().__init__(self.message)

# 在函数中使用自定义异常
def process_input(value):
    if not isinstance(value, int):
        # 引发自定义异常
        raise InvalidInputError("预期输入为整数")
    return value * 2

try:
    result = process_input("abc")
except InvalidInputError as err:
    print("捕获到自定义异常:", err)
raise语句:raise 语句用于主动引发异常。通常用于在遇到不符合预期的条件时中断程序执行,并将错误状态传递给调用者。
4、上下文管理器?with语句?
上下文管理器用于管理资源的获取与释放,确保在使用资源后能够自动清理(如文件、网络连接等)。在 Python 中,上下文管理器定义了 __enter__ 和 __exit__ 方法,分别在进入和退出上下文时自动调用。
class MyResource:
    def __enter__(self):
        print("资源被获取")
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        print("资源被释放")
        # 根据异常类型决定是否抑制异常,此处返回 False 表示不抑制异常
        return False

with MyResource() as resource:
    print("使用资源")
进入 with 块时调用 __enter__,退出时调用 __exit__ 来释放资源
with 语句简化了资源管理,不必手动调用清理代码。例如,文件操作时使用 with 能自动关闭文件,即使发生异常。自定义上下文可管理锁、数据库连接、网络会话等。__exit__ 返回 True 可吞掉异常,用于安全重试或清理后隐藏错误。
文件操作
1、文件的读写
| 读文件 | 写文件 |
| open():用于打开文件。 read():读取整个文件的内容。 readline():逐行读取文件。 readlines():将文件的每一行作为列表中的一个元素返回 | 写入文本文件时,常用的模式是 "w"(写入,若文件存在则覆盖)和 "a"(追加)。x'排他创建,文件存在则失败 |
with open('large_file.txt', 'r', encoding='utf-8') as f:

    # 迭代器逐行读取(内存友好)
    for line in f:
        process(line)

    # 按块读取(二进制模式更高效)
    f.seek(0)  # 重置文件指针
    while chunk := f.read(4096):  # 海象运算符(Python 3.8+)
        process_chunk(chunk)
高级技巧
编码检测:使用chardet库自动识别文件编码;错误处理:errors='replace'参数处理解码错误;内存映射:mmap模块处理超大文件
import mmap
with open('huge.log', 'r+') as f:
    mm = mmap.mmap(f.fileno(), 0)
    index = mm.find(b'ERROR')
2、二进制文件操作
二进制文件不同于文本文件,它以字节流的方式存储数据。读取和写入二进制文件时,打开文件时需要使用 "rb"(读取二进制)和 "wb"(写入二进制)模式。
# 读取二进制
with open('image.jpg', 'rb') as f:
    jpg_header = f.read(4)  # b'\xff\xd8\xff\xe0'

# 写入二进制
import struct
with open('data.bin', 'wb') as f:
f.write(struct.pack('!I', 1024))  # 网络字节序整型
#内存视图优化
with open('video.mp4', 'rb') as f:
    buffer = memoryview(f.read())
    header = buffer[:4].tobytes()  # 零拷贝切片
#随机访问模式
with open('database.idx', 'r+b') as f:
    f.seek(1024 * 8)  # 定位到第8KB位置
    f.write(b'NEWDATA')
    f.flush()  # 强制刷盘
正则
1、正则?使用?
正则表达式的概念:正则表达式(Regular Expression, 简称 regex) 是一种用于匹配字符串的模式,它是一种强大的文本处理工具,广泛应用于搜索、替换和验证操作。正则表达式由特殊字符和元字符组成,能够描述符合特定模式的字符串。
正则表达式的基本语法:字符匹配:例如,a 匹配字符 a。元字符:如 . 表示任意字符,^ 表示行的开始,$ 表示行的结束。字符集:如 [a-z] 匹配所有小写字母,[0-9] 匹配所有数字。量词:如 * 表示零个或多个,+ 表示一个或多个,? 表示零个或一个。
import re
pattern = r'\d{3}-\d{8}'  # 示例:匹配电话号码
text = "紧急联系:028-12345678"
result = re.findall(pattern, text)
2、python的re模块
Python 的 re 模块提供了多个方法来执行正则表达式的匹配操作,常用的方法包括:
| 方法 | 功能特点 | 返回值 | 典型场景 |
| re.match() | 仅从字符串起始位置匹配 | MatchObject | 格式验证(如HTTP协议头) |
| re.search() | 扫描整个字符串找首个匹配 | MatchObject | 日志关键信息提取 |
| re.findall() | 返回所有非重叠匹配列表 | List | 数据采集 |
| re.finditer() | 返回迭代器节约内存 | Iterator | 大文件处理 |
3、贪婪、非贪婪?
贪婪匹配:
贪婪匹配是指正则表达式尽可能多地匹配字符,直到无法匹配为止。默认情况下,量词(如 *、+)是贪婪的。使用.* .+ .{n,}示例:<div>content</div>中<.*>会匹配整个标签
非贪婪匹配:
非贪婪匹配(或称懒惰匹配)是指正则表达式尽可能少地匹配字符,即它会尽早停止匹配。通过在量词后面加上 ? 来实现非贪婪匹配。使用.*? .+? .{n,}?
示例:<div>content</div>中<.*?>会逐个匹配标签
text = "<div>First</div><div>Second</div>"

# 贪婪匹配
greedy_match = re.findall(r"<div>.*</div>", text)
print(greedy_match)  # 输出: ['<div>First</div><div>Second</div>']

# 非贪婪匹配
non_greedy_match = re.findall(r"<div>.*?</div>", text)
print(non_greedy_match)  # 输出: ['<div>First</div>', '<div>Second</div>']
4、查找与替换
| 方法 | 返回值 | 特点 |
| re.sub() | 新字符串 | 返回替换后的完整字符串 |
| re.subn() | (字符串,次数) | 同时返回替换次数统计 |
import re
text = "I have 2 apples and 3 oranges."
pattern = r"\d+"  # 匹配数字
# 替换数字
new_text = re.sub(pattern, "X", text)
print(new_text)  # 输出: I have X apples and X oranges.
#回调函数动态生成替换内容
def replace(match):
    return str(int(match.group()) * 2)
new_text = re.sub(r"\d+", replace, text)
print(new_text)  # 输出: I have 4 apples and 6 oranges.
测试
1、单元测试
单元测试(Unit Testing) 是一种软件测试方法,它通过对程序的最小单元(通常是函数或方法)进行独立测试,确保每个功能模块按预期工作。单元测试通常由开发人员编写,能够快速发现代码中的问题,增强代码的可维护性和可靠性
最小测试单元:针对程序模块(函数/类方法)的独立验证
白盒测试:基于代码内部逻辑设计的测试案例
快速反馈:毫秒级执行速度,支持开发中实时验证
隔离性:使用Mock/Stub隔离外部依赖
可重复:相同输入永远得到相同结果
原子性:每个测试用例验证单一功能点
2、unittest、pytest
unittest 模块的使用:unittest 是 Python 内置的单元测试框架,提供了丰富的功能来组织、运行和报告测试。主要步骤包括:1、创建测试类,继承 unittest.TestCase。2、编写测试方法。3、使用 unittest.main() 运行所有测试。
import unittest
class MathTest(unittest.TestCase):
    # 测试夹具
    def setUp(self):
        self.calculator = Calculator()

    def test_addition(self):
        self.assertEqual(self.calculator.add(2,3), 5)  # 基本断言
    def tearDown(self):
        del self.calculator
测试钩子setup/teardown)用于在测试执行之前和之后做一些准备工作和清理工作,确保每个测试用例都在一致的环境中运行。unittest 中有 setUp() 和 tearDown(),pytest 中有 setup_method() 和 teardown_method(),还可以使用 pytest.fixture() 来设置测试环境。
| 方法 | 作用域 | 执行时机 |
| setUpClass() | 类级别 | 整个测试类开始前执行 |
| tearDownClass() | 类级别 | 整个测试类结束后执行 |
| setUp() | 方法级别 | 每个测试方法前执行 |
| tearDown() | 方法级别 | 每个测试方法后执行 |
高级断言方法
self.assertAlmostEqual(0.1 + 0.2, 0.3, places=7) # 浮点数近似断言
self.assertRaisesRegex(ValueError, "除数不能为零", divide, 10, 0) # 异常正则匹配
self.assertListEqual(result, expected) # 复杂数据结构验证
unittest.mock
是 Python 标准库中的一个模块,用于创建假对象(mock objects)以便进行隔离测试。它可以替换真实的函数、类或对象,使得在测试中不依赖外部资源。
from unittest.mock import Mock

# 创建一个 Mock 对象
mock_function = Mock(return_value=10)
print(mock_function())  # 输出 10

# 使用 mock 替换某个函数
def fetch_data():
    return "real data"

mock_fetch = Mock(return_value="mock data")
print(mock_fetch())  # 输出 "mock data"
Mock 还可以用来检查函数是否被调用,以及调用的次数、参数等。
patch() 装饰器可以在指定作用域内临时替换某个对象或函数,适用于单元测试。
pytest
零样板代码:无需继承特定类;智能发现:自动查找test_*.py文件;丰富插件:超过800个扩展插件生态;
pytest 是一个第三方 Python 测试框架,它比 unittest 更简单易用,支持自动发现测试、丰富的断言和插件系统。pytest 自动识别以 test_ 开头的函数作为测试用例,测试方法不需要继承 unittest.TestCase。pytest 自动发现以 test_ 开头的函数,运行时不需要显式的测试类。assert 语句用于检查结果是否符合预期。
# 参数化测试
@pytest.mark.parametrize("input,expected", [
    ("3+5", 8),
    ("2*4", 8),
    ("6/2", 3)
])

def test_eval(input, expected):
    assert eval(input) == expected

# Fixture依赖管理
@pytest.fixture
def db_connection():
    conn = create_db_conn()
    yield conn
    conn.close()

def test_query(db_connection):
    result = db_connection.execute("SELECT 1")
    assert result == 1
3、测试用例和测试套件
测试用例(Test Case):测试用例是对被测试单元(如函数或方法)的一种具体测试,它通过输入数据并检查输出结果来验证单元的正确性。在 unittest 中,每个测试方法就是一个测试用例。
测试套件(Test Suite):测试套件是多个测试用例的集合,它允许将多个测试用例分组并一起运行。测试套件有助于组织复杂的测试流程。
| 概念 | 组成单位 | 管理方式 | 执行粒度 |
| 测试用例 | 单个测试方法 | TestCase子类 | 方法级别 |
| 测试套件 | 多个TestCase | TestSuite容器 | 模块/包级别 |
import unittest

# 测试用例1
def add(a, b):
    return a + b

class TestAdd(unittest.TestCase):
    def test_add_positive(self):
        self.assertEqual(add(2, 3), 5)
    def test_add_negative(self):
        self.assertEqual(add(-1, 1), 0)

# 测试用例2
def multiply(a, b):
    return a * b

class TestMultiply(unittest.TestCase):
    def test_multiply_positive(self):
        self.assertEqual(multiply(2, 3), 6)
    def test_multiply_negative(self):
        self.assertEqual(multiply(-1, 1), -1)

# 创建测试套件
def suite():
    suite = unittest.TestSuite()
    suite.addTest(unittest.makeSuite(TestAdd))  # 添加 TestAdd 测试用例
    suite.addTest(unittest.makeSuite(TestMultiply))  # 添加 TestMultiply 测试用例
    return suite

# 运行测试
if __name__ == "__main__":
    unittest.TextTestRunner().run(suite())
测试夹具fixture
夹具用于测试前准备和测试后清理工作。
unittest 中使用 setUp 和 tearDown。pytest 中使用 @pytest.fixture 装饰器。
4、如何进行代码覆盖率测试?
代码覆盖率:测量测试用例执行过程中,代码中有多少比例的行被执行了。它有助于发现哪些代码没有被测试到,从而提高测试的全面性。
| 覆盖率类型 | 检测维度 | 重要性 |
| 语句覆盖率 | 代码执行路径 | 基础指标 |
| 分支覆盖率 | 条件判断分支 | 关键路径 |
| 函数覆盖率 | 函数调用情况 | 架构层面 |
| 行覆盖率 | 具体代码行执行 | 细节层面 |
使用 coverage 工具进行代码覆盖率测试:1、pip install coverage 2、coverage run -m unittest discover # 运行单元测试并收集覆盖率数据 3、coverage report # 生成覆盖率报告;4、coverage html # 生成 HTML 格式的报告
5、生成试报告
在 Python 中,unittest 和 pytest 都支持生成测试报告,常见格式有文本、HTML 和 XML。
pytest 可以通过 pytest-html 插件生成漂亮的 HTML 报告,unittest 支持生成 XML 格式的报告。
# 使用 pytest 生成 HTML 报告
pytest --html=report.html

# 使用 unittest 生成 XML 报告
python -m unittest discover -s tests -p "*.py" > result.xml
pytest 的 HTML 报告可以集成到 Jenkins 或其他 CI 工具中。
unittest 的 XML 报告适用于与 CI 系统的集成,支持更详细的测试结果展示。
6、如何编写可重复用的测试套件?
可重复用的测试套件需要高内聚、低耦合:将公共的初始化、清理逻辑抽象为 fixtures(在 pytest 中)或 setUp/tearDown(在 unittest 中)将测试数据与测试逻辑分离;使用参数化避免重复代码
# pytest 中使用 fixture 和参数化
import pytest
from myapp import create_app

@pytest.fixture(scope="session")
def app():
    app = create_app("testing")
    return app.test_client()

@pytest.mark.parametrize("input, expected", [
    ({"a":1,"b":2}, 3),
    ({"a":-1,"b":5}, 4),
])
def test_add_api(app, input, expected):
    resp = app.post("/add", json=input)
    assert resp.status_code == 200
    assert resp.json["result"] == expected
将公共的请求封装成工具函数(如 api_client.post_json()),放在单独模块;
使用数据驱动(YAML/JSON/CSV)管理测试用例,配合参数化动态加载;
对于大型项目,可将测试分层(单元、集成、端到端),并定义清晰的目录结构。
7、简介selenium
Selenium 是一种自动化浏览器的工具,支持多浏览器(Chrome、Firefox、Safari 等)和语言绑定。通过 WebDriver API 操控浏览器,实现点击、输入、导航、截屏等操作。
Selenium 提供多种 By 策略定位元素,包括 ID、名称、类名、标签名、链接文本、CSS 选择器和 XPath。
from selenium import webdriver
from selenium.webdriver.common.by import By

driver = webdriver.Chrome()
driver.get("https://example.com/login")
driver.find_element(By.NAME, "username").send_keys("alice")
driver.find_element(By.NAME, "password").send_keys("secret")
driver.find_element(By.CSS_SELECTOR, "button.submit").click()
driver.find_element(By.ID, "element_id")
driver.find_element(By.NAME, "element_name")
driver.find_element(By.CLASS_NAME, "some-class")
driver.find_element(By.TAG_NAME, "div")
driver.find_element(By.LINK_TEXT, "Click here")
driver.find_element(By.CSS_SELECTOR, ".class > a[href='/']")
driver.find_element(By.XPATH, "//div[@id='main']/ul/li[2]")
assert "Dashboard" in driver.title
driver.quit()
8、各种测试
如何分析压力测试结果?
吞吐量(TPS/QPS)、响应时间(平均、最大、百分位数)、错误率和失败请求。
资源利用率(CPU、内存、网络、磁盘)、识别瓶颈(数据库、网络、应用层)。
(使用图表和趋势分析辅助判断。结合日志和监控数据定位问题)
数据库性能测试与监控指标
查询响应时间、慢查询数;连接数、锁等待、死锁;缓存命中率、IO 读写速率。
事务吞吐量。(使用数据库自带工具(如 MySQL 的 EXPLAIN、SHOW PROCESSLIST)。
结合监控系统(Prometheus + Grafana)实时监控)
如何测试消息队列(如 Kafka)性能?
吞吐量(消息生产和消费速率)、延迟(消息从生产到消费的时间)、消息丢失和重复率。
系统稳定性和容错能力。
使用 Kafka 自带的性能测试工具 kafka-producer-perf-test.sh 和 kafka-consumer-perf-test.sh。
结合 Python 客户端(confluent-kafka-python)编写自定义测试脚本。
设计模式
1、什么是单例模式?使用场景,如何实现?
单例模式的概念:单例模式(Singleton Pattern)是一种设计模式,确保一个类只有一个实例,并提供全局访问点。这种模式通常用于控制资源的访问,例如数据库连接、日志管理器等。它避免了类被多次实例化,从而节省资源。
使用场景:
日志系统:确保日志类只有一个实例,避免多次打开日志文件。
数据库连接池:确保数据库连接池有且仅有一个实例,避免多个连接池浪费资源。
配置类:确保配置信息只有一个实例,避免重复加载。
如何实现单例模式:通过类变量保存唯一实例。通过 __new__ 方法确保每次创建对象时返回同一个实例。
class Singleton:
    _instance = None

    def __new__(cls):
        if cls._instance is None:
            cls._instance = super(Singleton, cls).__new__(cls)
        return cls._instance

# 测试
obj1 = Singleton()
obj2 = Singleton()
print(obj1 is obj2)  # 输出: True,表示 obj1 和 obj2 是同一个实例
2、什么是工厂模式?使用场景,请给出示例。
工厂模式的概念:工厂模式(Factory Pattern)是一种创建对象的设计模式。它通过定义一个创建对象的接口,由子类决定实例化哪一个类。工厂方法允许类的实例化延迟到子类进行。
使用场景:对象创建复杂:当一个类的实例化过程涉及多个步骤时,使用工厂模式可以将创建过程封装在一个工厂方法中,避免直接调用构造函数。
不同产品对象的创建:如果需要根据不同条件创建不同类型的对象(例如,操作系统不同创建不同的操作系统类),工厂模式非常有效。
class Car:
    def drive(self):
        print("Driving a car")

class Bike:
    def drive(self):
        print("Riding a bike")

class VehicleFactory:
    @staticmethod
    def create_vehicle(vehicle_type):
        if vehicle_type == "car":
            return Car()
        elif vehicle_type == "bike":
            return Bike()
        else:
            raise ValueError("Unknown vehicle type")

# 测试
vehicle = VehicleFactory.create_vehicle("car")
vehicle.drive()  # 输出: Driving a car
vehicle2 = VehicleFactory.create_vehicle("bike")
vehicle2.drive()  # 输出: Riding a bike
3、什么是观察者模式?使用场景,请解释。
观察者模式的概念:观察者模式(Observer Pattern)是一种行为设计模式。它定义了一对多的依赖关系,让多个观察者对象监听某一主题对象,当主题对象状态发生变化时,所有依赖于它的观察者都会得到通知并自动更新。
使用场景:事件处理系统:例如图形用户界面的按钮点击事件,多个按钮的监听器需要响应按钮的点击。
订阅发布系统:例如,新闻网站的订阅功能,当新闻内容更新时,所有订阅的用户会自动收到更新通知。
class Subject:
    def __init__(self):
        self._observers = []
    def attach(self, observer):
        self._observers.append(observer)
    def detach(self, observer):
        self._observers.remove(observer)
    def notify(self):
        for observer in self._observers:
            observer.update()
class Observer:
    def update(self):
       pass

class ConcreteObserver(Observer):
    def __init__(self, name):
        self.name = name
    def update(self):
        print(f"{self.name} has been notified.")

# 测试
subject = Subject()
observer1 = ConcreteObserver("Observer 1")
observer2 = ConcreteObserver("Observer 2")
subject.attach(observer1)
subject.attach(observer2)
subject.notify()  # 输出: Observer 1 has been notified. \n Observer 2 has been notified.
Subject 类维护一个观察者列表,并在状态变化时通知所有观察者。
Observer 类定义了 update() 方法,具体的观察者通过继承该类并实现 update() 方法来定义响应逻辑。
其他
1、生成器、迭代器
生成器:生成器(generator)是 Python 中的一种特殊类型的迭代器,它通过 yield 语句逐步产生值,而不是一次性返回所有值。生成器能让你按需生成大量的数据,因此它比一次性返回所有数据更节省内存。
惰性计算:按需生成数据项,内存效率优化(对比列表)
执行状态保持:通过yield暂停/恢复执行上下文
迭代器协议实现:自动实现__iter__和__next__
# 方式1:生成器函数
def count_down(n):
    while n > 0:
        yield n
        n -= 1

# 方式2:生成器表达式
squares = (x**2 for x in range(100))
# 方式3:类实现(高级定制)
class FibGenerator:
    def __init__(self, max):
        self.a, self.b = 0, 1
        self.max = max
     def __iter__(self):
        return self
    def __next__(self):
        if self.a > self.max:
            raise StopIteration
        result = self.a
        self.a, self.b = self.b, self.a + self.b
return result| 特性 | return | yield |
|---|---|---|
| 功能 | 结束函数并返回值 | 暂停函数并产出一个值,保留上下文 |
| 返回类型 | 普通值或 None | 生成器对象 (generator) |
| 复用 | 一次调用结束 | 多次调用(迭代) |
什么是迭代器(iterator)?
迭代器的概念:迭代器是一个实现了 __iter__() 和 __next__() 方法的对象。可以通过迭代器逐个访问集合中的元素,直到没有更多元素为止。__iter__():返回迭代器对象本身。__next__():返回集合中的下一个元素。如果没有更多元素,抛出 StopIteration 异常。
迭代器的特点:
惰性求值:迭代器是惰性求值的,每次调用 next() 返回一个元素,直到结束。
一次性:迭代器只能被遍历一次,不能回退或重新遍历。
# 定义一个迭代器

class MyIterator:
    def __init__(self, limit):
        self.limit = limit
        self.current = 0
    def __iter__(self):
        return self  # 返回迭代器对象本身
    def __next__(self):
        if self.current < self.limit:
            self.current += 1
            return self.current
        else:
           raise StopIteration  # 没有更多元素时抛出异常

# 使用迭代器
iterator = MyIterator(3)
for num in iterator:
    print(num)
2、协程(异步编程
协程是 Python 中的一种特殊的函数,它能暂停执行并且在需要时恢复执行。与普通的函数不同,协程函数在运行时能通过 await 和 async 关键字挂起执行,并等待某些操作完成(如 I/O 操作),然后再恢复执行。
协程能让程序在执行 I/O 密集型任务时不阻塞其他任务,因此非常适合并发处理。
async:定义协程函数的关键字。await:挂起协程执行,等待其他协程或任务完成
| 维度 | 协程 | 线程 | 进程 |
| 切换开销 | 函数调用级(ns) | 内核级(μs) | 最高(ms) |
| 并发数量 | 10万级 | 千级 | 百级 |
| 数据共享 | 直接共享 | 需同步机制 | IPC通信 |
| 适用场景 | I/O密集型 | 混合型 | CPU密集型 |
# Python 3.4之前(yield实现)
@asyncio.coroutine
def old_coroutine():
    yield from asyncio.sleep(1)

# Python 3.5+(async/await语法)
async def modern_coroutine():
    await asyncio.sleep(1)
    return "done"
协程与生成器的区别
生成器:用 yield 暂停并返回一个值,下一次调用继续执行;是可迭代对象。
协程:用 async def 定义,await 挂起等待,可与事件循环配合,实现异步调度;可返回值。
协程之间可通过 asyncio.Queue、asyncio.Event 等同步。
Python 3.11 引入 TaskGroup 简化并发管理。
sync with?
异步上下文管理器需实现 __aenter__ 和 __aexit__,与事件循环配合保证资源正确打开/关闭。
# 生成器
def gen():
    yield 1
    yield 2

# 协程
async def coro():
    await asyncio.sleep(1)
    return "done"
#with
#第三方异步库(如 aiomysql、aiohttp)常提供异步上下文管理支持。
#能保证异步资源自动清理,避免泄漏。
import aiofiles, asyncio

async def write_file():
    async with aiofiles.open('data.txt', 'w') as f:
        await f.write('Hello Async!')

asyncio.run(write_file())
3、json模块
Python 的 json 模块用于处理 JSON 数据,可以将 Python 对象转换为 JSON 格式(序列化),也可以将 JSON 格式的数据转换为 Python 对象(反序列化)。常用于 Web 开发中的数据交换。
常用方法
json.dumps():将 Python 对象转换为 JSON 字符串。
json.loads():将 JSON 字符串转换为 Python 对象。
json.dump():将 Python 对象直接写入文件,以 JSON 格式存储。
json.load():从文件中读取 JSON 格式数据并转换为 Python 对象。
import json

# Python 对象转换为 JSON 字符串
data = {'name': 'Alice', 'age': 30}
json_str = json.dumps(data)
print(json_str)  # 输出: {"name": "Alice", "age": 30}

# JSON 字符串转换为 Python 对象
data_dict = json.loads(json_str)
print(data_dict)  # 输出: {'name': 'Alice', 'age': 30}

# 将 Python 对象写入 JSON 文件
with open('data.json', 'w') as f:
    json.dump(data, f)

# 从 JSON 文件读取数据
with open('data.json', 'r') as f:
    loaded_data = json.load(f)
    print(loaded_data)  # 输出: {'name': 'Alice', 'age': 30}
4、pickle 模块
pickle 模块用于序列化和反序列化 Python 对象。序列化是将 Python 对象转换为字节流,以便保存到文件或通过网络传输。反序列化是将字节流转换回 Python 对象。
常用方法
pickle.dumps():将 Python 对象序列化为字节流。
pickle.loads():字节流反序列化为 Python 对象
pickle.dump():将 Python 对象序列化并写入文件。
pickle.load():从文件中读取字节流并反序列化为 Python 对象
import pickle
# Python 对象序列化为字节流
data = {'name': 'Bob', 'age': 25}
serialized_data = pickle.dumps(data)
print(serialized_data)

# 字节流反序列化为 Python 对象
deserialized_data = pickle.loads(serialized_data)
print(deserialized_data)  # 输出: {'name': 'Bob', 'age': 25}

# 将 Python 对象写入文件
with open('data.pkl', 'wb') as f:
    pickle.dump(data, f)

# 从文件中读取并反序列化
with open('data.pkl', 'rb') as f:
    loaded_data = pickle.load(f)
    print(loaded_data)  # 输出: {'name': 'Bob', 'age': 25}
5、GIL
GIL(Global Interpreter Lock) 是 CPython 解释器中的一个机制,它确保同一时刻只有一个线程在执行 Python 字节码。即使在多核 CPU 上,GIL 也会限制线程并行执行,导致 Python 在多线程中无法充分利用多核处理器的优势。
GIL 的影响:
多线程中的限制:由于 GIL 的存在,即使在多线程程序中,多个线程也不能同时执行 Python 代码。因此,Python 的多线程并不能提供与其他语言相同的并行性。
I/O 密集型任务:对于 I/O 密集型任务(如文件读取、网络请求),Python 的多线程仍然有效,因为线程在等待 I/O 操作时会释放 GIL。
CPU 密集型任务:对于 CPU 密集型任务,多线程无法充分利用多核 CPU,反而可能因为 GIL 的存在而导致性能瓶颈。
解决方法
多进程:通过 multiprocessing 模块,可以使用多个进程来充分利用多核 CPU,因为每个进程有自己的 GIL。
使用 C 扩展:某些 C 扩展(如 NumPy)能够绕过 GIL,实现并行计算
6、python的垃圾回收机制
Python 中的垃圾回收机制主要负责自动管理内存,回收不再使用的对象,避免内存泄漏。
| 方面 | 说明 |
|---|---|
| 核心机制 | 引用计数,引用计数为0时立即回收对象 |
| 循环引用问题 | 引用计数无法解决,使用 gc 模块分代回收 |
| 分代收集 | 将对象分为三代,频繁回收新生代,减少开销 |
| 手动控制 | 通过 gc 模块手动触发和调节垃圾回收 |
| 作用 | 自动管理内存,避免内存泄漏和程序崩溃 |
核心机制:Python 中每个对象维护一个引用计数器,记录有多少个引用指向该对象。计数变化:当创建新引用时,计数加一;当引用被删除或指向其他对象时,计数减一。回收时机:当引用计数降为零时,说明对象不再被使用,立即被销毁,释放内存。
循环引用:问题:引用计数无法处理循环引用(两个或多个对象互相引用,导致引用计数不为零,但对象不可达)。解决方案:Python 引入了垃圾回收器(gc 模块),专门检测和回收循环引用。
垃圾回收器(gc 模块):工作原理:采用分代收集算法,将对象分为三代(0代、1代、2代),新创建的对象属于0代。触发机制:当0代对象达到一定数量时,触发垃圾回收,检查不可达的循环引用对象。分代优势:大多数对象生命周期短,分代回收提高效率,减少不必要的检查。
内次管理-> 引用计数每个对象维护一个引用计数当计数为0时立即回收
垃圾回收(GC) 通过gc模块检测循环引用(对象相互引用计数不为0)定期清理
import gc
print(gc.isenabled())       # True
gc.disable()                # 关闭垃圾回收,仅依赖引用计数
obj = {}
a = obj; b = obj
del a, b                    # 引用计数归零,obj 立即释放
可通过 gc.get_threshold()、gc.set_threshold() 调优 GC 触发频率。
在高性能场景可短暂关闭 GC,批量创建对象后再手动 gc.collect()
7、如何优化 Python 代码的性能?
性能优化方法
避免不必要的计算:使用缓存(例如 lru_cache)来避免重复计算;使用生成器(yield)代替列表推导式,避免在内存中存储大量数据。
选择合适的数据结构:
使用哈希表(字典)来快速查找数据;使用 collections.deque 替代列表进行队列操作,因为它在两端操作比列表更高效。
避免过多的函数调用:
内部函数调用会增加调用栈的负担,可以考虑使用内联计算或通过 map() 等高效函数来替代。
使用并行计算:
对于 CPU 密集型任务,使用 multiprocessing 模块创建多进程;对于 I/O 密集型任务,使用 asyncio 或 threading 模块实现异步或多线程处理。
优化内存使用:
使用生成器代替列表,避免一次性加载大量数据到内存中;使用sys.getsizeof() 或 memory_profiler 来分析内存使用情况。
8、线程、进程、协程
进程:
定义:进程是操作系统分配资源的基本单位,是程序运行时的一个实例。特点:每个进程拥有独立的内存空间、系统资源和执行上下文。多进程:操作系统可以同时运行多个进程,实现并发或并行
Python 通过 multiprocessing 模块实现多进程。multiprocessing 模块封装了底层操作系统的进程管理接口,支持跨平台。通过创建 Process 对象,指定目标函数和参数,启动新进程。
from multiprocessing import Process

def worker(name):
    print(f"进程 {name} 正在运行")

if __name__ == '__main__':
    p1 = Process(target=worker, args=('A',))
    p2 = Process(target=worker, args=('B',))
    p1.start()
    p2.start()
    p1.join()
    p2.join()
    print("所有进程执行完毕")
进程间内存独立,通信需使用 IPC(如队列、管道、共享内存)Python multiprocessing 提供多种 IPC 方式:
队列(Queue):基于管道实现,线程安全,适合传递消息。
管道(Pipe):双向通信通道。
共享内存(Value、Array):共享简单数据类型。
Manager:支持共享复杂数据结构。
不受 GIL 限制,能实现真正的并行计算。适用于:计算密集型任务,如图像处理、科学计算。
| 优点 | 缺点 |
|---|---|
| 充分利用多核 CPU,适合 CPU 密集型 | 创建和切换开销大,资源消耗高 |
| 进程间相互独立,安全性高 | 进程间通信复杂 |
进程池:
进程池用于管理大量进程,避免频繁创建销毁进程带来的开销。通过 multiprocessing.Pool 创建进程池,支持异步执行任务。
from multiprocessing import Pool

def f(x):
    return x * x

if __name__ == '__main__':
    with Pool(4) as p:
        results = p.map(f, [1, 2, 3, 4])
        print(results)
线程
定义:线程是操作系统调度的最小执行单元,是程序执行流的基本单位。特点:同一进程内的多个线程共享进程的内存空间和资源。Python 线程:通过 threading 模块实现多线程编程。
线程实现
使用 threading.Thread 类创建线程,指定目标函数和参数。线程启动后,操作系统调度线程执行。线程共享全局变量,通信方便,但需注意线程安全。
适用场景:多线程适合 I/O 密集型任务,如网络请求、文件操作。
import threading

def worker(num):
    print(f"线程 {num} 正在运行")

threads = []
for i in range(5):
    t = threading.Thread(target=worker, args=(i,))
    threads.append(t)
    t.start()

for t in threads:
    t.join()

print("所有线程执行完毕")
线程同步:
多线程共享资源时,需使用同步机制避免竞态条件。Python 提供多种同步原语
Lock(互斥锁);RLock(可重入锁);Semaphore(信号量);Event(事件);Condition(条件变量)
线程间通信可以通过共享内存、队列(queue.Queue)和事件(threading.Event)等方式进行。
Queue 是线程安全的,适合生产者-消费者模式。
import threading
import queue

def producer(q):
    for i in range(5):
        q.put(i)

def consumer(q):
    while True:
        item = q.get()
        if item is None:
            break
        print(f"Consumed: {item}")

q = queue.Queue()
t1 = threading.Thread(target=producer, args=(q,))
t2 = threading.Thread(target=consumer, args=(q,))

t1.start()
t2.start()

t1.join()
q.put(None)  # 结束消费线程
t2.join()
threading 模块和 multiprocessing 模块区别
| 方面 | threading 模块 | multiprocessing 模块 |
|---|---|---|
| 运行方式 | 多线程,受 GIL 限制,线程间共享内存 | 多进程,独立内存空间,真正并行 |
| 适用场景 | I/O 密集型任务 | CPU 密集型任务 |
| 资源开销 | 较小 | 较大 |
| 进程间通信 | 共享内存,需同步机制 | 通过管道、队列等 IPC 机制 |
| 创建和销毁速度 | 快 | 慢 |
协程
定义:协程是一种用户态的轻量级线程,通过事件循环调度,实现非阻塞的并发执行。特点:协程在单线程内切换,避免线程切换的开销,适合大量 I/O 密集型任务。区别于线程:协程不是由操作系统调度,而是由程序自身控制切换。
协程的实现: Python 3.4 引入 asyncio 模块,提供事件循环和协程支持。;Python 3.5+ 引入 async 和 await 关键字,简化协程定义和调用。;协程函数使用 async def 定义,内部通过 await 挂起等待异步操作完成。
import asyncio

async def say_hello():
    print("Hello")
    await asyncio.sleep(1)
    print("World")

async def main():
    await asyncio.gather(say_hello(), say_hello())

asyncio.run(main())
协程的工作原理
事件循环:负责调度协程的执行,管理任务的挂起和恢复。任务(Task):包装协程对象,交给事件循环调度。挂起点:协程遇到 await 表达式时挂起,等待异步操作完成后恢复执行。
| 优点 | 缺点 |
|---|---|
| 轻量级,创建和切换开销极小 | 编程模型复杂,需要异步思维 |
| 高效处理大量并发 I/O | 不适合 CPU 密集型任务 |
| 避免线程切换和锁竞争 | 依赖异步库支持 |
三者对比
| 方面 | 线程(Thread) | 进程(Process) | 协程(Coroutine) |
|---|---|---|---|
| 内存空间 | 共享 | 独立 | 共享(单线程) |
| 并行性 | 受 GIL 限制,CPU 密集型受限 | 真正并行,适合 CPU 密集型 | 单线程内并发,适合 I/O 密集型 |
| 创建开销 | 较小 | 较大 | 极小 |
| 切换开销 | 较小 | 较大 | 极小 |
| 编程复杂度 | 低 | 中等 | 较高,需要异步编程思维 |
| 适用场景 | I/O 密集型任务 | CPU 密集型任务 | 大量并发 I/O,异步网络编程 |
并发、异步编程
并发:通过多线程或多进程实现任务同时执行,适合 CPU 密集或 I/O 密集任务。
异步:基于事件循环和协程,单线程内实现高效 I/O 并发,适合大量 I/O 操作。
| 特性 | 多线程/多进程并发 | 异步编程(asyncio) |
|---|---|---|
| 线程数 | 多线程/多进程 | 单线程事件循环 |
| 适用场景 | CPU 密集型、多核利用 | I/O 密集型、高并发 |
| 编程模型 | 线程/进程切换 | 协程挂起与恢复 |
| 资源消耗 | 较高 | 较低 |
asyncio 进行异步测试?
使用 asyncio 的事件循环运行异步测试函数,确保异步代码正确执行。结合 pytest-asyncio 插件简化异步测试。pytest-asyncio 允许直接用 async def 定义测试函数,自动管理事件循环
import asyncio

async def async_func():
    await asyncio.sleep(1)
    return 42

def test_async():
    result = asyncio.run(async_func())
    assert result == 42
import pytest
import asyncio

@pytest.mark.asyncio
async def test_async():
    await asyncio.sleep(0.1)
    assert True
多进程测试与进程通信
多进程测试可利用 multiprocessing 模块,进程间通信(IPC)通过队列、管道、共享内存实现。
from multiprocessing import Process, Queue

def worker(q):
    q.put("done")

q = Queue()
p = Process(target=worker, args=(q,))
p.start()
p.join()
print(q.get())
微服务、消息驱动架构的测试策略、事件流系统
测试难点:1)服务依赖复杂,测试环境搭建困难。2)服务接口频繁变更,契约维护难。3)分布式事务和数据一致性难测。4)性能瓶颈难定位。
可以使用:契约测试、服务虚拟化、端到端测试等缓解。自动化和监控是关键
消息驱动架构测试:1)测试消息格式和内容。2)测试消息顺序和幂等性。3)测试消息丢失和重复处理。4)性能和压力测试。5)使用模拟消息代理。6)结合日志和监控
事件流系统测试:1)验证事件产生、传递和消费。2)测试事件顺序和一致性。3)性能和容错测试。4)使用事件回放和模拟。5)结合分布式追踪。
9、元编程与反射
元编程指的是编写能够操作、生成或修改代码本身的程序。
在 Python 中,元编程允许程序在运行时动态地创建类、修改类或函数的行为。常用技术包括动态创建类、装饰器、元类(metaclass)、反射等。元编程提高代码的灵活性和复用性,常用于框架设计和动态功能扩展
Python 中如何使用反射?
反射是指程序在运行时动态获取对象信息或调用对象方法的能力。Python 提供内置函数实现反射
getattr(obj, name[, default]):获取对象属性或方法。
setattr(obj, name, value):设置对象属性。
hasattr(obj, name):判断对象是否有某属性。
delattr(obj, name):删除对象属性。
10、Python 中如何开启调试模式?
Python 提供了 pdb(Python Debugger)模块用于调试。通过 import pdb; pdb.set_trace() 可以在代码中设置断点。
import pdb

def divide(a, b):
    pdb.set_trace()  # 设置断点
    return a / b

divide(4, 2)
可以使用 python -m pdb script.py 命令在命令行中启动调试器。还可以结合 logging 模块进行更灵活的调试信息输出。
11、内存泄漏与内存池机制
内存泄漏
虽有自动回收,循环引用(尤其含 __del__ 方法)或全局变量(如缓存)未清理,都可导致内存无法释放。threading.local() 等线程局部存储不当也会造成泄漏。
class A:
    def __init__(self, b): self.b = b
class B:
    def __init__(self, a): self.a = a

a = A(None)
b = B(a)
a.b = b  # 循环引用
del a, b  # 引用计数不为 0,需 gc.collect() 清理
使用 gc 模块的 get_referrers()、get_referents() 辅助定位泄漏源。推荐避免长生命周期结构中存放大对象,定期清空缓存或使用 weakref(weakref 模块提供弱引用,不增加对象的引用计数,可打破循环引用,让垃圾回收器正常释放)
import weakref

class Node:
    def __init__(self, value):
        self.value = value
        self.parent = None
        self.children = []

root = Node(0)
child = Node(1)
root.children.append(child)
child.parent = weakref.ref(root)  # 弱引用

del root
# root 可以被回收,child.parent() 返回 None
Python 中的内存池机制是什么?
CPython 实现了 小对象内存池(PyMalloc),对小于 512 字节的对象频繁分配使用预分配内存池,减少系统调用,提高效率。
示例:当你频繁创建、销毁小整型、短字符串等,CPython 会从内存池中分配,而不是每次向操作系统申请。
内存池机制对性能提升显著,但可能导致内存碎片。对超大对象,直接调用 malloc/free,不走内存池。
内存优化技巧:避免过多的短生命周期对象,使用生成器代替列表节省内存、预分配内存空间使用__slots__限制对象属性,处理大量数据时利用numpy活着pandas搞笑内存管理库。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 17
 0
- 0


 已为社区贡献4条内容

所有评论(0)