【课程笔记】华为 HCIA-Big Data 大数据09:Kafka分布式消息订阅系统
目录
1. Kafka分布式消息订阅系统(强依赖ZooKeeper)
学习目标:
①Kafka分布式消息订阅系统、点对点消息传递模式、发布-订阅消息传递模式
②Kafka特点
③Kafka拓扑结构图、Broker、Topic、Partition、Producer、Consumer、Consumer Group、offset偏移量
④offset存储机制
⑤Kafka其他重要概念、Replica、Leader、Follow、Controller
⑥Kafka Partition Replica
⑦Kafka的Leader和Follow消息同步、ISR、当所有Replica副本不工作时
⑧消息传输语义、At most once、At least once、Exactly once
⑨可靠性保证、幂等性、acks机制
⑩旧数据处理方式
1. Kafka分布式消息订阅系统(强依赖ZooKeeper)
Kafka最初由LinkedIn公司开发,是基于ZooKeeper协调的分布式日志系统
主要应用场景:日志收集系统和消息系统
分布式消息传递基于可靠的消息队列,在客户端应用和消息系统之间异步传递消息。有两种消息传递:点对点传递模式、发布-订阅模式(大多数)
Kafka就是发布-订阅模式
(1)点对点消息传递模式
消息持久化到队列,此时,会有一个或多个消费者消费队列中的数据。但一条消息只能被消费一次。当一个消费者消费了队列中的某条数据后,该条数据会从队列中删除。该模式即使有多个消费者同时消费数据,也能保证数据处理的顺序
(2)发布-订阅消息传递模式
消息持久化到一个topic中,消费者可以订阅一个或多个topic,消费者可以消费该topic中所有的数据,同一条数据可以被多个消费者消费,数据被消费后不会立马删除。消息生产者叫发布者,消费者叫订阅者
2. Kafka特点
(1)以时间复杂度为O(1)【常量,不会随数据量变大时间变小】的方式提供消息持久化能力,即使对TB以上数据也能保证常熟时间访问
(2)高吞吐率。即使在廉价机器也能单机每秒100K条消息传输
(3)支持消息分区,分布式消费,同时保证每个分区内消息顺序传输
(4)同时支持离线数据处理和实时数据处理
(5)Scale out:支持在线水平扩展
3. Kafka拓扑结构图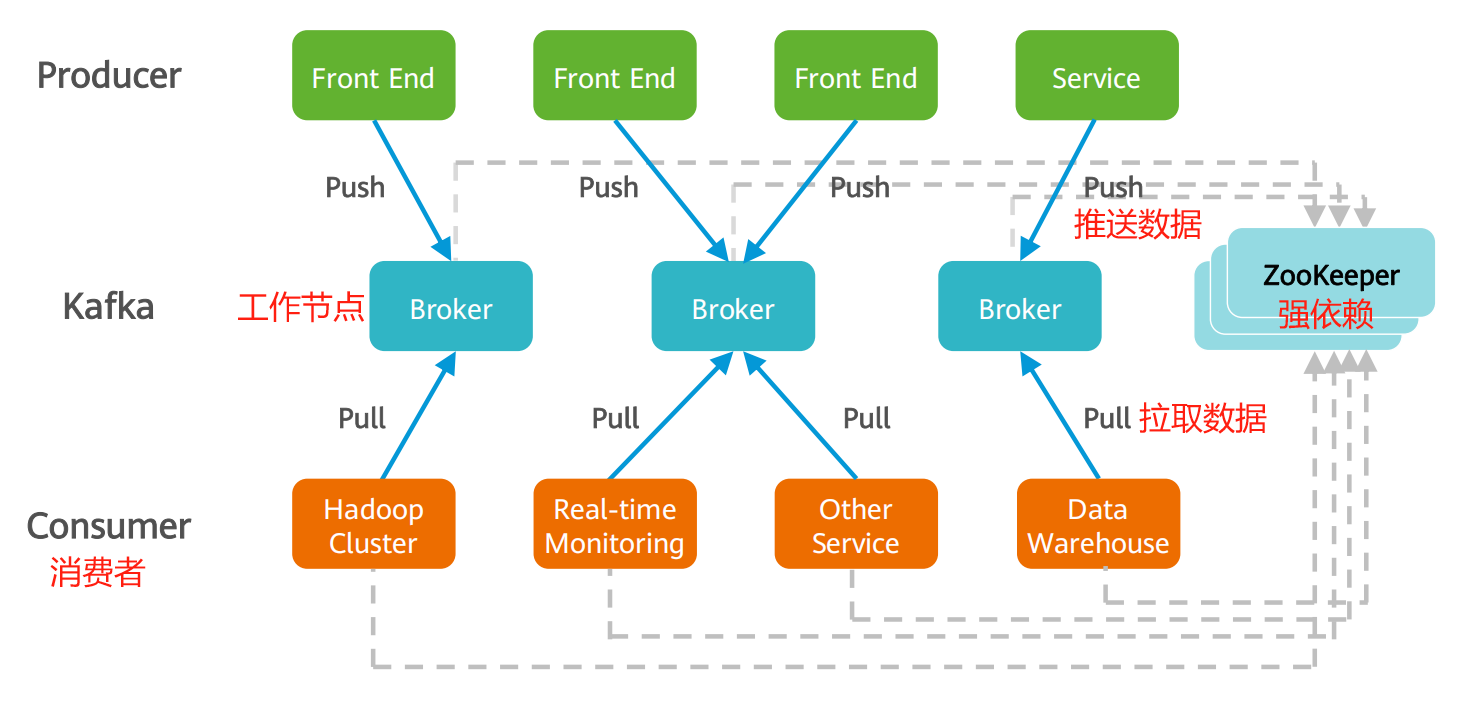
(1)Broker:服务实例,可以动态添加
(2)Topic:每条发布到Kafka集群的消息都要有类别、主题
(3)Partition:Kafka把Topic分成一个或多个Partition分区,每个分区在物理上对应一个文件夹,该文件夹下存储这个Partition所有消息和索引文件
(4)Producer:负责发布消息到Kafka Broker
(5)Consumer:消费者(记录Offset,数据偏移量)
(6)Consumer Group:每个消费者属于一个特定的Consumer Group,组内消费者对于数据是竞争,组间的消费者对于数据是共享
Partition分区支持被消费者并行读取,如: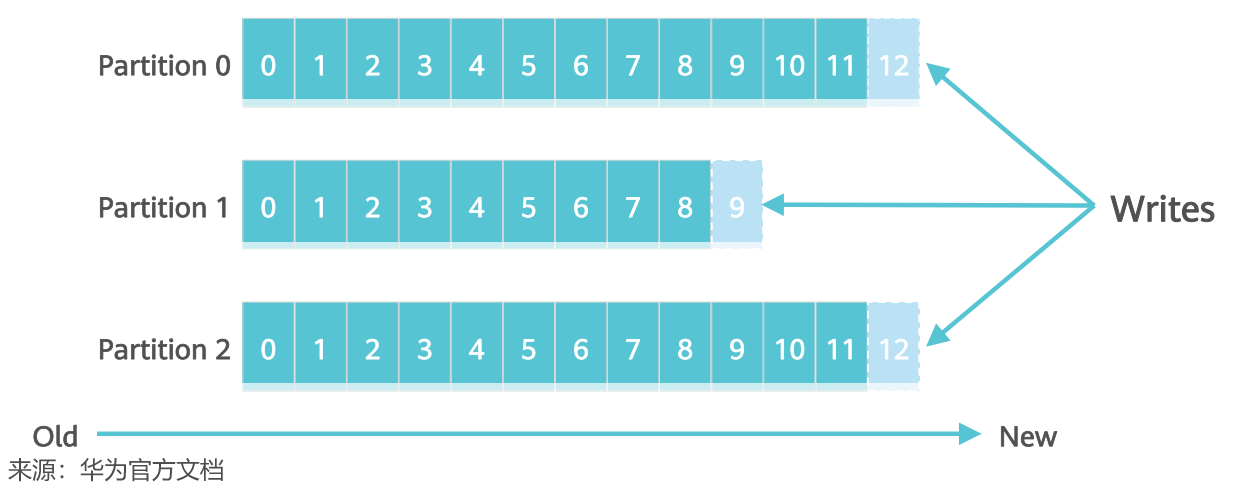
每条消息在文件中的位置叫offset偏移量
消费者通过(offset、partition、topic)跟踪记录
4. offset存储机制
Consumer在从Broker读取消息后,可以选择commit,该操作会在Kafka中保存该Consumer消费者在该Partition中读取的消息offset。该Consumer下一次再读该Partition时会从下一条开始读(保证同一消费者从Kafka中不会重复消费数据)
5. Kafka其他重要概念(默认HA)
(1)Replica:是Partition的副本,保障Partition分区的高可用
(2)Leader和Follow:在既有分区又有副本的情况下,对外服务的肯定只有一个。这两都是"Replica"的角色。Leader负责跟Producer和Consumer交互,而Follow从"Leader"复制数据
(3)Controller:Kafka集群中的服务器,用来进行对Leader的选举(当leader挂了)
6. Kafka Partition Replica
Kafka所有消息都会被持久化硬盘中(相互绑定)
每个Partition有一个至多个Replication副本,且该副本分布在集群不同Broker上来提高可用性。Partition分区的每个Replication副本在逻辑上抽象为一个日志(Log)对象,是一一对应的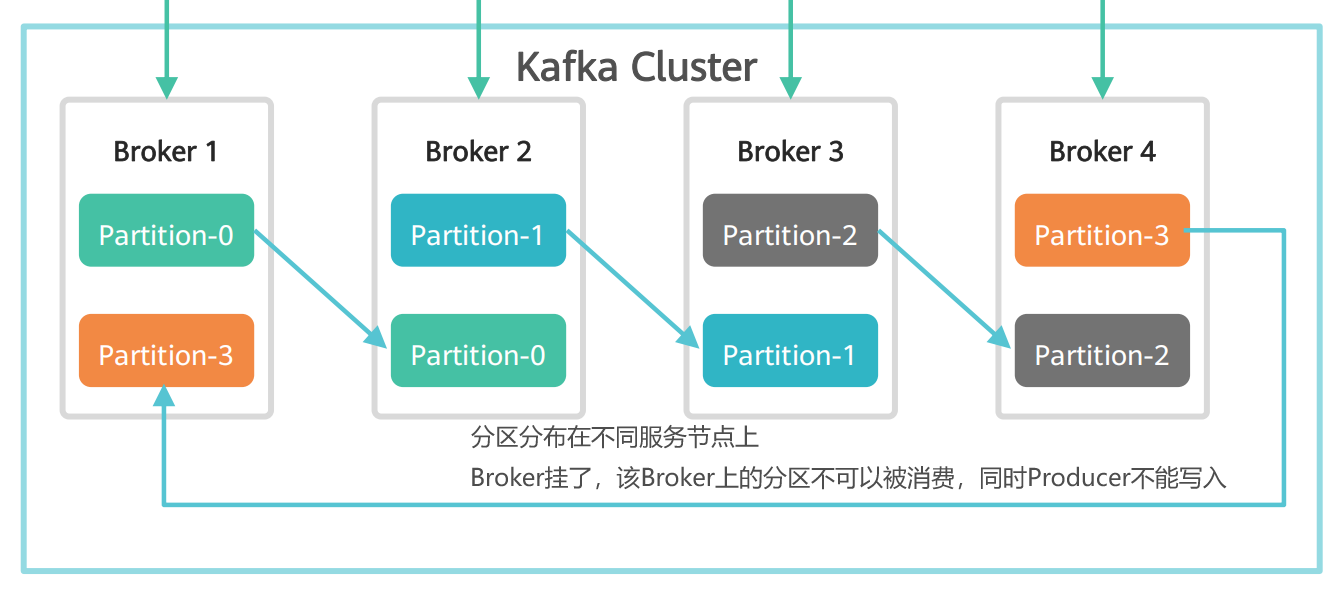
7. Kafka的Leader和Follower消息同步
Follower从Leader那拉取高水位以下的已经存储的消息到本地的Log(日志)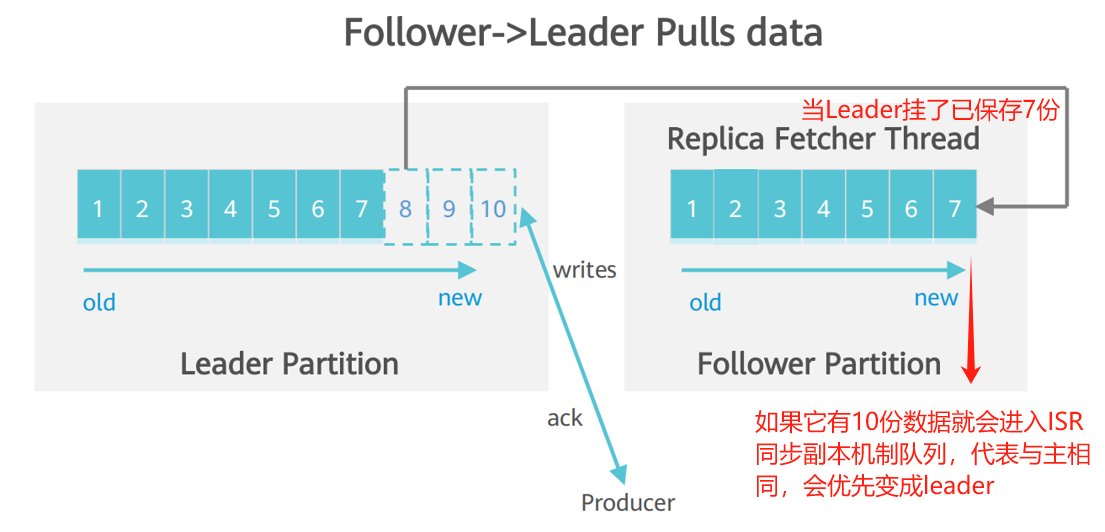
对于f+1个Replica副本,Partition可以容忍f个Replica失效的情况下保证消息不丢失
当所有Replica副本都不工作:
(1)等待ISR中任一Replica活过来,并选它为Leader。可保障数据不丢失但时间可能相对较长
(2)选择第一个活过来的Replica(不一定是ISR成员)作为Leader。无法保障数据不丢失,但相对不可用时间较短
选择更高第(2)种,不一定能活过来既然第(1)种挂了
8. 消息传输语义
(1)At most once 最多一次
消息可能丢失;消息不会重复发送和处理
(2)At Least once 最少一次
消息不会丢失;消息可能会重复发送和处理
(3)Exactly once 仅有一次
消息不会丢失;消息仅被处理一次
9. 可靠性保证
(1)幂等性:被执行多次造成的影响和只执行一次造成的影响一样
原理:
①每发送到Kafka的消息都含有一个序列号,Broker使用这个序列号来删除重复数据
②这个序列号被持久化到副本日志,即使分区的Leader挂了,其他Broker接管了Leader,新Leader仍可以判断重复发送的是否重复
③这种机制开销非常低,每批消息只有几个额外的字段
(2)acks机制
Producer生产者需要Server接收到信号之后发出确认接收的信号,此项配置指Producer需要多少个这样的确认信号(实际代表了数据备份的可用性)
①acks=0,Producer不需要信号
②acks=1,至少要等Leader成功将数据写入本地Log,但并没有等待所有Follower是否成功写入。如果该Leader挂了,消息会丢弃
③acks=all或者-1,Leader要等所有备份都成功写入日志,这种策略会保证只要有一个备份存活就不会丢数据(Leader接收数据,Follow拉取数据)
10. 旧数据处理方式
默认Kafka存储168小时,过了就删
Kafka把Topic中的一个Partition分区大文件分成多个小文件段,通过多个小文件段就容易定期清除或删除已经消费完文件,减少磁盘占用
.index数据的偏移量,.log是实际数据。它俩组成一批数据,存在一批批数据
Kafka集群会保留所有消息,无论其被消费与否,但因磁盘限制肯定要删
日志的清理方式有两种:delete和compact(压缩,旧数据删除,key相同留下最大的values)
删除的阈值有两种:过期的时间和分区内总日志大小,触发都会删除老数据
①日志数据文件保留最长时间168小时
②每个Partition上的日志数据所能达到的最大字节,默认不限制-1,可以修改
Kafka不支持消息随机读取

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献2条内容

所有评论(0)