北京智源开源 RoboBrain :从抽象到具体的机器人操纵统一脑模型
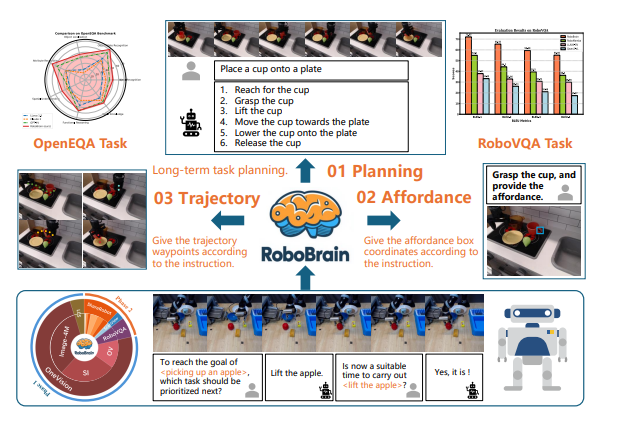
近年来,多模态大语言模型(MLLM)的快速发展极大地推动了人工通用智能(AGI)的研究进展。通过利用来自互联网的海量多模态数据并结合自监督学习技术,MLLMs 在视觉感知和理解人类语言指令方面表现出了非凡的能力。然而,尽管 MLLMs 在一般任务中的表现令人印象深刻,但在具身场景中仍面临巨大挑战,尤其是在长视距操作任务中。
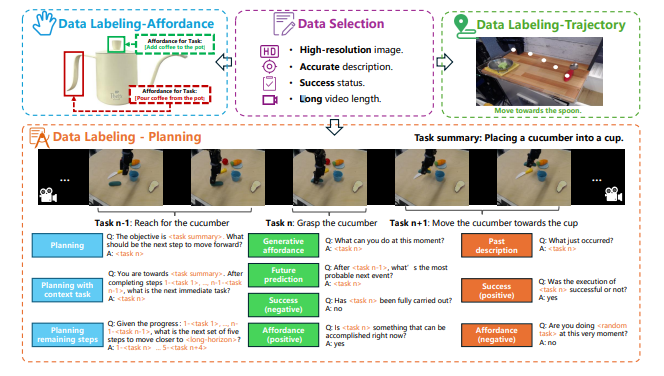
在机器人学中,长视距操纵任务是机器人执行复杂任务的核心能力之一。这些任务通常涉及多个步骤和长期互动,例如 "在厨房准备一杯茶 "或 “在仓库完成物品分类”。这类任务要求机器人不仅要理解抽象指令,还要将这些指令转化为具体行动。具体来说,成功执行长期操控任务依赖于三种核心能力:
-
规划:机器人需要将复杂的抽象指令分解为可执行的子任务。例如,"提起茶壶并将水倒入杯中 "必须分解为 “靠近茶壶并提起”、"移动茶壶使壶嘴对准杯口 "和 "倾斜茶壶倒水 "等步骤。
-
辅助感知:机器人必须准确识别物体的可操作区域,例如茶壶的把手或壶嘴,以确保其操作的精确性。
-
轨迹预测:机器人需要根据任务指令预测从起点到目标位置的完整路径,例如从当前位置到茶壶把手的运动轨迹。
然而,现有的 MLLM 在这些方面表现出明显的缺陷。例如,在面对 "提起茶壶并将水倒入杯中 "的任务时,MLLMs 可能难以准确分解任务步骤、识别茶壶的可抓取区域,甚至难以预测从起点到目标位置的完整轨迹。这些局限性主要源于目前缺乏专门为 MLLM 和机器人长视距操纵任务设计的大规模精细数据集。

为了填补这一空白,我们提出了 ShareRobot–一个专为机器人操纵任务设计的高质量异构数据集。ShareRobot 注释了多维信息,包括任务规划、物体承受区域和末端执行器轨迹,为增强机器人能力奠定了坚实的基础。在 ShareRobot 的基础上,我们开发了机器人大脑(RoboBrain),这是一个统一的体现性多模态大脑模型,旨在增强机器人在长视距操纵任务中的能力。通过精心设计的数据配比、多阶段训练策略以及长视频和高分辨率图像的输入,RoboBrain 实现了从抽象任务指令到具体行动表达的认知飞跃,展示了其在机器人领域的实际应用潜力。
RoboBrain 包含用于远距离操纵任务的三种关键机器人能力:规划、能力感知和轨迹预测。基于我们构建的 ShareRobot 数据集,RoboBrain 通过精心设计的多阶段训练过程,在多个机器人基准测试中取得了最先进的性能,实现了从抽象指令理解到具体行动表达的认知飞跃。
使用
import torch
from transformers import AutoProcessor, AutoModelForPreTraining

model_id = "BAAI/RoboBrain"

print("Loading Checkpoint ...")
model = AutoModelForPreTraining.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    low_cpu_mem_usage=True,
).to("cuda:0")

processor = AutoProcessor.from_pretrained(model_id)

# Define a chat history and use `apply_chat_template` to get correctly formatted prompt
# Each value in "content" has to be a list of dicts with types ("text", "image")
messages = [
    {
        "role": "user",
        "content": [
            {"type": "text", "text": "What is shown in this image?"},
            {"type": "image", "url": "http://images.cocodataset.org/val2017/000000039769.jpg"},
        ],
    },
]

print("Processing input...")
inputs = processor.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt"
)

inputs = {k: v.to("cuda:0") for k, v in inputs.items()}

print("Generating output...")
output = model.generate(**inputs, max_new_tokens=250)
print(processor.decode(output[0][2:], skip_special_tokens=True))

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 29
 0
- 0


 已为社区贡献14条内容

所有评论(0)