【机器学习实战1】K-近邻算法---海伦约会
目录
一、问题引入
海伦一直使用在线约会网站寻找适合自己的约会对象。她曾交往过三种类型的人:
- 不喜欢的人
- 一般喜欢的人
- 非常喜欢的人
海伦收集的约会数据存放在文本文件datingTestSet.txt中,每个样本数据占据一行,总共有1000行。海伦的样本主要包含以下三种特征:
1. 每年获得的飞行常客里程数
2. 玩视频游戏所耗时间百分比
3. 每周消费的冰淇淋公升数
该网站现在需要尽可能向海伦推荐她喜欢的人,需要我们设计一个分类器,根据用户的以上三种特征,识别出是否该向海伦推荐。
二、需求概要分析
根据问题,我们可知,样本特征个数为3,样本标签为三类。现需要实现将一个待分类样本的三个特征值输入程序后,能够识别该样本的类别,并且将该类别输出。
三、程序结构设计说明
根据问题,可以知道程序大致流程如下:
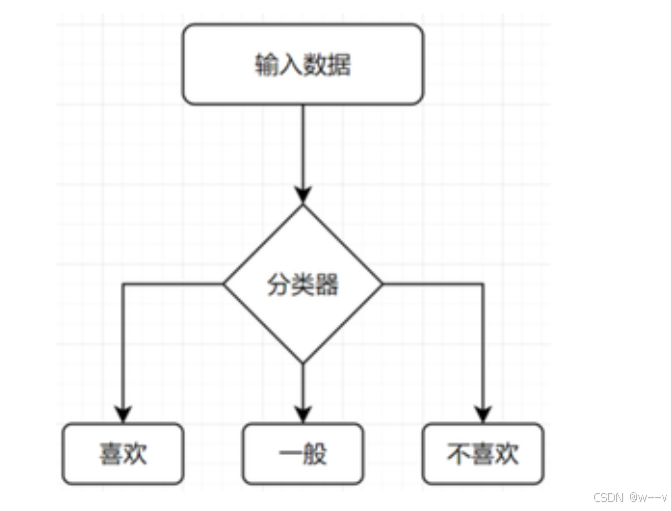
其中输入数据包含三个值,输出为喜欢,一般,不喜欢,三个中的一个。
四、算法实现
1.数据加载
在将上述特征数据输入到分类器前,必须将待处理的数据的格式改变为分类器可以接收的格式。要将数据分类两部分,即特征矩阵和对应的分类标签向量。在knn.py文件中创建函数load_data来处理输入格式问题。并将datingTestSet.txt放到与knn.py相同目录下。代码如下:
# 加载数据
def load_data(file_path):
    # 从指定路径加载数据集
    data = np.loadtxt(file_path, delimiter='\t', dtype=str)
    # 提取特征数据(前三列),并将其转换为浮点数
    features = data[:, :3].astype(float)
    # 定义标签映射,将文本标签转换为整数
    label_map = {'didntLike': 0, 'smallDoses': 1, 'largeDoses': 2}
    # 提取标签数据(最后一列),并根据映射将其转换为整数
    labels = np.array([label_map[label] for label in data[:, -1]])
    return features, labels

# 加载数据文件
file_path = 'datingTestSet.txt'
features, labels = load_data(file_path)
我们已经顺利导入数据,并对数据进行解析,格式化为分类器需要的数据格式。
2. 数据归一化
下表给出了四组样本,如果想要计算样本3和样本4之间的距离,可以使用欧式距离公式计算。
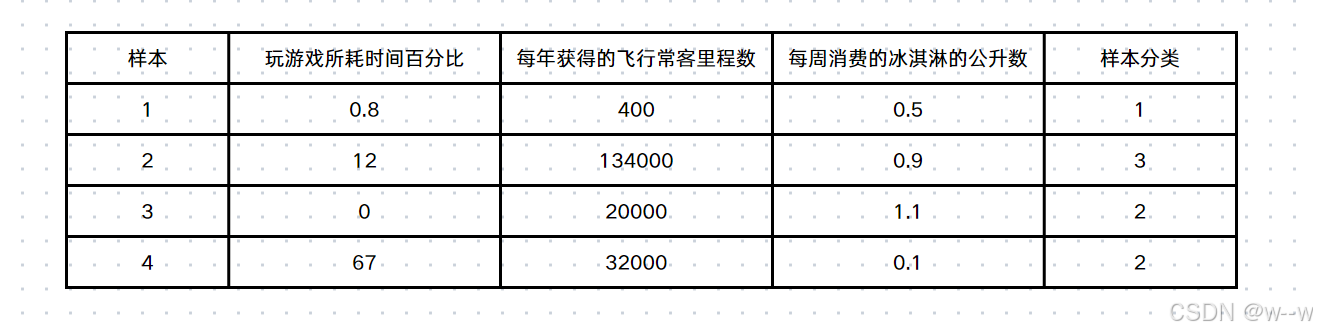
计算方法如图:
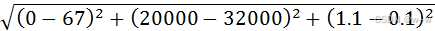
我们很容易发现,当计算样本之间的距离时数字差值最大的属性对计算结果的影响最大,也就是说,每年获取的飞行常客里程数对于计算结果的影响将远远大于上表中其他两个特征-玩视频游戏所耗时间占比和每周消费冰淇淋公斤数的影响。而产生这种现象的唯一原因,仅仅是因为飞行常客里程数远大于其他特征值。但海伦认为这三种特征是同等重要的,因此作为三个等权重的特征之一,飞行常客里程数并不应该如此严重地影响到计算结果。
在处理这种不同取值范围的特征值时,我们通常采用的方法是将数值归一化,如将取值范围处理为0到1或者-1到1之间。下面的公式可以将任意取值范围的特征值转化为0到1区间内的值:
newValue = (oldValue - min) / (max - min)
其中min和max分别是数据集中的最小特征值和最大特征值。改变数值取值范围增加了分类器的复杂度,为了得到准确结果,我们需要这样做。在knn.py文件中编写函数normalize_data,用该函数将数据归一化。代码如下:
# 归一化数据
def normalize_data(data):
    # 计算每列数据的最小值
    min_vals = data.min(axis=0)
    # 计算每列数据的最大值
    max_vals = data.max(axis=0)
    # 计算每列数据的范围(最大值 - 最小值)
    ranges = max_vals - min_vals
    # 使用公式 (data - min_vals) / ranges 将数据归一化到 [0, 1] 范围
    norm_data = (data - min_vals) / ranges
    return norm_data, ranges, min_vals

# 对特征数据进行归一化处理
norm_features, ranges, min_vals = normalize_data(features)
3. K近邻分类函数
对于一个新的输入样本,通过计算输入样本与训练集中每个样本的欧氏距离。对距离进行排序,找出距离最近的 k 个样本(即“近邻”),然后根据这些近邻的类别标签进行投票,选择出现次数最多的类别作为预测结果。代码如下:
# K近邻分类函数
def classify_knn(in_x, data_set, labels, k):
    # 获取数据集的样本数量
    data_set_size = data_set.shape[0]
    # 计算输入样本与数据集中每个样本的差值矩阵
    diff_mat = np.tile(in_x, (data_set_size, 1)) - data_set
    # 计算差值矩阵的平方
    sq_diff_mat = diff_mat ** 2
    # 计算每个样本的欧氏距离的平方
    sq_distances = sq_diff_mat.sum(axis=1)
    # 计算欧氏距离
    distances = sq_distances ** 0.5
    # 对距离进行排序,获取排序后的索引
    sorted_dist_indices = distances.argsort()
    # 创建字典用于统计前 k 个最近邻的类别
    class_count = {}
    for i in range(k):
        # 获取第 i 个最近邻的类别
        vote_label = labels[sorted_dist_indices[i]]
        # 统计类别出现的次数
        class_count[vote_label] = class_count.get(vote_label, 0) + 1
    # 按类别出现的次数降序排序
    sorted_class_count = sorted(class_count.items(), key=lambda x: x[1], reverse=True)
    # 返回出现次数最多的类别
    return sorted_class_count[0][0]
4. 数据集划分
随机打乱数据索引,根据比例将数据集划分为训练集和测试集。代码如下
# 划分数据集
def split_data_set(data_set, labels, test_ratio=0.1):
    # 获取数据集的样本数量
    data_set_size = data_set.shape[0]
    # 计算测试集的大小
    test_size = int(data_set_size * test_ratio)
    # 获取所有样本的索引
    indices = list(range(data_set_size))
    # 随机打乱索引
    np.random.shuffle(indices)
    # 获取测试集的索引
    test_indices = indices[:test_size]
    # 获取训练集的索引
    train_indices = indices[test_size:]
    # 根据索引划分训练集和测试集
    train_data = data_set[train_indices, :]
    train_labels = labels[train_indices]
    test_data = data_set[test_indices, :]
    test_labels = labels[test_indices]
    return train_data, train_labels, test_data, test_labels

# 划分训练集和测试集
train_data, train_labels, test_data, test_labels = split_data_set(norm_features, labels, test_ratio=0.1)
5. 测试 K 近邻算法
K近邻算法既可以用于分类任务,也可以用于回归任务。虽然它们的基本思想相同(即通过找到输入样本的K个最近邻居来进行预测),但在具体实现和输出结果上有所不同。
- 对于分类任务:查看K个最近邻居中最常见的类别,作为预测结果。例如,如果K=3,并且三个最近邻居的类别是[1, 2, 1],那么预测结果就是类别1。
- 对于回归任务:预测结果可以是K个最近邻居的平均值或加权平均值。
选择K近邻算法在分类任务中的应用,即通过统计K个最近邻居中最常见的类别来作为预测结果。对测试集中的每个样本调用classify_knn函数进行预测,统计错误率。代码如下:
# 测试K近邻算法
def test_knn(train_data, train_labels, test_data, test_labels, k):
    # 初始化错误计数
    error_count = 0
    # 获取测试集的样本数量
    total_count = test_data.shape[0]
    # 用于存储预测结果
    predictions = []
    # 遍历测试集中的每个样本
    for i in range(total_count):
        # 使用 KNN 算法进行预测
        predict_label = classify_knn(test_data[i], train_data, train_labels, k)
        # 将预测结果存储到列表中
        predictions.append(predict_label)
        # 打印每个测试样本的真实标签和预测标签
        print(f"Test Sample {i + 1}: True Label = {test_labels[i]}, Predicted Label = {predict_label}")
        # 如果预测错误,增加错误计数
        if predict_label != test_labels[i]:
            error_count += 1
    # 计算错误率
    error_rate = error_count / total_count
    print(f"Error Rate: {error_rate:.2f}")
    return predictions

# 测试 KNN 算法,使用 k=3
predictions = test_knn(train_data, train_labels, test_data, test_labels, k=3)
6. 绘制3D散点图
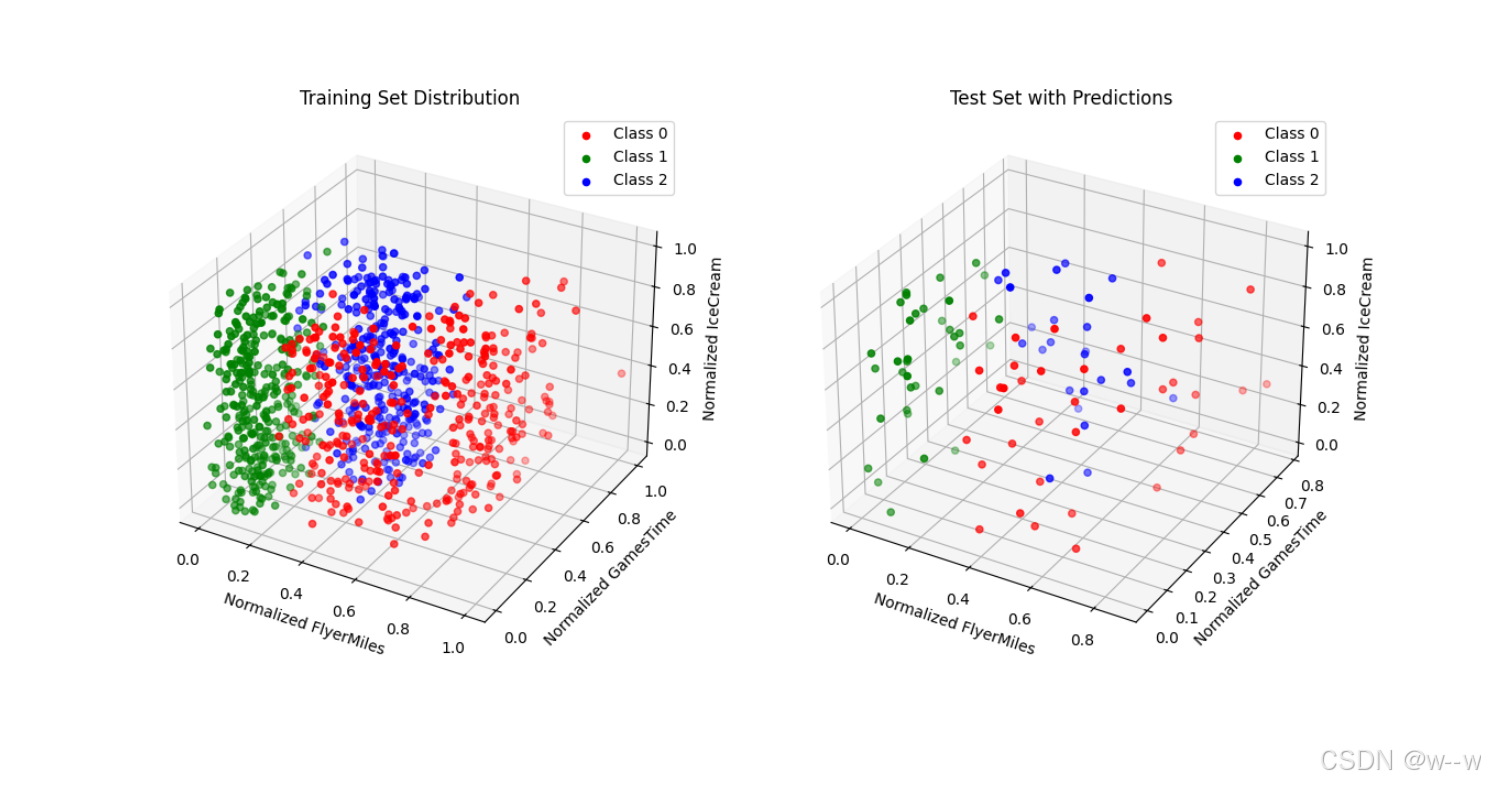
为了直观地展示数据集的分布情况以及分类结果,使用3D散点图进行可视化。使用matplotlib的 add_subplot方法创建两个3D子图,分别用于绘制两个数据集的散点图。根据类别标签,使用不同的颜色绘制数据点,并添加图例和坐标轴标签。然后通过plt.show 方法展示最终的 3D 散点图。代码如下:
# 绘制3D散点图
def plot_3d_side_by_side(data_set1, labels1, title1, data_set2, labels2, title2):
    # 创建图形窗口,设置大小为14x7
    fig = plt.figure(figsize=(14, 7))

    # 创建第一个子图(位于左侧)
    ax1 = fig.add_subplot(121, projection='3d')  # 1行2列的第1个位置
    # 定义颜色列表,用于区分不同类别
    colors = ['red', 'green', 'blue']
    # 遍历每个类别,绘制散点图
    for label in np.unique(labels1):
        ax1.scatter(data_set1[labels1 == label, 0], data_set1[labels1 == label, 1], data_set1[labels1 == label, 2],
                    c=colors[label], label=f'Class {label}')
    # 设置子图标题和坐标轴标签
    ax1.set_title(title1)
    ax1.set_xlabel('Normalized FlyerMiles')
    ax1.set_ylabel('Normalized GamesTime')
    ax1.set_zlabel('Normalized IceCream')
    ax1.legend()

    # 创建第二个子图(位于右侧)
    ax2 = fig.add_subplot(122, projection='3d')  # 1行2列的第2个位置
    # 遍历每个类别,绘制散点图
    for label in np.unique(labels2):
        ax2.scatter(data_set2[labels2 == label, 0], data_set2[labels2 == label, 1], data_set2[labels2 == label, 2],
                    c=colors[label], label=f'Class {label}')
    # 设置子图标题和坐标轴标签
    ax2.set_title(title2)
    ax2.set_xlabel('Normalized FlyerMiles')
    ax2.set_ylabel('Normalized GamesTime')
    ax2.set_zlabel('Normalized IceCream')
    ax2.legend()

    # 显示整个图形窗口
    plt.show()

# 调用函数绘制两张图表
plot_3d_side_by_side(norm_features, labels, 'Training Set Distribution', test_data, np.array(predictions),
                     'Test Set with Predictions')
7.运行效果截图
可视化结果如图:
8.完整代码
import numpy as np
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D

# 加载数据
def load_data(file_path):
    # 从指定路径加载数据集
    data = np.loadtxt(file_path, delimiter='\t', dtype=str)
    # 提取特征数据(前三列),并将其转换为浮点数
    features = data[:, :3].astype(float)
    # 定义标签映射,将文本标签转换为整数
    label_map = {'didntLike': 0, 'smallDoses': 1, 'largeDoses': 2}
    # 提取标签数据(最后一列),并根据映射将其转换为整数
    labels = np.array([label_map[label] for label in data[:, -1]])
    return features, labels

# 加载数据文件
file_path = 'datingTestSet.txt'
features, labels = load_data(file_path)

# 归一化数据
def normalize_data(data):
    # 计算每列数据的最小值
    min_vals = data.min(axis=0)
    # 计算每列数据的最大值
    max_vals = data.max(axis=0)
    # 计算每列数据的范围(最大值 - 最小值)
    ranges = max_vals - min_vals
    # 使用公式 (data - min_vals) / ranges 将数据归一化到 [0, 1] 范围
    norm_data = (data - min_vals) / ranges
    return norm_data, ranges, min_vals

# 对特征数据进行归一化处理
norm_features, ranges, min_vals = normalize_data(features)

# K近邻分类函数
def classify_knn(in_x, data_set, labels, k):
    # 获取数据集的样本数量
    data_set_size = data_set.shape[0]
    # 计算输入样本与数据集中每个样本的差值矩阵
    diff_mat = np.tile(in_x, (data_set_size, 1)) - data_set
    # 计算差值矩阵的平方
    sq_diff_mat = diff_mat ** 2
    # 计算每个样本的欧氏距离的平方
    sq_distances = sq_diff_mat.sum(axis=1)
    # 计算欧氏距离
    distances = sq_distances ** 0.5
    # 对距离进行排序,获取排序后的索引
    sorted_dist_indices = distances.argsort()
    # 创建字典用于统计前 k 个最近邻的类别
    class_count = {}
    for i in range(k):
        # 获取第 i 个最近邻的类别
        vote_label = labels[sorted_dist_indices[i]]
        # 统计类别出现的次数
        class_count[vote_label] = class_count.get(vote_label, 0) + 1
    # 按类别出现的次数降序排序
    sorted_class_count = sorted(class_count.items(), key=lambda x: x[1], reverse=True)
    # 返回出现次数最多的类别
    return sorted_class_count[0][0]

# 划分数据集
def split_data_set(data_set, labels, test_ratio=0.1):
    # 获取数据集的样本数量
    data_set_size = data_set.shape[0]
    # 计算测试集的大小
    test_size = int(data_set_size * test_ratio)
    # 获取所有样本的索引
    indices = list(range(data_set_size))
    # 随机打乱索引
    np.random.shuffle(indices)
    # 获取测试集的索引
    test_indices = indices[:test_size]
    # 获取训练集的索引
    train_indices = indices[test_size:]
    # 根据索引划分训练集和测试集
    train_data = data_set[train_indices, :]
    train_labels = labels[train_indices]
    test_data = data_set[test_indices, :]
    test_labels = labels[test_indices]
    return train_data, train_labels, test_data, test_labels

# 划分训练集和测试集
train_data, train_labels, test_data, test_labels = split_data_set(norm_features, labels, test_ratio=0.1)

# 测试K近邻算法
def test_knn(train_data, train_labels, test_data, test_labels, k):
    # 初始化错误计数
    error_count = 0
    # 获取测试集的样本数量
    total_count = test_data.shape[0]
    # 用于存储预测结果
    predictions = []
    # 遍历测试集中的每个样本
    for i in range(total_count):
        # 使用 KNN 算法进行预测
        predict_label = classify_knn(test_data[i], train_data, train_labels, k)
        # 将预测结果存储到列表中
        predictions.append(predict_label)
        # 打印每个测试样本的真实标签和预测标签
        print(f"Test Sample {i + 1}: True Label = {test_labels[i]}, Predicted Label = {predict_label}")
        # 如果预测错误,增加错误计数
        if predict_label != test_labels[i]:
            error_count += 1
    # 计算错误率
    error_rate = error_count / total_count
    print(f"Error Rate: {error_rate:.2f}")
    return predictions

# 测试 KNN 算法,使用 k=3
predictions = test_knn(train_data, train_labels, test_data, test_labels, k=3)

# 绘制3D散点图
def plot_3d_side_by_side(data_set1, labels1, title1, data_set2, labels2, title2):
    # 创建图形窗口,设置大小为14x7
    fig = plt.figure(figsize=(14, 7))

    # 创建第一个子图(位于左侧)
    ax1 = fig.add_subplot(121, projection='3d')  # 1行2列的第1个位置
    # 定义颜色列表,用于区分不同类别
    colors = ['red', 'green', 'blue']
    # 遍历每个类别,绘制散点图
    for label in np.unique(labels1):
        ax1.scatter(data_set1[labels1 == label, 0], data_set1[labels1 == label, 1], data_set1[labels1 == label, 2],
                    c=colors[label], label=f'Class {label}')
    # 设置子图标题和坐标轴标签
    ax1.set_title(title1)
    ax1.set_xlabel('Normalized FlyerMiles')
    ax1.set_ylabel('Normalized GamesTime')
    ax1.set_zlabel('Normalized IceCream')
    ax1.legend()

    # 创建第二个子图(位于右侧)
    ax2 = fig.add_subplot(122, projection='3d')  # 1行2列的第2个位置
    # 遍历每个类别,绘制散点图
    for label in np.unique(labels2):
        ax2.scatter(data_set2[labels2 == label, 0], data_set2[labels2 == label, 1], data_set2[labels2 == label, 2],
                    c=colors[label], label=f'Class {label}')
    # 设置子图标题和坐标轴标签
    ax2.set_title(title2)
    ax2.set_xlabel('Normalized FlyerMiles')
    ax2.set_ylabel('Normalized GamesTime')
    ax2.set_zlabel('Normalized IceCream')
    ax2.legend()

    # 显示整个图形窗口
    plt.show()

# 调用函数绘制两张图表
plot_3d_side_by_side(norm_features, labels, 'Training Set Distribution', test_data, np.array(predictions),
                     'Test Set with Predictions')
五、总结
本文详细介绍 KNN 算法的完整实现过程,包括数据加载、归一化处理、算法实现、数据集划分、性能测试以及可视化展示。KNN算法虽然简单,但在许多实际问题中表现出色,尤其适用于数据分布较为明显的情况。通过本文的代码实现和实验,希望能帮助读者可以更好地理解KNN算法的工作原理及其在实际问题中的应用。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献1条内容

所有评论(0)