利用python提取图片型pdf中的文字(提取pdf扫描件文字)实战案例
在实际开发项目中,很多pdf是先经过某些领导签字确认后,通过打印机扫描件生成pdf文档,那这些图片型的pdf文档,我们想要提取某些内容该怎么办呢?那这就需要用到OCR(光学字符识别)功能。
演示版本:
系统环境:win 10 Python版本: python 3.10
准备工具:
Tesseract OCR程序(含中文包)和pytesseract库、PyMuPDF库、其他包库
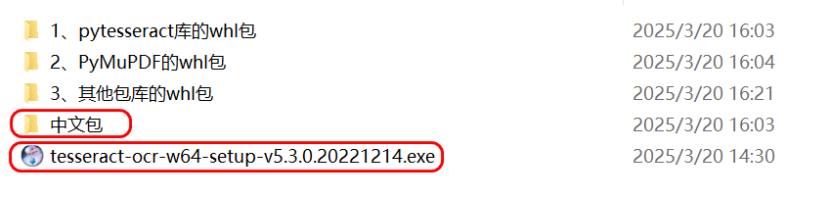
其中Tesseract OCR程序和对应的中文包在git上下载很慢,我这里已经打包收集整理好了
Tesseract下载及环境变量配置:
1、下载地址:https://pan.quark.cn/s/0a8d8a8c5d8f,如果自己是在内网环境开发,那就都下载下来
2、如果要识别中文,就得安装3.0以上的版本,这里tesseract 我安装的是5.3版本
3、下载完成之后,双击打开,安装路径自己按实际情况选好安装位置,其他的直接点击next即可,记住自己安装的位置,后面配置环境变量需要。我安装的位置是:D:\Program Files\Tesseract-OCR
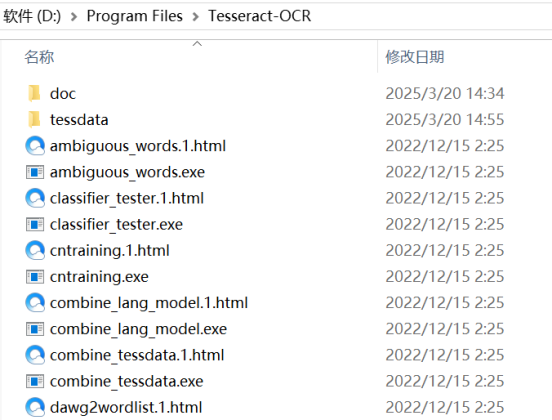
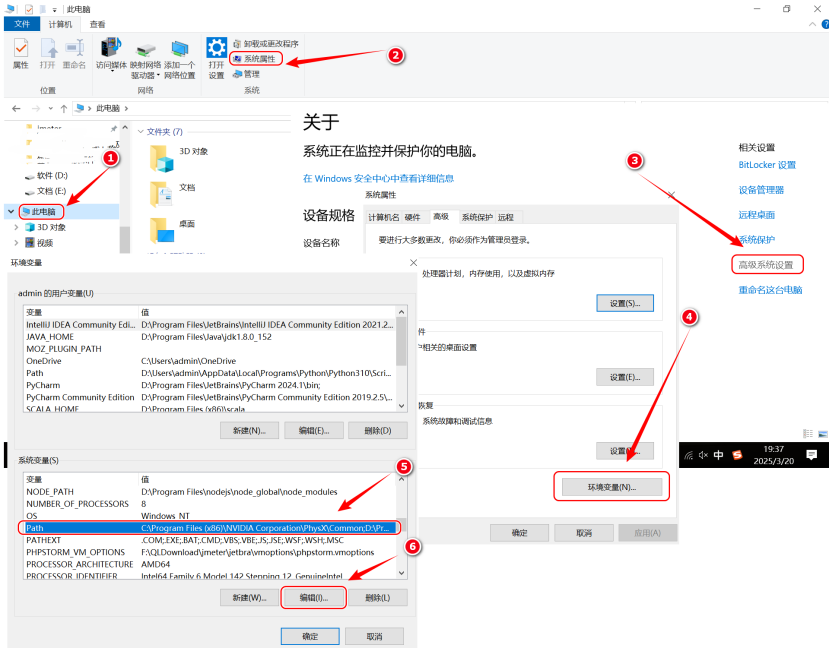
4、安装完成后进行环境变量配置,找到系统变量的path,点击编辑,如图:
5、新建一个环境变量,变量的值是tesseract的安装位置,如图:
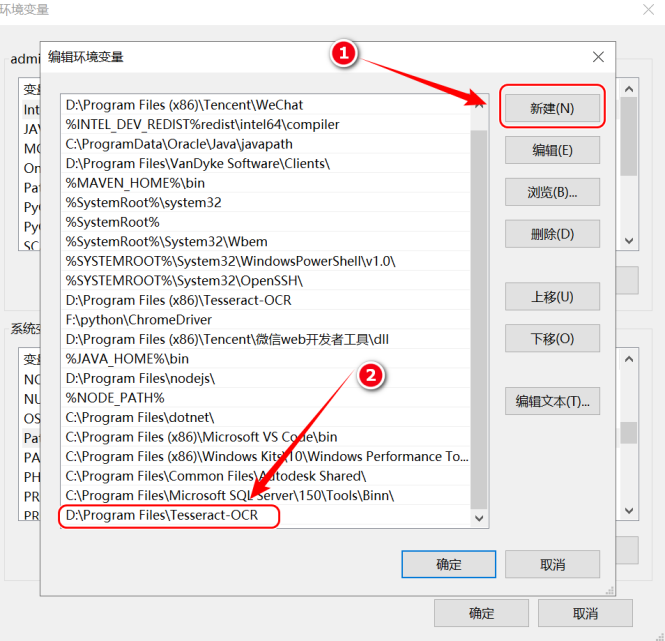
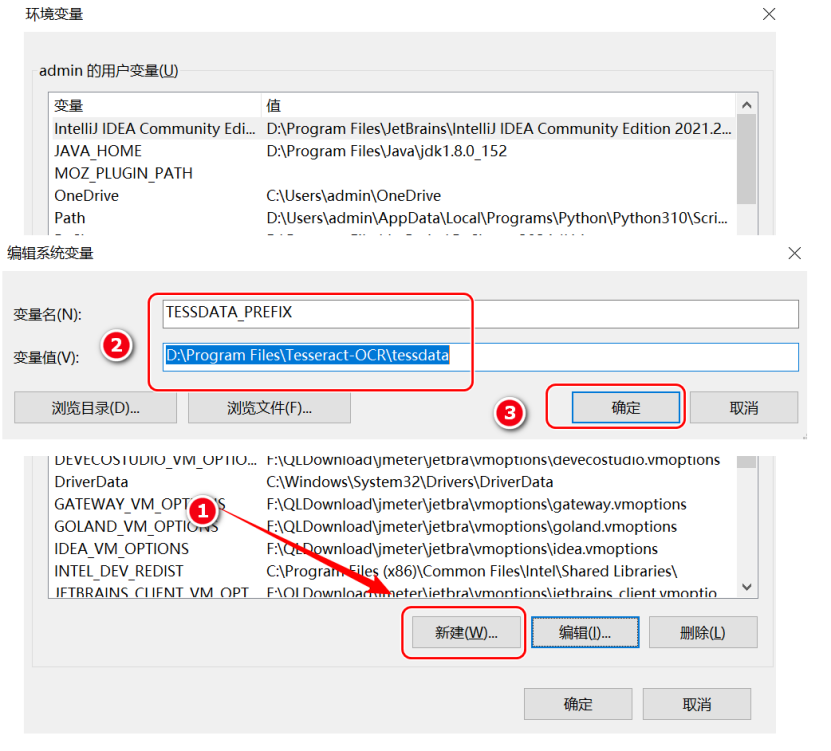
6、点击确定之后,在系统变量界面,新建一个系统变量,变量名为TESSDATA_PREFIX,变量值为安装目录下的tessdata目录位置,之后就一直点击确定即可,如下图
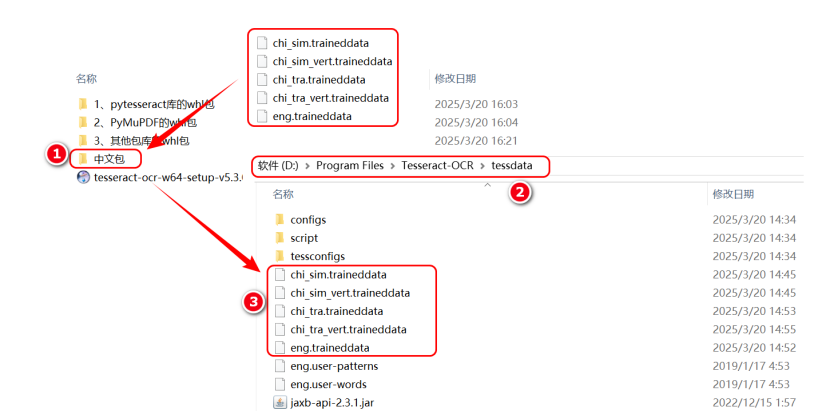
7、安装中文包,直接将下载的好的5个包复制扔到tessdata即可
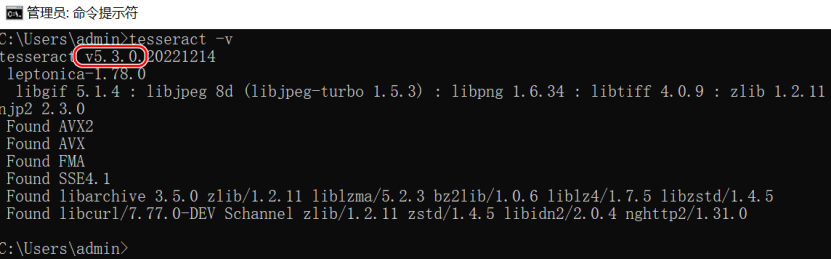
8、验证tesseract 安装是否完成,在命令行输入tesseract -v,显示tesseract的版本号,就表示安装完成了,如图:
9、安装pytesseract库
1)互联网cmd命令行输入: pip install pytesseract
内网用我下载好的pytesseract-0.3.13-py3-none-any.whl包,如下图:
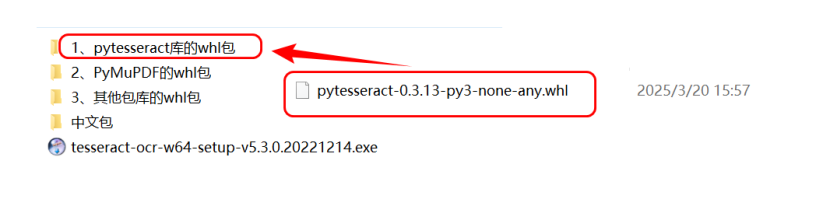
2)内网cmd命令行输入:pip install D:\python学习\1、pytesseract库的whl包\pytesseract-0.3.13-py3-none-any.whl
10、安装其他库
1)互联网cmd命令行输入: pip install PyMuPDF PIL
同理,要是内网,就用我下载好的如下图里的包,包里分64和32位的,可根据实际情况安装
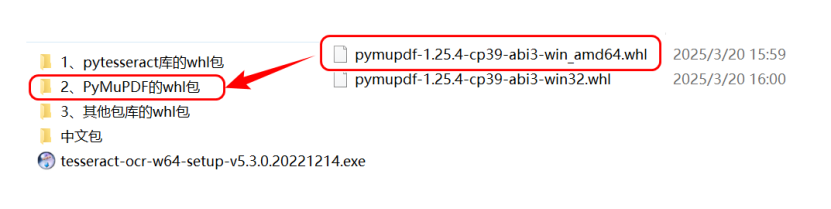
2)内网cmd命令行输入:pip install D:\python学习\1、pytesseract库的whl包\pymupdf-1.25.4-cp39-abi3-win_amd64.whl
11、若是后面程序报frontend找不到,可下载frontend包
1)互联网cmd命令行输入: pip install frontend
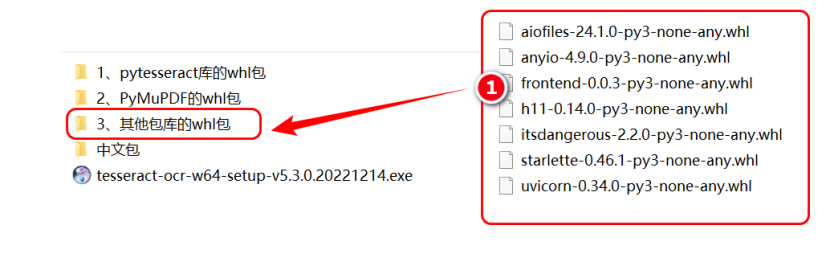
2)内网就把其他包里的whl,依次安装上,注意下图里的都要安装,都是frontend包的依赖包,安装跟上面同理
12、正式提取图片型pdf的文字,完整代码如下
# -*- coding: UTF-8 -*-
import fitz
import pytesseract
from PIL import Image
import io


def readPDFInfoOCR(cmdExe,filePath):
    # 1、配置tesseract路径
    pytesseract.pytesseract.tesseract_cmd = cmdExe

    # 2、打开pdf文件
    pdf_file = fitz.open(filePath)

    # 3、遍历pdf的每一页
    for page_num in range(len(pdf_file)):
        # (1)获取页面
        page = pdf_file[page_num]

        # (2)提取页面上的图像
        image_list = page.get_images(full=True)
        print("-------------------------解析开始-------------------------")
        for image_index, img in enumerate(image_list):
            # (3)提取图像
            xref = img[0]
            base_image = pdf_file.extract_image(xref)
            image_bytes = base_image["image"]

            # (4)将字节转换为PIL图像
            image = Image.open(io.BytesIO(image_bytes))

            # (5)使用pytesseract对图像进行ocr
            text = pytesseract.image_to_string(image, lang='chi_sim')

            # (6)输出打印结果
            print(f"Page {page_num + 1}, Image {image_index + 1}:")

            print(text)
        print("-------------------------解析完成-------------------------")
    # 关闭pdf文件
    pdf_file.close()


if __name__ == '__main__':

    cmdExe = r'D:\Program Files\Tesseract-OCR\tesseract.exe'
    filePath = r'D:\01.pdf'
    readPDFInfoOCR(cmdExe,filePath)
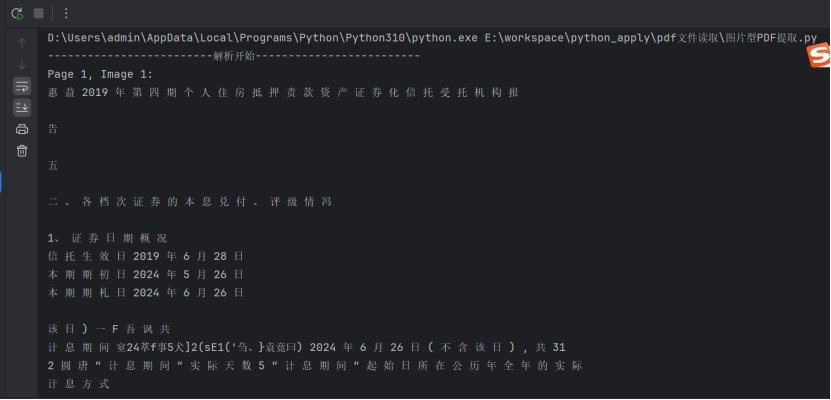
13、运行结果如下

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)