爬虫科普:小白也能玩爬虫(一)
本篇将基于小白的视角去探索爬虫
第一步:网络爬虫是什么呢?
网络爬虫(Web Crawler)是一种自动化程序,用于从互联网上批量采集、解析和存储数据。
简单来说:网络爬虫 = 自动化复制粘贴工具
- 你手动操作:打开网页 → 选中文字 → 复制 → 粘贴到Excel → 记下新链接
- 爬虫自动做:代码模拟你的操作,但速度快100倍,且24小时不休息
工作原理
graph LR
A(起始URL) --> B[发送HTTP请求]
B --> C{是否成功?}
C -- 是 --> D[解析HTML/JSON数据]
C -- 否 --> E[记录错误]
D --> F[提取目标数据]
F --> G[存储到文件/数据库]
G --> H[发现新链接]
H --> B
网络爬虫如何工作?(春天也快到了,用一个蜜蜂采蜜的例子解释一下)
- 出发:告诉小蜜蜂第一个花朵地址(比如
https://news.com) - 采蜜:
- 蜜蜂用“触角”发送请求(代码发送
requests.get()) - 花朵返回花蜜(服务器返回网页的HTML)
- 蜜蜂用“触角”发送请求(代码发送
- 识别花蜜:蜜蜂用复眼扫描花瓣结构(代码用
BeautifulSoup解析HTML标签) - 存储:把花蜜分类存到蜂巢的格子(数据保存到Excel/数据库)
- 找新花朵:发现这朵花指向的其他花朵链接(提取页面中的新URL),重复过程
技术栈
(Python为例,对可爱的小白来说先学会
requests+BeautifulSoup就行)
| 工具类型 | 常用库/框架 | 用途 |
|---|---|---|
| 请求库 | requests aiohttp | 发送HTTP请求获取网页 |
| 解析库 | BeautifulSoup lxml pyquery | 从HTML/XML提取数据 |
| 动态渲染库 | Selenium Playwright | 处理JavaScript渲染的页面 |
| 爬虫框架 | Scrapy Feapder | 大型项目的工程化管理 |
| 反反爬工具 | fake-useragent proxy | 绕过IP封锁和验证码 |
第二步:爬虫爬什么?它爬取的对象是什么?(代码的视角)
感性认知:用生活场景比喻技术对象
1. HTML:网页的“骨架和说明书”
- 比喻:
如果把网页比作一间房子,HTML就是房子的骨架和装修说明书。- 骨架:用钢筋水泥(
<div>、<h1>标签)标出哪里是客厅(标题)、哪里是厨房(导航栏)。 - 说明书:告诉工人瓷砖颜色(
style="color:red")和家具摆放位置(<img src="沙发.jpg">)。
- 骨架:用钢筋水泥(
- 技术真相:
HTML是纯文本代码,包含文字、链接、标签结构,但不含图片或样式(这些是额外加载的)。
2. 图片/视频:挂在墙上的“装饰画”
- 比喻:
房子装修好后,要在墙上挂装饰画(图片)和电视(视频)。这些画并不在说明书(HTML)里,而是通过画店的地址(图片URL)单独采购。 - 技术真相:
图片和视频以独立文件(如.jpg、.mp4)存在,HTML中仅用链接(<img src="图片地址">)标记位置,爬虫需按地址二次下载。
3. API数据:藏在自动售货机里的“饮料”
- 比喻:
有些数据像自动售货机的饮料,表面看不到(网页不直接显示),但按特定暗号(API请求)就能吐出罐装数据(JSON/XML格式)。 - 技术真相:
网站通过后端接口(如/api/get_data)返回结构化数据,爬虫可绕过HTML直接调用API获取(需破解暗号规则)。
理性认知:拆解技术流程(动手步骤)
场景:假设小白想爬取豆瓣电影页面的标题、海报和评分。
-
抓取HTML(获取说明书)
- 爬虫发送HTTP请求(像快递员敲门说:“我要豆瓣电影页面的说明书!”)。
- 服务器返回HTML(一叠纯文本装修指南)。
- 关键代码(Python示例):
import requests
html = requests.get("https://movie.douban.com").text
-
解析HTML(按说明书找家具)
- 用工具(如BeautifulSoup)按标签定位数据:
- 标题:找
<h1 class="title">标签里的文本。 - 海报链接:找
<img class="poster">标签的src属性值。
- 标题:找
- 关键代码:
from bs4 import BeautifulSoup
soup = BeautifulSoup(html, "lxml")
title = soup.find("h1", class_="title").text
poster_url = soup.find("img", class_="poster")["src"]
- 用工具(如BeautifulSoup)按标签定位数据:
-
下载图片(按地址采购装饰画)
- 根据
poster_url再次发送请求,下载图片文件:image_data = requests.get(poster_url).content with open("poster.jpg", "wb") as f: f.write(image_data)
- 根据
-
调用API(破解自动售货机暗号)
- 观察网页加载时的网络请求(浏览器按F12→Network),找到返回评分的API地址(如
/api/rating?movie_id=123)。 - 模拟请求参数,直接获取JSON数据:
rating_data = requests.get("https://xxx/api/rating?movie_id=123").json()
print(rating_data["score"])  # 输出9.5
- 观察网页加载时的网络请求(浏览器按F12→Network),找到返回评分的API地址(如
提问:暴露漏洞(小白的灵魂拷问)
- “为什么有些图片用爬虫下载后是坏的?”
→ 可能图片地址是假的(动态生成),或需要登录权限(如微信文章配图)。 - “HTML里明明有文字,为什么爬虫抓不到?”
→ 文字可能是JavaScript动态渲染的(如评论区),原始HTML里只有空壳<div id="comments"></div>。 - “API请求的暗号怎么破解?”
→ 可能需要添加请求头(如User-Agent伪装浏览器)、处理加密参数(如token)或验证码。
实践:让小白动手验证
测试题(检验是否真懂):
- 如果想爬取微博热搜榜的标题和热度值,应该先抓取什么?
→ 答案:先抓HTML,如果HTML里没有数据,再找API接口。 - 下载图片时,发现
<img src="data:image/png;base64,...">,这是什么意思?
→ 答案:图片被编码成Base64字符串直接嵌入HTML,无需单独下载,但需解码保存。 - 为什么直接复制浏览器看到的文字,用爬虫却抓不到?
→ 答案:浏览器渲染了JavaScript,而爬虫默认只读取原始HTML(需用Selenium模拟浏览器)。
归纳(技术钉子)
爬虫的技术本质是:
- 对HTML → 按标签规则提取文本和链接(像用X光看骨架)。
- 对图片/文件 → 按链接地址二次下载(像拿着购物清单去超市)。
- 对API数据 → 伪装成合法用户,直接“截胡”结构化数据(像破解自动售货机的按钮组合)。
记住三个关键词:解析规则、二次下载、伪装请求。
第三步:我是小白可以直接上手写爬虫吗?
当然可以,技术并不复杂,至少目前来说是这样的。
1.先来尝试爬HTML
找一个网站:http://books.toscrape.com
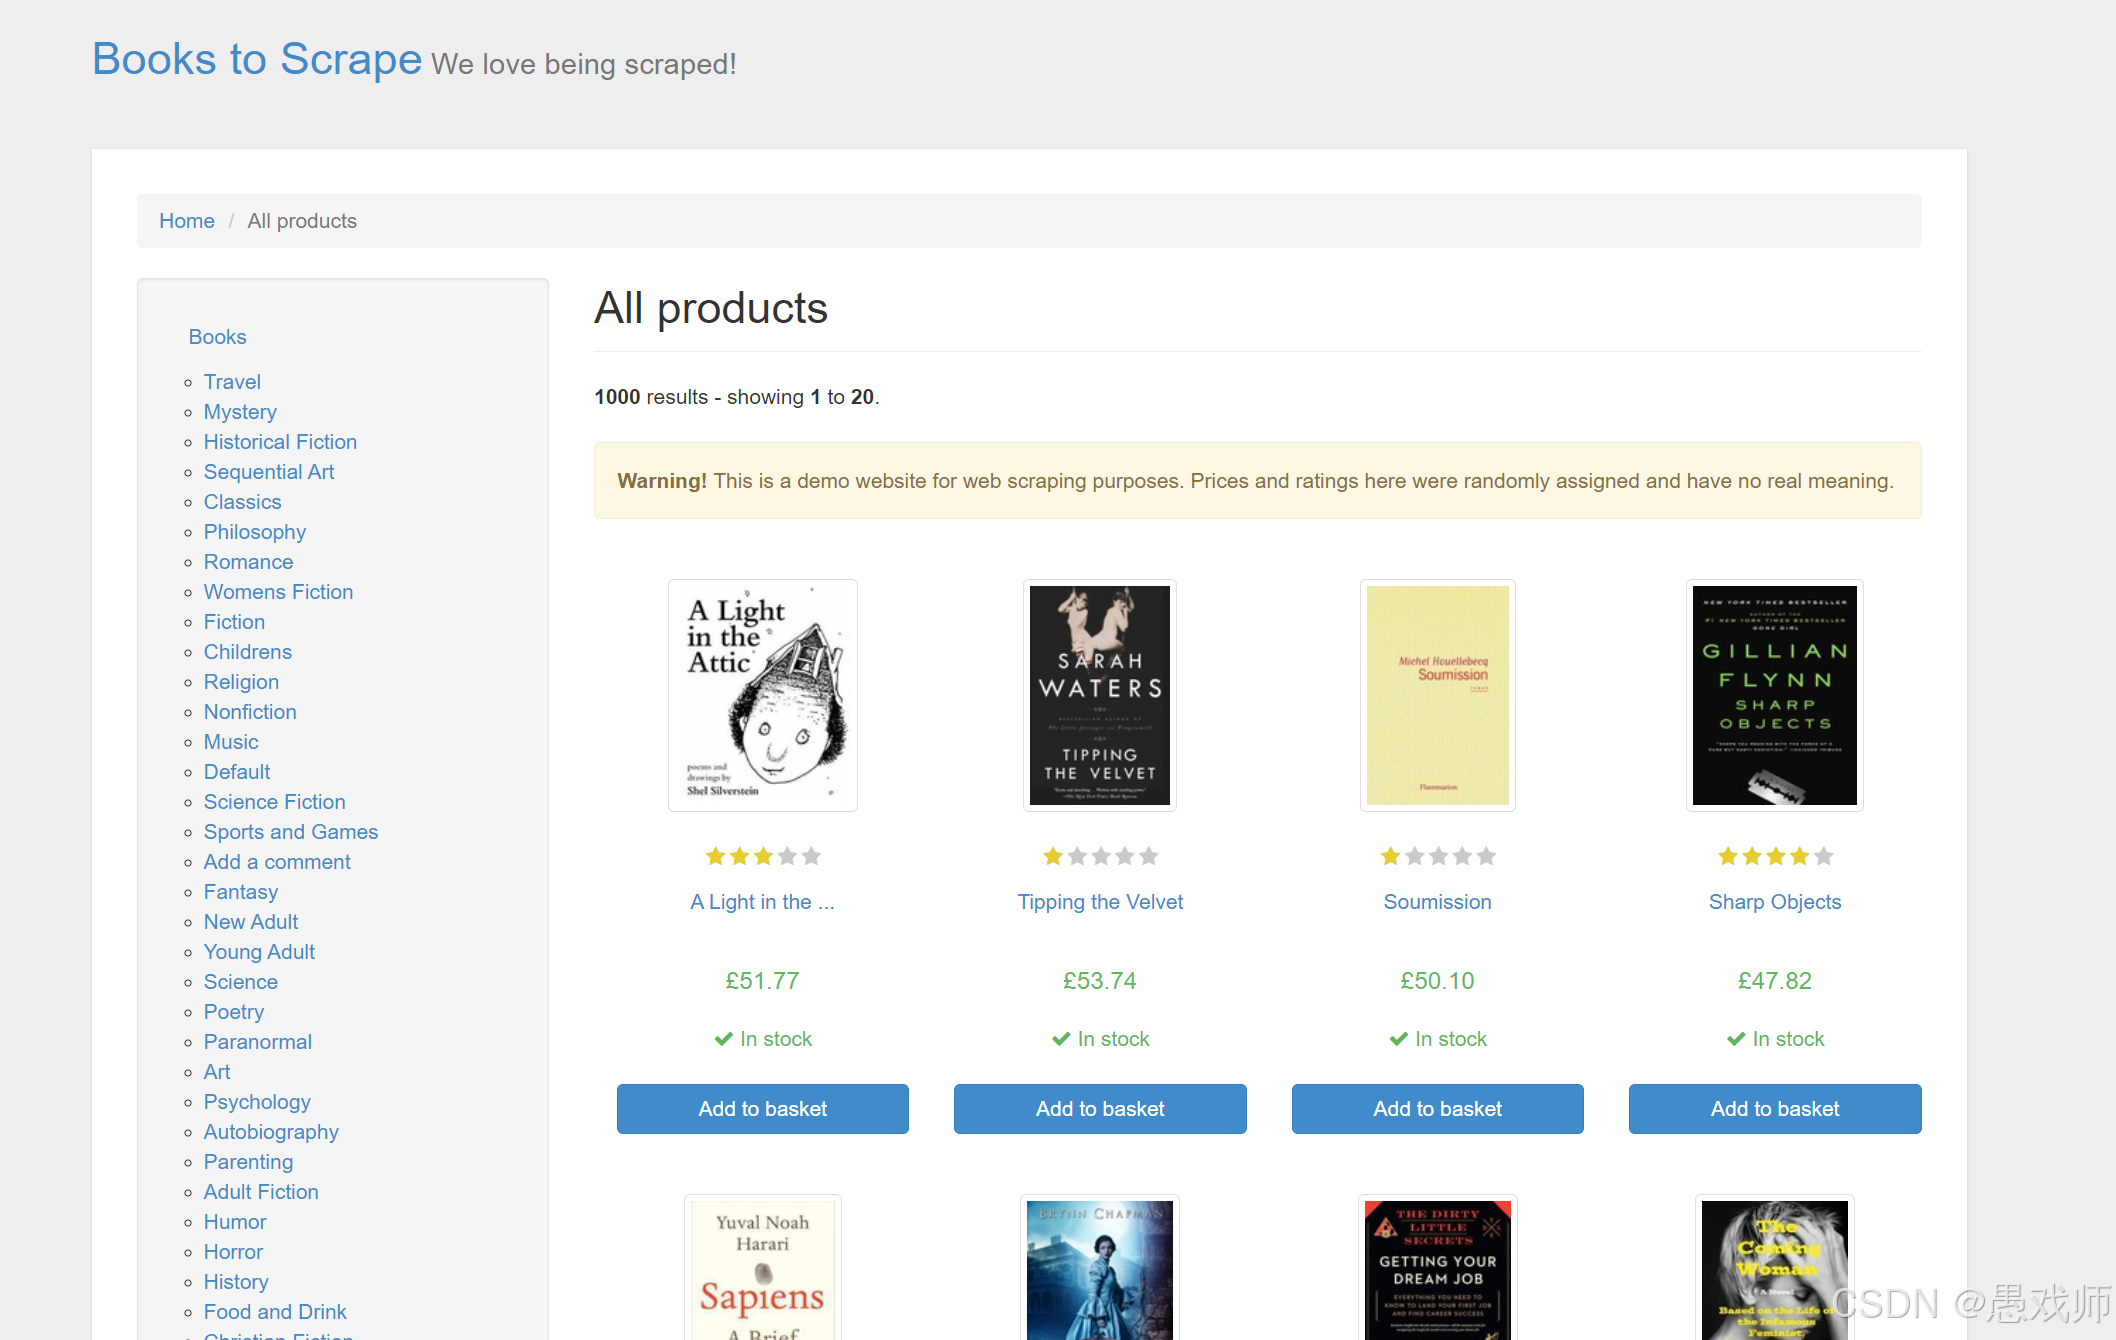
首先爬取这个页面并输出前1000字符(可以理解为请求并获得了一个很长的字符串)
需提前安装requests库:
pip install requests
import requests as rq

# 1. 发送请求获取网页内容
url='http://books.toscrape.com'
response=rq.get(url)
response.encoding = "utf-8"  # 防止中文乱码
# 检查请求是否成功(状态码200表示成功)
if response.status_code == 200:
    print("网页请求成功!")
else:
    print("请求失败,错误代码:", response.status_code)
#html文本
html=response.text
print(html[:1000])# 打印前1000个字符
结果
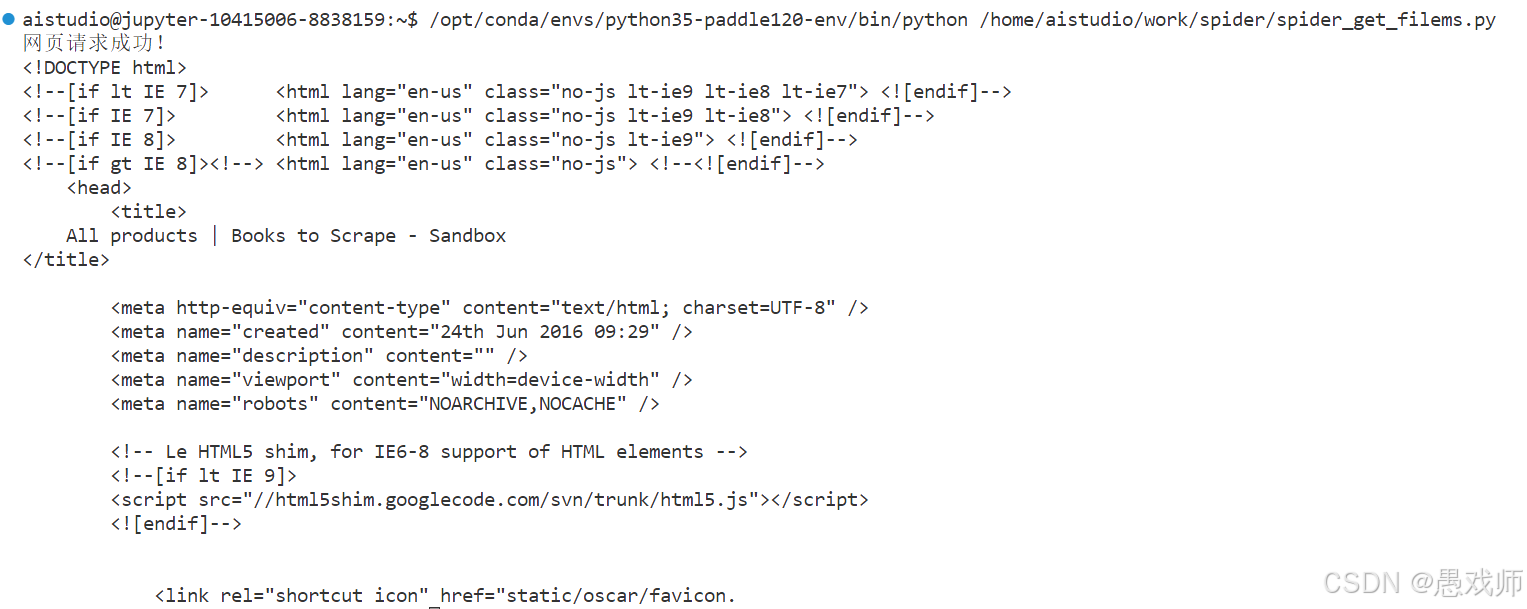
解析这个HTML文本(目前可以这样理解:从这个字符串中根据标签提取我们的目标信息,可能是网页标题,书籍名等需要的信息)
需提前安装 beautifulsoup4 和 lxml 库:
pip install beautifulsoup4 lxml
import requests as rq
from bs4 import BeautifulSoup as bs
# 1. 发送请求获取网页内容
url='http://books.toscrape.com'
response=rq.get(url)
response.encoding = "utf-8"  # 防止中文乱码
# 检查请求是否成功(状态码200表示成功)
if response.status_code == 200:
    print("网页请求成功!")
else:
    print("请求失败,错误代码:", response.status_code)
#html文本
html=response.text
# print(html[:1000])# 打印前1000个字符

# 2. 解析HTML内容,提取所需信息
'''
创建了一个 BeautifulSoup 对象,并生成一个包含标签、属性和文本的树形结构。
通过此对象,可以方便地使用 find()、select() 等方法提取数据
'''
#核心作用是通过 lxml 解析器将 HTML 字符串转换为可操作的树形结构对象
#说白了就像给字典编了个索引
soup=bs(html,'lxml')
#比如我要页面title标题
title=soup.title.string
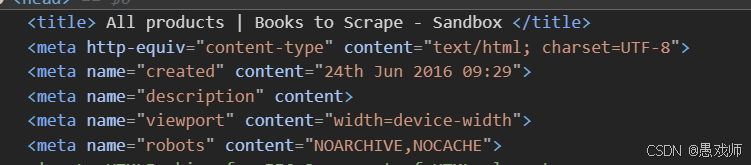
print(title)#  结果:All products | Books to Scrape - Sandbox
和网页对比,确实我获取到了title标签的内容:
还有一些常用到的操作
(1)提取标签内容
# 获取第一个 <title> 标签的文本
title = soup.title.string

# 获取所有 <a> 标签的 href 属性
links = [a['href'] for a in soup.find_all('a')]
(2)使用 CSS 选择器
# 提取 class 为 "story" 的段落
paragraphs = soup.select('p.story')

# 提取嵌套在 <div> 下的直接子元素 <a>
nested_links = soup.select('div > a')
(3)处理属性和文本
# 获取标签属性
first_link = soup.a
print(first_link.get('href'))  # 输出 href 属性值

# 获取标签内所有文本(自动拼接子标签文本)
text_content = soup.p.get_text()
做个表格总结一下:
BeautifulSoup在解析HTML中的主要应用场景及对应方法的表格总结:
| 应用场景 | 方法/属性 | 示例 | |
|---|---|---|---|
| HTML文档解析 | BeautifulSoup(html_content, '解析器') | soup = BeautifulSoup(html_doc, 'lxml') 使用lxml解析器生成文档树 | |
| 元素查找 | find()、find_all() | soup.find('h1') 查找第一个<h1>标签;soup.find_all('p') 查找所有<p>标签 | |
| 按属性筛选元素 | attrs参数或class_、id | soup.find('div', class_='content') 查找class为"content"的<div>标签 | |
| CSS选择器 | select()、select_one() | soup.select('div#main a') 选择ID为"main"的<div>下的所有<a>标签 | |
| 提取文本内容 | .text、.string、.get_text() | h1_tag.text 获取标签内文本;title_tag.string 直接获取标签字符串内容 | |
| 获取元素属性 | .get('属性名') 或字典形式访问 | link['href'] 或 link.get('href') 安全获取<a>标签的链接地址 | |
| 导航文档树 | .parent、.children、.next_sibling | link.parent 获取父节点;link.next_sibling 获取下一个兄弟节点 | |
| 修改文档内容 | 直接修改属性或文本 | soup.title.string = "新标题" 修改标题文本;first_p['class'] = 'new-class' 修改类名 | |
| 格式化输出 | .prettify() | print(soup.prettify()) 输出格式化的HTML代码 | |
| 处理动态网页(这个嘛以后会用到现在不急哈) | 结合Selenium获取源码后解析 | 使用driver.page_source获取动态渲染的HTML,再用BeautifulSoup解析 |
实践
回归正题,让我们用一些小尝试去理解爬虫。看图
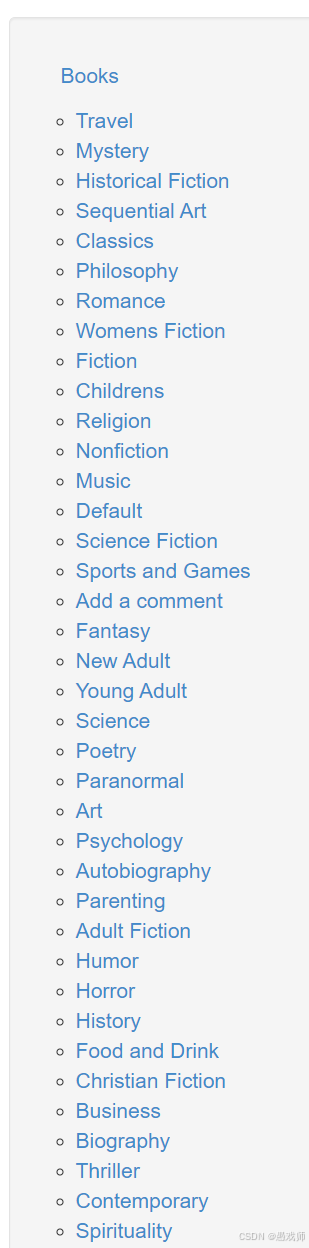
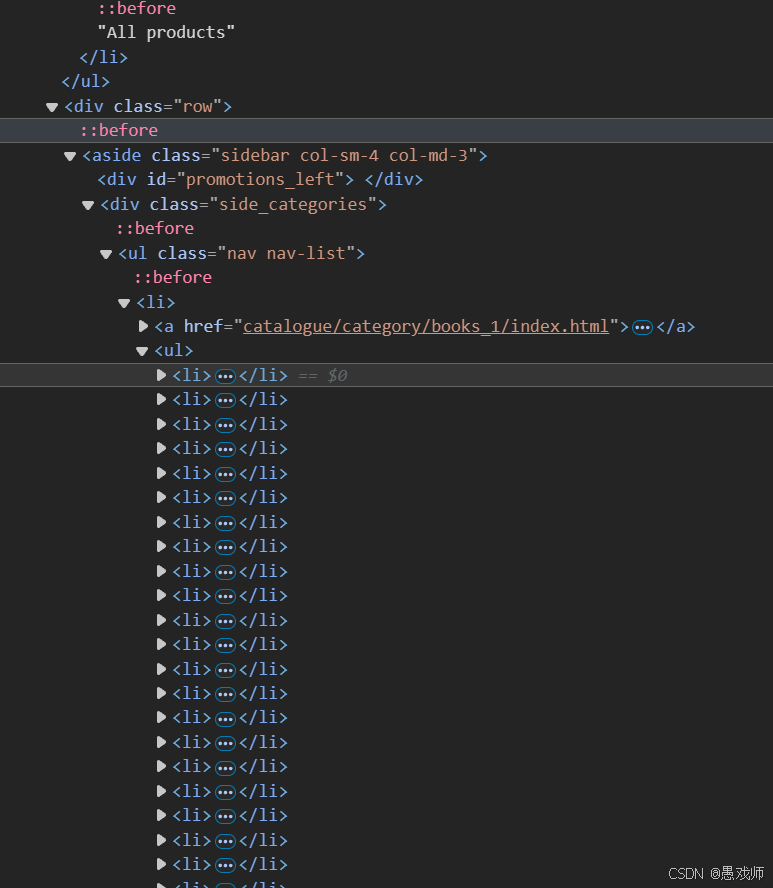
如何根据所给的HTML结构去把这些链接扒下来?
咱先看看,就像我们去取快递总要先知道快递站或者快递柜的位置,然后还要知道具体的货架号对吧,那我们爬链接也一样
先进行HTML结构解析(来自图片)
<aside class="sidebar col-sm-4 col-md-3">
    <div class="side_categories">
        <ul class="nav-list">  <!-- 导航列表容器 -->
            <li>
                <a href="catalogue/category/books_1/index.html"></a>
            </li>
            <!-- 其他<li>项省略 -->
        </ul>
    </div>
</aside>
有一种快捷的方式(如下)
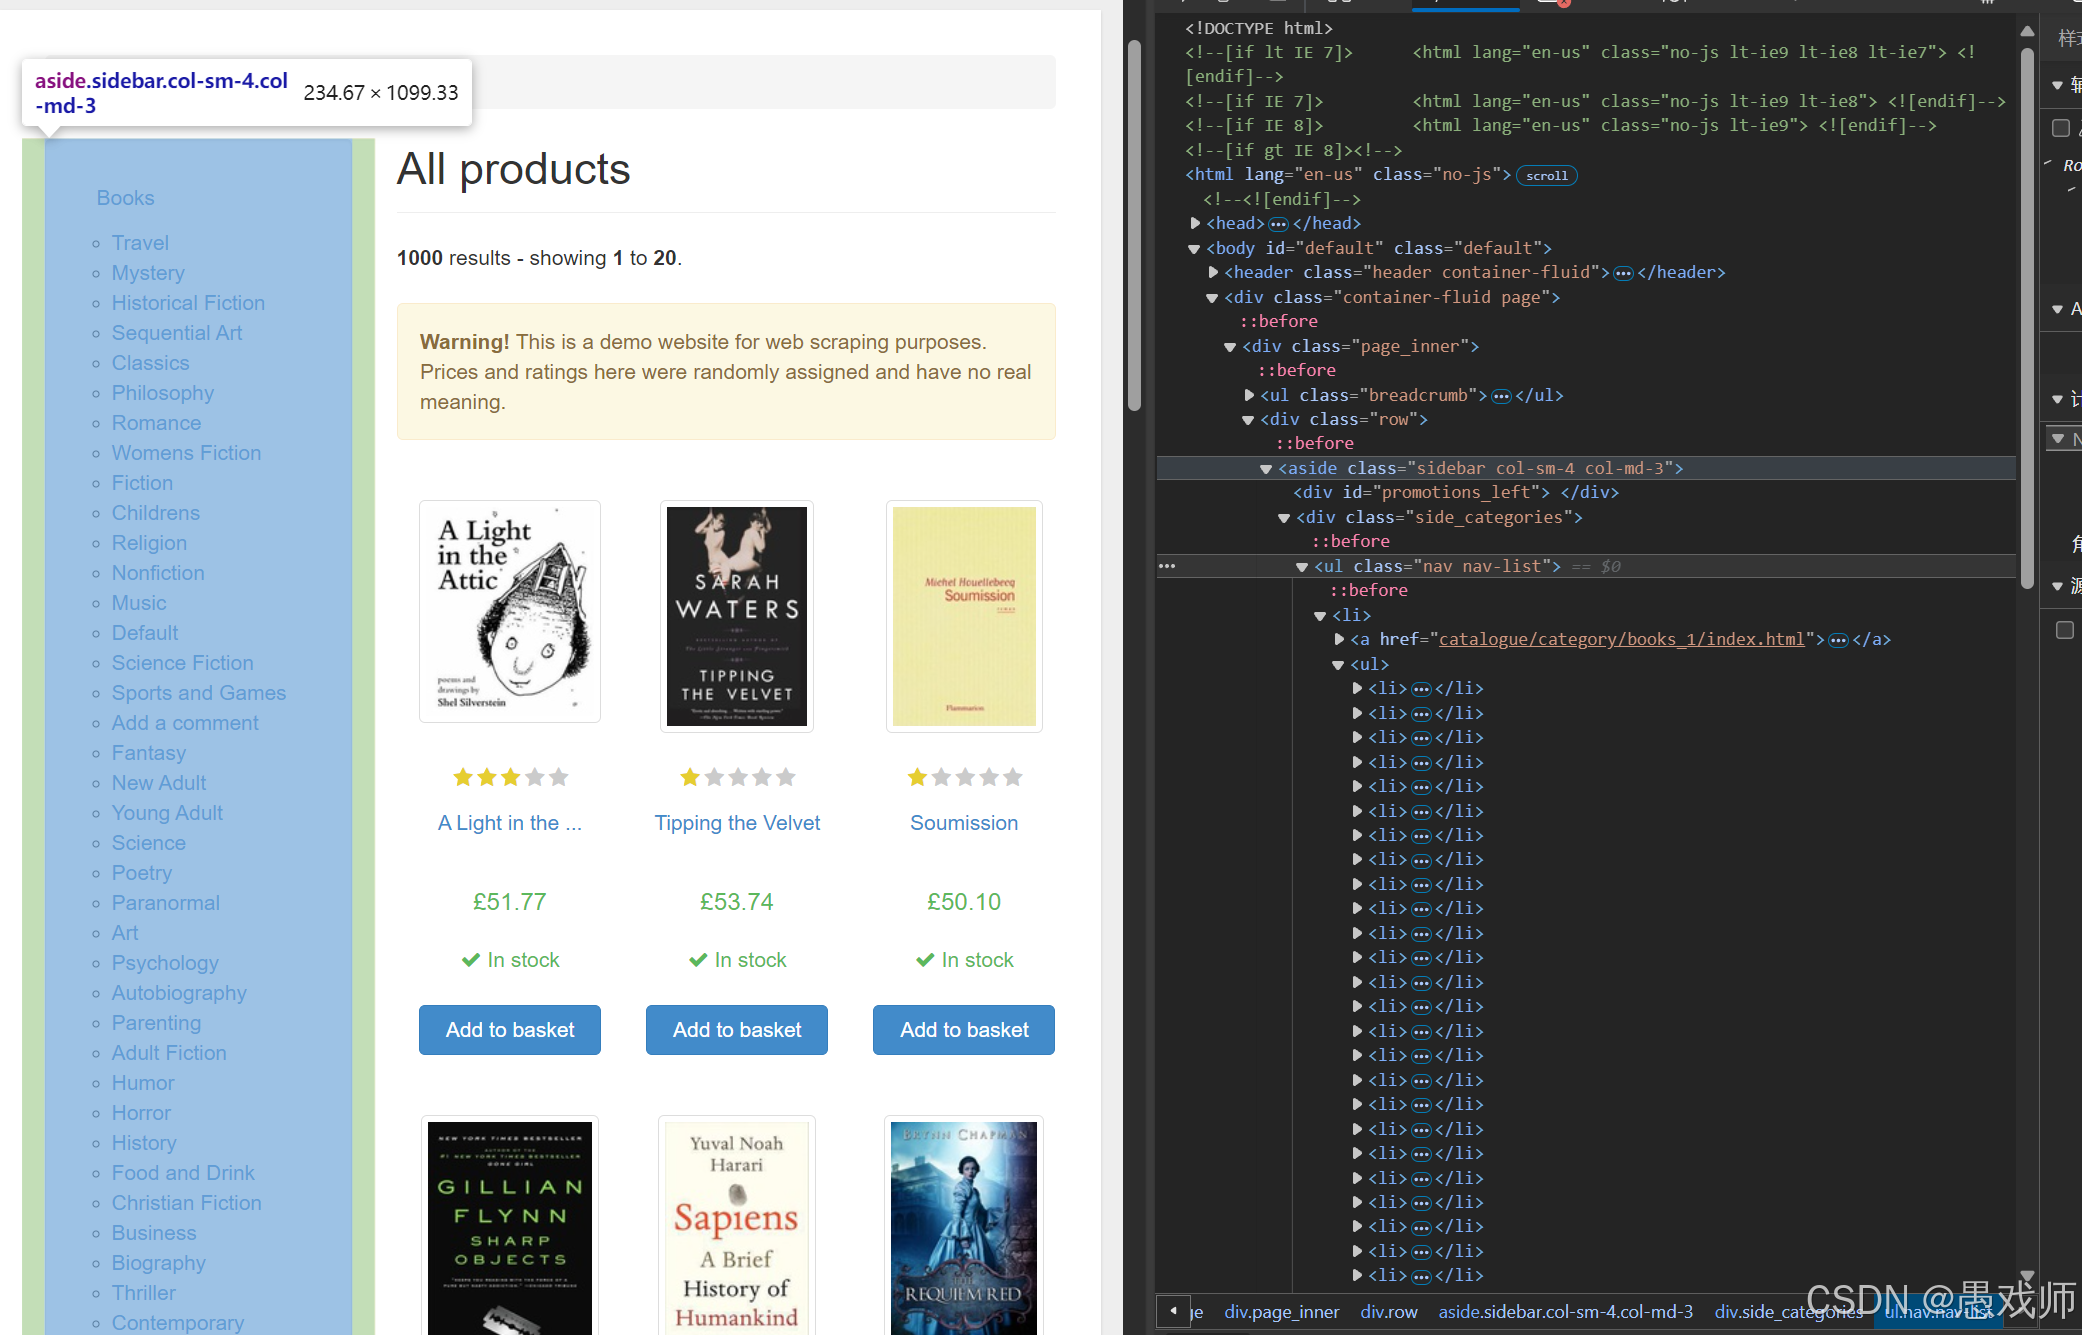
在术语里嘛这就叫定位:
nav_list = soup.select_one(".sidebar .nav-list") # 仅匹配 class="nav-list"
这就是一个定位器,告诉我去哪里们爬下来
让我专业一点,提升一下“比哥”
定位器解析
nav_list = soup.select_one(".sidebar .nav-list")的作用是:在侧边栏(.sidebar)内精准定位到导航列表容器(<ul class="nav-list">)。以下是详细拆解:
1. 选择器结构分析
选择器部分 含义 对应HTML元素(来自图片) .sidebar匹配类名为 sidebar的元素<aside class="sidebar col-sm-4 col-md-3">.nav-list匹配类名为 nav-list的元素<ul class="nav-list">中间的空格 表示层级关系( .nav-list是.sidebar的后代元素,无论嵌套多少层).sidebar→.side_categories→.nav-list
2. 为什么这个选择器有效?
- 精准定位侧边栏:
通过.sidebar锁定侧边栏容器(避免其他区域的同名类干扰)。- 直接匹配列表容器:
<ul class="nav-list">是导航链接的直接父容器,无需额外层级(如.side_categories)。
- 即使中间存在
<div class="side_categories">,空格选择器已隐含任意层级关系。
完整代码:
import requests as rq
from bs4 import BeautifulSoup as bs
# 1. 发送请求获取网页内容
response = rq.get('http://books.toscrape.com')
response.encoding = "utf-8"
html = response.text

# 2. 解析HTML内容,提取所需信息
soup = bs(html, 'lxml')

#3. 定位侧边栏列表容器
sidebar_list = soup.select_one(".sidebar .nav-list")  # 仅匹配 class="nav-list"
# print(sidebar_list)

# 4. 提取所有超链接
links = []
if sidebar_list:  # 避免因元素不存在导致报错
    for a_tag in sidebar_list.find_all("a"):
        href = a_tag.get("href")
        if href:
            links.append(href)
else:
    print("未找到侧边栏列表容器")

# 5. 输出结果
print("爬取到的链接列表:")
for link in links:
    print(link)
来我们瞅一眼,就是这样的结果:

今天先到这,明早就要去开会过几天再继续去优化这个东西。你今天开心吗?

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献5条内容

所有评论(0)