基于协同过滤的动漫推荐系统 计算机毕设选题推荐 python毕设 大数据毕设 适合作为毕业设计 课程设计 实习项目 附源码+安装部署+视频讲解+文档指导
✍✍计算机编程指导师
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
⚡⚡
Java实战 | SpringBoot/SSM
Python实战项目 | Django
微信小程序/安卓实战项目
大数据实战项目
⚡⚡文末获取源码
动漫推荐系统-研究背景
随着动漫文化的蓬勃发展,动漫作品种类繁多,观众在选择时往往面临信息过载的困境。传统的推荐方式依赖于人工编辑或简单的分类推荐,难以满足个性化需求。因此,开发一种智能化的动漫推荐系统,成为提升用户体验、促进动漫产业发展的关键。
现有解决方案多基于内容过滤或热门排行,存在推荐精度不高、个性化不足等问题。内容过滤往往局限于作品本身的特征,而忽略用户间的互动关系;热门排行则易受流行度影响,忽视小众但优质的作品。这些问题的存在,进一步凸显了基于协同过滤的动漫推荐系统研究的必要性。
本课题旨在通过协同过滤技术,挖掘用户间的相似性,实现精准、个性化的动漫推荐。其理论意义在于丰富推荐系统的研究领域,为类似系统提供理论参考;实际意义则在于提升用户满意度,推动动漫产业的健康发展。
动漫推荐系统-技术
开发语言:Java或Python
数据库:MySQL
系统架构:B/S
后端框架:SSM/SpringBoot(Spring+SpringMVC+Mybatis)+Django
前端:Vue+ElementUI+HTML+CSS+JavaScript+jQuery+Echarts
动漫推荐系统-视频展示
基于协同过滤的动漫推荐系统 计算机毕设选题推荐 python毕设 大数据毕设 适合作为毕业设计 课程设计 实习项目 附源码+安装部署+视频讲解+文档指导
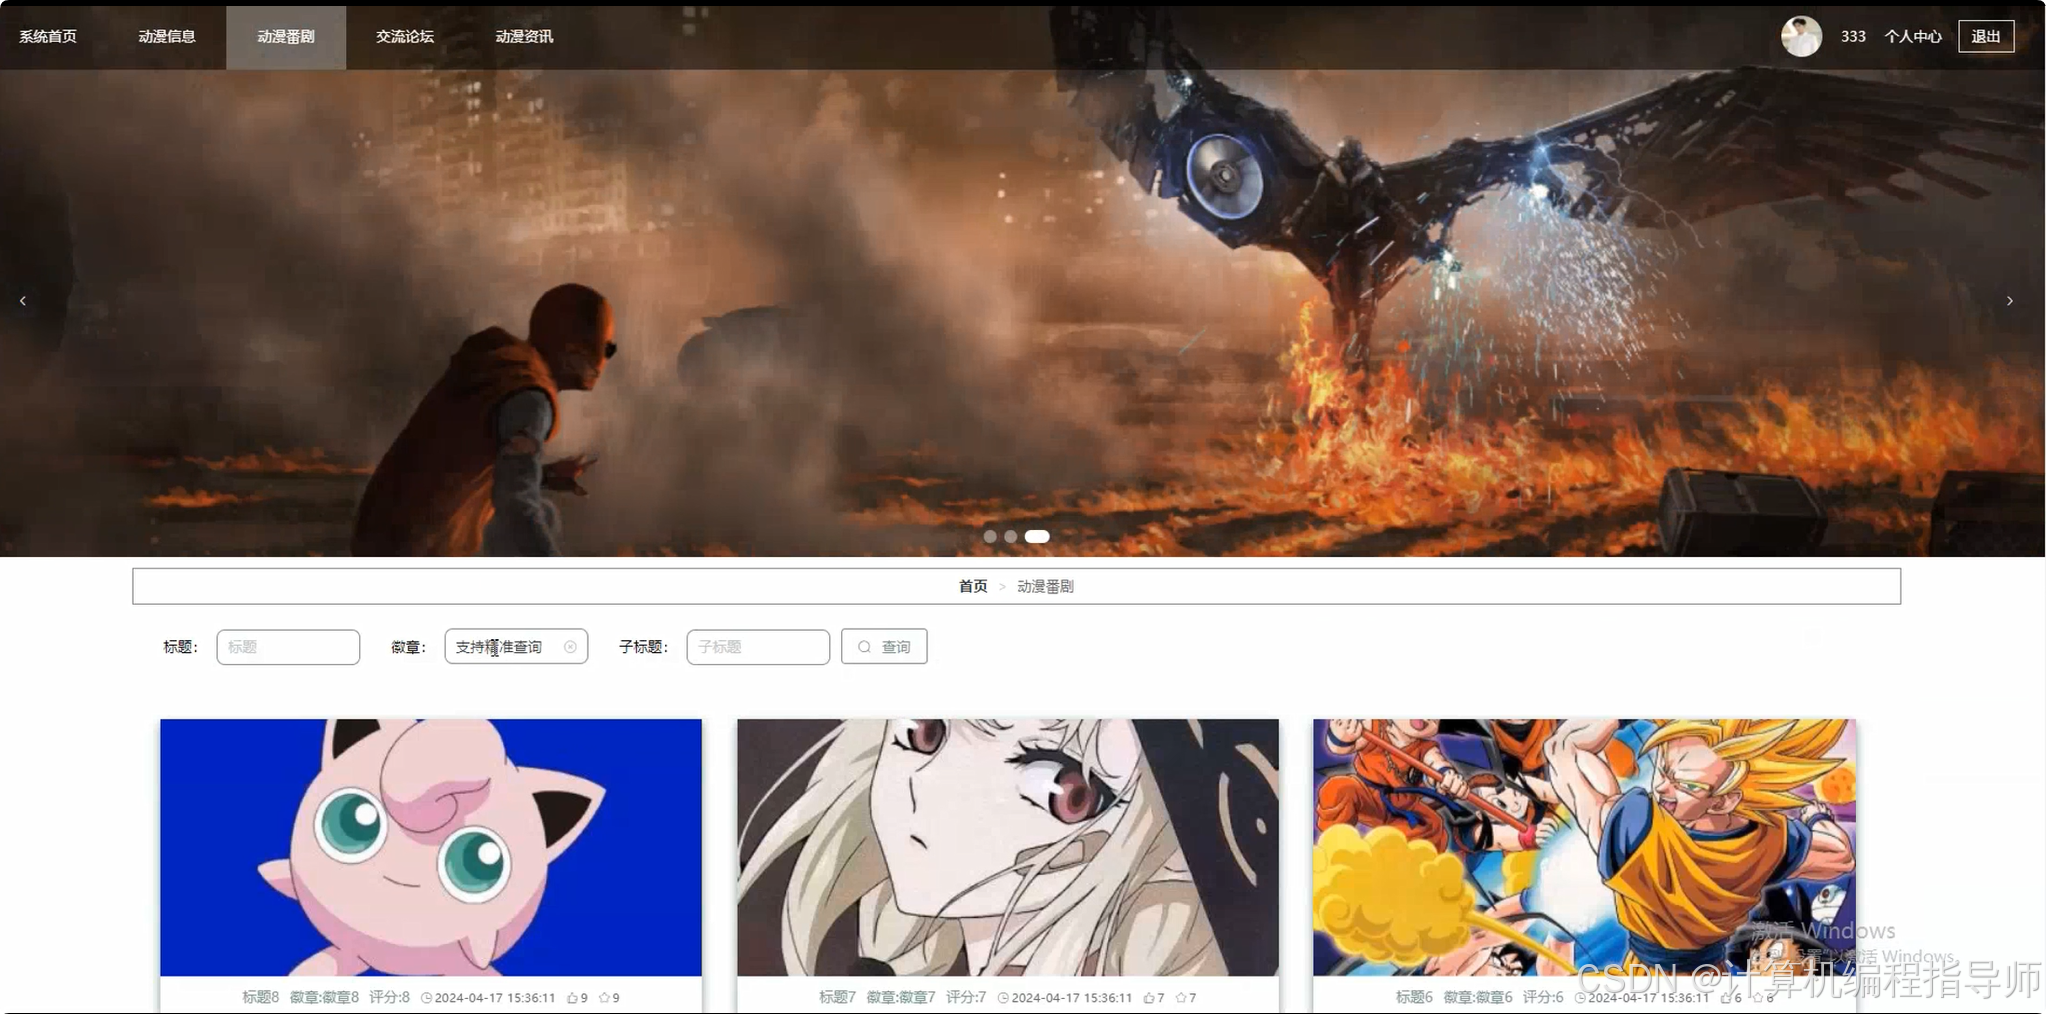
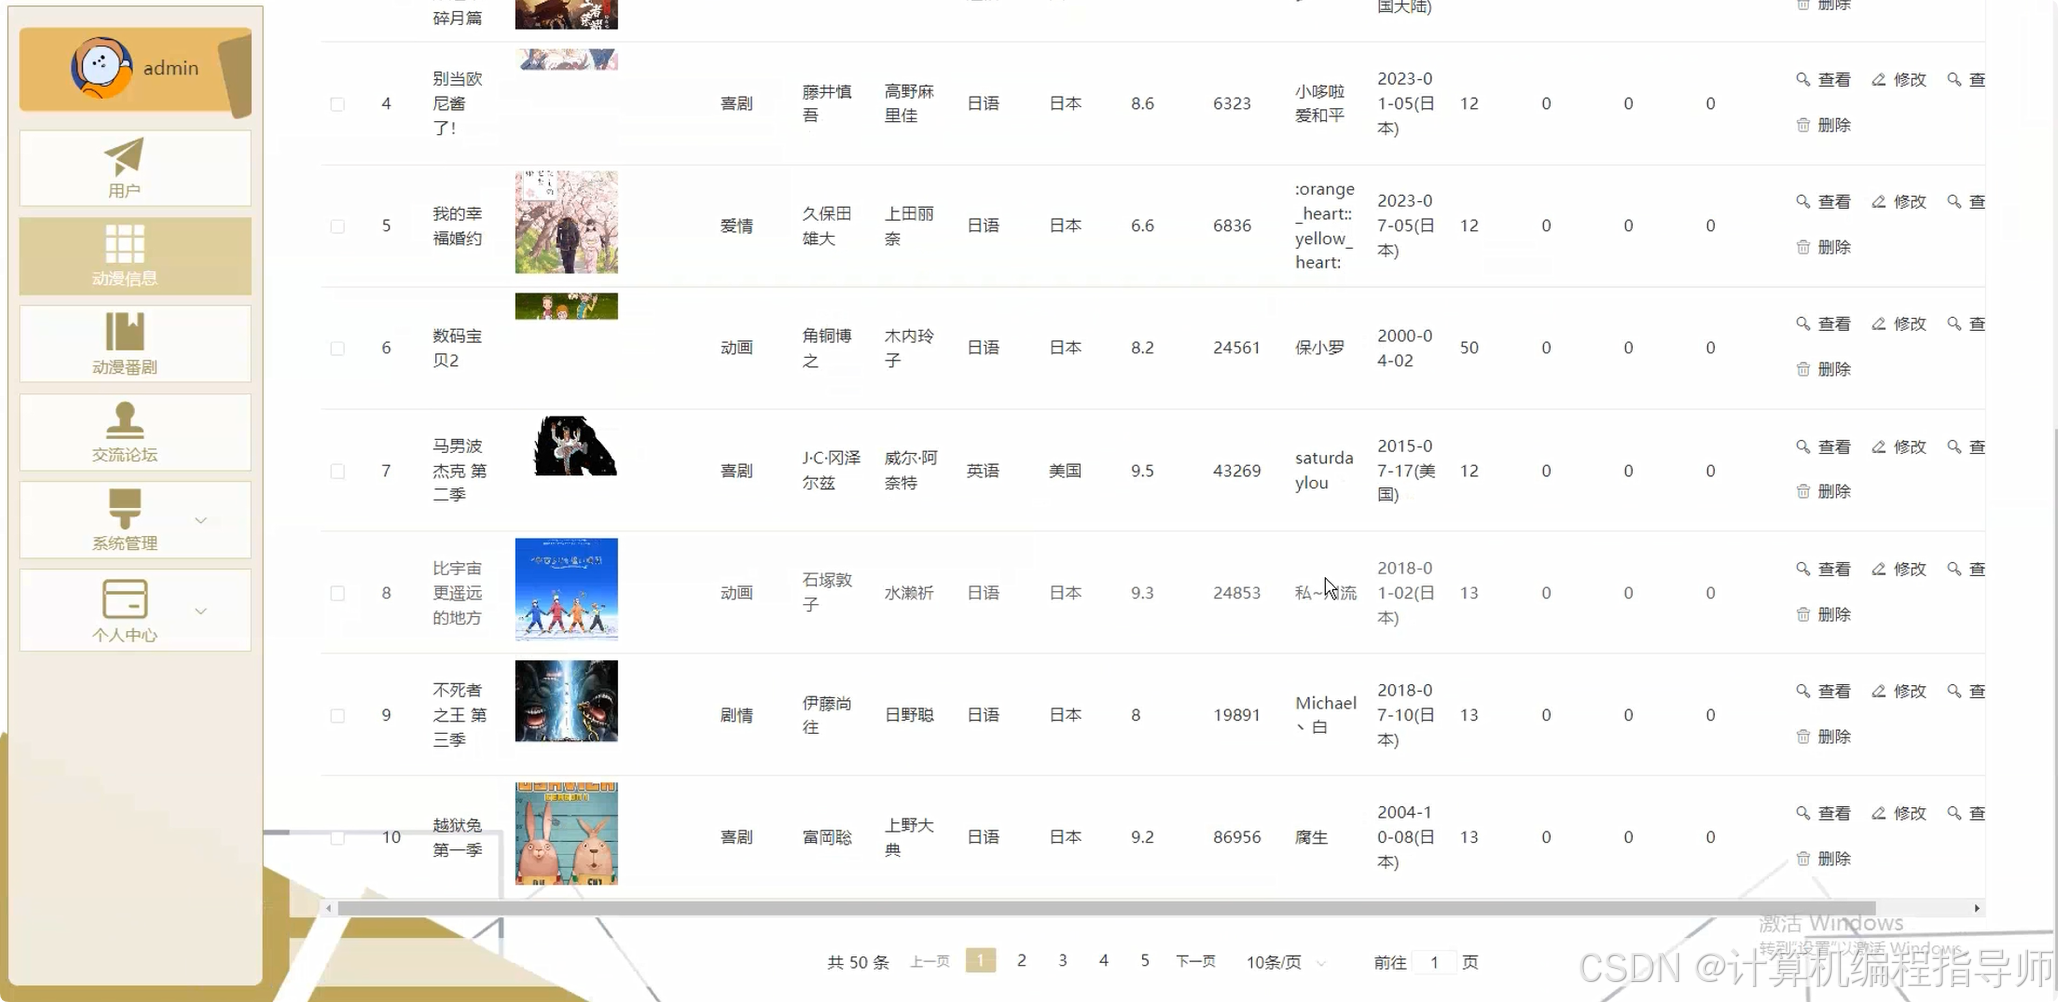
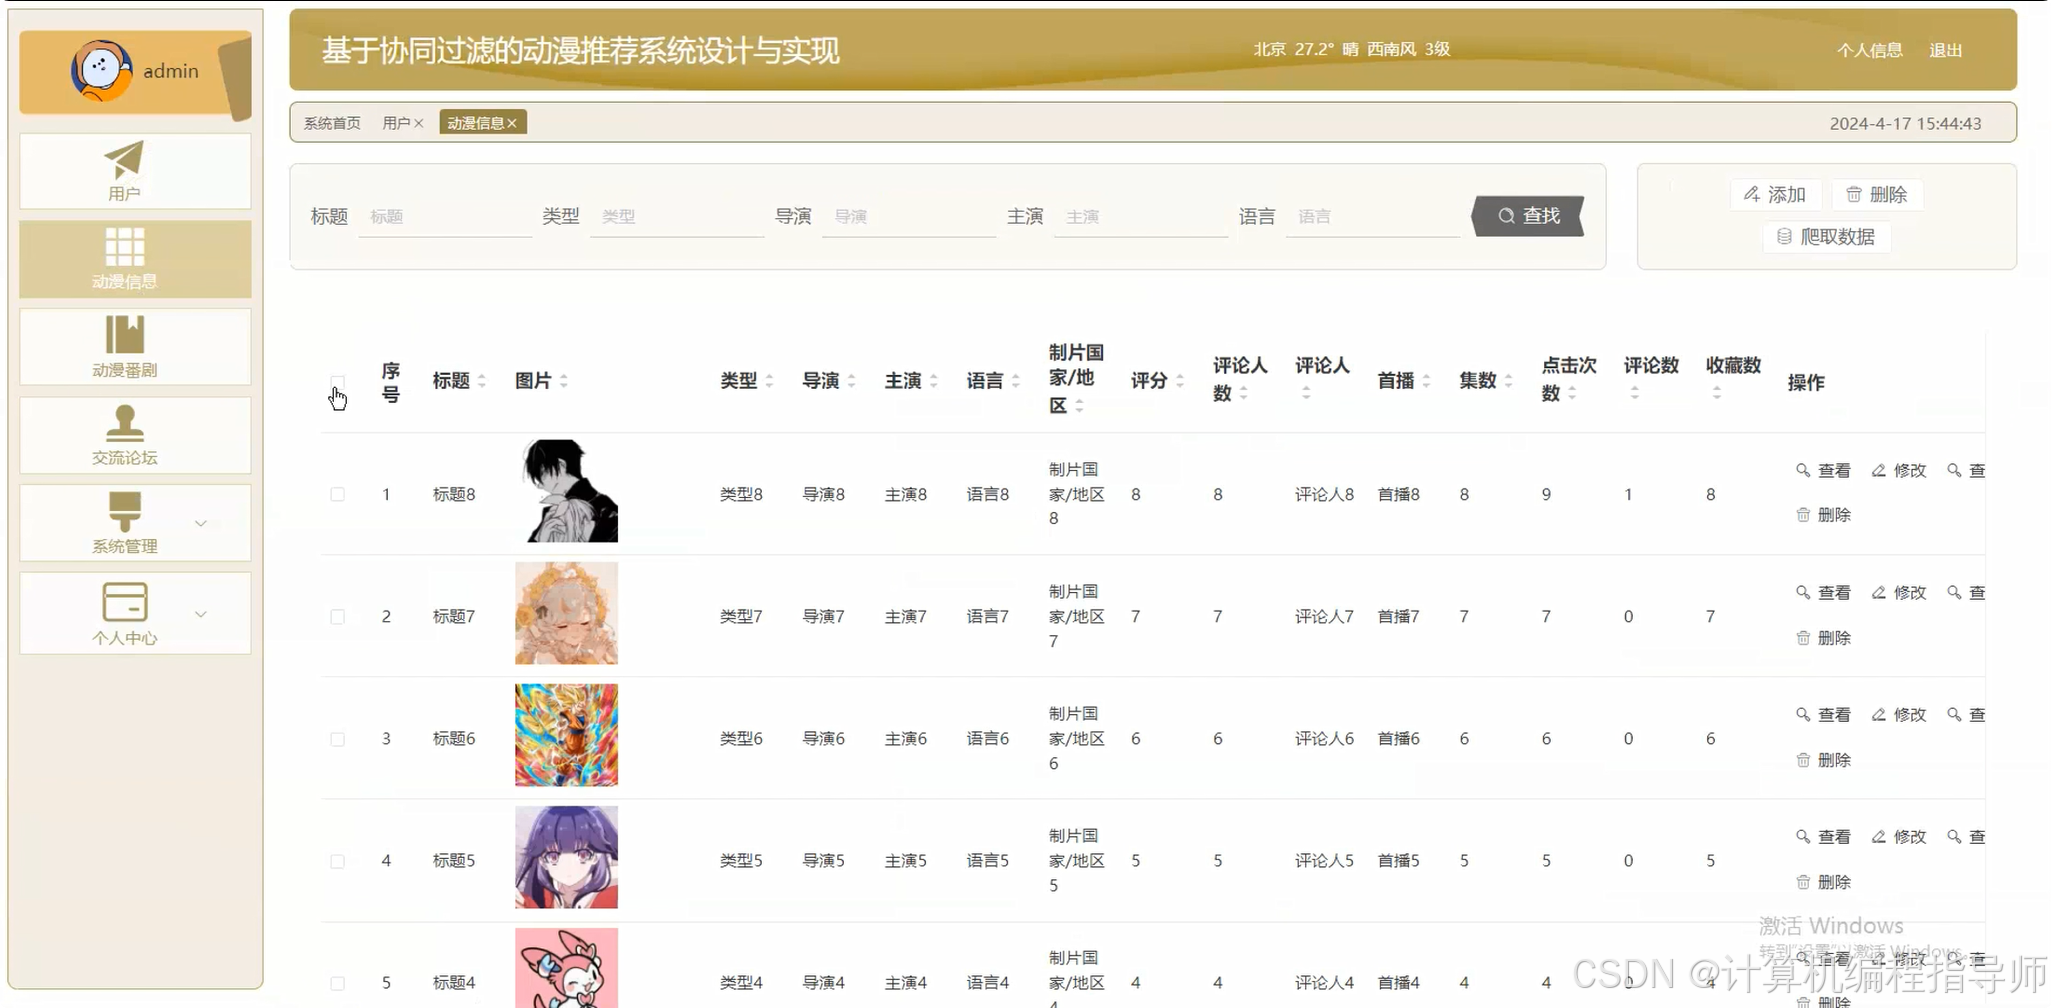
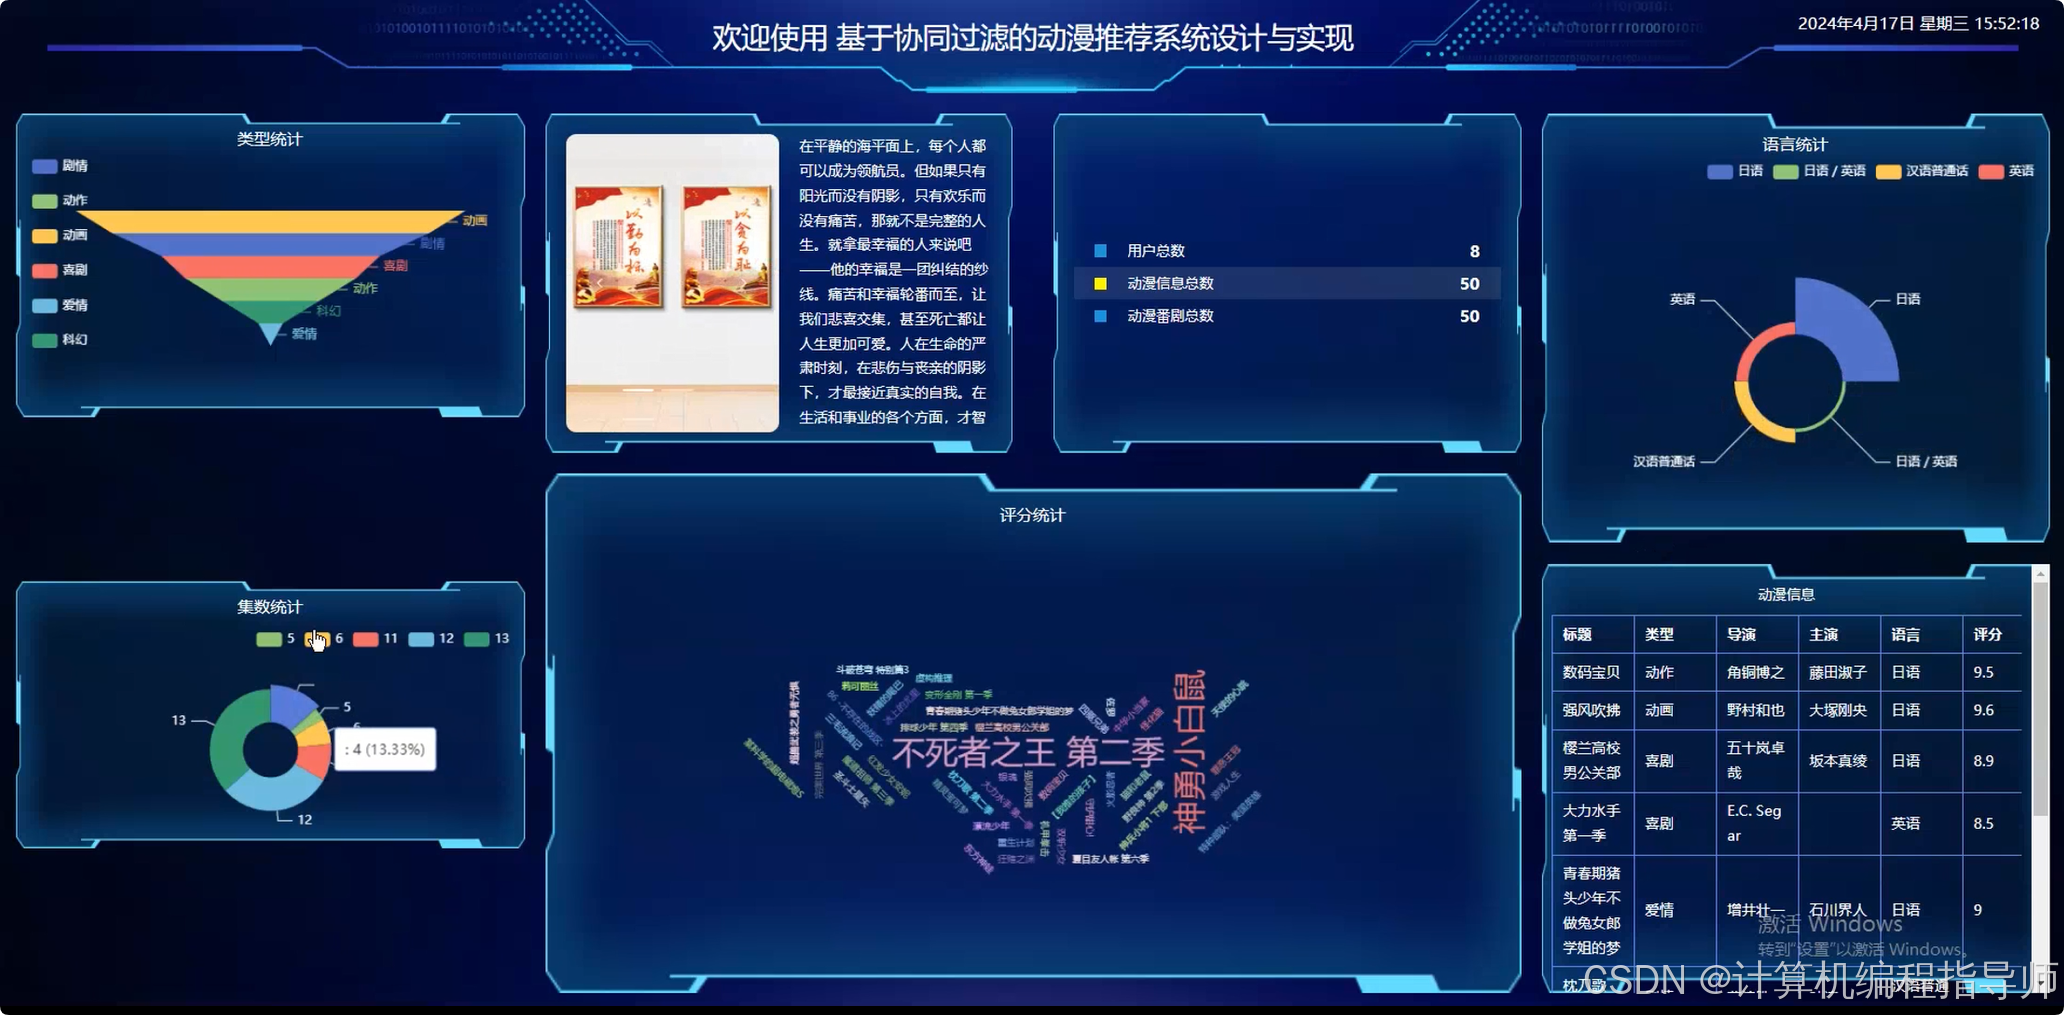
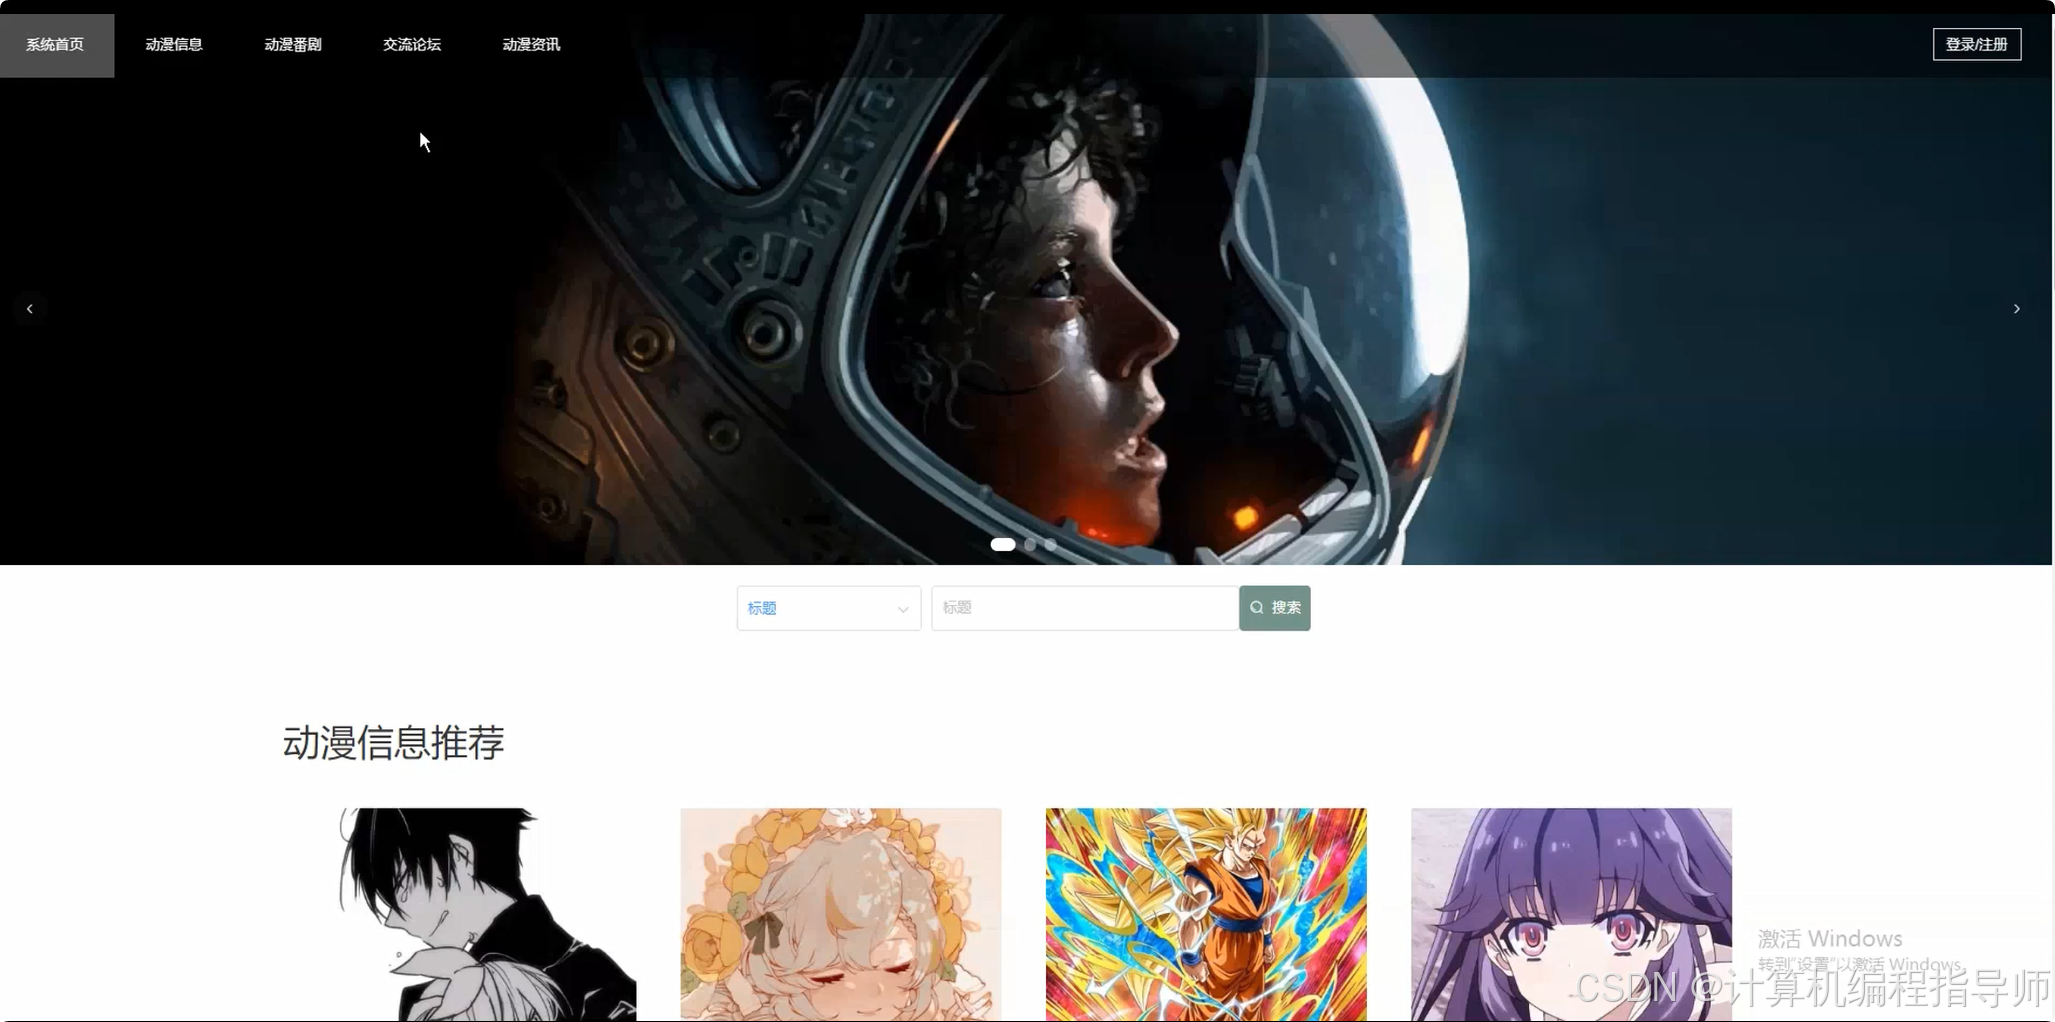
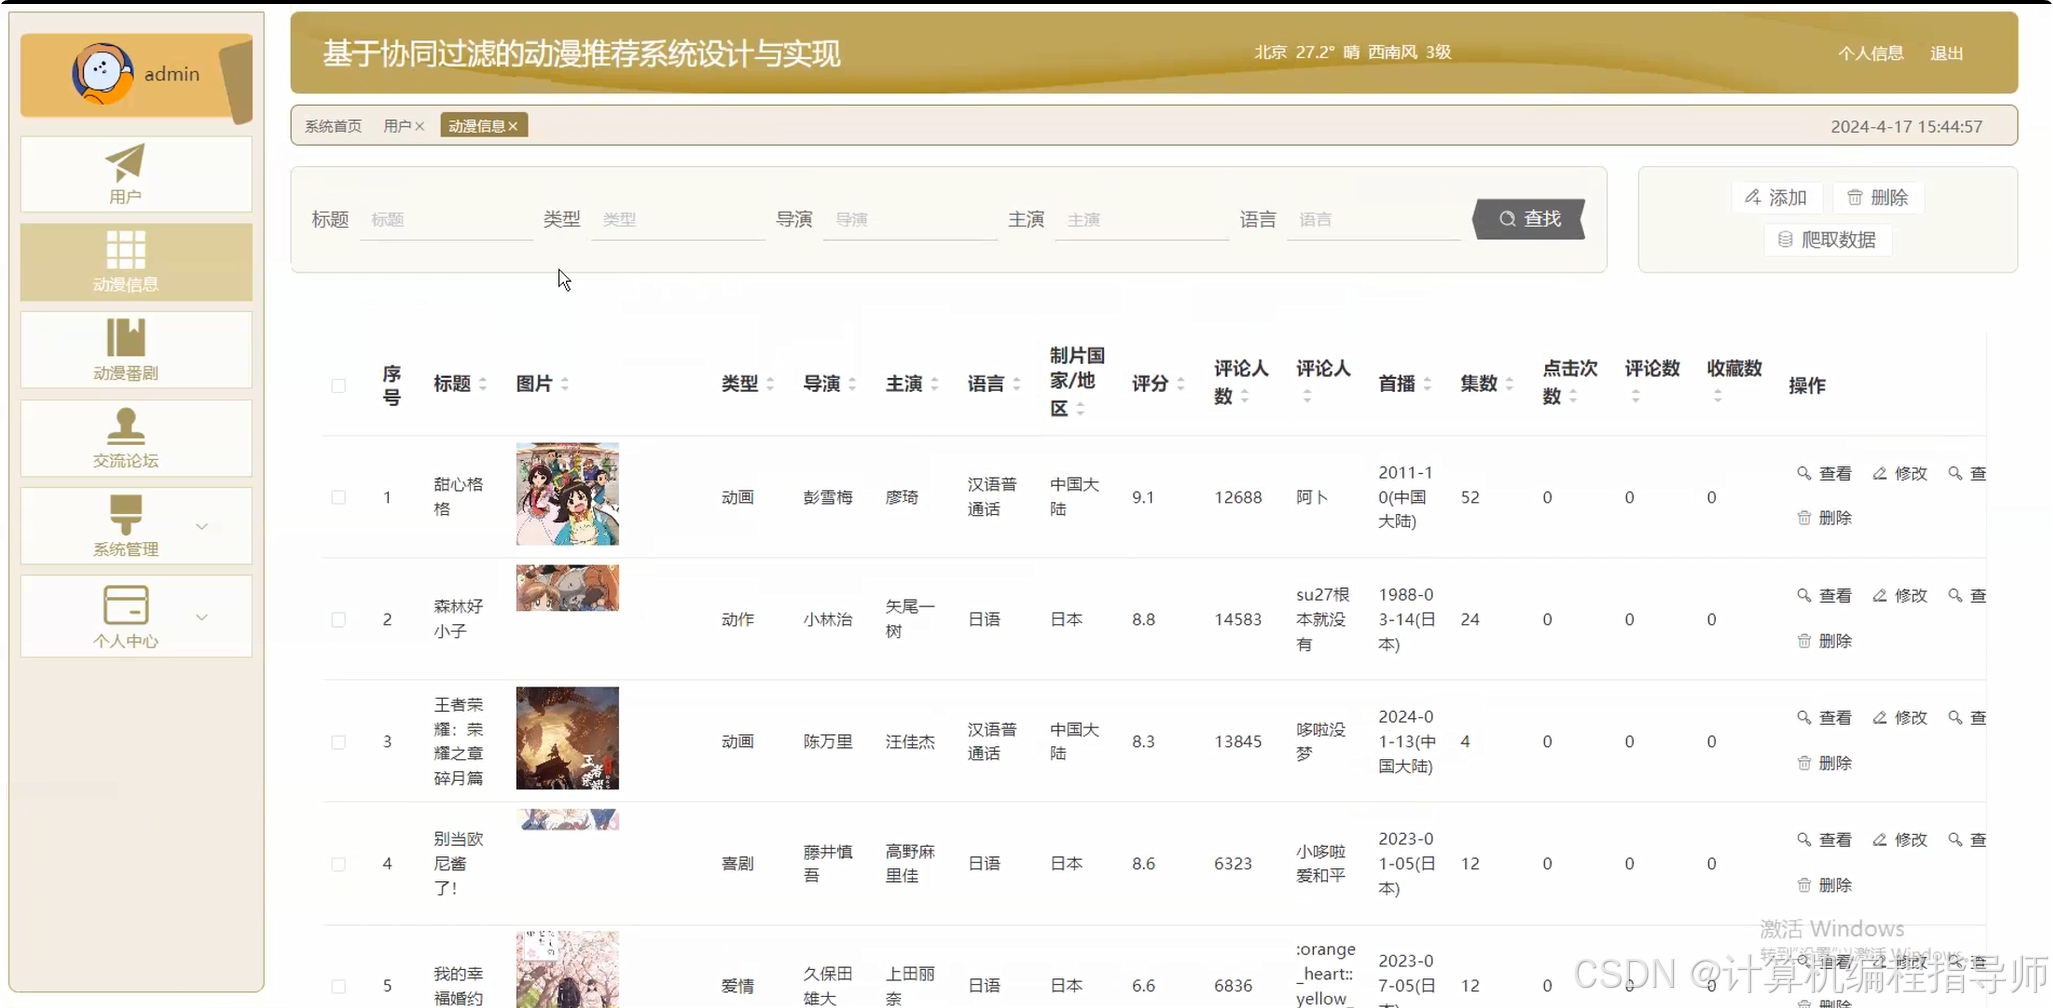
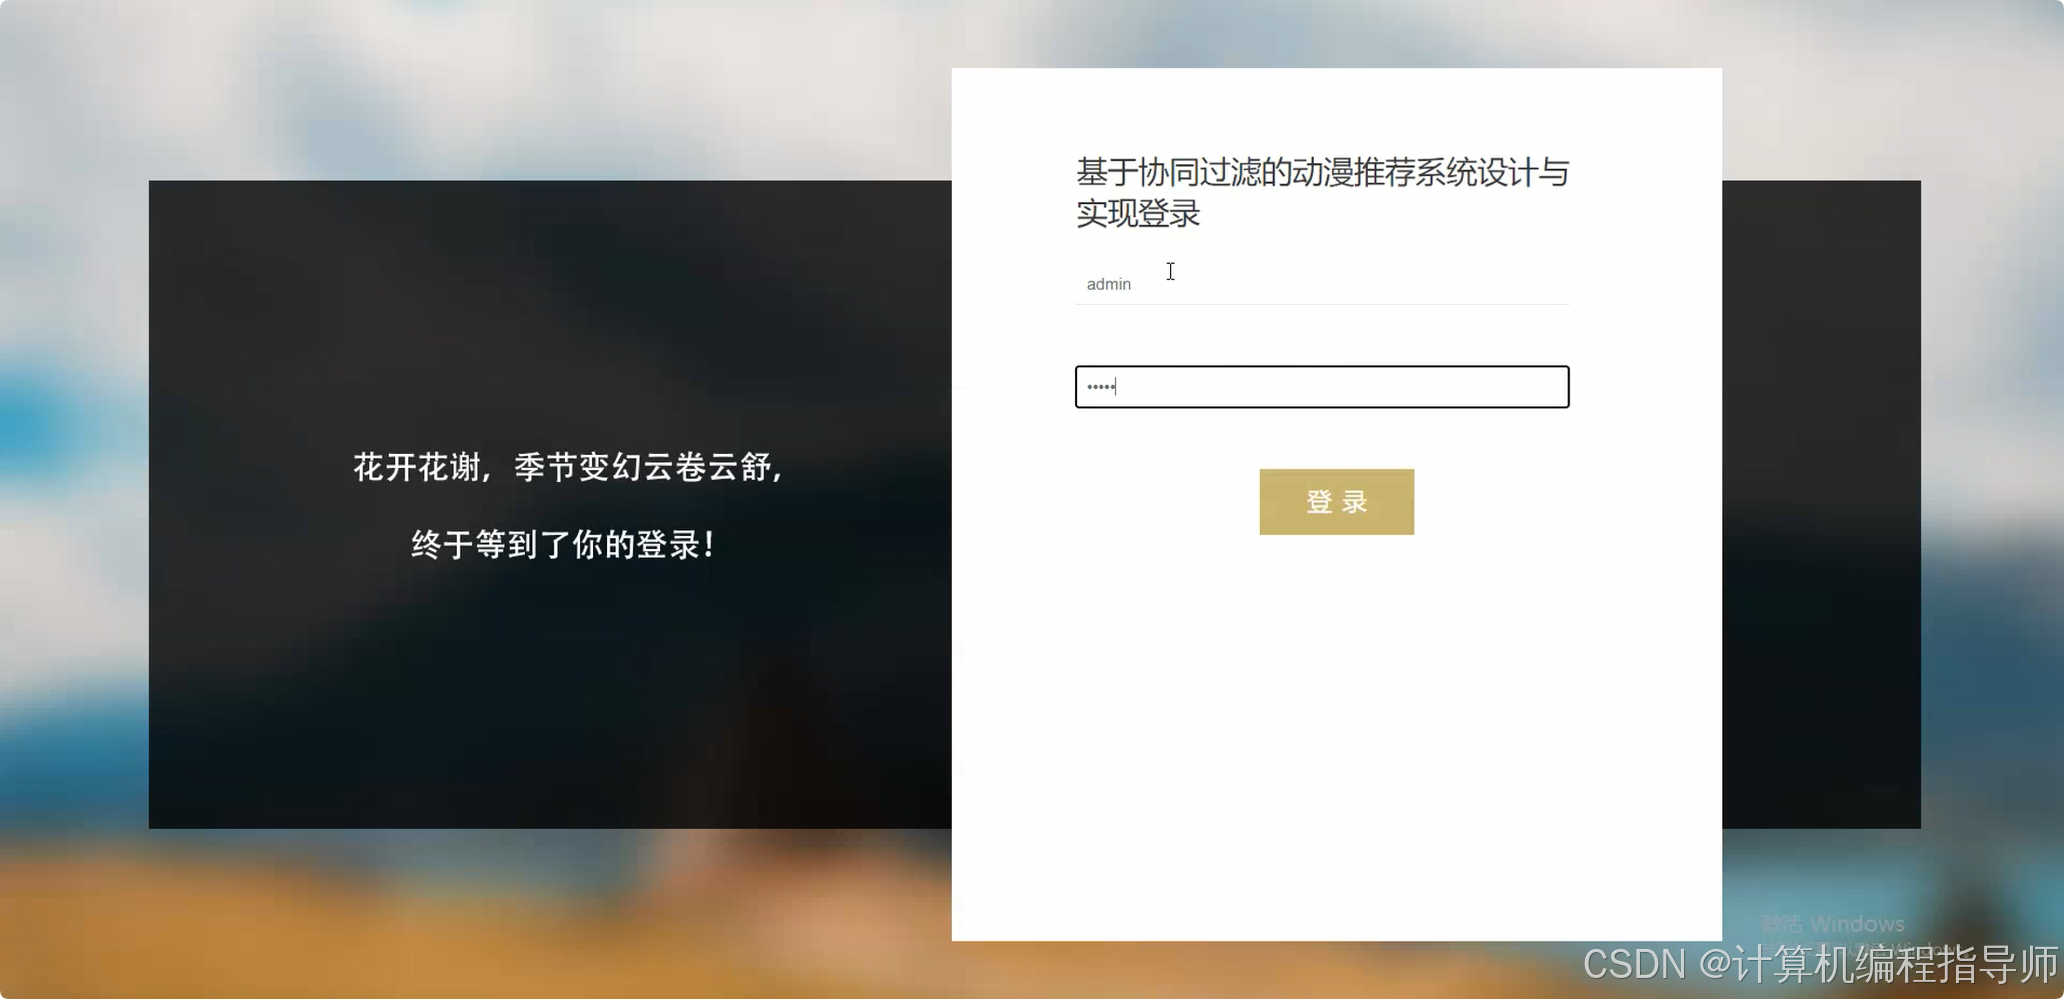
动漫推荐系统-图片展示
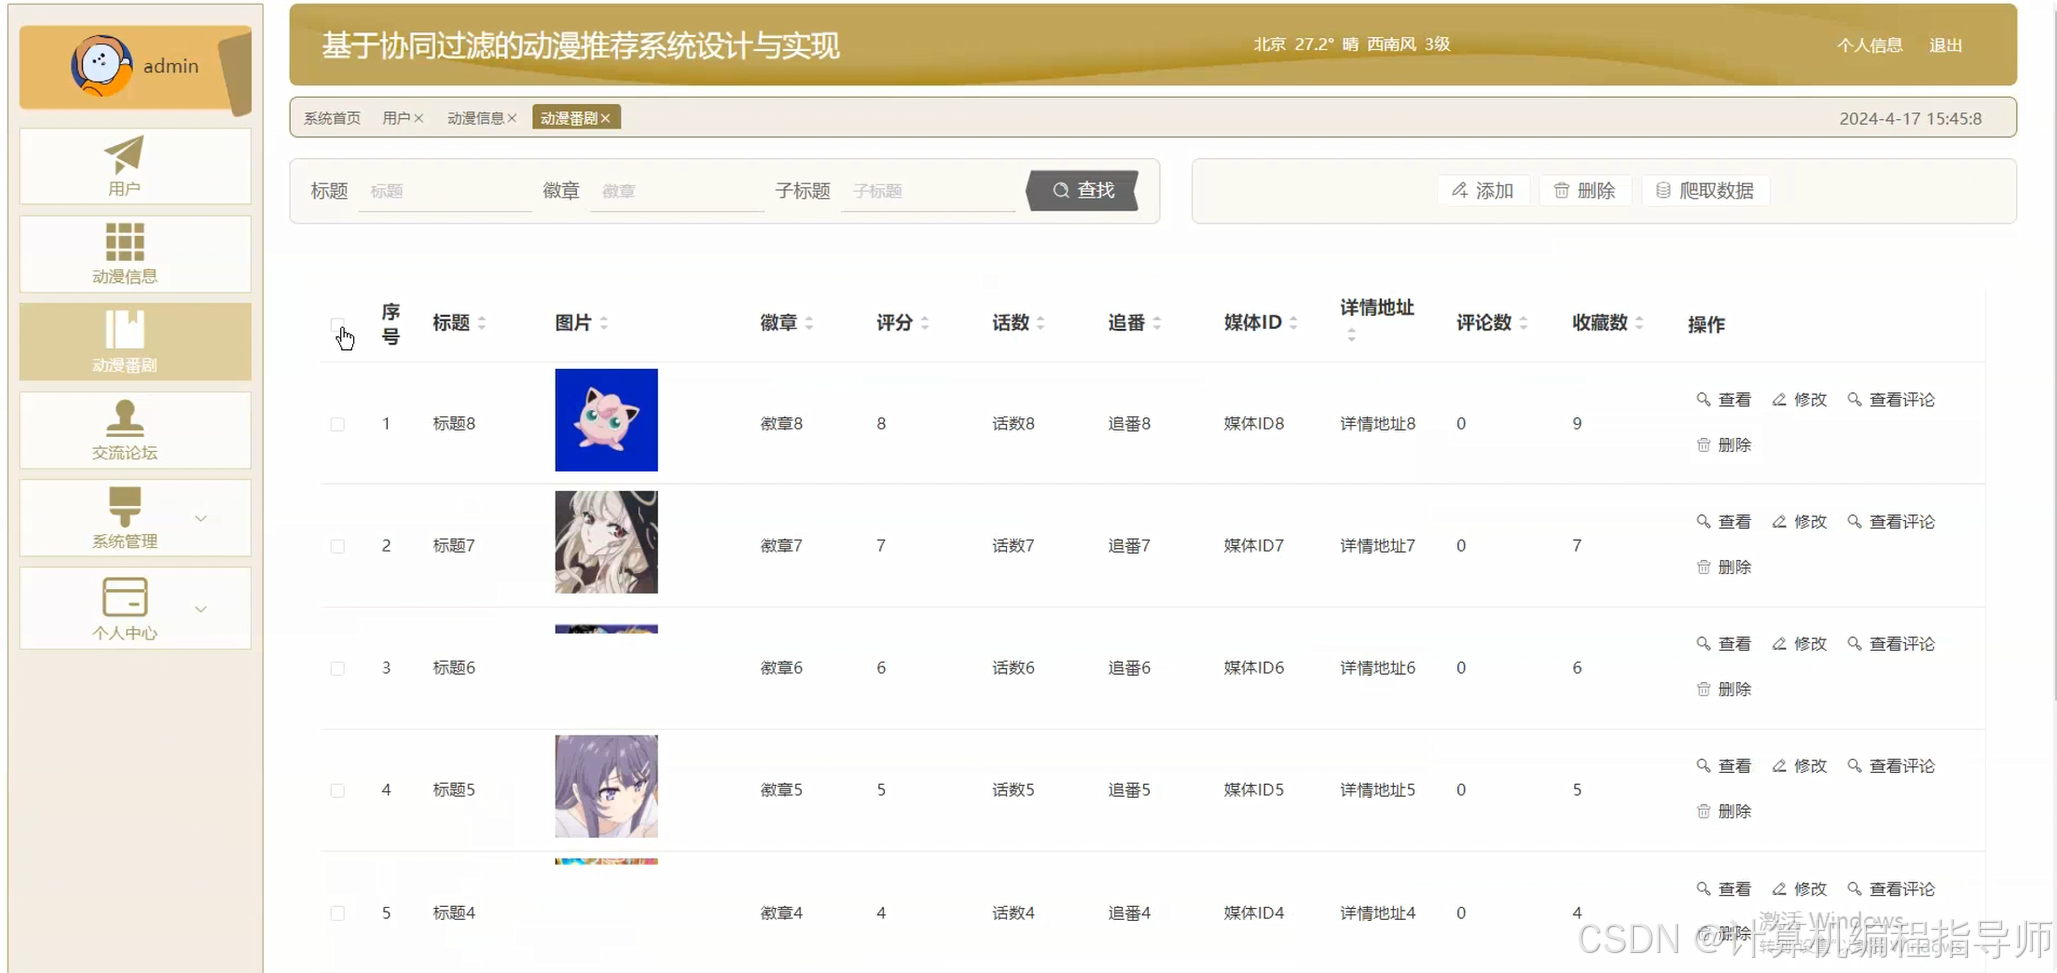
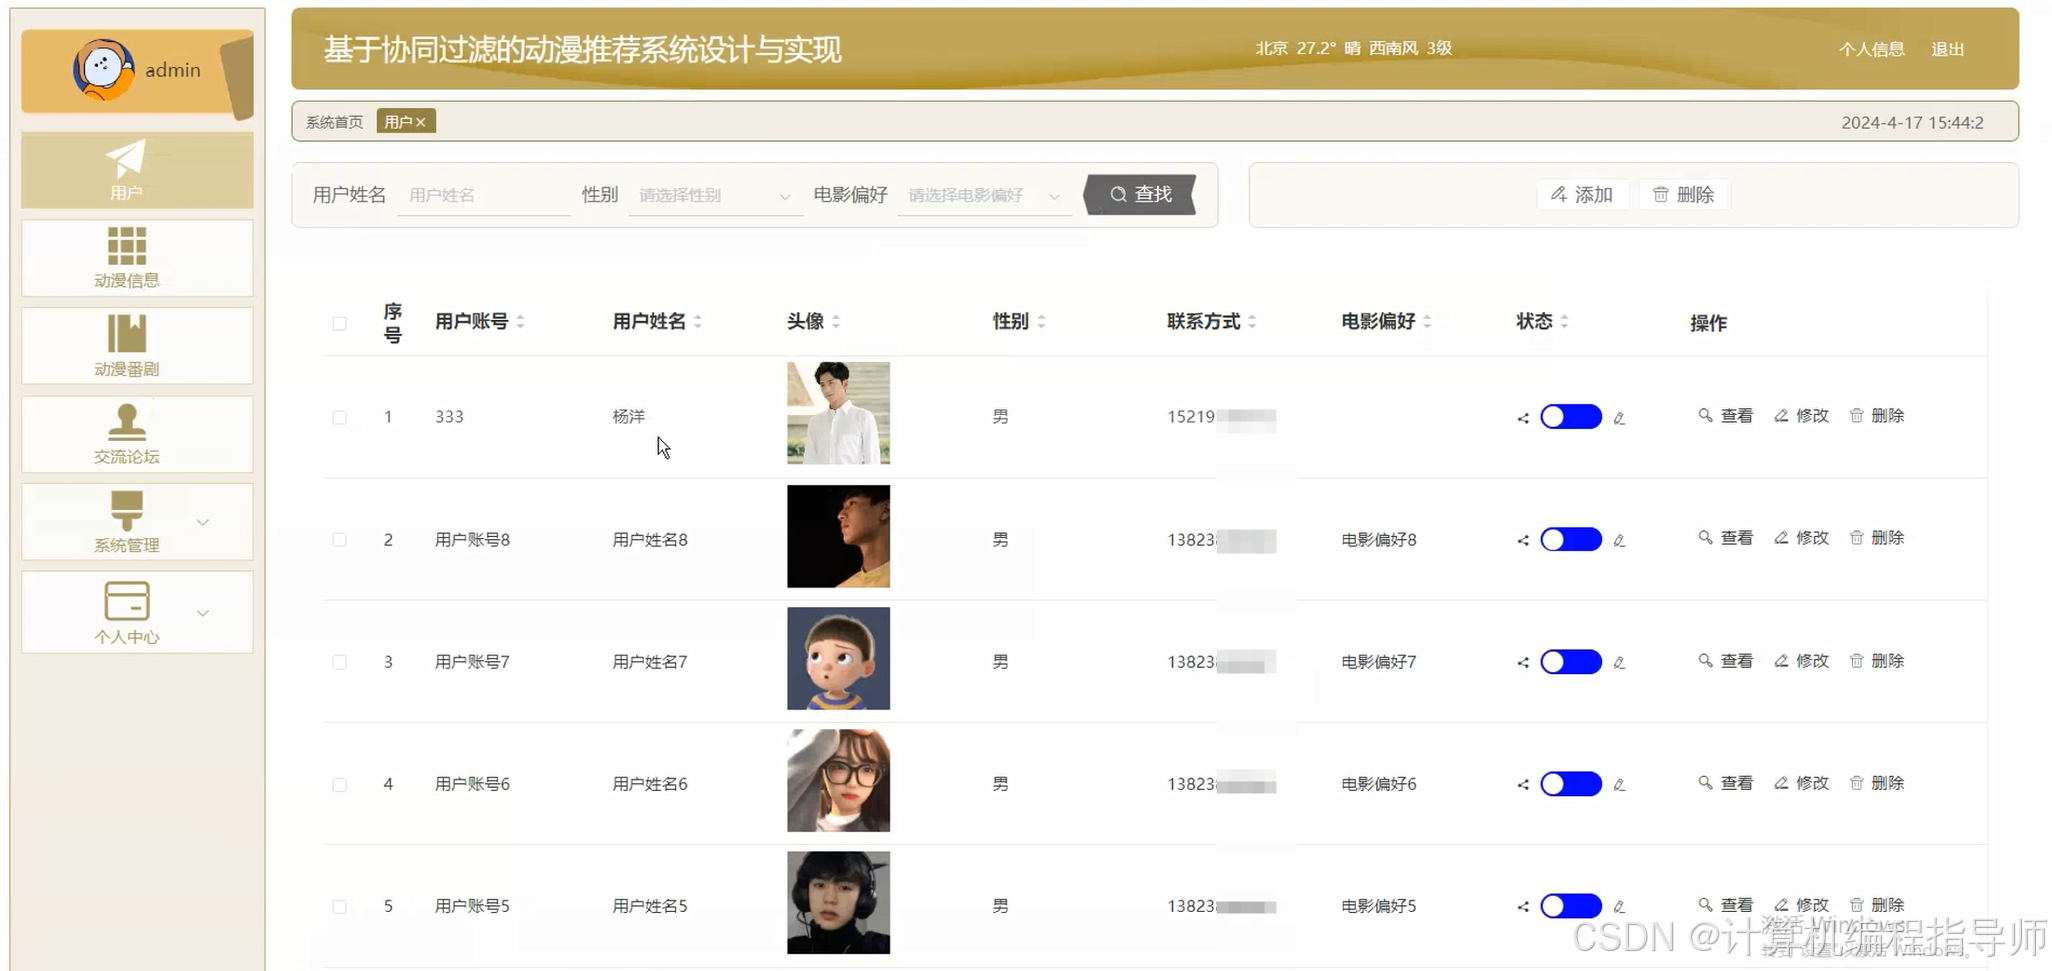
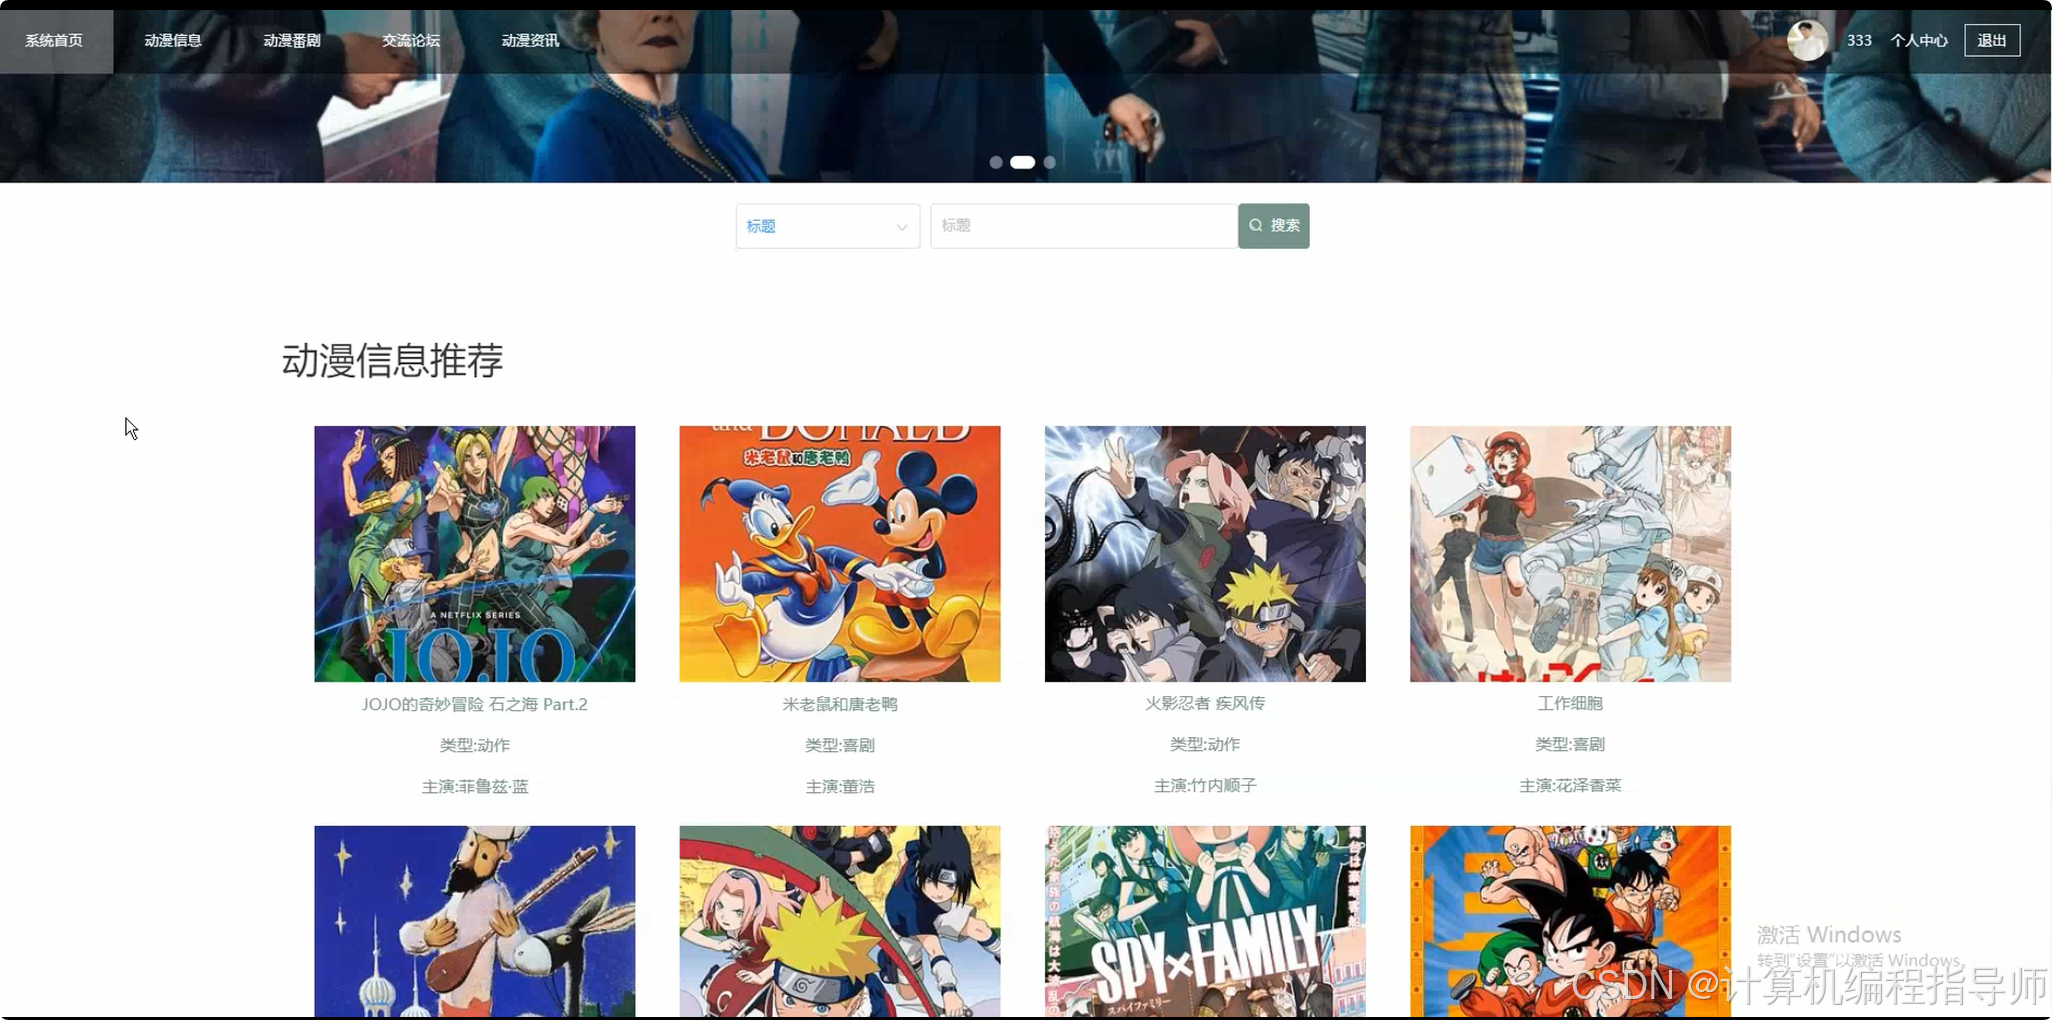
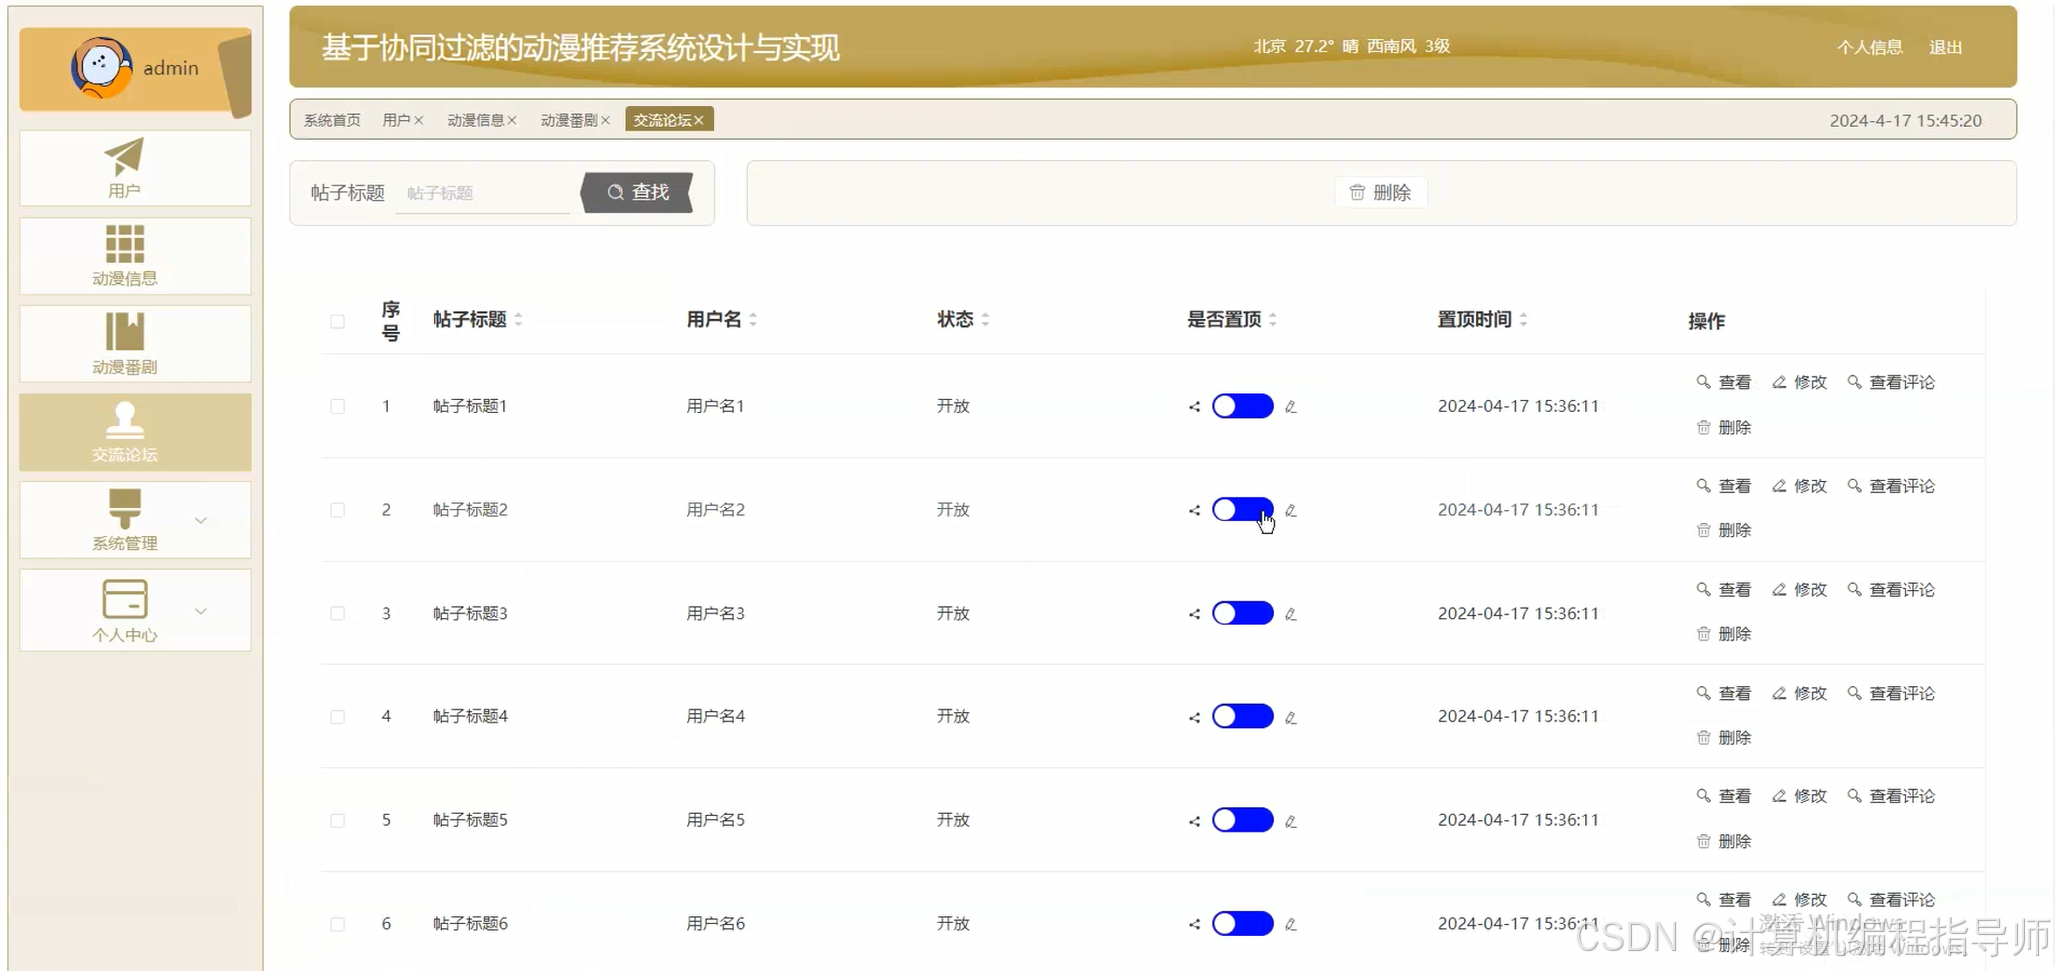
动漫推荐系统-代码展示
import pandas as pd
from sklearn.metrics.pairwise import cosine_similarity

# 假设有一个用户-动漫评分矩阵
user_anime_ratings = pd.DataFrame({
    'user1': [5, 3, 0, 1],
    'user2': [4, 0, 0, 1],
    'user3': [1, 1, 0, 5],
    'user4': [1, 0, 0, 4],
    'user5': [0, 1, 5, 4],
}, index=['anime1', 'anime2', 'anime3', 'anime4'])

# 计算用户间的余弦相似度
user_similarity = cosine_similarity(user_anime_ratings.T)
user_similarity_df = pd.DataFrame(user_similarity, index=user_anime_ratings.columns, columns=user_anime_ratings.columns)

print(user_similarity_df)
def recommend_animes(user, similarity_df, ratings_df, num_recommendations=5):
    # 获取与目标用户最相似的其他用户
    similar_users = similarity_df[user].sort_values(ascending=False).index[1:]

    # 获取这些相似用户评分较高的动漫
    recommended_animes = ratings_df.loc[:, similar_users].sum(axis=1).sort_values(ascending=False)

    # 过滤掉目标用户已经评分的动漫
    recommended_animes = recommended_animes[recommended_animes.index.isin(ratings_df.loc[:, user][ratings_df.loc[:, user] == 0].index)]

    return recommended_animes.head(num_recommendations)

# 为用户1推荐动漫
recommended_animes_for_user1 = recommend_animes('user1', user_similarity_df, user_anime_ratings)
print(recommended_animes_for_user1)
def update_user_ratings(user, anime, rating, ratings_df):
    # 更新用户对动漫的评分
    ratings_df.at[anime, user] = rating

    # 重新计算用户相似度
    global user_similarity_df
    user_similarity_df = pd.DataFrame(cosine_similarity(ratings_df.T), index=ratings_df.columns, columns=ratings_df.columns)

# 示例:用户1对动漫3进行了评分
update_user_ratings('user1', 'anime3', 4, user_anime_ratings)
print(user_anime_ratings)
print(user_similarity_df)
动漫推荐系统-结语
感谢各位同学的关注与支持!如果你喜欢我们的动漫推荐系统,不妨一键三连支持一下哦!同时,也欢迎大家在评论区留下你的宝贵意见和观后感,与更多动漫爱好者一起交流分享。你的每一个互动,都是我们前进的动力!关注我们,更多精彩内容等你来发现
⚡⚡
Java实战 | SpringBoot/SSM
Python实战项目 | Django
微信小程序/安卓实战项目
大数据实战项目
⚡⚡有技术问题或者获取源代码!欢迎在评论区一起交流!
⚡⚡大家点赞、收藏、关注、有问题都可留言评论交流!
⚡⚡有问题可以在主页上详细资料里↑↑联系我~~
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献7条内容

所有评论(0)