(2024|ECCV|NVIDIA)Dolphins: 多模态语言模型在自动驾驶中的应用
Dolphins: Multimodal Language Model for Driving
目录
1. 引言
当前的 自动驾驶系统(Autonomous Driving Systems,ADS)主要采用数据驱动的模块化方法,将任务划分为感知、预测、规划和控制。然而,这些系统在处理复杂的现实世界场景时,仍存在整合性差、泛化能力不足等问题:
- 整体理解和解释:现有的数据驱动的自动驾驶系统 (ADS) 往往无法整体理解和解释动态和复杂场景,尤其是开放世界驾驶环境的长尾分布中的场景。例如,考虑一个球弹到路上,然后一个孩子追着它跑的场景,人类驾驶员可以立即推断出潜在的危险并采取相应行动,以防止任何事故发生,利用常识、过去的经验和对人类行为的基本理解。相比之下,现有的 ADS 可能很难准确地解释这种场景,除非事先接触大量类似的数据。这种缺乏整体理解的情况限制了系统在可能位于数据分布长尾的意外场景中很好地概括的能力。
- 即时学习和适应:与人类驾驶员仅通过几个示例就能立即学习和适应新场景不同,现有的 ADS 需要大量数据进行大量训练才能处理新情况。例如,人类驾驶员在遇到一两次新型道路障碍物后就能快速学会如何绕过它,而 ADS 可能需要接触许多类似的场景才能学到同样的知识。
- 反思和错误恢复:现有的 ADS 在运行过程中通常采用前馈处理,缺乏基于反馈和指导的实时校正能力。相比之下,人类驾驶员可以根据反馈实时纠正他们的驾驶行为。例如,如果人类驾驶员走错了路,他们可以根据错误反馈快速调整决定,而 ADS 可能很难从错误反馈中快速恢复。
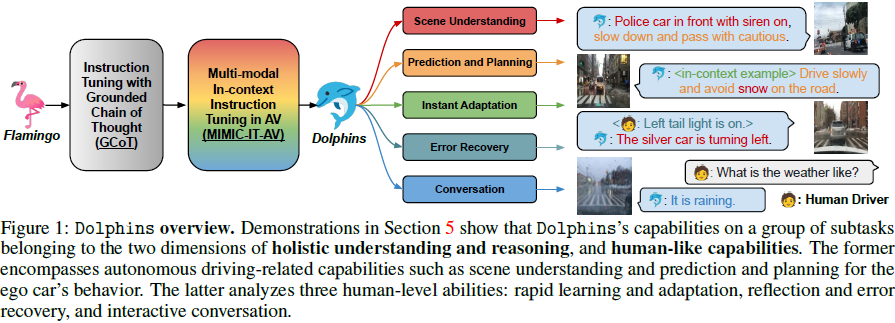
Dolphins 是一个新型的视觉语言模型(VLM),旨在作为自动驾驶的对话式驾驶助手,弥补现有 ADS 与人类驾驶员之间的差距。它能够处理多模态输入(视频、图像、文本指令和历史控制信号),并结合 情境指令微调(In-context Instruction Tuning)和 接地链式推理(Grounded Chain of Thought,GCoT),提高对驾驶场景的理解和适应能力。
Dolphins 具备以下核心特性:
- 综合理解能力——能识别并解析复杂的驾驶环境,处理多种自动驾驶任务。
- 人类驾驶能力——包括即时适应(gradient-free adaptation)、错误恢复(reflection & error recovery)等功能。
关键词:自动驾驶(Autonomous Driving)、多模态语言模型(Multimodal Language Model)、视觉语言模型(Vision-Language Model, VLM)、指令微调(Instruction Tuning)、链式推理(Chain of Thought, CoT)、情境学习(In-Context Learning)、误差恢复(Error Recovery)
2. 相关工作
大语言模型在自动驾驶中的应用
- 近期研究探索了如何利用大语言模型(LLM)进行自动驾驶任务,例如 DriveLikeHuman、GPT-Driver、SurrealDriver 以及 DriveLM。
- 这些模型大多依赖文本输入,缺乏视觉感知能力。相比之下,Dolphins 采用视觉-语言联合建模,提高了视觉感知与推理能力。
大规模视觉语言模型(LVLMs)
- 近年来的 Flamingo、BLIP-2、LLaVA、MiniGPT-4 等模型推进了视觉语言模型(VLM)的发展。
- 这些模型虽具备视觉理解能力,但在驾驶领域的泛化能力较弱。Dolphins 通过指令微调和多模态学习克服了这一局限。
多模态情境学习(Multimodal In-context Learning)
- 通过构建多模态大规模数据集,Flamingo 等模型在开放任务中表现出色。
- Dolphins 进一步将该方法应用到自动驾驶场景,使其具备少样本学习能力。
3. 方法
3.1 基于 GCoT 的指令微调
当前的数据集(如大量驾驶视频与相关问答集配对组成的数据集)的粗粒度对齐使得现有 VLMs 在自动驾驶任务上的理解能力有限。
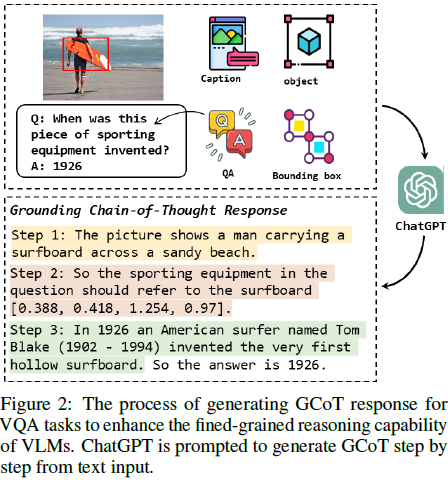
Dolphins 通过 接地链式推理(Grounded Chain of Thought, GCoT),使其具备更细粒度的视觉理解和推理能力。
可基于通用视觉问答(VQA)数据集,通过 ChatGPT 生成 GCoT 训练数据。如图 2 所示。
- 简要描述图片内容。
- 识别问题中的物体并描述其空间位置。
- 如果问题需要推理,则在此步骤中提供推理过程。
- 最后,将这三个步骤中 ChatGPT 生成的句子组合起来,并在末尾附加 “所以答案是 {answer}”,以形成完整的 GCoT 响应。
3.2 自动驾驶指令任务设计
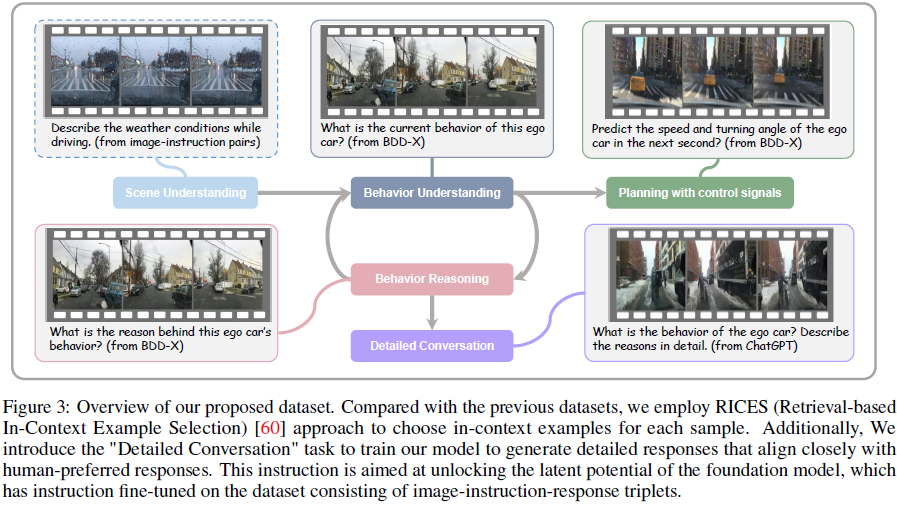
Dolphins 使用 BDD-X 数据集构建视觉指令遵循数据集,涵盖四类核心任务:
- 驾驶行为理解(Behavior Understanding):预测车辆的驾驶动作,如停车、变道等。
- 驾驶行为推理(Behavior Reasoning):分析车辆行为背后的原因,如遇到红灯而停车。
- 基于控制信号的预测(Prediction with Control Signals):预测下一秒的车速和转向角度。
- 详细对话(Detailed Conversation):与驾驶员进行深入对话,如交通规则、潜在风险等。
由于任务和指令多样性的限制,在此数据集上训练的 VLM 在对未见过的任务进行零样本泛化的能力方面表现出了显著的缺陷。因此,我们利用 多模态情景指令微调(multi-modal in-context instruction tuning),来帮助我们的模型在自动驾驶相关任务中,仅使用少量带注释的示例即可快速适应新指令。
3.3 多模态情境指令微调
采用 OpenFlamingo 作为基础模型,并引入多模态情境学习方法,使 Dolphins 能够适应多种自动驾驶任务。
自动驾驶相关指令数据集(如 第 3.2 节 所述)采用 视频-指令-答案三元组(video-instruction-answer triplets)的格式。因此,我们采用 检索方法 为每个三元组选择情境示例(in-context examples)。
具体而言,
- 我们利用 VideoMAE 作为 视频编码器(E_Image)和 text-embedding-ada-002 作为 文本编码器(E_Text),分别将视频片段 X_v 和文本实例(指令-答案对)X_t 映射到 d 维的潜在空间。
- 然后,对于每个样本 Z^i = (X^i_v,X^i_t) ,我们基于 余弦相似度 检索情境示例。该检索流程可表示如下:
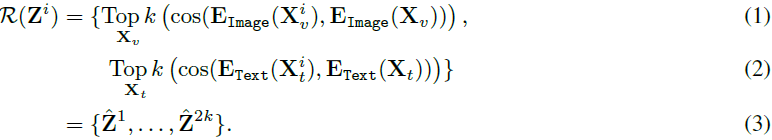
其中,k 表示分别在 文本编码的潜在空间 和 图像编码的潜在空间 中搜索的最近邻样本数。
本质上,该方法倾向于选择在视频中具有 类似行为 的情境示例(in-context examples)。
4. 训练
4.1 模型架构
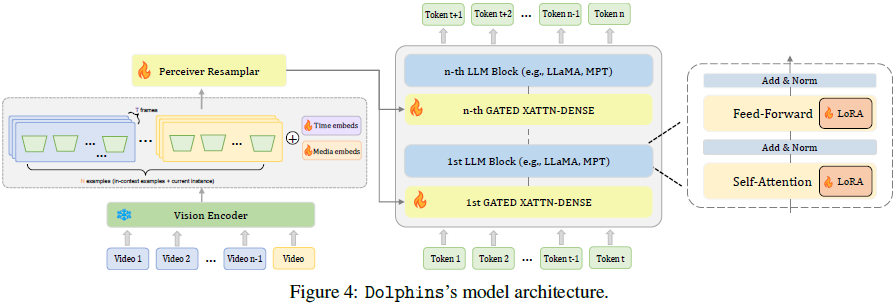
Dolphins 采用 OpenFlamingo 结构(Flamingo 的复现),包括:
- CLIP 视觉编码器
- 感知采样器(Perceiver Resampler):从视觉编码器接收视觉特征
- 语言编码器(LLaMA 或 MPT)
- 增强的交叉注意力模块
由于 OpenFlamingo 不支持视频输入,我们引入 时间位置嵌入(Temporal Position Embeddings),减轻由于空间特征聚集而导致的全局时间特征的消失,提升对视频输入的理解能力。
我们冻结两个编码器,仅对感知器重采样器模块、门控交叉注意层和添加到文本编码器的 LoRA 模块进行微调。
4.2 训练细节
采用 DeepSpeed 进行优化,使用 AdamW 进行权重衰减。
训练数据:
- 第一阶段:使用 GCoT 数据集进行微调,提高推理能力。
- 第二阶段:使用自动驾驶数据集进一步优化,使其适应实际驾驶任务。
5. 实验与示例
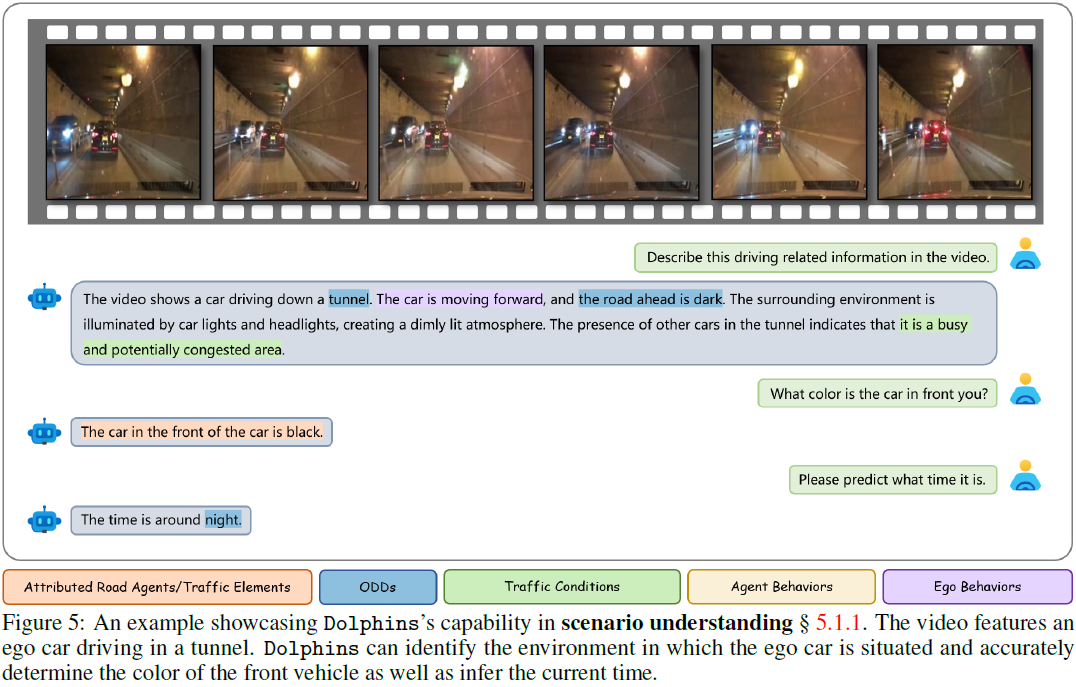
【更多示例图像见原论文】
5.1 车况理解与推理
- 感知(Perception):识别道路环境(天气、交通信号)、车辆状态(车灯、转向)、交通流等。
- 预测(Prediction):预测其他车辆的行为,如是否变道、停车等。
- 规划(Planning):根据路况和预测结果,为自动驾驶提供可行的驾驶方案。
5.2 类人能力
- 快速学习与适应(Rapid Learning & Adaptation):通过少量示例快速学习新任务,如判断天气影响、交通信号等。
- 交互对话(Interactive Conversation):可与驾驶员进行多轮对话,解答驾驶相关问题。
- 错误恢复(Reflection & Error Recovery):能根据反馈修正自身错误,如误判车辆行为后进行调整。
6. 结论与未来方向
Dolphins 在自动驾驶任务上展现出显著的优势,主要体现在:
- 多模态理解能力——能够解析复杂驾驶场景,提供合理推理。
- 人类驾驶能力模拟——能像人类驾驶员一样适应新情况,并进行错误修正。
- 高可解释性——可通过自然语言解释自身决策,提高透明度。
挑战与未来方向:
- 计算资源需求高——当前 Dolphins 在 NVIDIA A100 上推理时间为 1.34 秒,优化计算效率是未来重点。
- 任务泛化性——需要构建更丰富的自动驾驶数据集,以提升泛化能力。
- 模型轻量化——未来可探索精简版 Dolphins 以适应车载设备。
论文地址:https://arxiv.org/abs/2312.00438
项目页面:https://vlm-driver.github.io/
进 Q 学术交流群:922230617 或加 V:CV_EDPJ 进 V 交流群

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 27
 0
- 0


 已为社区贡献17条内容

所有评论(0)