强化学习DAY2:马尔可夫决策过程(MDP) & Q函数
·
1.2.2 马尔可夫决策过程(MDP):马尔可夫奖励(MRP) + 智能体动作因素
根据上文我们已经得知,在随机过程的基础上
- 增加马尔可夫性质,即可得马尔可夫过程
- 而再增加奖励,则得到了马尔可夫奖励过程(MRP)
- 如果我们再次增加一个来自外界的刺激比如智能体的动作,就得到了马尔可夫决策过程(MDP)
通俗讲,MRP与MDP的区别就类似随波逐流与水手划船的区别
在马尔可夫决策过程中,
(
是状态的集合)和
(
是奖励的集合)的每个可能的值出现的概率只取决于前一个状态
和前一个动作
(
是动作的集合),并且与更早之前的状态和动作完全无关
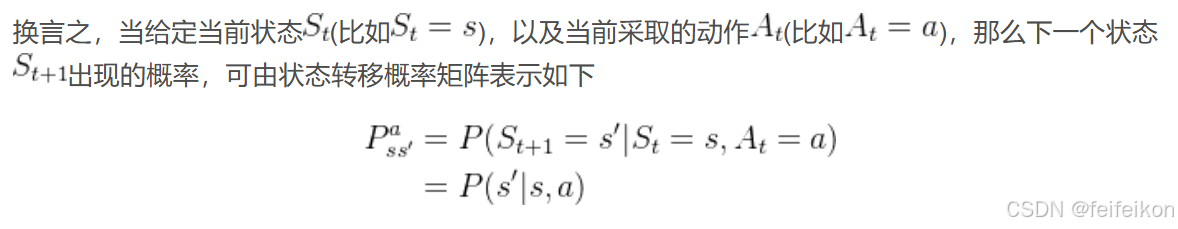
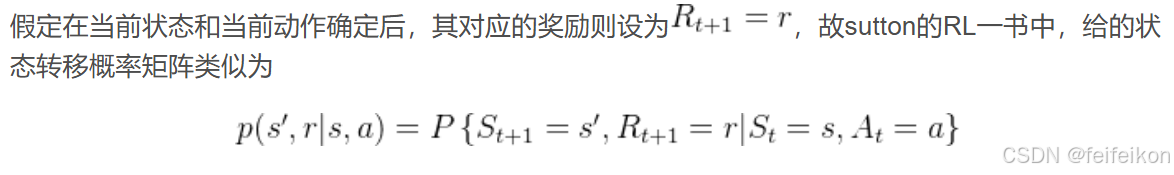
从而可得奖励函数即为
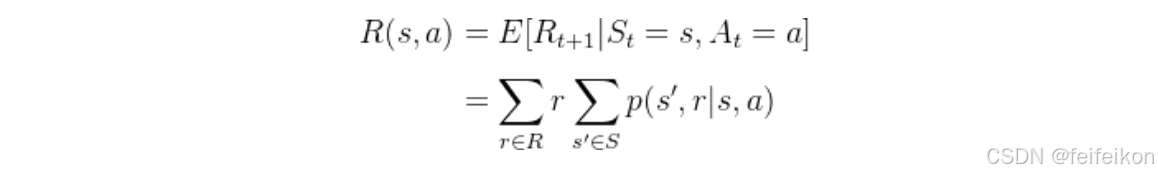
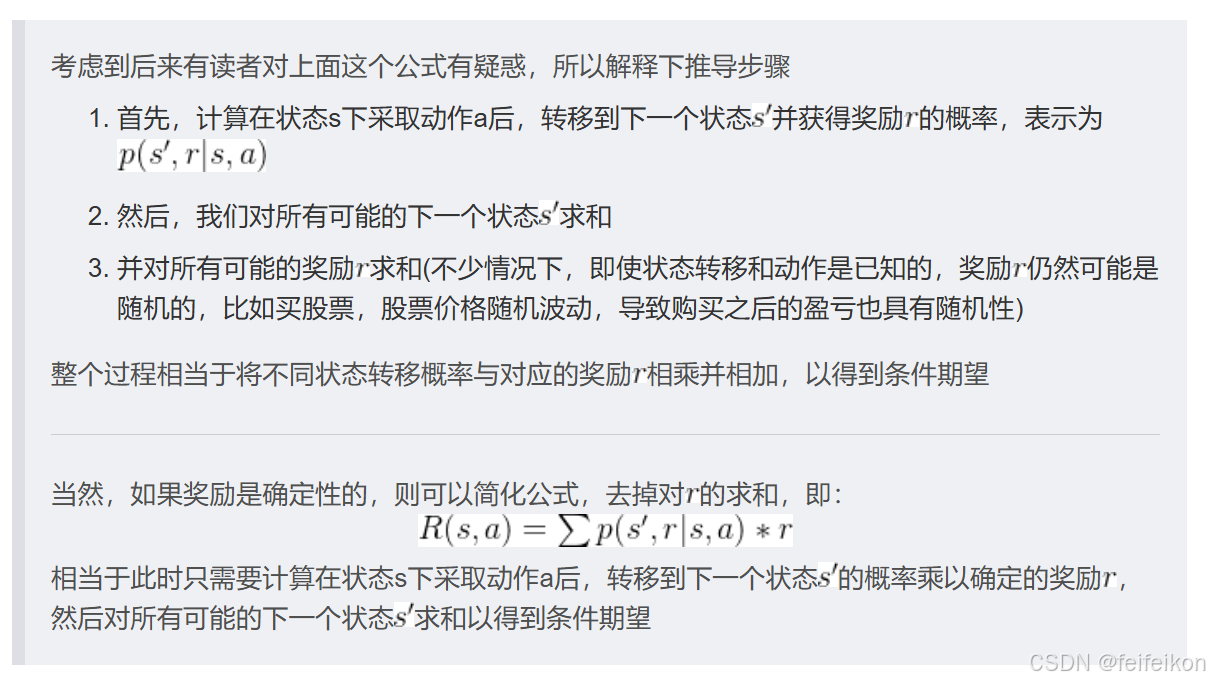
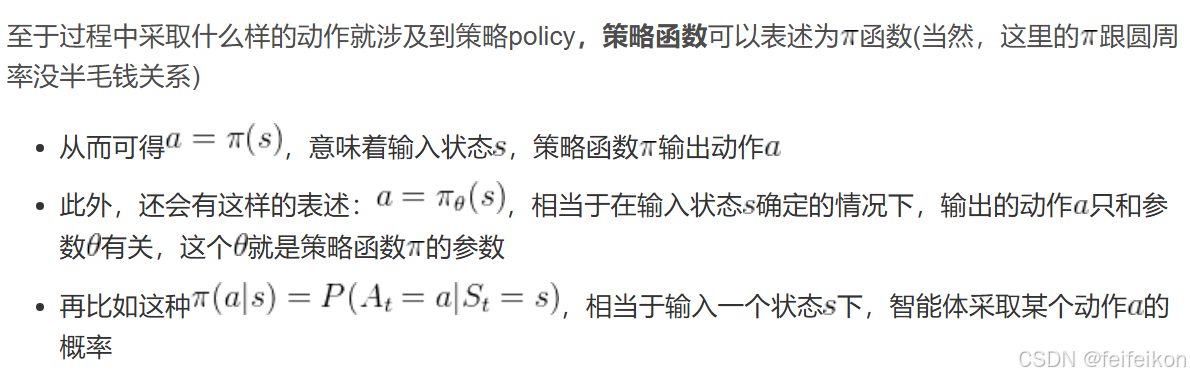
通过上文,我们已经知道不同状态出现的概率不一样(比如今天是晴天,那明天是晴天,还是雨天、阴天不一定),同一状态下执行不同动作的概率也不一样(比如即便在天气预报预测明天大概率是天晴的情况下,你大概率不会带伞,但依然不排除你可能会防止突然下雨而带伞)
而有了动作这个因素之后,我们重新梳理下价值函数
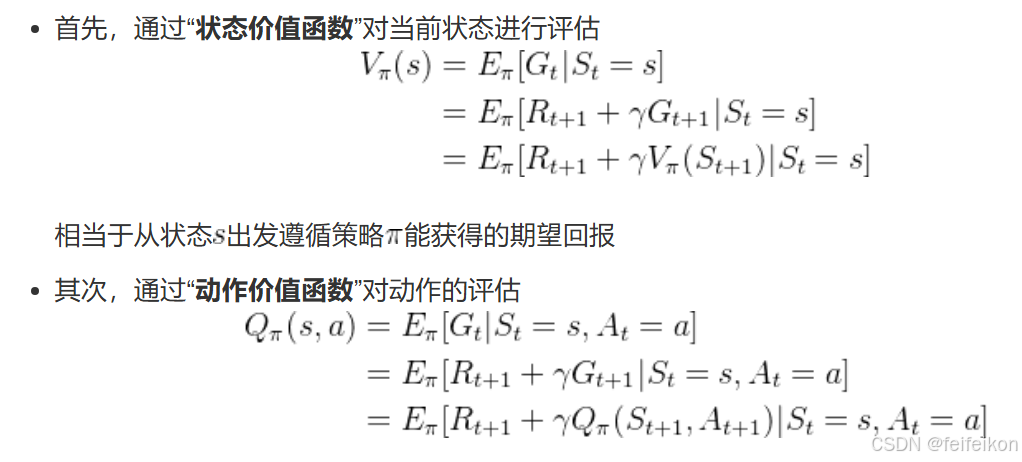 相当于对当前状态
依据策略
执行动作
得到的期望回报,这就是大名鼎鼎的
函数,得到
函数后,进入某个状态要采取的最优动作便可以通过
函数得到
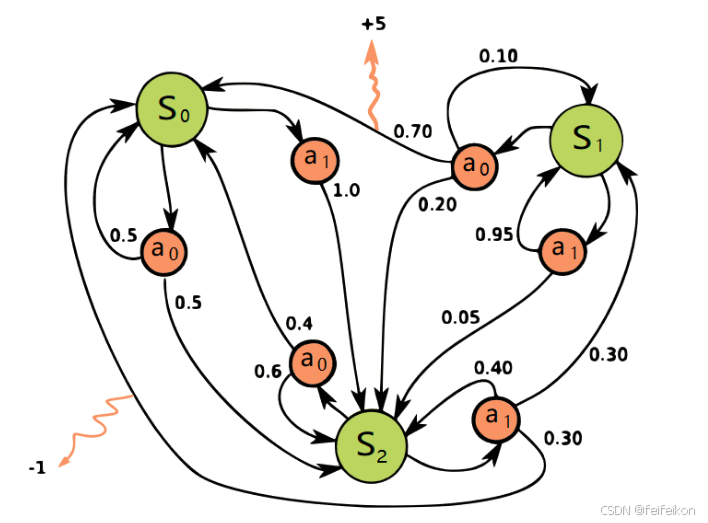
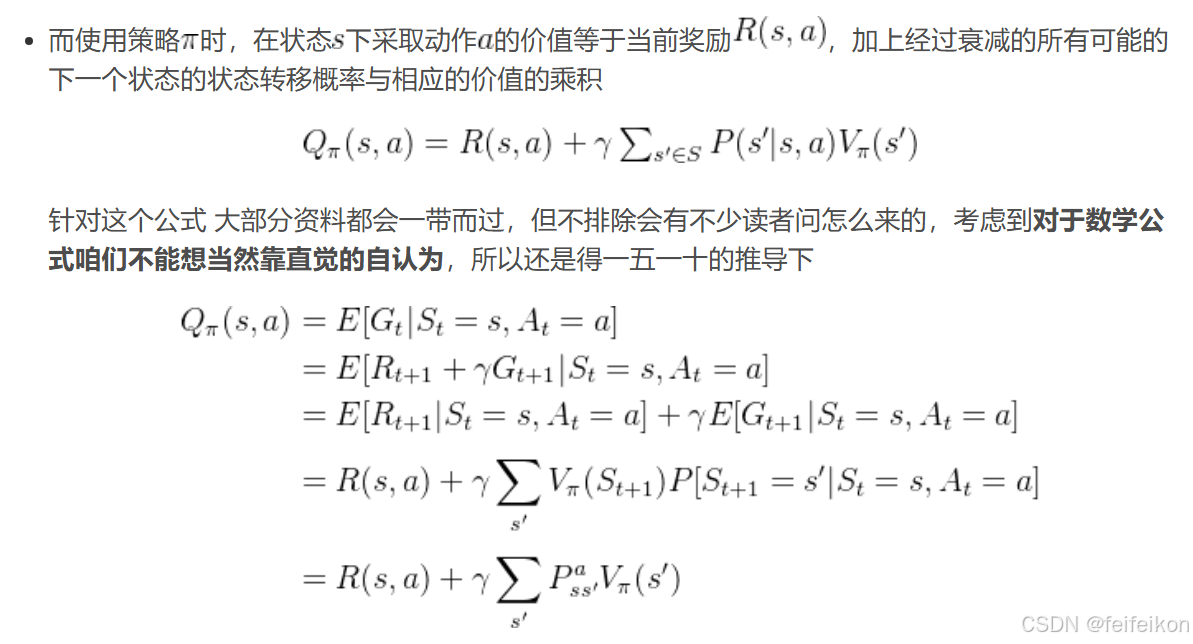
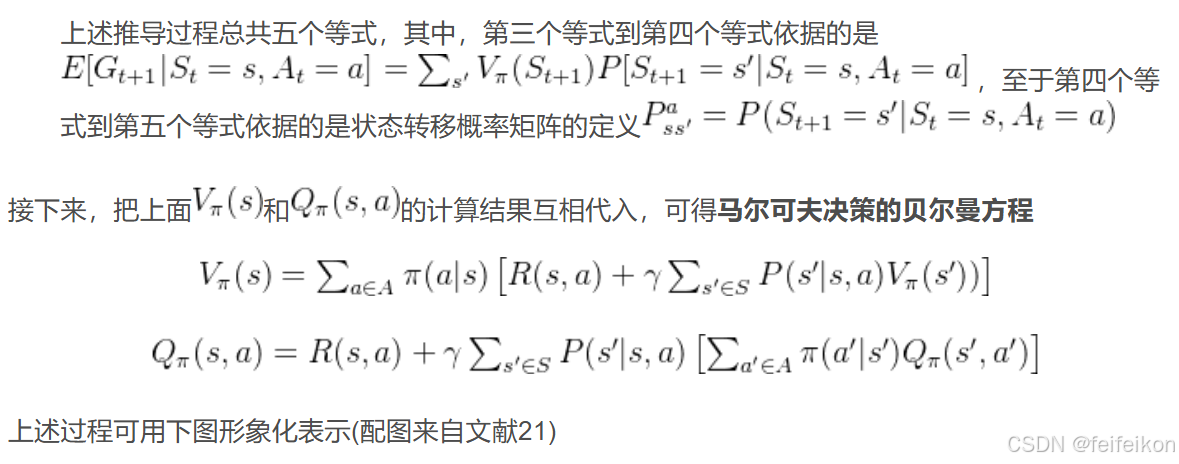
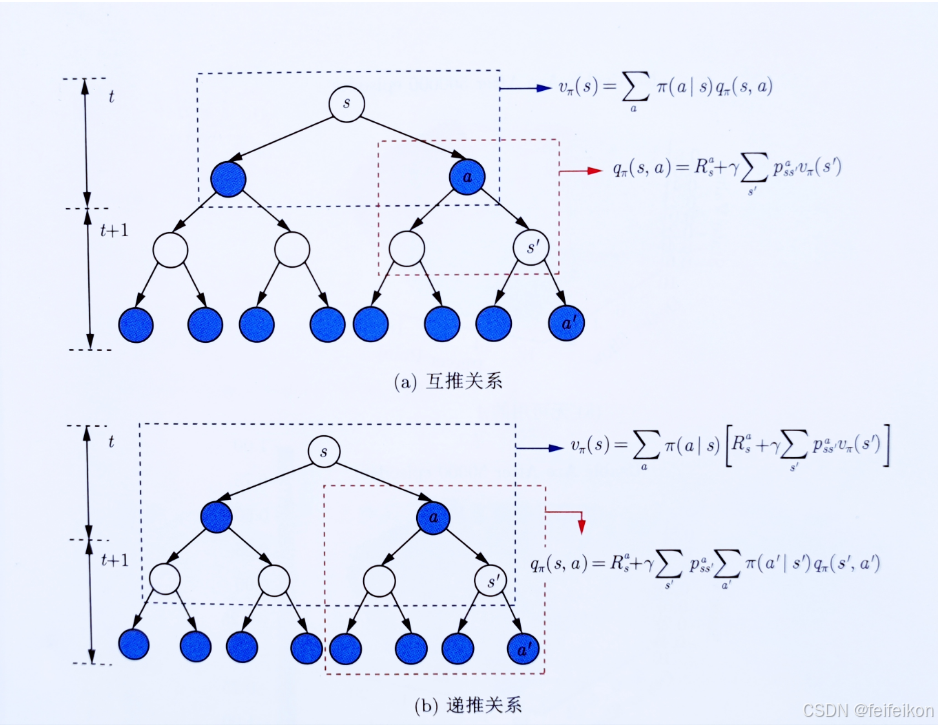
当有了策略、价值函数和模型3个组成部分后,就形成了一个马尔可夫决策过程(Markov decision process)。如下图所示,这个决策过程可视化了状态之间的转移以及采取的动作
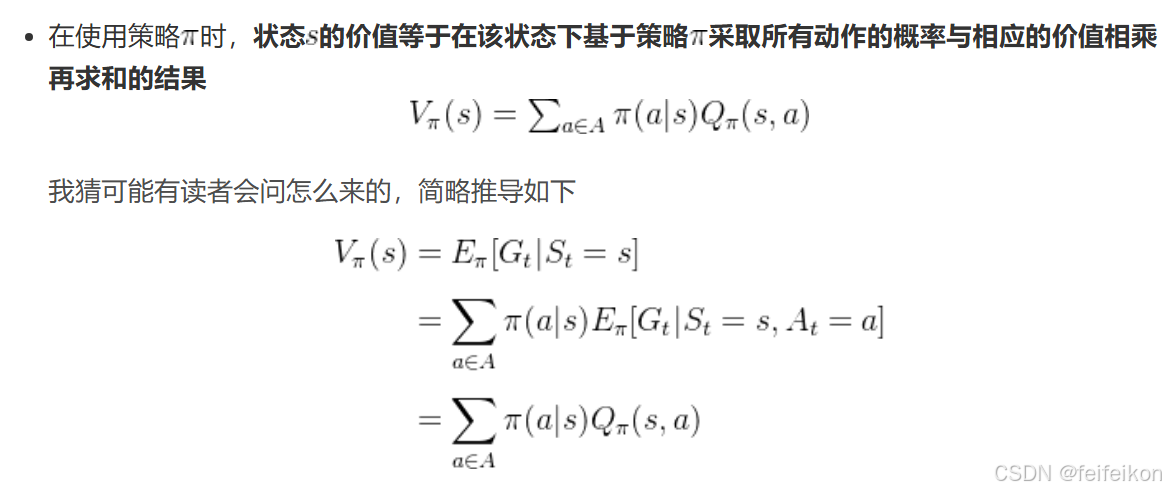
且通过状态转移概率分布,我们可以揭示状态价值函数和动作价值函数之间的联系了

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 3
 0
- 0


 已为社区贡献7条内容

所有评论(0)