Python 深度学习实战:有关神经网络建模、强化学习与迁移学习的解决方案【1.1】
1.11 用 CNTK 实现高性能模型
微软公司不久前推出了开源深度学习框架:微软认知工具包,这个框架称为 CNTK。由于性能的原因, CNTK 是用 C ++ 语言编写的,并且有一个 Python API。 CNTK 支持单GPU 和多 GPU 的使用。
如何去做…
1)首先,用 pip 安装 CNTK,如下所示:
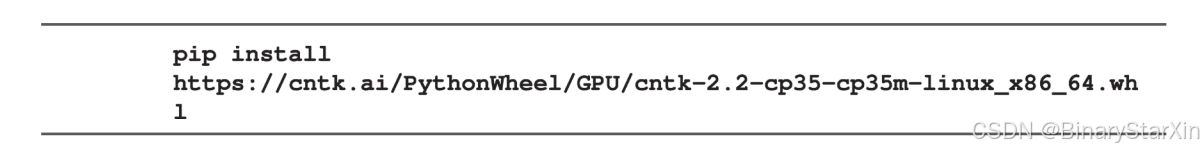
若 有 必 要, 调 整 磁 盘 文 件 ( 参 阅 https : //docs.microsoft.com/en-us/ cognitive-toolkit/ Setup-Linux-Python?tabs=cntkpy22)。
2)安装完 CNTK 后,可以将它导入到 Python 环境中:
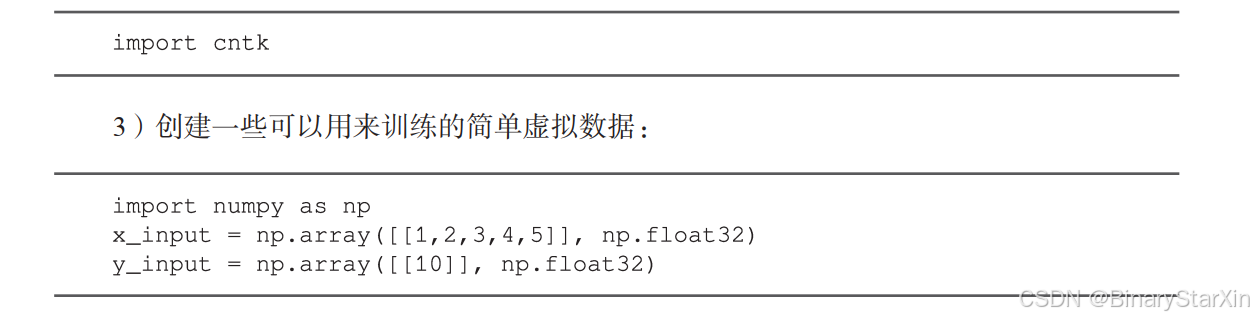
4)接下来,需要为输入数据定义占位符: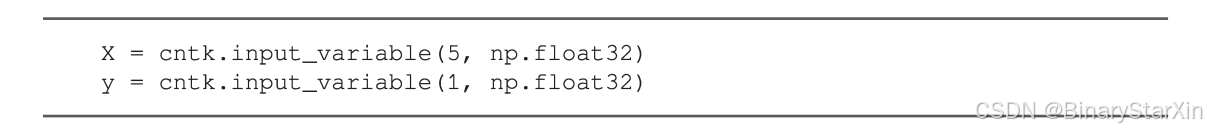
5)使用 CNTK,可以直接堆叠多个层。在一个输出层上堆叠了一个带有 32 个输入的密集层,并带有 1 个输出神经元: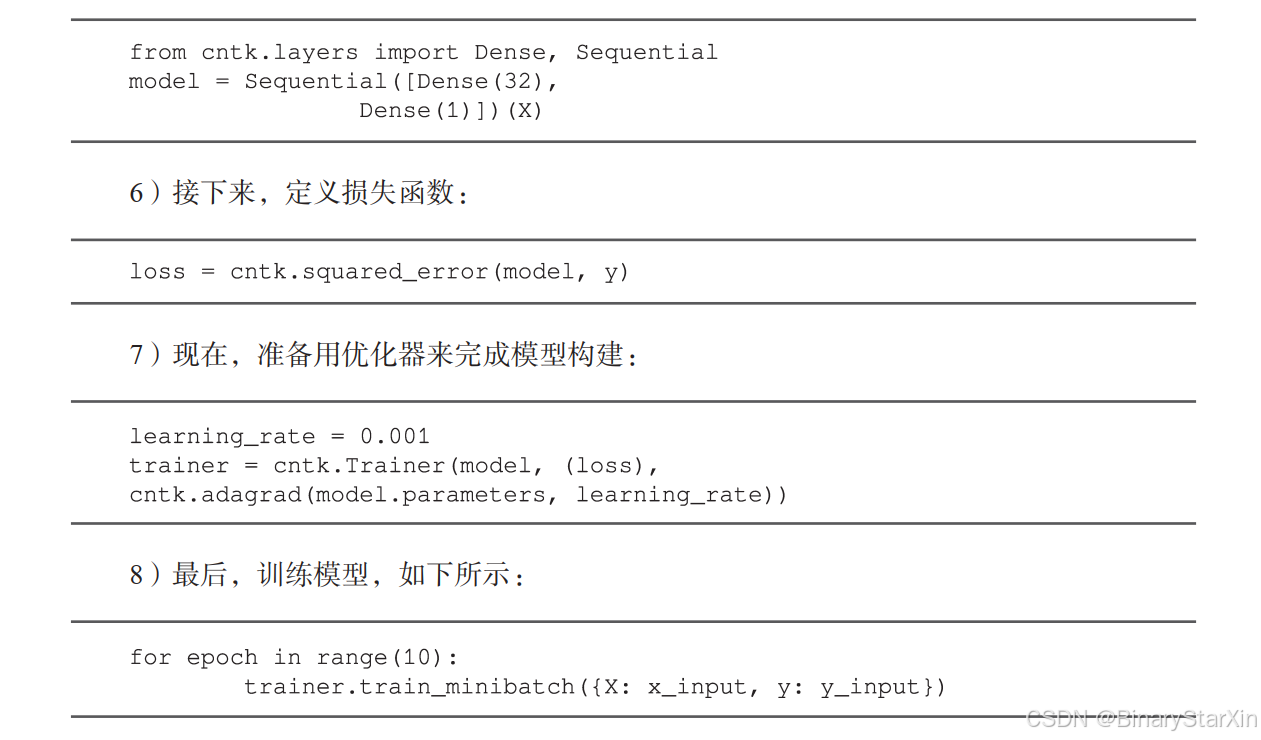
正如在此介绍中已经展示的那样,用适当的高级封装来建立 CNTK 模型是很简单的。但是,就像 TensorFlow 和 PyTorch 一样,可以选择更细化的级别来实现模型,这给了读者很大的自由度。
1.12 使用 MXNet 构建高效的模型
MXNet 深度学习框架允许使用 Python 构建高效的深度学习模型。除了 Python,它还允许使用 R、 Scala 和 Julia 等流行语言构建模型。亚马逊和百度等公司都支持 Apache MXNet。MXNet 已被证明是快速的基准框架之一,它支持对单 GPU 和多 GPU 的使用。通过使用简单评估, MXNet 能够并行自动执行操作。此外, MXNet 框架使用符号界面,称为 Symbol,这简化了构建神经网络体系结构。
如何去做…
1)在支持 GPU 的 Ubuntu 上安装 MXNet,可以在终端中使用以下命令:

对于其他平台和非 GPU 支持,请查看 https : //mxnet. incubator.apache.org/get_started/ install.html。
2)接下来,在 Python 环境中导入 mxnet:
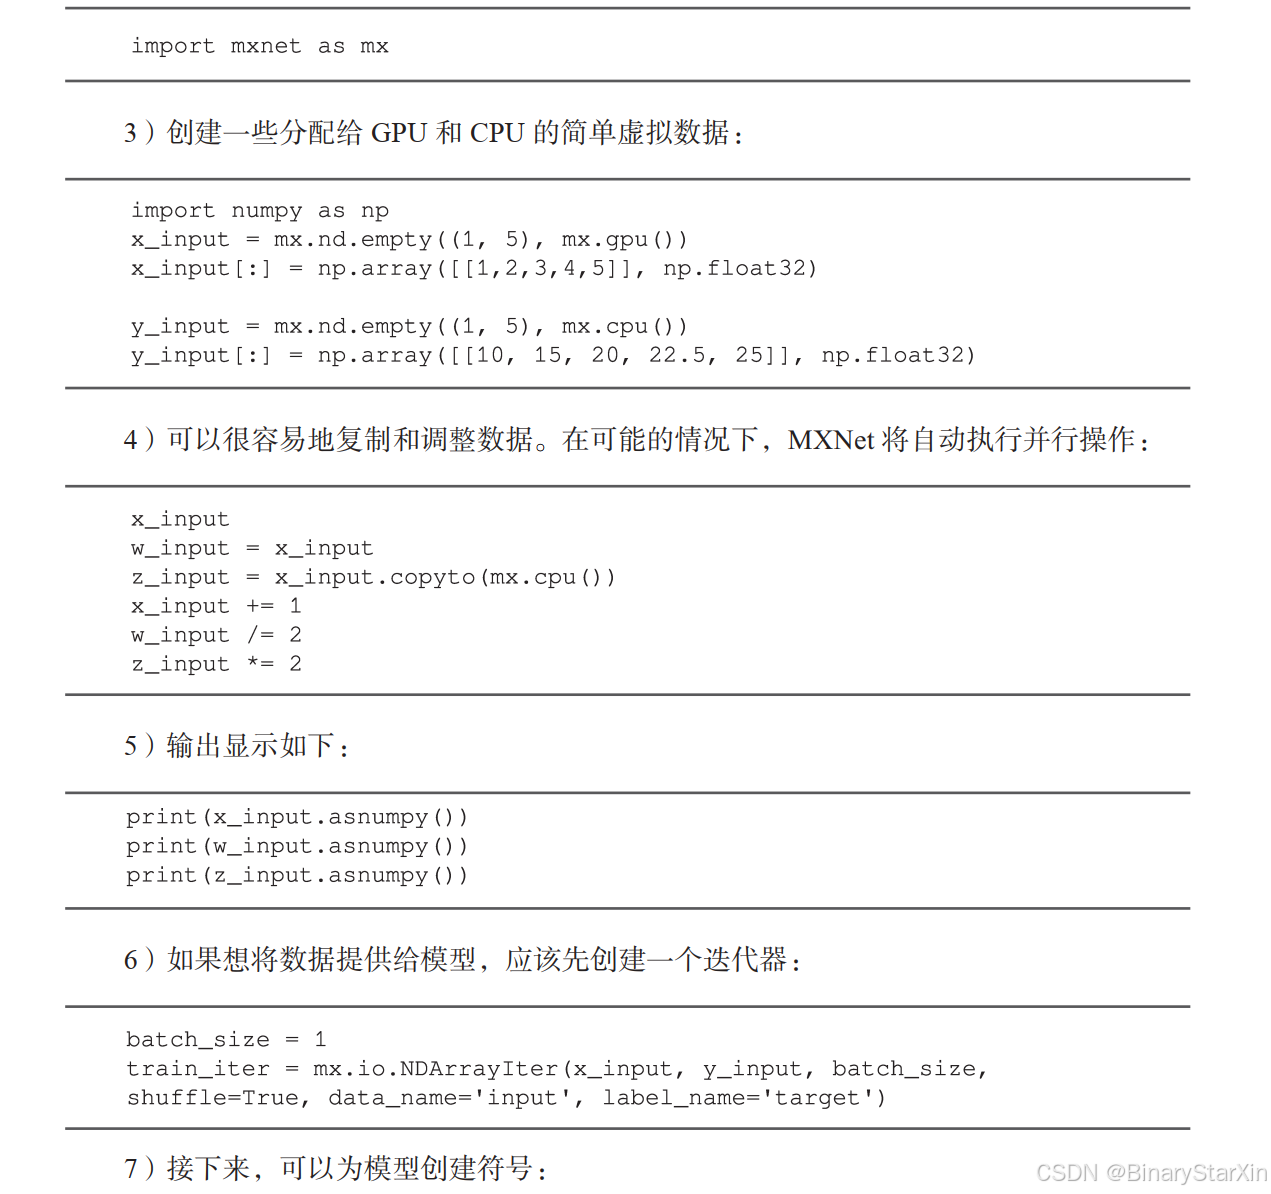
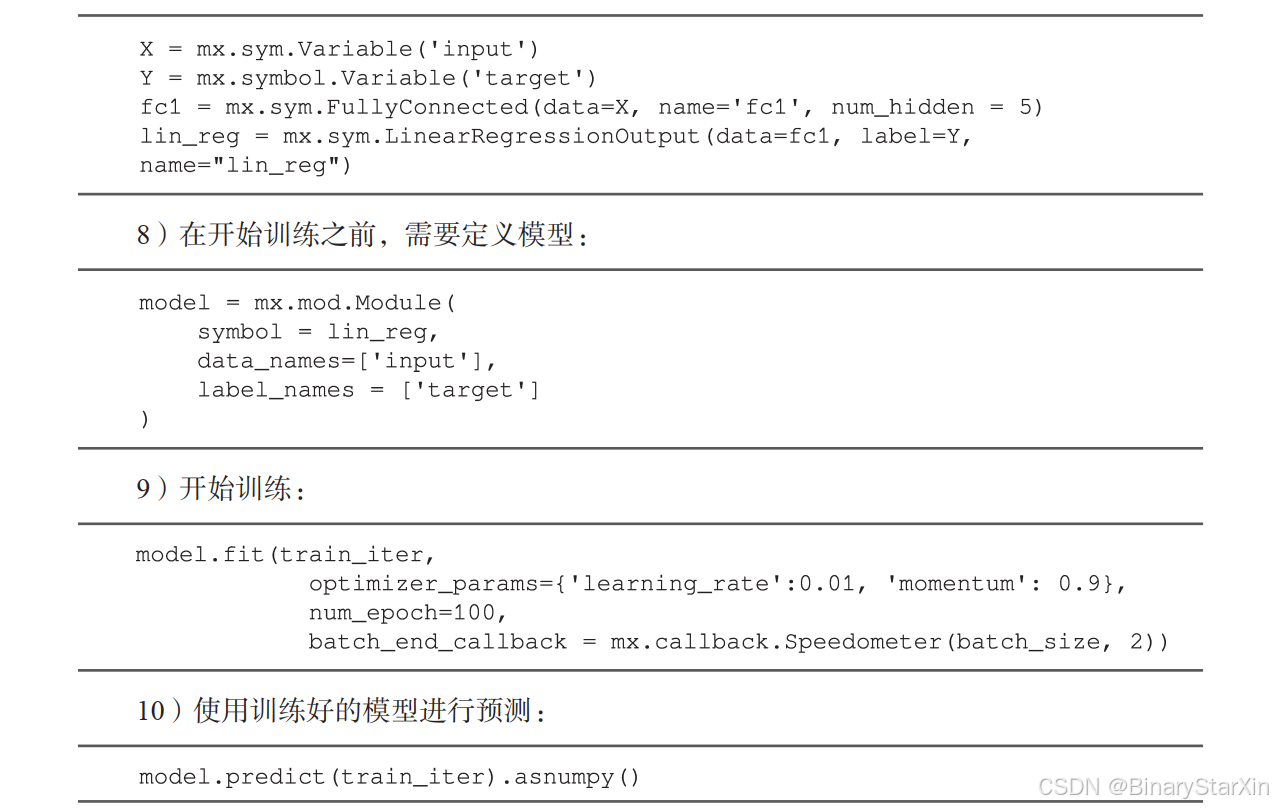
这里简短地介绍了 MXNet 框架。在这个介绍中,演示了如何轻松地将变量和计算分配给 CPU 或 GPU 以及如何使用 Symbol 接口。但是,还有很多需要探索的内容, MXNet 是构建灵活、高效的深度学习模型的强大框架。
1.13 使用简单、高效的 Gluon 编码定义网络
Gluon 是使用广泛的深度学习框架的最新成员。 Gluon 最近由 AWS 和微软公司推出,提供了简单、易于理解的代码,而不会损失性能。 Gluon 已经包含在 MXNet 的最新版本中,将在未来版本的 CNTK(和其他框架)中提供。就像 Keras 一样, Gluon 是其他许多深度学习框架的一个封装。 Keras 和 Gluon 的主要区别在于, Gluon 首先将重点放在命令框架上。
如何去做…
1) Gluon 包含在最新版本的 MXNet 中(按照使用 MXNet 构建高效模型的步骤来安装MXNet)。
2)安装完成后,可以直接输入 gluon 如下:

3)接下来,创建一些虚拟数据。为此,需要将数据载入 MXNet 的 NDArray 或 Symbol 中:
importmxnetas mX
import numpy as np
x input =mx.nd.empty((1,5),mx.gpu())x_input[:]np.array([[1,2,3,4,5]],np.float32)
y_input =mx.nd.empty((1,5),mx.gpu())y_input[:]=np.array([[10,15,20,22.5,25]],np.float32)
4)使用 Gluon,通过叠加层建立神经网络非常简单:
net = qluon.nn.Sequential()with net.name scope():
net.add(qluon.nn.Dense(16,activation="relu"))net.add(gluon.nn.Dense(len(yinput)))
5)接下来,初始化参数,将参数存储在 GPU 上,如下所示:
net.collect_params().initialize(mx.init.Normal(),ctx=mx.gpu())
6)用下面的代码设置损失函数和优化器
softmax cross entropygluon.loss.SoftmaxCrossEntropyLoss()trainer =qluon.Trainer(net.collect params()adam'{'learning rate':.1})
7)开始训练或建模
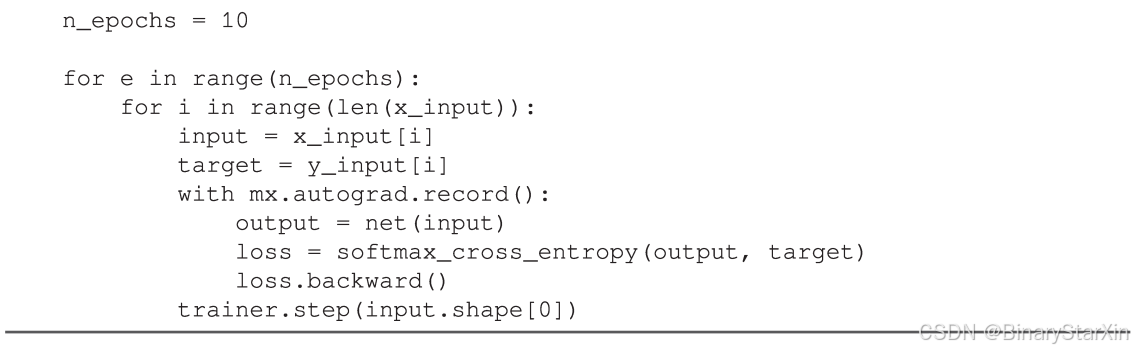
这里简短演示了如何使用 Gluon 实现神经网络架构。 Gluon 是一个功能强大的扩展应用,可以用简捷的代码来实现深度学习架构。同时,使用 Gluon 几乎没有性能损失。
第 2 章前馈神经网络
在本章中,将实现前馈神经网络( FNN) 并讨论深度学习的基石:
• 理解感知器;
• 实现一个单层神经网络;
• 构建一个多层神经网络;
• 开始使用激活函数;
• 关于隐层和隐层神经元的实验;
• 实现一个自动编码器;
• 调整损失函数;
• 测试不同的优化器;
• 使用正则化技术提高泛化能力;
• 添加 Dropout 以防止过拟合。
2.1 简介
本章的重点是为 FNN 和其他网络拓扑的常见实现问题提供解决方案。本章讨论的技术也适用于后续内容。
FNN 是信息只向一个方向移动而不循环的网络(正如在第 4 章 递归神经网络 中看到的)。 FNN 主要用于监督学习,其中数据不是顺序或时间依赖的,例如用于一般分类和回归任务。首先介绍感知器,然后介绍如何使用 NumPy 实现感知器。感知器展现了单一神经元的工作机制。接下来,通过增加神经元数量来增加复杂性,并引入单层和多层神经网络。大数量神经元和多层次网络,增加了结构的深度,也符合深度学习这个名字。
2.2 理解感知器
首先,需要了解神经网络的基础知识。神经网络由一层或多层神经元组成,以人脑中的生物神经元命名。通过实现感知器来演示单个神经元的工作机理。在感知器中,单个神经元执行所有的计算,之后扩大神经元的数量来创建深度神经网络,如图 2.1 所示。
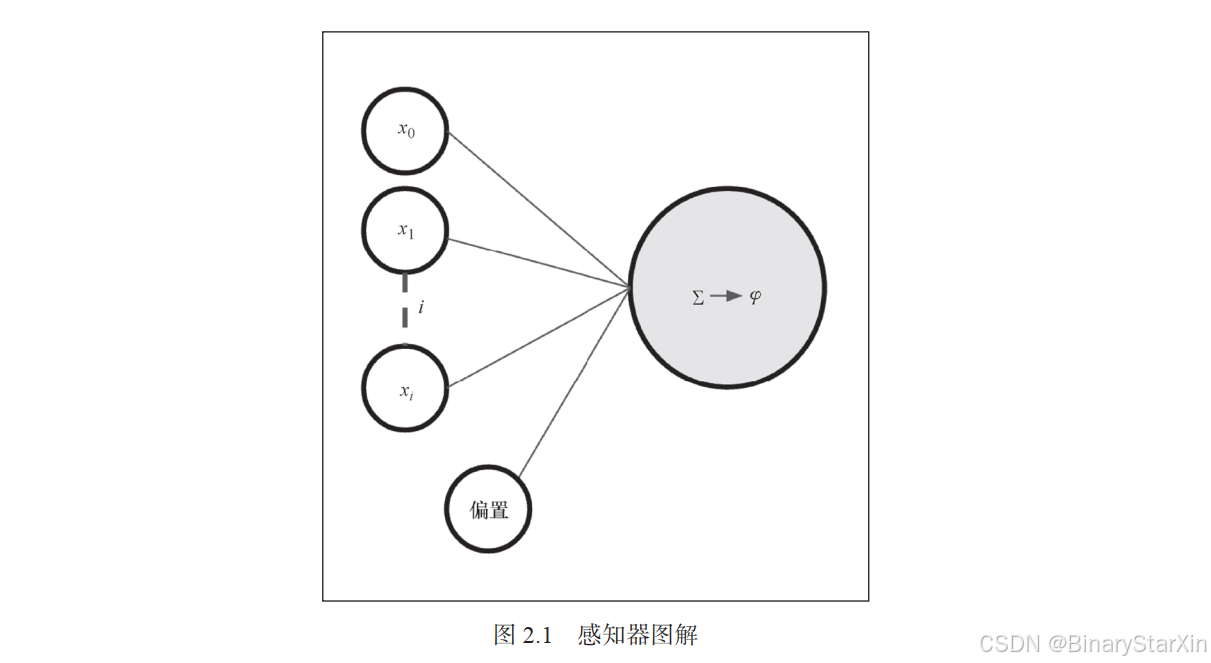
感知器可以有多个输入。在这些输入上,神经元执行计算并输出单个值,例如对两个类别进行分类的二进制值。该神经元执行的计算是输入和权重的简单矩阵乘法。将得到的值加起来并添加一个偏置,如下:
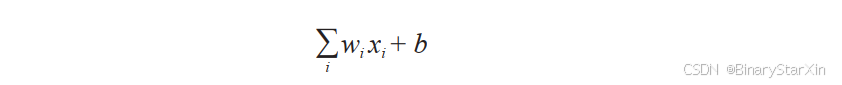
这些计算可以很容易地扩展到高维输入。激活函数 φ( x)确定正向传递中感知器的最终输出: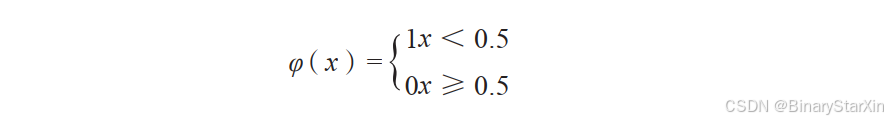
权重和偏置随机初始化。在每个周期(对训练数据迭代)之后,基于网络输出与期望输出之间的误差值乘以学习率来更新权重。因此,网络训练将按新权重施加到训练数据上( 反向传播阶段),并且输出的精度会提高。感知器是在训练数据上优化的线性组合。作为一个激活函数,将使用一个单位阶跃函数:如果输出超过一定的阈值将被激活(因此,成为一个 0 与 1 的二进制分类器)。如果这些类是线性可分,感知器就能够以 100%的精度对模式进行分类。在下一个方案中,将向读者展示如何用 NumPy 实现感知器。
如何去做…
1)导入函数库和数据集,如下:
import numpy as np
from sklearn.model selection import train test_splitimport matplotlib.pyplot as plt
#使用Iris植物数据库
from sklearn.datasets import load iris
SEED =2017
2)首先,将导人的数据进行分组,如下所示:
#Iris数据库中的前两类线性可分(Iris-Setosa和Iris-Versicolour)
iris = load iris()
idxs = np.where(iris.target<2)
X= iris.datalidxs]
y = iris.target[idxs]
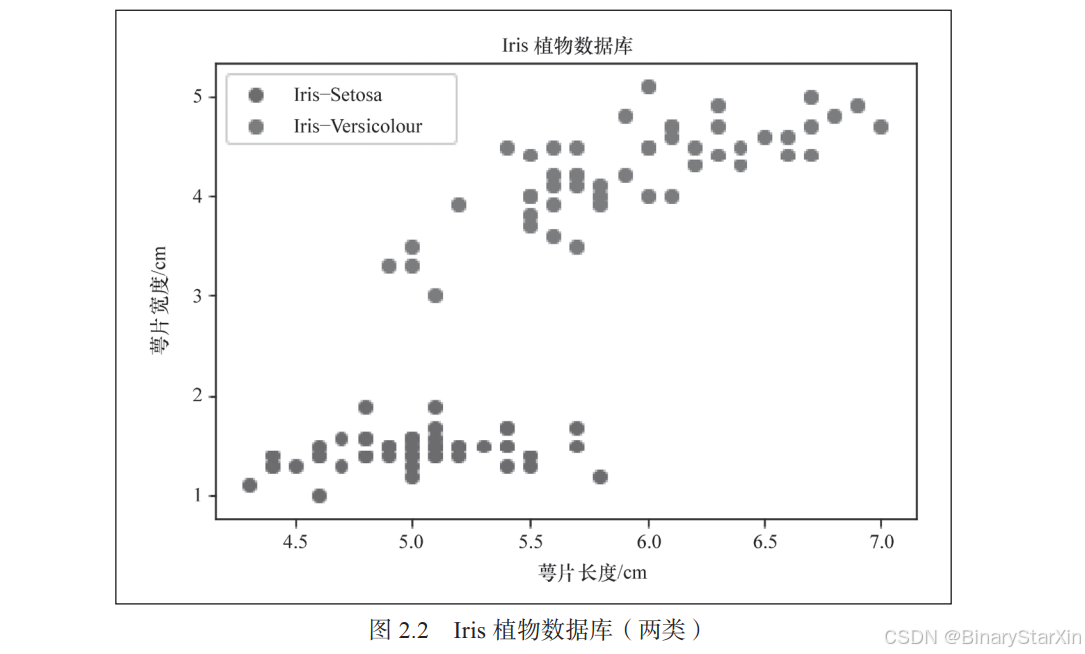
3)用下面的代码片断绘制四个变量中两个变量的数据展示:
plt.scatter(X[Y==0][:,0],X[Y==0][:,2],color='green', label='IrisSetosa')
plt.scatter(X[Y==1][:,0],X[Y==1][:,2],color='red',label='Iris-Versicolour')
plt.title(Iris Plants Database')
plt.xlabel('sepal length in cm')
plt.ylabel('sepal width in cm')
plt.legend()
plt.show()
在图 2.2 中,绘制了两个类的分布:
4)为了验证结果,将数据分成如下的训练集和测试集:
Xtrain,Xval,ytrain,yval=train test_split(X,ytest size=0.2,random state=SEED)
5)接下来,初始化感知器的权重和偏置:
weights = np.random.normal(size=X train.shape[1])bias =1
6)在训练之前,需要定义超参数:
learning_rate=0.1n_epochs =15
7)现在,开始用 for 循环来训练感知器:
del w=np.zeros(weights.shape)hist loss=[1hist accuracy=[]
i in range(n epochs):for#使用阶跃函数,若输出>0.5,预测结果为1,否则为0output =np.where((Xtrain.dot(weights)+bias)>0.5,1,0)
#ぜ慰穫横弊算濺棛甡撬棣禄跛痴SE
error =np.mean((y train-output)**2)
#更新权值与偏置
weights-= learning rate *np.dot((output-y train),X train)bias += learning rate *np.sum(np.dot((output-y train),X train))
#计算MSE
y_train)** 2)loss =np.mean((outputhist loss.append(loss)
#确定验证精度
output val=np.where(X val.dot(weights)>0.5,10)accuracy =np.mean(np.where(y val==output val,1,0))hist accuracy.append(accuracy)
8)保存训练损失值和验证精度,以便可以绘图呈现:
fig =plt.figure(figsize=(8,4))
a = fig.add subplot(121)
imgplot =plt.plot(hist loss)plt.xlabel('epochs')a.set title(Training loss')
a=fig.add subplot(122)imgplot = plt.plot(hist accuracy)plt.xlabel('epochs')
a.set title('Validation Accuracy')
plt.show()
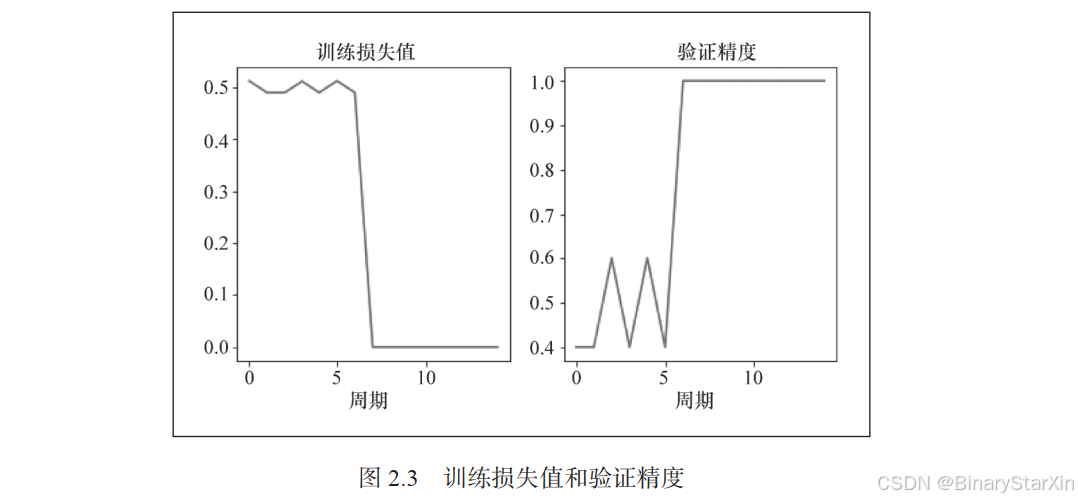
在图 2.3 中,显示了由此产生的训练损失值和验证精度
2.3 实现一个单层神经网络
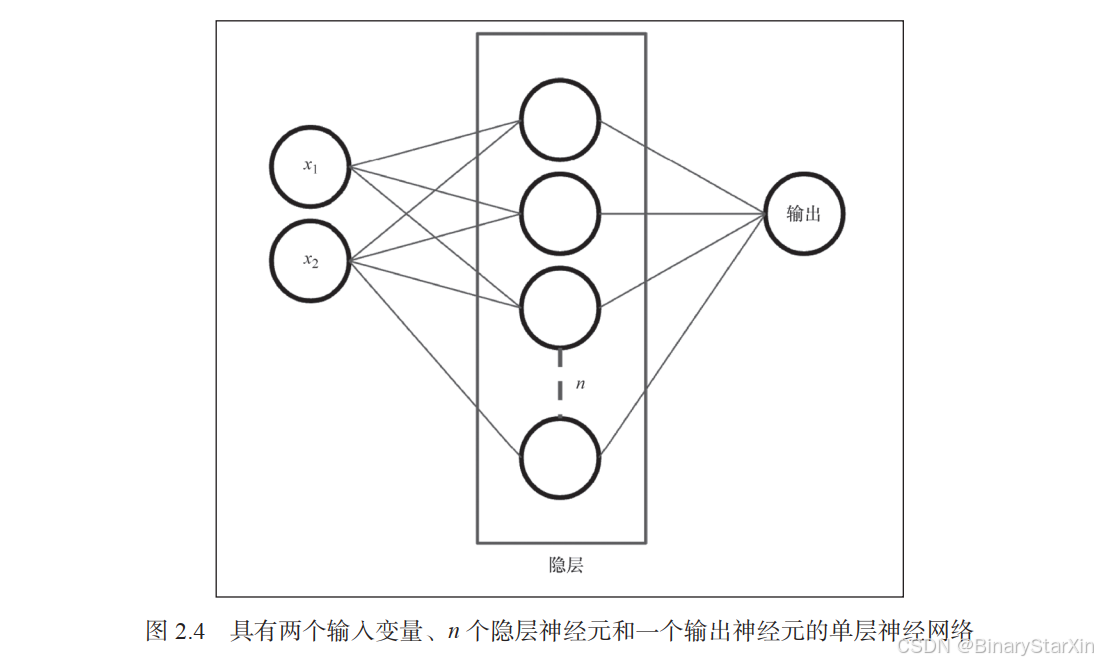
现在可以转向神经网络,从实现最简单的神经网络形式开始:单层神经网络。它与感知器的区别在于计算过程是由多个神经元完成的,因此构成一个网络。正如所期望的那样,增加更多的神经元会增加可解决问题的难度。这些神经元分别执行它们的计算并堆叠在一个层中,这个层称为隐层。所以,在该层堆叠的神经元称为隐层神经元。现在,只考虑单个隐层。输出层表现为感知器。这一次,作为输入,在隐层中的神经元为隐层神经元而不是输入变量,如图 2.4 所示。
在感知器的实现中,使用了单位阶跃函数来确定类别。在下一个方案中,将对隐层神经元和输出函数使用一个非线性激活函数 sigmoid。通过用非线性激活函数代替阶跃函数,网络也将能够发现非线性模式。稍后在“激活函数” 一节中将进一步介绍。在后向传递中,使用 sigmoid 函数的导数来更新权重。
在下面的方案中,将用 NumPy 对两个非线性可分的类进行分类。
如何去做…
1)导人函数库和数据集:
import numpyasnp
from sklearn.model selection import train test split
import matplotlib.pyplot as plt
#使用scikit-learn中的make circles 函数
from sklearn.datasetsimportmake circles
SEED =2017
2)首先,创建训练数据,
#创建内圈及外圈
X,y=make circles(n samples=400,factor=.3,noise=.05random state=2017)0outer=y二>7inner=y==
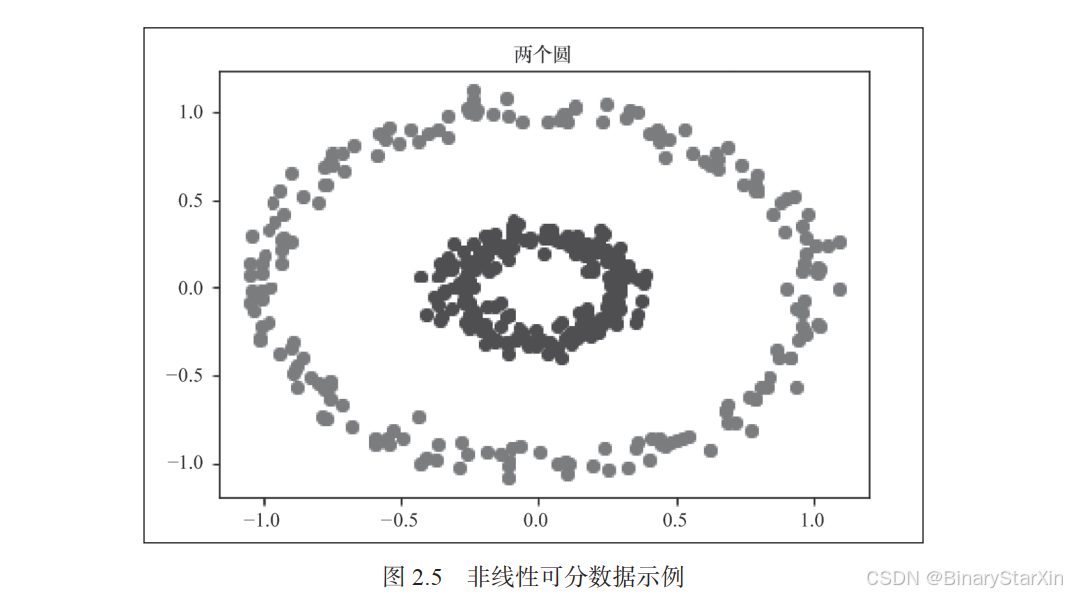
3)绘制数据的分布来显示两个类,
plt.title("Two Circles")
plt.plot(X[outer,0],X[outer,1],"rO")"bo")plt.plot(X[inner,0l,X[inner,1]plt.show()
非线性可分数据示例如图 2.5 所示。
4)标准化数据,以确保两个圆的中心是(1.1):
X= X+1
5)为了确定算法的性能,对数据进行分割:
Xtrain,Xval,ytrain,y_val=train_test_split(X,ytest size=0.2,random state=SEED)
6)线性激活函数在这种情况下不起作用,所以使用 sigmoid 函数:
def siqmoid(x):
return 1/(1 +np.exp(-x))
7)接下来,定义超参数:
nhidden=50#隐层神经元数目nepochs =1000learning_rate=1
8)初始化权重和其他变量:
#初始化权值
weights hidden =np.random.normal(0.0,size=(X train.shape[1]
n hidden))
weights output =np.random.normal(0.0,size=(n hidden))
hist loss =[]
hist_accuracy=[]
9)运行单层神经网络并输出统计信息: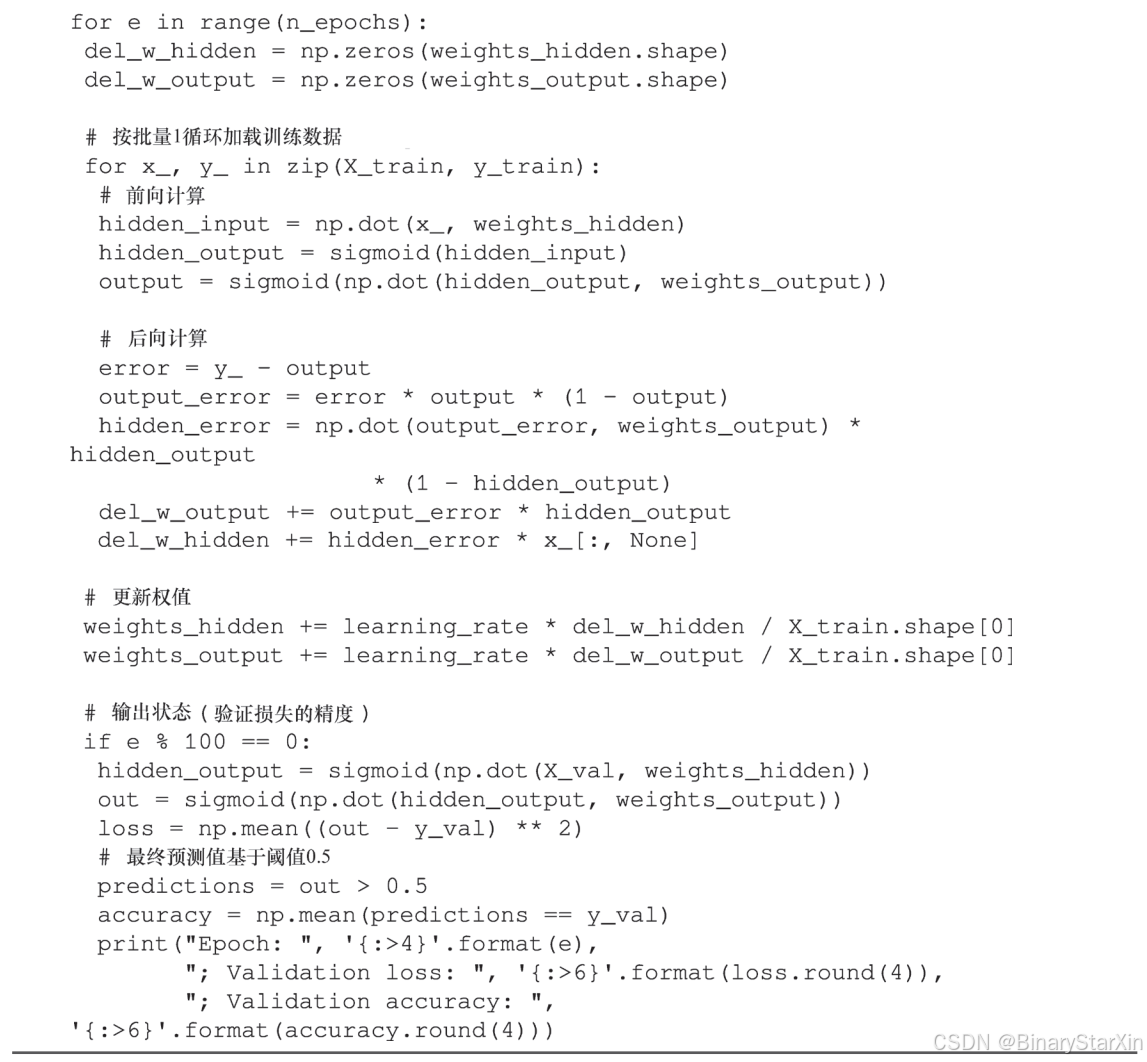
在图 2.6 中,显示了训练期间的输出结果: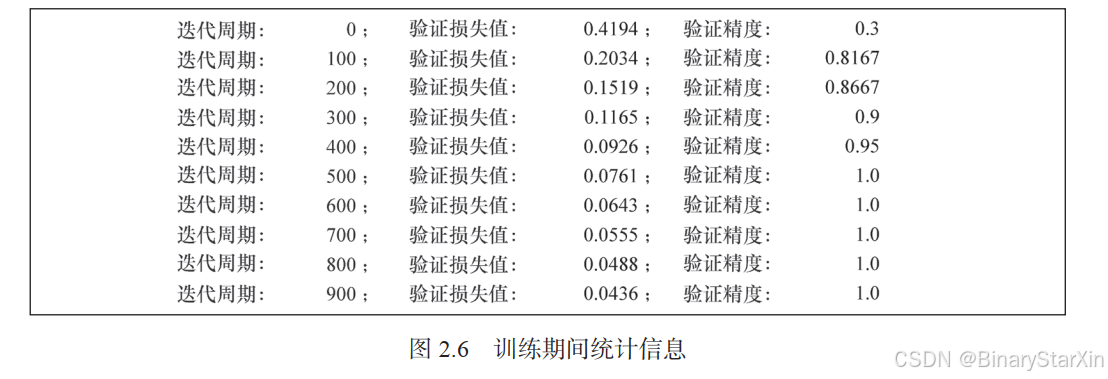

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 19
 0
- 0


 已为社区贡献4条内容

所有评论(0)