LangGraph 下一代 公司:0 基础开发多智能体员工,打造 1 人 超级 AI 公司
LangGraph 下一代 公司:0 基础开发多智能体员工,打造 1 人 超级 AI 公司
官方文档:https://langchain-ai.github.io/langgraph/tutorials/introduction/
本文版本:
-
langgraph-0.3.19
-
langchain-0.3.3
StateGraph
智能体开发的核心是,你的工作流要理清楚。
LangGraph 把将工作流程建模为 图结构:
- 节点 代表操作或步骤(如调用 LLM、访问数据库、搜索网页、反思评估、调用 DIY 工具等)
- 边 表示步骤之间的关系
当一个节点完成后,会沿着一个 或 多个边 向其他节点发信息,边告诉下一步做什么。
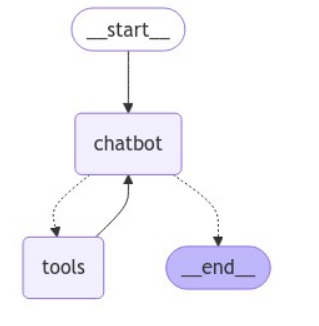
上图的边有实线边、虚线边:
- 实线边:自动触发的边
- 虚线边:满足设定才触发的边
状态图 StateGraph = 图结构 Graph (节点、边)+ 状态 State,每一个节点的运行都要接收并更新当前状态。
- 状态
State是一个数据结构,可以是任何 Python 类型,默认是TypeDict类型
StateGraph 的强大之处在于它能够表达复杂的非线性执行流程,特别适合AI应用中的多步骤推理和决策过程。
基本图结构和节点
掌握如何创建基本的 LangGraph 图结构,定义节点和连接它们。
在 LangGraph 中,一切始于 StateGraph 对象,它是你构建应用的基础:
这就像是在一张白纸上画下第一笔,你正在创建一个框架,稍后会在这个框架中添加各种功能。
注意我们使用了 TypedDict 来定义状态的结构。这不仅让代码更加清晰,也让 Python 的类型检查器能够帮助你避免错误。
它允许你:
- 定义一系列节点(代表工作流中的处理步骤)
- 建立节点之间的连接关系(简单边和条件边)
- 管理状态在节点间的传递和转换
- 执行复杂的基于条件的路由逻辑
简而言之,StateGraph使你能够创建复杂的、非线性的工作流程,特别适合需要动态决策的AI应用,如对话系统、多步骤推理、决策树等。
1. 创建基本图结构
from langgraph.graph import StateGraph
from typing import TypedDict, Annotated
# TypedDict在大型、复杂项目中的优势尤为明显,比 普通的dict 好

# 定义状态结构
class GraphState(TypedDict):
    input: str
    output: str

# 创建状态图
langgraph = StateGraph(GraphState, input=InputState, output=OutputState)
# 创建StateGraph实例,定义图的状态类型、输入和输出格式
# OverallState: 定义图内部使用的完整状态结构
# InputState: 定义外部调用图时的输入格式
# OutputState: 定义图执行完成后的输出格式
参数说明:
state_type:状态的类型或结构,通常是TypedDict或Pydantic模型input:(可选) 输入状态的类型output:(可选) 输出状态的类型channels:(可选) 定义状态中的哪些键应该被视为通道
2. 添加节点
节点是图中执行实际工作的部分。
每个节点都是一个函数,接收当前状态并返回更新:
def greeting_node(state: GraphState) -> dict:
    """一个简单的问候节点"""
    user_input = state["input"]
    return {"output": f"你好!你说的是:{user_input}"}

# 将节点添加到图中
graph.add_node("greeting", greeting_node)
想象节点就像是流水线上的工作站,每个工作站负责特定的任务。
在这个例子中,greeting_node 接收用户输入并生成一个问候语。
每个节点函数应接收当前状态并返回状态更新。
3. 添加简单边
定义了节点后,需要指定它们之间的连接。
这就像是在节点之间画箭头,告诉系统数据应该如何流动。
set_entry_point 定义了图的起点,而 add_edge 则指定了从一个节点到另一个节点的路径。
# 设置入口节点
graph.set_entry_point("greeting")

# 如果有多个节点,可以这样连接
graph.add_node("response", response_node)

graph.add_edge("greeting", "response")

langgraph.add_edge("answer_reasoning", END)
# END: 特殊常量,表示图的结束点
4. 添加条件边
条件边允许你根据当前状态动态决定数据应该流向哪个节点,实现智能路由。
基本用法分为两步:
- 定义路由函数:一个接收状态并返回路由决策的函数
- 添加条件边:使用 add_conditional_edges 方法连接节点
# 定义条件路由函数,基于路由分流
def complex_router(state: dict):
    # 根据输入,分流到不同节点做事
    text_length = len(state["content"])
    # 根据返回值,系统查找映射字典中的对应关系
    if text_length < 10:
        return "short"
    elif text_length < 50:
        return "medium"
    else:
        return "long"

# 添加条件边
graph.add_conditional_edges(
    "input_processor",
    # 当 input_processor 节点处理完成后,调用 complex_router 函数
    complex_router,
    {
        "short": "short_handler",
        "medium": "medium_handler",
        "long": "long_handler"
    }
)
参数说明:
node:源节点名称condition:条件函数,该函数接收状态并返回下一个节点的名称default_node:(可选) 当条件函数未返回匹配节点时的默认节点
5. 编译图
# 编译图:将定义好的图结构转换为可执行的形式
# 编译后的图才能被invoke方法调用
langgraph = langgraph.compile()
6. 执行图
编译步骤将你定义的逻辑转换为可执行的形式,就像是将蓝图变成实际的建筑。
# 执行图:传入符合InputState格式的问题,开始执行整个工作流
# 返回符合OutputState格式的结果
result = langgraph.invoke({"question": "李白作了多少首诗?"})
参数说明:
input:符合图的输入状态类型的数据
返回符合图的输出状态类型的结果。
7. 可视化图结构
# 可视化图结构:生成并显示图的Mermaid格式可视化图像
# 用于调试和理解工作流的结构
display(Image(langgraph.get_graph().draw_mermaid_png()))
invoke 方法则启动图的执行,从入口点开始,按照定义的路径流经各个节点。
8. 创建多节点图
用户输入首先经过 process_node 处理,然后结果传递给 respond_node 生成最终输出。
from langgraph.graph import StateGraph
from typing import TypedDict

class ChatState(TypedDict):
    input: str
    intermediate: str
    output: str

# 创建图
graph = StateGraph(ChatState)

# 定义节点
def process_node(state: ChatState) -> dict:
    return {"intermediate": f"处理: {state['input']}"}

def respond_node(state: ChatState) -> dict:
    return {"output": f"响应: {state['intermediate']}"}

# 添加节点
graph.add_node("process", process_node)
graph.add_node("respond", respond_node)

# 连接节点
graph.set_entry_point("process")
graph.add_edge("process", "respond")

# 编译和运行
compiled_graph = graph.compile()
result = compiled_graph.invoke({"input": "如何使用 LangGraph?"})
print(result)  # 包含完整的状态
输出:
{'input': '如何使用 LangGraph?', 'intermediate': '处理: 如何使用 LangGraph?', 'output': '响应: 处理: 如何使用 LangGraph?'}
实践检测题(由易到难)
- 在 LangGraph 中,什么是状态图(StateGraph)?
- 如何在 LangGraph 中定义状态结构?
- 编写一个简单的节点函数,它接收状态并返回更新。
- 如何将节点添加到图中?使用什么方法?
- 什么是图的入口点?如何设置它?
- 如何定义节点之间的连接?
- 在运行图之前为什么需要编译它?
- 创建一个包含三个节点的图,分别负责处理输入、分析内容和生成回复。
- 如何确保图中的数据流动符合你的期望?设计一个简单的测试方法。
- 设计一个更复杂的图,包含条件分支,根据输入内容选择不同的处理路径。
状态管理
深入理解 LangGraph 中的状态管理,学习如何有效地定义、更新和利用状态。
在 LangGraph 中,状态是整个图执行过程中传递的数据。
它就像是一个包裹,从一个节点传递到另一个节点,逐渐被丰富和更新。
想象你正在进行一场对话:每次交流都基于之前的对话内容。
状态就像是这个对话的记忆,它保存了所有重要的信息,让整个过程连贯有序。
定义结构化状态
使用 TypedDict 或 Pydantic 模型来定义状态结构,这样可以获得更好的类型提示和错误检查:
from typing import TypedDict, List

# 使用 TypedDict
class ConversationState(TypedDict):
    history: List[str]
    current_input: str
    response: str
    context: dict

# 创建图
from langgraph.graph import StateGraph
graph = StateGraph(ConversationState)
这就像是为数据创建一个模板,确保所有节点都知道它们可以期望哪些数据字段,以及每个字段的类型。
状态更新模式
在 LangGraph 中,节点可以通过两种方式更新状态:
返回部分更新:只返回需要更改的字段
def process_input(state: ConversationState) -> dict:
    # 只更新 response 字段
    return {"response": f"处理了: {state['current_input']}"}
返回完整状态:返回整个更新后的状态(注意需要标记)
from langgraph.graph import StateGraph

def process_full_state(state: ConversationState) -> ConversationState:
    # 创建一个新的状态副本
    new_state = state.copy()
    # 更新响应
    new_state["response"] = f"处理了: {state['current_input']}"
    # 添加到历史
    new_state["history"].append(state["current_input"])
    new_state["history"].append(new_state["response"])
    return new_state

# 创建图时指定节点更新整个状态
graph = StateGraph(ConversationState)
graph.add_node("process", process_full_state, update_state=True)
第一种方式更加简洁,适合只需更新少量字段的情况;第二种方式给予你更多控制权,适合需要复杂更新逻辑的场景。
想象每个节点都是一个专家,只关注自己专业领域的信息。这种方式让系统更容易理解和维护。
多状态案例
from typing import TypedDict, List, Optional

class Message(TypedDict):
    role: str
    content: str

class AgentState(TypedDict):
    messages: List[Message]
    tools_output: Optional[dict]
    final_answer: Optional[str]

# 定义更新消息历史的节点
def add_user_message(state: AgentState, user_input: str) -> dict:
    new_messages = state["messages"].copy()
    new_messages.append({"role": "user", "content": user_input})
    return {"messages": new_messages}

def add_assistant_message(state: AgentState) -> dict:
    new_messages = state["messages"].copy()
    # 创建响应(实际应用中可能调用语言模型)
    response = "这是助手的回复"
    new_messages.append({"role": "assistant", "content": response})
    return {"messages": new_messages}

# 创建图
graph = StateGraph(AgentState)
graph.add_node("add_user", add_user_message)
graph.add_node("add_assistant", add_assistant_message)
graph.set_entry_point("add_user")
graph.add_edge("add_user", "add_assistant")
实践检测题(由易到难)
- 什么是 LangGraph 中的"状态"?它在图执行中扮演什么角色?
- 如何使用 TypedDict 定义一个包含用户问题和助手回答的状态结构?
- 描述节点更新状态的两种主要方式,并说明它们各自的优缺点。
- 编写一个节点函数,它只更新状态中的 “response” 字段。
- 如何创建一个节点,使其更新整个状态而不仅仅是部分字段?
- 设计一个状态结构,用于跟踪一个多轮对话系统,包括对话历史、当前用户输入和系统响应。
- 编写一个节点,它将当前用户输入和系统响应添加到对话历史中。
- 什么是状态管理的不可变性原则?为什么它在 LangGraph 中很重要?
- 设计一个处理嵌套状态的节点,例如更新对话历史中的最后一条消息的状态。
- 创建一个完整的状态管理示例,展示如何在一个包含多个节点的图中跟踪和更新复杂状态。
节点间通信
掌握节点之间的通信机制,学习如何在 LangGraph 中传递数据和控制流。
基本通信模式
节点之间通过共享状态进行"通信",每个节点只需关注自己的处理逻辑。
一个节点对状态的更新会传递给下一个节点。
这就像是一个接力赛跑,每个选手(节点)接过接力棒(状态),做一些事情,然后传给下一个选手。
from typing import TypedDict
from langgraph.graph import StateGraph

class MessageState(TypedDict):
    content: str
    processed: bool
# 定义了一个包含两个字段的状态:content(消息内容)和processed(是否已处理)。

def node_A(state: MessageState) -> dict:
    # 处理内容
    processed_content = f"处理后的: {state['content']}"
    # 更新状态
    return {"content": processed_content, "processed": True}
# 节点接收原始状态,修改content字段(添加"处理后的:"前缀),并将processed标记为True。

def node_B(state: MessageState) -> dict:
    # 检查内容是否已处理
    if state["processed"]:
        # 使用处理后的内容
        return {"content": f"节点B回应: {state['content']}"}
    else:
        # 内容未处理
        return {"content": "需要先处理内容"}
# 节点检查processed标志 - 如果内容已处理,就在内容前添加"节点B回应:";如果未处理,则返回错误信息。


# 创建图并连接节点
graph = StateGraph(MessageState)
graph.add_node("process", node_A)
graph.add_node("respond", node_B)
graph.set_entry_point("process")
graph.add_edge("process", "respond")
通过参数传递额外信息
有时,你可能需要向节点传递额外的信息。
这可以通过在调用 invoke 时提供额外参数实现:
def enhanced_node(state: MessageState, config: dict) -> dict:
    # state: 正常的状态对象,使用额外的配置参数 config: 额外的配置字典
    template = config.get("template", "默认回复: {}")
    # 如果没有提供模板,则使用"默认回复: {}"作为默认模板。
    return {"content": template.format(state["content"])}

# 在编译时配置,所有调用都会使用这些参数
graph.add_node("enhanced", enhanced_node, config={"template": "定制回复: {}"})
# 这里在添加节点时提供了默认配置,这个配置会在每次调用该节点时使用,除非被覆盖。

# 或者在调用时传递
compiled_graph = graph.compile()
result = compiled_graph.invoke(
    {"content": "测试消息", "processed": False},
    config={"template": "调用时的模板: {}"}
    # 在调用图时提供了特定的配置,它会覆盖添加节点时设置的默认配置。
    # 当"enhanced"节点执行时,它使用的是调用时传递的配置,而不是添加节点时的默认配置
)
输出:
初始状态: {"content": "测试消息", "processed": False}
调用时配置: {"template": "调用时的模板: {}"}
节点运行后,返回: {"content": "调用时的模板: 测试消息"}
这种机制非常有用,因为它允许:
- 设置一致的默认行为(添加节点时的配置)
- 在需要时灵活覆盖这些默认值(调用时的配置)
这样你可以在不修改节点代码的情况下,让同一个节点在不同情况下有不同的行为,大大提高了代码的灵活性和可重用性。
条件通信
在某些情况下,你可能希望根据状态内容决定数据的流向。
这就像是一个交通指挥员,根据情况决定数据应该走哪条路。
条件路由让你的应用能够做出智能决策,处理各种不同的情况。
from typing import TypedDict, Literal
from langgraph.graph import StateGraph

class RoutingState(TypedDict):
    content: str
    sentiment: Literal["positive", "negative", "neutral"]
    response: str

def analyze_sentiment(state: RoutingState) -> dict:
    # 简单情感分析(实际应用中可能使用NLP模型)
    text = state["content"].lower()
    if "好" in text or "喜欢" in text:
        return {"sentiment": "positive"}
    elif "不" in text or "讨厌" in text:
        return {"sentiment": "negative"}
    else:
        return {"sentiment": "neutral"}

def positive_response(state: RoutingState) -> dict:
    return {"response": "我很高兴听到您的积极反馈!"}

def negative_response(state: RoutingState) -> dict:
    return {"response": "我很抱歉听到您的负面体验,我们会努力改进。"}

def neutral_response(state: RoutingState) -> dict:
    return {"response": "感谢您的反馈。"}

# 创建图
graph = StateGraph(RoutingState)

# 添加节点
graph.add_node("analyze", analyze_sentiment)
graph.add_node("positive", positive_response)
graph.add_node("negative", negative_response)
graph.add_node("neutral", neutral_response)

# 设置入口点
graph.set_entry_point("analyze")

# 定义条件路由
def router(state: RoutingState):
    return state["sentiment"]

# 添加条件边
graph.add_conditional_edges(
    "analyze",
    router,
    {
        "positive": "positive",
        "negative": "negative",
        "neutral": "neutral"
    }
)
实践检测(由易到难)
- 节点间通信的主要方式是什么?简单描述这一机制。
- 如何让一个节点能够接收额外的配置参数?
- 编写一个简单的节点函数,它检查状态中的"validated"字段,并根据结果返回不同的消息。
- 在 LangGraph 中,如何向节点传递运行时配置?
- 什么是条件路由?它解决了什么问题?
- 编写一个简单的路由函数,根据输入消息的长度将其分类为"短"、“中"或"长”。
- 使用 add_conditional_edges 方法,创建一个基于消息类型进行路由的图结构。
- 设计一个使用中间节点进行数据转换的简单系统,包括数据验证。
- 如何确保节点按正确的顺序处理数据?描述一种防止数据未经预处理就被处理的策略。
- 设计一个完整的对话系统,使用条件边根据用户意图(问候、查询、投诉)路由到不同的处理节点。
条件分支和循环
条件分支和循环模块是 LangGraph 中用于控制数据流向的核心功能,它们让你的图不再是简单的线性流程,而是能够:
- 根据不同条件选择不同处理路径(条件分支)
- 重复执行某些操作直到满足特定条件(循环)
- 构建能够自我迭代改进的系统(自我改进)
条件分支
条件分支是构建智能系统的基础,它让你的应用能够做出决策。
创建条件分支,最基本的条件分支包含三个部分:
- 一个源节点
- 一个路由函数
- 多个可能的目标节点
想象你在开发一个客服机器人,它需要根据用户的意图提供不同的服务:
- 问候 → 回复欢迎信息
- 产品问题 → 查询产品数据库
- 售后服务 → 连接到服务系统
条件分支让这种智能路由成为可能。
from typing import TypedDict, Literal
from langgraph.graph import StateGraph

# 定义状态
class QueryState(TypedDict):
    query: str
    query_type: Literal["greeting", "question", "command"]
    response: str

# 路由函数
def query_router(state: QueryState) -> str:
    """根据查询类型路由到不同节点"""
    return state["query_type"]  # 返回字符串作为路由决策

# 处理节点
def handle_greeting(state: QueryState) -> dict:
    return {"response": "你好!有什么我可以帮助你的?"}

def handle_question(state: QueryState) -> dict:
    return {"response": f"对于问题 '{state['query']}',我的回答是..."}

def handle_command(state: QueryState) -> dict:
    return {"response": f"正在执行命令: {state['query']}"}

# 创建图
graph = StateGraph(QueryState)

# 添加节点
graph.add_node("greeting_handler", handle_greeting)
graph.add_node("question_handler", handle_question)
graph.add_node("command_handler", handle_command)

# 添加条件边
graph.add_conditional_edges(
    "query_classifier",  # 源节点
    query_router,        # 路由函数
    {
        "greeting": "greeting_handler",  # 如果返回"greeting",回复欢迎信息
        "question": "question_handler",  # 如果返回"question",查询产品数据库
        "command": "command_handler"     # 如果返回"command",连接到服务系统
    }
)
循环结构
想象你在做一道菜:
- 你先准备好原料(初始数据)
- 然后你开始烹饪(处理数据)
- 每隔几分钟,你尝一尝味道(检查完成条件)
- 如果味道不够好,你继续烹饪(继续循环)
- 如果味道满意了,你停止烹饪(结束循环)
from typing import TypedDict, List
from langgraph.graph import StateGraph, END

# 定义状态结构
class IterativeState(TypedDict):
    iterations: int     # 记录已经迭代了多少次
    max_iterations: int # 最多允许迭代多少次
    data: List[float]   # 要处理的数据
    result: float       # 处理结果

# 处理数据的函数
def process_data(state: IterativeState) -> dict:
    """处理一轮数据"""
    current_data = state["data"]
    # 简单示例:每轮将所有数据乘以0.9
    new_data = [x * 0.9 for x in current_data]

    # 计算新的结果(例如平均值)
    new_result = sum(new_data) / len(new_data)

    # 增加迭代计数
    new_iterations = state["iterations"] + 1

    # 返回更新后的状态
    return {
        "data": new_data,
        "result": new_result,
        "iterations": new_iterations
    }

# 检查是否完成迭代的函数
def check_completion(state: IterativeState) -> str:
    # 如果已达到最大迭代次数,返回"complete"
    if state["iterations"] >= state["max_iterations"]:
        return "complete"
    else: # 否则返回"continue"
        return "continue"

# 创建图
graph = StateGraph(IterativeState)
graph.add_node("process", process_data)

# 设置入口点
graph.set_entry_point("process")

# 添加条件边实现循环
graph.add_conditional_edges(
    "process",            # 源节点
    check_completion,     # 使用check_completion函数检查是否继续循环
    {
        "continue": "process",  # 如果返回"continue",继续循环
        "complete": END         # 如果返回"complete",结束执行
    }
)
实践检测题(由易到难)
- 在 LangGraph 中,如何实现一个简单的条件分支?
- 什么是复杂路由?它与简单条件分支有何不同?
- 如何在 LangGraph 中创建一个基于多个条件的路由函数?
- 在 LangGraph 中,如何实现一个简单的循环结构?
- 设计一个迭代计算图,计算斐波那契数列的前 N 项。
- 什么情况下你会选择使用循环而不是简单的顺序执行?
- 自我改进系统的核心组件有哪些?它们如何协同工作?
- 设计一个自我改进的文本摘要系统,能够生成初步摘要,评价其质量,并进行多轮改进。
- 如何防止循环结构中的无限循环?讨论几种可能的策略。
- 创建一个复杂的对话系统,结合条件分支和循环,能够处理多轮对话,并在需要时优化其回复。
与外部工具集成
调用 Qwen
# 导入必要的库
from openai import OpenAI
from langchain_core.messages import HumanMessage, AIMessage
from langgraph.graph import StateGraph, START, END
from typing import TypedDict, List, Dict, Any

# 创建千问API客户端
def create_qwen_client(api_key):
    return OpenAI(
        api_key=api_key,
        base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
    )

# 调用千问API生成回复
def generate_with_qwen(client, prompt, model_name="qwen-max", temperature=0.7):
    try:
        # 创建消息格式
        messages = [{"role": "user", "content": prompt}]

        # 调用API
        response = client.chat.completions.create(
            model=model_name,
            messages=messages,
            temperature=temperature
        )

        # 返回生成的内容
        return response.choices[0].message.content
    except Exception as e:
        print(f"调用千问API时发生错误: {str(e)}")
        return "发生错误,请稍后再试。"

# 创建千问客户端
client = create_qwen_client(api_key="sk-.....")

# 定义状态类型
class ChatState(TypedDict):
    messages: List

# 定义节点函数
def call_model(state: ChatState) -> Dict[str, Any]:
    # 获取消息列表
    messages = state["messages"]

    # 获取最后一条消息的内容
    prompt = messages[-1].content

    # 调用千问生成回复
    response = generate_with_qwen(client, prompt)

    # 返回更新后的状态
    return {"messages": messages + [AIMessage(content=response)]}

# 创建状态图
workflow = StateGraph(ChatState)

# 添加节点
workflow.add_node("call_model", call_model)

# 添加边,定义流程
workflow.add_edge(START, "call_model")
workflow.add_edge("call_model", END)

# 编译图
chain = workflow.compile()

# 创建初始状态并调用
messages = [HumanMessage(content="介绍一下LangGraph的主要特点")]
result = chain.invoke({"messages": messages})
print(result)
输出:
{'messages':
[HumanMessage(content='介绍一下LangGraph的主要特点', additional_kwargs={}, response_metadata={}),
AIMessage(content='LangGraph是阿里巴巴推出的一种多模态预训练模型,它在处理语言和图像信息方面具有显著的优势。以下是LangGraph的一些主要特点:\n\n1. **多模态融合能力**:LangGraph能够同时理解和处理文本与图像信息,实现跨模态的信息理解与生成。这意味着它可以基于给有的文字描述生成相应的图片,或者根据提供的图片生成相关的文字说明。\n\n2. **强大的预训练基础**:通过大规模的数据集进行预训练,使得LangGraph具备了广泛的知识背景,能够更好地适应各种应用场景下的需求。这种广泛的预训练不仅限于中文或英文单一语种,而是覆盖了多种语言,增强了其在全球范围内的适用性。\n\n3. **高效灵活的应用接口**:为了方便开发者使用,LangGraph提供了易于集成的API接口。这些接口允许用户轻松地将该模型应用于自己的项目中,无论是网页应用、移动应用程序还是其他类型的软件开发,都能够快速接入并利用到LangGraph的强大功能。\n\n4. **支持多样化任务场景**:除了基本的文字生成图片、图片识别文字等功能外,LangGraph还支持更复杂的任务如视觉问答(VQA)、图像标题生成等。这使得它能够在多个领域发挥作用,比如教育、娱乐、广告创意设计等领域都有潜在的应用价值。\n\n5. **持续迭代优化**:作为一款前沿的技术产品,阿里巴巴团队会不断地对LangGraph进行更新和改进,以确保其性能始终保持领先,并且能够满足市场上日益增长的需求变化和技术挑战。\n\n总之,LangGraph以其独特的多模态处理能力和丰富的应用场景,为用户提供了一个强大而灵活的工具,有助于推动人工智能技术在更多领域的创新发展。请注意,具体功能可能会随着版本更新而有所调整,请参考官方文档获取最新信息。', additional_kwargs={}, response_metadata={})]}
编排多个语言模型
如根据医学指南,生成建议:
- 第一个模型 (qwen-turbo) - 提供快速、简洁的基本回答
- 第二个模型 (qwen-plus) - 基于第一个模型的回答提供补充信息
- 第三个模型 (qwen-max) - 作为评审者,检查前两个模型的回答,纠正错误,并提供最终整合的回答
# 导入必要的库
from openai import OpenAI
from langchain_core.messages import HumanMessage, AIMessage, SystemMessage
from langgraph.graph import StateGraph, START, END
from typing import TypedDict, List, Dict, Any

# 创建千问API客户端
def create_qwen_client(api_key):
    """创建千问API客户端"""
    return OpenAI(
        api_key=api_key,
        base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
    )

# 调用千问API生成回复
def generate_with_qwen(client, messages, model_name, temperature=0.7):
    try:
        # 转换消息格式
        api_messages = []
        for message in messages:
            if isinstance(message, dict):
                api_messages.append(message)
            else:
                role = "system" if message.type == "system" else ("assistant" if message.type == "ai" else "user")
                api_messages.append({"role": role, "content": message.content})

        # 调用API
        response = client.chat.completions.create(
            model=model_name,
            messages=api_messages,
            temperature=temperature
        )

        # 返回生成的内容
        return response.choices[0].message.content
    except Exception as e:
        print(f"调用千问API时发生错误: {str(e)}")
        return "发生错误,请稍后再试。"

# 创建千问客户端
client = create_qwen_client(api_key="sk-f80c7")  # 替换为你的实际密钥

# 定义状态类型
class ChatState(TypedDict):
    messages: List  # 用户消息
    answer: str     # 第一个模型的回答
    supplement: str # 第二个模型的补充
    final_answer: str  # 第三个模型的检查结果

# 定义第一个模型节点 - 提供基本回答
def first_model(state: ChatState) -> Dict[str, Any]:
    """使用第一个模型(qwen-turbo)生成基本回答"""
    messages = state["messages"]

    # 创建系统提示,指导模型提供基本回答
    system_message = SystemMessage(content="你是一个助手,请提供对问题的基本回答。保持简洁明了。")

    # 组合消息
    prompt_messages = [system_message] + messages

    # 调用千问turbo模型
    response = generate_with_qwen(client, prompt_messages, "qwen-turbo")

    # 返回更新后的状态
    return {"answer": response}

# 定义第二个模型节点 - 提供补充信息
def second_model(state: ChatState) -> Dict[str, Any]:
    """使用第二个模型(qwen-plus)补充信息"""
    messages = state["messages"]
    answer = state["answer"]

    # 创建系统提示,指导模型补充信息
    system_message = SystemMessage(content=f"""
    你是一个信息补充专家。以下是用户的问题以及已有的基本回答:

    已有回答: {answer}

    请补充更多相关信息、例子或细节,使回答更加完整。不要重复已有内容。
    """)

    # 组合消息
    prompt_messages = [system_message] + messages

    # 调用千问plus模型
    response = generate_with_qwen(client, prompt_messages, "qwen-plus")

    # 返回更新后的状态
    return {"supplement": response}

# 定义第三个模型节点 - 检查和合并
def third_model(state: ChatState) -> Dict[str, Any]:
    """使用第三个模型(qwen-max)检查并整合前两个模型的回答"""
    messages = state["messages"]
    answer = state["answer"]
    supplement = state["supplement"]

    # 创建系统提示,指导模型进行检查和整合
    system_message = SystemMessage(content=f"""
    你是一个质量检查专家。以下是用户的问题、基本回答和补充信息:

    基本回答: {answer}

    补充信息: {supplement}

    请完成以下任务:
    1. 检查基本回答和补充信息的准确性
    2. 纠正任何错误或不准确的信息
    3. 整合两部分内容,确保逻辑连贯
    4. 确保最终回答全面、准确且易于理解

    请提供最终的完整回答。
    """)

    # 组合消息
    prompt_messages = [system_message] + messages

    # 调用千问max模型
    response = generate_with_qwen(client, prompt_messages, "qwen-max")

    # 返回更新后的状态,包括最终回答和AI消息
    return {
        "final_answer": response,
        "messages": messages + [AIMessage(content=response)]
    }

# 创建状态图
workflow = StateGraph(ChatState)

# 添加节点
workflow.add_node("first_model", first_model)
workflow.add_node("second_model", second_model)
workflow.add_node("third_model", third_model)

# 添加边,定义顺序流程
workflow.add_edge(START, "first_model")
workflow.add_edge("first_model", "second_model")
workflow.add_edge("second_model", "third_model")
workflow.add_edge("third_model", END)

# 编译图
chain = workflow.compile()

# 创建初始状态并调用
initial_state = {
    "messages": [HumanMessage(content="什么是LangGraph以及它的主要特点?")],
    "answer": "",
    "supplement": "",
    "final_answer": ""
}

# 运行工作流
result = chain.invoke(initial_state)

# 打印结果
print("=== 第一个模型的基本回答 ===")
print(result["answer"])
print("\n=== 第二个模型的补充信息 ===")
print(result["supplement"])
print("\n=== 第三个模型的最终回答 ===")
print(result["final_answer"])
输出:(等了很久,大概几分钟)
=== 第一个模型的基本回答 ===
LangGraph 是一种基于图结构的语言表示方法,主要用于自然语言处理和语义分析任务。其主要特点是将语言中的词汇、短语或句子以节点的形式表示,并通过边来连接具有语义关系的元素,从而形成一个图结构。这种表示方式能够更好地捕捉语言中的复杂语义关联。

### 主要特点:
1. **图结构建模**:利用图论的方法建模语言数据,可以灵活表达复杂的语义关系。
2. **语义丰富性**:能够更直观地表示词汇之间的同义、反义、上下位等语义关系。
3. **可扩展性**:适合处理大规模文本数据,支持多种语言任务(如问答、文本生成等)。
4. **动态性**:可以根据不同应用场景调整图的构建规则和特征。

总之,LangGraph 提供了一种强大的工具来建模语言的语义网络,适用于需要深入理解语言内在关系的任务。

=== 第二个模型的补充信息 ===
LangGraph 是一种创新的语言表示方法,通过将自然语言中的词汇、短语和句子建模为图结构(graph structure),从而更好地捕捉语言中的复杂语义关系。它结合了图论与自然语言处理技术的优势,为解决多种语言任务提供了强大的工具支持。

### 补充信息及特点:

#### 1. **多模态融合能力**
   LangGraph 不仅可以用于纯文本数据的建模,还能够与其他模态(如图像、音频)的数据进行融合。例如,在视觉问答(Visual Question Answering, VQA)任务中,可以通过构建联合图结构来同时表示文本和图像中的信息,从而更准确地理解问题和场景之间的关联。

#### 2. **动态知识图谱集成**
   在实际应用中,LangGraph 可以与现有的知识图谱(Knowledge Graphs)相结合。通过引入外部知识(如维基百科或Freebase中的实体关系),LangGraph 能够增强对文本的理解能力。例如,在命名实体识别(NER)任务中,LangGraph 可以利用知识图谱中的实体类型和关系来提高识别精度。

#### 3. **上下文敏感性**
   传统词嵌入方法(如Word2Vec或GloVe)通常无法区分同一词语在不同上下文中的含义,而LangGraph 通过节点和边的动态调整,能够灵活地捕捉词语在具体语境中的意义。例如,在句子“*银行是河流的一部分*”和“*银行提供贷款服务*”中,“银行”具有完全不同的含义,LangGraph 可以通过图结构中的上下文依赖关系区分这些差异。

#### 4. **高效推理机制**
   LangGraph 支持基于图的推理算法(如随机游走、图卷积网络GCN等),这使得模型能够在复杂的语义网络中进行高效推理。例如,在逻辑推理任务中,LangGraph 可以通过分析句子间的因果关系或条件关系,推导出隐含的信息。

#### 5. **实际应用场景**
   - **机器翻译**:通过构建源语言和目标语言之间的映射图,LangGraph 可以帮助捕捉两种语言之间的深层语义对应关系。
   - **情感分析**:通过对句子中的情感词汇及其关系进行建模,LangGraph 能够更精确地判断文本的情感倾向。
   - **对话系统**:在多轮对话中,LangGraph 可以跟踪历史对话内容并建立长期记忆图,从而生成更加连贯和自然的回复。

#### 6. **技术实现细节**
   - **图的构建方式**:LangGraph 的图结构通常由句法分析器(如依存句法树)或语义角色标注工具生成。节点可以代表单词、短语甚至整个句子,而边则表示它们之间的语法或语义关系。
   - **特征表示**:每个节点和边都可以附带丰富的特征向量,这些特征可能来源于预训练的语言模型(如BERT)、词嵌入或其他特征提取方法。
   - **优化方法**:为了提升性能,LangGraph 常常与深度学习框架结合使用,例如通过图神经网络(Graph Neural Networks, GNNs)对图结构进行端到端训练。

#### 示例:
假设我们有一段文本:“猫喜欢追着老鼠跑。”
- 在LangGraph 中,这句话可以被建模为一个图,其中“猫”、“喜欢”、“追着”、“老鼠”和“跑”作为节点。
- 边可以表示它们之间的关系,例如:
  - “猫” → “喜欢”(主谓关系)
  - “喜欢” → “追着”(动宾关系)
  - “追着” → “老鼠”(宾语关系)
  - “老鼠” → “跑”(伴随动作关系)

这种图结构不仅清晰地展示了句子的语法结构,还蕴含了潜在的语义信息,比如“猫”和“老鼠”之间存在捕食关系。

### 总结
LangGraph 是一种功能强大且灵活的语言建模方法,特别适合需要深入理解语言内在关系的任务。通过其独特的图结构设计,LangGraph 能够整合多模态信息、外部知识以及上下文依赖关系,为自然语言处理领域带来了新的研究方向和实践可能性。

=== 第三个模型的最终回答 ===
LangGraph 是一种基于图结构的语言表示方法,主要用于自然语言处理和语义分析任务。它通过将自然语言中的词汇、短语或句子以节点的形式表示,并通过边来连接具有语义关系的元素,从而形成一个图结构。这种表示方式能够更好地捕捉语言中的复杂语义关联。

### 主要特点:

1. **图结构建模**:
   - 利用图论的方法建模语言数据,可以灵活表达复杂的语义关系。
   - 通过句法分析器(如依存句法树)或语义角色标注工具生成图结构,节点代表单词、短语或句子,边表示它们之间的语法或语义关系。

2. **语义丰富性**:
   - 能够更直观地表示词汇之间的同义、反义、上下位等语义关系。
   - 每个节点和边都可以附带丰富的特征向量,这些特征可能来源于预训练的语言模型(如BERT)、词嵌入或其他特征提取方法。

3. **可扩展性**:
   - 适合处理大规模文本数据,支持多种语言任务(如问答、文本生成等)。
   - 可以与其他模态(如图像、音频)的数据进行融合,例如在视觉问答(VQA)任务中,构建联合图结构来同时表示文本和图像中的信息。

4. **动态性**:
   - 可以根据不同应用场景调整图的构建规则和特征。
   - 通过节点和边的动态调整,能够灵活地捕捉词语在具体语境中的意义,解决传统词嵌入方法无法区分同一词语在不同上下文中的含义的问题。

5. **动态知识图谱集成**:
   - 可以与现有的知识图谱(如维基百科或Freebase中的实体关系)相结合,增强对文本的理解能力。
   - 在命名实体识别(NER)任务中,利用知识图谱中的实体类型和关系来提高识别精度。

6. **高效推理机制**:
   - 支持基于图的推理算法(如随机游走、图卷积网络GCN等),在复杂的语义网络中进行高效推理。
   - 例如,在逻辑推理任务中,通过分析句子间的因果关系或条件关系,推导出隐含的信息。

7. **实际应用场景**:
   - **机器翻译**:通过构建源语言和目标语言之间的映射图,帮助捕捉两种语言之间的深层语义对应关系。
   - **情感分析**:通过对句子中的情感词汇及其关系进行建模,更精确地判断文本的情感倾向。
   - **对话系统**:在多轮对话中,跟踪历史对话内容并建立长期记忆图,生成更加连贯和自然的回复。

#### 示例:
假设我们有一段文本:“猫喜欢追着老鼠跑。”
- 在LangGraph 中,这句话可以被建模为一个图,其中“猫”、“喜欢”、“追着”、“老鼠”和“跑”作为节点。
- 边可以表示它们之间的关系,例如:
  - “猫” → “喜欢”(主谓关系)
  - “喜欢” → “追着”(动宾关系)
  - “追着” → “老鼠”(宾语关系)
  - “老鼠” → “跑”(伴随动作关系)

这种图结构不仅清晰地展示了句子的语法结构,还蕴含了潜在的语义信息,比如“猫”和“老鼠”之间存在捕食关系。

### 总结
LangGraph 是一种功能强大且灵活的语言建模方法,特别适合需要深入理解语言内在关系的任务。通过其独特的图结构设计,LangGraph 能够整合多模态信息、外部知识以及上下文依赖关系,为自然语言处理领域带来了新的研究方向和实践可能性。
高级图控制
并行执行 - 让多个任务同时进行,提高效率
在LangGraph中,通常任务是按顺序执行的:A完成后才开始B,B完成后才开始C。
但有了并行执行,A完成后,B和C可以同时开始。
LangGraph的并行执行功能基于"超步"(super-steps)概念。
在同一个超步中的节点会并行执行,而在不同超步中的节点会顺序执行。
from langgraph.graph import StateGraph
from typing import TypedDict, List, Dict, Any
import time

# 定义状态类型
class ParallelState(TypedDict):
    question: str                # 用户的原始问题
    sub_tasks: List[str]         # 子任务列表
    results: Dict[str, Any]      # 存储任务结果
    pending_tasks: List[int]     # 待处理任务的索引列表
    final_answer: str            # 最终答案

# 定义拆分任务的节点
def split_tasks(state: ParallelState) -> ParallelState:
    """将用户问题分解为多个子任务"""
    question = state["question"]
    print(f"拆分任务: {question}")

    # 动态创建子任务 - 可以根据问题内容动态决定需要哪些子任务
    sub_tasks = [
        f"调查 {question} 的历史背景",
        f"分析 {question} 的当前情况",
        f"预测 {question} 的未来趋势",  # 添加了第三个任务
        # 可以根据需要添加更多任务
    ]

    state["sub_tasks"] = sub_tasks
    state["results"] = {}
    # 初始化所有任务为待处理
    state["pending_tasks"] = list(range(len(sub_tasks)))

    return state

# 处理单个任务的节点
def process_task(state: ParallelState) -> ParallelState:
    """处理一个待处理的任务"""
    # 如果没有待处理的任务,直接返回
    if not state["pending_tasks"]:
        return state

    # 获取一个待处理的任务
    task_idx = state["pending_tasks"][0]
    task = state["sub_tasks"][task_idx]

    print(f"处理任务 {task_idx}: {task}")
    time.sleep(1)  # 模拟处理时间

    # 存储结果
    state["results"][task] = f"任务'{task}'的分析结果"

    # 从待处理列表中移除该任务
    state["pending_tasks"].remove(task_idx)

    return state

# 定义合并结果的节点
def combine_results(state: ParallelState) -> ParallelState:
    """将所有子任务的结果合并为最终答案"""
    print("合并所有结果")

    all_results = "\n".join([
        f"- {task}: {result}"
        for task, result in state["results"].items()
    ])

    state["final_answer"] = f"综合分析结果:\n{all_results}"

    return state

# 根据任务完成情况决定下一步
def next_step(state: ParallelState) -> List[str]:
    """决定下一步操作"""
    # 如果还有待处理的任务,继续处理
    if state["pending_tasks"]:
        return ["process_task"]
    # 如果所有任务都已完成,进行结果合并
    else:
        return ["combine_results"]

# 创建状态图
parallel_graph = StateGraph(ParallelState)

# 添加节点
parallel_graph.add_node("split_tasks", split_tasks)
parallel_graph.add_node("process_task", process_task)
parallel_graph.add_node("combine_results", combine_results)

# 添加边 数据流向
parallel_graph.add_edge("split_tasks", "process_task")
parallel_graph.add_conditional_edges("process_task", next_step)

# 设置入口节点
parallel_graph.set_entry_point("split_tasks")

# 编译图
parallel_app = parallel_graph.compile()

# 执行图
print("开始执行灵活的任务处理图...")
result = parallel_app.invoke({"question": "人工智能在医疗领域的应用"})
print("\n最终结果:")
print(result["final_answer"])
输出:
开始执行灵活的任务处理图...
拆分任务: 人工智能在医疗领域的应用
处理任务 0: 调查 人工智能在医疗领域的应用 的历史背景
处理任务 1: 分析 人工智能在医疗领域的应用 的当前情况
处理任务 2: 预测 人工智能在医疗领域的应用 的未来趋势
合并所有结果

最终结果:
综合分析结果:
- 调查 人工智能在医疗领域的应用 的历史背景: 任务'调查 人工智能在医疗领域的应用 的历史背景'的分析结果
- 分析 人工智能在医疗领域的应用 的当前情况: 任务'分析 人工智能在医疗领域的应用 的当前情况'的分析结果
- 预测 人工智能在医疗领域的应用 的未来趋势: 任务'预测 人工智能在医疗领域的应用 的未来趋势'的分析结果
Map-Reduce模式 - 将大问题分解成小问题,然后合并结果
递归控制 - 调用自己,处理嵌套问题:自我修正的RAG系统
展示一个自我修正的RAG系统,TA 会检查生成的答案质量,如果不满意,会重新检索和生成,直到得到满意的结果或达到递归限制。
- 每次相似度评估,是设计的随机真或假(教学演示)
from typing import List, Literal
from typing_extensions import TypedDict
from langgraph.graph import StateGraph, START, END
from langgraph.errors import GraphRecursionError  # 正确导入错误类

# 定义RAG状态
class RAGState(TypedDict):
    question: str  # 用户问题
    documents: List[str]  # 检索到的文档
    generation: str  # 生成的答案
    query: str  # 检索查询
    is_relevant: bool  # 文档是否相关
    is_hallucination: bool  # 答案是否存在幻觉
    is_useful: bool  # 答案是否有用
    iterations: int  # 跟踪迭代次数,用于限制递归

# 检索文档的节点
def retrieve(state: RAGState):
    """根据查询检索文档"""
    # 在实际应用中,这会调用向量数据库进行检索
    query = state.get("query", state["question"])
    print(f"检索:'{query}'")

    # 模拟检索结果
    docs = [f"关于'{query}'的文档1", f"关于'{query}'的文档2"]
    iterations = state.get("iterations", 0) + 1

    return {"documents": docs, "query": query, "iterations": iterations}

# 评估文档相关性的节点
def grade_documents(state: RAGState):
    """评估检索到的文档是否相关"""
    print(f"评估文档相关性")
    import random
    is_relevant = random.choice([True, False])  # 随机决定是否相关

    return {"is_relevant": is_relevant}

# 生成答案的节点
def generate(state: RAGState):
    """根据文档生成答案"""
    question = state["question"]
    print(f"生成答案")
    answer = f"基于检索到的文档,对于问题'{question}'的回答是..."

    return {"generation": answer}

# 检查答案质量的节点
def check_quality(state: RAGState):
    """检查生成的答案是否存在幻觉,是否有用"""
    print(f"检查答案质量")
    import random
    is_hallucination = False  # 假设没有幻觉
    is_useful = random.choice([True, False])  # 随机决定是否有用

    return {
        "is_hallucination": is_hallucination,
        "is_useful": is_useful
    }

# 重写查询的节点
def rewrite_query(state: RAGState):
    """重写查询以获得更好的检索结果"""
    question = state["question"]
    print(f"重写查询")
    new_query = f"详细信息: {question}"

    return {"query": new_query}

# 定义路由函数
def decide_next_step(state: RAGState) -> Literal["rewrite_query", "END"]:
    """决定下一步操作"""
    # 添加迭代次数限制,防止无限循环
    if state.get("iterations", 0) >= 3:
        print("达到最大迭代次数,结束流程")
        return END

    # 如果文档不相关,重写查询并重新检索
    if not state.get("is_relevant", False):
        print("文档不相关,重写查询")
        return "rewrite_query"

    # 如果存在幻觉,重写查询并重新检索
    if state.get("is_hallucination", False):
        print("答案存在幻觉,重写查询")
        return "rewrite_query"

    # 如果答案不够有用,重写查询并重新检索
    if not state.get("is_useful", False):
        print("答案不够有用,重写查询")
        return "rewrite_query"

    # 一切正常,结束流程
    print("答案质量良好,完成")
    return END

# 创建图
rag_graph = StateGraph(RAGState)

# 添加节点
rag_graph.add_node("retrieve", retrieve)
rag_graph.add_node("grade_documents", grade_documents)
rag_graph.add_node("generate", generate)
rag_graph.add_node("check_quality", check_quality)
rag_graph.add_node("rewrite_query", rewrite_query)

# 添加边
rag_graph.add_edge(START, "retrieve")
rag_graph.add_edge("retrieve", "grade_documents")
rag_graph.add_edge("grade_documents", "generate")
rag_graph.add_edge("generate", "check_quality")
rag_graph.add_conditional_edges("check_quality", decide_next_step, {
    "rewrite_query": "rewrite_query",
    END: END
})
rag_graph.add_edge("rewrite_query", "retrieve")  # 形成循环

# 编译图
rag_app = rag_graph.compile()

# 运行图,设置递归限制
try:
    result = rag_app.invoke(
        {"question": "什么是递归控制?", "iterations": 0},
        {"recursion_limit": 10}  # 设置递归限制
    )
    print("最终结果:", result)
except GraphRecursionError as e:
    print(f"达到递归限制,未能找到满意的答案: {e}")
输出:
检索:'什么是递归控制?'
评估文档相关性
生成答案
检查答案质量
答案不够有用,重写查询

检索:'详细信息: 什么是递归控制?'
评估文档相关性
生成答案
检查答案质量
答案质量良好,完成

最终结果: {'question': '什么是递归控制?', 'documents':
 ["关于'详细信息: 什么是递归控制?'的文档1", "关于'详细信息: 什么是递归控制?'的文档2"],
  'generation': "基于检索到的文档,对于问题'什么是递归控制?'的回答是...",
  'query': '详细信息: 什么是递归控制?', 'is_relevant': True, 'is_hallucination': False, 'is_useful': True, 'iterations': 2}
持久化和状态管理
线程持久化实现与优化
大模型上下文:通常仅限于当前对话的范围,一旦对话结束或超出上下文窗口(如4K-128K tokens),之前的信息就会丢失。
LangGraph 线程持久化:信息可以存储在独立的持久层中,即使在会话结束、应用重启后依然存在。
应用场景如,长期知识积累:需要随时间积累和改进信息的应用,如个性化学习助手、长期项目管理助手等。
from langgraph.graph import StateGraph
from langgraph.checkpoint.memory import MemorySaver  # 正确的导入路径
from typing import TypedDict, List
import time
import uuid  # 导入 uuid 模块生成唯一 ID

# 定义状态类型
class CounterState(TypedDict):
    count: int
    history: List[str]

# 创建内存检查点器
memory_saver = MemorySaver()

# 定义节点函数
def increment(state: CounterState) -> dict:
    """增加计数器的节点"""
    return {
        "count": state["count"] + 1,
        "history": state["history"] + [f"增加到 {state['count'] + 1} (时间: {time.strftime('%H:%M:%S')})"]
    }

def double(state: CounterState) -> dict:
    """将计数器翻倍的节点"""
    return {
        "count": state["count"] * 2,
        "history": state["history"] + [f"翻倍到 {state['count'] * 2} (时间: {time.strftime('%H:%M:%S')})"]
    }

# 创建图
graph = StateGraph(CounterState)

# 添加节点
graph.add_node("increment", increment)
graph.add_node("double", double)

# 添加边
graph.add_edge("increment", "double")

# 设置入口点
graph.set_entry_point("increment")

# 编译图并启用持久化
persisted_graph = graph.compile(checkpointer=memory_saver)

# 创建自定义线程 ID(不使用 new_thread 方法)
thread_id = str(uuid.uuid4())  # 或者使用任何字符串,如 "thread-1"
print(f"线程 ID: {thread_id}")

# 创建配置字典
config = {"configurable": {"thread_id": thread_id}}

# 第一次执行
result1 = persisted_graph.invoke(
    {"count": 1, "history": ["初始值: 1"]},
    config
)
print("第一次执行结果:", result1)

# 暂停几秒(模拟中断)
time.sleep(2)

# 第二次执行(继续之前的状态)
result2 = persisted_graph.invoke(
    {"count": 0, "history": []},  # 这个初始值会被忽略
    config  # 使用相同的线程 ID
)
print("第二次执行结果:", result2)

# 第三次执行(继续之前的状态)
result3 = persisted_graph.invoke(
    {"count": 0, "history": []},  # 这个初始值会被忽略
    config  # 使用相同的线程 ID
)
print("第三次执行结果:", result3)
输出:
线程 ID: d5900033-3f71-4364-afd0-543433207ef7
第一次执行结果: {'count': 4, 'history': ['初始值: 1', '增加到 2 (时间: 15:45:40)', '翻倍到 4 (时间: 15:45:40)']}
第二次执行结果: {'count': 2, 'history': ['增加到 1 (时间: 15:45:42)', '翻倍到 2 (时间: 15:45:42)']}
第三次执行结果: {'count': 2, 'history': ['增加到 1 (时间: 15:45:42)', '翻倍到 2 (时间: 15:45:42)']}
允许人类在自动化流程中适时干预
人在环中功能允许人类在自动化流程中适时干预,主要适用于:
- 审批敏感操作:当AI要执行敏感操作前(如发送邮件、进行支付、删除文件)需要人类确认。
- 内容审核:生成营销文案、客户回复或重要文档时,由人类审核并确保内容合规、准确。
- 错误校正:发现AI推理或决策中的错误,人类可以及时纠正,防止错误进一步传播。
- 处理极端案例:对于AI无法准确处理的边缘情况,转由人类处理。
- 知识填补:当AI面临知识缺口时,允许人类提供必要信息或指导。
from typing import TypedDict, List, Dict, Any
from langgraph.graph import StateGraph, START, END
import uuid

# 定义一个简单的状态结构
class SimpleApprovalState(TypedDict):
    request: Dict[str, Any]  # 请求信息
    approved: bool           # 是否批准
    result: str              # 结果

# 定义处理请求的节点
def process_request(state: SimpleApprovalState) -> Dict[str, Any]:
    """处理初始请求"""
    print("步骤1: 处理初始请求")

    # 从状态中获取请求,或使用默认值
    request = state.get("request", {})
    print(f"收到请求: {request}")

    return state  # 返回原始状态,不做修改

# 定义模拟人类审批的节点
def simulate_approval(state: SimpleApprovalState) -> Dict[str, Any]:
    """模拟人类审批过程"""
    print("\n步骤2: 模拟人类审批")

    # 在实际应用中,这里会使用interrupt函数等待人类输入
    # 在这个演示中,我们直接模拟批准
    print("模拟决策: 批准请求")

    return {"approved": True}

# 定义执行操作的节点
def execute_action(state: SimpleApprovalState) -> Dict[str, Any]:
    """执行已批准的操作"""
    print("\n步骤3: 执行操作")

    if state.get("approved", False):
        result = "操作已成功执行!"
        print(f"结果: {result}")
        return {"result": result}
    else:
        result = "操作被拒绝,未执行。"
        print(f"结果: {result}")
        return {"result": result}

# 创建工作流图
builder = StateGraph(SimpleApprovalState)

# 添加节点
builder.add_node("process", process_request)
builder.add_node("approve", simulate_approval)
builder.add_node("execute", execute_action)

# 设置入口点
builder.set_entry_point("process")

# 添加边
builder.add_edge("process", "approve")
builder.add_edge("approve", "execute")
builder.add_edge("execute", END)

# 编译图(不使用检查点)
workflow = builder.compile()

# 准备初始状态
initial_state = {
    "request": {
        "type": "email",
        "recipient": "zhang.san@example.com",
        "subject": "会议安排调整",
        "content": "明天的会议改到下午3点"
    }
}

# 执行工作流
print("===== 开始执行工作流 =====")
result = workflow.invoke(initial_state)
print("\n===== 工作流执行完毕 =====")
print("最终状态:")
for key, value in result.items():
    print(f"{key}: {value}")
输出:
===== 开始执行工作流 =====
步骤1: 处理初始请求
收到请求: {'type': 'email', 'recipient': 'zhang.san@example.com', 'subject': '会议安排调整', 'content': '明天的会议改到下午3点'}

步骤2: 模拟人类审批
模拟决策: 批准请求

步骤3: 执行操作
结果: 操作已成功执行!

===== 工作流执行完毕 =====
最终状态:
request: {'type': 'email', 'recipient': 'zhang.san@example.com', 'subject': '会议安排调整', 'content': '明天的会议改到下午3点'}
approved: True
result: 操作已成功执行!
状态编辑与人类反馈
时间旅行功能
时间旅行允许回溯到历史状态点并创建替代执行路径,适用于:
- 分析决策过程:探究AI为何做出特定决策,追踪导致错误的关键点。
- 比较解决方案:从同一起点创建多个解决方案分支,比较不同方法的效果。
- 调试与修复:识别问题发生的确切时刻,从该点重新启动而不必从头开始。
- 版本控制:保存不同版本的解决方案,类似代码版本控制,便于回退或选择最佳方案。
- 教育培训:展示不同决策路径的后果,作为团队培训或教育工具。
- 性能优化:通过尝试不同的执行路径,识别流程中的瓶颈并进行优化。
在具有长期记忆的有状态Agent中的应用
store 持久化层储存Agent的长期记忆
记忆模式与用户画像
Memory Collection 管理
会话记忆、人类自然遗忘机制
会话历史记录的高效管理
对话摘要记忆的实现与应用
交互式调试与流程控制
断点与动态断点的应用
图状态的编辑与调试
工具集成于调用
ToolNode工具调用与集成
工具调用流程管理
运行时值与工具交互
子图设计
有一个主系统(主图)接收问题:
- 系统能够判断问题属于哪个领域(数学或历史)
- 然后将问题转发给相应的专家子系统(子图)处理
- 最后整合专家的回答,提供最终答案
这种子图设计在以下场景中特别有用:
- 多专家协作系统:比如一个客服机器人,根据不同问题类型(订单、退款、技术支持等)调用不同的专家模块
- 工作流自动化:企业中的审批流程,将不同类型的申请分配给不同部门处理
- 复杂AI助手:功能强大的AI助手,能够将任务分解并调用专门模块处理不同任务(如代码编写、数据分析、内容创作等)
- 知识型应用:需要从多个领域整合知识的应用,如医疗诊断系统(可能需要放射科、病理科、内科等专家的输入)
from typing import TypedDict, List, Literal, Annotated
from operator import add
import uuid
import time
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.memory import MemorySaver

# 定义专家子图状态
class ExpertState(TypedDict):
    question: str
    thoughts: str
    answer: str
    expertise: str
    logs: Annotated[List[str], add]

# 创建专家节点函数
def expert_think(state: ExpertState):
    """专家思考问题的节点"""
    expertise = state["expertise"]
    question = state["question"]

    # 模拟专家思考过程
    thoughts = f"作为{expertise}专家,我需要考虑{question}..."
    time.sleep(1)  # 模拟思考时间

    return {
        "thoughts": thoughts,
        "logs": [f"专家({expertise})正在思考: {time.ctime()}"]
    }

def expert_answer(state: ExpertState):
    """专家提供答案的节点"""
    expertise = state["expertise"]
    question = state["question"]
    thoughts = state["thoughts"]

    # 模拟专家回答
    if expertise == "数学":
        answer = f"从数学角度: {question}的答案是基于数学原理..."
    elif expertise == "历史":
        answer = f"从历史角度: {question}可以追溯到历史事件..."
    else:
        answer = f"从{expertise}角度: {question}的答案是..."

    return {
        "answer": answer,
        "logs": [f"专家({expertise})提供答案: {time.ctime()}"]
    }

# 构建专家子图
def build_expert_graph(expertise_type: str):
    """创建特定领域的专家子图"""
    expert_builder = StateGraph(ExpertState)

    # 添加节点
    expert_builder.add_node("思考", expert_think)
    expert_builder.add_node("回答", expert_answer)

    # 添加边
    expert_builder.add_edge(START, "思考")
    expert_builder.add_edge("思考", "回答")
    expert_builder.add_edge("回答", END)

    # 编译专家子图
    memory_saver = MemorySaver()
    return expert_builder.compile(checkpointer=memory_saver)

# 创建各领域的专家子图
math_expert = build_expert_graph("数学")
history_expert = build_expert_graph("历史")

# 定义主图状态
class MainState(TypedDict):
    query: str
    expert_type: Literal["数学", "历史", "其他"]
    expert_answer: str  # 添加字段用于存储专家回答
    final_answer: str
    all_logs: Annotated[List[str], add]

# 主图节点函数
def classify_query(state: MainState):
    """分类查询类型的节点"""
    query = state["query"]

    # 简单分类逻辑
    if "数学" in query or "计算" in query or "三角形" in query or "勾股定理" in query:
        expert_type = "数学"
    elif "历史" in query or "古代" in query or "发明" in query:
        expert_type = "历史"
    else:
        expert_type = "其他"

    return {
        "expert_type": expert_type,
        "all_logs": [f"查询已分类为: {expert_type} - {time.ctime()}"]
    }

def call_math_expert(state: MainState):
    """调用数学专家子图"""
    # 准备子图输入 - 确保包含所有必要字段
    subgraph_input = {
        "question": state["query"],
        "expertise": "数学",  # 显式提供expertise字段
        "thoughts": "",
        "answer": "",
        "logs": []
    }

    # 调用子图
    result = math_expert.invoke(subgraph_input)

    # 处理子图输出
    return {
        "expert_answer": result["answer"],
        "all_logs": result["logs"]  # 添加子图的日志到主图
    }

def call_history_expert(state: MainState):
    """调用历史专家子图"""
    # 准备子图输入 - 确保包含所有必要字段
    subgraph_input = {
        "question": state["query"],
        "expertise": "历史",  # 显式提供expertise字段
        "thoughts": "",
        "answer": "",
        "logs": []
    }

    # 调用子图
    result = history_expert.invoke(subgraph_input)

    # 处理子图输出
    return {
        "expert_answer": result["answer"],
        "all_logs": result["logs"]
    }

def route_to_expert(state: MainState) -> str:
    """根据专家类型路由的函数"""
    expert_type = state["expert_type"]
    if expert_type == "数学":
        return "math_expert"
    elif expert_type == "历史":
        return "history_expert"
    else:
        return "general_answer"

def general_answer(state: MainState):
    """当没有特定专家时的回答节点"""
    return {
        "final_answer": "这个问题需要综合知识,我建议查阅更多资料。",
        "all_logs": ["使用通用回答 - " + time.ctime()]
    }

def process_expert_answer(state: MainState):
    """处理专家回答的节点"""
    expert_type = state["expert_type"]
    expert_answer = state["expert_answer"]

    return {
        "final_answer": f"根据{expert_type}专家的意见: {expert_answer}",
        "all_logs": [f"处理了{expert_type}专家的回答 - {time.ctime()}"]
    }

# 构建主图
builder = StateGraph(MainState)

# 添加节点
builder.add_node("分类", classify_query)
builder.add_node("数学专家", call_math_expert)
builder.add_node("历史专家", call_history_expert)
builder.add_node("通用回答", general_answer)
builder.add_node("处理回答", process_expert_answer)

# 添加边
builder.add_edge(START, "分类")
builder.add_conditional_edges("分类", route_to_expert, {
    "math_expert": "数学专家",
    "history_expert": "历史专家",
    "general_answer": "通用回答"
})
builder.add_edge("数学专家", "处理回答")
builder.add_edge("历史专家", "处理回答")
builder.add_edge("通用回答", END)
builder.add_edge("处理回答", END)

# 编译主图
memory_saver = MemorySaver()
main_graph = builder.compile(checkpointer=memory_saver)

# 创建线程ID
thread_id = str(uuid.uuid4())
print(f"线程ID: {thread_id}")

# 配置
config = {"configurable": {"thread_id": thread_id}}

# 执行图 - 数学问题
result1 = main_graph.invoke(
    {"query": "如何计算三角形的面积?", "all_logs": []},
    config
)
print("\n--- 数学问题结果 ---")
print(f"查询: {result1['query']}")
print(f"专家类型: {result1['expert_type']}")
print(f"最终答案: {result1['final_answer']}")
print("日志:")
for log in result1['all_logs']:
    print(f"  - {log}")

# 执行图 - 历史问题
# 使用相同的线程ID续接状态
result2 = main_graph.invoke(
    {"query": "古代中国的四大发明是什么?", "all_logs": []},
    config
)
print("\n--- 历史问题结果 ---")
print(f"查询: {result2['query']}")
print(f"专家类型: {result2['expert_type']}")
print(f"最终答案: {result2['final_answer']}")
print("日志:")
for log in result2['all_logs']:
    print(f"  - {log}")

# 查看子图的工作
print("\n--- 子图执行流 ---")
for chunk in main_graph.stream(
    {"query": "什么是勾股定理?", "all_logs": []},
    config,
    stream_mode="values",
    subgraphs=True
):
    # 打印每个步骤的输出
    print(chunk)
输出:
线程ID: 8c94e1da-0741-4ff5-889a-b42d4f55443a

--- 数学问题结果 ---
查询: 如何计算三角形的面积?
专家类型: 数学
最终答案: 根据数学专家的意见: 从数学角度: 如何计算三角形的面积?的答案是基于数学原理...
日志:
  - 查询已分类为: 数学 - Tue Mar 25 16:13:19 2025
  - 专家(数学)正在思考: Tue Mar 25 16:13:20 2025
  - 专家(数学)提供答案: Tue Mar 25 16:13:20 2025
  - 处理了数学专家的回答 - Tue Mar 25 16:13:20 2025

--- 历史问题结果 ---
查询: 古代中国的四大发明是什么?
专家类型: 历史
最终答案: 根据历史专家的意见: 从历史角度: 古代中国的四大发明是什么?可以追溯到历史事件...
日志:
  - 查询已分类为: 数学 - Tue Mar 25 16:13:19 2025
  - 专家(数学)正在思考: Tue Mar 25 16:13:20 2025
  - 专家(数学)提供答案: Tue Mar 25 16:13:20 2025
  - 处理了数学专家的回答 - Tue Mar 25 16:13:20 2025
  - 查询已分类为: 历史 - Tue Mar 25 16:13:20 2025
  - 专家(历史)正在思考: Tue Mar 25 16:13:21 2025
  - 专家(历史)提供答案: Tue Mar 25 16:13:21 2025
  - 处理了历史专家的回答 - Tue Mar 25 16:13:21 2025

--- 子图执行流 ---
((), {'query': '什么是勾股定理?', 'expert_type': '历史', 'expert_answer': '从历史角度: 古代中国的四大发明是什么?可以追溯到历史事件...', 'final_answer': '根据历史专家的意见: 从历史角度: 古代中国的四大发明是什么?可以追溯到历史事件...', 'all_logs': ['查询已分类为: 数学 - Tue Mar 25 16:13:19 2025', '专家(数学)正在思考: Tue Mar 25 16:13:20 2025', '专家(数学)提供答案: Tue Mar 25 16:13:20 2025', '处理了数学专家的回答 - Tue Mar 25 16:13:20 2025', '查询已分类为: 历史 - Tue Mar 25 16:13:20 2025', '专家(历史)正在思考: Tue Mar 25 16:13:21 2025', '专家(历史)提供答案: Tue Mar 25 16:13:21 2025', '处理了历史专家的回答 - Tue Mar 25 16:13:21 2025']})
((), {'query': '什么是勾股定理?', 'expert_type': '数学', 'expert_answer': '从历史角度: 古代中国的四大发明是什么?可以追溯到历史事件...', 'final_answer': '根据历史专家的意见: 从历史角度: 古代中国的四大发明是什么?可以追溯到历史事件...', 'all_logs': ['查询已分类为: 数学 - Tue Mar 25 16:13:19 2025', '专家(数学)正在思考: Tue Mar 25 16:13:20 2025', '专家(数学)提供答案: Tue Mar 25 16:13:20 2025', '处理了数学专家的回答 - Tue Mar 25 16:13:20 2025', '查询已分类为: 历史 - Tue Mar 25 16:13:20 2025', '专家(历史)正在思考: Tue Mar 25 16:13:21 2025', '专家(历史)提供答案: Tue Mar 25 16:13:21 2025', '处理了历史专家的回答 - Tue Mar 25 16:13:21 2025', '查询已分类为: 数学 - Tue Mar 25 16:13:21 2025']})
(('数学专家:95f084dc-710e-b1ba--',), {'question': '什么是勾股定理?', 'thoughts': '', 'answer': '', 'expertise': '数学', 'logs': []})
(('数学专家:95f084dc-710e-b1ba--',), {'question': '什么是勾股定理?', 'thoughts': '作为数学专家,我需要考虑什么是勾股定理?...', 'answer': '', 'expertise': '数学', 'logs': ['专家(数学)正在思考: Tue Mar 25 16:13:22 2025']})
(('数学专家:95f084dc-710e-b1ba--',), {'question': '什么是勾股定理?', 'thoughts': '作为数学专家,我需要考虑什么是勾股定理?...', 'answer': '从数学角度: 什么是勾股定理?的答案是基于数学原理...', 'expertise': '数学', 'logs': ['专家(数学)正在思考: Tue Mar 25 16:13:22 2025', '专家(数学)提供答案: Tue Mar 25 16:13:22 2025']})
((), {'query': '什么是勾股定理?', 'expert_type': '数学', 'expert_answer': '从数学角度: 什么是勾股定理?的答案是基于数学原理...', 'final_answer': '根据历史专家的意见: 从历史角度: 古代中国的四大发明是什么?可以追溯到历史事件...', 'all_logs': ['查询已分类为: 数学 - Tue Mar 25 16:13:19 2025', '专家(数学)正在思考: Tue Mar 25 16:13:20 2025', '专家(数学)提供答案: Tue Mar 25 16:13:20 2025', '处理了数学专家的回答 - Tue Mar 25 16:13:20 2025', '查询已分类为: 历史 - Tue Mar 25 16:13:20 2025', '专家(历史)正在思考: Tue Mar 25 16:13:21 2025', '专家(历史)提供答案: Tue Mar 25 16:13:21 2025', '处理了历史专家的回答 - Tue Mar 25 16:13:21 2025', '查询已分类为: 数学 - Tue Mar 25 16:13:21 2025', '专家(数学)正在思考: Tue Mar 25 16:13:22 2025', '专家(数学)提供答案: Tue Mar 25 16:13:22 2025']})
((), {'query': '什么是勾股定理?', 'expert_type': '数学', 'expert_answer': '从数学角度: 什么是勾股定理?的答案是基于数学原理...', 'final_answer': '根据数学专家的意见: 从数学角度: 什么是勾股定理?的答案是基于数学原理...', 'all_logs': ['查询已分类为: 数学 - Tue Mar 25 16:13:19 2025', '专家(数学)正在思考: Tue Mar 25 16:13:20 2025', '专家(数学)提供答案: Tue Mar 25 16:13:20 2025', '处理了数学专家的回答 - Tue Mar 25 16:13:20 2025', '查询已分类为: 历史 - Tue Mar 25 16:13:20 2025', '专家(历史)正在思考: Tue Mar 25 16:13:21 2025', '专家(历史)提供答案: Tue Mar 25 16:13:21 2025', '处理了历史专家的回答 - Tue Mar 25 16:13:21 2025', '查询已分类为: 数学 - Tue Mar 25 16:13:21 2025', '专家(数学)正在思考: Tue Mar 25 16:13:22 2025', '专家(数学)提供答案: Tue Mar 25 16:13:22 2025', '处理了数学专家的回答 - Tue Mar 25 16:13:22 2025']})

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献31条内容

所有评论(0)