Python爬虫:豆瓣读书数据的智能挖掘与分析
豆瓣读书爬虫:用Python挖掘书海中的宝藏
大家好,今天咱们来聊聊怎么用Python这把“铲子”去豆瓣读书的大海里挖宝藏——也就是那些有价值的书籍数据。你是不是也有过这样的烦恼:书山有路勤为径,但书海无涯苦作舟,想找本好书犹如大海捞针。别急,咱们这就来一步步教你怎么用Python爬虫技术,把豆瓣上的好书一网打尽,还能顺便做个小分析,看看大家都在看啥。
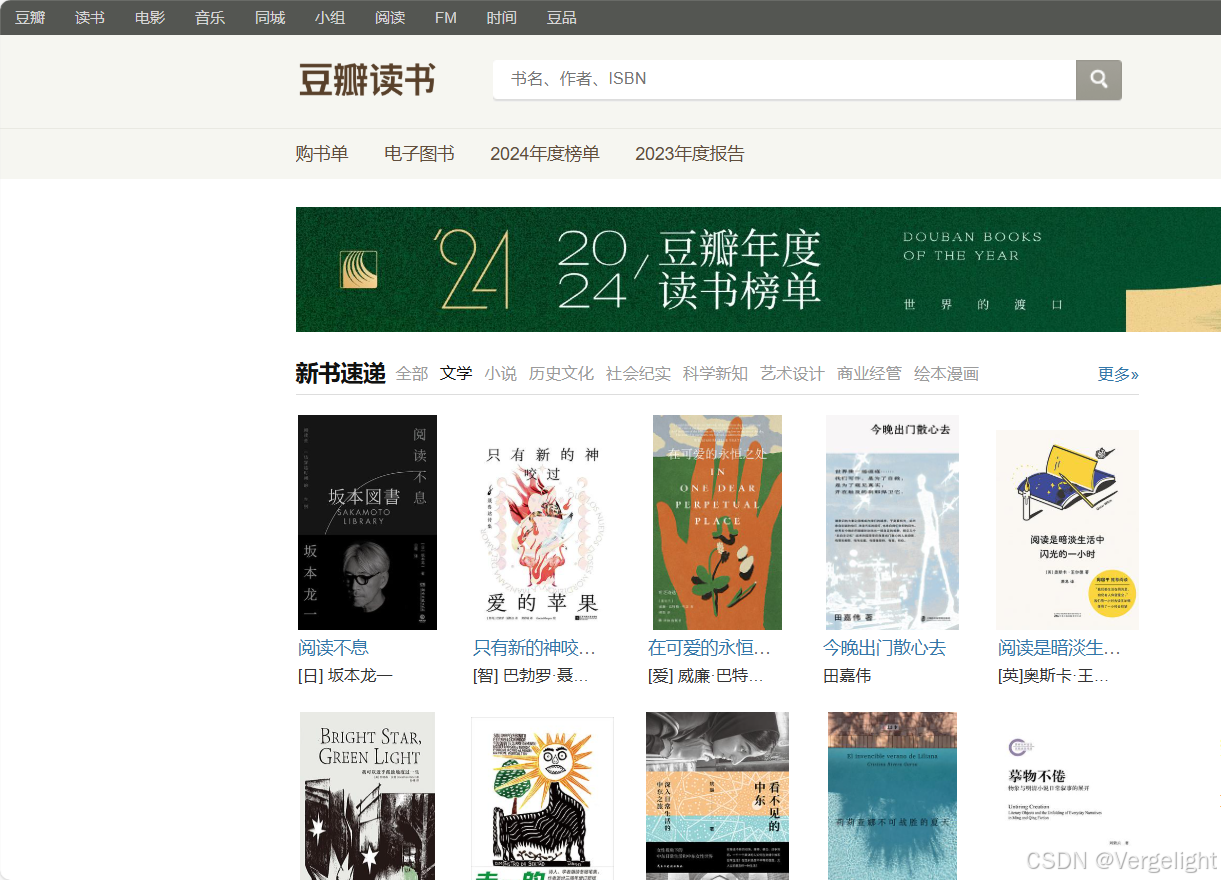
豆瓣读书数据的含金量
豆瓣读书上的数据,那可是金矿啊。书名、作者、评分、评论,这些信息对于咱们爱书人来说,简直就是选书的指南针。出版社可以用它来决定出版啥书,作者可以看看自己的书受不受待见,书店可以据此进货,咱们读者也能挑到心仪的书。
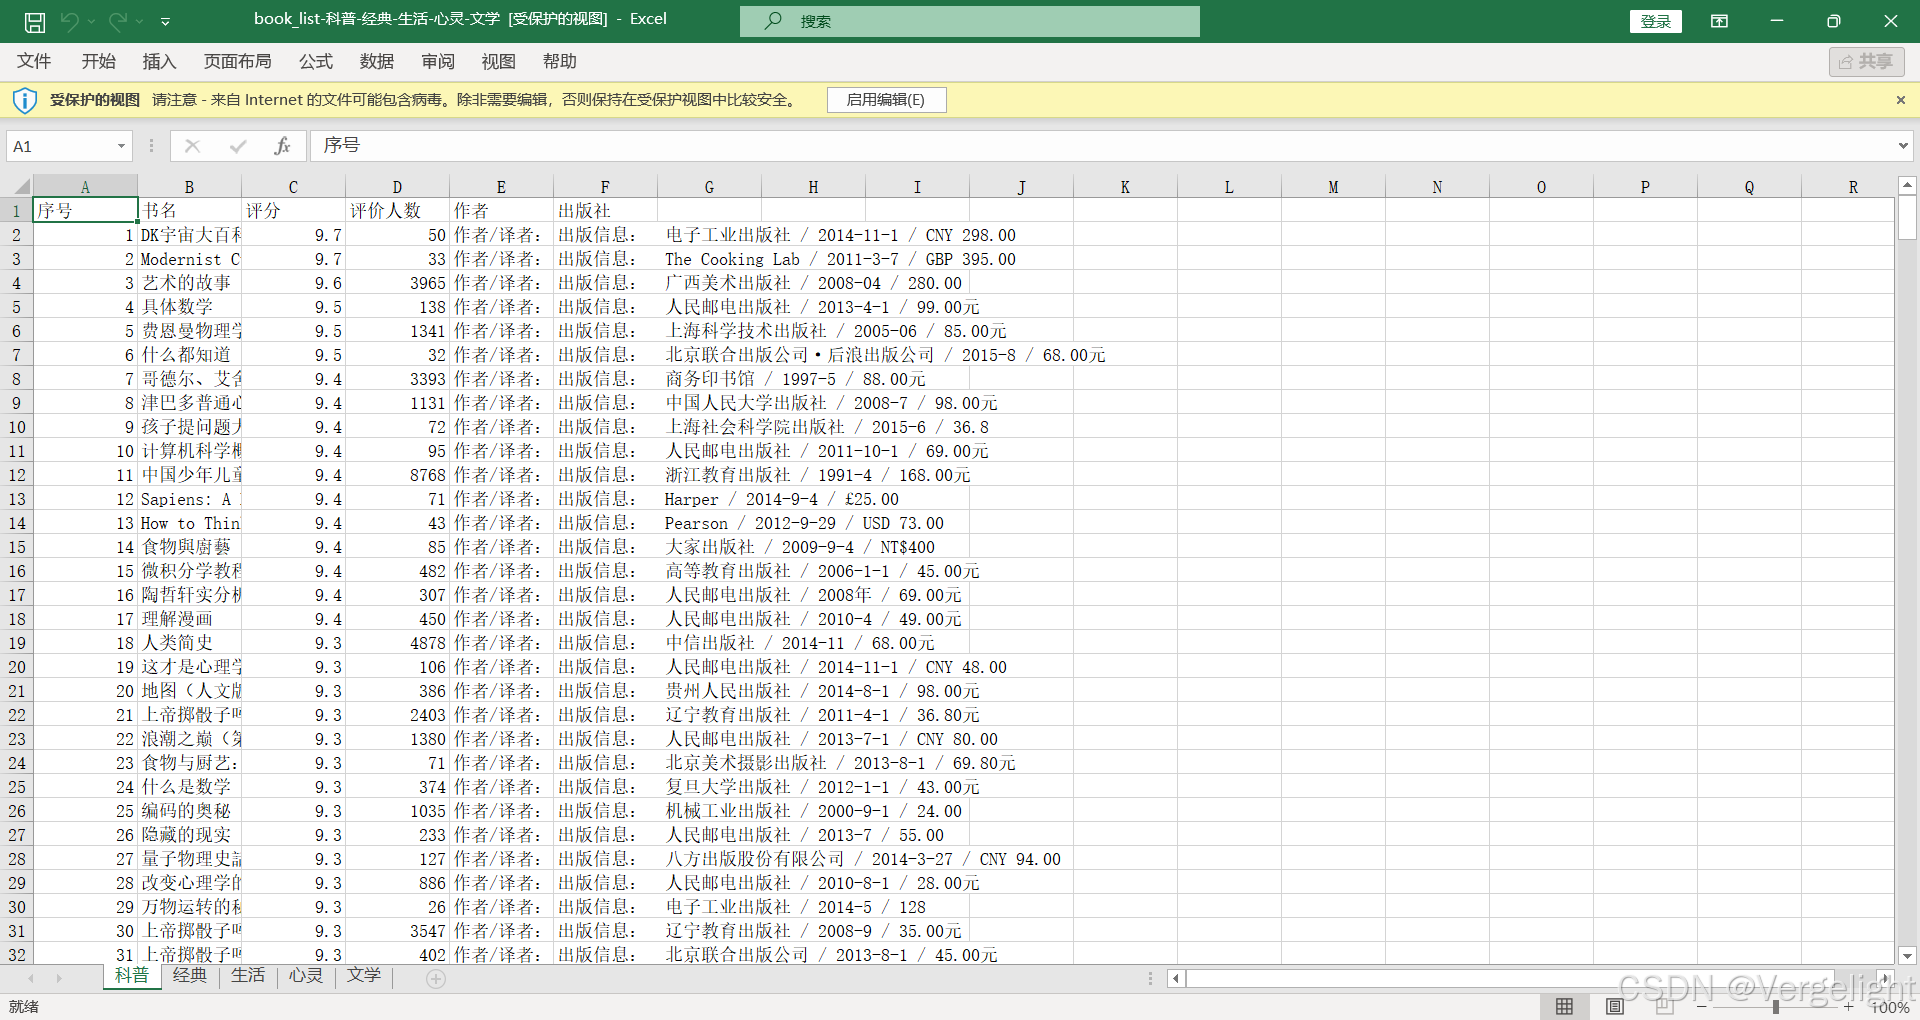
Python爬虫:技术的力量
说到爬虫,你可能觉得这是高深莫测的技术活儿,但其实没那么复杂。咱们用Python的几个小工具,比如requests去请求网页,BeautifulSoup来扒开网页的外衣找到咱们想要的数据,最后用pandas来整理整理这些数据,就能开始分析了。
数据分析:让数据说话
拿到数据后,咱们可以做的事情可多了。比如,看看哪些书评分高,哪些书人气旺,哪些作者的书迷多,甚至还能看看书名里哪些词儿最常见。这些分析,不仅能帮咱们找到好书,还能帮咱们了解书市的风向。
引发讨论:大家一起来
1. 书的价值: 你觉得豆瓣读书的数据对咱们有啥用?比如,书店老板能不能用这些数据来决定进啥书?
2. 爬虫的边界: 咱们用爬虫技术的时候,是不是也得注意别越界?你怎么看爬虫的道德和法律边界?
3. 隐私保护: 咱们在扒数据的时候,怎么保护那些书评人的隐私?你有啥好主意?
Python爬虫代码展示
# -*- coding: UTF-8 -*-

import sys
import time
import urllib
import urllib2
import requests
import numpy as np
from bs4 import BeautifulSoup
from openpyxl import Workbook

# 重新加载sys模块,设置默认编码为utf8
reload(sys)
sys.setdefaultencoding('utf8')

# 定义一些用户代理,用于模拟不同的浏览器访问
hds = [
    {'User-Agent': 'Mozilla/5.0 (Windows; U; Windows NT 6.1; en-US; rv:1.9.1.6) Gecko/20091201 Firefox/3.5.6'},
    {'User-Agent': 'Mozilla/5.0 (Windows NT 6.2) AppleWebKit/535.11 (KHTML, like Gecko) Chrome/17.0.963.12 Safari/535.11'},
    {'User-Agent': 'Mozilla/5.0 (compatible; MSIE 10.0; Windows NT 6.2; Trident/6.0)'}
]

# 定义爬取书籍信息的函数
def book_spider(book_tag):
    page_num = 0  # 初始化页数
    book_list = []  # 存储书籍信息的列表
    try_times = 0  # 尝试请求的次数

    # 循环爬取每一页的书籍信息
    while True:
        # 构造URL,爬取特定标签下的书籍
        url = 'http://www.douban.com/tag/' + urllib.quote(book_tag) + '/book?start=' + str(page_num * 15)
        time.sleep(np.random.rand() * 5)  # 随机等待一段时间,避免请求过快

        try:
            # 使用urllib2发送请求,模拟不同的用户代理
            req = urllib2.Request(url, headers=hds[page_num % len(hds)])
            source_code = urllib2.urlopen(req).read()
            plain_text = str(source_code)
        except (urllib2.HTTPError, urllib2.URLError) as e:
            print(e)
            continue

        # 解析HTML,提取书籍信息
        soup = BeautifulSoup(plain_text)
        list_soup = soup.find('div', {'class': 'mod book-list'})

        # 如果没有找到书籍列表或尝试次数过多,则退出循环
        try_times += 1
        if list_soup is None and try_times < 200:
            continue
        elif list_soup is None or len(list_soup) <= 1:
            break

        # 提取每本书的信息
        for book_info in list_soup.findAll('dd'):
            title = book_info.find('a', {'class': 'title'}).string.strip()
            desc = book_info.find('div', {'class': 'desc'}).string.strip()
            desc_list = desc.split('/')
            book_url = book_info.find('a', {'class': 'title'}).get('href')

            # 提取作者、出版信息、评分和评价人数
            try:
                author_info = '作者/译者: ' + '/'.join(desc_list[0:-3])
            except:
                author_info = '作者/译者: 暂无'
            try:
                pub_info = '出版信息: ' + '/'.join(desc_list[-3:])
            except:
                pub_info = '出版信息: 暂无'
            try:
                rating = book_info.find('span', {'class': 'rating_nums'}).string.strip()
            except:
                rating = '0.0'
            try:
                people_num = get_people_num(book_url)
                people_num = people_num.strip('人评价')
            except:
                people_num = '0'

            # 将书籍信息添加到列表中
            book_list.append([title, rating, people_num, author_info, pub_info])
            try_times = 0  # 重置尝试次数
        page_num += 1
        print('Downloading Information From Page %d' % page_num)
    return book_list

# 定义获取评价人数的函数
def get_people_num(url):
    try:
        # 发送请求,获取书籍详情页的HTML
        req = urllib2.Request(url, headers=hds[np.random.randint(0, len(hds))])
        source_code = urllib2.urlopen(req).read()
        plain_text = str(source_code)
    except (urllib2.HTTPError, urllib2.URLError) as e:
        print(e)
    soup = BeautifulSoup(plain_text)
    # 提取评价人数
    people_num = soup.find('div', {'class': 'rating_sum'}).findAll('span')[1].string.strip()
    return people_num

# 定义主函数,用于爬取多个标签下的书籍信息
def do_spider(book_tag_lists):
    book_lists = []
    for book_tag in book_tag_lists:
        book_list = book_spider(book_tag)
        book_list = sorted(book_list, key=lambda x: x[1], reverse=True)
        book_lists.append(book_list)
    return book_lists

# 定义将书籍信息打印到Excel文件的函数
def print_book_lists_excel(book_lists, book_tag_lists):
    wb = Workbook(optimized_write=True)
    ws = []
    for i in range(len(book_tag_lists)):
        ws.append(wb.create_sheet(title=book_tag_lists[i].decode()))  # 将utf8编码转换为unicode
    for i in range(len(book_tag_lists)):
        ws[i].append(['序号', '书名', '评分', '评价人数', '作者', '出版社'])
        count = 1
        for bl in book_lists[i]:
            ws[i].append([count, bl[0], float(bl[1]), int(bl[2]), bl[3], bl[4]])
            count += 1
    save_path = 'book_list'
    for i in range(len(book_tag_lists)):
        save_path += ('-' + book_tag_lists[i].decode())
    save_path += '.xlsx'
    wb.save(save_path)
结语
咱们这篇文章,就是想用Python这把“铲子”,带大家一起去豆瓣读书的大海里挖挖看。不仅能学到技术,还能一起探讨数据背后的意义。希望这篇文章能引发大家的讨论,咱们一起探索数据的奥秘。
记住,咱们这篇文章和代码,都是用来学习和研究的,真的用的时候,还得遵守豆瓣的规矩和法律。咱们一起努力,让技术更好地服务于生活,同时也保护每个人的权益。
大家怎么看?欢迎在评论区留下你的高见,咱们一起讨论讨论。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)