Snomed2Vec:将传统词嵌入范式转变为图嵌入范式,通过知识图谱捕捉医疗概念的多维关系
Snomed2Vec:将传统词嵌入范式转变为图嵌入范式,通过知识图谱捕捉医疗概念的多维关系
代码:https://gitlab.com/agarwal.khushbu/Snomed2Vec
论文大纲
├── 1 研究背景【研究动机】
│      ├── 医疗深度学习应用需求【现状描述】
│      └── 医疗数据向量表示的重要性【技术需求】
│
├── 2 相关工作【研究基础】
│      ├── 早期研究【发展历程】
│      │      ├── Word2Vec在医学文本中的应用【技术应用】
│      │      └── 临床文本处理【应用场景】
│      └── 最新进展【技术现状】
│             ├── Med2Vec:基于电子病历的表示学习【技术方案】
│             └── CUI2Vec:多源数据融合的向量表示【技术方案】
│
├── 3 主要贡献【研究价值】
│      ├── 基于SNOMED-CT的向量表示学习【创新点】
│      │      ├── Node2vec:随机游走连接性【技术特点】
│      │      ├── Metapath2vec:多关系属性【技术特点】
│      │      └── Poincaré:超球面层次结构【技术特点】
│      ├── 性能优势【研究成果】
│      │      ├── 概念相似度提升5-6倍【具体指标】
│      │      └── 患者诊断准确率提升6-20%【具体指标】
│      └── 开源贡献【实践价值】
│             ├── 代码开源【应用支持】
│             └── 30万医学概念预训练向量【资源共享】
│
├── 4 实验评估【研究验证】
│      ├── 图质量评估【评估维度】
│      │      ├── 多标签分类【评估任务】
│      │      └── 链接预测【评估任务】
│      └── 领域任务评估【评估维度】
│             ├── 概念相似度【评估任务】
│             └── 患者状态预测【评估任务】
│
└── 5 实验结果【研究结论】
├── Poincaré表现最优【结果分析】
│      ├── 节点类型分类准确率最高【具体表现】
│      └── 患者状态预测效果最好【具体表现】
└── Node2vec优势明显【结果分析】
├── 链接预测准确率最高【具体表现】
└── 概念相似度评估最优【具体表现】
理解
- 背景和问题:
- 类别问题:医疗深度学习应用中的数据表示问题
- 具体问题:将离散的医疗数据(如诊断代码、药物代码)转换为连续向量空间的表示方法
- 痛点:现有方法主要依赖电子病历或医疗索赔数据集,这些数据集分布有限且难以获取
- 概念性质:
- 本质:是一种医学概念的向量表示学习方法
- 形成原因:医疗知识图谱SNOMED-CT提供了丰富的概念关系网络结构
- 特点:能够捕获医学概念之间的层次关系和语义关联
- 对比案例:
- 正例:通过Node2vec方法在概念相似度任务上比现有方法提升5-6倍
- 反例:Med2vec仅能处理27,523个ICD-9概念,而本文方法可处理超过30万个医学概念
-
类比理解:
就像地图导航系统需要将现实世界的地理位置转换为经纬度坐标才能进行计算一样,医疗AI系统也需要将复杂的医学概念转换为计算机可以理解的向量形式。 -
概念介绍与总结:
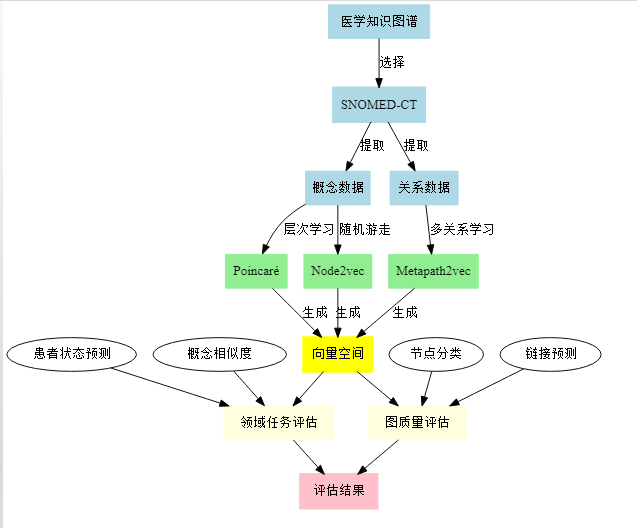
Snomed2Vec是一种基于知识图谱的医学概念向量表示方法,它通过三种不同的图嵌入算法(Node2vec、Metapath2vec、Poincaré)来学习医学概念的向量表示,使得计算机能够更好地理解和处理医学概念之间的关系。 -
概念重组:
“向量表示学习"可以重组为"学习医学概念在向量空间中的表示方法,使其具备可计算性”。 -
上下文关联:
本研究是对现有医学概念向量表示方法的改进,通过利用公开的知识图谱资源,解决了数据可获取性和可重复性的问题。 -
规律发现:
主要矛盾:医疗数据的离散性与深度学习需要连续向量表示之间的矛盾
次要矛盾:
- 数据获取难度与研究可重复性的矛盾
- 计算效率与表示准确性的矛盾
- 模型复杂度与实际应用的矛盾
- 功能分析:
核心功能:将离散的医学概念转换为连续的向量表示
定量指标:
- 概念相似度提升:5-6倍
- 患者诊断准确率提升:6-20%
- 可处理概念数量:超过30万个医学概念
- 来龙去脉梳理:
- 起因:深度学习在医疗领域应用需要连续向量表示
- 发展:从简单的文本嵌入发展到基于电子病历的表示学习
- 现状:现有方法依赖难以获取的数据集
- 创新:利用公开医学知识图谱SNOMED-CT进行向量表示学习
- 结果:在多个评估任务上显著优于现有方法
- 意义:提供了一个开源的、可重复的医学概念向量表示解决方案
1. 确认目标
如何构建一个高质量、可复现的医学概念向量表示模型?
2. 分析过程(目标-手段分析)
-
如何获取可靠的医学概念数据?
- 使用SNOMED-CT知识图谱作为数据源
- 包含超过30万个临床概念
- 提供标准化的医学术语和关系定义
-
如何学习医学概念之间的关系?
- Node2vec:捕获随机游走的连接性(随机游走捕捉节点连接性)
- Metapath2vec:学习多关系属性(元路径约束捕捉多重关系)
- Poincaré:在超球面空间学习层次结构(双曲空间学习层次结构)
-
如何评估模型的效果?
- 图质量评估:多标签分类、链接预测
- 领域任务评估:概念相似度、患者状态预测
- 与现有方法(Med2vec、CUI2vec)对比
3. 实现步骤
-
数据准备:
- 从UMLS提取SNOMED-CT子图
- 选择相关语义组:解剖、化学药物、疾病、医疗程序
-
模型实现:
- 实现三种图嵌入算法
- 生成不同维度(20-500)的向量表示
- 优化模型参数
-
评估验证:
- 设计多个评估任务
- 进行对照实验
- 分析性能指标
4. 效果展示
- 目标:提高医学概念向量表示的质量和可用性
- 过程:利用知识图谱和多种图嵌入算法
- 问题:现有方法依赖难获取的数据集
- 方法:基于SNOMED-CT的图嵌入学习
- 结果:
- 概念相似度提升5-6倍
- 患者诊断准确率提升6-20%
- 覆盖30万医学概念
- 开源代码和预训练向量
5. 领域金手指
知识图谱+图嵌入学习是该领域的金手指方案,可以应用于:
- 医疗信息检索:找到相似的医学概念
- 问答系统:理解医学概念间的关系
- 诊断支持:预测患者的诊断信息
- 药物研发:分析药物和疾病的关联
- 医疗数据集成:统一不同来源的医学术语
- 临床决策支持:提供相关的医学知识
- 医疗文献挖掘:理解文献中的医学概念关系
- 患者分组:基于诊断代码的相似性分析
这种方案的优势在于:
- 数据可获取性:基于公开知识图谱
- 可重复性:方法和数据都是开源的
- 可扩展性:支持不同类型的医学概念
- 性能优势:在多个任务上表现优异
全流程
患者状态预测的深度学习模型架构:
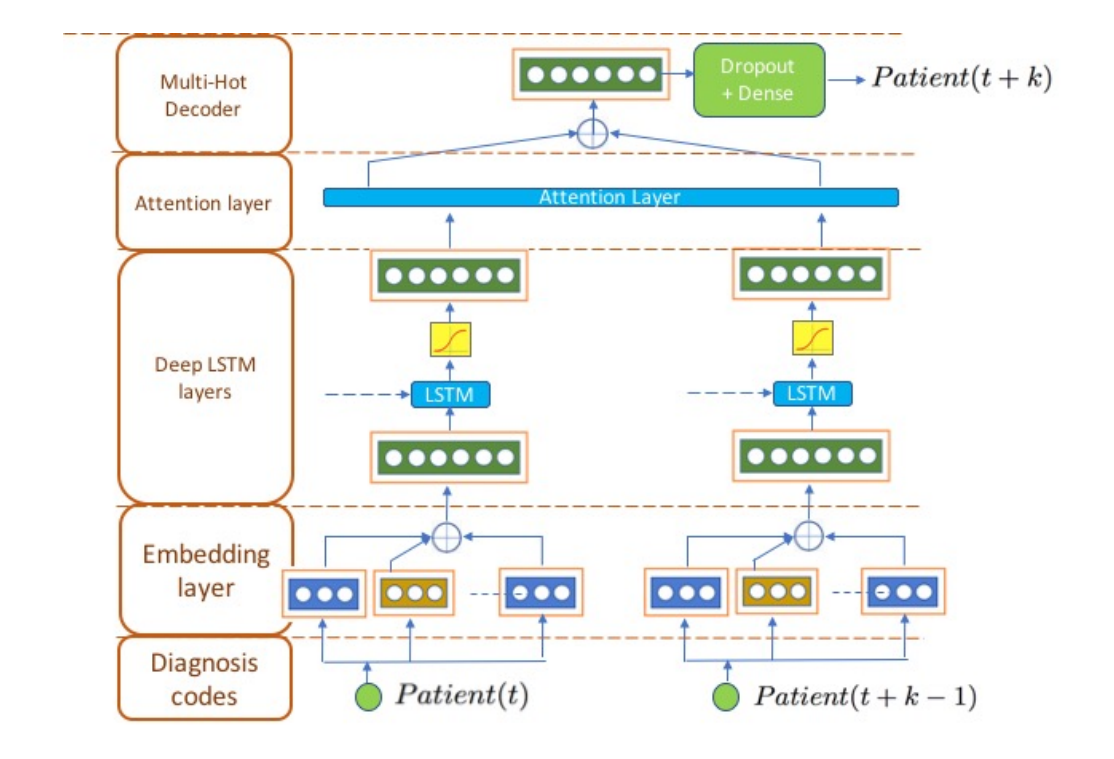
展示了用于预测诊断代码的深度学习模型结构:
组件从下到上:
- 底层:Diagnosis codes 诊断代码输入
- Embedding layer 嵌入层
- Deep LSTM layers 深度LSTM层
- Attention layer 注意力层
- Multi-Hot Decoder 多标签解码器
- 输出:Patient(t+k) 预测未来时刻的患者状态
图中展示了如何利用学习到的医疗概念嵌入进行患者状态预测,包括:
- 时序数据的处理方式
- 模型的层次结构
- 数据在各层间的传递路径
医学概念向量表示 = 知识图谱结构 + 图嵌入算法 + 评估框架

图嵌入算法 = Node2vec + Metapath2vec + Poincaré

评估性能 = 概念相似度 × 权重1 + 患者预测 × 权重2 + 链接预测 × 权重3
- 全流程优化
多题一解特征:
- 共同特征:医学概念的语义表示需求
- 通用解法:基于知识图谱的向量表示学习
- 适用场景:概念相似度计算、诊断预测、链接预测等任务
一题多解分析(以概念表示为例):
-
Word2vec解法
- 特征:文本共现关系
- 局限:忽略领域知识
-
Med2vec解法
- 特征:时序就诊记录
- 局限:数据获取困难
-
本文解法(Snomed2Vec)
- 特征:知识图谱结构
- 优势:开放获取、关系丰富
优化分析:
-
数据源优化:从私有数据到开放知识图谱
-
表示方法优化:
- Node2vec:优化随机游走策略
- Metapath2vec:加入关系类型信息
- Poincaré:利用超球面空间表示层次结构
-
评估体系优化:同时考虑图质量和领域应用
-
输入输出分析
输入:
- SNOMED-CT知识图谱
- 医学概念节点(>30万)
- 概念间关系
处理流程:
-
数据预处理:
- 概念提取
- 关系提取
- 图构建
-
向量学习:
- 随机游走采样
- 多关系路径生成
- 超球面映射
-
模型训练:
- 参数优化
- 损失函数最小化
- 向量更新
输出:
- 医学概念的向量表示
- 维度选择:20-500
- 应用于多种下游任务
- 性能评估结果
核心模式
- 问题模式
- 从离散到连续:医疗概念需要向量化表示
- 从封闭到开放:用公开知识库替代私有数据
- 从简单到复杂:需考虑概念间的层次和关系
- 解决方案模式
三种互补的嵌入方法分别对应不同目标:
- Node2vec → 捕捉节点间连接关系
- Metapath2vec → 学习多重语义关系
- Poincaré → 表示层次结构关系
- 验证模式
构建了完整的评估体系:
- 内在质量:节点分类、链接预测
- 语义理解:概念相似度
- 实际应用:患者状态预测
- 贡献模式
- 方法:开放数据 + 图嵌入学习
- 效果:5-6倍相似度提升 + 6-20%诊断改进
- 影响:开源代码 + 预训练模型
创新点
将传统词嵌入范式转变为图嵌入范式,通过知识图谱捕捉医疗概念的多维关系,实现了:
- 数据基础的突破:从私有EHR数据转向开放SNOMED-CT
- 表示方法的突破:从词共现统计转向图结构学习
- 评估体系的突破:从单一指标转向多维度验证
解法拆解
1. 逻辑关系拆解
目的:构建更好的医疗概念向量表示方法
问题:现有方法依赖私有数据,缺乏可重复性,无法充分表达概念间的复杂关系
【解法】= Snomed2Vec框架
子解法1:基于知识图谱的数据基础(因为数据可获取性和覆盖度特征)
- 之所以用 SNOMED-CT 知识图谱,是因为它是公开的、标准化的医疗术语体系,包含30万+概念
子解法2:多维度图嵌入学习(因为概念关系的多样性特征)
- 之所以用三种不同的图嵌入方法,是因为医疗概念之间存在连接性、多重关系、层次结构等不同类型的关系
- Node2vec:捕捉节点连接关系
- Metapath2vec:学习多类型关系
- Poincaré:表示层次结构
子解法3:多任务评估验证(因为应用场景的多样性特征)
- 之所以设计多个评估任务,是因为医疗概念表示需要在不同应用场景下都表现良好
例子:
在医疗问诊场景中:
- 知识图谱提供标准化的症状-疾病关系
- 多维度嵌入捕捉症状组合的临床意义
- 评估确保推理结果的准确性
2. 决策树形式的逻辑链
Snomed2Vec
├── 数据源选择
│   ├── 公开性 → SNOMED-CT
│   ├── 覆盖度 → 30万+概念
│   └── 标准化 → UMLS映射
│
├── 嵌入方法选择
│   ├── 连接性需求 → Node2vec
│   ├── 关系类型需求 → Metapath2vec
│   └── 层次结构需求 → Poincaré
│
└── 评估体系
    ├── 内在质量
    │   ├── 节点分类
    │   └── 链接预测
    │
    └── 外部应用
        ├── 概念相似度
        └── 患者诊断
1. 为什么需要向量表示?
为了在医疗领域应用深度学习,需要将离散的输入数据(如诊断码和药品码)转换为连续的向量空间表示。
这是因为深度学习模型无法直接处理离散的医疗编码,需要连续的向量表示来支持信息检索、问答系统、诊断支持和预测分析等应用。
2. 现有方法的局限性
论文指出Med2Vec和CUI2Vec存在两个主要问题:
- 数据可及性:基于EHR或医疗索赔数据集,这些数据集通常限制分发和访问
- 可重复性:由于无法访问原始数据,难以复现和理解这些嵌入是如何被数据集中的医疗概念覆盖率以及算法决策所影响的
3. 为什么选择SNOMED-CT?
论文给出几个关键原因:
- 公开可用:SNOMED-CT是一个公开的开放资源
- 覆盖广:提供超过30万个临床概念的覆盖
- 互操作性:基于UMLS,支持术语的映射和标准化
- 可重复性:便于研究结果的重现和验证
4. Node2vec的随机游走机制
论文解释Node2vec试图最小化如下损失函数:
Σvi,vj∈V(G) -log(pL(vj|vi))
其中pL(vj|vi)是从节点vi开始的长度为L的随机游走访问到节点vj的概率。
这种机制帮助捕捉医疗概念之间的邻域相关性。
5. Metapath2vec的元路径
论文提到Metapath2vec通过约束随机游走来体现多重关系属性。
元路径是一种预定义的路径模式,用于指导在异构网络中的随机游走,确保走过的路径具有特定的语义含义(如疾病-药物-疾病)。
7. 为什么使用双曲空间?
论文给出了明确解释:
- 许多真实数据集具有层次结构特征
- 相比欧氏空间,双曲空间更适合表示层次结构
- 在Poincaré球模型中,可以在熟悉的欧氏空间内模拟双曲空间
- 双曲空间中的距离计算考虑了节点在层次结构中的位置,更好地保持了概念间的层次关系
论文还给出了双曲空间中两点距离的计算公式:
d(u,v) = cosh^(-1)(1 + 2||u-v||^2/((1-||u||^2)(1-||v||^2)))
这种表示方法特别适合医疗概念的层次性组织结构。
打造医疗智能词典
Snomed2Vec 的核心工作是把医学概念(如症状、疾病、药物等)转换成向量,这样计算机就能更好地理解这些概念之间的关系。具体在医疗问诊中的应用:
- 向量表示学习
输入:医学术语"头痛"
输出:[0.2, 0.5, -0.3, ...] (多维向量)

好处:
- 相似的症状在向量空间中距离更近
- 相关的疾病、药物也会在向量空间中靠近
- 结构特征捕获
例如系统可以学到:
- "头痛" + "恶心" + "视物模糊" 常与"偏头痛"相关
- "头痛" + "发热" + "颈部僵硬" 可能提示"脑膜炎"
- "头痛" + "血压升高" 需要考虑"高血压性头痛"
- 实际应用场景
- 节点分类:识别症状属于哪类疾病
- 链接预测:预测症状之间的关联性
- 患者状态预测:基于历史症状预测疾病发展
总的来说,这个工作就像是给医学领域建立了一个"智能词典",不仅知道每个医学术语的含义,还能理解它们之间复杂的关联关系,从而帮助提升智能问诊的准确性。
关键创新点在于:它不是简单的关键词匹配,而是通过图结构学习到了更深层的医学知识关联。
让我系统梳理一下 Snomed2Vec 的完整流程:
1️⃣ 输入:
- SNOMED-CT 知识图谱数据,包含:
- 医学概念节点(症状、疾病、药物、解剖部位等)
- 概念间的关系(例如"is_a", "finding_site_of"等)
- 每个节点的语义类型(ANAT解剖学、DISO疾病等)
2️⃣ 处理过程:
Step 1: 图嵌入学习
- 使用三种方法:Node2vec/Metapath2vec/Poincaré
- 将图中的节点转换为低维向量
- 保持节点间的结构关系和语义关系

Step 2: 训练模型
- 使用三种任务训练和评估:
  * 节点分类:预测概念的类型
  * 链接预测:预测概念间是否存在关系
  * 患者状态预测:预测下一步可能出现的症状
3️⃣ 输出:
- 医学概念的向量表示(维度可选20-500)
- 这些向量编码了概念间的语义关系
4️⃣ 在医疗问诊中的应用环节:
1. 初始问诊阶段:
- 输入:患者描述的症状
- 应用:将症状转为向量,寻找相关症状

2. 辅助诊断阶段:
- 输入:症状组合
- 应用:推测可能的疾病

3. 病情发展预测:
- 输入:患者历史状态
- 应用:预测可能的并发症或后续症状
5️⃣ 核心优势:
- 不需要人工定义规则
- 能发现隐含的症状关联
- 可以处理复杂的多症状组合
这就像是一个会"思考"的医学词典,通过学习大量的医学知识关系,帮助医生进行更准确的诊断推理。
训练模型
Snomed2Vec 的训练:
- 目标:学习医学概念的向量表示
- 训练数据:SNOMED-CT 知识图谱
- 训练过程:使用图嵌入算法(如 Node2vec)学习节点的向量表示
- 输出:每个医学概念的向量
与大语言模型(如 Qwen)的区别:
- 训练目标不同:
- Snomed2Vec:学习概念间的结构关系
- Qwen:学习语言理解和生成
- 训练方法不同:
- Snomed2Vec:使用图算法(随机游走等)
- Qwen:使用 Transformer 架构和语言建模
- 数据规模不同:
- Snomed2Vec:仅使用医疗知识图谱
- Qwen:使用海量通用文本数据
所以 Snomed2Vec 更像是一个专门用于学习医学概念关系的"小模型",而不是通用的大语言模型。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 35
 0
- 0


 已为社区贡献31条内容

所有评论(0)