【自然语言处理|Transformer架构-06】:编码部分实现
·
1 编码器层部分
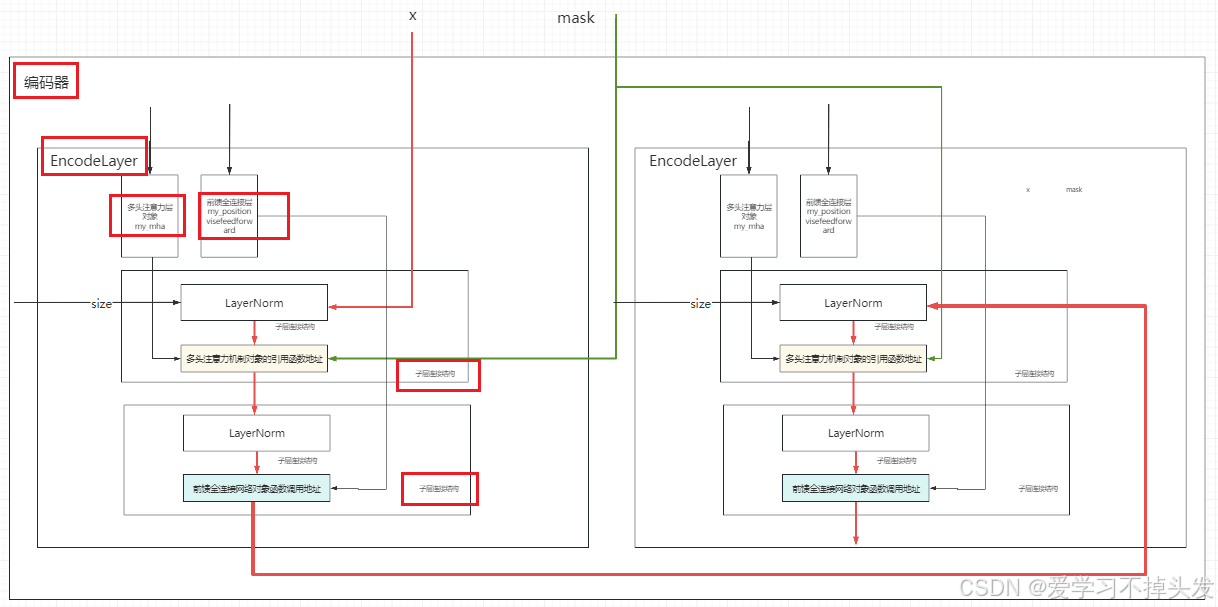
- 编码器层是编码器的组成单元(是编码部分的组成单元)
- 完成一次对输入特征的提取, 即编码过程
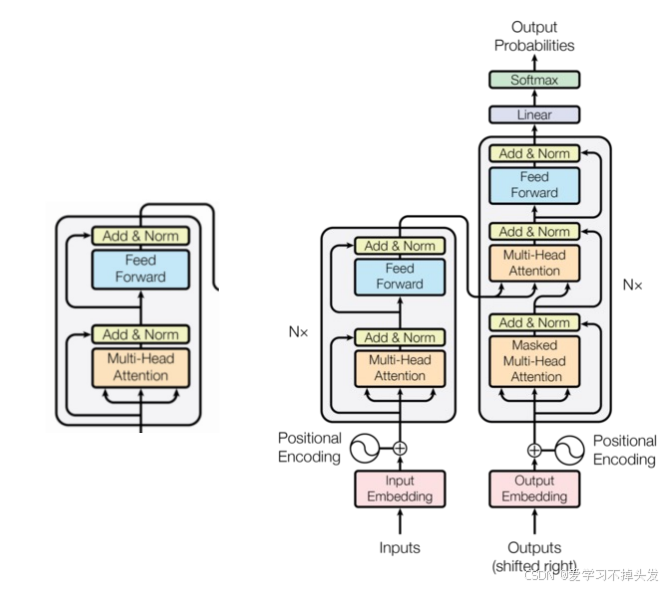
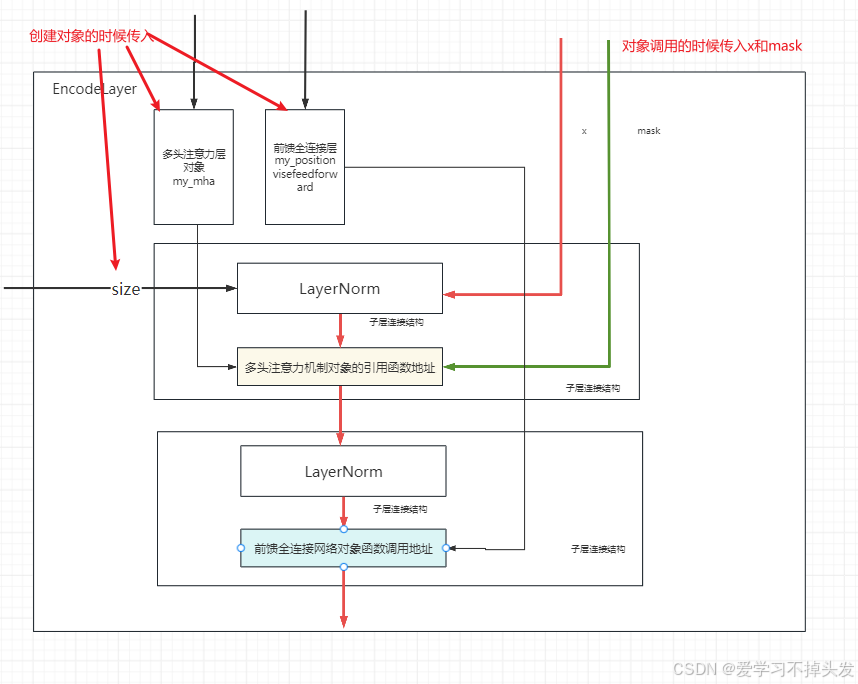
# 编码器层类 EncoderLayer 实现思路分析
# init函数 (self, size, self_attn, feed_forward, dropout):
    # 实例化多头注意力层对象self_attn # 前馈全连接层对象feed_forward  self.size词嵌入维度512
    # clones两个子层连接结构 self.sublayer = clones(SublayerConnection(size,dropout),2)
# forward函数 (self, x, mask)
    # 数据经过子层连接结构1 self.sublayer[0](x, lambda x: self.self_attn(x, x, x, mask))
    # 数据经过子层连接结构2 self.sublayer[1](x, self.feed_forward)
class EncoderLayer(nn.Module):
    def __init__(self, size, self_attn, feed_forward, dropout):
        super(EncoderLayer, self).__init__()

        # 实例化多头注意力层对象self_attn
        self.self_attn = self_attn

        # 前馈全连接层对象feed_forward
        self.feed_forward = feed_forward

        # size词嵌入维度512
        self.size = size

        # clones两个子层连接结构 self.sublayer = clones(SublayerConnection(size,dropout),2)
        self.sublayer = clones(SublayerConnection(size, dropout), 2)

    def forward(self, x, mask):

        # 数据经过第1个 子层连接结构
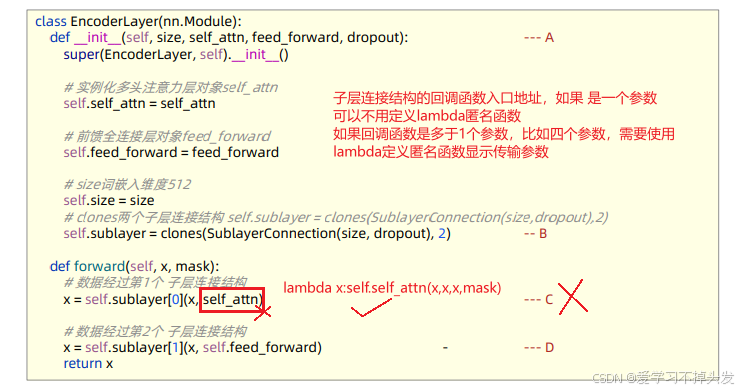
        x = self.sublayer[0](x, lambda x:self.self_attn(x, x, x, mask))
        # x = self.sublayer[0](x, self.self_attn) # 这样写掉不起来

        # 数据经过第2个 子层连接结构
        x = self.sublayer[1](x, self.feed_forward)
        return x


def dm07_test_EncoderLayer():

    # 1-1 准备数据
    pe_result = torch.randn(2, 4, 512)

    # 1-2 实例化多头注意力机制对象
    mask = Variable(torch.zeros(8, 4, 4))
    my_mha = MultiHeadedAttention(8, 512, 0.1)

    # 1-3 实例化PositionwiseFeedForward
    d_model, d_ff = 512, 1024
    my_positionwisefeedforward = PositionwiseFeedForward(d_model, d_ff)

    # 实例化编码器层
    my_encoderlayer = EncoderLayer(512, my_mha, my_positionwisefeedforward, 0.1)
    print('my_encoderlayer-->', my_encoderlayer)

    el_result =  my_encoderlayer(pe_result, mask)
    print('el_result-->', el_result.shape)
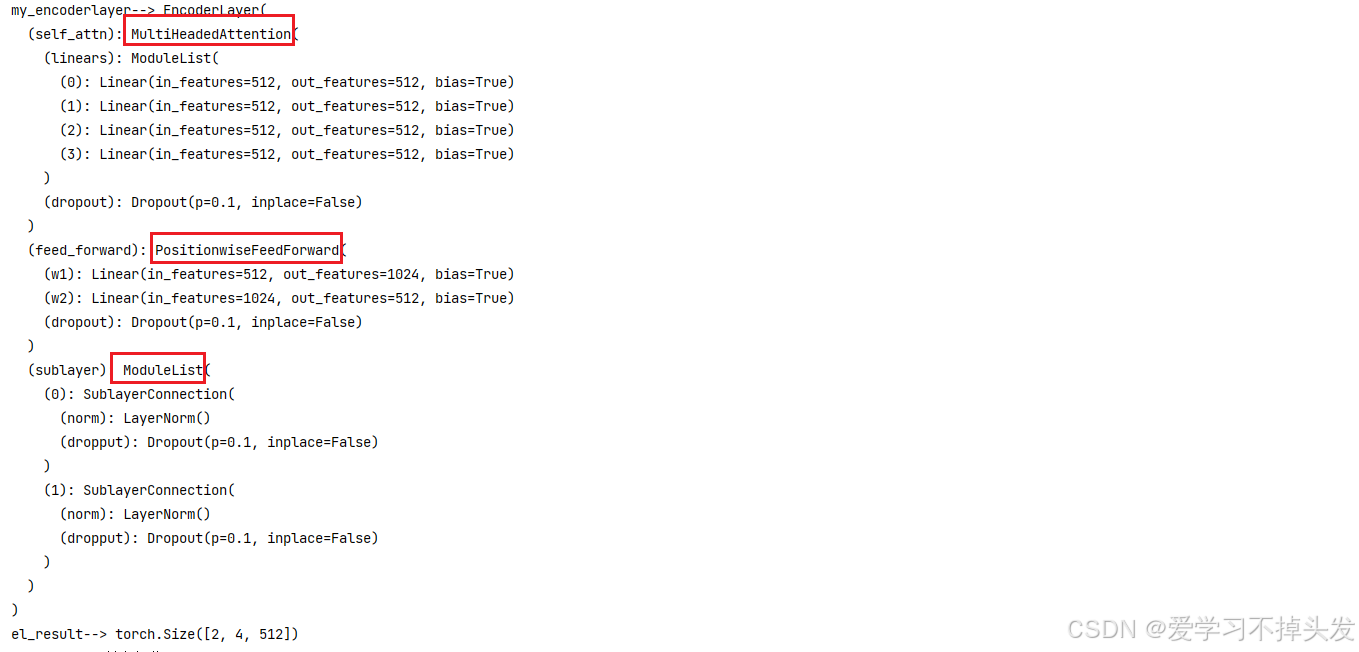
1.1 深拷贝多头注意力机制和前馈全连接传参
- 编码器层,在传入多头自注意力机制对象的时候,需要进行深拷贝,保证每个编码器层使用自己独立的my_mha对象,my_positionwisefeedforward对象;也就说每个层拥有自己独立自注意力层权重参数
# 实例化 一个 编码器层
c = copy.deepcopy
my_encoderlayer = EncoderLayer(512, c(my_mha), c(my_positionwisefeedforward), 0.1)
1.2 子层连接结构传参
2 编码器实现
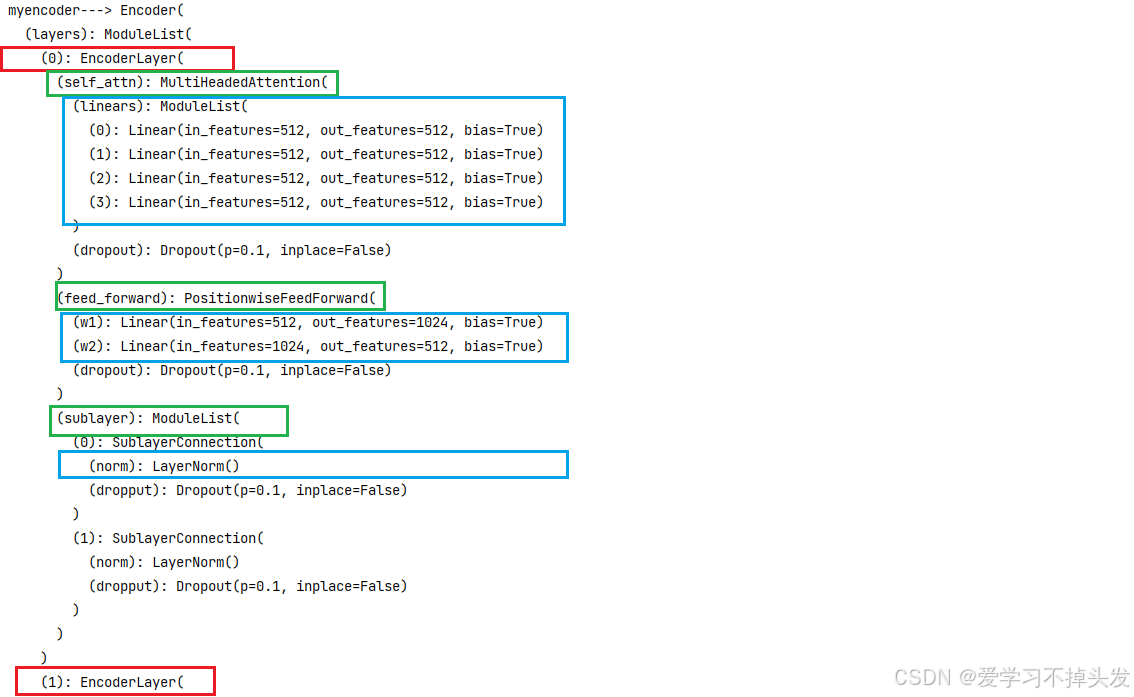
- 由N个编码器层堆叠而成
- 编码器用于对输入进行指定的特征提取过程, 也称为编码
# 编码器类 Encoder 实现思路分析
# init函数 (self, layer, N)  # 注意layerobj是一个实例化后的对象 super()
    # 实例化多个编码器层对象self.layers=clones(layer, N)
    # 实例化规范化层 self.norm = LayerNorm(layer.size)
# forward函数 (self, x, mask)
    # 数据经过N个层 x = layer(x, mask)
    #  返回规范化后的数据 return self.norm(x)
class Encoder(nn.Module):
    def __init__(self, layer, N):
        # layer 是一个实例化层的对象
        super(Encoder, self).__init__()

        # 实例化多个层
        self.layers = clones(layer, N)

        # 实例化规范化层
        self.norm = LayerNorm(layer.size)

    def forward(self, x, mask):

        # 数据经过N个层 x = layer(x, mask)
        for layer in self.layers:
            x = layer(x, mask)

        #  返回规范化后的数据
        #  使用前置norm策略,在最后一个层输出的数据 需要 添加一个norm处理
        return self.norm(x)


def dm08_test_Encoder():
    c = copy.deepcopy

    # 1-1 准备数据
    pe_result = torch.randn(2, 4, 512)

    # 1-2 实例化多头注意力机制对象
    mask = Variable(torch.zeros(8, 4, 4))
    my_mha = MultiHeadedAttention(8, 512, 0.1)

    # 1-3 实例化PositionwiseFeedForward
    d_model, d_ff = 512, 1024
    my_positionwisefeedforward = PositionwiseFeedForward(d_model, d_ff)

    # 实例化 一个 编码器层
    my_encoderlayer = EncoderLayer(512, c(my_mha), c(my_positionwisefeedforward), 0.1)


    # 实例化编码器部分
    myencoder = Encoder(my_encoderlayer, 6)
    print('myencoder--->', myencoder)

    # 给模型喂数据
    encoder_result = myencoder(pe_result, mask)
    print('encoder_result--->', encoder_result.shape, encoder_result)
3 解码器层部分
- 是解码器的组成单元
- 每个解码器层根据给定的输入向目标方向进行特征提取操作,即解码过程
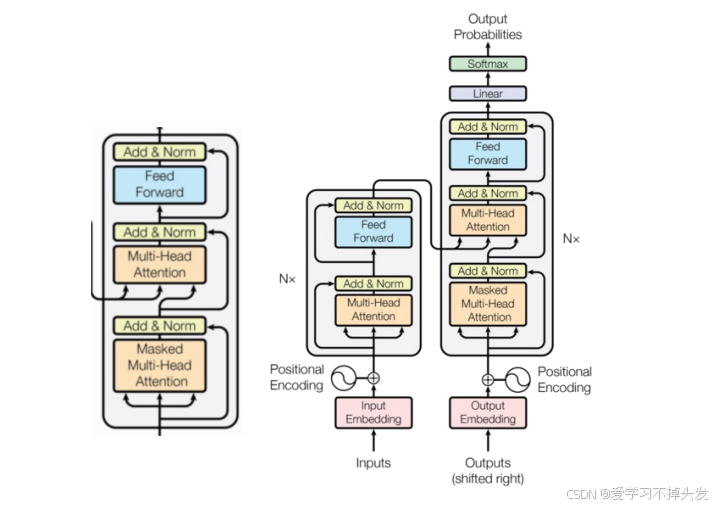
# 解码器层类 DecoderLayer 实现思路分析
# init函数 (self, size, self_attn, src_attn, feed_forward, dropout)
    # 词嵌入维度尺寸大小size 自注意力机制层对象self_attn 一般注意力机制层对象src_attn 前馈全连接层对象feed_forward
    # clones3子层连接结构 self.sublayer = clones(SublayerConnection(size,dropout),3)
# forward函数 (self, x, memory, source_mask, target_mask)
    # 数据经过子层连接结构1 self.sublayer[0](x, lambda x:self.self_attn(x, x, x, target_mask))
    # 数据经过子层连接结构2 self.sublayer[1](x, lambda x:self.src_attn(x, m, m, source_mask))
    # 数据经过子层连接结构3 self.sublayer[2](x, self.feed_forward)
class DecoderLayer(nn.Module):

    def __init__(self, size, self_attn, src_attn, feed_forward, dropout):

        super(DecoderLayer, self).__init__()
        # 词嵌入维度尺寸大小size
        self.size = size

        # 自注意力机制层对象 self_attn
        self.self_attn = self_attn

        # 一般注意力机制层对象 src_attn
        self.src_attn = src_attn

        # 前馈全连接层对象 feed_forward
        self.feed_forward = feed_forward

        # clones3子层连接结构 self.sublayer = clones(SublayerConnection(size,dropout),3)
        self.sublayer = clones(SublayerConnection(size, dropout), 3)

    def forward(self, x, memory, source_mask, target_mask):
        m = memory
        # 数据经过子层连接结构1 self.sublayer[0](x, lambda x:self.self_attn(x, x, x, target_mask))
        x = self.sublayer[0](x, lambda x: self.self_attn(x, x, x, target_mask))

        # 数据经过子层连接结构2 self.sublayer[1](x, lambda x:self.src_attn(x, m, m, source_mask))
        x = self.sublayer[1](x, lambda x: self.src_attn(x, m, m, source_mask))

        # 数据经过子层连接结构3 self.sublayer[2](x, self.feed_forward)
        x = self.sublayer[2](x, self.feed_forward)
        return  x


def dm01_test_DecoderLayer():
    # 1-1 准备数据
    pe_result = torch.randn(2, 4, 512)

    # 1-2 实例化多头注意力机制对象
    source_mask = Variable(torch.zeros(8, 4, 4))
    target_mask = Variable(torch.zeros(8, 4, 4))
    self_attn = src_attn = MultiHeadedAttention(8, 512, 0.1)

    # 1-3 实例化PositionwiseFeedForward
    d_model, d_ff = 512, 1024
    ff = PositionwiseFeedForward(d_model, d_ff)

    # 实例化 一个 编码器层
    my_decoderlayer = DecoderLayer(512, self_attn, src_attn, ff, 0.1)
    print('my_decoderlayer--->', my_decoderlayer)

    # 准备编码器部分的最后编码结果 也就是中间语义张量C
    memory = torch.randn(2, 4, 512)

    dl_result = my_decoderlayer(pe_result, memory, source_mask, target_mask)
    print('dl_result--->', dl_result.shape, dl_result)
4 解码器实现
- 多个解码器层组成解码器(解码器部分)
- 根据编码器的结果以及上一次预测的结果, 对下一次可能出现的‘值’进行特征表示;
# 解码器类 Decoder 实现思路分析
# init函数 (self, layer, N): #  super()
    # self.layers clones N个解码器层clones(layer, N)
    # self.norm 定义规范化层 LayerNorm(layer.size)
# forward函数 (self, x, memory, source_mask, target_mask)
    # 数据以此经过各个子层  x = layer(x, memory, source_mask, target_mask)
    # 数据最后经过规范化层  return self.norm(x)
    # 返回处理好的数据

class Decoder(nn.Module):

    def __init__(self, layer, N):
        super(Decoder, self).__init__()

        # clone实例化解码器层
        self.layers = clones(layer, N)

        # 实例化规范化层
        self.norm = LayerNorm(layer.size)

    def forward(self, x, memory, source_mask, target_mask):

        # 让数据经过各个解码器层
        for layer in self.layers:
           x = layer(x, memory, source_mask, target_mask)

        return self.norm(x)


def dm02_test_Decoder():

    c = copy.deepcopy

    # 1-1 准备数据
    pe_result = torch.randn(2, 4, 512)

    # 1-2 实例化多头注意力机制对象
    source_mask = Variable(torch.zeros(8, 4, 4))
    target_mask = Variable(torch.zeros(8, 4, 4))
    self_attn = src_attn = MultiHeadedAttention(8, 512, 0.1)

    # 1-3 实例化PositionwiseFeedForward
    d_model, d_ff = 512, 1024
    ff = PositionwiseFeedForward(d_model, d_ff)

    # 实例化 一个 编码器层
    my_decoderlayer = DecoderLayer(512, c(self_attn), c(src_attn), c(ff), 0.1)
    print('my_decoderlayer--->', my_decoderlayer)

    # # 准备编码器部分的最后编码结果 也就是中间语义张量C
    memory = torch.randn(2, 4, 512)

    # 实例化解码器部分
    my_decoder = Decoder(my_decoderlayer, 6)
    print('my_decoder--->', my_decoder)

    # 让数据经过解码器部分
    decoder_result = my_decoder(pe_result, memory, source_mask, target_mask)
    print('decoder_result--->', decoder_result.shape, decoder_result)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献10条内容

所有评论(0)