凯旋归来!耗时45天,初步认识Python的爬虫基础信息 主撰写——小亦,副主编——于老师 (测试版2.0版本)字数7000+
本文章耗时32天,整理出了Python爬虫基础信息与代码样例,刚出炉为1.0测试版本过了10天后今天加强改进,如在测试版中发现一点小问题或知识性搞错,有可能是小亦写的时候脑子有点抽了,如发现联系博主,谢谢,耗时看完整个博文需1小时03分 主撰写——小亦 副主编——华南理工大学——于老师
建议边看边听:Visctory
配音师:hyl
带你玩转Python爬虫(胆小者勿进)千万别做坏事·······_python爬虫危险不-CSDN博客
上面是建议给大家更好的博文5%参考了 @阿玥的小东东博主
初步认识Python的爬虫
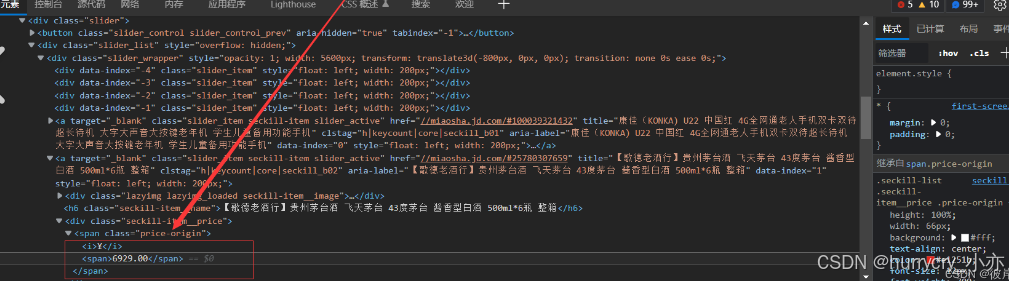
一、爬虫的概念与重要性
在大数据时代,数据成为许多公司和项目的核心资源。数据的来源多种多样,包括购买第三方数据、从免费数据网站下载、通过爬虫爬取数据以及人工收集数据等。在这些方法中,爬虫是一种高效且灵活的数据获取方式。
网络爬虫(又被称为网页蜘蛛、网络机器人)是模拟浏览器发送网络请求,接收请求响应,并按照一定的规则自动抓取互联网信息的程序。原则上,只要是浏览器(客户端)能做的事情,爬虫都能够做。爬虫技术广泛应用于搜索引擎、数据分析、机器学习等领域。
二、爬虫的分类与流程
-
爬虫的分类
- 通用爬虫:通常指搜索引擎的爬虫,如百度、谷歌等搜索引擎使用的爬虫,它们会爬取互联网上的大量网页信息。
- 聚焦爬虫:针对特定网站的爬虫,用于爬取特定网站或网页的数据。
-
爬虫的基本流程
- 发送请求:爬虫向目标网页发送请求,获取网页内容。
- 解析网页:从返回的网页内容中提取需要的信息。
- 保存数据:将提取到的信息保存到文件或数据库中,以便后续分析。
三、HTTP基本原理
-
URL
URL(Uniform Resource Locator)即统一资源定位符,用于唯一标识互联网上的资源。URL通常由协议、域名、端口、资源路径和查询参数等部分组成。
-
超文本
超文本是指通过超链接连接在一起的文本,网页就是一种超文本。网页的源代码是一系列HTML代码,包含了一系列标签,如
<img>显示图片,<p>指定显示段落等。 -
HTTP和HTTPS
- HTTP(Hyper Text Transfer Protocol)即超文本传输协议,用于在互联网上传输超文本数据。HTTP默认端口号是80。
- HTTPS(Hyper Text Transfer Protocol over Secure Socket Layer)是以安全为目标的HTTP协议,即HTTP下加入SSL层,简称为HTTPS。HTTPS默认端口号是443。
-
HTTP的请求过程
HTTP请求由客户端向服务端发出,可以分为四部分内容:请求方法(Request Method)、请求的网址(Request URL)、请求头(Request Headers)、请求体(Request Body)。常见的请求方法包括GET和POST。
HTTP响应由服务端返回给客户端,可以分为三部分:响应状态码(Response Status Code)、响应头(Response Headers)和响应体(Response Body)。响应状态码表示服务器的响应状态,如200代表服务器正常响应,404代表页面未找到,500代表服务器内部发生错误。
-
四、Python爬虫常用库与示例
-
requests库
requests库用于发送网络请求,获取网页内容。它是Python中非常流行的网络请求库,简单易用。
安装requests库:
-
pip install requests示例代码:
import requests

# 发送请求获取网页内容
url = 'https://www.baidu.com'
response = requests.get(url)

# 打印网页内容
print(response.text)
BeautifulSoup库
BeautifulSoup库用于解析网页内容,提取需要的数据。它支持多种解析器,如Python标准库中的html.parser,以及lxml和html5lib等第三方解析器。
安装BeautifulSoup库:
-
pip install beautifulsoup4from bs4 import BeautifulSoup # 解析网页内容 soup = BeautifulSoup(response.text, 'html.parser') # 获取标题 title = soup.title.text print('网页标题:', title)Selenium库
Selenium库用于处理JavaScript动态生成的内容。它可以像真实的用户一样与网页交互,如点击按钮、滚动页面等。
-
安装Selenium库:
-
pip install seleniumfrom selenium import webdriver # 设置浏览器驱动路径 driver = webdriver.Chrome() # 打开网页 driver.get('https://www.example.com') # 获取网页标题 print(driver.title) # 关闭浏览器 driver.quit()Scrapy框架
Scrapy是一个强大的爬虫框架,具有异步、高效的特点,适合用于构建复杂的爬虫。它包含了调度器、下载器、爬虫、实体管道和爬虫引擎等组件,可以方便地实现网页的爬取和数据的提取。
-
安装Scrapy框架: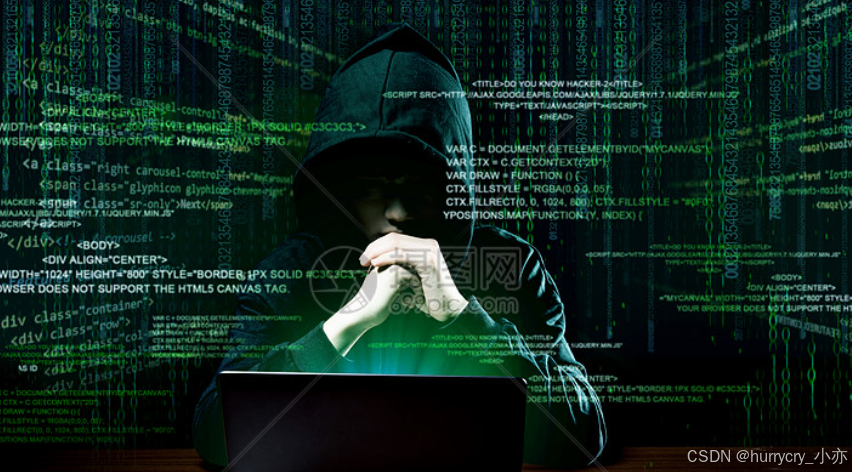
-
pip install scrapyScrapy项目的创建与运行:
-
scrapy startproject myproject cd myproject scrapy genspider myspider example.com scrapy crawl myspider -
爬虫常见问题及解决方案
-
网页反爬机制
有些网站不允许爬虫访问,通常会通过检测请求头或IP地址来防止爬虫访问。为了绕过这种限制,可以伪装成正常用户,添加请求头信息,如User-Agent等。
示例代码:
-
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
}
response = requests.get(url, headers=headers)
延迟访问
频繁访问某个网站可能会触发反爬机制,可以通过设置延迟避免这种问题。使用time.sleep()函数可以延迟发送下一个请求。
示例代码:
-
import time

# 延迟2秒后发送下一个请求
time.sleep(2)
代理IP 如果网站通过检测IP地址限制访问,可以使用代理IP。通过设置proxies参数,可以指定代理服务器来发送请求。 示例代码:数据保存与后续处理
-
保存到CSV文件
使用Python的csv模块可以将提取到的数据保存到CSV文件中。
示例代码:
-
import csv

# 保存数据到CSV文件
with open('data.csv', 'w', newline='', encoding='utf-8') as file:
    writer = csv.writer(file)
    writer.writerow(['标题', '链接'])  # 写入表头

    # 假设links是一个包含网页链接的列表
    for link in links:
        writer.writerow([link.text, link.get('href')])
保存到数据库
可以使用SQLite或其他数据库,将数据保存到数据库中。通过SQL语句可以方便地查询、更新和管理数据。
示例代码(使用SQLite):
import sqlite3

# 连接数据库(如果不存在会自动创建)
conn = sqlite3.connect('data.db')
cursor = conn.cursor()

# 创建表
cursor.execute('CREATE TABLE IF NOT EXISTS links (title TEXT, href TEXT)')

# 插入数据
for link in links:
    cursor.execute('INSERT INTO links (title, href) VALUES (?, ?)', (link.text, link.get('href')))

# 提交事务
conn.commit()

# 关闭数据库连接
conn.close()
、爬虫技术的进阶应用
-
分布式爬虫
随着互联网数据量的爆炸式增长,单机爬虫已无法满足大规模数据爬取的需求。分布式爬虫通过将任务分配到多台机器上并行处理,可以显著提高数据爬取的效率。
分布式爬虫的设计和实现需要考虑多个方面,如任务调度、数据去重、数据存储等。常见的分布式爬虫框架包括Scrapy-Redis等。
-
-
反爬机制的应对
网站的反爬机制越来越复杂,爬虫需要不断适应和应对。除了上述的伪装成正常用户、设置延迟和使用代理IP等方法外,还可以尝试使用不同的请求方式(如POST请求)、模拟用户行为(如点击按钮、滚动页面)等策略来绕过反爬机制。
-
数据清洗与预处理
爬取到的数据往往包含大量的噪声和冗余信息,需要进行清洗和预处理才能用于后续的分析和挖掘。数据清洗和预处理的方法包括去重、去噪、填充缺失值、数据标准化等。
-
爬虫技术的深入探索与应用
-
一、高级数据处理技术
-
数据清洗
- 缺失值处理:检查并处理数据中的缺失值,如填充缺失值或删除含有缺失值的记录。
- 异常值处理:识别并处理数据中的异常值,如通过设定阈值或使用统计方法过滤异常值。
- 数据标准化:将不同格式或单位的数据转换为统一的标准格式,以便后续分析。
-
数据整合
- 多源数据合并:将来自不同网站或数据库的数据进行合并,形成更全面的数据集。
- 数据去重:在合并数据时,需要去除重复的记录,确保数据的唯一性。
-
数据可视化
- 使用Python的matplotlib、seaborn等库,将爬取的数据进行可视化展示,以便更直观地分析数据。
-
动态加载内容的处理
- 对于使用JavaScript动态加载内容的网页,可以使用Selenium等浏览器自动化工具来模拟用户行为,如滚动页面、点击按钮等,以触发JavaScript的加载。
-
验证码的处理
- 对于需要输入验证码的网页,可以通过OCR(光学字符识别)技术来自动识别验证码,或者使用第三方服务来绕过验证码。
-
IP地址被封禁的处理
- 当爬虫被网站封禁IP地址时,可以使用代理IP池来不断更换IP地址,以避免被封禁。同时,也可以尝试降低爬虫的访问频率,以减轻对网站的负载。
-
搜索引擎
- 爬虫技术是搜索引擎的核心组成部分,用于爬取互联网上的网页信息,并构建索引库,以便用户能够快速地搜索到所需的信息。
-
数据分析
- 通过爬虫技术获取大量的数据,可以进行数据分析,以了解市场趋势、用户行为等。例如,电商网站可以使用爬虫技术获取竞争对手的价格信息,以制定更合理的定价策略。
-
舆情监测
- 通过爬虫技术获取社交媒体、新闻网站等的信息,可以进行舆情监测,以了解公众对某个事件或话题的看法和态度。
-
学术研究
- 在学术研究中,爬虫技术可以用于获取公开的学术数据,如论文、专利等,以支持研究工作的开展。
-
遵守法律法规
- 在爬取数据时,需要遵守相关的法律法规,如《中华人民共和国计算机信息网络国际联网管理暂行规定》等。不得爬取涉及个人隐私、商业机密等敏感信息。
-
尊重网站权益
- 在爬取数据时,需要尊重网站的权益,不得对网站的正常运营造成干扰或损害。同时,也需要遵守网站的robots.txt协议,以了解哪些内容是可以被爬取的。
-
合理使用数据
- 在使用爬取的数据时,需要合理使用数据,不得将数据用于非法用途或侵犯他人权益。同时,也需要保护数据的隐私和安全,防止数据泄露或被滥用。
那爬虫技术有哪些应用场景呢
爬虫技术的应用场景非常广泛,几乎涵盖了所有需要从互联网上大量获取数据的领域。以下是一些常见的应用场景:
- 搜索引擎:
- 爬虫技术是搜索引擎的核心,用于爬取互联网上的网页,构建索引,以便用户能够搜索到相关信息。
- 价格监测与比价:
- 电商网站、价格比较网站等使用爬虫技术来获取商品信息、价格等,以便进行价格监测、比价分析,为用户提供购物决策支持。
- 新闻聚合与舆情监测:
- 新闻网站、社交媒体平台等使用爬虫技术来聚合新闻资讯、监测舆情动态,为用户提供实时更新的信息。
- 数据挖掘与分析:
- 企业、研究机构等使用爬虫技术来获取市场数据、用户行为数据等,进行数据挖掘与分析,以支持决策制定。
- 学术研究与资料收集:
- 学者、研究人员等使用爬虫技术来收集学术文献、专利数据等,以支持学术研究与资料收集工作。
- 竞争情报分析:
- 企业使用爬虫技术来获取竞争对手的信息,如产品信息、营销策略等,以进行竞争情报分析。
- 网络安全与漏洞扫描:
- 网络安全公司使用爬虫技术来扫描互联网上的网站,检测潜在的安全漏洞,以提供安全服务与解决方案。
- 自动化测试与监控:
- 软件测试人员使用爬虫技术来模拟用户行为,进行自动化测试;同时,也可以用于监控网站的运行状态,及时发现并解决问题。
- 金融数据收集与分析:
- 金融机构使用爬虫技术来收集股票价格、汇率等金融数据,进行数据分析与预测。
- 旅游与出行信息获取:
- 旅游网站、出行服务平台等使用爬虫技术来获取航班、酒店、景点等信息,为用户提供便捷的旅游与出行服务。
需要注意的是,在使用爬虫技术时,需要遵守相关的法律法规与网站的使用协议,确保合法合规地获取数据。同时,也需要注重数据的隐私与安全保护,防止数据泄露或被滥用。
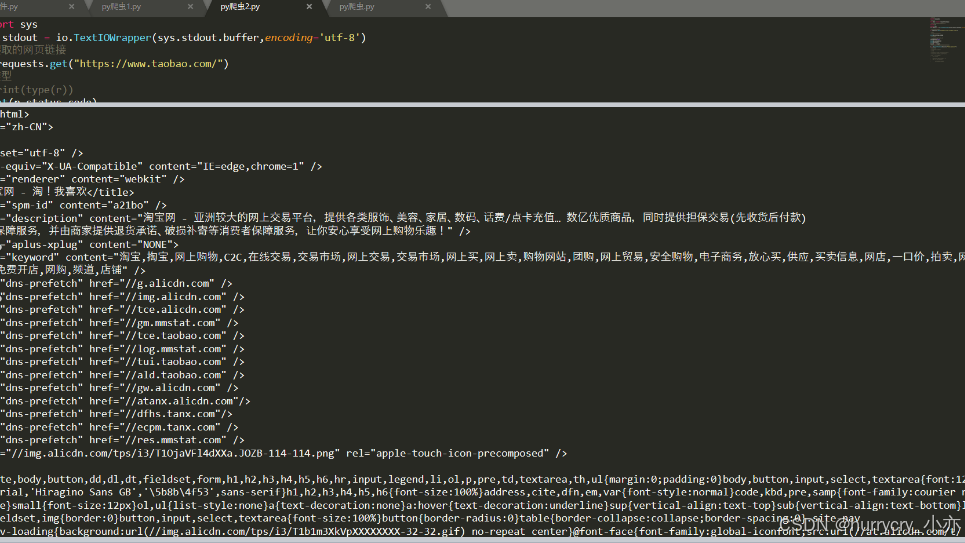
那讲了那么多爬虫到底是什么意思?
一、定义与原理
- 定义:Python爬虫是一种自动化数据收集技术,通过模拟浏览器的行为,自动访问目标网站,并抓取其中的数据。
- 原理:爬虫程序首先使用HTTP库(如requests)向目标网站发送请求,获取网页的HTML代码或其他格式的数据(如JSON、二进制数据等)。然后,利用Python的解析库(如BeautifulSoup、lxml等)对获取的网页代码进行解析,提取出所需的数据。最后,将解析得到的数据存储到本地文件、数据库或其他存储介质中,以便后续分析和处理。
二、应用步骤
- 选择目标网站:确定要爬取数据的网站,并识别数据源。
- 编写爬虫代码:使用Python编写爬虫程序,包括发送请求、解析网页和存储数据等步骤。
- 处理提取的数据:对爬取到的数据进行清洗、整合和分析,以满足特定的需求。
三、应用场景
- 数据抓取:从网站和其他在线平台收集数据,用于市场研究、竞争情报或产品分析。
- 价格监测:从电子商务网站跟踪产品的价格,以了解价格趋势或识别促销机会。
- 网络监控:自动监视网站的可用性、性能和内容的变化。
- 社交媒体分析:收集和分析社交媒体平台上的数据,以了解用户行为、品牌情绪和行业趋势。
- 搜索引擎优化:通过爬取搜索引擎的排名因素,进行针对性的优化。
- 网络安全:爬取网站的信息,发现其中存在的漏洞和安全隐患,并及时采取措施进行修复。
- 金融数据分析:从金融网站上获取股票、基金等金融产品的实时行情和历史数据,并进行数据挖掘和分析。
四、优势与挑战
- 优势:
- Python语言灵活且易于上手,拥有丰富的库和工具支持。
- 爬虫程序可以高度定制,满足不同的数据抓取需求。
- 自动化程度高,可以大幅提高数据收集的效率。
- 挑战:
- 反爬虫机制的应对:目标网站可能会采取各种反爬虫措施,如验证码验证、IP封禁等,增加了爬虫的复杂性。
- 数据隐私与安全问题:在爬取数据时,需要遵守相关的法律法规和网站的使用协议,确保合法合规地获取数据,并注重数据的隐私与安全保护。
综上所述,Python爬虫是一种强大的自动化数据收集工具,在各个领域都有着广泛的应用。然而,在使用爬虫技术时,也需要关注其可能带来的挑战和风险,并采取相应的措施进行应对。
那如果学会Python的爬虫将会怎么样
学会Python的爬虫技术,虽然带来了强大的数据获取能力和技能提升的机会,但同时也存在一些潜在的坏处和挑战。以下是一些可能的坏处:
- 法律和道德风险:
- 在使用爬虫技术时,必须严格遵守相关法律法规和网站的使用条款。未经授权的数据抓取可能涉及侵权问题,引发法律风险。
- 同时,爬虫技术也可能被用于非法或不道德的目的,如窃取敏感信息、破坏网站安全等,这将对个人隐私和网络安全构成威胁。
- 对目标网站的压力:
- 爬虫技术需要频繁地向目标网站发送请求,这可能会给网站的服务器带来额外的压力。
- 如果爬虫请求的频率过高或同时发送的请求数量过多,可能会导致网站服务器负载过高,影响网站的正常运行和其他用户的访问体验。
- 反爬虫机制的挑战:
- 许多网站都部署了反爬虫机制,以保护自己的数据不被滥用或盗用。
- 爬虫开发者需要投入大量时间和资源来研究目标网站的反爬虫策略,并实现相应的反反爬虫策略。这增加了开发的难度和成本,并可能导致爬虫程序在应对反爬虫机制时失效。
- 数据隐私和安全问题:
- 在抓取数据时,爬虫可能会触及到用户的个人信息或敏感数据。
- 如果这些数据没有得到合理的处理或保护,可能会导致隐私泄露或数据安全问题。这不仅可能引发法律纠纷,还可能损害用户的信任和利益。
- 技术更新和维护成本:
- 随着互联网技术的发展和网站结构的不断变化,爬虫技术也需要不断更新和维护。
- 这要求开发者具备持续学习和更新的能力,并投入时间和精力来维护爬虫代码,以适应新的情况和挑战。
- 网络问题的影响:
- 爬虫代码依赖于网络连接,如果网络不稳定或遇到阻塞等问题,可能导致数据抓取的不完整或失败。
- 这需要开发者采取相应的处理和重试机制,以确保数据的完整性和准确性。
综上所述,学会Python的爬虫技术虽然带来了很多好处,但也存在一些潜在的坏处和挑战。在使用爬虫技术时,开发者需要权衡利弊,并合理规划和使用。同时,也需要遵守相关法律法规和道德准则,确保合法合规地获取数据,并注重数据的隐私和安全保护。
Python爬虫可以抓取多种类型的数据,具体取决于目标网站的结构和爬虫的设计。以下是一些常见的可以被抓取的数据类型:
- 文本数据:这是最常见的数据类型,包括文章、博客、新闻、论坛帖子、评论等用户生成的内容,以及网页的标题、描述、关键词等SEO相关信息。
- 多媒体数据:爬虫可以抓取网站上的图片、插图、图标、动图、视频等多媒体内容。对于视频,爬虫通常可以获取视频的链接、标题、描述和缩略图等。
- 结构化数据:如数据库中的表格数据(需要额外的解析技术,如网站使用了JavaScript动态加载或表单提交),电子表格文件(如XLS、XLSX),以及API接口返回的数据(通常以JSON或XML格式提供)。
- 社交媒体数据:爬虫可以抓取社交媒体平台上的公开信息,如推文、状态更新、用户资料信息(如头像、简介、关注者数量等)。
- 其他数据:如音频文件(如MP3、WAV)的链接、下载链接(如软件安装包、文档等)、电子邮件地址、电话号码、地理位置等。
虽然说学习Python爬虫肯定是没有问题的,但是不能“反爬虫”,不会被遭受法律的制裁
为了让大家深刻理解Python爬虫,小亦,特意找了几个视频让大家巩固一下
1、【Python教程】《零基础入门学习Python》最新版(完结撒花🎉)_哔哩哔哩_bilibili
👆面的链接来自哔哩哔哩,作者:鱼C-小甲鱼
2、
【Python爬虫教程】40分钟上手Python爬虫/零基础入门到精通教学(第四期)|requests模块的基础使用_哔哩哔哩_bilibili
👆上面的视频是小亦极其推荐大家去看的,链接来自哔哩哔哩作者:python_-
另注本博文明令禁止转载和搬运,如果发现请联系删除或私信博主
本图片均来源于网络
感谢合作:
华南理工大学-于老师 hyl_ steambird xuangongdong lzyqwq
naught
感谢以上对本文章进行批阅和修改
另:英文版正在撰写中,敬请期待!!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献3条内容

所有评论(0)