【自然语言处理|RNN-03】:人名分类器案例
1 案例介绍
案例需求:
- 输入一个人名, 使用模型帮助我们判断可能是来自哪一个国家
- 业务意义:国际化公司的业务中具有重要意义,属于AI赋能互联网业务
- 比如:用户注册过程中, 根据填写的名字直接用户分配国家、地区信息、限制手机号码位数等,提高效率和友好度
数据格式说明
- 每一行第一个单词为人名,第二个单词为国家名。中间用制表符tab分割
- 数据一共有20074条,有18个国家

2 实现步骤
- 第一步:任务识别
- 第二步:数据的处理
- 数据处理三部曲:读数据到内存、构建数据集dataset、构建dataloader
- 第三步:构建RNN模型(包括传统RNN, LSTM以及GRU)
- 搭建模型和模型的测试程序(重点)
- 第四步:构建训练函数并进行训练
- 第五步:构建预测函数并进行预测
2.1 任务识别
-
根据人名预测是哪一个国家(18个国家),典型就是一个分类问题;AI赋能互联网行业-提高业务效率
-
文本数值化数值张量的技术选型分析(数据如何送给模型?)
- 比如:每个姓氏构成一个单词:“zhang”、“wang”、“li”、 ‘Weston’ 等等,需要转成张量送给模型。这里的姓名可以理解为通常的句子,但是姓名时一个短序列,不需要进行分词;或者将名字拆分为字母组合,将字母进行张量化,根据名字进行名字拼接
- 技术路线1:以单词为单位,word2id后送给RNN模型抽取事物特征进行分类。这样每个姓氏只能整体送1次。word2id,找到姓名对应的张量,送入到RNN中。
- 技术路线2:比如:z-h-a-n-g以字母为单位,送给RNN模型抽取事物特征进行分类。
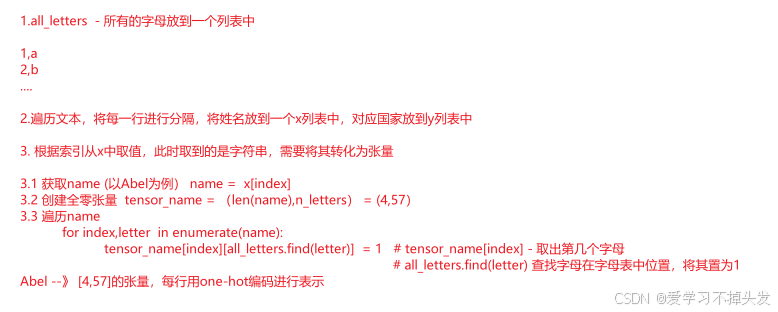
- 本案例:文本数值化方案采用:技术路线2:以字母为单位,进行文本数值化和数值张量化
- 比如:一共有57个字母,构成字母表。每个字母进行one-hot编码,再送给RNN模型
- 先得到字母对应的张量表,然后每个名字根据名字长度获取到对应的字母张量组成名字
-
短文本分类,模型选型分析 (如何选模型?)
- 模型可以选中RNN、LSTM、GRU,分布测试三个模型的准确率、损失下降情况、训练时间等等
- 综合对比三个模型在数据集的表现,选择合适的模型
2.2 数据处理
数据处理三个主要步骤:
- 读取数据到内存,实现文本张量化
- 构建数据集对象
- 构建DataLoader对象
- 读取数据到内存,构建原始的x和y,x存储的是未处理的语句,y存储的是label
# -*- coding: utf-8 -*-
import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from  torch.utils.data import Dataset, DataLoader
import string
import time
import matplotlib.pyplot as plt

"""
    按照字母进行送入数据
"""


# 获取常用字符包括字母和常用标点
all_letters = string.ascii_letters + " .,;'"
# 获取常用字符数量
n_letters = len(all_letters)  # # 'zhang' == [1,57]
# print('字母表all_letters-->', all_letters, '总长度', n_letters)
# 国家名 种类数
categorys = ['Italian', 'English', 'Arabic', 'Spanish', 'Scottish', 'Irish', 'Chinese', 'Vietnamese', 'Japanese',
             'French', 'Greek', 'Dutch', 'Korean', 'Polish', 'Portuguese', 'Russian', 'Czech', 'German']
# print('国家名-->', categorys, '总种类数', len(categorys))


# 思路分析
# 1 打开数据文件 open(filename, mode='r', encoding='utf-8')
# 2 按行读文件、提取样本x 样本y line.strip().split('\t')
# 3 返回样本x的列表、样本y的列表 my_list_x, my_list_y
# # 原始数据 -> 数据源NameClassDataset --> 数据迭代器DataLoader
def read_data(filename):
    my_list_x, my_list_y = [], []
    # 1 打开数据文件 open(filename, mode='r', encoding='utf-8')
    with open(filename, mode='r', encoding='utf-8') as f:
        for line in f.readlines():
            # 2 按行读文件、提取样本x 样本y line.strip().split('\t')
            x, y = line.strip().split('\t')
            my_list_x.append(x) # 存储的是姓名
            my_list_y.append(y) # 存储的是国家

    # 3 返回样本x的列表、样本y的列表 my_list_x, my_list_y
    return my_list_x, my_list_y
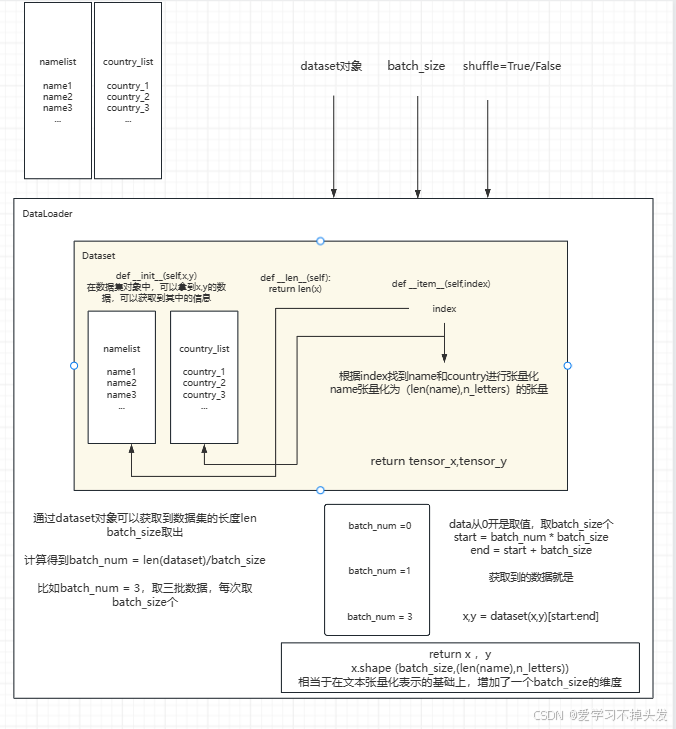
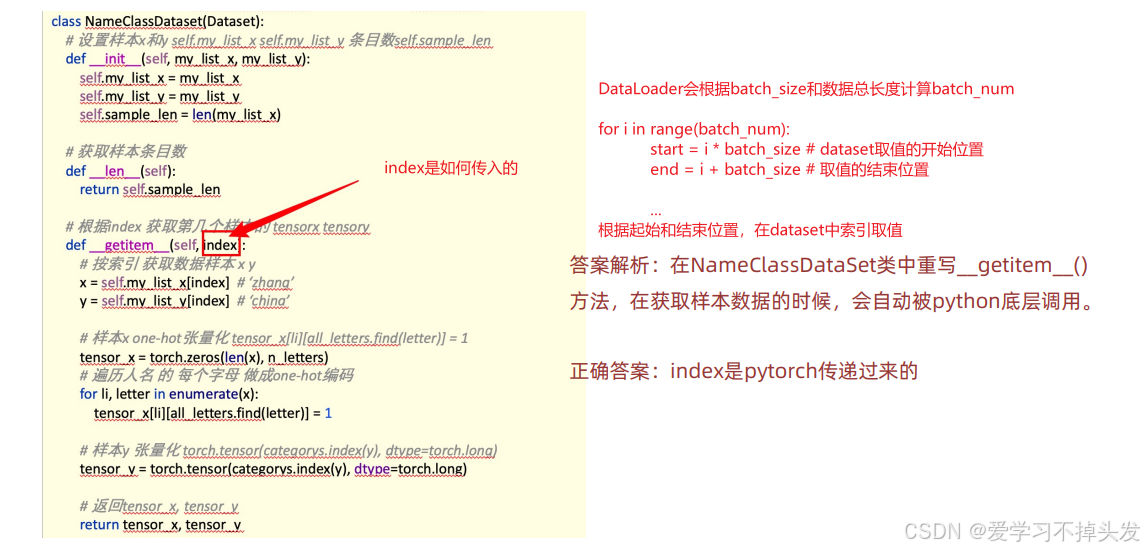
- 构建数据集对象,实现__getitem__是为了可以根据索引获取数据集对象的值,返回值为张量。所以在__getitem__中可以实现文本张量化,转化为one-hot编码
# 原始数据 -> 数据源NameClassDataset --> 数据迭代器DataLoader
# 构造数据源 NameClassDataset,把语料转换成x y
# 1 init函数 设置样本x和y self.my_list_x self.my_list_y 条目数self.sample_len
# 2 __len__(self)函数  获取样本条数
# 3 __getitem__(self, index)函数 获取第几条样本数据
    # 按索引 获取数据样本 x y
    # 样本x onehot张量化 torch.zeros(len(x), n_letters)
    # 遍历人名 的 每个字母 做成one-hot编码 tensor_x[li][all_letters.find(letter)] = 1
    # 样本y 张量化 torch.tensor(categorys.index(y), dtype=torch.long)
    # 返回tensor_x, tensor_y
class NameClassDataset(Dataset):
    def __init__(self, my_list_x, my_list_y):
        self.my_list_x = my_list_x
        self.my_list_y = my_list_y
        self.sample_len = len(self.my_list_x) # 一共有多少姓名

    def __len__(self):
        return self.sample_len

    def __getitem__(self, item):
        # 按索引 获取数据样本 x y
        x = self.my_list_x[item] # 根据index找到名字
        y = self.my_list_y[item] # 根据index找到国家

        # 样本x onehot张量化 torch.zeros(len(x), n_letters)
        # 获取到一个名字之后,构建全0的张量
        # len(x) - 名字长度
        tensor_x = torch.zeros(len(x), n_letters) # [3, 57] ,一个名字有三个字母,每个字母用57维的向量表示

        # 遍历人名 的 每个字母 做成one-hot编码
        # line - index
        # letter - name
        for line, letter in enumerate(x):
            tensor_x[line][all_letters.find(letter)] = 1

        # 样本y 张量化 torch.tensor(categorys.index(y), dtype=torch.long)
        tensor_y = torch.tensor(categorys.index(y), dtype=torch.long)

        # 返回tensor_x, tensor_y
        return  tensor_x, tensor_y
- 使用DataLoader批次拿到数据
# 1 读数据到内存  # 2 实例化数据源 # 3 实例化数据迭代器 批次拿数据
def  dm01_test_NameClassDataset():

    # 1 读数据到内存
    my_list_x, my_list_y = read_data('./data/name_classfication.txt')
    print('my_list_x-->', len(my_list_x))
    print('my_list_y-->', len(my_list_y))

    # 2 实例化数据源
    mynameclassdataset = NameClassDataset(my_list_x, my_list_y)
    print('mynameclassdataset-->', mynameclassdataset)
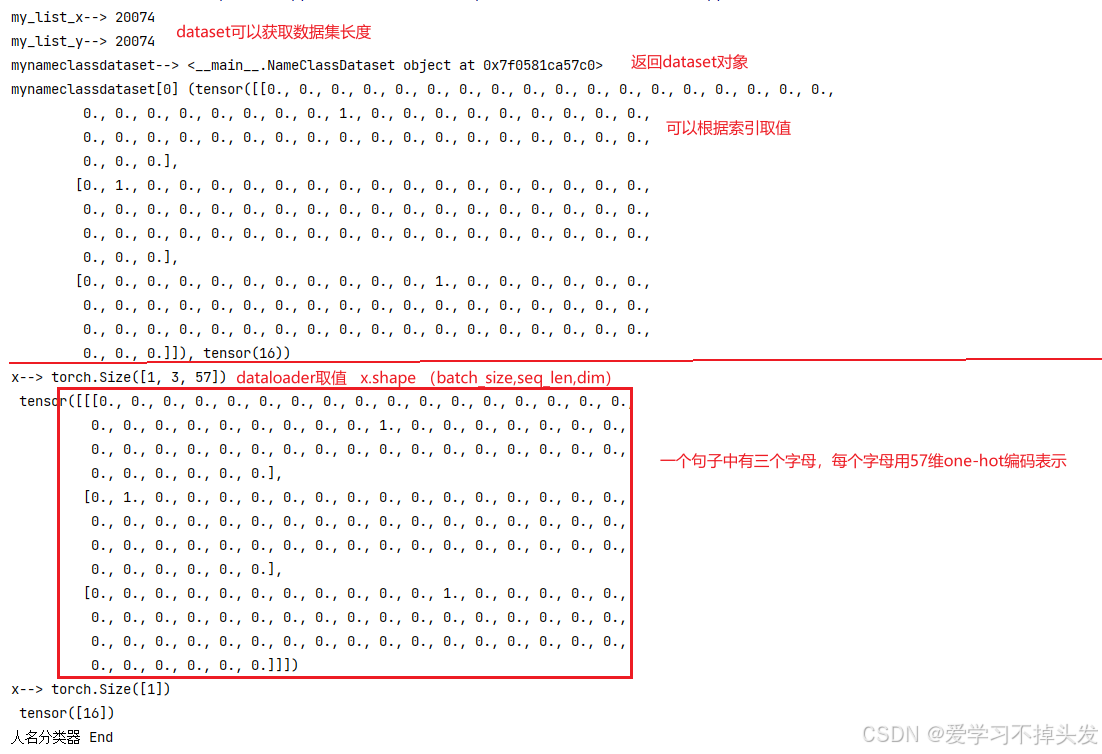
    print('mynameclassdataset[0]', mynameclassdataset[0])

    # 3 实例化数据迭代器 批次拿数据
    mydataloader = DataLoader(dataset=mynameclassdataset, batch_size=1, shuffle=False )
    for x, y in mydataloader:
    	# x的形状为(batch_size,seq_len,输入特征维数)
        print('x-->', x.shape, '\n', x) # torch.Size([1, 3, 57])
        print('x-->', y.shape, '\n', y) # torch.Size([1])
        break
2.3 模型构建
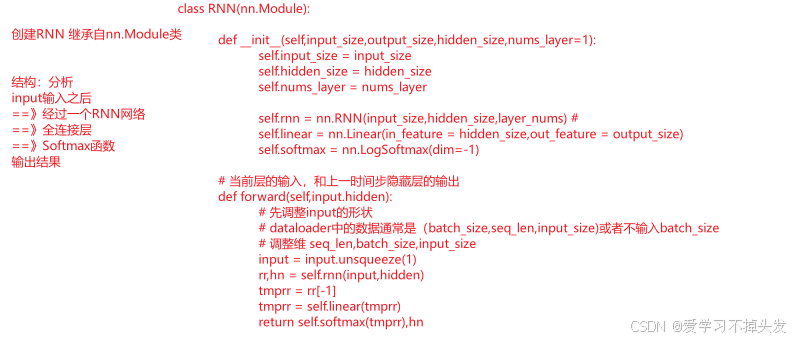
思路分析:
- RNN模型构建
# RNN类 实现思路分析:
# 1 init函数 (self, input_size, hidden_size, output_size, num_layers=1):
    # 准备super() self.rnn self.linear self.softmax=nn.LogSoftmax(dim=-1)
# 2 forward(input, hidden)函数
    # 数据调形 [6,57] ---> [6,1,57] input.unsqueeze(1)
    # 数据经过rnn层 形状变化 [seqlen,1,57],[1,1,128]) -> [seqlen,1,128],[1,1,128]
        # rr, hn=self.rnn(input, hidden)
    # 取最后一个128当人名的特征 [6,1,128] --> [1,128]  tmprr = rr[-1]
    # 数据经过全连接层 [1,128] ---> [1,18]
    # 返回 self.softmax(tmprr), hn
# 3 初始化隐藏层输入数据 inithidden()
#   形状[self.num_layers, 1, self.hidden_size]
class RNN(nn.Module):
    # output_size 全连接输出
    def __init__(self, input_size, hidden_size, output_size, num_layers=1):
        super(RNN, self).__init__()
        self.input_size = input_size
        self.hidden_size = hidden_size
        self.output_size = output_size
        self.num_layers = num_layers

        # 实例化rnn层
        self.rnn = nn.RNN(input_size=input_size, hidden_size=hidden_size, num_layers=num_layers)

        # 实例化全连接层
        self.linear = nn.Linear(in_features=hidden_size, out_features=output_size)

        # 实例化softmax层
        self.softmax = nn.LogSoftmax(dim=-1)

    def forward(self, input, hidden):
        # 6  - seq_len
        # 27 input_size
        # batch_size
        # 数据调形 [6,57] ---> [6,1,57] input.unsqueeze(1)
        input = input.unsqueeze(1)

        # 数据经过rnn层 形状变化 [6,1,57],[1,1,128]) -> [6,1,128],[1,1,128]
        rr, hn = self.rnn(input, hidden)


        # 取最后一个128当人名的特征 [6,1,128] --> [1,128]  tmprr = rr[-1]
        tmprr = rr[-1]

        # 数据经过全连接层 [1,128] ---> [1,18]
        tmprr = self.linear(tmprr)

        # 返回 self.softmax(tmprr), hn
        return  self.softmax(tmprr), hn

    def inithidden(self):
        #   形状[self.num_layers, 1, self.hidden_size]
        return  torch.zeros(self.num_layers, 1, self.hidden_size)

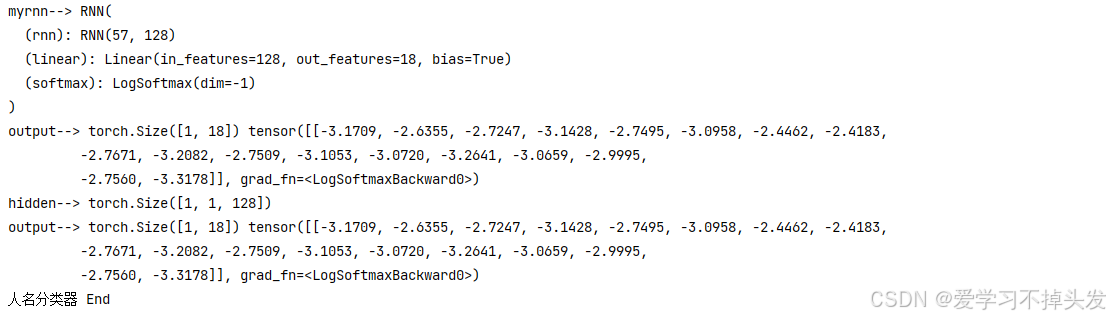
def dm02_test_RNN():
    # 1 rnn模型实例化
    myrnn = RNN(57, 128, 18)
    print('myrnn-->', myrnn)

    # 2 准备数据 input/hidden 'z h a n g a '
    input = torch.randn(6, 57) # 6个字母,组成的一个人名
    hidden = myrnn.inithidden()

    # 3 给模型喂数据
    # 3-1 一次性送数据 数据形状 [6,57] [1,1,128] ---> [1,18],[1,1,128]
    output, hidden = myrnn(input, hidden)
    print('output-->', output.shape, output)
    print('hidden-->', hidden.shape)

    # 3-2 一个字符一个字符的送数据
    hidden = myrnn.inithidden()  # 注意 第2种方式给模型喂数据,要注意hidden
    for i in range(input.shape[0]):
        tmp = input[i].unsqueeze(0)
        # print('tmp-->', tmp.shape)
        output, hidden = myrnn(tmp, hidden)

    print('output-->', output.shape, output)
- LSTM模型构建
###LSTM
class LSTM(nn.Module):
    def __init__(self, input_size, hidden_size, output_size, num_layers=1):
        super(LSTM, self).__init__()
        self.input_size = input_size
        self.hidden_size = hidden_size
        self.output_size = output_size
        self.num_layers = num_layers

        # 实例化rnn层
        self.lstm = nn.LSTM(input_size=input_size, hidden_size=hidden_size, num_layers=num_layers)

        # 实例化全连接层
        self.linear = nn.Linear(in_features=hidden_size, out_features=output_size)

        # 实例化softmax层
        self.softmax = nn.LogSoftmax(dim=-1)

    def forward(self, input, hidden, c0):
        # 数据调形 [6,57] ---> [6,1,57] input.unsqueeze(1)
        input = input.unsqueeze(1)

        # 数据经过rnn层 形状变化 [6,1,57],[1,1,128]) -> [6,1,128],[1,1,128]
        rr, (hn, cn) = self.lstm(input, (hidden, c0))


        # 取最后一个128当人名的特征 [6,1,128] --> [1,128]  tmprr = rr[-1]
        tmprr = rr[-1]

        # 数据经过全连接层 [1,128] ---> [1,18]
        tmprr = self.linear(tmprr)

        # 返回 self.softmax(tmprr), hn
        return  self.softmax(tmprr), hn, cn

    def inithidden(self):
        #   形状[self.num_layers, 1, self.hidden_size]
        h0 = c0 = torch.zeros(self.num_layers, 1, self.hidden_size)
        return h0, c0


def dm03_test_LSTM():
    # 1 rnn模型实例化
    mylstm = LSTM(57, 128, 18)
    print('mylstm-->', mylstm)

    # 2 准备数据 input/hidden 'z h a n g a '
    input = torch.randn(6, 57)
    hidden, c0 = mylstm.inithidden()

    # 3 给模型喂数据
    # 3-1 一次性送数据 数据形状 [6,57] [1,1,128] ---> [1,18],[1,1,128]
    output, hidden, c0 = mylstm(input, hidden, c0)
    print('output-->', output.shape, output)
    print('hidden-->', hidden.shape, c0.shape)

    # 3-2 一个字符一个字符的送数据
    hidden, c0 = mylstm.inithidden()  # 注意 第2种方式给模型喂数据,要注意hidden
    for i in range(input.shape[0]):
        tmp = input[i].unsqueeze(0)
        # print('tmp-->', tmp.shape)
        output, hidden, c0 = mylstm(tmp, hidden, c0)

    print('output-->', output.shape, output)
- GRU模型构建
class GRU(nn.Module):
    def __init__(self, input_size, hidden_size, output_size, num_layers=1):
        super(GRU, self).__init__()
        self.input_size = input_size
        self.hidden_size = hidden_size
        self.output_size = output_size
        self.num_layers = num_layers

        # 实例化rnn层
        self.gru = nn.GRU(input_size=input_size, hidden_size=hidden_size, num_layers=num_layers)

        # 实例化全连接层
        self.linear = nn.Linear(in_features=hidden_size, out_features=output_size)

        # 实例化softmax层
        self.softmax = nn.LogSoftmax(dim=-1)

    def forward(self, input, hidden):
        # 数据调形 [6,57] ---> [6,1,57] input.unsqueeze(1)
        input = input.unsqueeze(1)

        # 数据经过rnn层 形状变化 [6,1,57],[1,1,128]) -> [6,1,128],[1,1,128]
        rr, hn = self.gru(input, hidden)

        # 取最后一个128当人名的特征 [6,1,128] --> [1,128]  tmprr = rr[-1]
        tmprr = rr[-1]

        # 数据经过全连接层 [1,128] ---> [1,18]
        tmprr = self.linear(tmprr)

        # 返回 self.softmax(tmprr), hn
        return  self.softmax(tmprr), hn

    def inithidden(self):
        #   形状[self.num_layers, 1, self.hidden_size]
        return  torch.zeros(self.num_layers, 1, self.hidden_size)


def dm04_test_GRU():
    # 1 rnn模型实例化
    mygru = GRU(57, 128, 18)
    print('mygru-->', mygru)

    # 2 准备数据 input/hidden 'z h a n g a '
    input = torch.randn(6, 57)
    hidden = mygru.inithidden()

    # 3 给模型喂数据
    # 3-1 一次性送数据 数据形状 [6,57] [1,1,128] ---> [1,18],[1,1,128]
    output, hidden = mygru(input, hidden)
    print('output-->', output.shape, output)
    print('hidden-->', hidden.shape)

    # 3-2 一个字符一个字符的送数据
    hidden = mygru.inithidden()  # 注意 第2种方式给模型喂数据,要注意hidden
    for i in range(input.shape[0]):
        tmp = input[i].unsqueeze(0)
        # print('tmp-->', tmp.shape)
        output, hidden = mygru(tmp, hidden)

    print('output-->', output.shape, output)
2.4 训练函数构建及训练
- RNN模型训练
# 思路分析
# 从文件获取数据、实例化数据源对象nameclassdataset 数据迭代器对象mydataloader
# 实例化模型对象my_rnn 损失函数对象mycrossentropyloss=nn.NLLLoss() 优化器对象myadam
# 定义模型训练的参数
#       starttime total_iter_num total_loss  total_loss_list total_acc_num  total_acc_list
# 外层for循环 控制轮数 for epoch_idx in range(epochs)
# 内层for循环 控制迭代次数 for i, (x, y) in enumerate(mydataloader)
    # 给模型喂数据   # 计算损失  # 梯度清零 # 反向传播  # 梯度更新
    # 计算辅助信息
    # 累加总已训练样本 总损失 总准确数
    # 每100次求1下平均损失tmploss 存入total_loss_list列表中 方便画图
    # 每100次求1下平均准确数目tmpacc 存入total_acc_num列表中 方便画图
    # 每2000次训练 打印日志
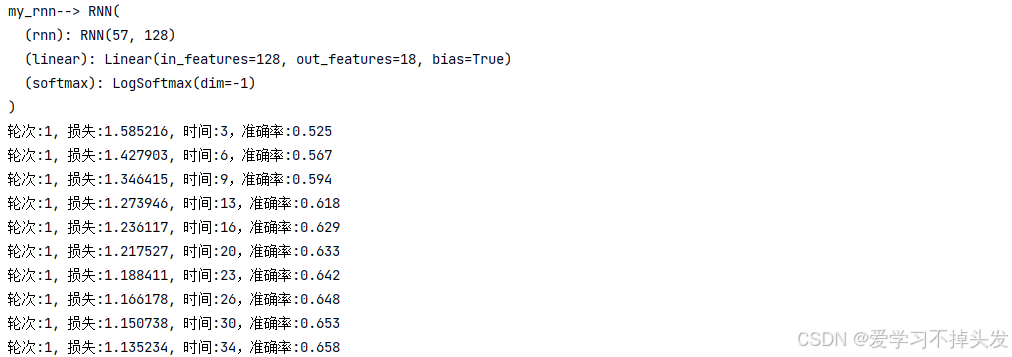
    # print('轮次:%d, 损失:%.6f, 时间:%d,准确率:%.3f' % (epoch_idx+1, tmploss, time.time()-starttime, tmpacc))
    # 其他 # 预测对错 i_predit_tag = (1 if torch.argmax(output_y).item() == y.item() else 0)
# 模型保存
    # torch.save(my_rnn.state_dict(), './my_rnn_model_%d.bin' % (epoch_idx + 1))
# 返回 平均损失列表total_loss_list, 时间total_time, 平均准确total_acc_list

# 模型训练参数
mylr = 1e-3
epochs = 1

def my_train_rnn():
    # 1 从文件获取数据、实例化数据源对象nameclassdataset 数据迭代器对象mydataloader
    my_list_x, my_list_y = read_data('./data/name_classfication.txt')
    mynameclassdataset = NameClassDataset(my_list_x, my_list_y)
    mydataloader = DataLoader(dataset=mynameclassdataset, batch_size=1, shuffle=True)

    # 2 实例化模型对象my_rnn
    my_rnn = RNN(57, 128, 18)
    print('my_rnn-->', my_rnn)
    # 损失函数对象 mycrossentropyloss=nn.NLLLoss()
    mycrossentropyloss = nn.NLLLoss()
    # 优化器对象myadam
    myadam = optim.Adam(params=my_rnn.parameters(), lr=mylr)

    # 3 定义模型训练的参数
    starttime  = time.time()        # 当前时间
    total_iter_num = 0              # 已经训练的样本个数 累加器
    total_loss  = 0                 # 总的损失  累加器
    total_loss_list = []            # 每100个样本,求一个平均损失 加入list
    total_acc_num  = 0              # 已经训练的样本中,对的数目
    total_acc_list = []             # 每100个样本,求一个平均准确率 加入list

    # 外层for循环 控制轮数 for epoch_idx in range(epochs)
    for epoch_idx in range(epochs):

        # 内层for循环 控制迭代次数 for i, (x, y) in enumerate(mydataloader)
        for  i, (x, y) in enumerate(mydataloader):
            # 给模型喂数据
            output_y, hidden = my_rnn(x[0], my_rnn.inithidden())
            # 计算损失
            myloss = mycrossentropyloss(output_y, y)
            # 梯度清零
            myadam.zero_grad()
            # 反向传播
            myloss.backward()
            # 梯度更新
            myadam.step()

            # 计算辅助信息
            # 累加总已训练样本 总损失 总准确数
            total_iter_num += 1
            total_loss += myloss.item()
            itag = (1 if torch.argmax(output_y).item() == y.item() else 0 )
            total_acc_num += itag

            if total_iter_num % 100 == 0:
                # 每100次求1下平均损失tmploss 存入total_loss_list列表中 方便画图
                tmploss = total_loss/total_iter_num
                total_loss_list.append(tmploss)

                # 每100次求1下平均准确数目tmpacc 存入total_acc_num列表中 方便画图
                tmpacc = total_acc_num / total_iter_num
                total_acc_list.append(tmpacc)

            # 每2000次训练 打印日志
            if total_iter_num % 2000 == 0:
                print('轮次:%d, 损失:%.6f, 时间:%d,准确率:%.3f' % \
                      (epoch_idx+1, tmploss, time.time()-starttime, tmpacc))
        # 模型保存
        torch.save(my_rnn.state_dict(), './my_rnn_model_%d.bin' % (epoch_idx + 1))
        # 返回 平均损失列表 total_loss_list, 时间total_time, 平均准确total_acc_list
        total_time = int(time.time() - starttime)
        return total_loss_list, total_time, total_acc_list
- LSTM模型训练
###LSTMTain
def my_train_lstm():
    # 1 从文件获取数据、实例化数据源对象nameclassdataset 数据迭代器对象mydataloader
    my_list_x, my_list_y = read_data('./data/name_classfication.txt')
    mynameclassdataset = NameClassDataset(my_list_x, my_list_y)
    mydataloader = DataLoader(dataset=mynameclassdataset, batch_size=1, shuffle=True)

    # 2 实例化模型对象my_rnn
    my_lstm = LSTM(57, 128, 18)
    print('my_lstm-->', my_lstm)
    # 损失函数对象 mycrossentropyloss=nn.NLLLoss()
    mycrossentropyloss = nn.NLLLoss()
    # 优化器对象myadam
    myadam = optim.Adam(params=my_lstm.parameters(), lr=mylr)

    # 3 定义模型训练的参数
    starttime  = time.time()        # 当前时间
    total_iter_num = 0              # 已经训练的样本个数 累加器
    total_loss  = 0                 # 总的损失  累加器
    total_loss_list = []            # 每100个样本,求一个平均损失 加入list
    total_acc_num  = 0              # 已经训练的样本中,对的数目
    total_acc_list = []             # 每100个样本,求一个平均准确率 加入list

    # 外层for循环 控制轮数 for epoch_idx in range(epochs)
    for epoch_idx in range(epochs):

        # 内层for循环 控制迭代次数 for i, (x, y) in enumerate(mydataloader)
        for  i, (x, y) in enumerate(mydataloader):
            # 给模型喂数据
            h0, c0 = my_lstm.inithidden()
            output_y, h0, c0 = my_lstm(x[0], h0, c0)
            # 计算损失
            myloss = mycrossentropyloss(output_y, y)
            # 梯度清零
            myadam.zero_grad()
            # 反向传播
            myloss.backward()
            # 梯度更新
            myadam.step()

            # 计算辅助信息
            # 累加总已训练样本 总损失 总准确数
            total_iter_num += 1
            total_loss += myloss.item()
            itag = (1 if torch.argmax(output_y).item() == y.item() else 0 )
            total_acc_num += itag

            if total_iter_num % 100 == 0:
                # 每100次求1下平均损失tmploss 存入total_loss_list列表中 方便画图
                tmploss = total_loss/total_iter_num
                total_loss_list.append(tmploss)

                # 每100次求1下平均准确数目tmpacc 存入total_acc_num列表中 方便画图
                tmpacc = total_acc_num / total_iter_num
                total_acc_list.append(tmpacc)

            # 每2000次训练 打印日志
            if total_iter_num % 2000 == 0:
                print('轮次:%d, 损失:%.6f, 时间:%d,准确率:%.3f' % \
                      (epoch_idx+1, tmploss, time.time()-starttime, tmpacc))
        # 模型保存
        torch.save(my_lstm.state_dict(), './my_lstm_model_%d.bin' % (epoch_idx + 1))
        # 返回 平均损失列表 total_loss_list, 时间total_time, 平均准确total_acc_list
        total_time = int(time.time() - starttime)
        return total_loss_list, total_time, total_acc_list
- GRU模型训练
###grutrain
def my_train_gru():
    # 1 从文件获取数据、实例化数据源对象nameclassdataset 数据迭代器对象mydataloader
    my_list_x, my_list_y = read_data('./data/name_classfication.txt')
    mynameclassdataset = NameClassDataset(my_list_x, my_list_y)
    mydataloader = DataLoader(dataset=mynameclassdataset, batch_size=1, shuffle=True)

    # 2 实例化模型对象my_rnn
    my_gru = GRU(57, 128, 18)
    print('my_gru-->', my_gru)
    # 损失函数对象 mycrossentropyloss=nn.NLLLoss()
    mycrossentropyloss = nn.NLLLoss()
    # 优化器对象myadam
    myadam = optim.Adam(params=my_gru.parameters(), lr=mylr)

    # 3 定义模型训练的参数
    starttime  = time.time()        # 当前时间
    total_iter_num = 0              # 已经训练的样本个数 累加器
    total_loss  = 0                 # 总的损失  累加器
    total_loss_list = []            # 每100个样本,求一个平均损失 加入list
    total_acc_num  = 0              # 已经训练的样本中,对的数目
    total_acc_list = []             # 每100个样本,求一个平均准确率 加入list

    # 外层for循环 控制轮数 for epoch_idx in range(epochs)
    for epoch_idx in range(epochs):

        # 内层for循环 控制迭代次数 for i, (x, y) in enumerate(mydataloader)
        for  i, (x, y) in enumerate(mydataloader):
            # 给模型喂数据
            output_y, hidden = my_gru(x[0], my_gru.inithidden())
            # 计算损失
            myloss = mycrossentropyloss(output_y, y)
            # 梯度清零
            myadam.zero_grad()
            # 反向传播
            myloss.backward()
            # 梯度更新
            myadam.step()

            # 计算辅助信息
            # 累加总已训练样本 总损失 总准确数
            total_iter_num += 1
            total_loss += myloss.item()
            itag = (1 if torch.argmax(output_y).item() == y.item() else 0 )
            total_acc_num += itag

            if total_iter_num % 100 == 0:
                # 每100次求1下平均损失tmploss 存入total_loss_list列表中 方便画图
                tmploss = total_loss/total_iter_num
                total_loss_list.append(tmploss)

                # 每100次求1下平均准确数目tmpacc 存入total_acc_num列表中 方便画图
                tmpacc = total_acc_num / total_iter_num
                total_acc_list.append(tmpacc)

            # 每2000次训练 打印日志
            if total_iter_num % 2000 == 0:
                print('轮次:%d, 损失:%.6f, 时间:%d,准确率:%.3f' % \
                      (epoch_idx+1, tmploss, time.time()-starttime, tmpacc))
        # 模型保存
        torch.save(my_gru.state_dict(), './my_gru_model_%d.bin' % (epoch_idx + 1))
        # 返回 平均损失列表 total_loss_list, 时间total_time, 平均准确total_acc_list
        total_time = int(time.time() - starttime)
        return total_loss_list, total_time, total_acc_list
2.5 三个模型绘图比较
def dm06_test_train_rnn_lstm_gru():
    total_loss_list_rnn, total_time_rnn, total_acc_list_rnn = my_train_rnn()

    total_loss_list_lstm, total_time_lstm, total_acc_list_lstm = my_train_lstm()

    total_loss_list_gru, total_time_gru, total_acc_list_gru = my_train_gru()

    # 绘制损失对比曲线
    # 创建画布0
    plt.figure(0)
    # # 绘制损失对比曲线
    plt.plot(total_loss_list_rnn, label="RNN")
    plt.plot(total_loss_list_lstm, color="red", label="LSTM")
    plt.plot(total_loss_list_gru, color="orange", label="GRU")
    plt.legend(loc='upper left')
    plt.savefig('./img/RNN_LSTM_GRU_loss2.png')
    plt.show()

    # 绘制柱状图-耗时对比
    # 创建画布1
    plt.figure(1)
    x_data = ["RNN", "LSTM", "GRU"]
    y_data = [total_time_rnn, total_time_lstm, total_time_gru]
    # 绘制训练耗时对比柱状图
    plt.bar(range(len(x_data)), y_data, tick_label=x_data)
    plt.savefig('./img/RNN_LSTM_GRU_period2.png')
    plt.show()

    # 绘制准确率对比曲线
    plt.figure(2)
    plt.plot(total_acc_list_rnn, label="RNN")
    plt.plot(total_acc_list_lstm, color="red", label="LSTM")
    plt.plot(total_acc_list_gru, color="orange", label="GRU")
    plt.legend(loc='upper left')
    plt.savefig('./img/RNN_LSTM_GRU_acc2.png')
    plt.show()
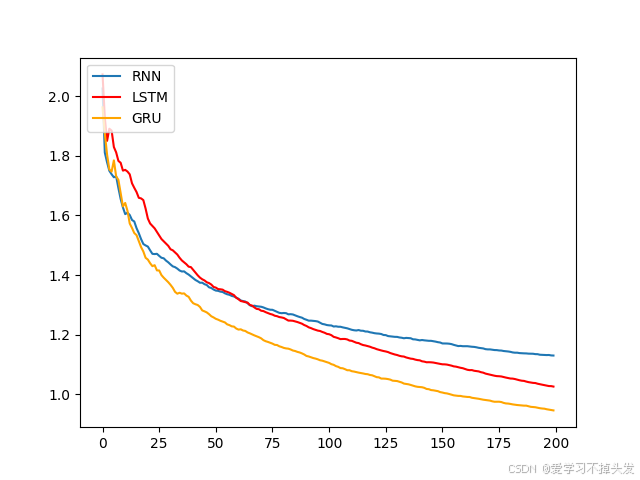
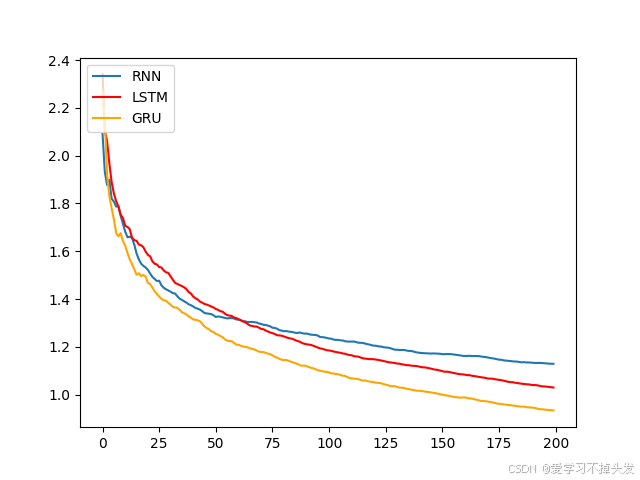
- 训练一个轮次损失曲线
-
训练四个轮次损失曲线
-
模型训练的损失降低快慢代表模型收敛程度。由图可知, 传统RNN的模型第一个轮次开始收敛情况最好,然后是GRU, 最后是LSTM, 这是因为RNN模型简单参数少,见效快。随着训练数据的增加,GRU效果最好、LSTM效
-
所以在以后的模型选用时, 要通过对任务的分析以及实验对比, 选择最适合的模型。
-
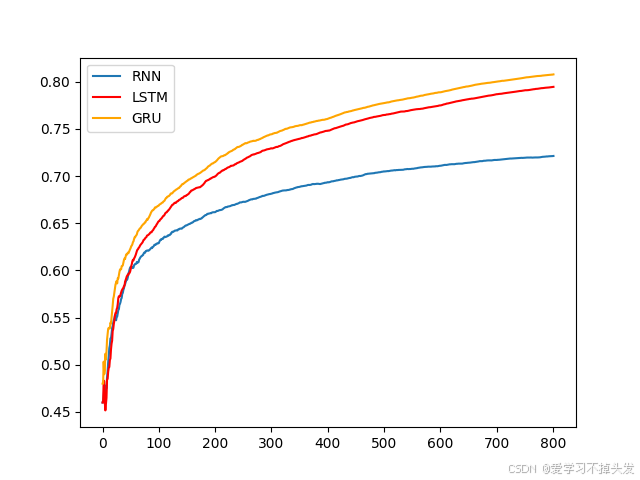
训练准确率对比图
-
模型选用一般应通过实验对比,并非越复杂或越先进的模型表现越好,而是需要结合自己的特定任务,从对数据的分析和实验结果中获得最佳答案。
-
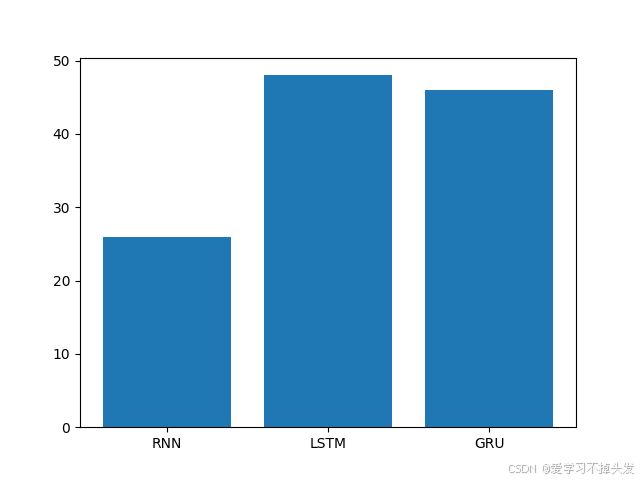
训练时间分析
-
模型训练的耗时长短代表模型的计算复杂度
-
由图可知, 也正如我们之前的理论分析,传统RNN复杂度最低, 耗时几乎只是后两者的一半,然后是GRU,最后是复杂度最高的LSTM
2.6 模型预测
- 将文本转换为张量
# 将人名转化为onehot张量
# eg 'bai' --> [3,57]
def lineToTensor(x):
    # 文本张量化x
    tensor_x = torch.zeros(len(x), n_letters, device=device)
    # 遍历这个人名中的每个字符索引和字符
    for li, letter in enumerate(x):
        # letter在字符串all_letters中的位置 就是onehot张量1索引的位置
        # letter在字符串all_letters中的位置 使用字符串find()方法获取
        tensor_x[li][all_letters.find(letter)] = 1
    return tensor_x
# def lineTotensor(x):
#     # eg x = 'zhang'
#     tensor_x = torch.zeros(len(x), n_letters)
#     for li, letter in enumerate(x):
#         tensor_x[li][all_letters.find(letter)] = 1
#     return tensor_x
思路分析 my_predict_rnn()
1 输入文本数据 张量化one-hot
2 实例化模型 加载已训练模型参数 my_rnn.load_state_dict(torch.load(my_path_rnn))
3 模型预测 with torch.no_grad()
output, hidden = my_rnn(x_tensor, my_rnn.inithidden())
4 从预测结果中取出前3名,显示打印结果
topv, topi = output.topk(3, 1, True)
category_idx = topi[0][i] category = categorys[category_idx]
def my_predict_rnn(x):

    n_letters = 57
    n_hidden = 128
    n_categories = 18

    # 输入文本, 张量化one-hot
    # 传入一个名字,进行张量化
    x_tensor = lineToTensor(x)

    # 实例化模型 加载已训练模型参数
    my_rnn = RNN(n_letters, n_hidden, n_categories)
    my_rnn.load_state_dict(torch.load(my_path_rnn))
    my_rnn = my_rnn.to(device)

    with torch.no_grad():
        # 模型预测
        # 将数据送入模型,然后训练得到结果
        output, hidden = my_rnn(x_tensor, my_rnn.inithidden())

        # 从预测结果中取出前3名
        # 3表示取前3名, 1表示要排序的维度, True表示是否返回元素的值
        topv, topi = output.topk(3, 1, True)

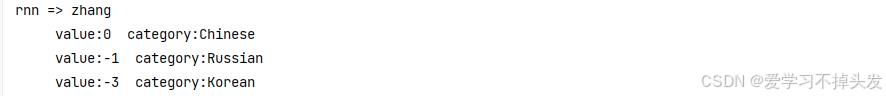
        print('rnn =>', x)
        for i in range(3):
            value = topv[0][i]
            category_idx = topi[0][i]
            category = categorys[category_idx]
            print('\t value:%d  category:%s' %(value, category))
if __name__ == "__main__":
	    my_predict_rnn('zhang')

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 17
 0
- 0


 已为社区贡献10条内容

所有评论(0)