MMKGs:首次将多模态知识图谱用于增强LLM的多模态推理能力,高效的架构设计,同时解决幻觉和知识限制问题
·
论文:Multimodal Reasoning with Multimodal Knowledge Graph
理解
核心问题
如何增强大语言模型(LLMs)的多模态推理能力,同时解决幻觉和知识限制问题?
核心解决方案
- 多模态知识图谱(MMKGs)集成
- 使用多模态知识图谱提供丰富的跨模态知识
- 采用关系图注意力网络(RGAT)进行编码
- 包含知识和视觉适配层用于对齐
- 架构设计
- 语言编码器:利用LLM的嵌入层
- 视觉编码器:采用预训练的CLIP
- 知识图谱编码器:实现RGAT进行知识嵌入
- 跨模态对齐:优化图像-文本匹配
- 训练策略
- 两阶段方法:
- 在MMKG数据集上预训练
- 在特定任务上微调
- 仅训练约2.25%的参数,同时冻结LLM和视觉编码器
"金钥匙"模式
论文的"金钥匙"在于有效利用MMKGs。这种模式可以从多个例子中看出:
- 湖人队颜色案例
- 问题:识别球队颜色
- 解决方案:MMKG提供湖人队的视觉和文本知识
- 结果:正确识别紫色和金色
- 州识别案例
- 问题:识别高亮显示的州
- 解决方案:MMKG提供州形状信息
- 结果:正确识别犹他州
- 物质状态案例
- 问题:识别固体材料
- 解决方案:MMKG提供材料的多模态属性
- 结果:正确识别岩石为固体
结果框架
- 量化改进
- 准确率提升1.95%
- Hits@1指标提升10.4%
- 仅使用2.25%可训练参数就达到了SOTA水平
- 质化效益
- 更好的跨模态理解
- 减少幻觉
- 更高效的参数利用
主要组件:
- 关系图注意力网络用于编码 MMKG 结构
- 视觉和知识适配器用于对齐不同模态
- 跨模态对齐模块优化图像-文本匹配
这项研究的核心创新在于使用多模态知识图谱而不是仅文本的知识来为语言模型的推理任务提供更丰富的上下文信息。
该方法在训练参数方面很高效,同时还能实现更好的性能。
解法拆解
目的:增强大语言模型的多模态推理能力
问题:现有大语言模型在多模态推理时容易产生幻觉,且知识可能不足或过时
解法:MR-MKG 框架
-
子解法1:使用多模态知识图谱(因为需要丰富的跨模态知识)
- 之所以用 MMKG,是因为单一模态的知识表示不足以支持复杂的推理任务
-
子解法2:关系图注意力网络编码(因为需要捕捉知识图谱中的复杂结构关系)
- 之所以用 RGAT,是因为普通的图网络无法有效处理关系信息
-
子解法3:跨模态适配对齐(因为需要融合不同模态的信息)
- 之所以设计适配器和对齐模块,是因为不同模态的表示空间存在差异
- 逻辑链结构:
MR-MKG框架
├── 知识获取
│   ├── 多模态知识图谱构建
│   └── 知识检索策略
├── 知识表示
│   ├── RGAT编码
│   └── 模态适配
└── 知识应用
    ├── 跨模态对齐
    └── 推理生成
- 隐性特征:
- 知识质量:检索到的知识必须相关且有用
- 模态平衡:不同模态信息的权重分配
- 计算效率:参数量与性能的权衡
- 领域适应:模型对不同任务的泛化能力
- 潜在局限性:
- 依赖高质量的多模态知识图谱
- 知识检索可能不准确,引入无关信息
- 跨模态对齐可能存在信息损失
- 在高性能模型上提升空间有限
- 计算资源要求较高
例子:以论文中的例子来看,当模型需要判断"哪种鱼的嘴适合撕裂肉类"时,如果知识图谱中缺乏相关信息或检索到的是电影"大鱼"这样的无关信息,就会导致推理失败。这说明了知识质量和检索准确性的重要性。
全流程拆解
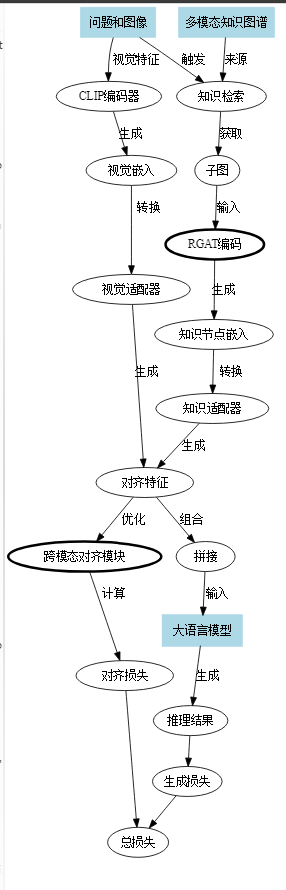
输入输出分析:
- 输入:
- 问题文本
- 相关图像
- 多模态知识图谱
- 处理流程:
- 知识检索
- 特征编码
- 模态对齐
- 知识融合
- 推理生成
- 输出:
- 推理答案
- 置信度分数
优化建议:
- 知识检索优化:改进相关性计算方法
- 特征提取增强:使用更先进的视觉编码器
- 对齐机制改进:设计更精确的跨模态对齐方法
- 推理过程优化:引入推理链或思维链条
- 参数效率提升:进一步减少需要训练的参数量
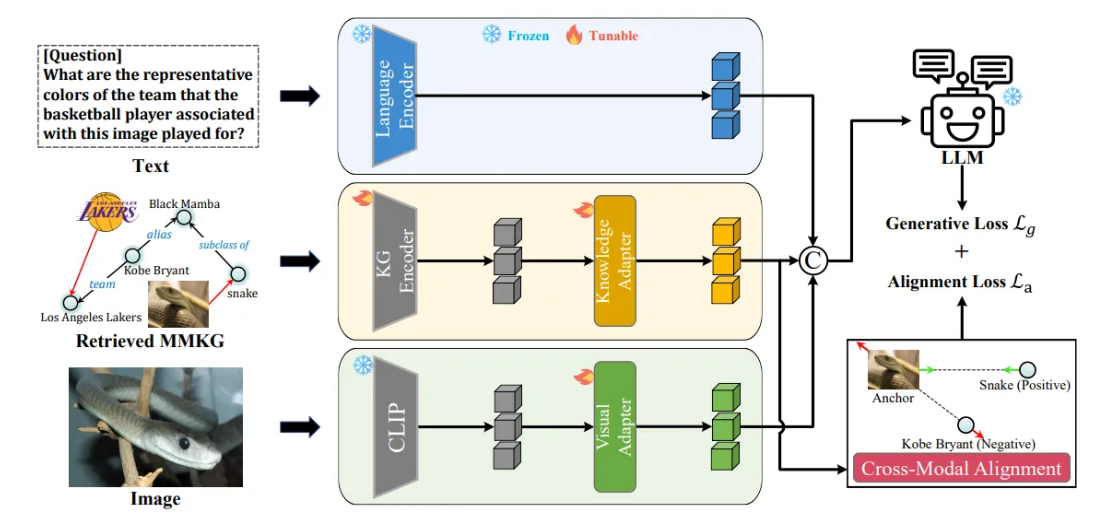
- 输入处理:
- 文本输入通过语言编码器处理
- 图像通过CLIP模型处理
- 多模态知识图谱(MMKG)通过知识图谱编码器处理
- 架构特点:
- 包含三个独立的编码路径(语言、知识图谱、图像)
- 使用专门的适配器(Knowledge Adapter和Visual Adapter)
- 设计了跨模态对齐模块来优化图像-文本匹配
- 最终输出包含生成损失和对齐损失
论文大纲
├── 1 引言【问题背景】
│      ├── 大语言模型的多模态推理挑战【现状】
│      │      ├── 容易产生幻觉【具体问题】
│      │      └── 知识可能缺失或过时【具体问题】
│      └── 现有解决方案的局限【技术现状】
│             └── 仅使用文本知识图谱【局限性】
│
├── 2 MR-MKG方法【技术方案】
│      ├── 多模态知识图谱【基础组件】
│      │      ├── 文本信息【知识类型】
│      │      ├── 图像信息【知识类型】
│      │      └── 实体关系【知识类型】
│      ├── 知识编码模块【核心模块】
│      │      ├── RGAT网络【技术选择】
│      │      └── 节点嵌入生成【功能】
│      ├── 模态适配层【核心模块】
│      │      ├── 视觉适配器【组件】
│      │      └── 知识适配器【组件】
│      └── 跨模态对齐【核心模块】
│             ├── 图像-文本匹配【功能】
│             └── 对齐损失计算【功能】
│
├── 3 训练策略【实现方法】
│      ├── 预训练阶段【训练步骤】
│      │      └── MMKG-grounded数据集【数据来源】
│      └── 微调阶段【训练步骤】
│             └── 特定任务适应【目标】
│
└── 4 实验验证【评估结果】
├── 问答任务评估【应用场景】
│      └── 准确率提升1.95%【效果】
├── 类比推理评估【应用场景】
│      └── Hits@1提升10.4%【效果】
└── 参数效率【性能指标】
└── 仅训练2.25%参数【优势】
四大组件分析
- 语言编码器
- 目标:将文本映射到统一的向量空间
- 实现方式:
- 利用预训练LLM的embedding层
- 在训练和推理阶段保持固定不更新参数
- 生成文本嵌入HT作为基础表示
- 视觉编码器
- 目标:提取图像的语义特征
- 主要特点:
- 使用预训练的CLIP视觉编码器
- 通过视觉适配器(visual adapter)将特征映射到语言空间
- 具体步骤:
- 将图像转换为视觉特征XI
- 使用线性层转换为视觉-语言嵌入HI
- 通过注意力机制与文本特征对齐得到H’I
- 知识图谱编码器
- 目标:学习图结构中的知识表示
- 核心实现:
- 采用RGAT(关系图注意力网络)
- 处理流程:
- 基于文本/图像检索相关子图
- 使用CLIP初始化节点和关系嵌入
- RGAT生成考虑图结构的知识节点嵌入XK
- 知识适配器将XK映射到语言空间得到H’K
- 跨模态对齐模块
- 目标:优化不同模态表示之间的对齐
- 实现机制:
- 在MMKG中构建图像-文本匹配任务
- 使用三元组损失进行优化:
- 锚点:图像实体嵌入
- 正样本:对应文本实体嵌入
- 负样本:其他文本实体嵌入
- 最小化正样本距离,最大化负样本距离
关键创新点:
- 多模态知识融合:将文本、视觉和知识图谱信息统一到语言空间
- 端到端训练:通过联合优化实现模态间的有效对齐
- 参数高效:仅训练适配器和对齐模块,大模型参数固定
患者提问:“这片皮肤红肿(附带图片)可能是什么问题?我有糖尿病病史。”
- 语言编码器处理
- 输入:患者的文字描述和病史
- 处理:将文字信息转换为向量表示
- 输出:包含症状描述和病史背景的语义表示
- 视觉编码器处理
- 输入:患者上传的皮肤症状图片
- 处理:
- CLIP提取图像特征
- 将视觉特征转换为与文字描述相兼容的表示
- 重点关注皮肤的颜色、纹理、形态等特征
- 输出:皮肤症状的视觉特征表示
- 知识图谱编码器处理
- 检索相关医学知识:
- 皮肤红肿相关的疾病信息
- 糖尿病相关并发症
- 类似病例图片
- 建立知识关联:
- 症状与可能病因的关联
- 病史与并发症风险的关联
- 视觉症状与典型案例的对比
- 跨模态对齐
- 将当前病例与知识库中的案例对齐:
- 症状描述的文本对齐
- 图像症状的视觉对齐
- 结合患者具体情况进行个性化匹配

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献31条内容

所有评论(0)