G-VCFL: Grouped Verifiable Chained Privacy-Preserving Federated Learning 可验证链式联邦学习
概括
提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加
联邦学习主要面对隐私泄露和聚合服务器单点故障,攻击者可以使用中间模型推断用户隐私,甚至操纵聚合服务器返回不正确的全局模型,面对这些安全威胁本文将G-VCFL作为一种分组可验证的链式隐私保护联邦学习方案提出。
具体地说,首先使用分组链学习机制来保证用户的隐私,然后提出一种可验证的安全聚合协议来保证全局模型的可验证性。G-VCFL不需要任何复杂的密码原语,也不引入噪声,但通过使用轻量级伪随机发生器实现了可验证的隐私保护联邦学习。
提示:写完文章后,目录可以自动生成,如何生成可参考右边的帮助文档
文章目录
介绍
提示:这里可以添加本文要记录的大概内容:
用户的数据可能包含隐私信息。例如,在医疗诊断中,患者数据是高度隐私的,不能直接与第三方共享。此外,收集大量数据成为一个主要挑战,特别是在网络资源有限的情况下。所有这些问题使得集中式机器学习极具挑战性。
联合学习由多轮培训组成。在每一轮训练中,聚合服务器基于规则将全局模型分发给所选择的用户。然后,用户在其本地数据集上训练本地模型并将其上载到服务器,并且聚合服务器执行模型聚合以获得新的全局模型。
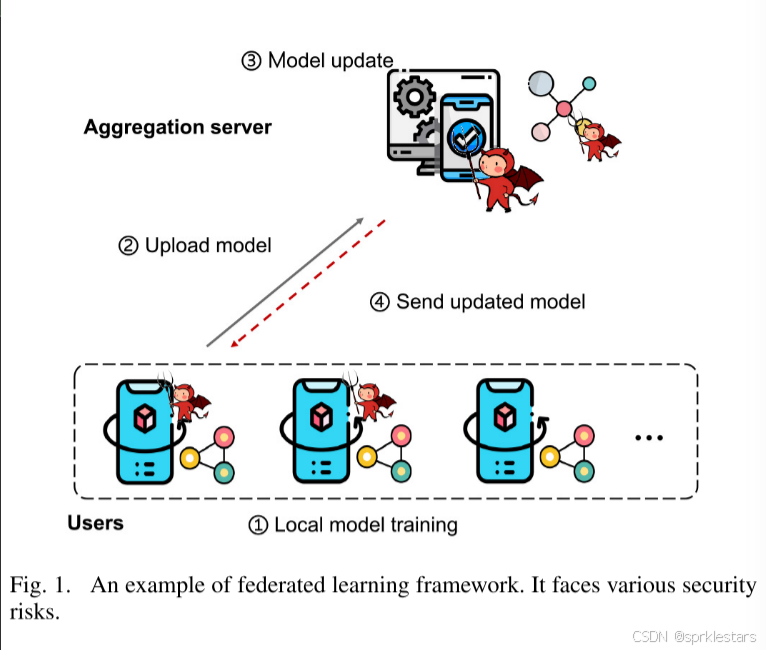
虽然Federated Learning会在本机保留敏感的训练数据,但它仍会面临安全性风险。图1说明了对联邦学习的可能攻击威胁。具体来说,联邦学习面临着来自用户和聚合服务器的威胁。
对于用户而言,最近的研究表明,在用户和服务器之间共享中间模型更新会导致各种隐私风险,例如成员推理攻击和各方输入的提取。
对于聚合服务器,最近的研究也表明,聚合服务器面临单点故障风险。例如,在对手危害服务器后,对手可以使其返回不正确的聚合结果,这会误导甚至破坏机器学习训练。
同时,“懒惰的”聚合服务器可以返回简单的、不太准确的模型以减少其计算成本。因此,保护用户隐私和防止聚合服务器的单点故障尤为重要。“
针对这些问题提出了差分隐私,安全多方计算等各种技术,但是都有各自的缺陷,联合学习由多轮培训组成。
在每一轮训练中,聚合服务器基于规则将全局模型分发给所选择的用户。然后,用户在其本地数据集上训练本地模型并将其上载到服务器,并且聚合服务器执行模型聚合以获得新的全局模型。
虽然Federated Learning会在本机保留敏感的训练数据,但它仍会面临安全性风险。图1说明了对联邦学习的可能攻击威胁。具体来说,联邦学习面临着来自用户和聚合服务器的威胁。对于用户而言,最近的研究表明,在用户和服务器之间共享中间模型更新会导致各种隐私风险,例如成员推理攻击和各方输入的提取。对于聚合服务器,最近的研究[也表明,聚合服务器面临单点故障风险。例如,在对手危害服务器后,对手可以使其返回不正确的聚合结果,这会误导甚至破坏机器学习训练。同时,“懒惰的”聚合服务器可以返回简单的、不太准确的模型以减少其计算成本。因此,保护用户隐私和防止聚合服务器的单点故障尤为重要。“为了实现这一目标,我们需要采取有效和安全的方法。显然,上述解决方案在解决该问题方面具有局限性。为此,我们需要回答以下问题:构建一个联邦学习解决方案,可以通过计算轻量级的方法验证聚合结果的正确性,同时保护用户的隐私。
为实现这一目标,遵循三大关键研究思路:
1)最小化服务器上可见的用户数量,
2)避免使用复杂的加密原语,
3)最小化聚合次数。
根据这三点,提出了一种分组可验证链式联邦学习方案,称为G-VCFL。
具体来说,
1)为了减少聚合服务器上可见的用户数量,G-VCFL将用户分成不同的用户组,每个用户组在每一轮训练中只需要与聚合服务器交互一次,从而服务器将每个用户组视为一个用户;
2)为了减少复杂加密原语的使用,G-VCFL采用链式学习结构,每个用户的信息由前一个用户保护;
3)为了最小化聚合次数,G-VCFL在模型和标签聚合的训练协议中使用双重聚合方法,以满足模型训练和验证的要求。
更具体地说,G-VCFL使用类似于Chain-PPFL 的链式训练结构来完成训练,并嵌入验证标签以验证聚合结果的正确性。值得注意的是,与Chain-PPFL不同,G-VCFL使用分组链式训练结构进一步提高训练效率,并且G-VCFL能够验证聚合结果的正确性。
主要贡献总结如下:
我们提出了G-VCFL,这是一种分组可验证链式联邦学习方案。其简单且易用的架构使其易于部署在计算资源有限的设备上。
G-VCFL在保证效率的同时保护用户本地模型的隐私和聚合结果的正确性。
我们实现了G-VCFL的系统原型,并在MNIST和CIFAR-10数据集下进行了实验评估。实验结果表明,G-VCFL的安全措施对模型训练没有负面影响,满足实际场景的要求。
提示:以下是本篇文章正文内容,下面案例可供参考
前瞻工作
保护隐私的联邦学习
隐私保护的联邦学习关注用户在训练过程中的隐私,其主要目的是防止聚合服务器窃取用户的隐私。目前,隐私保护的联邦学习主要基于
1)同态加密(HE),
2)差分隐私(DP)
3)安全多方计算(SMC)。
对于HE,通过使用加密算法为数据传输过程提供了强大的隐私保障。
此外,数据拥有者与训练方之间的交互影响通信开销。
为了避免多轮数据交互,Li等人提出了一个非交互式联合学习框架,并通过Paillier同态加密技术保护数据和模型的隐私。
张等人也使用Paillier加密实现了梯度的安全聚合。然而,这类方案由于同态加密的计算复杂性和密文扩展而带来了较大的计算和通信开销。显然,在计算资源较低的联邦学习场景中不能使用此类方案。
对于SMC,许多研究采用了服务器模型上运行的多方计算(MPC)技术。例如,Chaudhari等人提出了一个名为Trident的高效4PC隐私保护机器学习框架。但是,Trident无法容忍恶意参与方。
相比之下,BLAZE是一个更高效的隐私保护机器学习协议,允许存在恶意腐败方的情况下保障三台服务器的公平性。
然而,这类方案支持的参与方数量有限。因此,Sav等人提出了一种新的系统POSEIDON,该系统使用基于格的多方密码学来保护数据和模型的机密性。然而,它需要执行多轮多方计算协议,通信开销较高。
显然,这类方案更适合少数用户的机器学习。因此,为了满足本文的要求,我们必须提出一种新的方案,以在计算资源低的情况下保护众多用户的隐私。
对于DP,隐私通常通过向模型梯度或原始数据中添加噪声来实现。添加噪声后,聚合服务器无法从中间参数中推断出用户隐私。
Abadi等人首次提出了一种基于DP的深度学习方案,该方案使用高斯噪声来模糊梯度,展示了DP在隐私保护机器学习中的关键作用。此外,当数据分布不均且计算能力差距较大时,联邦学习训练的效率较低。
为了弥补这一差距,Zhou等人提出了一种基于本地差分隐私的联邦学习方案,提高了模型训练效率,同时保护用户隐私。同时,DP的隐私预算被广泛使用,这导致模型精度显著下降。因此,Zhu等人提出了一种细粒度DP联合学习方案(DPFL),在保证隐私的同时保持高模型性能。
不幸的是,如果对手利用GAN网络攻击协议,基于DP的策略都将不再安全。我们还需要注意,此类方案对模型精度有负面影响。此外,由于在参数中添加了噪声,用户无法通过可验证计算验证聚合的正确性,这也导致这种方案存在问题。
为什么说用GAN网络攻击协议,基于DP的策略都将不再安全
在DP机制中,添加噪声是为了掩盖数据的具体细节,防止隐私泄露。然而,GAN通过不断的训练,生成器可以找到噪声中的模式并逐步去除噪声,恢复数据的潜在结构。这就导致DP无法完全隐藏数据的隐私信息。
GAN可以通过训练生成一个与原始数据分布相似的模型,即使原始数据经过了差分隐私保护。这样,攻击者可以利用GAN生成的新数据来推测用户的数据分布,从而泄露用户隐私。例如,攻击者可以根据GAN生成的样本来分析用户的敏感信息,如位置、行为特征等。
GAN网络攻击协议不仅能够利用训练数据,还可以通过模型的输出结果进行攻击。即使差分隐私在模型训练中对梯度或参数添加了噪声,GAN可以从中学到规律并生成与原始数据相似的样本,间接泄露用户的隐私信息。
生成对抗网络是一个不断改进的过程,随着生成器和判别器的增强,攻击者可以设计出更强大的模型,来破解甚至绕过现有的隐私保护机制,如差分隐私。对于DP策略来说,这是一个潜在的威胁,因为GAN攻击可以逐渐找到隐私保护中的薄弱环节。
可验证的联邦学习
联邦学习的聚合服务器常面临单点故障的问题,且可能返回错误的聚合结果。因此,验证聚合结果的正确性非常重要。然而,仅有少数研究提出了验证聚合结果正确性的方法。
Xu等人提出了VerifyNet,这是第一个可验证的隐私保护联邦学习方案。它在安全聚合协议中加入了可验证计算。
然而,VerifyNet的通信开销与梯度向量的维度呈线性关系。为了减少VerifyNet在处理高维梯度向量时的过高通信开销,Guo等人提出了VERIFL。
类似地,VERIFL也利用了同态哈希函数,这使得VERIFL和VerifyNet都需要所有用户共享同态哈希的秘密值。为了解决这一问题,Hahn等人提出了VERSA。然而,VERSA仍然需要每个用户与聚合服务器通信,并且验证阶段的计算开销与用户数量呈线性关系。除此之外,Fu等人提出了VFL,一种用于工业物联网隐私保护大数据的可验证联邦学习方法。
它使用拉格朗日插值来精确设置插值点以验证聚合梯度的正确性。
类似地,张等人通过结合中国剩余定理和Paillier同态加密提出了一种可验证的隐私保护联邦学习方案。然而,这类方案需要所有用户预先共享预定义的秘密参数,显然不适合大规模用户的分布式训练的实际需求。
对比
从技术上讲,以往方法与本文的主要区别在于,它们大多使用复杂的密码原语,并且需要用户之间进行多次通信,通信和计算开销很高。
例如,SMC和基于HE的隐私保护方案经常招致显著的通信和计算开销。
与本文工作最相关的工作是VERIFL 和VERSA ,它们实现了对聚合结果的验证,同时保护了隐私。
然而,由于VERIFL使用线性同态散列,因此每个用户需要与其他用户通信以获得其他用户的梯度的线性同态散列。
这导致了巨大的通信开销,尤其是当用户数量变得很大时。另外,VERSA要求每个用户上传标签,聚合规则采用秘密共享技术,这就需要用户与聚合服务器进行多次通信,通信开销也比较大。
因此,我们无法使用VERIFL和VERSA来实现有效的可验证隐私保护联邦学习。
与此相反,我们提出了分组可验证链联邦学习方案。它不使用线性同态散列或秘密共享,而是简单地将验证标签上传到聚合服务器。
这样,每组用户只需要上传一次验证标签,不需要额外的操作,大大降低了通信开销。
这也消除了在其用户之间进行多次交互的需求。与传统的联合学习算法相比,该方案具有密文长度短、计度快的优点,因此更适用于大规模低计算资源用户场景下的联合学习。
为什么要分组?
- 线性同态散列的使用原因
验证多个用户的数据完整性:在传统的联邦学习中,如果不使用分组验证,每个用户需要保证其本地计算的正确性和完整性。线性同态散列允许对加密或隐藏的数据进行验证,而无需解密。每个用户需要计算和共享其梯度的线性同态散列,以确保参与方在聚合过程中的贡献是可靠的。
全局验证需求:当涉及到验证整个用户集合的聚合结果时,需要用户之间进行多次通信来共享和验证线性同态散列。这保证了所有用户的贡献都被正确地聚合在一起,并且未被篡改。但这种方法的缺点是通信和计算开销很高,尤其是在用户数量庞大时,因为每个用户都要参与到验证协议中,交换和验证多个同态散列值。
- 分组验证中只使用简单标签的原因
分组结构的优势:在分组验证方案中,将用户分为若干组,每组视为一个单独的实体来进行处理。这样,每组用户只需与聚合服务器进行一次交互,上传验证标签即可,而不需要与其他用户进行多次通信。验证标签可以是基于聚合结果的签名或验证标记,能够证明该组的贡献是有效的。
通信减少:由于每组用户的贡献被视为一个整体,服务器只需验证该组的验证标签,而不是验证每个用户的线性同态散列。这样大大减少了通信开销和复杂度。验证标签的实现可以采用简单的加密签名或哈希标记,这样减少了用户间的多轮交互和服务器的计算负担。
简化的验证过程:验证标签不涉及复杂的同态运算,因此计算和通信更加轻量。只需验证上传的标签是否符合预期来确认数据的正确性,这减少了通信频率和每轮通信的成本。
设计目标
我们的目标是设计一个安全有效的可验证的联邦学习方案,既能保护用户隐私,又能验证聚合服务器返回结果的正确性。在这里,我们使用没有攻击的FedAvg 作为基线来讨论保真度。
FedAvg是Google提出的一种典型的联邦学习解决方案,它将来自不同用户的局部模型更新的平均值作为全局模型更新。
本文中的核心聚合规则类似于FedAvg,但增加了隐私保护和可验证聚合。具体来说,我们设计的联邦学习方案需要满足以下设计目标:·
效率:我们的方案应该只引入有限的计算开销,并支持资源受限的用户。特别是,该方案不能使用密码原语,如同态加密,散列和秘密共享。
保真度:我们的方案不应该对模型的准确性产生负面影响
。特别是,我们的计划的预测精度应该是一致的FedAvg没有安全措施。
·安全性:我们的方案应该保护用户的隐私,并防止聚合服务器发起推断攻击来推断用户信息。此外,为了防止聚集服务器恶意篡改聚集结果并返回错误消息,我们的方案应该支持对聚集结果的验证,以确保模型训练的正确性。
安全聚合
`提示:这里对文章进行总结:
在安全聚合方面,一个简单的解决方案是调用现有的安全聚合协议。
用户在将中间参数上传到聚合服务器之前对中间参数进行双重询问,并且在聚合之后移除掩蔽因子。
然而,这种简单的解决方案在实践中是不可行的,因为它通常需要每个用户与其他用户协商掩蔽因子,导致高通信开销。当用户数量很大时,它不够实用。
此外,联邦学习在训练中迭代多次,这可能导致昂贵的训练开销。因此,迫切需要减轻隐私保护技术的过度开销。在可验证聚合方面,一个简单的想法是使用同态标签。
具体来说,首先,每个用户为其上传的中间参数生成一个线性同态散列;其次,它与其他用户进行通信,收集其他用户的散列;然后,它计算所有用户的散列之和;最后,它比较这个散列之和是否等于聚合结果的散列。
如果它们相等,则验证通过。然而,这样的解决方案还需要用户之间的交互,从而传递由不同用户上传的中间参数(注意,中间参数通常以加密的方式在用户之间共享),导致显著的开销。
此外,同态标签的计算也会带来很大的开销。这种解决方案的开销是联邦学习无法承受的。总的来说,这些解决方案的主要限制是过多的开销。特别是,联邦学习用户的数量可能非常大,更小的通信开销意味着更好的性能。因此,我们面临着以下困境:如何在保证用户隐私的同时验证聚合结果的正确性?此外,如何缓解安全措施导致的高培训开销问题?
威胁模型
与之前的工作类似,我们假设聚合服务器是恶意的,可能会直接提供错误的信息或偏离预定义协议来执行不同的计算逻辑,从而向所有用户返回错误的全局模型。
此外,服务器可以通过观察收到的本地模型参数来推测用户的隐私。这在实际应用中也符合现实,因为在实践中,系统经常面临单点故障的风险。攻击者可能会攻破聚合服务器,伪造错误的聚合结果,窃取用户隐私。
对于用户,我们假设大多数用户是“诚实但好奇”的,即他们会执行协议,但可能会推测其他用户的私人信息。之所以做出这一假设,是因为在现实世界中,用户会参与学习以获取全局模型,但不能保证他们不会对其他信息感到好奇。
总体而言,我们方案的安全目标是保护用户上传参数的隐私,并防止服务器篡改聚合结果。
模型设计
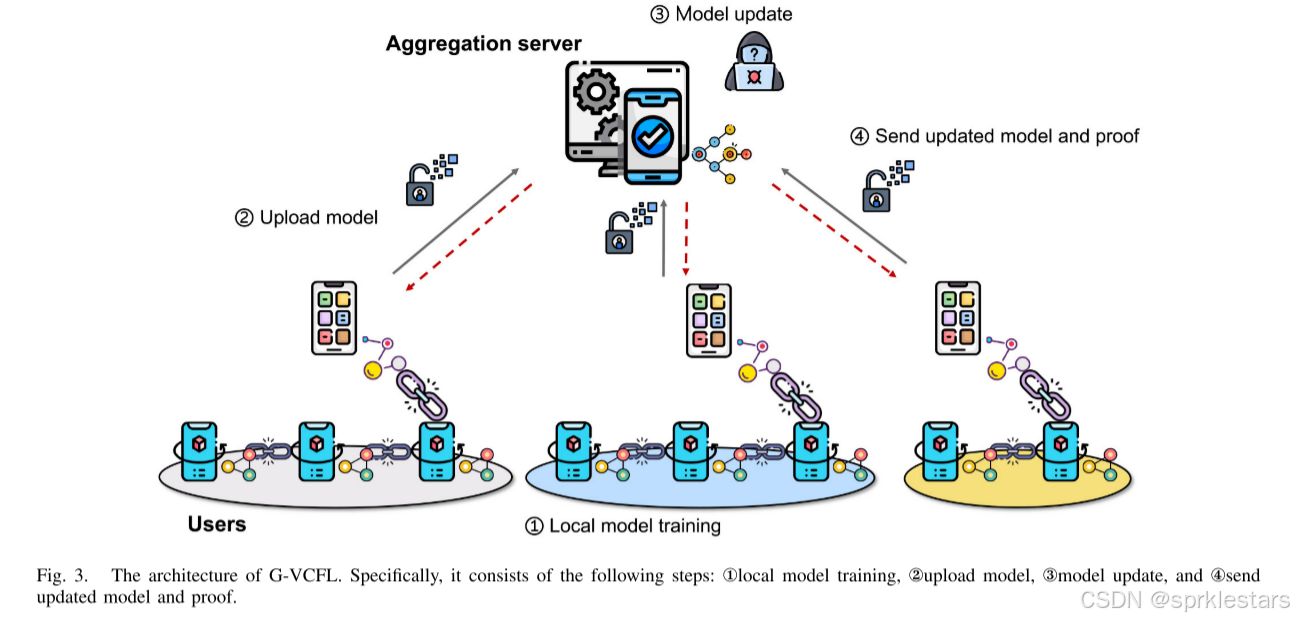
该方案的核心思想是减少复杂计算和多方通信的需要,以实现安全的联邦学习。
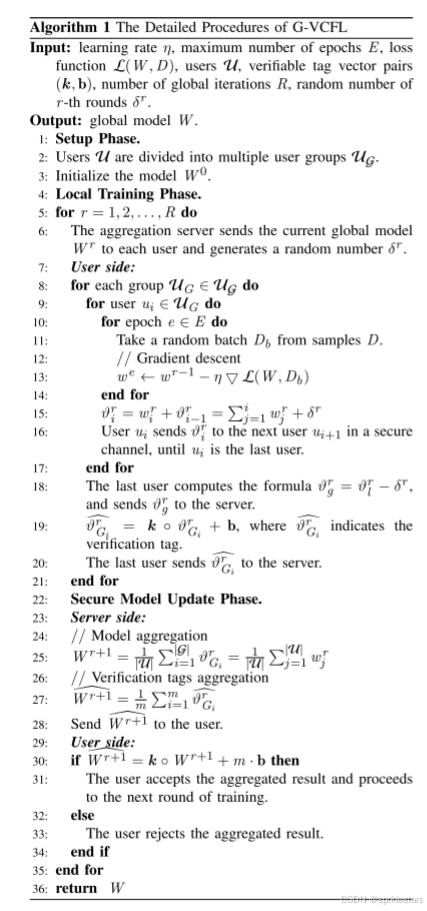
为此,我们提出了一个分组可验证的链式联邦学习方案G-VCFL(结构如图3所示),它达到了预期的设计目标。该方案的细节在算法1中描述。
具体地,将用户分成多个组,每组形成链式学习结构进行训练,然后将每组的训练结果发送给聚合服务器,最后聚合服务器进行双重聚合并返回聚合结果。
用户验证聚合结果的正确性,然后转到下一个迭代。
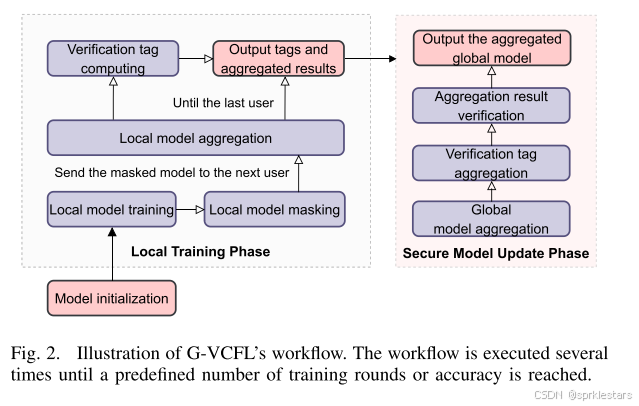
主要工作流程如图2所示。
为了便于理解,我们将G-VCFL分为三个阶段进行描述:
设置阶段、本地训练阶段和安全模型更新阶段。
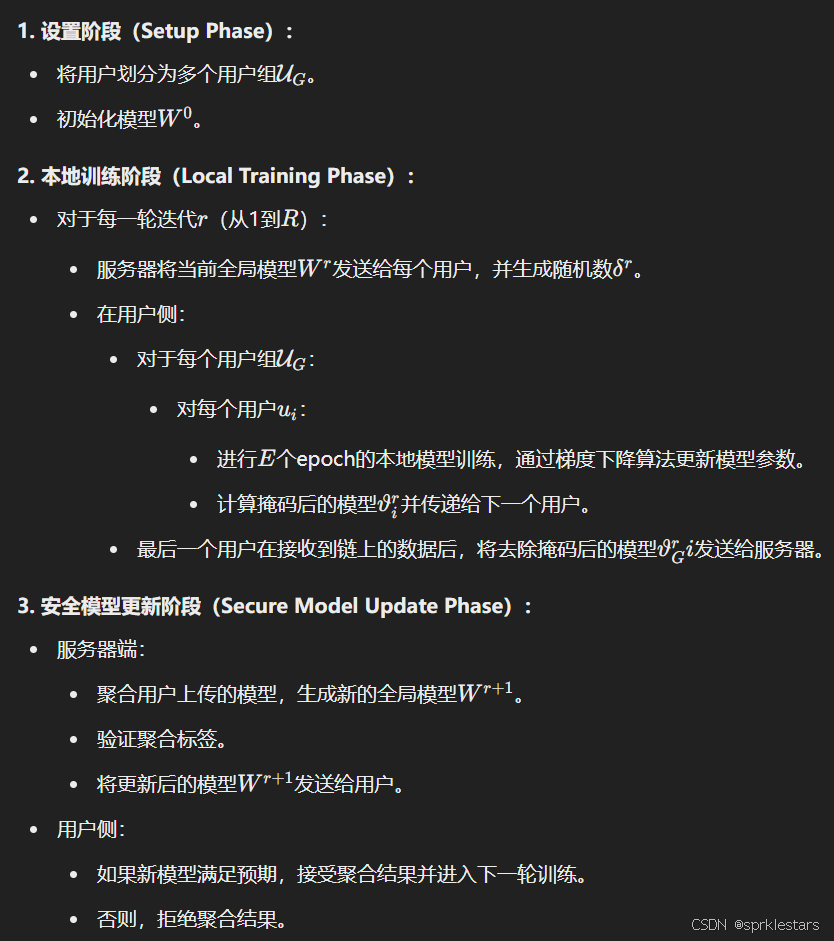
设置阶段:在此阶段中,主要关注的是初始化模型、构建网络拓扑以及将用户划分为若干个用户组。
本地培训阶段:此阶段主要关注链模型学习和将本地聚合结果上传到服务器。
具体地,每个用户首先进行局部模型训练,然后每组内的用户对训练结果进行局部模型聚合,最后将不同组的局部模型聚合结果上传到聚合服务器。同时,为了验证全局模型聚合结果的正确性,还需要将验证标签上传到服务器。
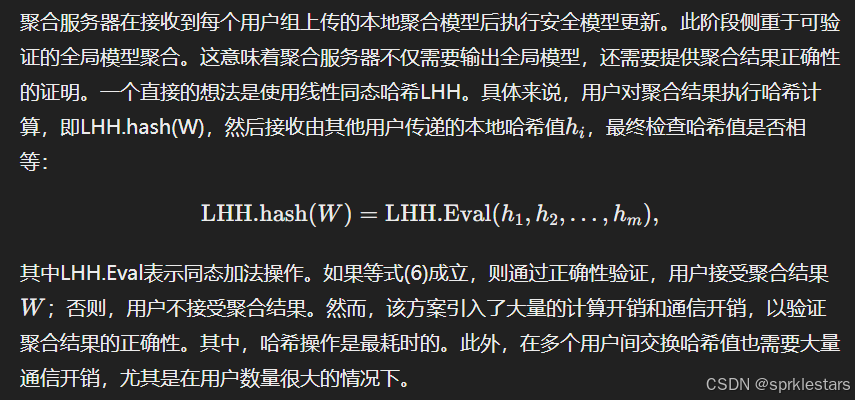
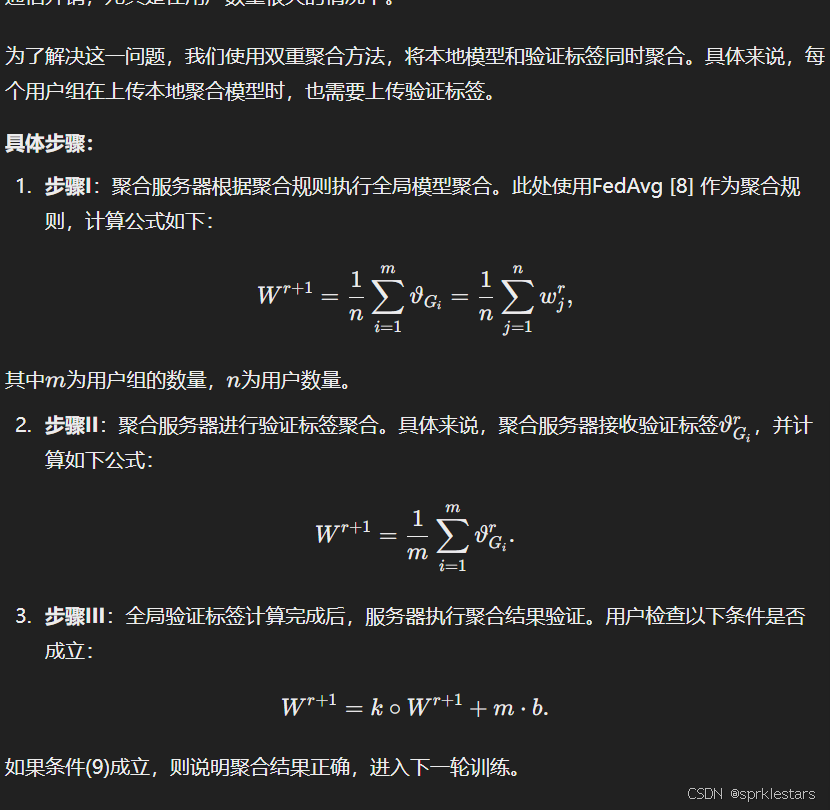
安全模型更新阶段:此阶段的重点是可验证的全局模型聚合,主要是防止服务器返回不正确的聚合结果。具体地,聚合服务器执行两个聚合,一个用于接收到的本地模型参数,另一个用于验证标签。
通过验证标签,用户可以验证聚合结果的正确性。如果验证通过,用户接受聚集的结果。
然后开始新一轮的训练迭代,直到模型训练完成。
算法设计
设计阶段
具体技术细节分为三个阶段:
设置阶段、
本地训练阶段和
安全模型更新阶段。
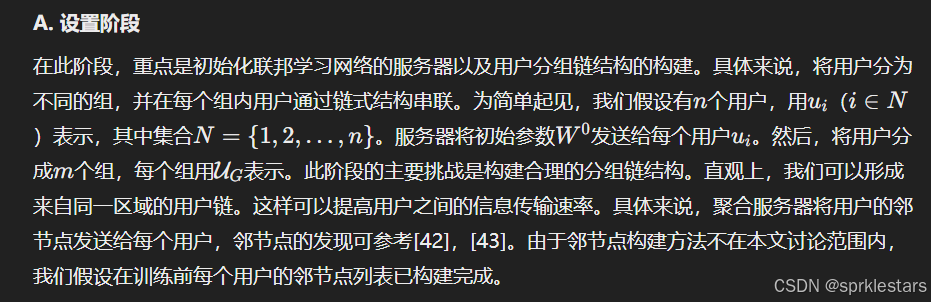
设置阶段
本地训练阶段
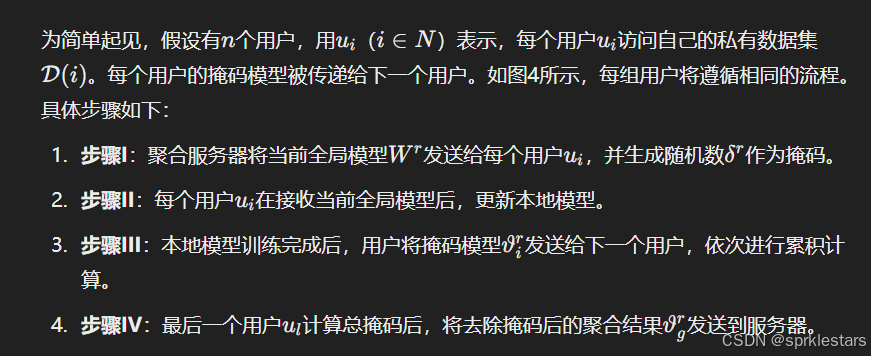
在此阶段,主要集中于用户本地模型的链式学习和训练结果的上传。具体来说,包括本地模型训练和隐私保护的模型上传。在本地模型训练中,每个用户在其本地数据集上使用SGD算法训练模型。每轮训练中,他们在本地数据集上迭代多次。完成本地模型训练后,进行隐私保护的模型上传。隐私保护模型上传时,每个用户以安全方式上传本轮训练结果到聚合服务器。需要注意的是,并非所有用户都需上传其本地训练模型。通常,每组中最后一个用户负责上传该组的训练结果。
算法:
安全模型更新阶段

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 12
 0
- 0


 已为社区贡献4条内容

所有评论(0)