简单!直接copy代码就可运行!爬虫获取知乎评论!!!
目录
一、代码简介
以下是获取知乎评论的python代码。此代码直接赋值粘贴在本地就可以直接运行(只需要修改三处即可)!适用于那些急需要爬取知乎评论,没有时间弄懂原理的同学!
第一处:获取 answer 号,这是整个代码唯一的输入!
第二处:获取你的 User-Agent。
第三处:获取你的 cookie。
我已经在代码中用 TODO 标记了需要输入参数的地方,直接 ctrl+F就可以找到!下面我将一一介绍如何获取这三个参数。
import csv
import requests
import time

def trans_date(v_timestamp):
    """10位时间戳转换为时间字符串"""
    v_timestamp = float(v_timestamp)
    timeArray = time.localtime(v_timestamp)
    otherStyleTime = time.strftime("%Y-%m-%d %H:%M:%S", timeArray)
    return otherStyleTime

def tran_gender(gender_tag):
    """转换性别"""
    if gender_tag == 1:
        return '男'
    elif gender_tag == 0:
        return '女'
    else:  # -1
        return '未知'

def fecth_everything(comment):
    gender = tran_gender(comment["author"]["member"]["gender"])
    # 评论的时间
    time_un = comment["created_time"]
    publish_time = trans_date(time_un)
    # 评论的IP属地
    IP = comment["address_text"]
    # 评论的内容
    content = comment["content"]
    # 评论的点赞数
    num = comment["vote_count"]

    return gender, publish_time, IP, content, num

# TODO:输入 answer 号
answer_id = input("请输入 answer 号:")
# TODO:添加你的 User-Agent
ua = " "
# TODO:添加你的 cokkie
c = " "
# 定义参数
headers = {
    'user-agent': ua
}
cookies = {
    # 填自己的z_0 cookie
    'cookie': c
}

# 加载 csv 文件
f = open("comments.csv", mode="a", encoding="utf-8-sig")
csv_write = csv.writer(f)

# 开始爬取
i = 0
j = 1
offset = 0
while i == 0:
    # 获取数据
    url = f"https://www.zhihu.com/api/v4/answers/{answer_id}/root_comments?order=normal&limit=20&offset={offset}&status=open"
    resp = requests.get(url, headers=headers, cookies=cookies)
    data = resp.json()
    # 无数据时终止循环
    if data["data"] == None:
        break
    print(f"正在爬取第{j}页!")
    comments = data["data"]
    for comment in comments:
        # 获取信息
        gender, publish_time, IP, content, num = fecth_everything(comment)
        # 存文件
        csv_write.writerow([gender, publish_time, IP, content, num])

        # 读取子评论
        if comment["child_comments"]:
            for child in comment["child_comments"]:
                gender, publish_time, IP, content, num = fecth_everything(child)
                # 存文件
                csv_write.writerow([gender, publish_time, IP, content, num])

    # 读取下一个 url
    offset += 20
    j += 1
    # 终止读取
    if offset == 1000:
        break

f.close()
print("Over!")
二、获取 answer 号
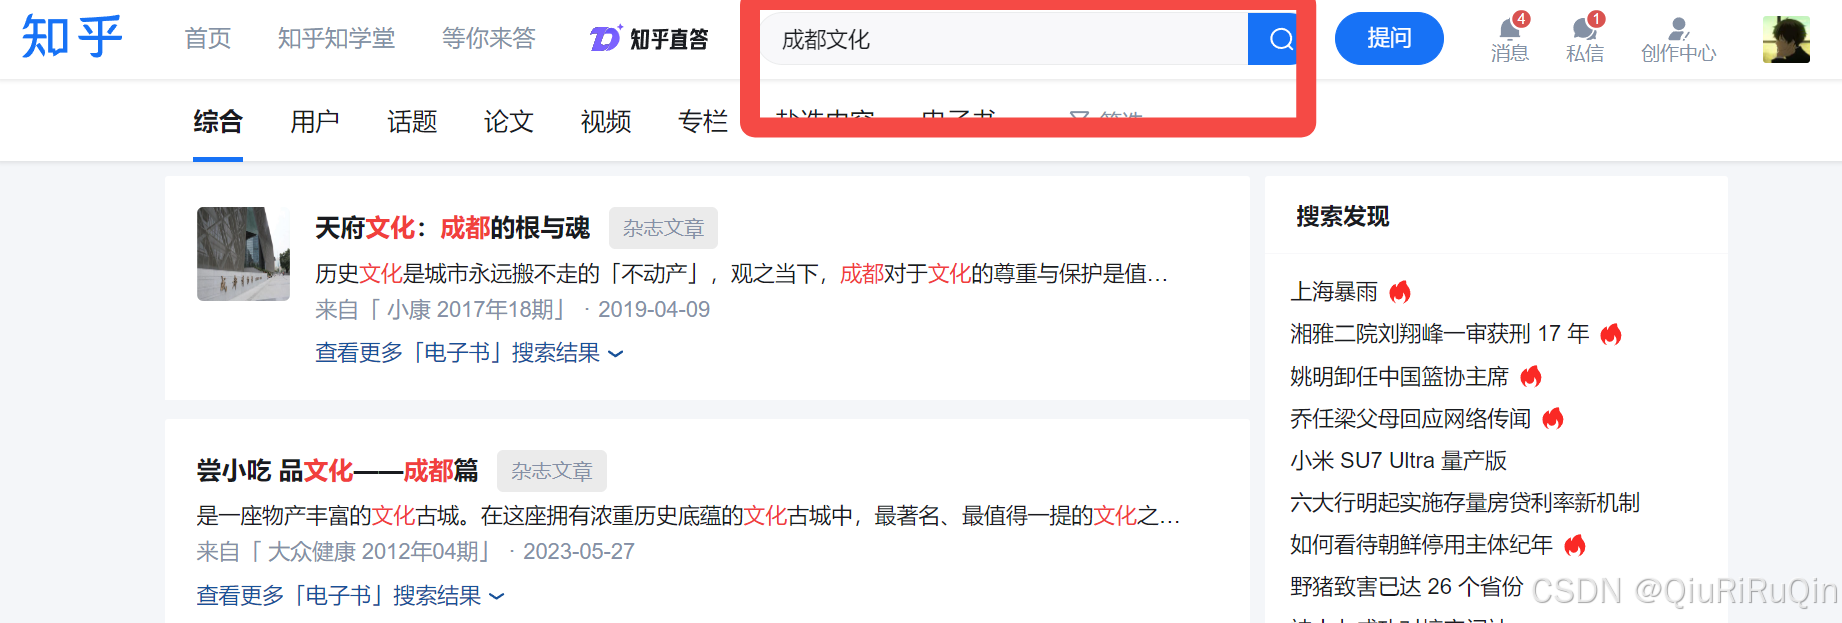
2.1 搜索一个问题
首先就是搜索一个问题,随便什么都可以
2.2 点开一个回答
在这个问题下,直接点开其中一个回答,就可以跳转到其页面。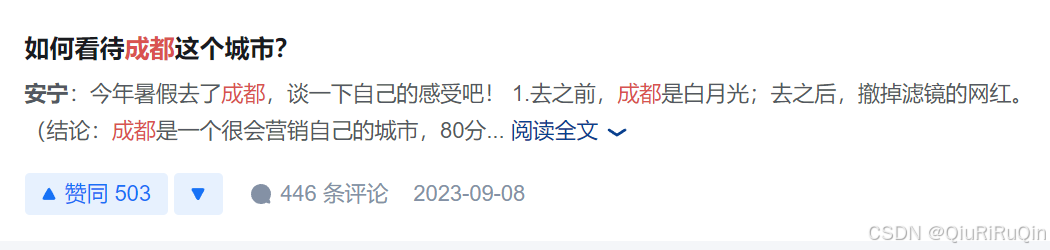
2.3 复制 answer 号
answer 号就是链接地址中 answer/ 后面的那一串数字。
好了!到这里,获取第一个参数—— answer 号的任务就完成了!!!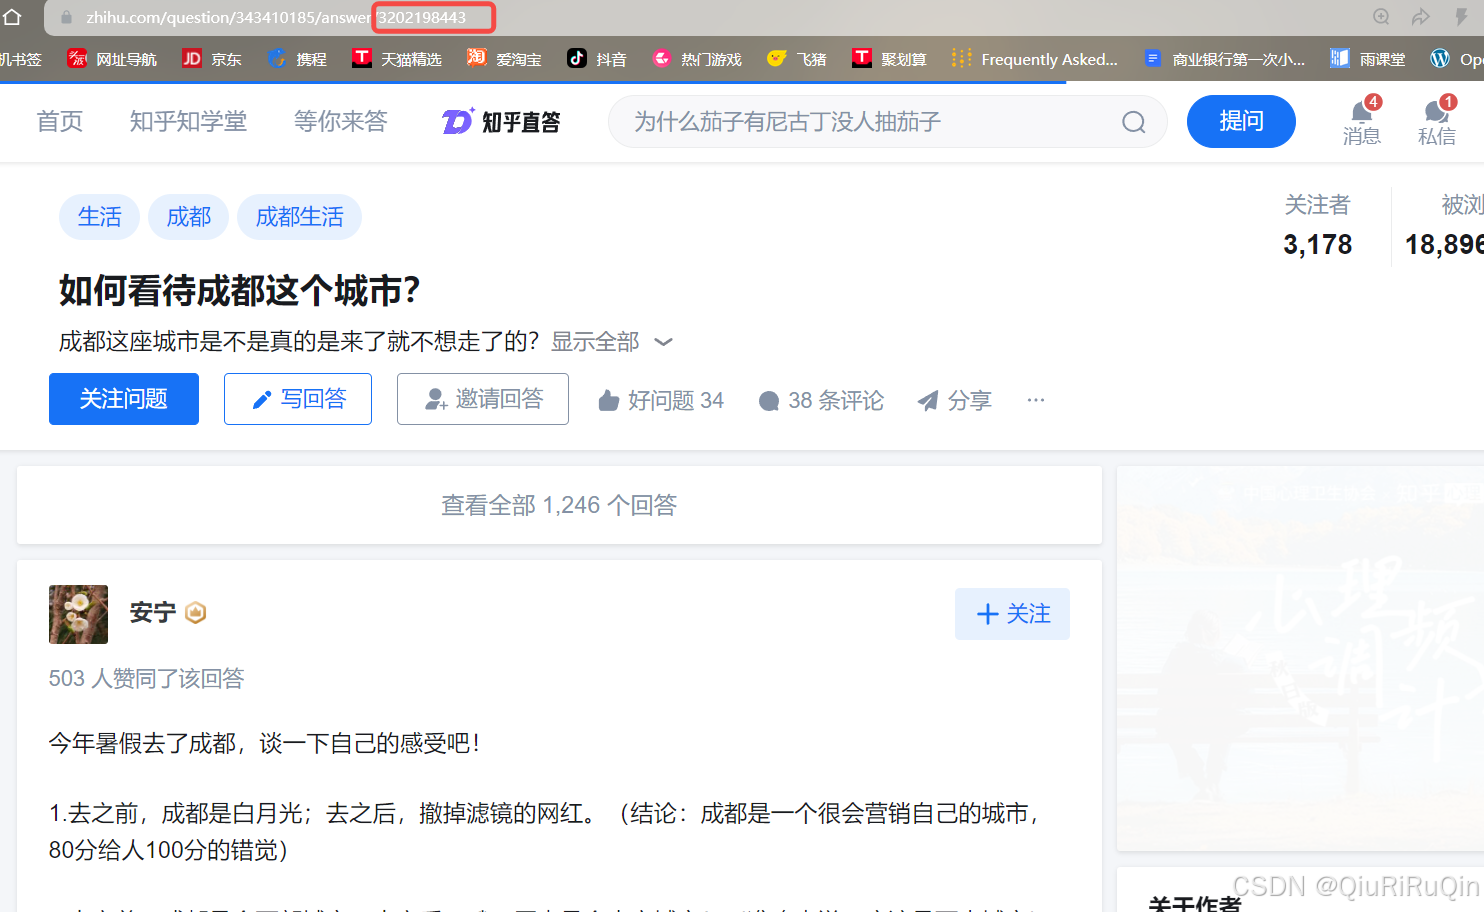
三、获取 User-Agent 和 cookie
3.1 复制地址到浏览器
在下面这个地址中标注的地方,填入你的 answer 号(注意删去大括号),然后复制粘贴到浏览器中!!!
https://www.zhihu.com/api/v4/answers/{填入你的 answer!!}/root_comments?order=normal&limit=20&offset=0&status=open3.2 点击F12
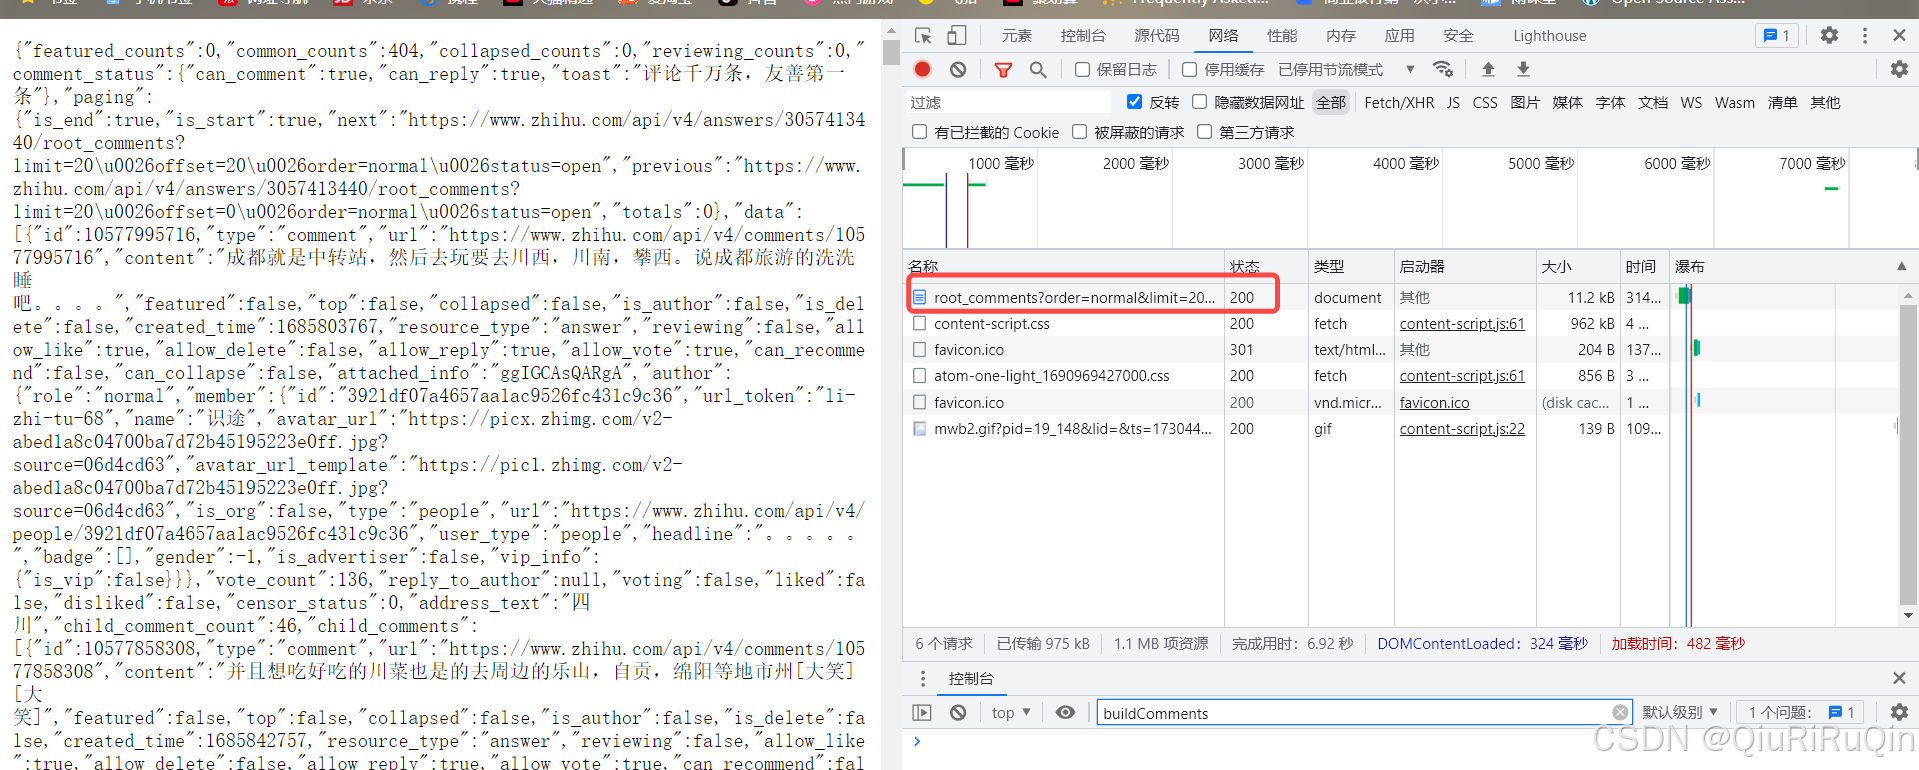
进去页面之后,点击F12可以看到抓包工具。现在抓包工具这里是什么都没有的。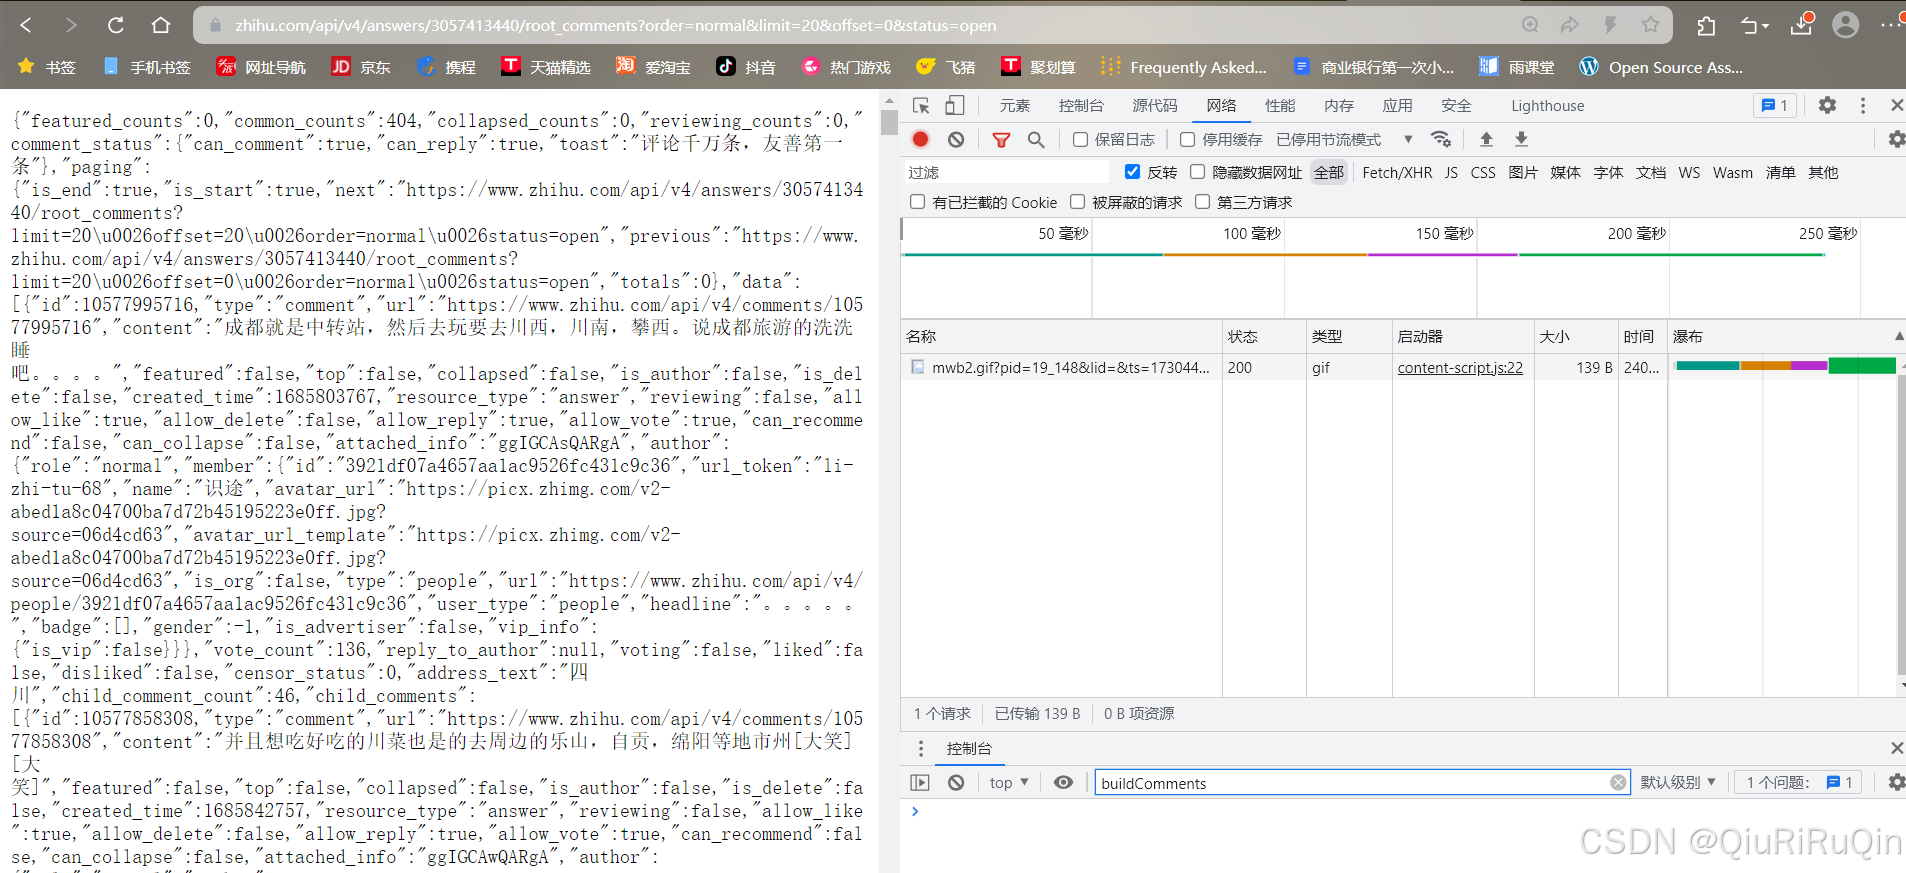
3.3 点击F5刷新
进一步地,点击F5进行刷新,就可以看到一些东西了!!!
注意:点开红框中的这个,root_comments?打头的这个!
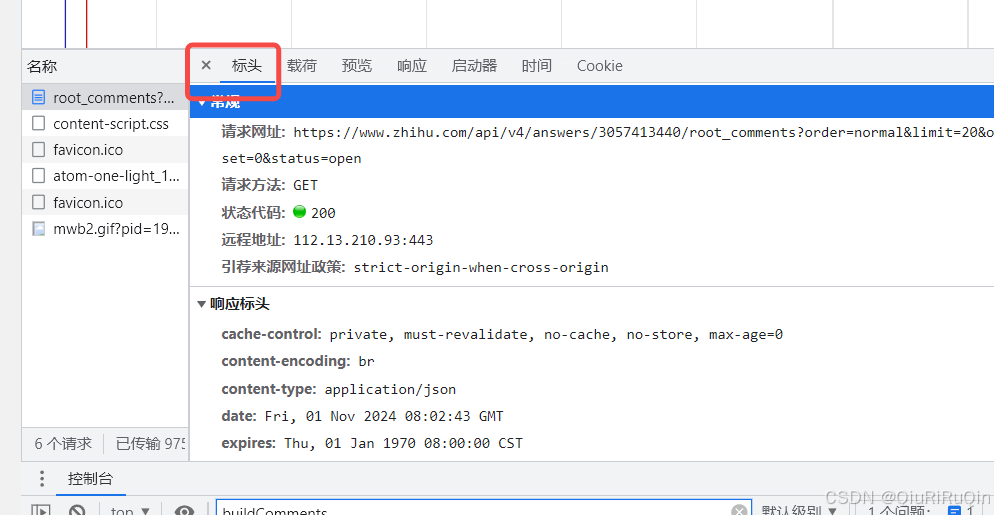
3.4 点击标头
选择标头,在这个页面中下拉!
3.5 获取 User-Agent
下拉之后就可以看到这个 user-agent,把冒号后面的都粘贴复制到 python 代码中就可以了!!!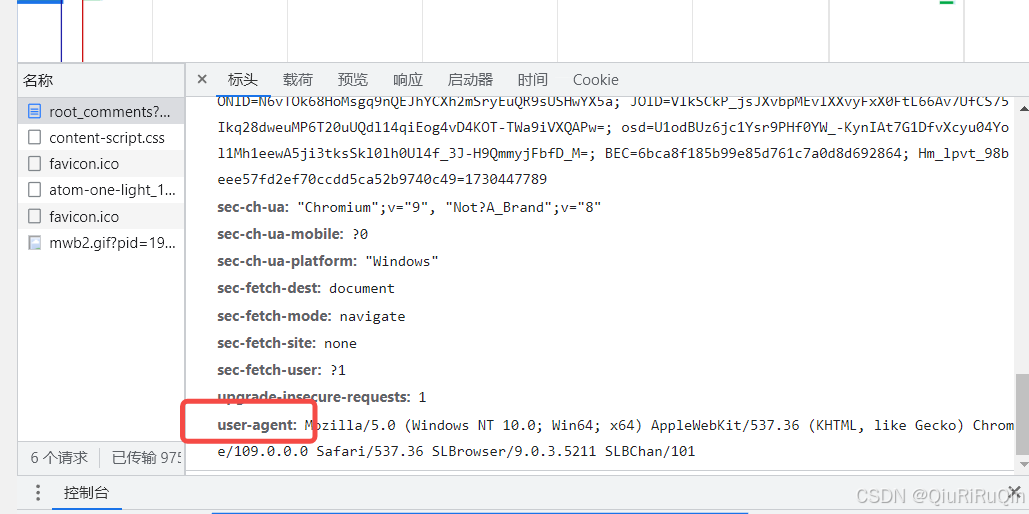
3.6获取cookie
继续在这个页面稍微上拉一下,就可以找到cookie,同样把冒号后面的都粘贴复制到 python代码中就可以了!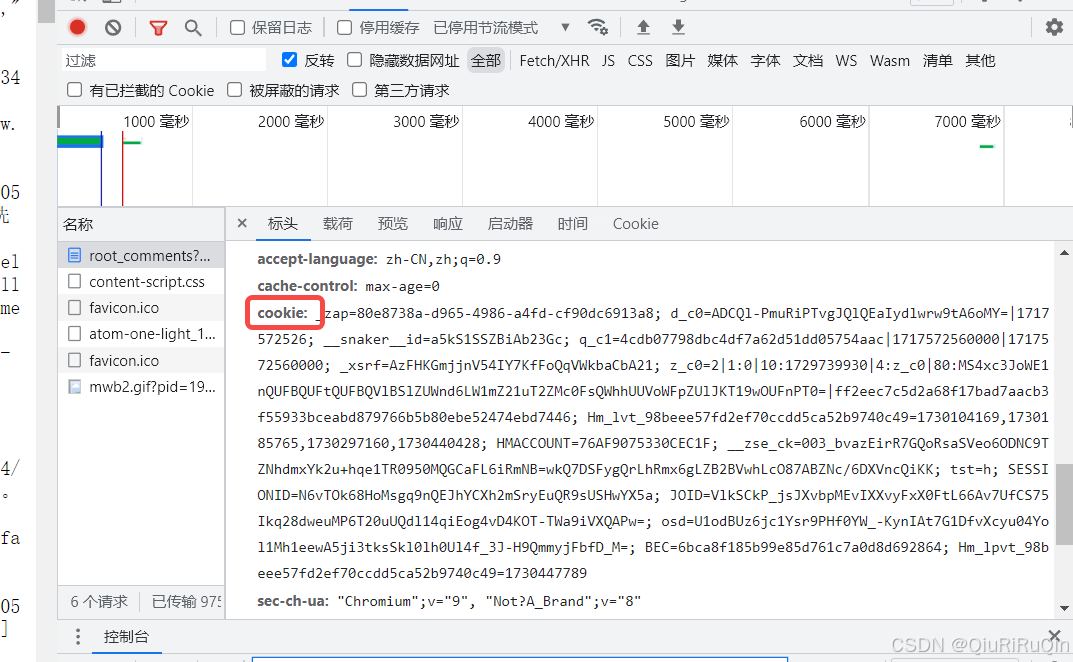
四、结束语
好啦!这就是全部的内容了!如果有任何问题欢迎在评论区留言讨论!!!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献1条内容

所有评论(0)