【大数据应用】移动通信网络语音质量MOS值预测
目录
事先声明:本文案仅限于本人在学习过程中的归纳与收录总结,不具有任何其他行为。
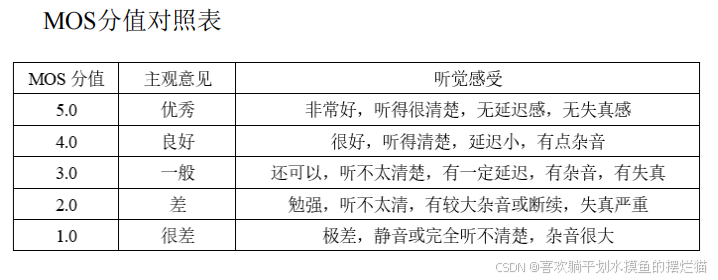
语音业务是移动用户最核心的业务需求之一,优化提升语音质量的前提是要有能正确评估语音质量的方法,通常采用平均意见得分(Mean Opinion Score,MOS)评分法。
MOS是从用户主观感受的角度评估语音质量的一个指标,它将用户对语音质量的感知量化为5个等级。
一、数据集介绍:
数据集共有105828条记录,每条记录包含9个属性。
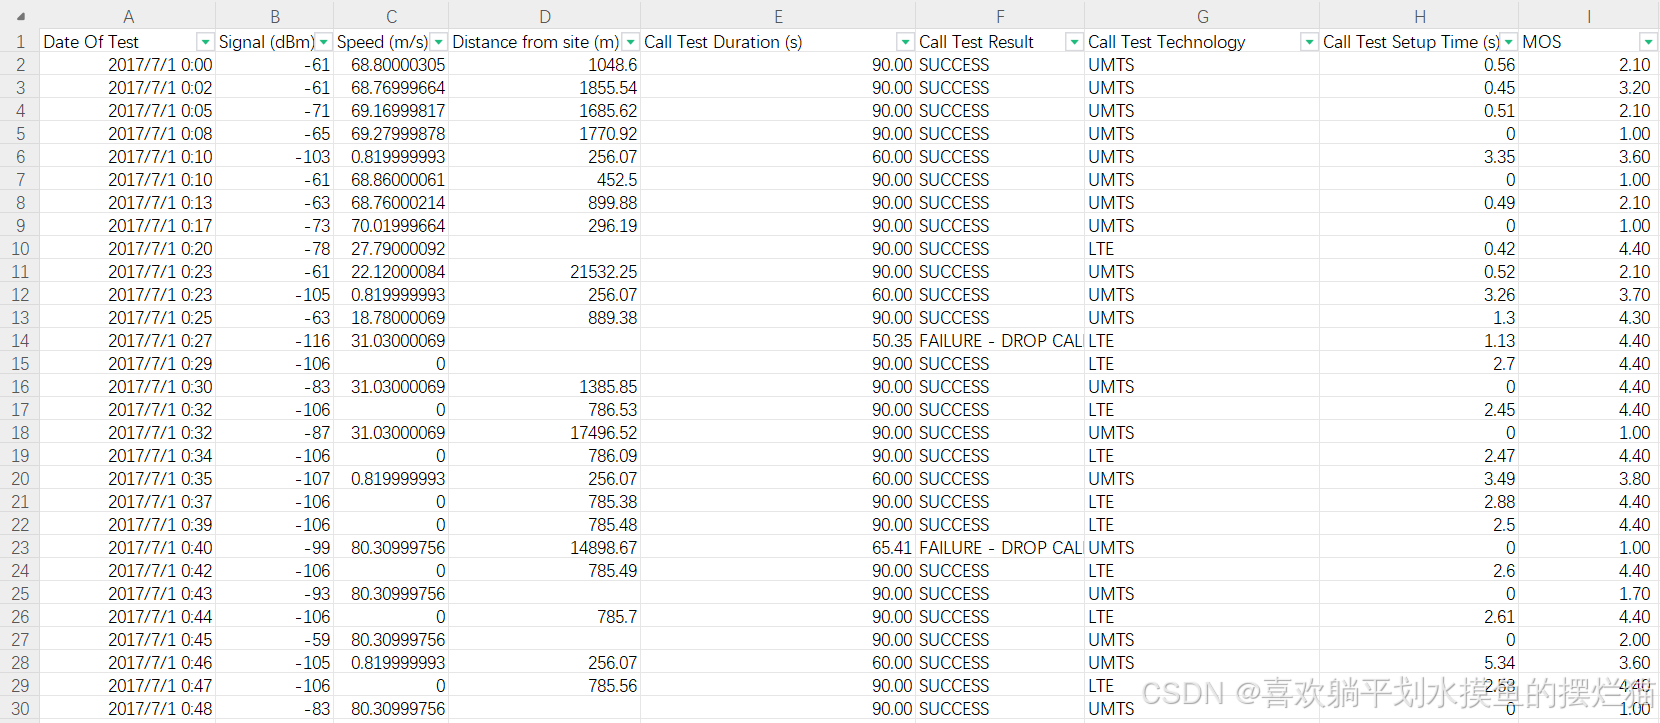
- Date Of Test:呼叫测试日期
- Signal:接收信号强度
- Speed:终端移动速度
- Distance from site:与基站的距离
- Call Test Duration:呼叫持续时长
- Call Test Result:呼叫测试结果,有成功、掉话、建立失败三种情况
- Call Test Technology:网络制式,有2G、3G、4G三种类型
- Call Test Setup Time:呼叫建立时延
- MOS:MOS值
数据集获取链接:mosdataset.xlsx
二、数据集导入:
下载的数据集以 .xlsx 文件的形式保存,处理时需要通过 pandas.read_excel() 函数导入,并存储在一个 DataFrame 类型的数据结构中。并对列重新命名。
Result:呼叫测试结果,有成功SUCCESS、掉话FAILURE-DROP CALL、建立失败FAILURE-SETUP FAIL三种情况。
- SUCCESS:'Success'
- FAILURE-DROP CALL:'Drop'
- FAILURE-SETUP FAIL:'Fail'
# 读入数据集
dataset = pd.read_excel("mosdataset.xlsx")

# 检查数据的属性数和样本数
print('数据集的形状为:', dataset.shape)

# 对列重新命名
dataset.columns = ['Date', 'Signal', 'Speed', 'Distance', 'Duration', 'Result', 'Technology', 'Delay', 'MOS']

# 对Result属性的取值重新命名
dataset['Result'] = dataset['Result'].map({'SUCCESS': 'Success', 'FAILURE - DROP CALL': 'Drop', 'FAILURE - SETUP FAIL': 'Fail'})
输出结果为:
数据集的形状为: (105828, 9)三、数据预处理:
# 检查是否存在缺失值
print('各属性的缺失值数量:')
print(dataset.isnull().sum())

# 对缺失值进行处理
# 有少量缺失值的Signal属性,直接删除缺失记录
dataset = dataset[~dataset['Signal'].isin(['NaN'])]

# 有较多缺失值的Distance属性,用插值法进行填充
dataset.interpolate(axis=0, inplace=True)
从 dataset 中移除那些在 'Signal' 列中包含 'NaN' 值的行。isna() 用于检测数据中的缺失值,而 ~ 操作符在这里用于取反,即选择那些 'Signal' 列中不含 'NaN' 值的行。
dataset.interpolate(axis=0, inplace=True):这用于对DataFrame进行线性插值。 axis=0 参数指定沿着行的方向进行插值,即对于每一列,它将尝试填充缺失值。inplace=True 参数意味着插值操作会直接在原始 DataFrame 上进行。
输出结果为:
各属性的缺失值数量:
Date              0
Signal            7
Speed             0
Distance      10359
Duration          0
Result            0
Technology        0
Delay             0
MOS               0
dtype: int64
1.处理缺失数据:
首先检查数据集中哪些属性存在缺失值。
Signal属性的缺失值很少,直接删除含有缺失值的记录。
Distance属性的缺失值量较大,采用插值法或者其他方法,根据样本的其他属性对缺失值进行估计和填充。
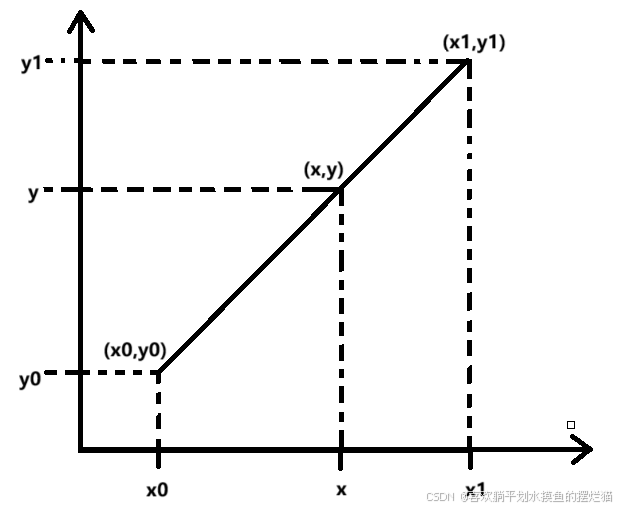
插值,它根据已知的数据序列,找到其中的规律;然后根据找到的这个规律,来对其中尚未有数据记录的点进行数值估计。
线性插值是一种针对一维数据的差值方法,根据一维数据序列中需要差值的点的左右邻近两个数据点来进行数值的估计。
它不是求这两个点数据大小的平均值,而是根据到这两个点的距离来分配它们的比重的。
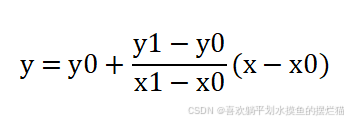
2.处理不合理数据:
Speed 的最小值为-1m/s,考虑到在移动通信中,终端移动速度不可能取负值,因此很有可能是测试者记录错误,或者-1是缺失数据的填充值。
对于不合常理的数据,可采用与缺失值相类似的处理方法,例如通过插值法进行替换。
# 查看属性的统计信息
print('数据集的统计信息:\n', dataset.describe())

# 有不合理值的属性,进行插值替换
dataset.replace({'Speed': -1, 'Delay': 0}, np.nan, inplace=True)
dataset.interpolate(axis=0, inplace=True)
调用 pandas.DataFrame.describe() 函数观察连续属性的取值范围和统计信息。
dataset.replace({'Speed': -1, 'Delay': 0}, np.nan, inplace=True):将 'Speed' 列的-1值和 'Delay' 列的0值替换为 NaN 。inplace=True 参数意味着替换操作会直接在原始 DataFrame 上进行。
dataset.interpolate(axis=0, inplace=True):这用于对 DataFrame进行线性插值。axis=0 参数指定沿着行的方向进行插值,即对于每一列,它将尝试填充缺失值。
输出结果为:
数据集的统计信息:
                                 Date         Signal          Speed       Distance       Duration          Delay            MOS
count                         105828  105828.000000  105828.000000  105828.000000  105828.000000  105828.000000  105828.000000
mean   2017-09-01 11:26:42.371858176     -78.654383       8.629296    7425.010656      84.202264       2.662776       3.105864
min              2017-07-01 00:00:27    -140.000000      -1.000000       1.410000      12.900000       0.000000       1.000000
25%              2017-08-03 11:11:47     -92.000000       0.000000     242.860000      60.000000       0.640000       2.100000
50%              2017-09-03 18:23:42     -79.000000       0.000000     444.920000      90.000000       3.510000       3.100000
75%    2017-09-30 07:30:44.750000128     -63.000000       7.770000     813.730000      90.000000       4.080000       4.400000
max              2017-10-31 23:50:19     -51.000000      86.310516  745483.680000     900.000000      45.330000       4.400000
std                              NaN      18.631577      18.008427   47763.712978      66.250741       2.057087       1.252348
3.识别离群值:
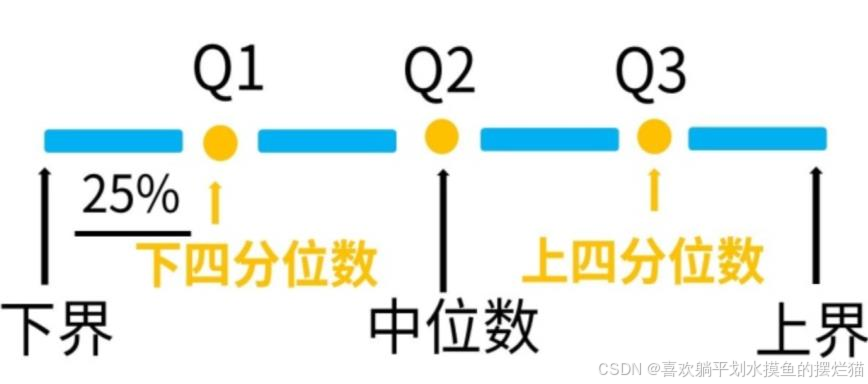
有时在样本属性中会存在一些不寻常的取值,它们明显偏离属性的典型值,我们称之为离群值。离群值可能是数据输入出错导致的,但也可能是出现概率极小的有效值,因此需要加以识别,以防止错误数据引起不可靠的结果。
识别连续属性离群值的方法有很多,如IQR(InterQuartileRange,四分位数间距)法等。本案例采用IQR法,它是一种简单稳健的方法,基本思想是利用四分位数Q1(第一四分位数)、Q2(第二四分位数)、Q3(第三四分位数)将数据集等分为4各部分,在此基础上定义IQR作为数据离散程度的度量。
# 检测连续性属性值是否存在离群点
col_names = ['Signal', 'Speed', 'Distance', 'Duration', 'Delay']
ver_coord = ['信号强度/dBm', '移动速度/m/s', '距离/m', '持续时长/s', '呼叫时延/s']

for i, col_val in enumerate(col_names):
    plt.figure(figsize=(8, 6))  # 为每一个图单独创建一个绘图对象,并设置图的大小
    sns.boxplot(y=dataset[col_val])
    plt.title('箱线图 - {}'.format(col_val), fontsize=13)
    plt.ylabel(ver_coord[i], fontsize=11)
    plt.show()  # 显示每个单独的图

# 删除Distance属性中的离群点(即大于100KM的记录)
print('Distance值超过100km的样本数:')
print(dataset[dataset['Distance'] > 100000].count())
col_names:定义了一个包含需要绘制箱线图的列名的列表。
ver_coord:定义了一个与 col_names 中列名对应的中文描述列表。
sns.boxplot(y=dataset[col_val]):使用 seaborn 的 boxplot 函数在第 i 个子图上绘制箱线图。
输出结果为:
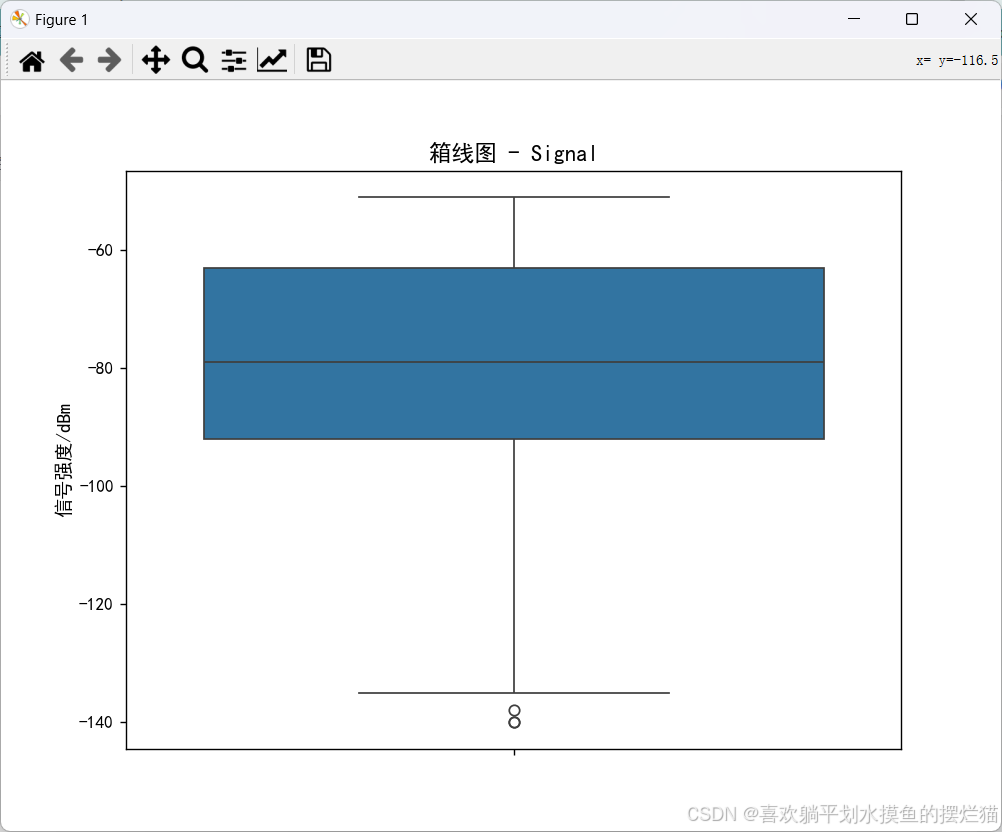
在 Signal 属性的箱线图中,当接收信号的强度非常低、接近-140dBm时,被认为是离群值。
由于 LTE 通信标准规定,终端能够测量到的信号强度范围是 [-140dBm, -44dBm] ,因此这些数据点表示很少出现的信号极差的情况,不应当做离群点处理。
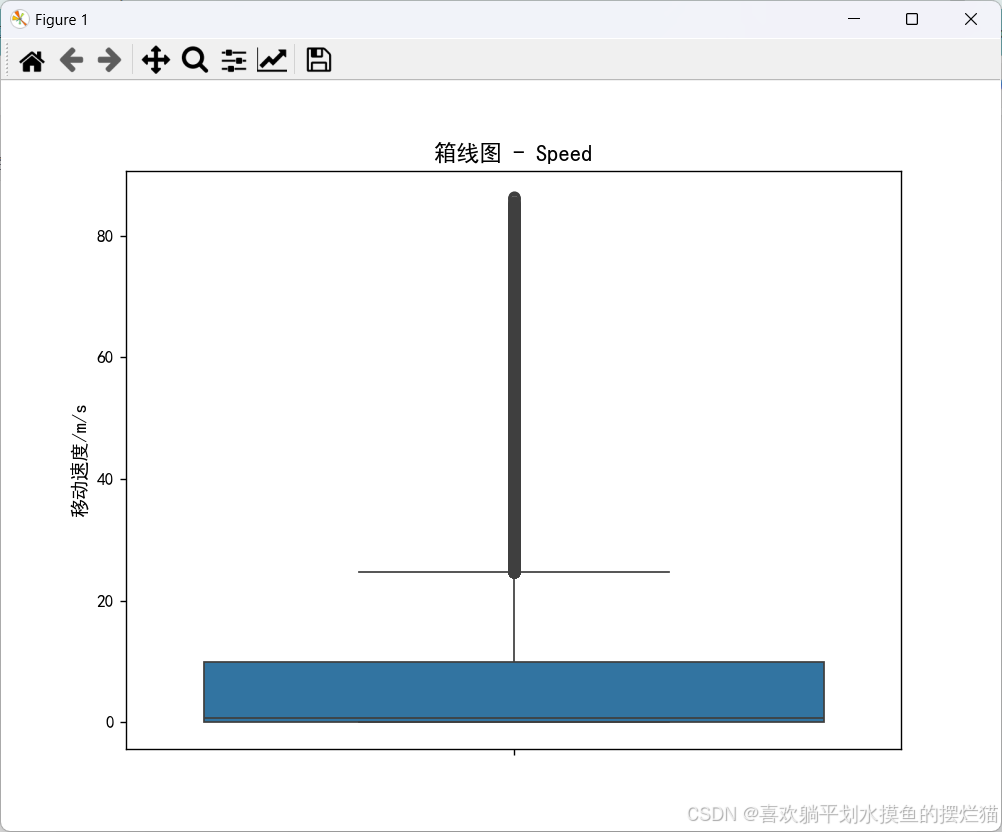
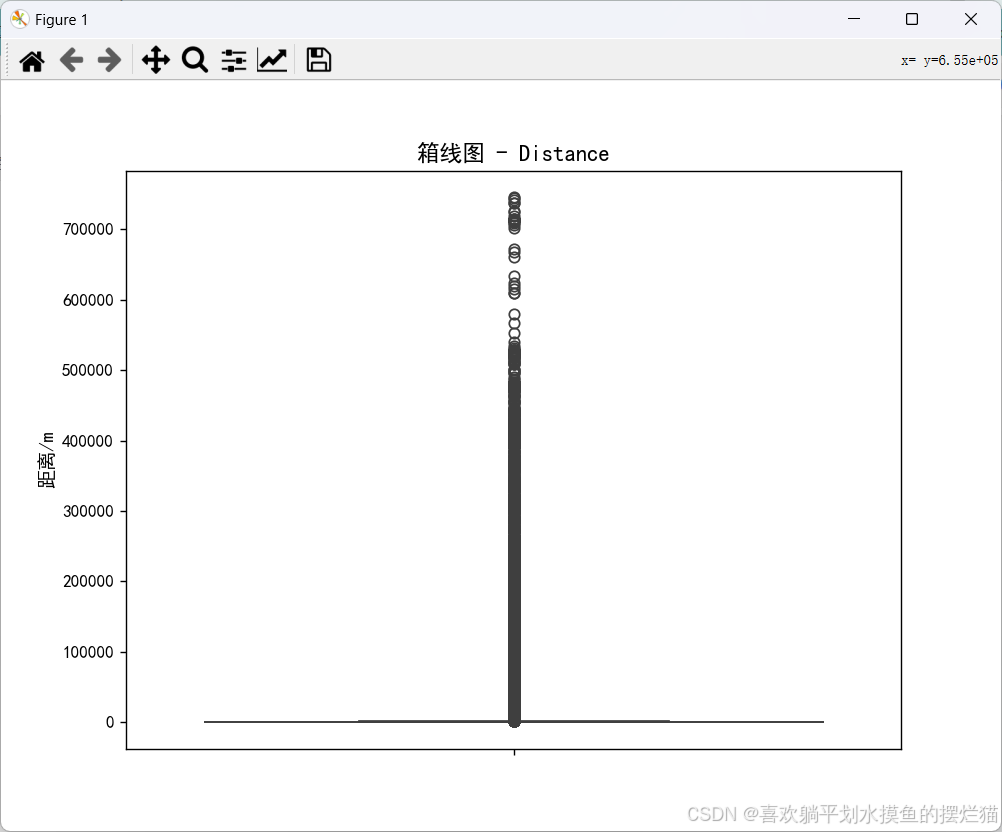
Distance属性,由于绝大多数样本的取值是在1000m以内,而最大值达到700km以上,二者差距过大,导致图无法显示蓝色方框区域,并且存在大量的离群点。所以你们觉得所有标识出的点真的都是离群点吗?bushi
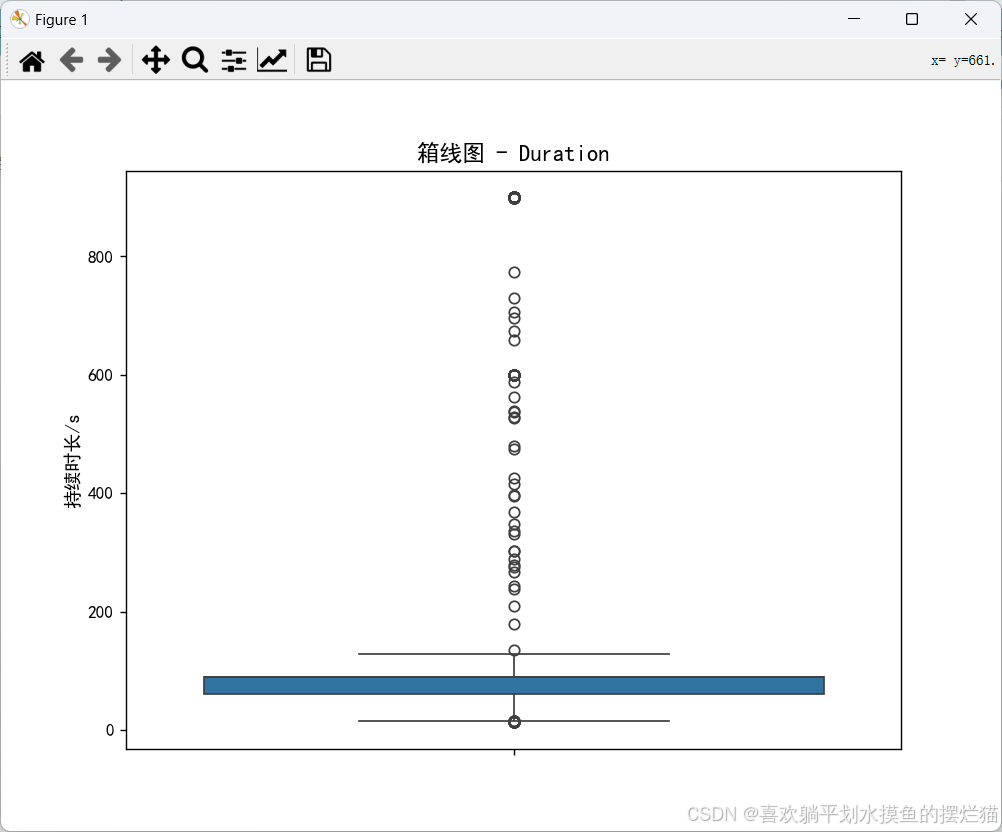
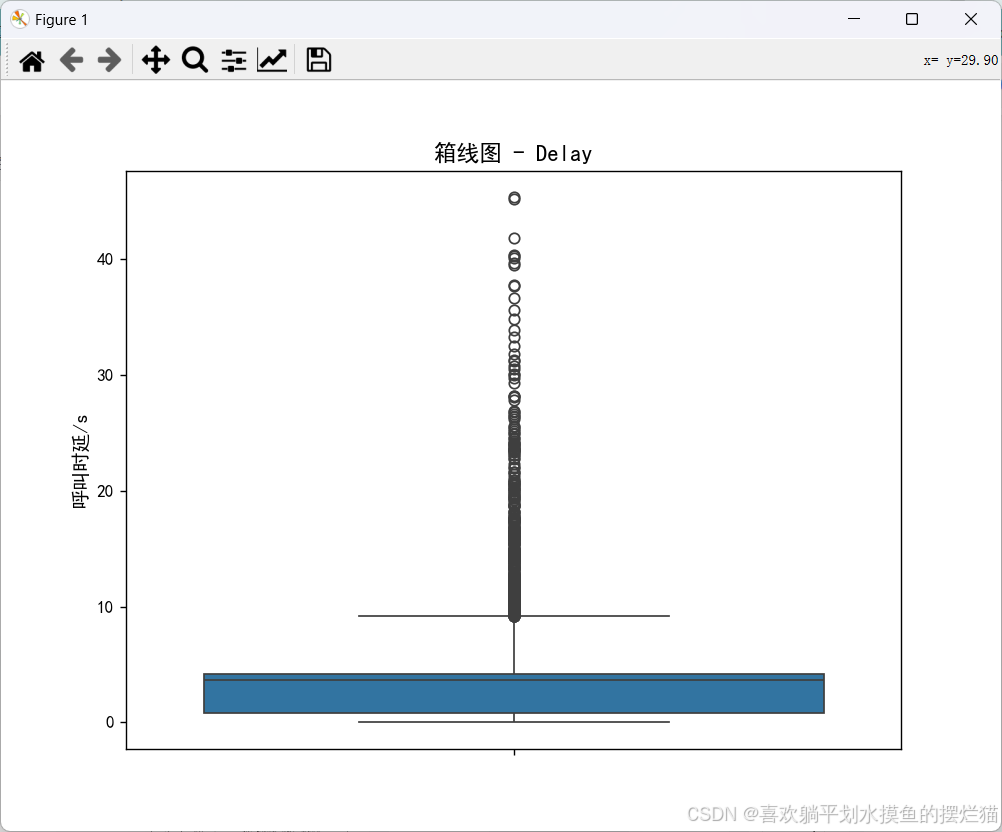
Distance值超过100km的样本数:
Date          1953
Signal        1953
Speed         1953
Distance      1953
Duration      1953
Result        1953
Technology    1953
Delay         1953
MOS           1953
dtype: int64
在城市区域内,通信基站的覆盖半径为2~3km,郊区可达到十几千米;近海基站的覆盖半径最大,为1000km左右。
因此,图中取值在100km以上的数据点一定是离群点。经统计发现,Distance 值大于100km的样本约2000条,在数据集中占比较小,可以直接将它们删除掉。
4.处理日期数据:
# 对日期进行处理
dataset = dataset.reindex(columns=['Month'] + ['Day'] + ['Weekday'] + ['Hour'] + list(dataset.columns))
dataset['Month'] = dataset.loc[:, 'Date'].dt.month
dataset['Day'] = dataset.loc[:, 'Date'].dt.day
dataset['Weekday'] = dataset.loc[:, 'Date'].dt.dayofweek
dataset['Hour'] = dataset.loc[:, 'Date'].dt.hour
print('对日期处理后的数据集:')
print(dataset.head(10))
dataset = dataset.reindex(columns=['Month'] + ['Day'] + ['Weekday'] + ['Hour'] + list(dataset.columns)):定义了一个新列的顺序,包括 'Month','Day','Weekday','Hour',然后是 dataset 中现有的所有列。reindex方法用于重新排序列,但不会改变数据。
输出结果为:
对日期处理后的数据集:
   Month  Day  Weekday  Hour                Date  Signal      Speed  Distance  Duration   Result Technology  Delay  MOS
0      7    1        5     0 2017-07-01 00:00:27   -61.0  68.800003   1048.60      90.0  Success       UMTS  0.560  2.1
1      7    1        5     0 2017-07-01 00:02:57   -61.0  68.769997   1855.54      90.0  Success       UMTS  0.450  3.2
2      7    1        5     0 2017-07-01 00:05:29   -71.0  69.169998   1685.62      90.0  Success       UMTS  0.510  2.1
3      7    1        5     0 2017-07-01 00:08:02   -65.0  69.279999   1770.92      90.0  Success       UMTS  1.930  1.0
4      7    1        5     0 2017-07-01 00:10:30  -103.0   0.820000    256.07      60.0  Success       UMTS  3.350  3.6
5      7    1        5     0 2017-07-01 00:10:37   -61.0  68.860001    452.50      90.0  Success       UMTS  1.920  1.0
6      7    1        5     0 2017-07-01 00:13:08   -63.0  68.760002    899.88      90.0  Success       UMTS  0.490  2.1
7      7    1        5     0 2017-07-01 00:17:57   -73.0  70.019997    296.19      90.0  Success       UMTS  0.455  1.0
8      7    1        5     0 2017-07-01 00:20:29   -78.0  27.790001  10914.22      90.0  Success        LTE  0.420  4.4
9      7    1        5     0 2017-07-01 00:23:01   -61.0  22.120001  21532.25      90.0  Success       UMTS  0.520  2.1
Date 属性包含日期和时间信息。为了更好地理解数据,可以通过特征衍生从 Date 中产生一些新属性,如月、日、小时、星期等。经过处理后的数据如图所示,数据集中新增加了4个属性,并且插在原有属性列之前。
利用可视化技术,观察衍生属性与MOS值之间的关系。
# 观察MOS随时间的变化
col_names = ['Month', 'Day', 'Weekday', 'Hour']
dataset['Weekday'] = dataset['Weekday'].map({0: 'Mon', 1: 'Tue', 2: 'Wed', 3: 'Thur', 4: 'Fri', 5: 'Sat', 6: 'Sun'})
hor_coord = ['时间/m', '时间/d', '时间/w', '时间/h']
# 设置绘图风格和中文字体
with sns.axes_style("whitegrid"):
    plt.rcParams['font.sans-serif'] = 'SimHei'
    fig, ax = plt.subplots(len(col_names), figsize=(8, 24))
    for i, col_val in enumerate(col_names):
        sns.pointplot(x=dataset[col_val], y=dataset['MOS'], ci=None, ax=ax[i])  # 图中的是均值点
        ax[i].set_title('Plot - {} tendency'.format(col_val), fontsize=13)
        ax[i].set_xlabel(hor_coord[i], fontsize=11)
        ax[i].set_ylabel('MOS', fontsize=11)
        ax[i].set_ylim(0, 5.0)
    plt.show()

dataset['Weekday'] = dataset['Weekday'].map({'Mon': 1, 'Tue': 2, 'Wed': 3, 'Thur': 4, 'Fri': 5, 'Sat': 6, 'Sun': 7})
col_names:定义了包含时间维度的列名列表,包括月份(Month)、日期(Day)、星期(Weekday)和小时(Hour)。
dataset['Weekday'] = dataset['Weekday'].map({0: 'Mon', 1: 'Tue', 2: 'Wed', 3: 'Thur', 4: 'Fri', 5: 'Sat', 6: 'Sun'}):将数据集中的Weekday列中的数字映射为对应的星期名称,方便后续的可视化。
hor_coord:定义了一个水平坐标轴标签的列表,对应于时间的不同维度。
sns.pointplot(x=dataset[col_val], y=dataset['MOS'], ci=None, ax=ax[i]):
sns.pointplot 是 Seaborn 库中用于绘制点图的函数,它通常用于展示数值变量的分布趋势。
x 参数:表示 x 轴的数据,dataset[col_val] 代表不同的类别或时间点。
y 参数:表示 y 轴的数据,dataset['MOS'] 表示 Mean Opinion Score(平均意见得分)。
输出结果为:
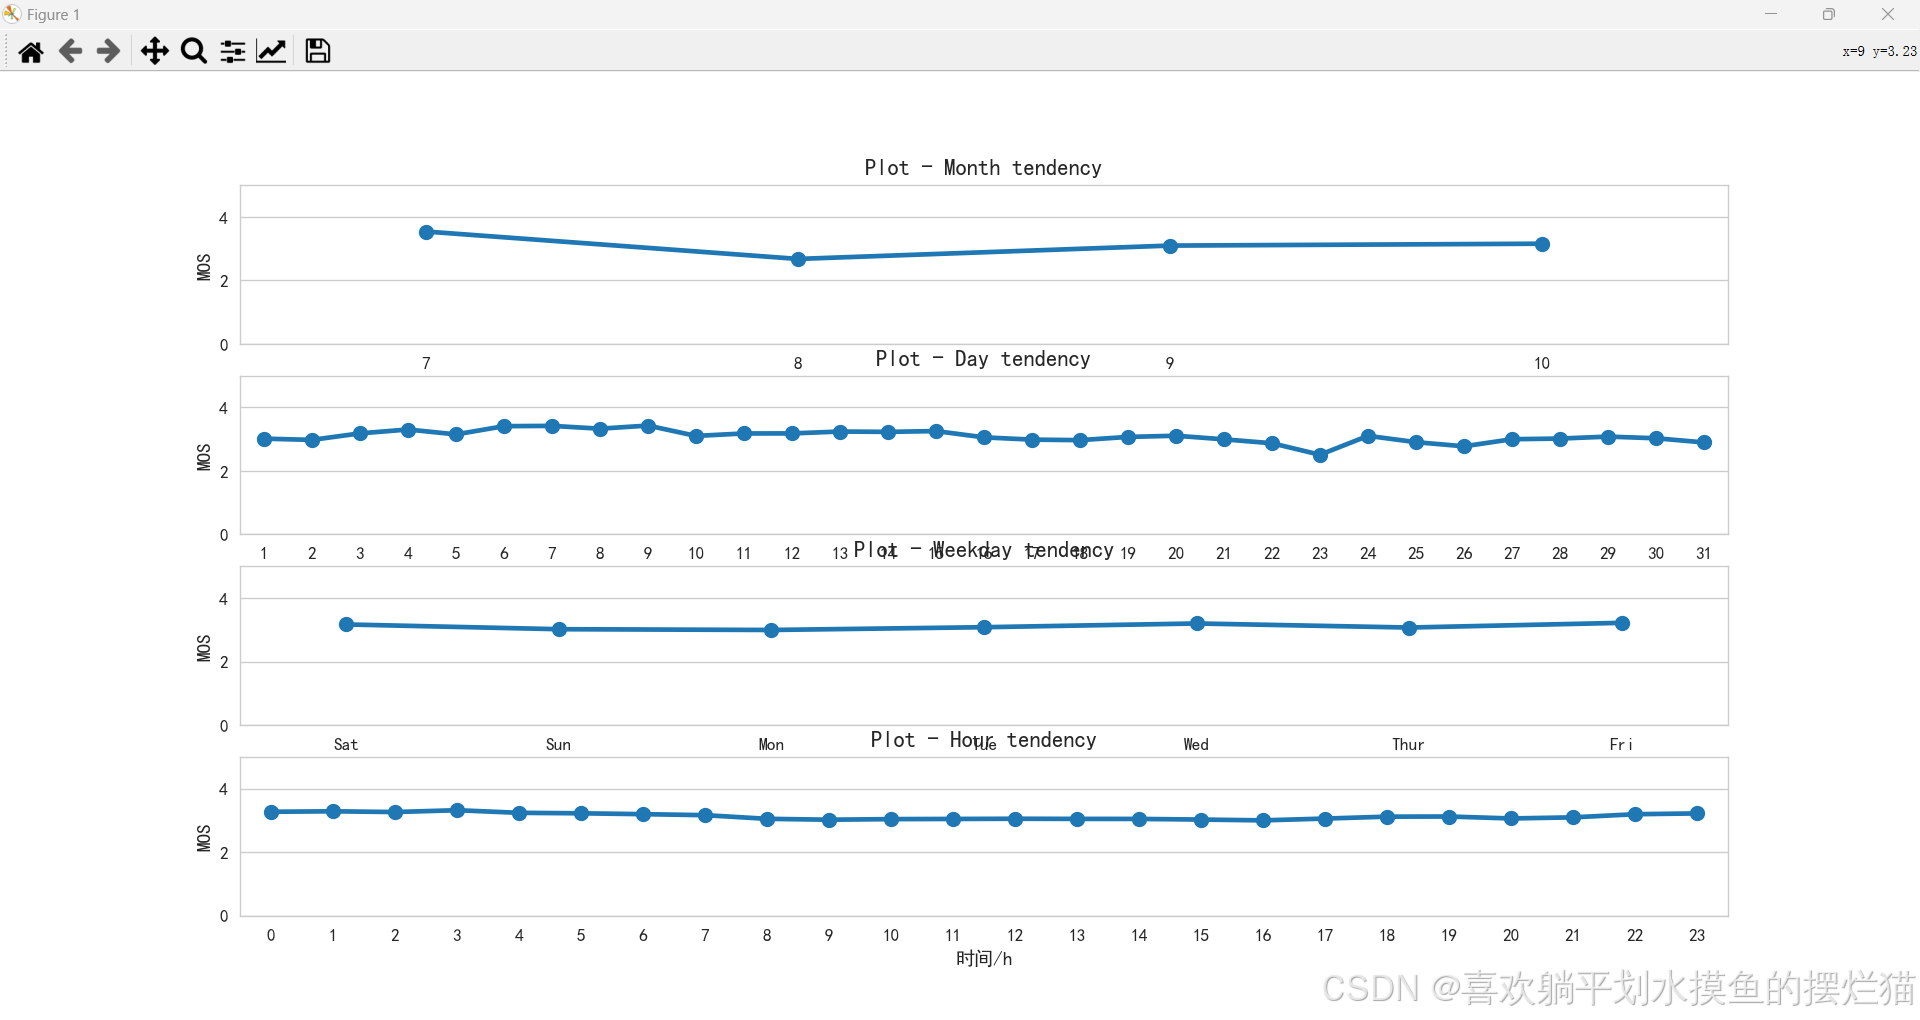
MOS值随时间变化趋势:
曲线表明语音质量在白天和晚上会稍有差别,这可能是由于该地区为商业区,晚间用户较少;也可能是因用户休息而是网络负荷下降,服务质量提高。
5.处理离散属性:
非数值的分类属性必须转化成数值属性才可用于训练模型,这里采用独热编码(One-Hot Encoding) 。
# 对分类属性进行one-hot encoding
new_data = pd.get_dummies(dataset, columns=['Technology'], prefix='Tech')
new_data = pd.get_dummies(new_data, columns=['Result'], prefix='Res')
print('对分类属性进行独热编码后的结果:')
print(new_data.head(10))
new_data = pd.get_dummies(dataset, columns=['Technology'], prefix='Tech'):对 dataset 中的 'Technology' 列进行独热编码,并将前缀设置为 'Tech'。每个唯一的 'Technology' 值都会在 new_data 中转换为一个以 'Tech' 开头的新列。
new_data = pd.get_dummies(new_data, columns=['Result'], prefix='Res'):对 new_data(已经包含 dataset 的原始数据和 'Technology' 独热编码后的列)中的 'Result' 列进行独热编码,并将前缀设置为 'Res'。
输出结果为:
对分类属性进行独热编码后的结果:
   Month  Day  Weekday  Hour                Date  Signal      Speed  Distance  Duration  Delay  MOS  Tech_GSM  Tech_LTE  Tech_UMTS  Res_Drop  Res_Fail  Res_Success
0      7    1        6     0 2017-07-01 00:00:27   -61.0  68.800003   1048.60      90.0  0.560  2.1     False     False       True     False     False         True
1      7    1        6     0 2017-07-01 00:02:57   -61.0  68.769997   1855.54      90.0  0.450  3.2     False     False       True     False     False         True
2      7    1        6     0 2017-07-01 00:05:29   -71.0  69.169998   1685.62      90.0  0.510  2.1     False     False       True     False     False         True
3      7    1        6     0 2017-07-01 00:08:02   -65.0  69.279999   1770.92      90.0  1.930  1.0     False     False       True     False     False         True
4      7    1        6     0 2017-07-01 00:10:30  -103.0   0.820000    256.07      60.0  3.350  3.6     False     False       True     False     False         True
5      7    1        6     0 2017-07-01 00:10:37   -61.0  68.860001    452.50      90.0  1.920  1.0     False     False       True     False     False         True
6      7    1        6     0 2017-07-01 00:13:08   -63.0  68.760002    899.88      90.0  0.490  2.1     False     False       True     False     False         True
7      7    1        6     0 2017-07-01 00:17:57   -73.0  70.019997    296.19      90.0  0.455  1.0     False     False       True     False     False         True
8      7    1        6     0 2017-07-01 00:20:29   -78.0  27.790001  10914.22      90.0  0.420  4.4     False      True      False     False     False         True
9      7    1        6     0 2017-07-01 00:23:01   -61.0  22.120001  21532.25      90.0  0.520  2.1     False     False       True     False     False         True
6.探索离散属性与其他属性之间的关系:
数据子集选择:tech_data_lte 包含 Tech_LTE 列值为1的所有行,这意味着这些行在原始数据中 'Technology' 列的值为 'LTE'。
绘制核密度估计图:使用 seaborn.kdeplot 函数为每种网络制式的 Signal 属性绘制 KDE 图。label 参数用于设置图例标签,linestyle 参数用于设置线条样式。
# 观察不同网络制式下Signal属性的分布
tech_data_lte = new_data[new_data['Tech_LTE'] == 1]
tech_data_umts = new_data[new_data['Tech_UMTS'] == 1]
tech_data_gsm = new_data[new_data['Tech_GSM'] == 1]

ax1 = sns.kdeplot(tech_data_lte['Signal'], label='LTE网络', linestyle='-.')
ax2 = sns.kdeplot(tech_data_umts['Signal'], label='UMTS网络', linestyle='--')
ax3 = sns.kdeplot(tech_data_gsm['Signal'], label='GSM网络')
plt.title('Signal属性核密度估计图')
plt.xlabel('信号强度/dBm', fontsize=11)
plt.ylabel('密度', fontsize=11)
plt.show()
输出结果为:
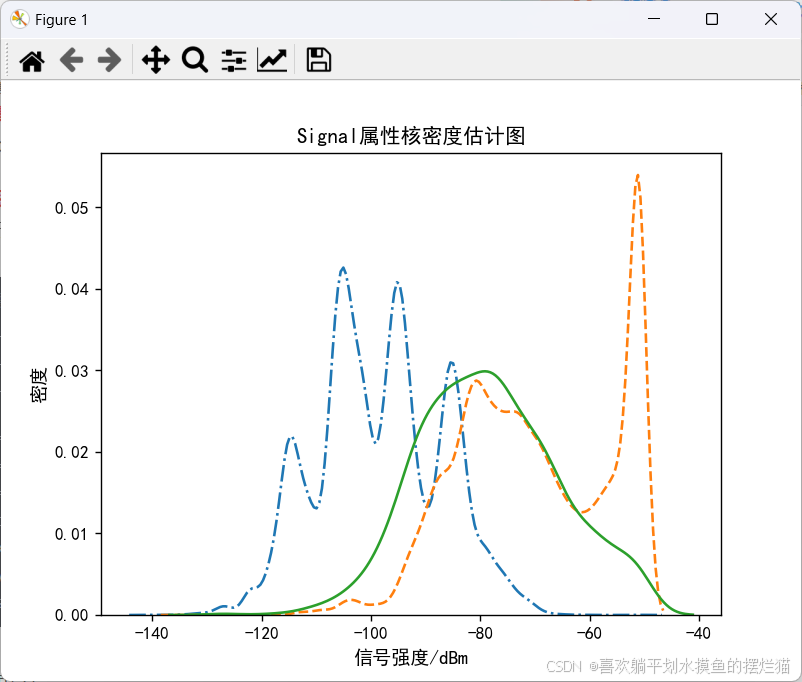
从离散属性 Technology 与 Signal 属性的关系图中可以看出:LTE 网络的接收信号强度一般要低于 UMTS 和 GSM 网络。
7.特征相关性分析:
从 new_data 中选择包含连续属性和 MOS 的列,存储在变量 a 中。
计算相关系数:使用 Pandas 的 corr 方法计算 a 中各列之间的相关系数矩阵。
绘制热图:使用 seaborn.heatmap 函数绘制相关系数矩阵的热图。
# 观察连续属性之间的相关性
f, ax = plt.subplots(figsize=(8, 6))
a = new_data[['Signal', 'Speed', 'Distance', 'Duration', 'Delay', 'MOS']]
corr = a.corr()
sns.heatmap(corr, xticklabels=corr.columns.values, yticklabels=corr.columns.values, annot=True)
plt.show()
输出结果为:
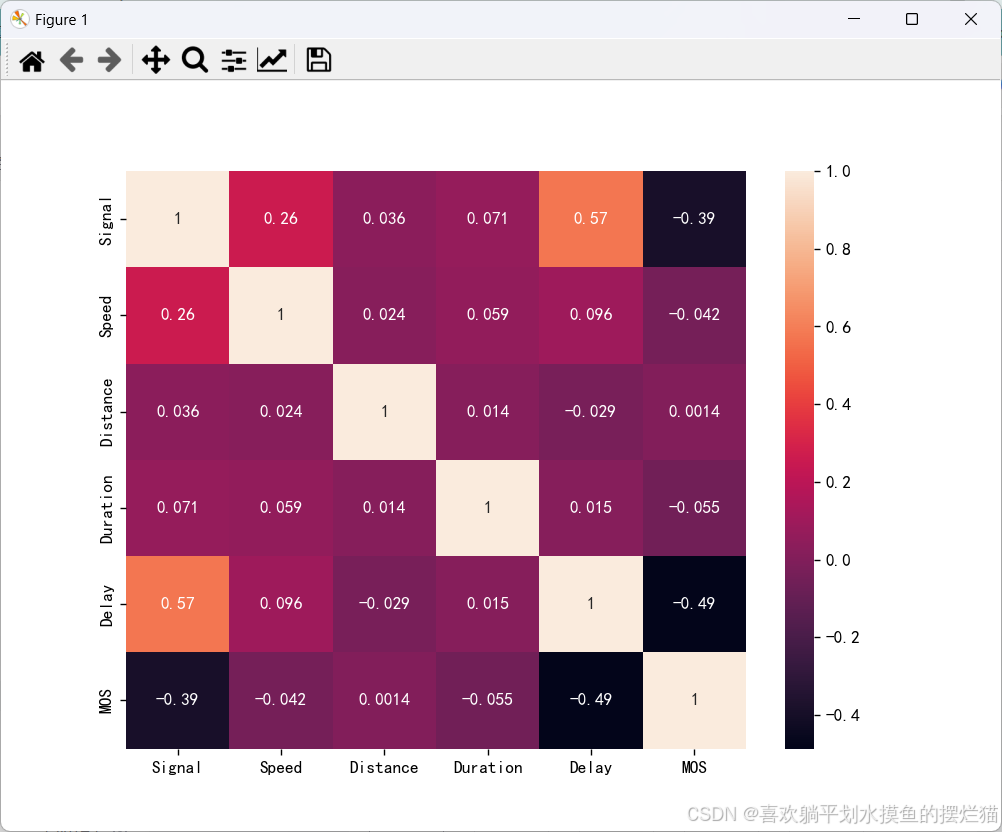
从热图中可以看出绝大多数属性的相关系数在0.2以下,说明他们之间没有或者仅有极弱的线性关系。
还可以看出,Delay 与 MOS 之间存在负相关性。这是由于引起呼叫建立时延增大的原因可能是网络信号质量较差或者网络负荷过重,而这些因素同样会影响语音业务的质量,造成 MOS 值下降。
8.建模与评价:
将数据集划分为训练集和测试集两部分,训练集站数据总量的75%;然后创建一个 RandomForestRegressor 对象,将它的所有参数设为默认值,并使用训练集对该对象进行训练;模型训练好后,通过测试集来检验它的预测效果。
# 删除多余的属性
new_data.drop(['Date', 'Speed', 'Distance', 'Duration', 'Delay', 'Res_Fail', 'Tech_GSM'], axis=1, inplace=True)

# 对数据集进行分割
labels = np.array(new_data['MOS'])
features = new_data.drop(['MOS'], axis=1)
feature_list = list(features.columns)
features = np.array(features)
train_features, test_features, train_labels, test_labels = train_test_split(features, labels, test_size=0.25, random_state=42, shuffle=True, stratify=labels)
1)准备标签和特征:
labels 是目标变量,即 new_data 中 'MOS' 列的值。
features 是特征变量,即 new_data 中除了 'MOS' 列的所有其他列。
2)数据集分割:
使用 train_test_split 函数从 sklearn.model_selection 模块将数据集分割为训练集和测试集。test_size=0.25表示测试集占总数据的25%。
random_state=42确保每次分割的结果相同,shuffle=True 表示在分割前会打乱数据,stratify=labels 确保分割后训练集和测试集的标签分布保持一致。
# 训练随机森林
# (1)使用默认参数
rf = RandomForestRegressor(random_state=10)
rf.fit(train_features, train_labels)

# 对测试集进行预测
predictions = rf.predict(test_features)

# 对结果进行评估
print("训练集的R2评分:%.3f" % metrics.r2_score(train_labels, rf.predict(train_features)))
print("测试集的R2评分:%.3f" % metrics.r2_score(test_labels, predictions))
输出结果为:
训练集的R2评分:0.726
测试集的R2评分:0.465
3)训练随机森林模型:
使用 RandomForestRegressor 从 sklearn.ensemble 模块创建随机森林回归器实例,并使用训练集数据训练模型。
4)模型预测:
使用训练好的随机森林模型对测试集进行预测。
5)模型估计:
使用 metrics.r2_score 函数从 sklearn.metrics 模块计算训练集和测试集的R2分数,以评估模型性能。
四、模型优化:
设置了随机森林算法的超参数:
定义了随机森林模型中决策树的几个关键参数的取值范围,以便进行参数调优。
# (2)模型优化
# 设置树的个数的取值范围
n_estimators = [int(x) for x in np.linspace(start=1500, stop=2500, num=100)]
# 设置节点分裂时需要考虑的属性数
max_features = np.linspace(0.01, 1.0)
# 设置树的最大深度
max_depth = [int(x) for x in np.linspace(5, 35, num=20)]
# 设置节点分裂所需的最少样本数
min_samples_split = [2, 5, 10]
# 设置每个叶子结点所需要的最小样本数
min_samples_leaf = [2, 5, 10, 25]
sklearn库中提供的随机搜索 RandomizedSearchCV类 :
# 创建随机网格
random_grid = {
    'n_estimators': n_estimators,
    'max_features': max_features,
    'max_depth': max_depth,
    'min_samples_split': min_samples_split,
    'min_samples_leaf': min_samples_leaf}

# 创建用于调参的随机森林模型
rf = RandomForestRegressor(random_state=10)
# 通过交叉验证搜索最优参数组合
rf_random = RandomizedSearchCV(estimator=rf, param_distributions=random_grid,
                               n_iter=5, scoring='neg_mean_absolute_error',
                               cv=3, verbose=2, random_state=42)  # , n_jobs=-1)
rf_random.fit(train_features, train_labels)

# 输出最优参数组合
print(rf_random.best_params_)
print("训练集的R2:%.3f" % metrics.r2_score(train_labels, rf_random.predict(train_features)))


# 对测试集进行预测
import matplotlib.pyplot as plt

predictions = rf_random.predict(test_features)
print("测试集的R2:%.3f" % metrics.r2_score(test_labels, predictions))
在指定的参数值范围内随机搜索5个采样点后,得到一个表现最优的参数组合,其中各参数的取值分别为:
输出结果为:
{'n_estimators': 2055, 'min_samples_split': 2, 'min_samples_leaf': 5, 'max_features': 0.19183673469387755, 'max_depth': 22}
训练集的R2:0.598
测试集的R2:0.536
利用优化后的模型对训练集和测试集进行预测,得到的R2评分分别为0.598和0.536。
五、结果分析:
随机森林算法在训练模型的同时,还能够定量的分析各属性对预测结果的贡献,称为属性重要性分析。
# 输出属性的重要性程度
importances = rf_random.best_estimator_.feature_importances_
indices = np.argsort(importances)[::-1]
print('各属性的重要性程度:')
for f in range(train_features.shape[1]):
    print("%2d) %-s %f" % (f + 1, new_data.drop(['MOS'], axis=1).columns[:][indices[f]], importances[indices[f]]))

# 用柱状图显示重要性程度
importances = sorted(list(importances))
y_values = list(range(len(importances)))
plt.figure(figsize=(8, 6))
plt.barh(y_values, importances)
reverse_indices = np.argsort(importances)
plt.yticks(range(len(indices)), [feature_list[i] for i in reverse_indices])
plt.xlabel('重要性程度')
plt.title('各属性重要性程度排名')
plt.show()
feature_importances_:从随机森林模型中获取特征重要性分数。
获取特征重要性:
rf_random.best_estimator_.feature_importances_ 从随机森林模型中获取特征重要性分数。
排序特征重要性:
使用 np.argsort 对特征重要性进行排序,[::-1] 表示降序。
打印特征重要性:
循环遍历特征,打印每个特征的索引、名称和重要性分数。
绘制柱状图:
使用 plt.barh 绘制特征重要性的横向柱状图。
输出结果为:
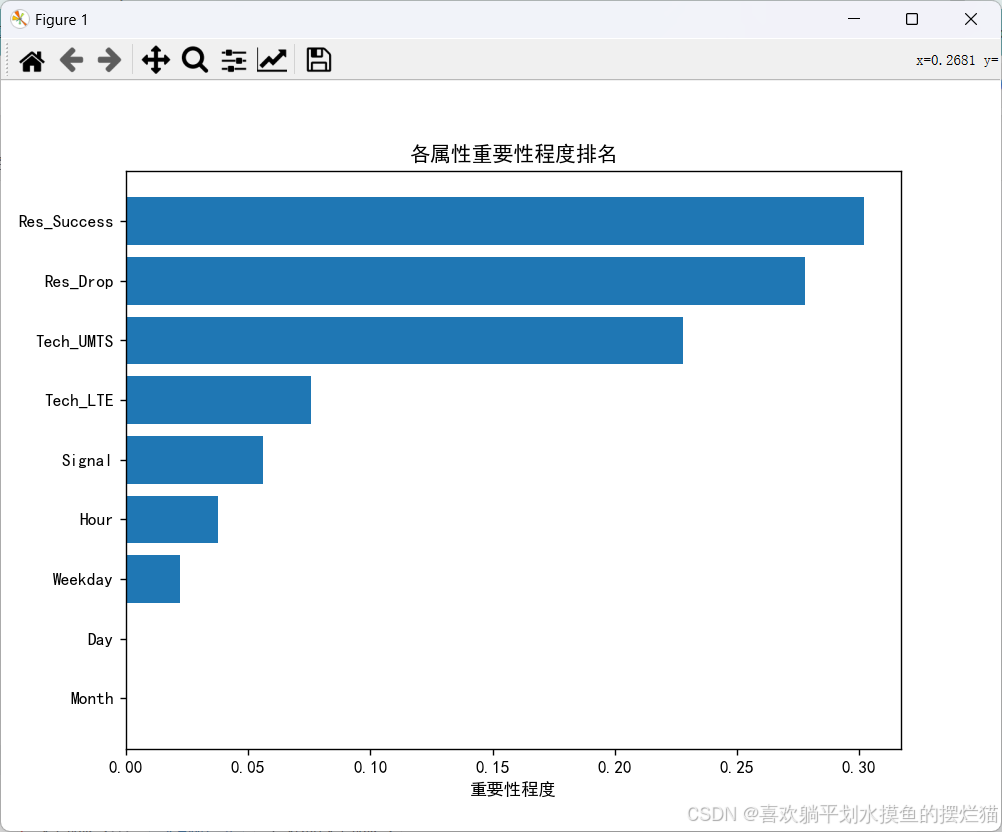
各属性的重要性程度:
 1) Tech_LTE 0.302074
 2) Tech_UMTS 0.277684
 3) Signal 0.227949
 4) Hour 0.075593
 5) Day 0.055914
 6) Month 0.037619
 7) Weekday 0.022098
 8) Res_Success 0.000549
 9) Res_Drop 0.000521
六、项目总代码:
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestRegressor
from sklearn import metrics
from sklearn.model_selection import RandomizedSearchCV
# 禁止显示告警信息
import warnings
warnings.filterwarnings(action='ignore')
# 设置print输出时的显示风格
pd.set_option('display.max_rows', 100)
pd.set_option('display.max_columns', 50)
pd.set_option('display.width', 800)
# 设置图片正确显示汉字
plt.rcParams['font.sans-serif']=['SimHei']
plt.rcParams['axes.unicode_minus'] = False


# 读入数据集
dataset = pd.read_excel("mosdataset.xlsx")

# 检查数据的属性数和样本数
print('数据集的形状为:', dataset.shape)

# 对列重新命名
dataset.columns = ['Date', 'Signal', 'Speed', 'Distance', 'Duration', 'Result', 'Technology', 'Delay', 'MOS']

# 对Result属性的取值重新命名
dataset['Result'] = dataset['Result'].map({'SUCCESS': 'Success', 'FAILURE - DROP CALL': 'Drop', 'FAILURE - SETUP FAIL': 'Fail'})

# 检查是否存在缺失值
print('各属性的缺失值数量:')
print(dataset.isnull().sum())

# 对缺失值进行处理
# 有少量缺失值的Signal属性,直接删除缺失记录
dataset = dataset[~dataset['Signal'].isin(['NaN'])]

# 有较多缺失值的Distance属性,用插值法进行填充
dataset.interpolate(axis=0, inplace=True)

# 查看属性的统计信息
print('数据集的统计信息:\n', dataset.describe())

# 有不合理值的属性,进行插值替换
dataset.replace({'Speed': -1, 'Delay': 0}, np.nan, inplace=True)
dataset.interpolate(axis=0, inplace=True)

# 检测连续性属性值是否存在离群点
col_names = ['Signal', 'Speed', 'Distance', 'Duration', 'Delay']
ver_coord = ['信号强度/dBm', '移动速度/m/s', '距离/m', '持续时长/s', '呼叫时延/s']

for i, col_val in enumerate(col_names):
    plt.figure(figsize=(8, 6))  # 为每一个图单独创建一个绘图对象,并设置图的大小
    sns.boxplot(y=dataset[col_val])
    plt.title('箱线图 - {}'.format(col_val), fontsize=13)
    plt.ylabel(ver_coord[i], fontsize=11)
    plt.show()  # 显示每个单独的图

# 删除Distance属性中的离群点(即大于100KM的记录)
print('Distance值超过100km的样本数:')
print(dataset[dataset['Distance'] > 100000].count())

# 对日期进行处理
dataset = dataset.reindex(columns=['Month'] + ['Day'] + ['Weekday'] + ['Hour'] + list(dataset.columns))
dataset['Month'] = dataset.loc[:, 'Date'].dt.month
dataset['Day'] = dataset.loc[:, 'Date'].dt.day
dataset['Weekday'] = dataset.loc[:, 'Date'].dt.dayofweek
dataset['Hour'] = dataset.loc[:, 'Date'].dt.hour
print('对日期处理后的数据集:')
print(dataset.head(10))

# 观察MOS随时间的变化
col_names = ['Month', 'Day', 'Weekday', 'Hour']
dataset['Weekday'] = dataset['Weekday'].map({0: 'Mon', 1: 'Tue', 2: 'Wed', 3: 'Thur', 4: 'Fri', 5: 'Sat', 6: 'Sun'})
hor_coord = ['时间/m', '时间/d', '时间/w', '时间/h']
# 设置绘图风格和中文字体
with sns.axes_style("whitegrid"):
    plt.rcParams['font.sans-serif'] = 'SimHei'
    fig, ax = plt.subplots(len(col_names), figsize=(8, 24))
    for i, col_val in enumerate(col_names):
        sns.pointplot(x=dataset[col_val], y=dataset['MOS'], ci=None, ax=ax[i])  # 图中的是均值点
        ax[i].set_title('Plot - {} tendency'.format(col_val), fontsize=13)
        ax[i].set_xlabel(hor_coord[i], fontsize=11)
        ax[i].set_ylabel('MOS', fontsize=11)
        ax[i].set_ylim(0, 5.0)
    plt.show()

dataset['Weekday'] = dataset['Weekday'].map({'Mon': 1, 'Tue': 2, 'Wed': 3, 'Thur': 4, 'Fri': 5, 'Sat': 6, 'Sun': 7})

# 对分类属性进行one-hot encoding
new_data = pd.get_dummies(dataset, columns=['Technology'], prefix='Tech')
new_data = pd.get_dummies(new_data, columns=['Result'], prefix='Res')
print('对分类属性进行独热编码后的结果:')
print(new_data.head(10))

# 观察不同网络制式下Signal属性的分布
tech_data_lte = new_data[new_data['Tech_LTE'] == 1]
tech_data_umts = new_data[new_data['Tech_UMTS'] == 1]
tech_data_gsm = new_data[new_data['Tech_GSM'] == 1]

ax1 = sns.kdeplot(tech_data_lte['Signal'], label='LTE网络', linestyle='-.')
ax2 = sns.kdeplot(tech_data_umts['Signal'], label='UMTS网络', linestyle='--')
ax3 = sns.kdeplot(tech_data_gsm['Signal'], label='GSM网络')
plt.title('Signal属性核密度估计图')
plt.xlabel('信号强度/dBm', fontsize=11)
plt.ylabel('密度', fontsize=11)
plt.show()

# 观察连续属性之间的相关性
f, ax = plt.subplots(figsize=(8, 6))
a = new_data[['Signal', 'Speed', 'Distance', 'Duration', 'Delay', 'MOS']]
corr = a.corr()
sns.heatmap(corr, xticklabels=corr.columns.values, yticklabels=corr.columns.values, annot=True)
plt.show()


# 删除多余的属性
new_data.drop(['Date', 'Speed', 'Distance', 'Duration', 'Delay', 'Res_Fail', 'Tech_GSM'], axis=1, inplace=True)

# 对数据集进行分割
labels = np.array(new_data['MOS'])
features = new_data.drop(['MOS'], axis=1)
feature_list = list(features.columns)
features = np.array(features)
train_features, test_features, train_labels, test_labels = train_test_split(features, labels, test_size=0.25, random_state=42, shuffle=True, stratify=labels)

# 训练随机森林
# (1)使用默认参数
rf = RandomForestRegressor(random_state=10)
rf.fit(train_features, train_labels)

# 对测试集进行预测
predictions = rf.predict(test_features)

# 对结果进行评估
print("训练集的R2评分:%.3f" % metrics.r2_score(train_labels, rf.predict(train_features)))
print("测试集的R2评分:%.3f" % metrics.r2_score(test_labels, predictions))

# (2)模型优化
# 设置树的个数的取值范围
n_estimators = [int(x) for x in np.linspace(start=1500, stop=2500, num=100)]
# 设置节点分裂时需要考虑的属性数
max_features = np.linspace(0.01, 1.0)
# 设置树的最大深度
max_depth = [int(x) for x in np.linspace(5, 35, num=20)]
# 设置节点分裂所需的最少样本数
min_samples_split = [2, 5, 10]
# 设置每个叶子结点所需要的最小样本数
min_samples_leaf = [2, 5, 10, 25]

# 创建随机网格
random_grid = {
    'n_estimators': n_estimators,
    'max_features': max_features,
    'max_depth': max_depth,
    'min_samples_split': min_samples_split,
    'min_samples_leaf': min_samples_leaf}

# 创建用于调参的随机森林模型
rf = RandomForestRegressor(random_state=10)
# 通过交叉验证搜索最优参数组合
rf_random = RandomizedSearchCV(estimator=rf, param_distributions=random_grid,
                               n_iter=5, scoring='neg_mean_absolute_error',
                               cv=3, verbose=2, random_state=42)  # , n_jobs=-1)
rf_random.fit(train_features, train_labels)

# 输出最优参数组合
print(rf_random.best_params_)
print("训练集的R2:%.3f" % metrics.r2_score(train_labels, rf_random.predict(train_features)))


# 对测试集进行预测
import matplotlib.pyplot as plt

predictions = rf_random.predict(test_features)
print("测试集的R2:%.3f" % metrics.r2_score(test_labels, predictions))

# 输出属性的重要性程度
importances = rf_random.best_estimator_.feature_importances_
indices = np.argsort(importances)[::-1]
print('各属性的重要性程度:')
for f in range(train_features.shape[1]):
    print("%2d) %-s %f" % (f + 1, new_data.drop(['MOS'], axis=1).columns[:][indices[f]], importances[indices[f]]))

# 用柱状图显示重要性程度
importances = sorted(list(importances))
y_values = list(range(len(importances)))
plt.figure(figsize=(8, 6))
plt.barh(y_values, importances)
reverse_indices = np.argsort(importances)
plt.yticks(range(len(indices)), [feature_list[i] for i in reverse_indices])
plt.xlabel('重要性程度')
plt.title('各属性重要性程度排名')
plt.show()

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 19
 0
- 0


 已为社区贡献1条内容

所有评论(0)