PS-FedGAN: An Efficient Federated Learning Framework With Strong Data Privacy 联邦学习阅读
概括
提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加
联邦学习目前成为分布式学习系统的有效典例,利用了底部的数据特征,也保护了数据隐私。
但是,在无线网络系统上的许多物联网应用中的FL客户端之间存在数据异构型性。
现有的FL框架在捕获不同分布的本地客户端数据的整体特征存在挑战。
一种方法是在FL中应用生成对抗网络(GAN),通过集成GAN来重新生成匿名训练数据,而不会将原始客户端数据暴露给可能的窃听,从而解决数据异构性问题。
尽管取得了进展,但现有的基于GAN的FL框架仍然会产生很高的通信成本,并引发其他隐私问题,限制了它们的实际应用。
为此,这项工作提出了一种新的FL框架,只适用于部分GAN模型共享。这种新的部分共享联邦GAN(PS-FedGAN)框架有效地解决了客户端之间的异构数据分布问题,并以降低的通信成本(特别是通过无线网络)加强了隐私保护。
本文分析证明了所提出的PS-FEdGAN框架的收敛性和隐私优势。通过基于几个著名的基准数据集的实验结果,提出的PS-FedGAN在异构(非独立同分布)客户端数据分布下表现出强大的解决FL的潜力,同时提高数据隐私和降低通信开销。
提示:写完文章后,目录可以自动生成,如何生成可参考右边的帮助文档
文章目录
前言
提示:这里可以添加本文要记录的大概内容:
联邦学习提供了一个高效的框架,用于分布式和协同学习,同时保护用户数据隐私。作为一个新兴的人工智能领域,FL的充分潜力必须有效地应对众多挑战,包括数据分布的异质性、数据隐私考虑以及通信效率,尤其是在物联网(IoT)系统的边缘设备上。
随着物联网设备的广泛部署,如智能穿戴设备、移动设备和个人数字助手,每秒都会生成大量数据,从而支持协同机器学习以提高效用。目前,许多全球机器学习模型(如分类器)已从丰富的用户生成数据中受益,并在许多物联网系统平台上得到实现。
另一方面,基于对新数据的访问,持续(机器)学习用于全球模型的更新,这也是物联网系统中重要的学习方面。由于通信效率和用户数据隐私等瓶颈,直接应用标准的机器学习技术来持续更新全球模型并不简单。作为一种解决方案,FL被广泛应用于此类物联网系统中。
尽管取得了成功,现有的联邦学习(FL)方法在处理不同参与FL客户端(用户)之间的非独立同分布(非IID)异质性数据时仍需更多关注,而不是假设用户数据是IID的。处理数据异质性的问题仍然是一个有趣的研究课题。现有的研究主要通过共享公共数据集、修改算法或生成模型来应对数据异质性。在这些处理数据异质性的FL方案中,基于生成对抗网络(GAN)的方法近年来备受关注,因为它们能够在不共享原始数据的情况下再生数据统计。
在以往的研究中,GAN模型被本地训练以捕获本地用户的数据分布,之后将本地训练的GAN模型共享到中心化服务器进行模型聚合。模型聚合可以依赖于生成更多数据来更新目标全局模型或为每个用户定制GAN模型。
尽管已有报道取得了一定的成功,但基于GAN的FL也表现出一些不足之处,例如由于共享完整模型或合成数据导致的隐私保护不佳和通信冗余问题。许多研究强调了传统FL方法对安全风险的敏感性,揭示了敏感信息泄露的潜在风险。这些问题也延伸到基于GAN的FL,如所指出的那样,发布GAN模型或合成数据会引发严重的隐私问题。具体来说,GAN面临来自重建攻击和成员推断攻击的威胁,攻击者试图分别重新创建数据样本和确定特定数据样本的使用情况。
为解决基于GAN的FL中的隐私问题,一些研究探索了差分隐私(DP)。
然而,采用DP带来了一个显著的挑战:平衡隐私与效用之间的权衡。
这一特定挑战因必须分配隐私预算而加剧,这是平衡学习模型性能与隐私保护的关键参数。
矛盾的是,为了提高下游任务的性能,实践者往往选择无限隐私预算,从而实际上取消了任何隐私保护措施。
此外,基于GAN的联邦学习(FL)的通信链路效率因共享模型的规模庞大和在各种现实网络场景中通信资源的限制而受到阻碍。
这种通信效率低下构成了实际障碍,限制了在联邦环境中模型更新的无缝交换以及协同学习过程。因此,应对隐私问题和通信效率成为提升基于GAN的FL方法的鲁棒性和适用性的关键挑战。
总结来说,现有的GAN相关FL方法由于完整GAN共享(FGS)而导致了较高的通信开销和严重的隐私泄露问题。另一方面,现有的隐私保护方法在保障数据安全时可能导致效用降低。
为此,我们重新审视了GAN共享策略,提出了一种新颖的GAN发布机制——部分共享联邦GAN(PS-FedGAN),以应对FL客户端用户中非独立同分布(非IID)数据异质性的实际情况。通过我们提出的FL框架,在服务器端从客户端用户本地训练的部分共享GAN模型中重建独立生成器,其中每个客户端仅与服务器共享其判别器。该PS-FedGAN大大降低了模型共享的通信网络开销,并在通信轮次中提供了更好的数据隐私保护。此外,它弥合了效用和隐私之间的差距。
我们总结了如下贡献:
我们提出PS-FedGAN,这是一种新颖的基于GAN的FL学习框架,专门用于应对FL客户端用户中的非IID数据。更具体地说,我们在服务器端训练生成器,以捕获本地用户GAN的底层数据分布,仅需共享单个判别器。该框架显著降低了通信成本并提高了数据隐私。
我们提供了生成器训练在客户端和云服务器端的收敛性分析。通过分析基于PS-FedGAN的通用判别器训练的收敛性,阐明了仅共享判别器在降低通信成本方面的优势。据我们所知,我们是首次对基于部分共享GAN的FL进行系统的理论分析。
我们提出了对PS-FedGAN隐私的可解释结果,并通过理论分析和大量实验进一步验证。
实验结果基于多个著名的基准数据集,从效用、隐私和通信成本方面证明了PS-FedGAN的有效性和效率。
提示:以下是本篇文章正文内容,下面案例可供参考
1
一、GAN是什么?
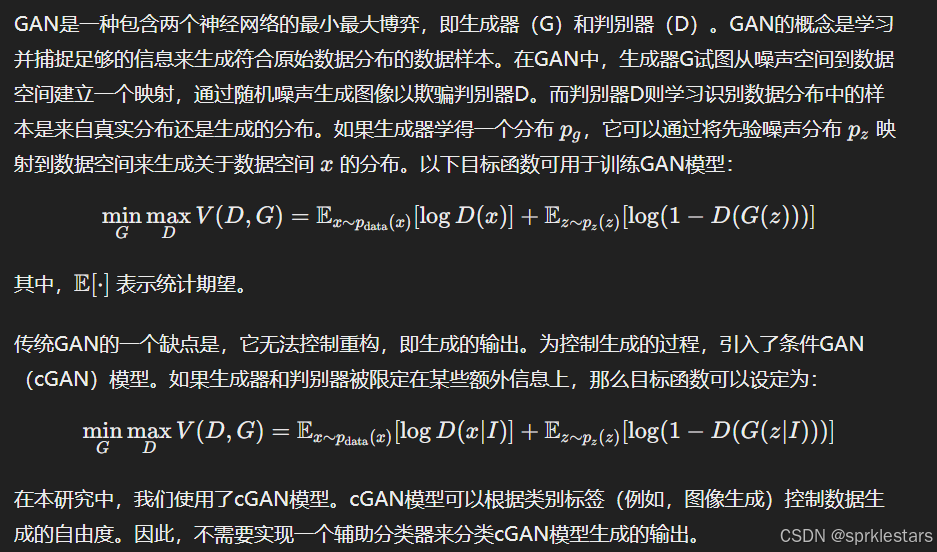
生成式对抗网络(GAN, Generative Adversarial Networks )是一种深度学习模型,是近年来复杂分布上无监督学习最具前景的方法之一。
模型通过框架中(至少)两个模块:生成模型(Generative Model)和判别模型(Discriminative Model)的互相博弈学习产生相当好的输出。
原始 GAN 理论中,并不要求 G 和 D 都是神经网络,只需要是能拟合相应生成和判别的函数即可。但实用中一般均使用深度神经网络作为 G 和 D 。一个优秀的GAN应用需要有良好的训练方法,否则可能由于神经网络模型的自由性而导致输出不理想。
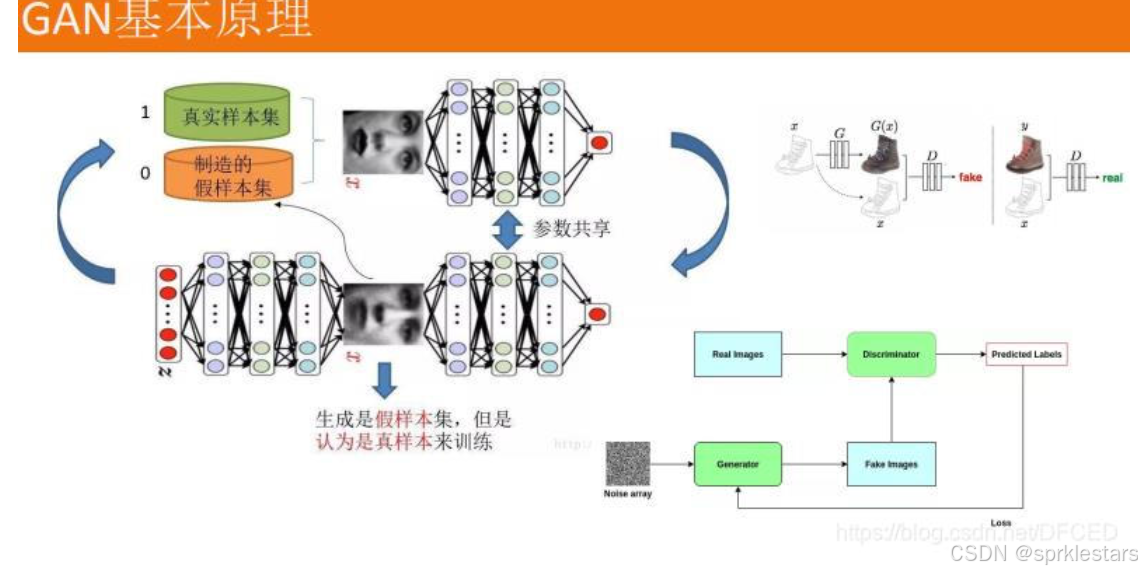
GAN的基本原理其实非常简单,这里以生成图片为例进行说明。假设我们有两个网络,G(Generator)和D(Discriminator)。正如它的名字所暗示的那样,它们的功能分别是:
G是一个生成图片的网络,它接收一个随机的噪声z,通过这个噪声生成图片,记做G(z)。
D是一个判别网络,判别一张图片是不是“真实的”。它的输入参数是x,x代表一张图片,输出D(x)代表x为真实图片的概率,如果为1,就代表100%是真实的图片,而输出为0,就代表不可能是真实的图片。
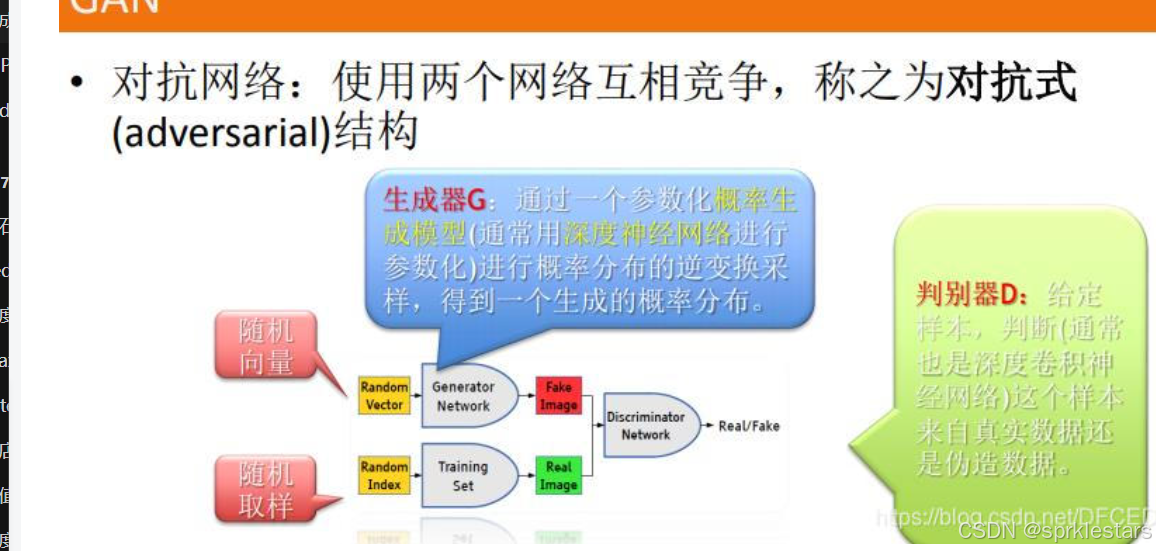
在训练过程中,生成网络G的目标就是尽量生成真实的图片去欺骗判别网络D。而D的目标就是尽量把G生成的图片和真实的图片分别开来。这样,G和D构成了一个动态的“博弈过程”
联邦学习和数据集
FL学习遇到的困境
联邦学习(FL)在分布式学习场景中的隐私保护方面表现出简单有效的优势。在基本的FL框架中,本地客户端的数据集往往是异质的、不平衡的,并且是非独立同分布(非IID)的。FL的网络环境受到通信带宽的限制。
为减少通信开销并保护隐私,联邦平均(FedAvg)算法成为了一种解决方案。FedAvg通过在一次通信轮次中整合多个本地更新来聚合各用户的梯度更新。
尽管已有研究探讨了FedAvg在非IID数据下的收敛性,但也有研究表明,FedAvg在非IID数据环境下对于某些数据集的准确率损失可能高达55%。
有效应对不同客户端之间的非IID数据异质性仍然是FL领域的一个开放问题。FedProx作为FedAvg的广义版本被引入,用于处理异构网络环境。
FedAvg的另一个扩展方法是SCAFFOLD,它集成了预测方差缩减技术来增强性能。Luo等人提出了一种新方法,涉及使用虚拟表示进行分类器校准,通过高斯混合模型采样虚拟特征。
采用另一种策略,Yoshida等人提倡在合作学习机制中共享原始数据。此外,有建议通过引入一小部分(例如5%)初始训练数据来使用传统FL算法处理非IID数据。
应对非IID数据的其他方法还包括GAN共享、合成数据共享和全局子数据集共享。这些多样化的方式共同推动了在FL中有效解决非IID客户端数据挑战的探索。
有关物联网的FL学习
FL可能适用于广泛的物联网(IoT)服务。这些服务包括IoT数据共享、数据卸载、缓存到IoT隐私和攻击检测。
与任何范式中的FL相似,IoT中FL的主要瓶颈在于不平衡且统计异质的用户数据以及增强系统安全性的需求。
Ghimire和Rawat研究了IoT中FL的网络安全方面。另一个关键问题涉及资源受限的IoT设备。另一方面,如文献中讨论的,GAN模型可以用于攻击基于IoT的FL系统。同时,基于GAN的FL方法在IoT应用中也很常见,以提升性能和提供个性化解决方案。
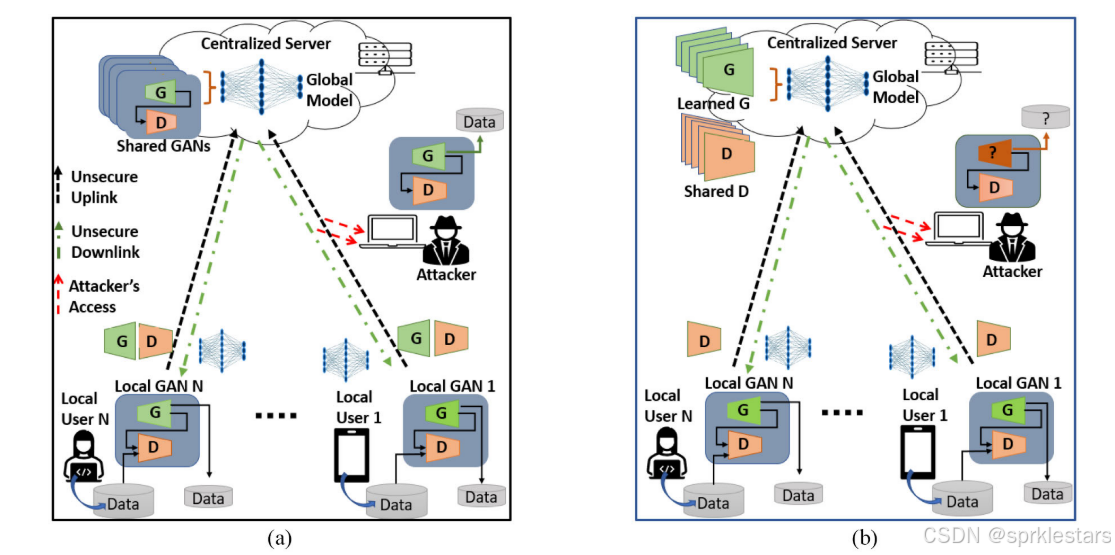
图(a): 传统FL中的完整GAN共享(FGS)
流程:在传统的完整GAN共享中,客户端用户会在本地训练其GAN模型,其中包含生成器(G)和判别器(D)。然后,客户端同时将生成器和判别器的参数传输给中央服务器以进行全局模型的更新。
安全性风险:由于通信链路的不安全,攻击者可能会窃听到生成器(G)和判别器(D)的信息,从而生成近似用户数据分布的合成数据,这可能导致数据隐私泄露。
隐私风险:攻击者获取到GAN模型后,可以通过合成数据接近真实的用户数据分布,甚至可能进行成员推断攻击,识别特定用户的数据是否在训练集中。
图(b): PS-FedGAN方案中的判别器部分共享
流程:在PS-FedGAN方案中,客户端用户只共享判别器(D)而不共享生成器(G)。在服务器端,根据多个客户端上传的判别器信息训练一个全局的判别器,同时在服务器端训练一个生成器,以学习和模拟不同客户端的本地数据分布。
安全性改进:由于只共享判别器,攻击者无法通过窃听获取生成器信息,因此无法重构出用户的合成数据分布,从而提高数据隐私保护。
隐私保护:PS-FedGAN通过仅共享判别器,避免了生成器共享带来的隐私风险,有效减少了攻击者重建或推测用户数据分布的可能性。
基于GAN的联邦学习(FL)用于IID和非IID客户端
在本地训练GAN并将训练好的模型发送到中央服务器的实践,已成为同时处理IID(独立同分布)和非IID(非独立同分布)数据的有效策略。在一项研究中,使用了条件GAN(cGAN),并且将本地分类器和生成器都共享给中央服务器。中央服务器训练一个全局分类器和生成器,以指导本地用户的操作。在此基础上,吴等人建议通过模型分割来保留cGAN的一部分,特别是判别器和隐藏分类器的一部分,同时共享生成器和全局分类器。
类似地,提出了共享整个本地GAN与服务器,并生成一个合成的本地数据集来训练全局GAN的概念。这种方法被称为完整GAN共享(FGS),一些研究中也探索了这一方法,其中仅聚合表现出最大均值差异的共享生成器。尽管这些方法表现出一定的前景,但在基于GAN的FL中有效应对隐私问题仍然是一个持续的挑战。为此,引入了差分隐私(DP)作为缓解措施,并在一些研究中展示了其应用。然而,在DP中引入隐私预算带来了隐私与效用之间的微妙平衡。
在基于GAN的FL中,寻找在保持隐私的同时减少共享模型大小(即通信成本)的有效方法仍然是一个开放的研究挑战,值得进一步探索和创新。
生成对抗网络
公式化
提示:这里对文章进行总结:
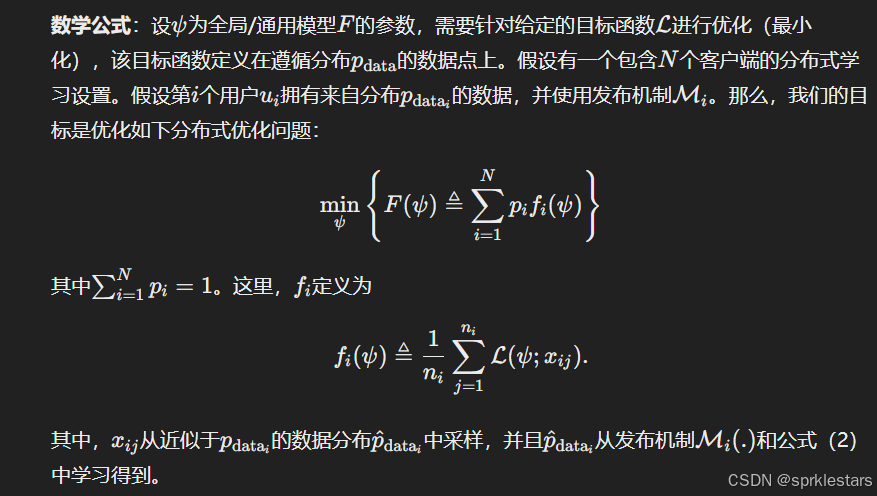
在本研究中,旨在开发一个新的基于GAN的联邦学习(FL)框架,以支持分布式学习环境中的全局/通用任务。
为了方便起见,我们将使用图像分类作为示例应用。假设存在一个可靠的中央服务器,但其访问客户端训练数据的权限有限,因此在全局任务上达到理想的准确率面临一定的挑战。我们假设在用户之间存在非IID数据分布和不安全的通信链路,这在实际应用中是常见的场景。
例如,在智能医疗中,一个学习任务可能是训练神经网络以检测特定疾病。某一临床机构可能拥有来自特定患者群体的大脑图像数据,而其他医院可能拥有相同疾病的多种样本。基于所有分布式数据的全局模型可以帮助所有参与的医院检测疾病,并为患者提供更好的服务,而无需释放实际的患者数据。
在这种协作系统中,用户数据隐私是一个关键问题。此外,向数据集中添加人工噪声以隐藏敏感信息可能导致信息失真和学习效率下降。在本研究中,我们探讨如何在保留局部隐私的同时保持原始数据统计。
受现有基于GAN的FL方法的启发,我们为FL开发了一种新的GAN共享/发布机制,以实现隐私保护和通信效率。
在现有的基于GAN的联邦学习(FL)工作中,我们假设一个由云端中央服务器和多个分布式客户端/用户组成的系统,这些客户端/用户与服务器进行通信。
每个客户端都拥有足够的资源来训练本地GAN模型。需要注意的是,尽管我们应用了条件GAN(cGAN)来通过伪标签化缓解标签检测的需求,但我们提出的方案的基本原理通常适用于所有类型的生成模型。
为了评估我们框架在隐私保护方面的有效性,我们考虑了被动窃听的对抗性攻击者。
为了模拟这些安静的对手的潜在攻击,我们假设攻击者有能力窃听连接本地用户和服务器的通信信道而不被检测到,如图1所示。攻击者的目标是通过重构攻击来估计本地用户的数据分布。
如图1所示,在传统的基于GAN的FL方法中,这类攻击者可能对整个GAN模型有不受限制的访问权限。然而,我们提出的PS-FedGAN特别设计用于应对与完整GAN共享相关的安全漏洞。
PS-FED模型
A. PS-FedGAN
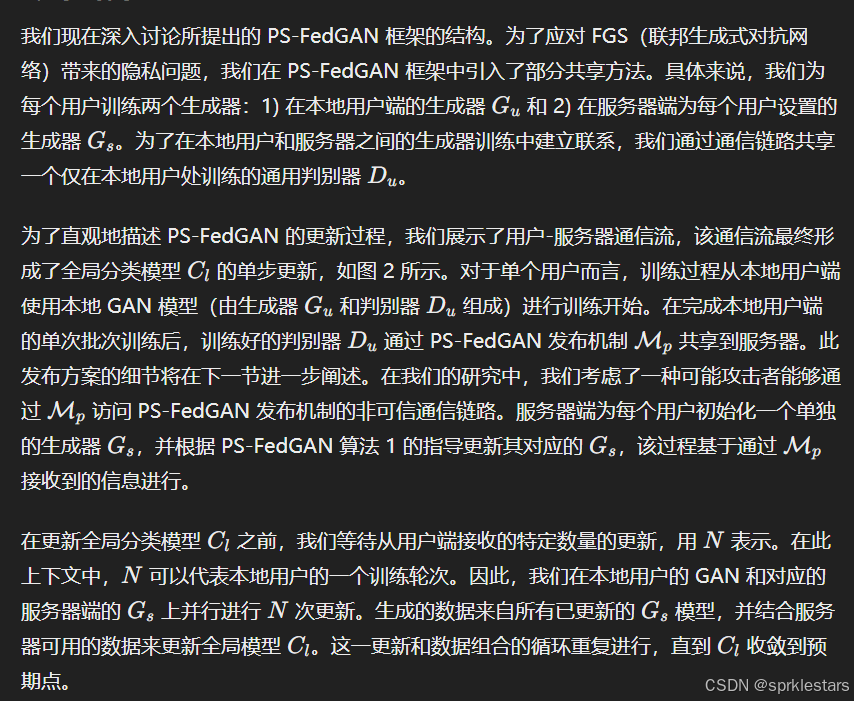
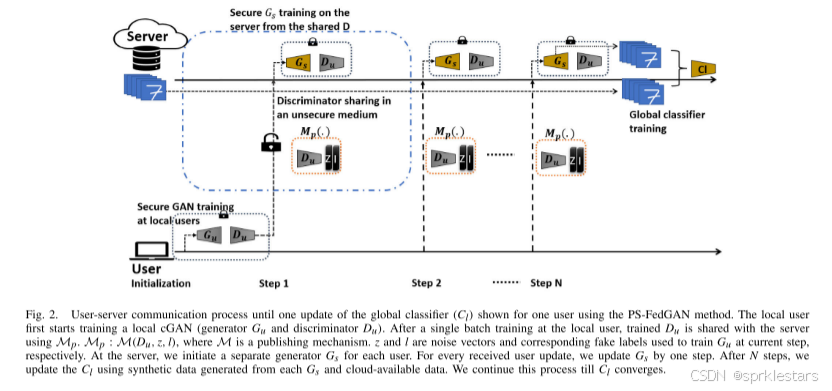
图2
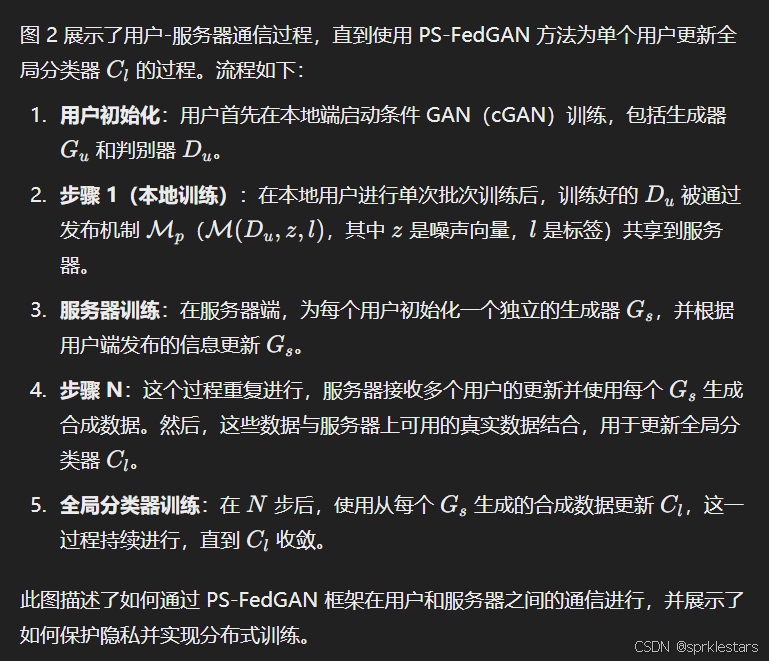
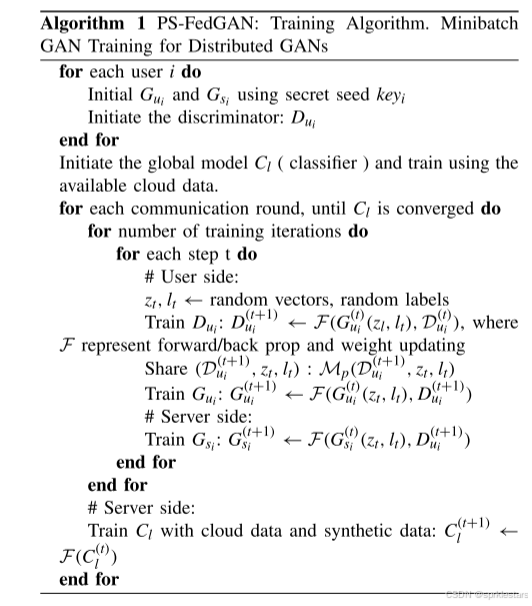
算法1
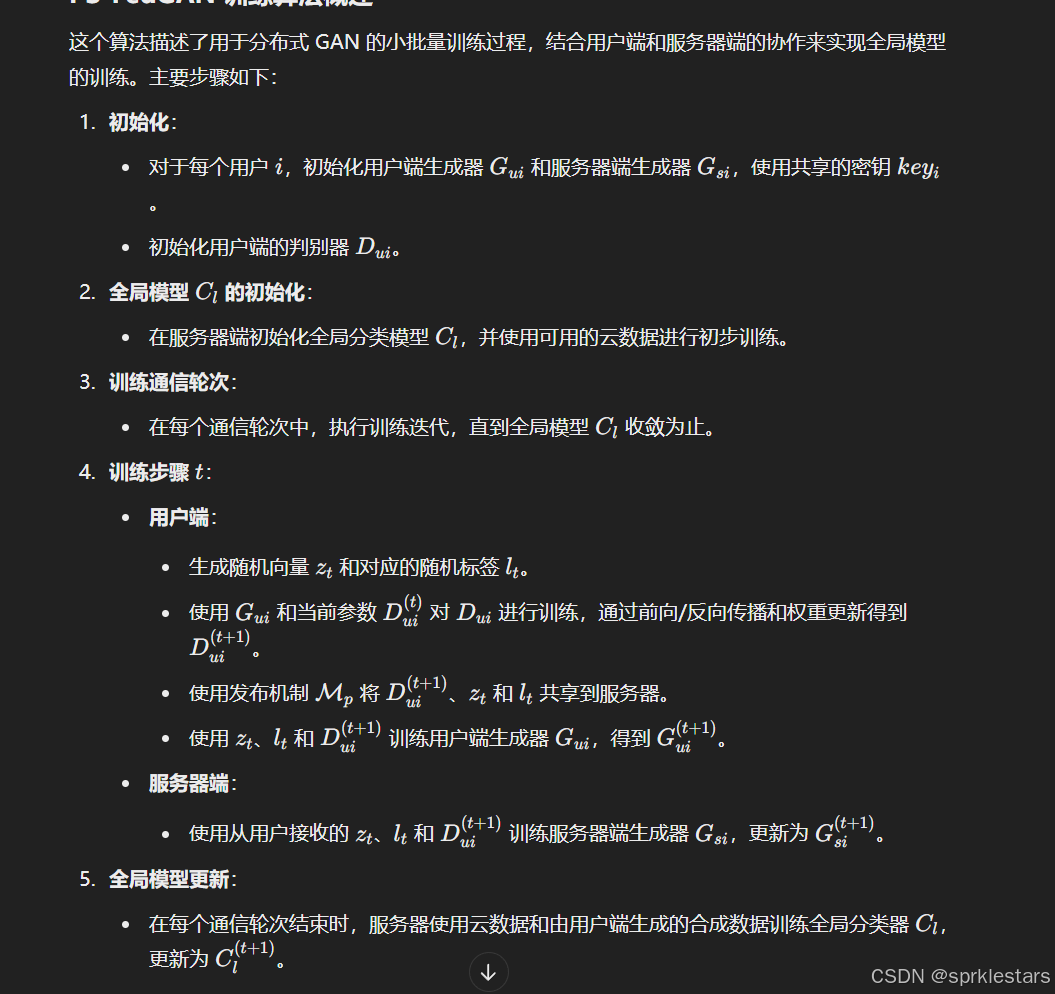
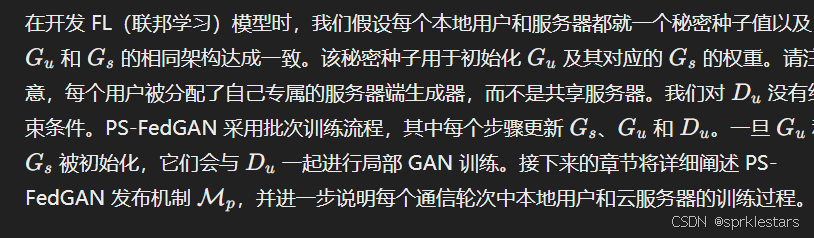
PS-FedGAN 发布机制:
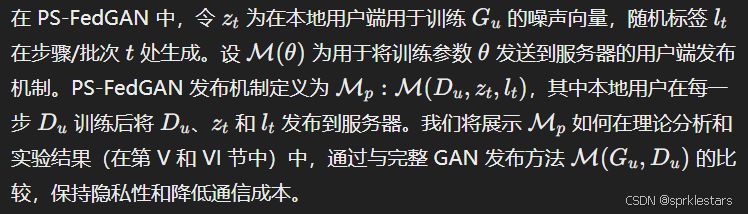
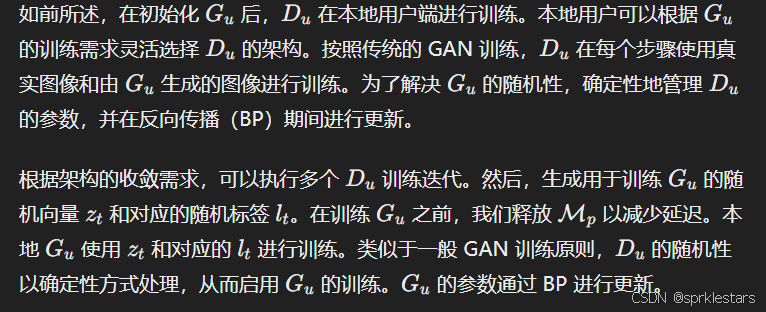
PS-FedGAN 本地用户训练:
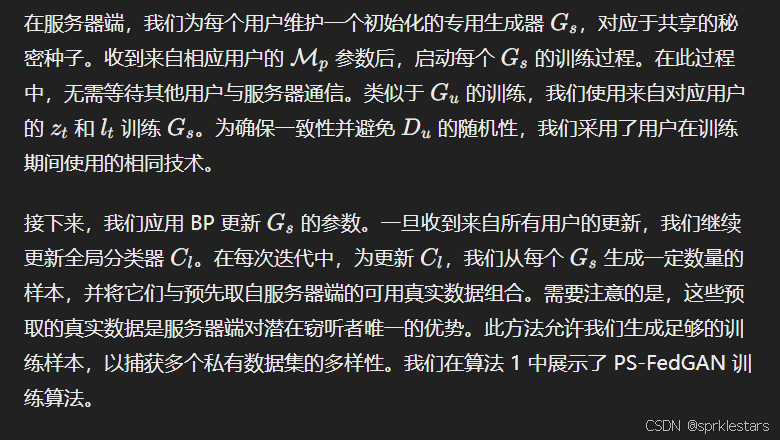
PS-FedGAN 服务器端训练:
攻击者模型
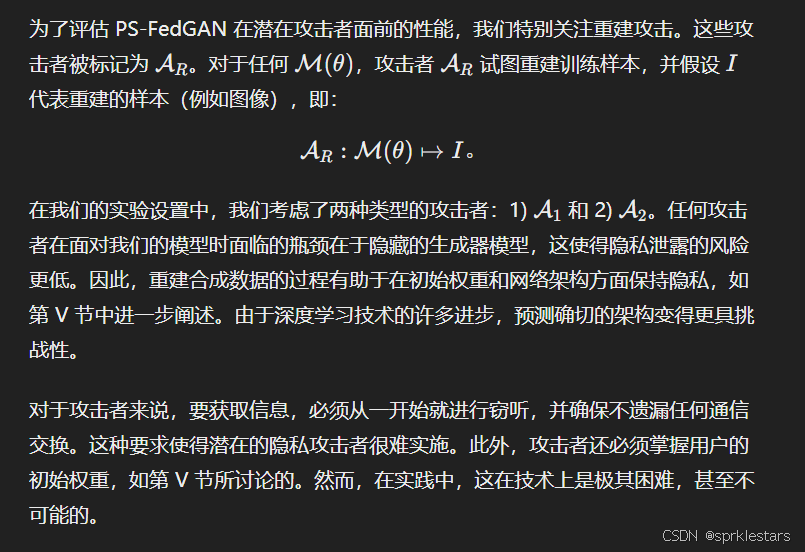
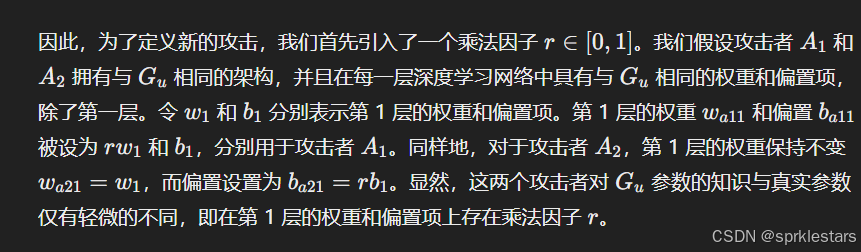
由于各种实际限制,例如功耗、延迟和硬件能力,很难准确估计生成器的结构。生成器结构的复杂性和多样性在保护隐私方面发挥了重要作用。生成器可用的多样化结构及其复杂性,使攻击者难以准确推断出精确的模型结构。这种内在的困难进一步增强了系统中隐私的保护。
通过利用复杂且多变的生成器结构,PS-FedGAN 为潜在的隐私泄露提供了额外的保护层。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 41
 0
- 0


 已为社区贡献4条内容

所有评论(0)