SVCA: Secure and Verifiable Chained Aggregation for Privacy-Preserving Federated Learning 联邦学习文献阅读
概括
提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加
在联邦学习过程中允许多个用户使用个体数据在本地训练机器学习模型,然后以隐私保护的聚合方式更新全局模型。
然而,在联邦学习中,用户的模型参数存在隐私泄露风险,聚集服务器也可能伪造聚合结果。
本文提出了可验证的链式聚合隐私保护(PPFL)方案SVCA。
先对用户进行分组并构造链式聚合结构,然后采用秘密共享的方式方式整租用户丢失,最后提出了一种聚合结果的安全验证方案,保证了聚合结果的安全性和验证过程的安全性分析证明。
此外,第二个挑战是在保证安全验证的同时,减少不必要的计算和通信开销是非常必要的。提出了一种安全可验证的PPFL链式聚合,该聚合使用了轻量级的密码原语,不仅保护了用户的隐私,而且验证了聚合的正确性,保证了验证过程的安全性.更具体地说:1)为了实现解决方案的轻量级原则,我们对不同区域的用户进行分组,每个组使用链式聚合操作,并将其发送到聚合服务器。2)为了验证聚合结果的正确性和保证验证过程的安全性,我们采用了一种承诺方案来保证向量对不被篡改,并允许每个用户验证返回结果的正确性。
综上所述,本文的主要贡献可以概括如下。1)提出的SVCA算法不仅能够保护用户模型参数的隐私性,而且能够支持不同区域的整组用户的退出.此外,SVCA具有简单的架构,允许在资源有限的设备上部署。2)为了保护聚合服务器免受单点故障的影响,SVCA使用Hadamard乘积来验证聚合结果的正确性,并使用提交方案来保证验证过程的安全性。3)安全性分析表明,SVCA保证了用户的隐私,并验证了返回的聚合结果的正确性。大量实验证明SVCA不影响模型的分类性能,具有实用性。
提示:写完文章后,目录可以自动生成,如何生成可参考右边的帮助文档
文章目录
背景
基于噪声的链式联邦学习
与传统的加密方法不同,基于DP的PPFL是一种数据扰动方法,根据数据的统计分布机制,通过在FL训练参数中加入噪声来实现隐私保护。与其他方法相比具有相对较低的计算开销,但以牺牲模型精度为代价。此外,此类方案通常会在模型参数中引入难以去除的噪声,从而难以保证返回的聚合结果的正确性。
基于安全多方计算的链式联邦学习
基于掩码的PPFL
Chain-PPFL使用单掩码和链式传输通信机制,但它没有考虑聚合服务器的单点故障。
Xu et al. ,Guo et al. ,Ren et al. 和Li et al. 都采用了基于成对掩码的安全聚合协议。该协议在诚实但好奇和活跃的对手设置中是高度安全的,并支持用户退出。但是,它不保证返回的聚合结果的正确性。类似于利用单一屏蔽聚合协议来实现安全聚合,但他们尚未考虑返回聚合结果的正确性。
基于密码共享的PPFL
在基于SS的PPFL方案中,用户计算秘密数据的份额并将其发送到聚合服务器,聚合服务器重构秘密数据。
可验证的链式联邦学习
由于聚合服务器返回的聚合结果与用户数据的隐私密切相关,因此如果聚合服务器存在单点故障的风险,则用户遭受隐私泄露的风险通常也会增加。
提示:这里可以添加本文要记录的大概内容:
提示:以下是本篇文章正文内容,下面案例可供参考
准备知识
FL基本框架
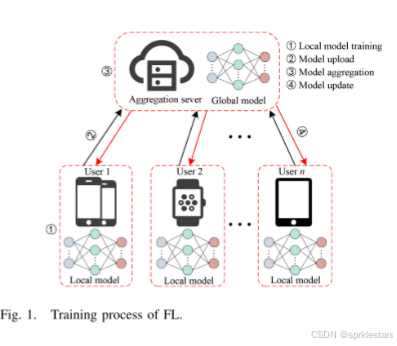
1)本地模型训练:每个用户接收到聚合服务器发送的全局模型后,进行本地模型训练。
2)模型上传:每个用户将他/她的本地训练模型上传到聚合服务器。
3)模型汇总。聚集服务器接收本地模型以更新全局模型。
4)模型更新:聚合服务器更新全局模型,并将其发送给每个用户,以便在下一个纪元中进行训练
密码原语
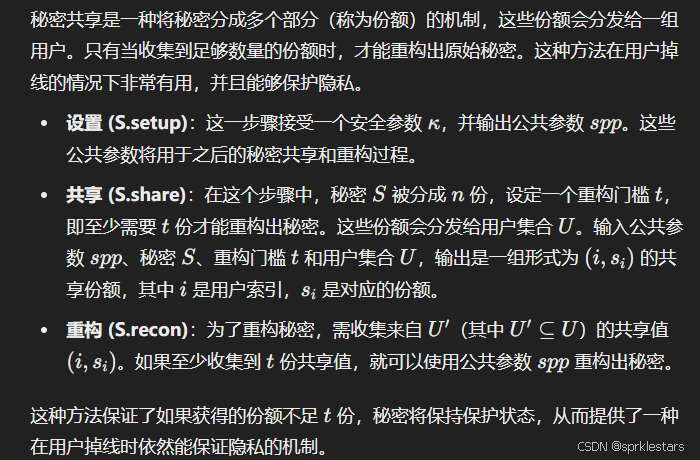
秘密共享
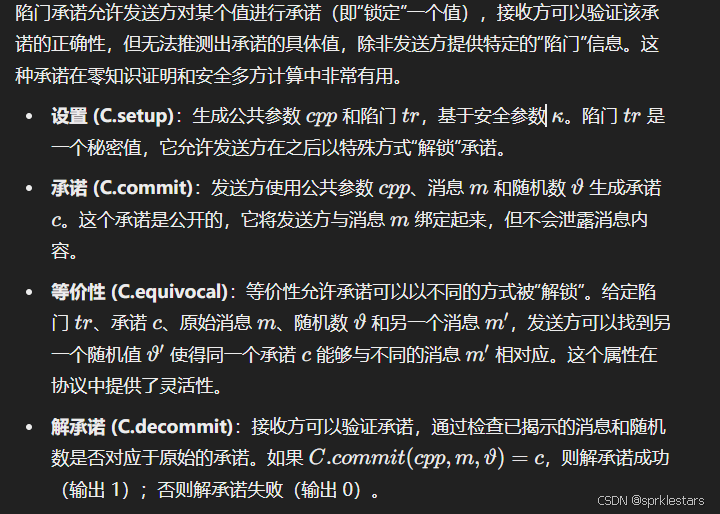
陷门承诺
Hadamard积
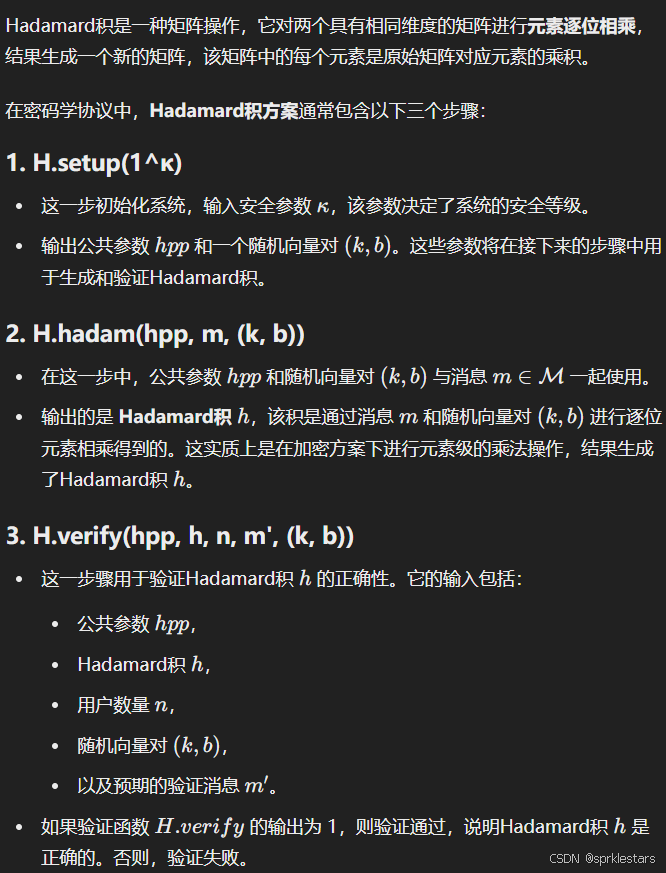
Hadamard积是一种矩阵操作,它对两个具有相同维度的矩阵进行元素逐位相乘,结果生成一个新的矩阵,该矩阵中的每个元素是原始矩阵对应元素的乘积。
在密码学协议中,Hadamard积方案通常包含以下三个步骤:
系统模型
系统架构
本文提出的 SVCA(安全可验证协同聚合)系统架构包括三个实体:
聚合服务器;
普通用户;
中继用户。
- 聚合服务器(Aggregation Server)
在每个轮次(epoch),聚合服务器不仅生成随机掩码、随机向量对和所有用户的提交随机数,还会聚合每组用户上传的模型参数。此外,它为每个用户生成承诺和证明。 - 普通用户(Normal Users)
每个普通用户使用私有数据集来训练机器学习模型,并在每个轮次中获得更新的本地模型参数。此外,他们不仅使用随机掩码对本地参数进行加密,还验证聚合服务器返回的模型参数的正确性。 - 中继用户(Relay Users)
每组中的最后一个用户充当中继用户。在每个轮次中,他们不仅具备普通用户的功能,还负责去除掩码、生成秘密共享,并生成组标签。
威胁模型
在SVCA(安全可验证协同聚合)中,我们假设所有用户都是诚实且好奇的,意味着用户在执行协议时会诚实地提供正确的模型参数,但他们可能会试图在协议执行期间推测出其他用户的私人数据。此外,我们假设聚合服务器是恶意的,并且可能被恶意的外部对手捕获,导致其偏离协议或执行不同的计算来获取用户的私人数据。特别地,恶意的外部对手还可能操纵聚合服务器,修改或伪造聚合模型参数和验证标签,以欺骗诚实用户接受错误的聚合结果和验证标签,从而破坏联邦学习的训练。
此外,在一个组内,我们不仅允许l−1个普通用户串通,还允许中继用户与l−2个普通用户串通。但我们不允许中继用户与l−1个普通用户串通,因为在这种情况下,组内的信息是公开透明的,隐私保护将不再必要。
设计目标
基于前述的威胁模型,我们提出的 SVCA 需要满足以下设计目标:
效率(Efficiency):随着技术的不断发展,手持设备(如智能手机、平板电脑等)的数量显著增加。这些设备通常受限于电池容量和计算能力,以及其他外部因素。因此,理想的 PPFL(隐私保护联邦学习)系统应尽量减少使用复杂的密码学原语,并减少通信次数。
容错性(Dropout Tolerance):由于电池电量和外部因素的影响,某些轮次中中继用户可能会掉线,进而影响联邦学习的训练。因此,理想的 PPFL 系统应支持整个用户组的掉线容忍能力。
正确性(Correctness):恶意的聚合服务器可能会篡改聚合结果,返回伪造的值,从而破坏联邦学习的训练。因此,理想的 PPFL 系统应支持用户独立验证聚合结果的正确性。
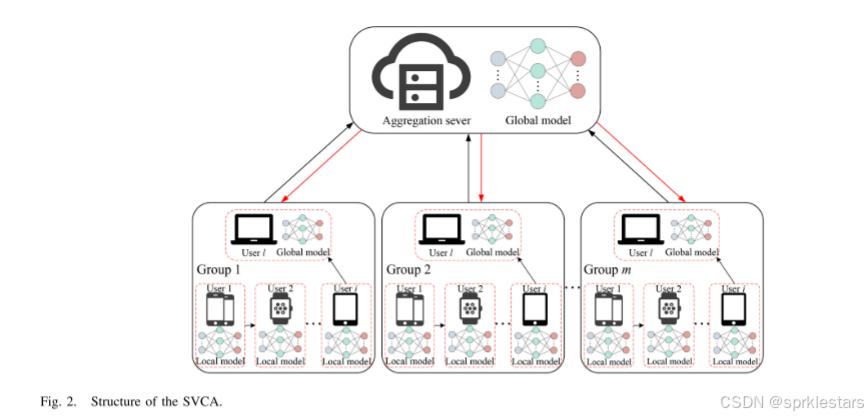
详细实现
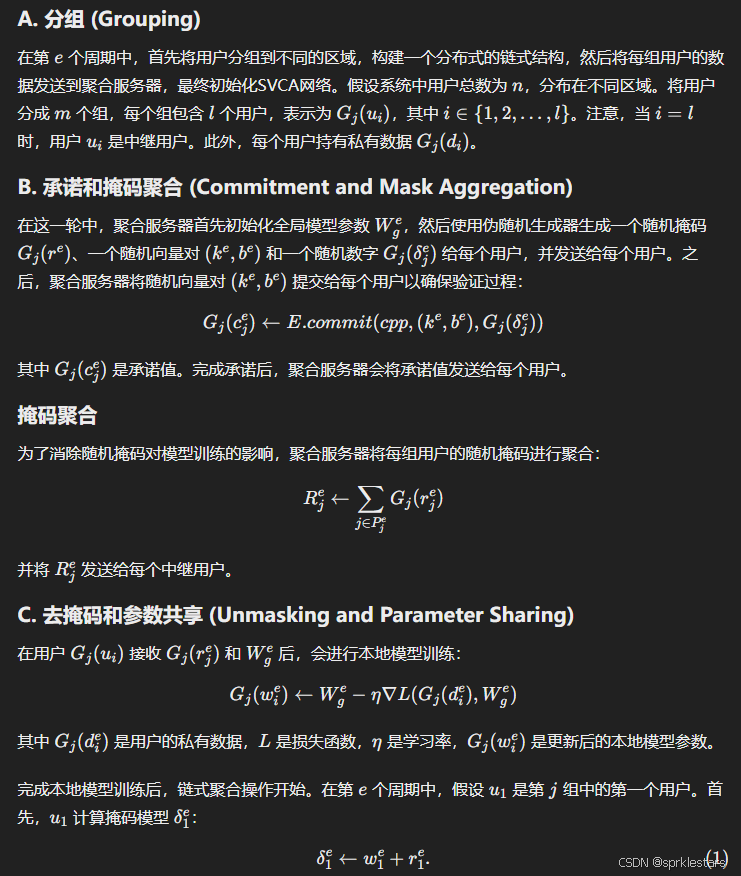
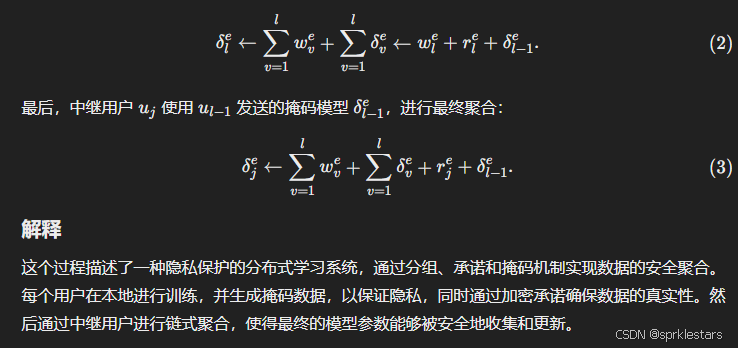
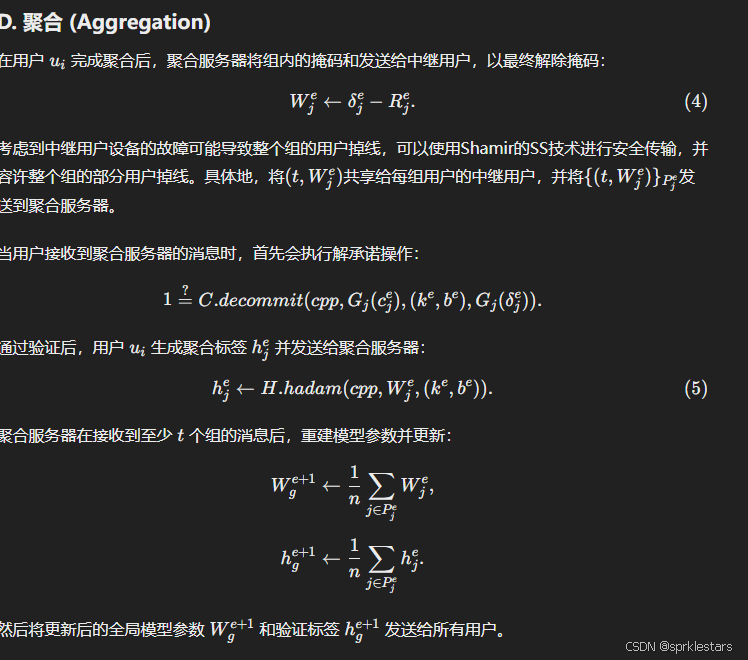
我们介绍了我们提出的SVCA的技术细节,它可以分为五轮:
1)分组;
2)提交和掩码聚合;
3)解掩码和参数共享;
4)聚合;
5)验证
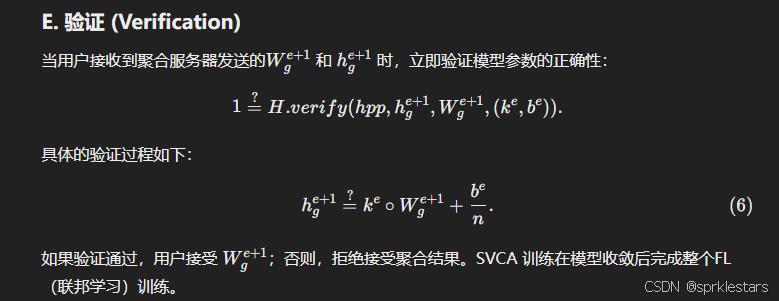
整体分析
在这个联邦学习的过程中,SVCA(Secure Verification-based Chain Aggregation)方法通过分组、掩码和验证机制,确保了每个用户的数据隐私以及聚合结果的可靠性:
数据隐私和安全:
在用户计算和传输的过程中,利用掩码技术和加密承诺保护了数据隐私,防止了未经授权的数据泄露。Shamir的SS技术还确保了即使有部分用户掉线,系统仍能完成整体计算。
分组和中继机制:
系统通过将用户分组以及链式的中继机制,将用户的数据逐步聚合,避免了中心化的负担和潜在的单点故障。同时,通过掩码聚合防止单个用户直接泄露其本地模型。
验证与最终模型共享:
验证机制确保了数据在传输和聚合过程中未被篡改,验证通过的模型结果被共享给所有用户,实现数据一致性和模型可靠性。
最终更新的全局模型参数 被验证后,确保了整个训练过程的正确性和安全性。
这个方案通过掩码和加密技术将联邦学习中的数据隐私和安全问题解决,同时通过分布式链式结构提高了数据处理的鲁棒性和容错性,是一个兼具安全性和效率的联邦学习方案。
安全分析
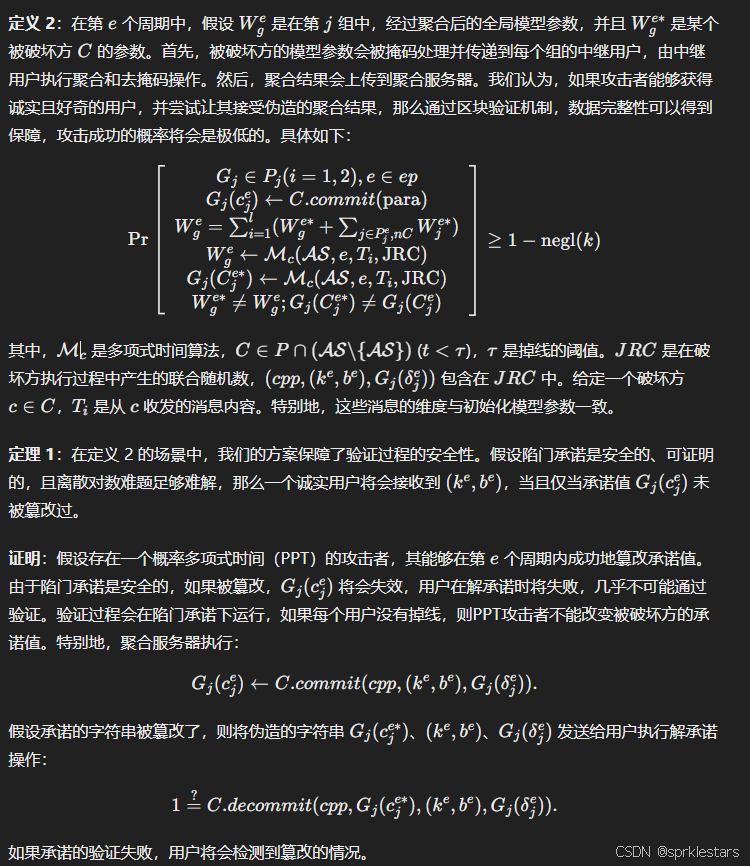
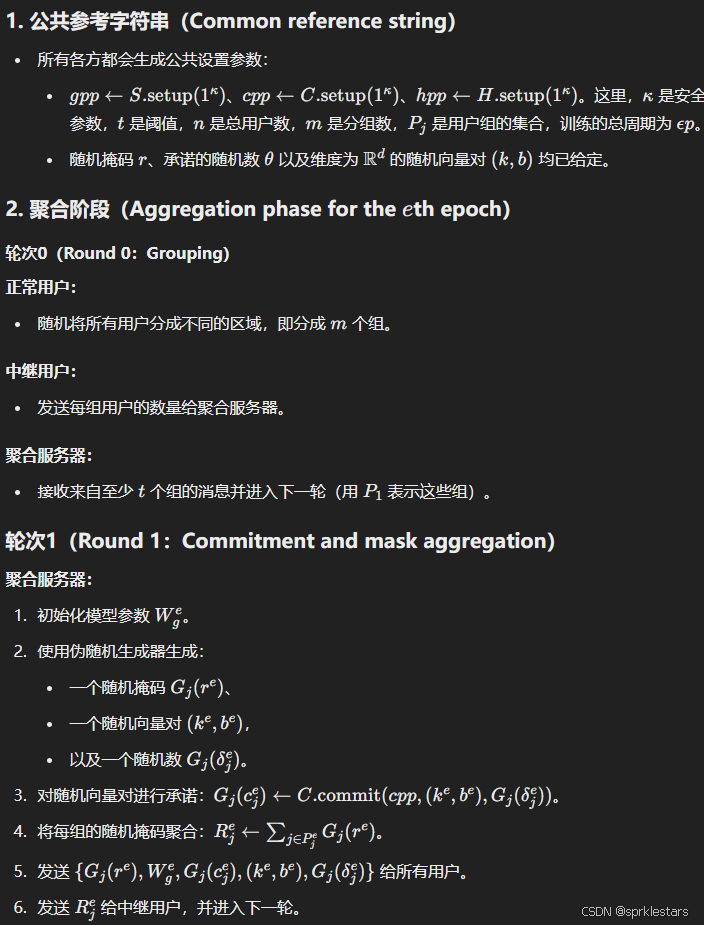
详细流程:
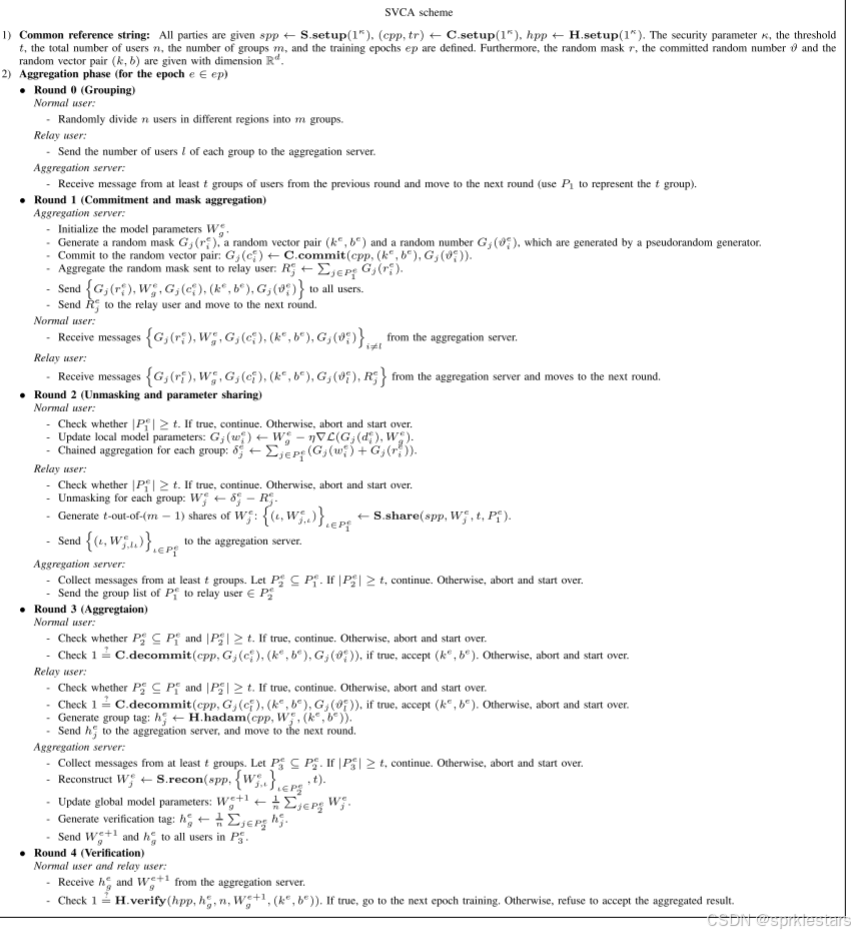
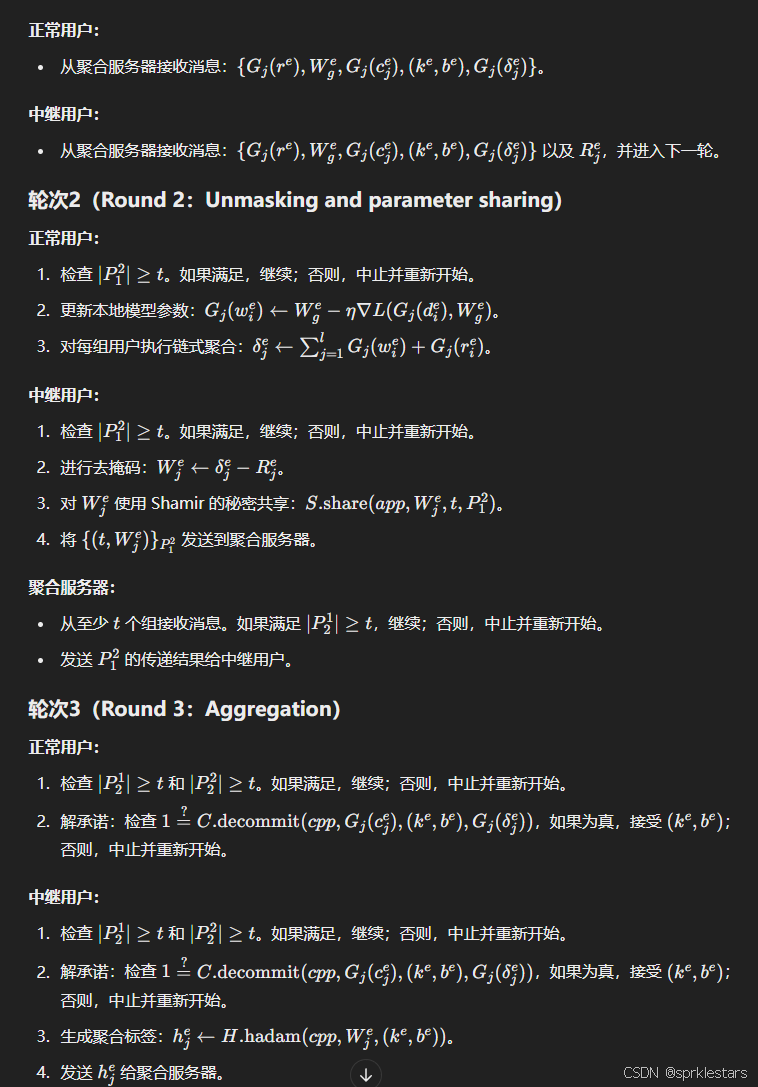
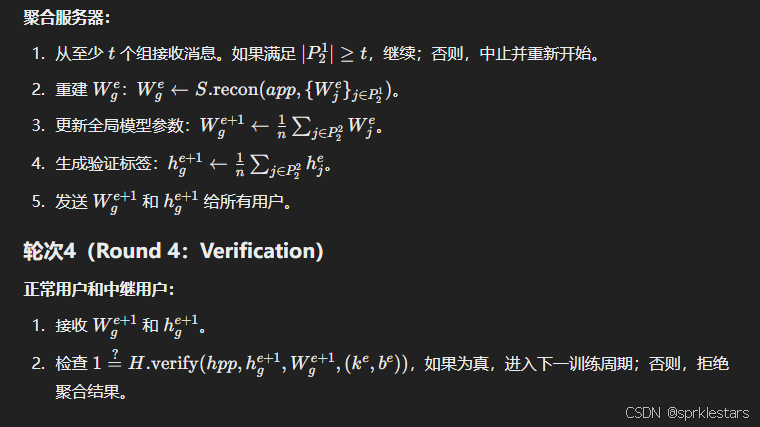
承诺安全性验证
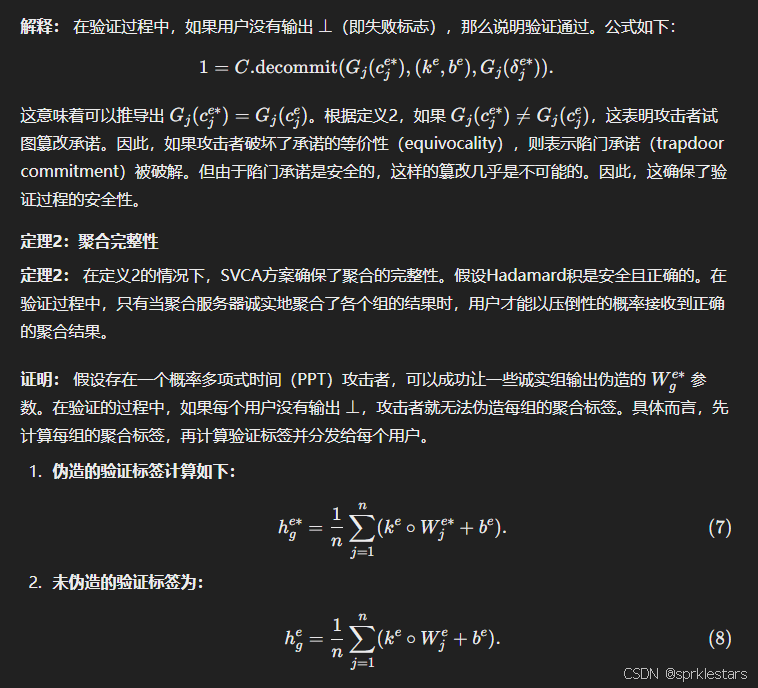
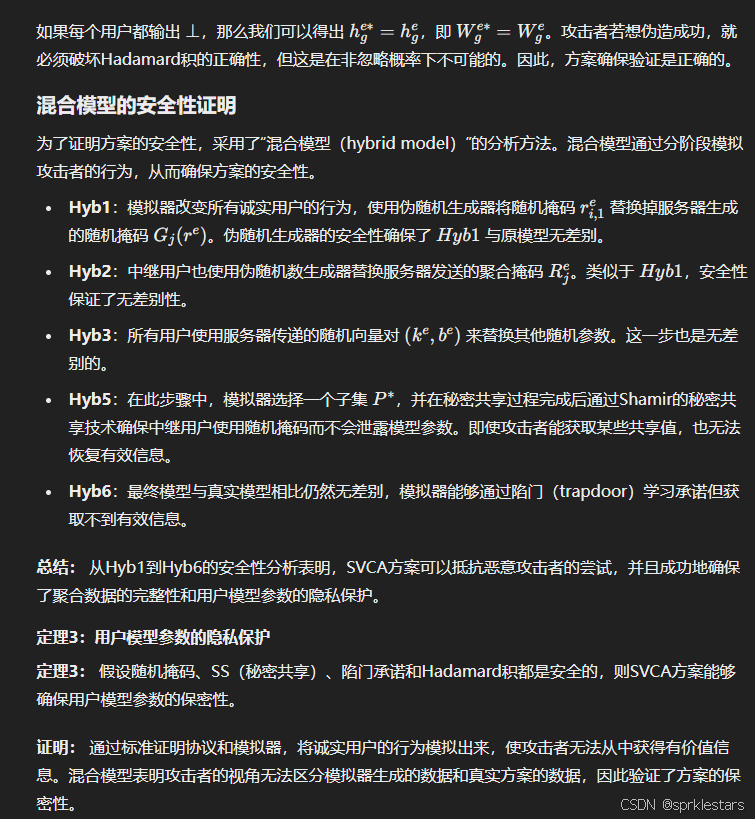
在SVCA方案中,通过承诺、验证和混合模型等机制,确保了数据的完整性和安全性。Hadamard积和随机数的结合保护了数据验证,确保了即使在网络传输和聚合过程中,用户的数据也能保持隐私和正确性。
总结
SVCA方案是一个用于联邦学习中的安全验证和数据聚合方案,旨在确保数据在传输和聚合过程中保持隐私性和完整性。以下是方案的核心流程和概念的简要总结:
- 公共设置和参数生成
所有参与方先进行公共参数的设置,生成安全参数和随机向量对等,确保后续步骤中的数据安全和一致性。 - 数据分组和分发
用户被随机分成不同的组,每个组会选择一个中继用户作为代表,负责组内数据的传递和聚合。
中继用户汇总每组的用户数量并发送给聚合服务器,启动数据聚合流程。 - 承诺和掩码聚合
聚合服务器生成随机掩码和承诺值,并将这些值发送给用户,确保在后续的步骤中数据可以被验证。
用户接收这些数据后,利用承诺机制来保护数据的完整性和隐私性。 - 去掩码和参数共享
用户根据服务器提供的模型参数进行本地训练,并生成新的模型参数,再结合掩码值进行链式聚合。
中继用户负责解除掩码并通过Shamir的秘密共享机制将数据传递给聚合服务器。 - 安全验证和聚合
聚合服务器收集各组传递的数据进行验证,确保数据未被篡改。
服务器通过计算全局模型参数和生成验证标签,并将其发送给用户进行确认。 - 安全验证过程
用户使用承诺值和验证标签来验证聚合结果的正确性。如果验证通过,则进入下一轮的训练,否则拒绝聚合结果。
安全性保障
承诺机制:防止数据在传输过程中被篡改,通过随机数和哈希操作来确保数据的一致性。
秘密共享:确保即使部分用户掉线,聚合服务器也能正确恢复数据,同时保护数据隐私。
验证标签:通过Hadamard积生成的标签,确保聚合结果的真实性,防止服务器篡改或伪造数据。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 28
 0
- 0


 已为社区贡献4条内容

所有评论(0)