【Python机器学习】决策树 机器学习及泰坦尼克号生存预测,线性回归决策树与线性回归对比
·
文章目录
决策树
决策树简介
- 生活中的决策树
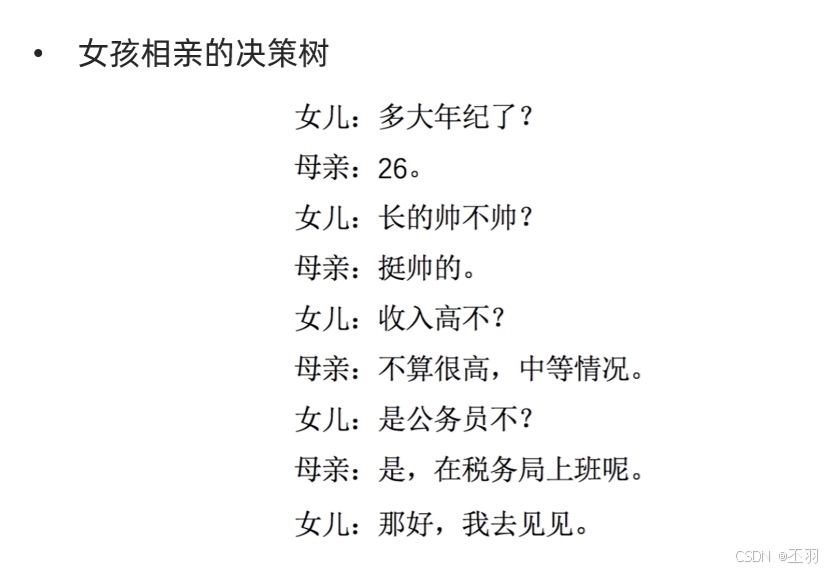
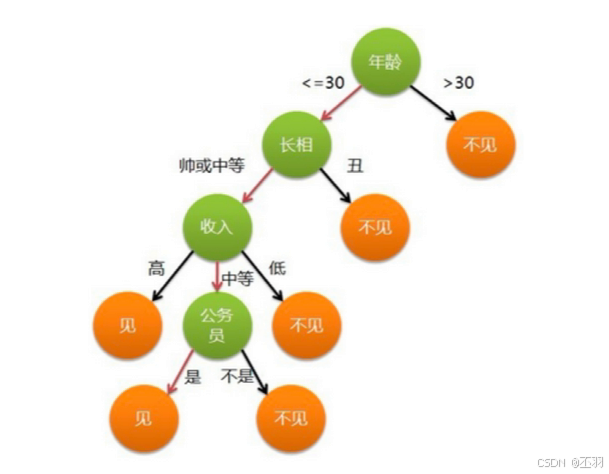
请添加图片描述
-
决策树是一种树形结构
树中每个内部节点表示一个特征上的判断, 每个分支代表一个判断结果的输出,每个叶子节点代表一种分类结果
-
决策树的建立过程
1.特征选择 : 选取有较强分类能力的特征
2.决策树生成: 根据选择的特征生成决策树
3.决策树也容易过拟合,采用剪枝的方法缓解过拟合
ID3决策树
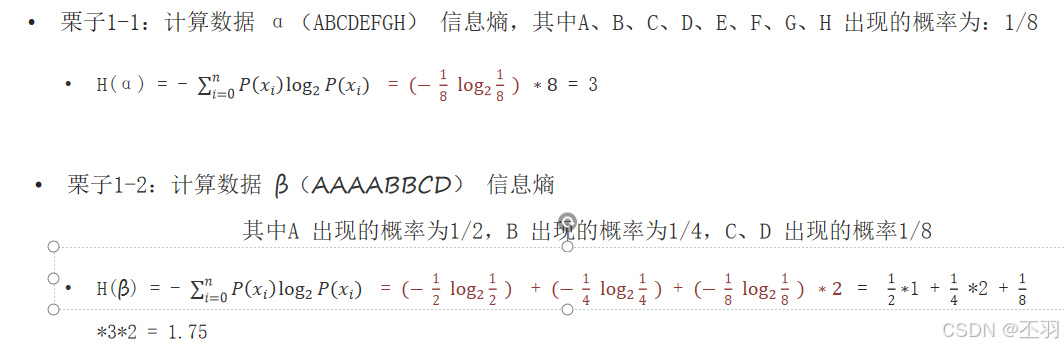
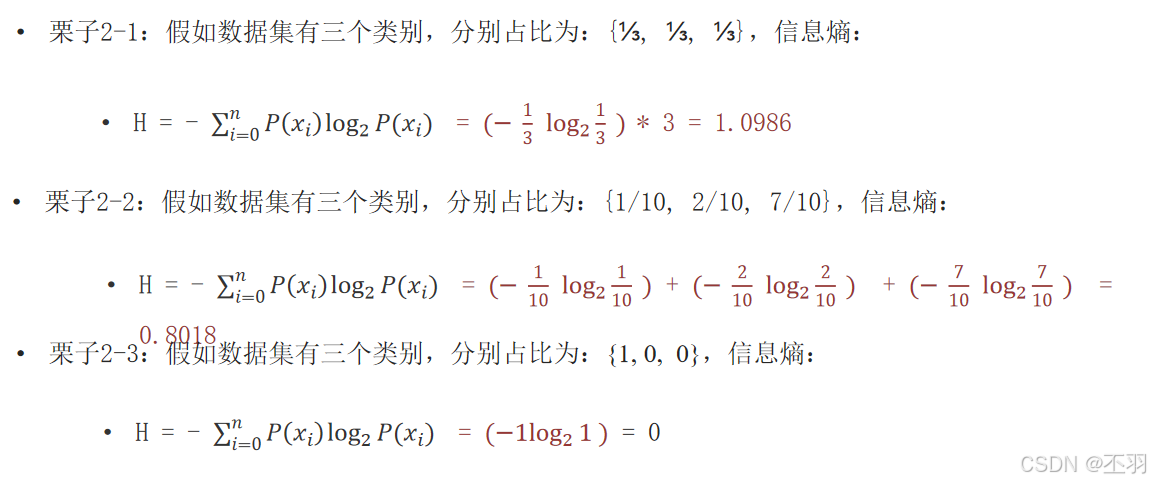
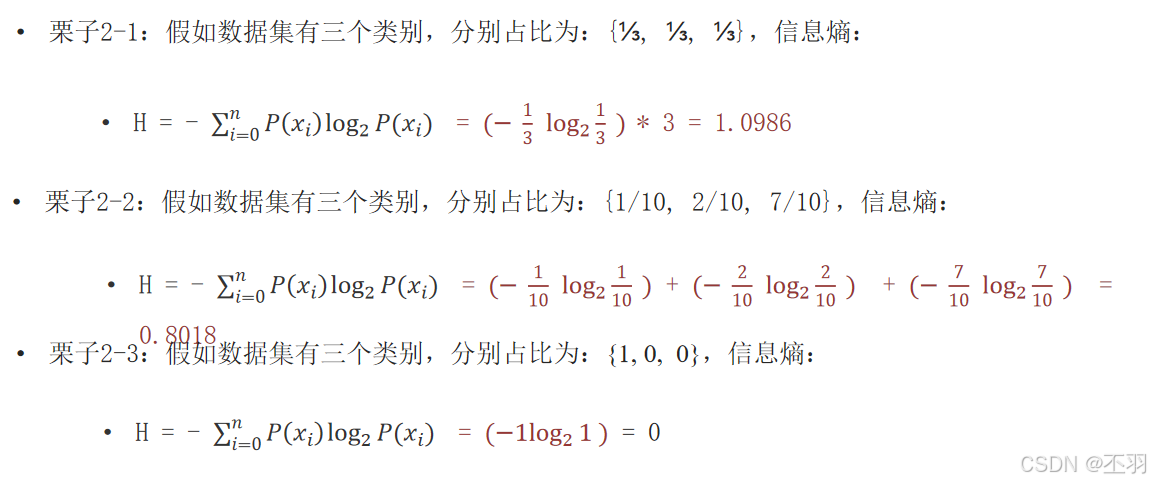
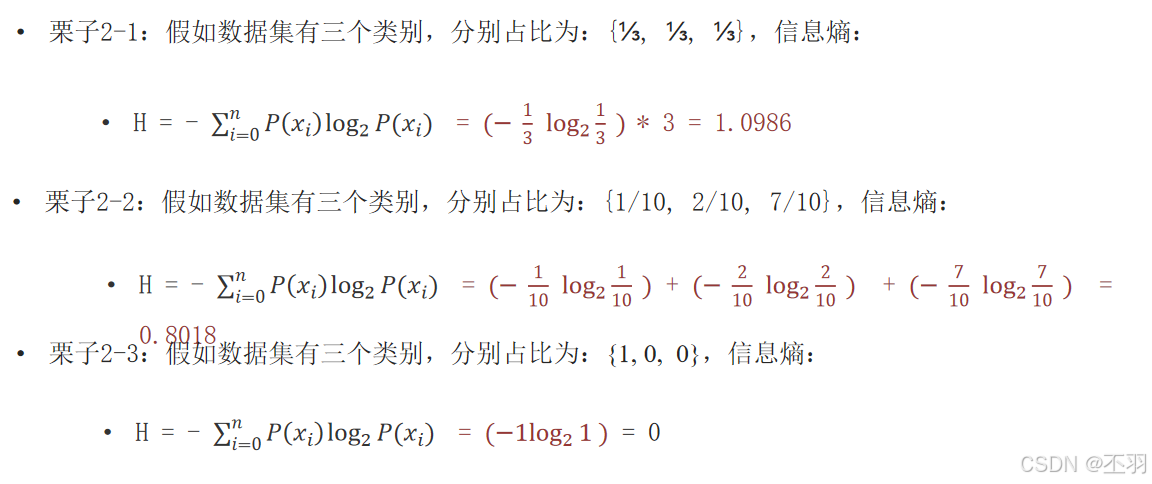
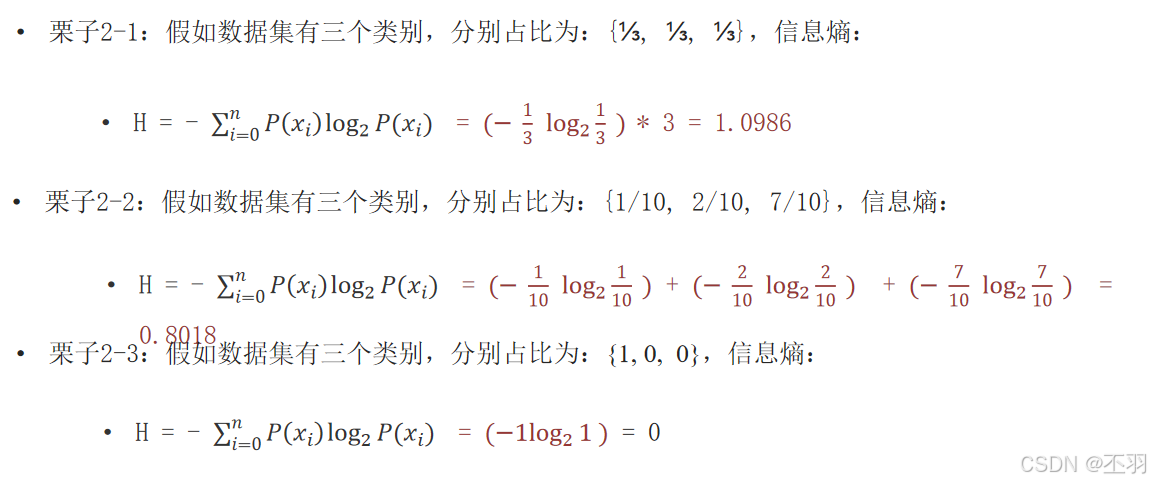
信息熵
- 计算方法
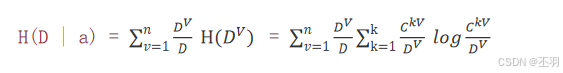
- 例如:

)
信息增益
- 概念:
特征a对训练数据集D的信息增益𝐺𝑎𝑖𝑛(𝐷, 𝑎)或g(D,a),定义为集合D的熵H(D)与特征a给定条件下D的熵H(D | a)之差。
- 数学公式:
𝐺𝑎𝑖𝑛(𝐷, 𝑎) = H(D)-H(D | a) 信息增益 = 熵 - 条件熵
- 条件熵:
- 例如
ID3决策树构建流程
1.计算每个特征的信息增益
2,使用信息增益最大的特征将数据集 拆分为子集
3.使用该特征 (信息增益最大的特征)作为决策树的一个节点
4.使用剩余特征对子集重复上述(1,2,3)过程
ID3决策树的不足
偏向于选择种类多的特征作为分裂依据
C4.5决策树
信息增益率
- 信息增益率 = 信息增益 /特征熵
- 计算方法
- 信息增益率的本质
- 特征的信息增益 ➗ 特征的内在信息
- 相当于对信息增益进行修正,增加一个惩罚系数
- 特征取值个数较多时,惩罚系数较小;特征取值个数较少时,惩罚系数较大。
- 惩罚系数:数据集D以特征a作为随机变量的熵的倒数
- 例如:
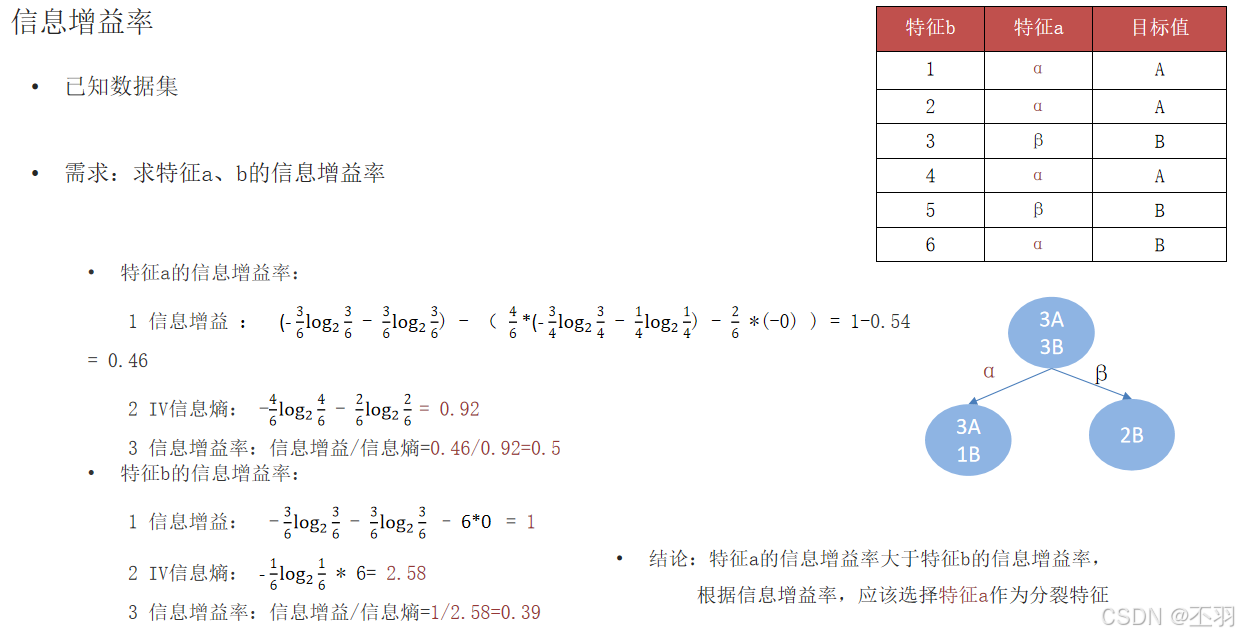
信息增益率的作用:
- 信息增益偏向于选择种类多的特征作为分裂依据
- 缓解ID3树中存在的不足
CART决策树
Cart模型是一种决策树模型,它即可以用于分类,也可以用于回归。
Cart回归树使用平方误差最小化策略,
Cart分类生成树采用的基尼指数最小化策略。
基尼值和基尼指数:
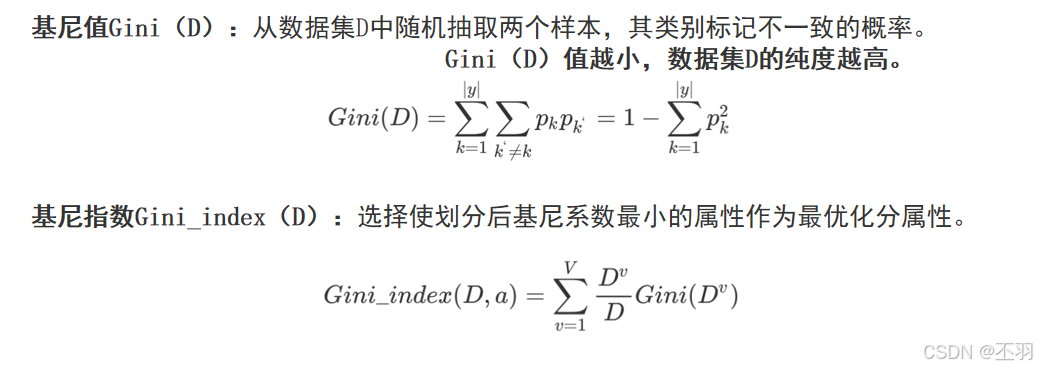
注意:
1.信息增益(ID3)、信息增益率值越大(C4.5),则说明优先选择该特征。
2.基尼指数值越小(CART),则说明优先选择该特征。
CART分类树
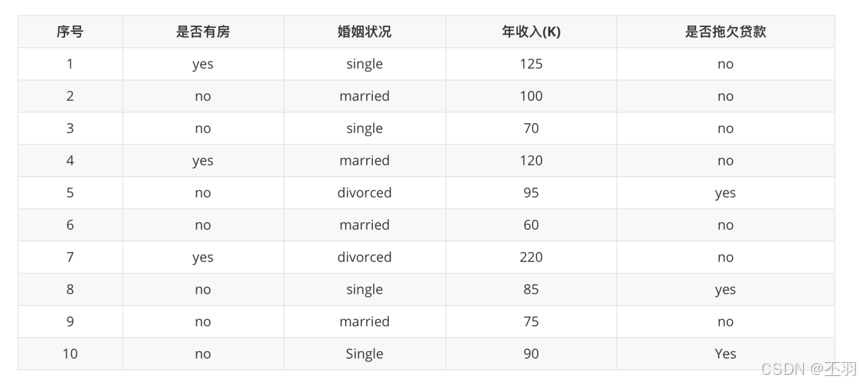
- 已知:是否拖欠贷款数据。
- 需求:计算各特征的基尼指数,选择最优分裂点
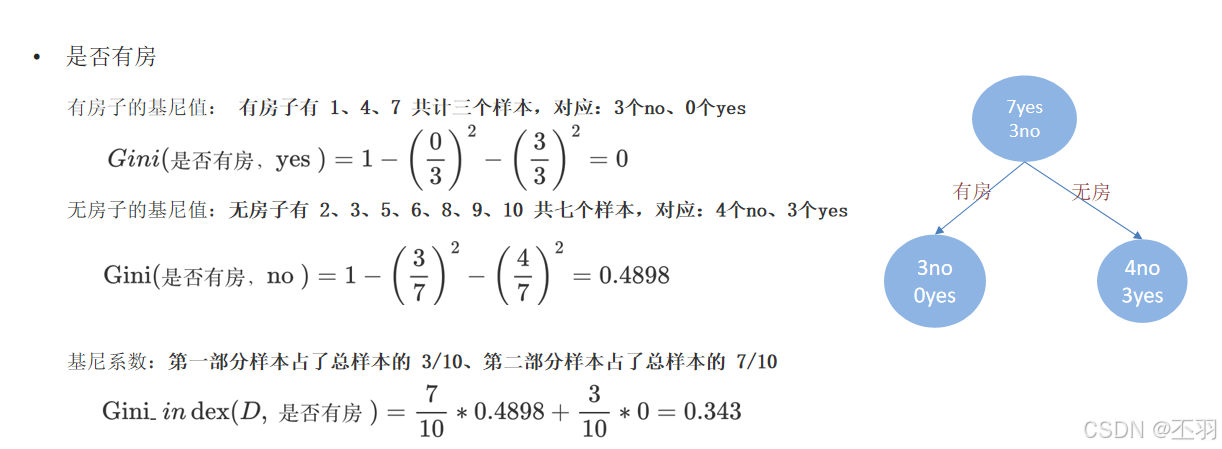
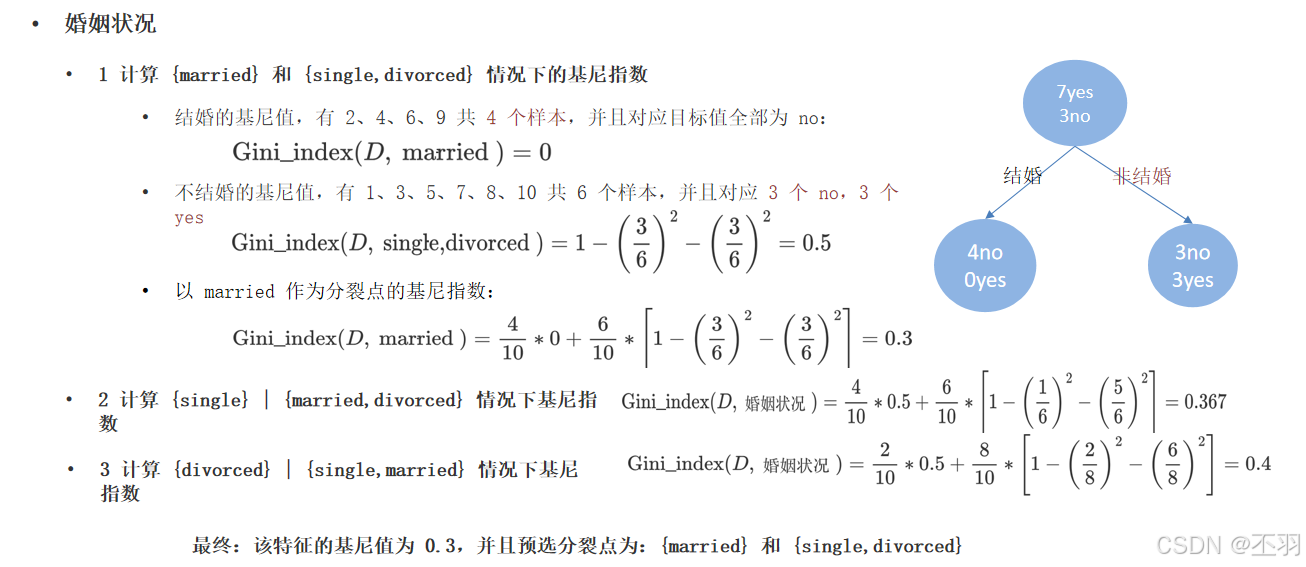
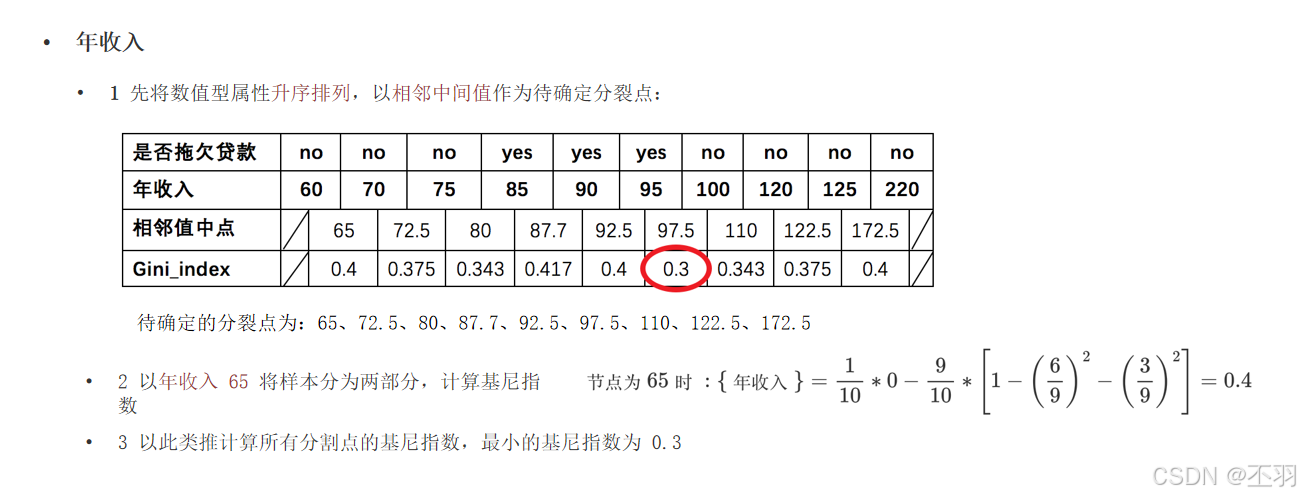
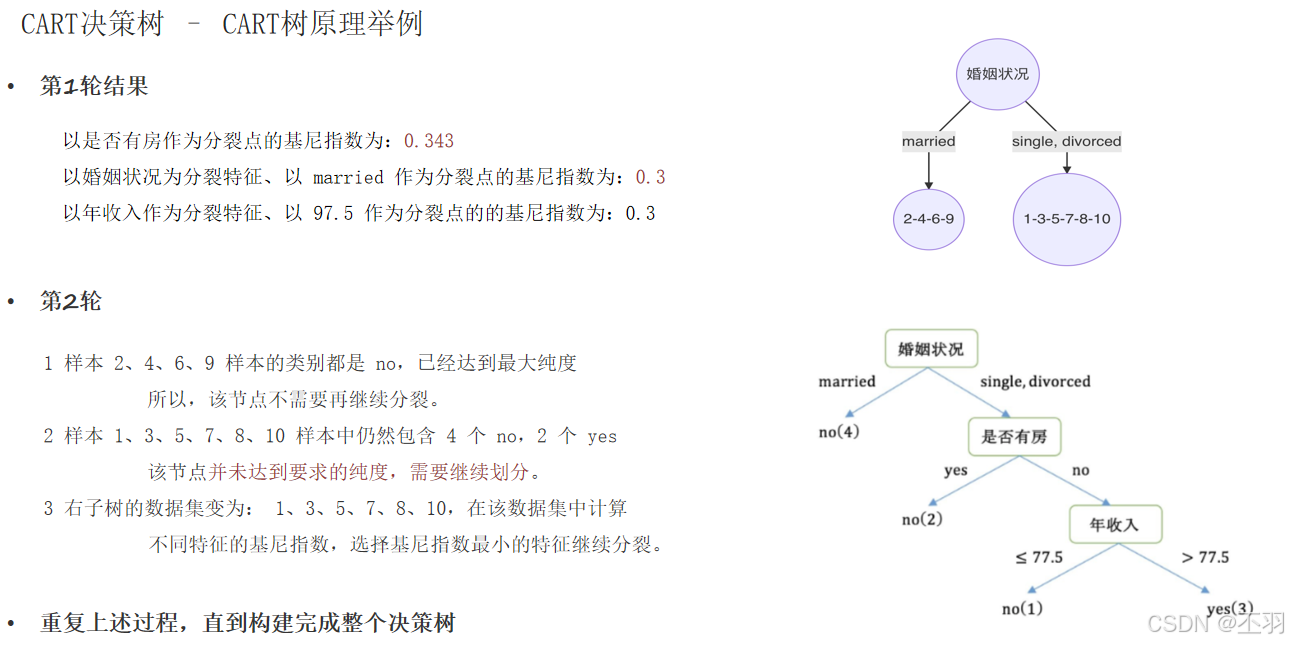
三种分类树的对比:
| 名称 | 提出时间 | 分支方式 | 特点 |
|---|---|---|---|
| ID3 | 1975 | 信息增益 | 1.ID3只能对离散属性的数据集构成决策树2.倾向于选择取值较多的属性 |
| C4.5 | 1993 | 信息增益率 | 1.缓解了ID3分支过程中总喜欢偏向选择值较多的属性2.可处理连续数值型属性,也增加了对缺失值的处理方法3.只适合于能够驻留于内存的数据集,大数据集无能为力 |
| CART | 1984 | 基尼指数 | 1.可以进行分类和回归,可处理离散属性,也可以处理连续属性2.采用基尼指数,计算量减小3.一定是二叉树 |
泰坦尼克号生存预测
决策树API介绍
class sklearn.tree.DecisionTreeClassifier(criterion=’gini’,max_depth=None,random_state=None
- Criterion: 特征选择标准 “gini"或"entropy”,前者代表基尼系数,后者代表信息增益。默认"gini",即CART算法
- min_samples_split:内部节点再划分所需最小样本数
- min_samples_leaf:叶子节点最少样本数
- max_depth:决策树最大深度
案例背景和数据情况
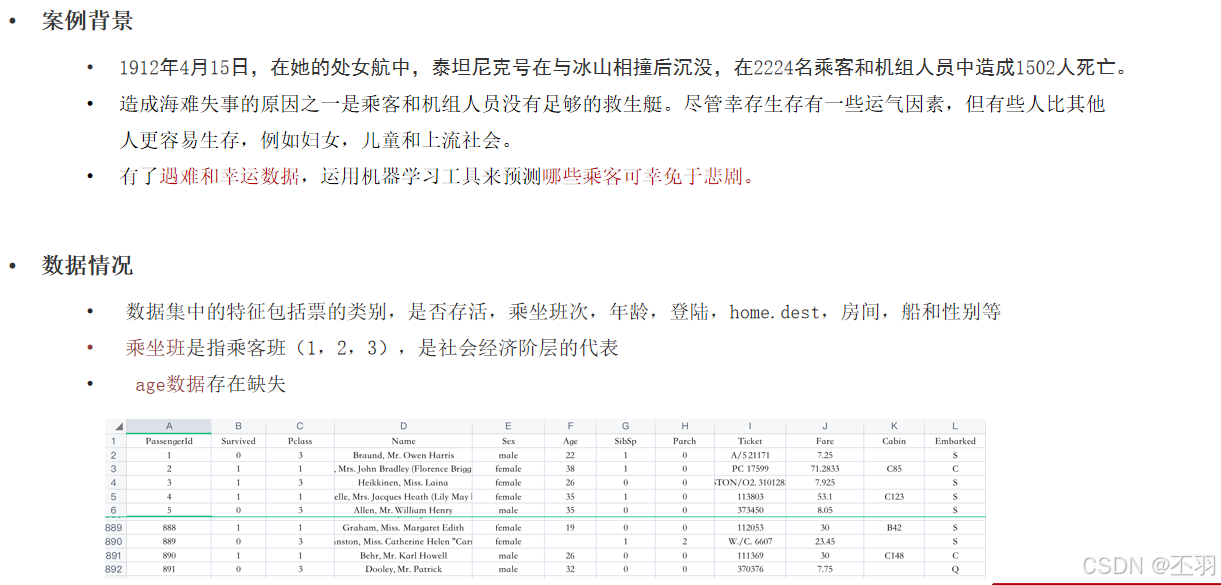
代码实现
导包
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import classification_report, precision_score, recall_score, f1_score, roc_auc_score
import matplotlib.pyplot as plt
from sklearn.tree import plot_tree
主体代码
def demo01():
    # 读取数据集
    t_df = pd.read_csv('../data/titanic_train.csv')
    print(t_df.head())
    print(t_df.info())
    # 数据处理
    x = t_df[['Pclass', 'Age', 'Sex']]  # 特征值
    y = t_df['Survived']  # 标签值
    # 缺失值处理
    x['Age'].fillna(x['Age'].mean(), inplace=True)
    x = pd.get_dummies(x)  # pclass 类别型数据 和sex 中文类型热编码
    # 数据集划分
    x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=21)

    # 模型训练
    # 获取决策树训练对象
    estimator = DecisionTreeClassifier()
    estimator.fit(x_train, y_train)

    # 模型预测
    y_predict = estimator.predict(x_test)

    # 模型评估
    print('准确率:', estimator.score(x_test, y_test))
    print('精确率:', precision_score(y_test, y_predict))
    print('召回率:', recall_score(y_test, y_predict))
    print('F1-score:', f1_score(y_test, y_predict))
    print('AUC:', roc_auc_score(y_test, y_predict))
    print(classification_report( y_predict,y_test,target_names=['died','survived']))

    # 数据可视化
    plt.figure(figsize=(50,50))
    plot_tree(estimator,max_depth=10,
              filled=True,
              feature_names=['Pclass', 'Age', 'Sex_female','Sex_male'],
              class_names=['died','survived']
              ,fontsize=8)
    plt.show()

if __name__ == '__main__':
    demo01()
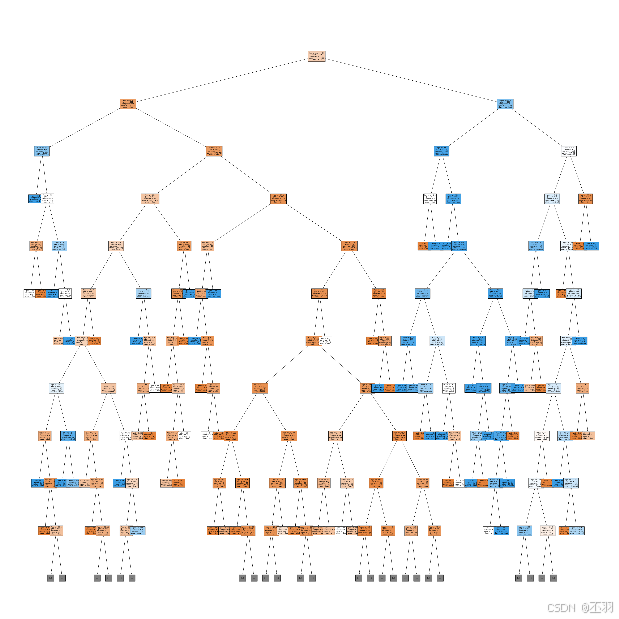
数据可视化结果:
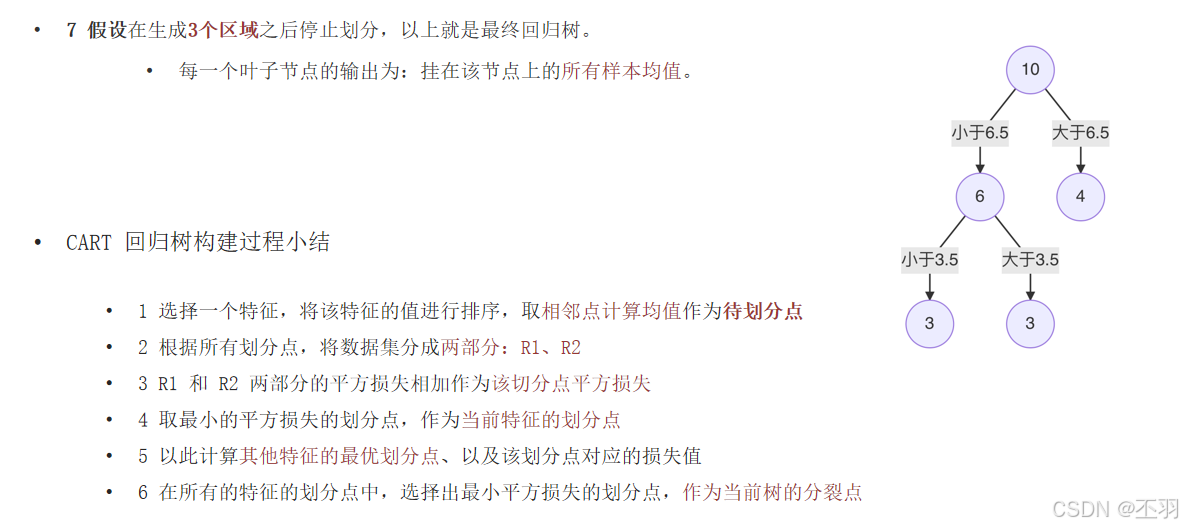
CART回归树
-
CART 回归树和 CART 分类树的不同之处
- CART 分类树预测输出的是一个离散值,CART 回归树预测输出的是一个连续值
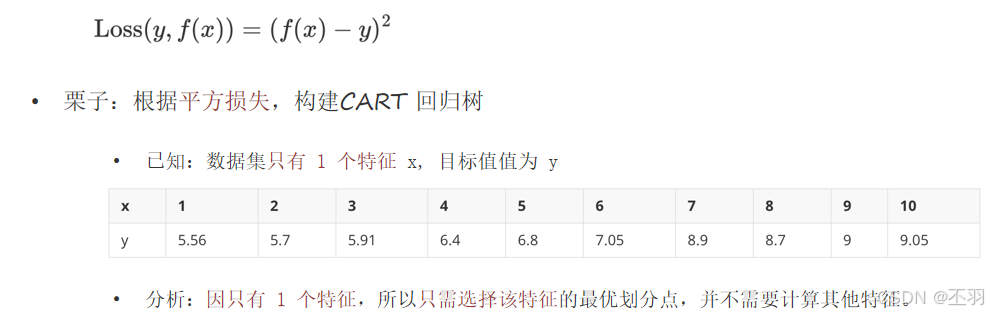
- CART 分类树使用基尼指数作为划分、构建树的依据,CART 回归树使用平方损失
- 分类树使用叶子节点多数类别作为预测类别,回归树则采用叶子节点里均值作为预测输出
-
CART 回归树的平方损失
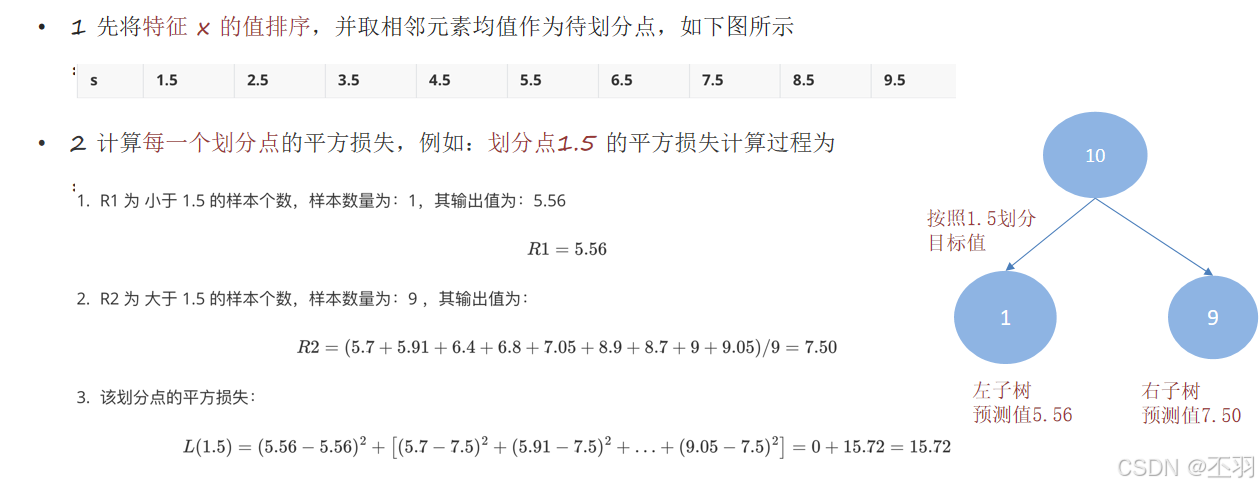
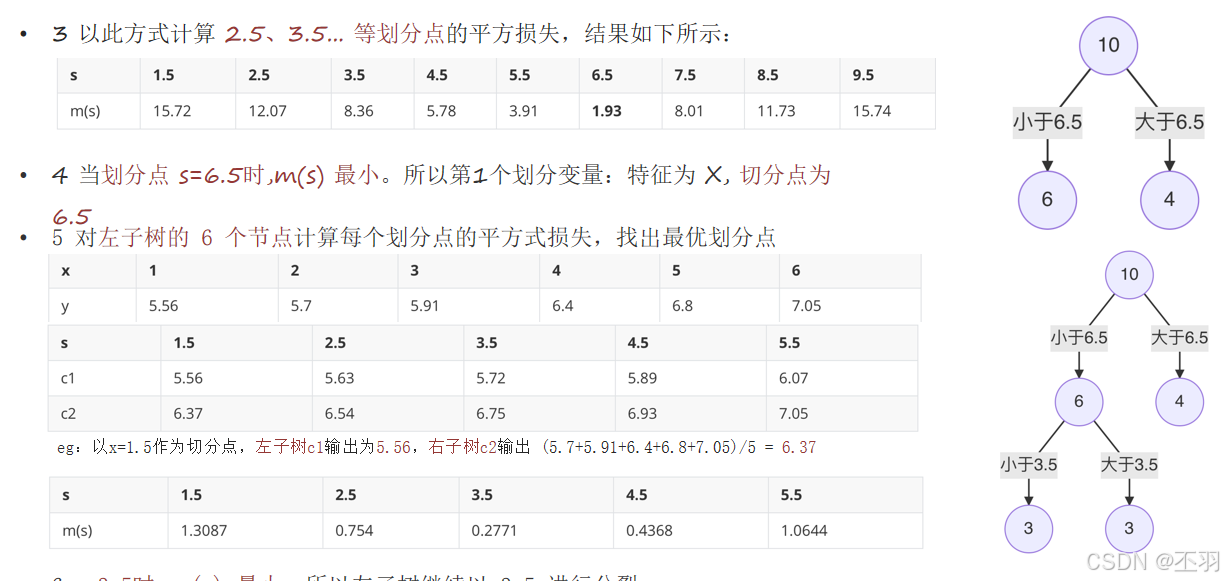
实现方式
案例 - 线性回归决策树与回归决策树对比
需求
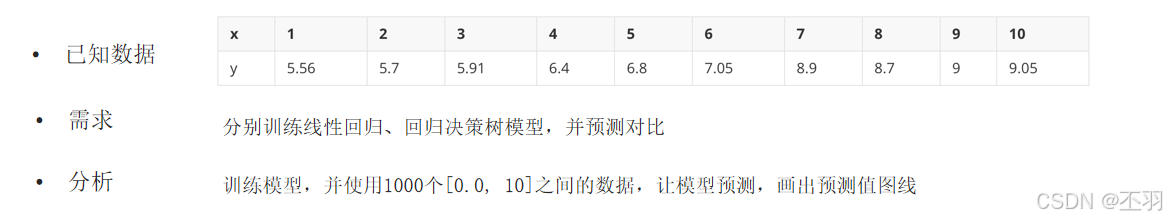
代码:
import numpy as np
import pandas as pd
from sklearn.tree import DecisionTreeClassifier, DecisionTreeRegressor
from sklearn.linear_model import LinearRegression
import matplotlib.pyplot as plt


def demo1():
    # 准备数据
    x = np.array(list(range(1, 11))).reshape(-1, 1)  # reshape 重塑 行 列
    y = np.array([5.56, 5.70, 5.91, 6.40, 6.80, 7.05, 8.90, 8.70, 9.00, 9.05])

    # 模型训练
    model1 = DecisionTreeRegressor(max_depth=1)
    model2 = DecisionTreeRegressor(max_depth=2)
    model3 = DecisionTreeRegressor(max_depth=3)
    model4 = LinearRegression()

    # 模型训练
    model1.fit(x, y)
    model2.fit(x, y)
    model3.fit(x, y)
    model4.fit(x, y)

    # 模型预测
    x_test = np.arange(0.0, 10.0, 0.01).reshape(-1, 1)
    y_predict1 = model1.predict(x_test)
    y_predict2 = model2.predict(x_test)
    y_predict3 = model3.predict(x_test)
    y_predict4 = model4.predict(x_test)
    print(y_predict1, y_predict2, y_predict3, y_predict4)

    # 数据可视化
    plt.figure(figsize=(10, 6), dpi=100)
    # x y 散点图
    plt.scatter(x, y)
    # 预测值
    plt.plot(x_test, y_predict1, label='max_depth=1')
    plt.plot(x_test, y_predict2, label='max_depth=2')
    plt.plot(x_test, y_predict3, label='max_depth=3')
    plt.plot(x_test, y_predict4, label='LinearRegression')

    plt.xlabel('data')
    plt.ylabel('target')

    plt.title('DecisionTreeClassifier')
    plt.legend()  # 图例
    plt.show()


if __name__ == '__main__':
    demo1()
运行结果
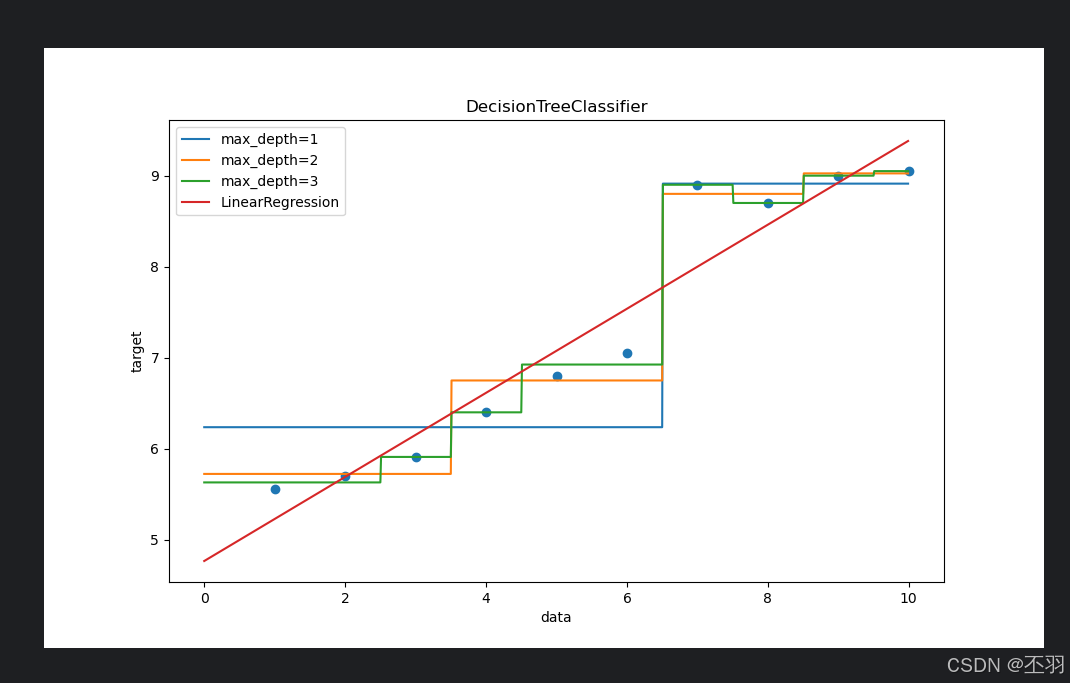
从预测效果来看:
1、线性回归是一条直线
2、决策树是曲线
3、树的拟合能力是很强的,易过拟合
决策树剪枝
- 决策树剪枝是一种防止决策树过拟合的一种正则化方法;提高其泛化能力。
- 把子树的节点全部删掉,使用用叶子节点来替换
- 剪枝方法
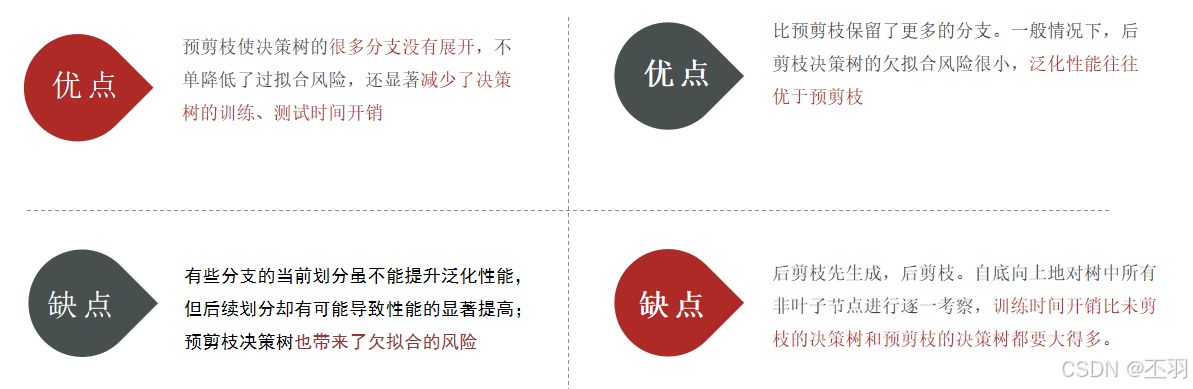
- 预剪枝:指在决策树生成过程中,对每个节点在划分前先进行估计,若当前节点的划分不能带来决策树泛化性能提升,则停止划分并将当前节点标记为叶节点;
- 后剪枝:是先从训练集生成一棵完整的决策树,然后自底向上地对非叶节点进行考察,若将该节点对应的子树替换为叶节点能带来决策树泛化性能提升,则将该子树替换为叶节点。
剪枝原理
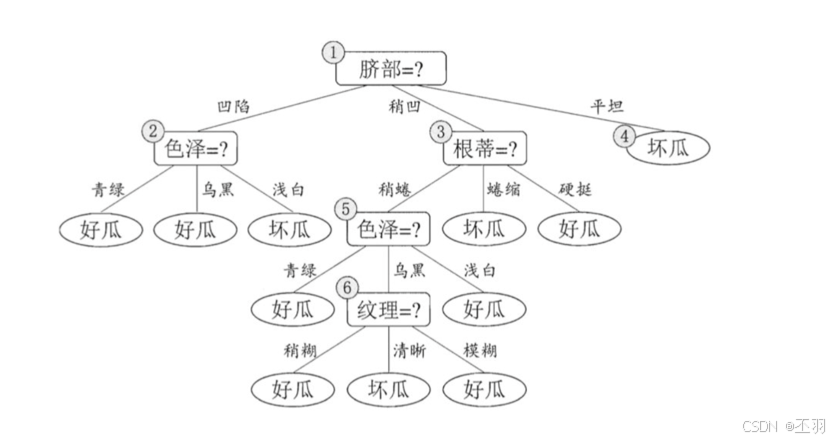
预剪枝
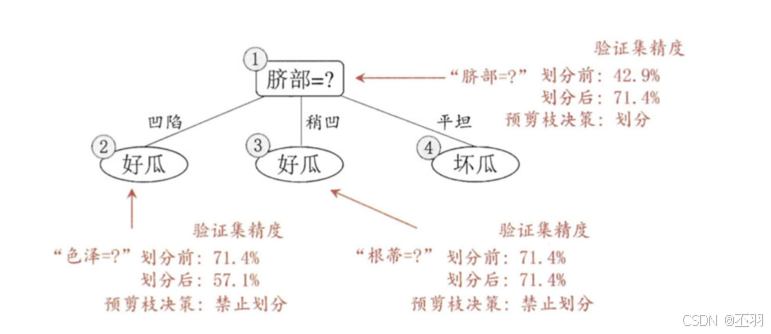
基于预剪枝策略从上表数据所生成的决策树如上图所示,其验证集精度为 71.4%.
后剪枝
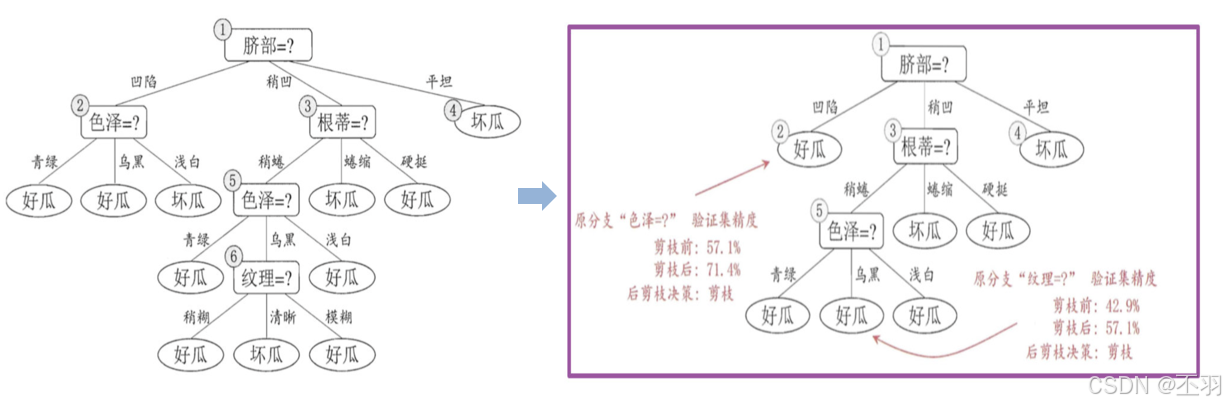
先利用训练集完整的生成一颗树,有6个内部节点。分别考察这些节点作为叶子节点模型的准确率,若准确率上升,则剪掉,否则保留。
剪枝方式对比

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 35
 0
- 0


 已为社区贡献5条内容

所有评论(0)