【AI大模型】面试题集锦
·
一、基础
1. 为什么Transformer中使用K、V的缓存?
因为减少token生成的矩阵运算, 比如预测第100个token,模型需要先处理前99个token的信息,对这些信息进行矩阵运算,而进行矩阵运算是非常耗时的,所以KV缓存就是为了减少这种矩阵运算,在推理过程中,会把键和值放到KV缓存中,这样模型在后续生成token的时候,直接访问缓存
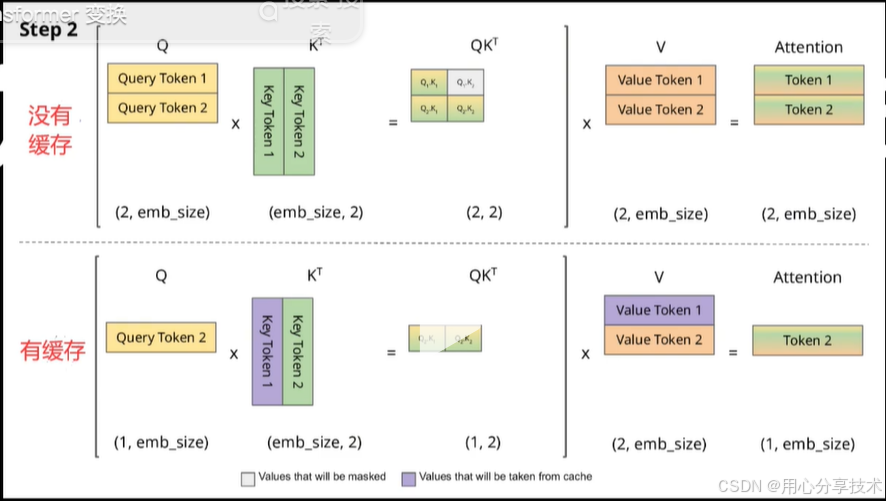
2. Transformer如何通过K、V减少token生成的矩阵运算?
- 没有缓存: 每次计算一个token,都需要重新计算之前的token, 才能进行最新的token的计算
- 有缓存: 只需要计算最新的token, 再与之前缓存好的KV的结果拼接成大矩阵就行,即计算量减少了一半,减少self attention的计算量,从序列长度的二次方变成了线性
3. 在解码过程中,一个典型带有K、V cache大模型的推理过程,包含哪些阶段?
- prefill:会输入一个prompt序列,为每个transformer层生成KV缓存,同时输出第一个token
- decoding:发生在计算第二个token到最后一个token的过程中,这时候cache是有值的,每轮推理都需要读取cache即可,同时将当前轮计算新的key和value追加写入cache即可,这样FLops降低,gemm操作变成了gemv操作,推理阶段相比于第一阶段更快
4. 一般使用KV cache的缓存一般会用什么数据类型来存储这个张量?
- float16
- bfloat16
5. 如果算这个KV缓存,一般要消耗多少显存?
- KV缓存会为每一层和每个注意力头存储一对KV张量,总显存公式: 层数 * KV注意力头数量 * 注意力头维度 * (位宽/8) * 2
- 2代表有两组张量,也就是键和值,然后位宽通常是16位,8位一个字节,所以除以8
6. 使用KV缓存有什么缺点?
- KV缓存在超长文本和复杂模型的场景会成为下一个瓶颈,Llama 3 8B模型,一个token占用131,072字节=0.1M, 若全部Context,则大小是8192个token存储KV张量,差不多占用1.1G的显存,如果24GB显存的消费级GPU,差不多缓存站到4.5%,如果模型更大更复杂,那么KV缓存增长会更快Llama 70B,它有80层,公式算出来就占用0.3M,对于8191个token,缓存会占用2.7G, 比如batch size=32的Llama 3 8B缓存,大概需要35.2G的GPU显存,这时候一块消费级GPU就cover不住了
7. 如何解决超长文本和复杂模型的场景?
- 量化KV缓存,比如计算KV精度,比如从64bit降低到4bit, 比如16位张量降低为原来的1/4, 通过2位量化,降低到原来的1/8, 理论上4 bit量化可以KV缓存大小从35.2G打到8.8G,使用2bit量化可以打到4.4GB,当然还取决于其他因素,比如算法、超参、group大小
8. 实际项目会有哪些量化策略?会有什么问题?怎么规避?
- HQQ量化, 4bit量化使用预计可以减少到2到3倍
- 块状量化,实现一个接近三倍的减少
- 会出现的问题: 减慢解码的过程,影响到大语言模型的准确性
- 怎么规避: 调整量化超参,重写量化算子,对量化操作,反量化操作与其他算子做一些融合,来提高降低解码速度的影响
9. KV缓存可以应用的新的工作或者Paper?
- 比如 KV缓存复用从层内复用跨越到层间复用,微软发的论文,提出了YOCO(You only cache once),即层间共享的新思路
- MIT-IBM AI LAB也发了一篇类似的论文,提出了CLA(Cross Layer Attention),即KV缓存的层间共享,将上下文长度扩展到1百万,最常见KV缓存共享策略是MQA/GQA, 从Layer视野来看MQA/GPA是层间KV缓存共享,而YOCO提出的想法可以看做是Intel-Layer层间的KV缓存共享,这个算法理论上最多可以把KV缓存的Memory需求降低到1/N, (N为Transformer的层数),并且与层间KV缓存共享不冲突,可以两者结合使用

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 22
 0
- 0


 已为社区贡献5条内容

所有评论(0)