大模型应用开发(二):RAG实战教程,基于LangChain+Faiss+千问的本地知识库问答简单模式,一看就会
概要
今天这个文章主要写的就是使用langchain+千问+faiss,生成一个本地的知识库,我这边用的是百度百科的两段文字分别介绍的就是英雄联盟盲僧和艾克的技能介绍。
整体架构流程
首先需要安装Faiss向量数据库,然后通过langchain根据指定内容进行文档切片,通过faiss转换成向量数据存入向量数据库保存在磁盘上,使用的是text-embedding-v1文本嵌入模型,至此知识库建立完毕。
其次通过加载本地向量数据库,创建检索器,进行相似度检索,查询相关信息。
安装
pip install langchain langchain_community dashscope faiss-cpu unstructured unstructured[doc] unstructured[pdf]
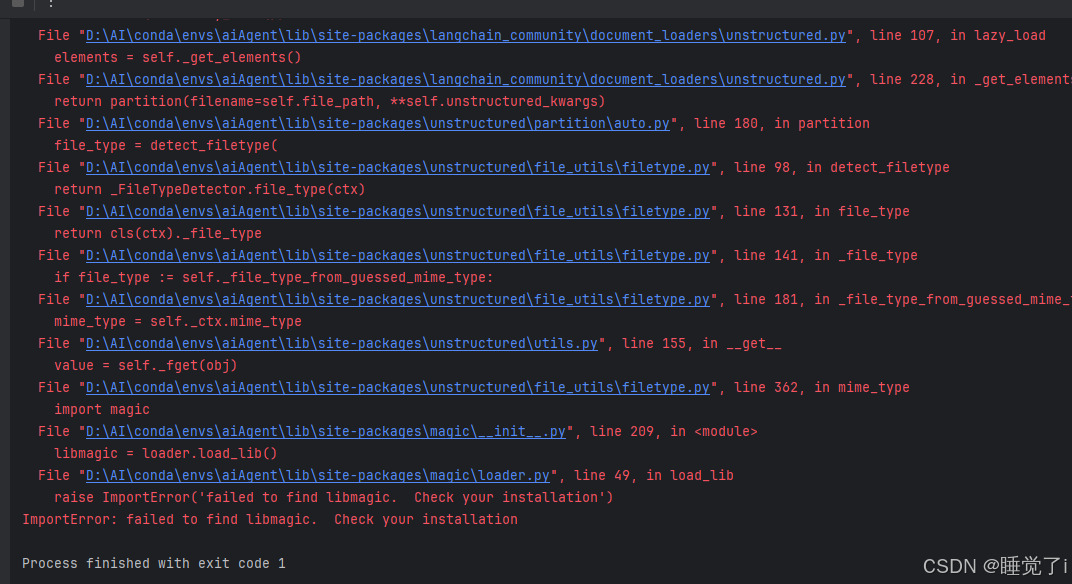
报错内容
安装这里有三个unstructured,具体是因为可能会出现报错,所以三个都加上去了,安装完成之后运行代码可能会出现报错,下面两个图所示,都有可能出现AttributeError: module 'magic' has no attribute 'from_file'和failed to find libmagic. Check your installation
解决方案:咱们把这两个包直接卸载即可。
pip uninstall python-magic
pip uninstall install python-magic-bin==0.4.14

技术细节
代码
主要就是把文档存放到data_path位置,遍历查询生成documents文档,
最重要的一步就是 将文档数据拆分为chunk大小,chunk_size=500表示每个文本块的最大字符数为500,chunk_overlap=50表示每个块之间有50个字符的重叠部分,以确保信息的连续性,这样做的目的就是可以增强上下文理解,处理长文档,可以改善检索性能,提高处理效率。
# 将文档数据拆分为 chunk 的大小
text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
all_splits = text_splitter.split_documents(documents)
随后就是通过文本嵌入模型text-embedding-v1将文档转换成想来数据库保存到磁盘
# 文本嵌入模型
embeddings = DashScopeEmbeddings(
    model="text-embedding-v1"
)

# 将文本编码为向量,并保存为向量
# normalize_L2=True表示向量进行L2归一化 是一种检索方式
vectorstore = FAISS.from_documents(
    documents=all_splits,
    embedding=embeddings,
    normalize_L2=True,
)
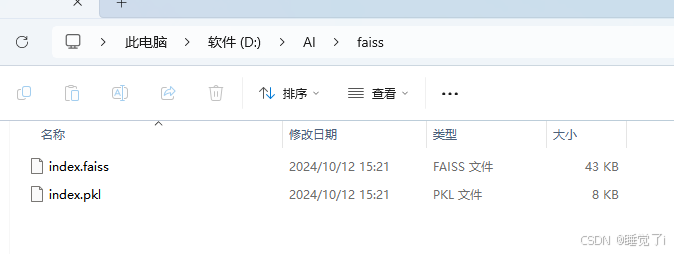
vectorstore.save_local(f"D:/AI/faiss")
完整代码
#把文档输入faiss向量库,保存在d:/faiss

import os
# 导入向量数据库(向量存储、查询)
from langchain_community.vectorstores import FAISS
# 导入langchain 文本拆分器
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.document_loaders import UnstructuredFileLoader

# 文档存放位置
data_path = f"D:/AI/doc"

documents = []
# 指定要处理的文件类型
file_types = ('.pdf', '.docx')

# 处理文件  遍历目录 加载文件 最后扩展文档列表拿到documents
for filename in os.listdir(data_path):
    if filename.endswith(file_types):  # 如果你想加载其他类型的文件,可以修改此处
        file_path = os.path.join(data_path, filename)
        loader = UnstructuredFileLoader(file_path)
        docs = loader.load()
        documents.extend(docs)


# 将文档数据拆分为 chunk 的大小
text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
all_splits = text_splitter.split_documents(documents)

# 千问api
os.environ["DASHSCOPE_API_KEY"] = "sk-xxxx"

# 文本嵌入模型
embeddings = DashScopeEmbeddings(
    model="text-embedding-v1"
)

# 将文本编码为向量,并保存为向量
# normalize_L2=True表示向量进行L2归一化 是一种检索方式
vectorstore = FAISS.from_documents(
    documents=all_splits,
    embedding=embeddings,
    normalize_L2=True,
)
vectorstore.save_local(f"D:/AI/faiss")
运行成功会在磁盘生成faiss文件
接下来就是查询了
需要使用相同的文本嵌入模型,然后加载本地向量数据,给他创建索引器,通过提示词,让大模型去查找出对于的知识库信息
    embeddings = DashScopeEmbeddings(model="text-embedding-v1")

        vectorstore = FAISS.load_local(f"D:/AI/faiss", embeddings, allow_dangerous_deserialization=True)
        # 创建检索器
        retriever = vectorstore.as_retriever()

        template = """以context为基础回答问题:
          {context}

          Question: {question}
          """
贴出完整代码
import os
from langchain_community.vectorstores import FAISS
from langchain_community.llms import Tongyi
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableParallel, RunnablePassthrough
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_core.prompts import ChatPromptTemplate

os.environ["DASHSCOPE_API_KEY"] = "sk-xxx"


class FaissWord:
    def faissTest(query: str = ""):
        embeddings = DashScopeEmbeddings(model="text-embedding-v1")

        vectorstore = FAISS.load_local(f"D:/AI/faiss", embeddings, allow_dangerous_deserialization=True)
        # 创建检索器
        retriever = vectorstore.as_retriever()

        template = """以context为基础回答问题:
          {context}

          Question: {question}
          """
        prompt = ChatPromptTemplate.from_template(template)

        model = Tongyi(model_name="qwen2-57b-a14b-instruct")

        chain = (
                RunnableParallel({"context": retriever, "question": RunnablePassthrough()})
                | prompt
                | model
                | StrOutputParser()
        )

        vector_answer = chain.invoke(query)

        return vector_answer


if __name__ == "__main__":
    print("------" + FaissWord.faissTest("艾克技能简介") + "------")
运行成功
D:\AI\conda\envs\aiAgent\python.exe D:\Pycharm\aiAgent\pythonProject\llm\knowledge_base\knowledgeTest_0918.py
------艾克是一位拥有独特时间操控能力的英雄,其技能如下:

- **被动技能:Z型驱动共振**
  艾克的技能和普通攻击会充盈着时光能量。第三次命中同一个目标时,会造成额外伤害;如果目标是英雄,则艾克还会获得移动加速效果。

- **Q技能:时间卷曲器**
  艾克投掷一个时光手雷,命中敌方英雄后会扩展成一个减速力场,并在延迟后返回给艾克,对往返路径上的敌人造成两次魔法伤害。具体数值随技能等级提升而增加。

- **W技能:时光交错**
  艾克创造一个时间场,在短暂延迟后会对敌人产生减速效果。若艾克进入该时间场,会触发爆炸,使周围敌人晕眩并为自己提供护盾。

- **E技能:相位俯冲**
  艾克向前位移,并强化下一次攻击,使其造成魔法伤害,并允许艾克瞬移到目标旁边。

- **R技能:时空断裂**
  艾克返回至4秒前的位置,并治疗这段时间内受到的部分伤害,同时对周围敌人造成大量魔法伤害。

以上便是艾克的各项技能简介。------

Process finished with exit code 0
查询盲僧的相关信息
D:\AI\conda\envs\aiAgent\python.exe D:\Pycharm\aiAgent\pythonProject\llm\knowledge_base\knowledgeTest_0918.py
------盲僧·李青的技能如下:

1. **疾风骤雨(被动)**:
   - 在李青使用一次技能后,他的下两次攻击会获得40%攻速加成,且分别回复20/30/40、10/15/20能量(1/7/13级时)。

2. **天音波/回音击(Q)**:
   - 冷却时间:11/10/9/8/7
   - 射程:1200
   - 消耗:50 能量(天音波) / 30能量(回音击)
   - 天音波:李青发出刺耳的声波定位敌人,对首个敌人造成55/80/105/130/155 (+100% 额外AD) 物理伤害。如果天音波击中敌人,李青在接下来3秒可施放回音击。
   - 回音击:李青冲向被天音波击中的敌人,造成55/80/105/130/155 (+100% 额外AD) 物理伤害,并根据敌人损失的生命值0-100%造成额外百分比伤害(对野怪最多附加400点伤害)。

3. **金钟罩/铁布衫(W)**:
   - 冷却时间:14秒
   - 距离:700
   - 消耗:50能量(金钟罩) / 30能量(铁布衫)
   - 金钟罩:李青突进到一名友军旁边。如果目标友军是一名英雄,李青会为自己和目标提供一层吸收50/100/150/200/250 (+0.8AP) 伤害的护盾,持续2秒,并且金钟罩的冷却时间会减少50%。施放金钟罩后接下来3秒,李青可施放铁布衫。
   - 铁布衫:李青高强度的训练让他在战斗中激发潜能。李青可以在4秒里获得5/9.5/14/18.5/23% 生命偷取和法术吸血。

4. **天雷破/摧筋断骨(E)**:
   - 冷却时间:10
   - 范围:600
   - 消耗:50能量(天雷破) / 30能量(摧筋断骨)
   - 天雷破:李青撞击地面,施放冲击波,造成80/120/160/200/240 (+1额外AD) 魔法伤害,并使被击中单位暴露,持续4秒。如果天雷破击中敌人,李青可以在接下来的3秒内施放摧筋断骨。
   - 摧筋断骨:李青致残被天雷破侦查到的敌人,减少敌人20/30/40/50/60% 的移动速度,持续4秒。持续期间受影响单位的移动速度会逐渐恢复正常。

5. **猛龙摆尾(R)**:
   - 冷却时间:110/85/60
   - 距离:375
   - 击退距离:1200
   - 李青用强力的回旋踢击退敌方英雄,对目标以及被目标撞到的任何敌人造成175/400/625 (+2额外AD) 物理伤害。被目标撞到的敌方英雄会被短暂击飞,在目标撞飞一名敌方英雄时,目标也会造成相当于该敌方英雄12/15/18%额外生命值的物理伤害。------

Process finished with exit code 0
咱们这个整个流程其实就是一个RAG(检索增强生成),RAG的核心可以理解为检索+生成,而增强呢则是通过LLM的提示词进行增强查询,好了今天的文章就到这里了,下期我会分享Langchain+LLM+知识图谱的(Neo4j)的简单功能,就是通过自然语言让大模型去查询知识图谱,可以生成相关cypher语句,感谢大家的观看,鼓励大家提出疑问和对我进行指导,谢谢大家。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 19
 0
- 0


 已为社区贡献1条内容

所有评论(0)