山东大学(威海)数据科学实验班20级软件设计大赛3D智慧医疗算法部分
1️⃣项目介绍
🚀内容介绍:
算法部分共分为两个部分,
第一部分:将base_train.zip数据集按10折交叉检验,基于baseline设计一个更好的算法,训练后输出一个10折平均dice。
第二部分:对Paddleseg内置的各种分割模型,即VNet、UNETR、nnFormer、nnUNet、TransUNet、SwinUNet,进行尝试、对比,并提供详细的实验过程描述,评价结果需用表格或图展示出来。
📍数据集介绍
多器官数据集共有11个器官的标注,包括脾脏、右肾、左肾、胆囊、食道、肝、胃、主动脉、下腔静脉、胰腺、膀胱。本数据集共包含160个训练数据,40个测试数据。
💡整体项目概览
-
第一部分:基于baseline的算法改进
- Baseline介绍
- Baseline结果
- 设计思路
- Pipline
-
第二部分:基于paddleseg内置的6个网络模型分析
- 网络介绍
- 数据分析
- Pipline
- 总结
-
第三部分:对所有模型数据总结对比
-
项目运行链接:
第一部分: https://aistudio.baidu.com/aistudio/projectdetail/6585522
第二部分:
- TransUNet https://aistudio.baidu.com/aistudio/projectdetail/6571955
- SwinUNet https://aistudio.baidu.com/aistudio/projectdetail/6570400
- nnUNet:https://aistudio.baidu.com/aistudio/projectdetail/6547514
- VNet https://ieeexplore.ieee.org/abstract/document/7785132
- UNETR https://aistudio.baidu.com/aistudio/projectdetail/6592278
- nnFormer https://aistudio.baidu.com/aistudio/projectdetail/6544295
2️⃣第一部分
该任务意在基于大赛提供baseline,设计算法以达到更好效果。设计思路是在对数据集进行归一化后先使用旋转、高斯噪声、高斯模糊的数据增强手段提高模型的鲁棒性,训练时使用十折交叉验证策略训练数据,再根据第一次训练得到的结果切割出**3D数据中感兴趣部分(ROI)**再进行训练得到更精确的分割的结果。
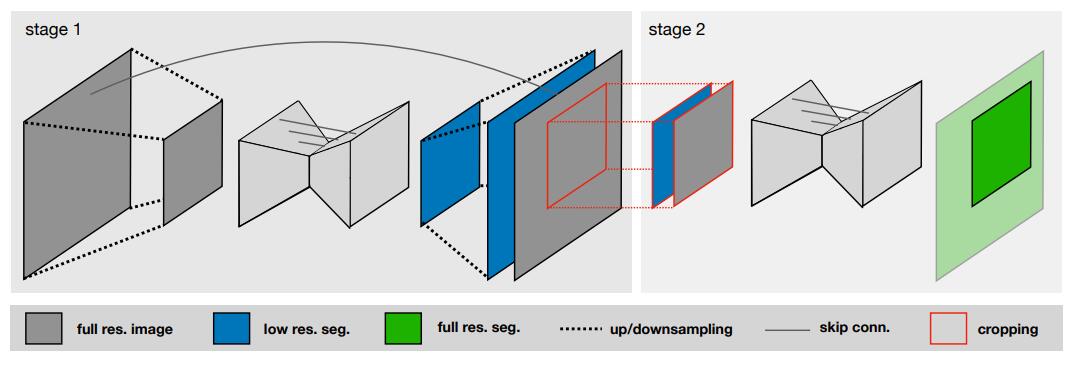
一、Baseline: nnU-Net介绍
nnU-Net(no-new-UNet)是对U-Net架构的扩展和改进,而U-Net是一种常用于图像分割的卷积神经网络结构。与传统的U-Net相比,nnU-Net引入了自配置的机制,以更好地适应不同的医学图像分割任务,无需手动调整和优化网络架构。这种自配置的能力使得nnU-Net在应用于不同数据集和任务时能够更加灵活和高效。
nnU-Net框架并没有对UNet进行过多修改(ReLU换 leaky ReLU、BN换Instance Norm),而是将重心放在预处理(resampling和normalization)、训练(loss,optimizer设置、数据增广)、推理(patch-based策略、test-time-augmentations集成和模型集成等)、后处理(如增强单连通域等)。
网络结构:U-Net2d、U-Net3d、UNet-Cascade,结构如下图。
二、baseline运行结果
根据官方提供代码,基于baseline运用10折交叉验证策略,在aistudio上训练验证得到的结果如下表:
表一:每一折的所有分类的平均dice
| fold0 | fold1 | fold2 | fold3 | fold4 | fold5 | fold6 | fold7 | fold8 | fold9 | MEAN | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| dice | 0.8149 | 0.859 | 0.8831 | 0.8083 | 0.8046 | 0.8512 | 0.8497 | 0.8218 | 0.7486 | 0.8405 | 0.82817 |
表二:10折mdice
| background | spleen | right kidney | left kidney | gall bladder | esophagus | liver | stomach | arota | postcava | pancreas | bladder | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| dice(online) | 0.99737853 | 0.91039857 | 0.92159785 | 0.90497482 | 0.64492576 | 0.68816753 | 0.94623484 | 0.77011192 | 0.91045195 | 0.81994966 | 0.69421586 | 0.72977343 |
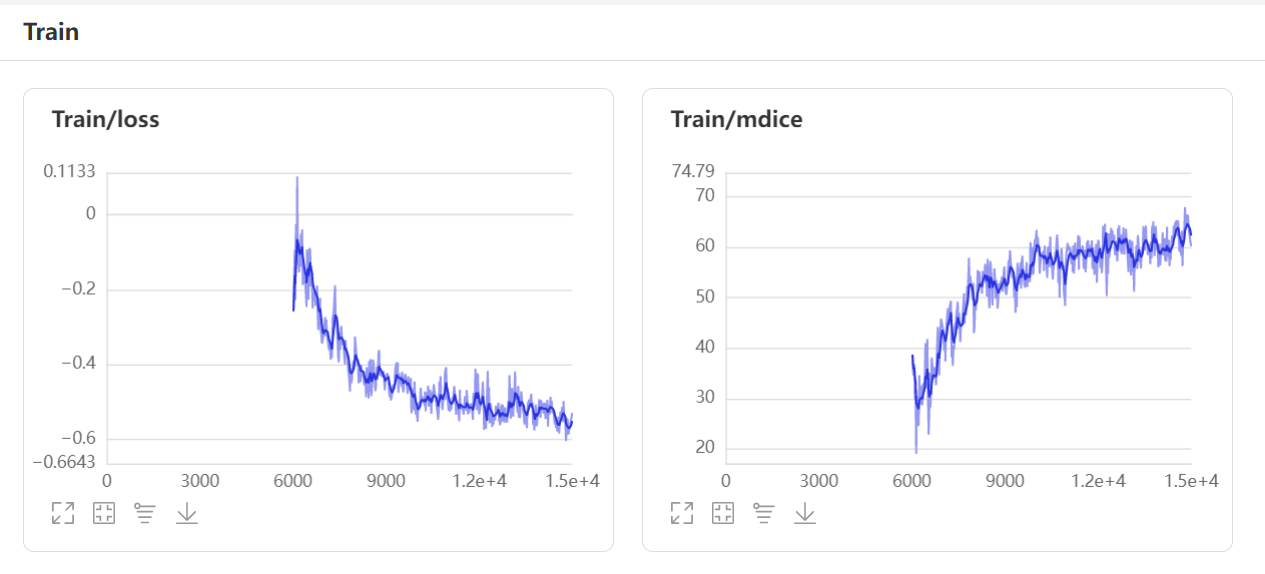
训练过程图,以fold0为例:
具体运行代码示例请点击链接:【附上只有nnunet运行的链接】
三、算法改进
在医学图像分割领域,深度学习模型nnU-Net为基线提供了出色的起点。然而,随着任务复杂性和数据多样性增加,我们采用了数据增强、十折交叉验证、调参对比和Coarse to Fine策略来提高Dice系数值。数据增强增加了数据多样性和模型泛化能力,十折交叉验证确保评估结果的稳健性,调参对比找到最优配置,而Coarse to Fine策略则增强了分割结果的准确性和细节表现。这些策略有效地优化了nnU-Net模型,显著提升了医学图像分割性能。
🎈1. 数据增强
我们针对该任务采用了多种数据增强策略,以提升模型性能和泛化能力。重点关注的数据增强手段包括旋转、高斯噪声和高斯模糊。通过随机旋转图像(±15度) 、引入高斯噪声(10%) 有助于增加图像的鲁棒性,模拟真实场景中的噪声情况。此外,高斯模糊处理(20%) 使模型能够适应模糊图像,增强了对模糊情况的应对能力。
添加如下:
  transforms:
    - type: RandomRotation3D
    - type: GaussianNoiseTransform
    - type: GaussianBlurTransform
🎈2.调参对比
为了验证模型改进的有效性,我们进行了算法调参工作。我们重点关注了batch size、learning rate和optimizer这三个关键参数。通过仔细调整它们的取值,并进行对比实验,我们找到了最佳配置,使得模型在训练过程中能够更快收敛,性能得到显著提升。
值得注意的是,按照iter = 30000固然可以得到更好的数据结果。但是考虑到时间、硬件条件,我们选择对10折统一叠代次数为1.5w。
对比实验结果如下,统一iter=15000,stage=0:
| Experiment | optimizer | lr | batchsize | dice |
|---|---|---|---|---|
| E1 | sgd | 0.01 | 2 | 0.7673 |
| E2 | adamw | 0.01 | 2 | 0.8377 |
| E3 | adamw | 0.02 | 2 | 0.83424 |
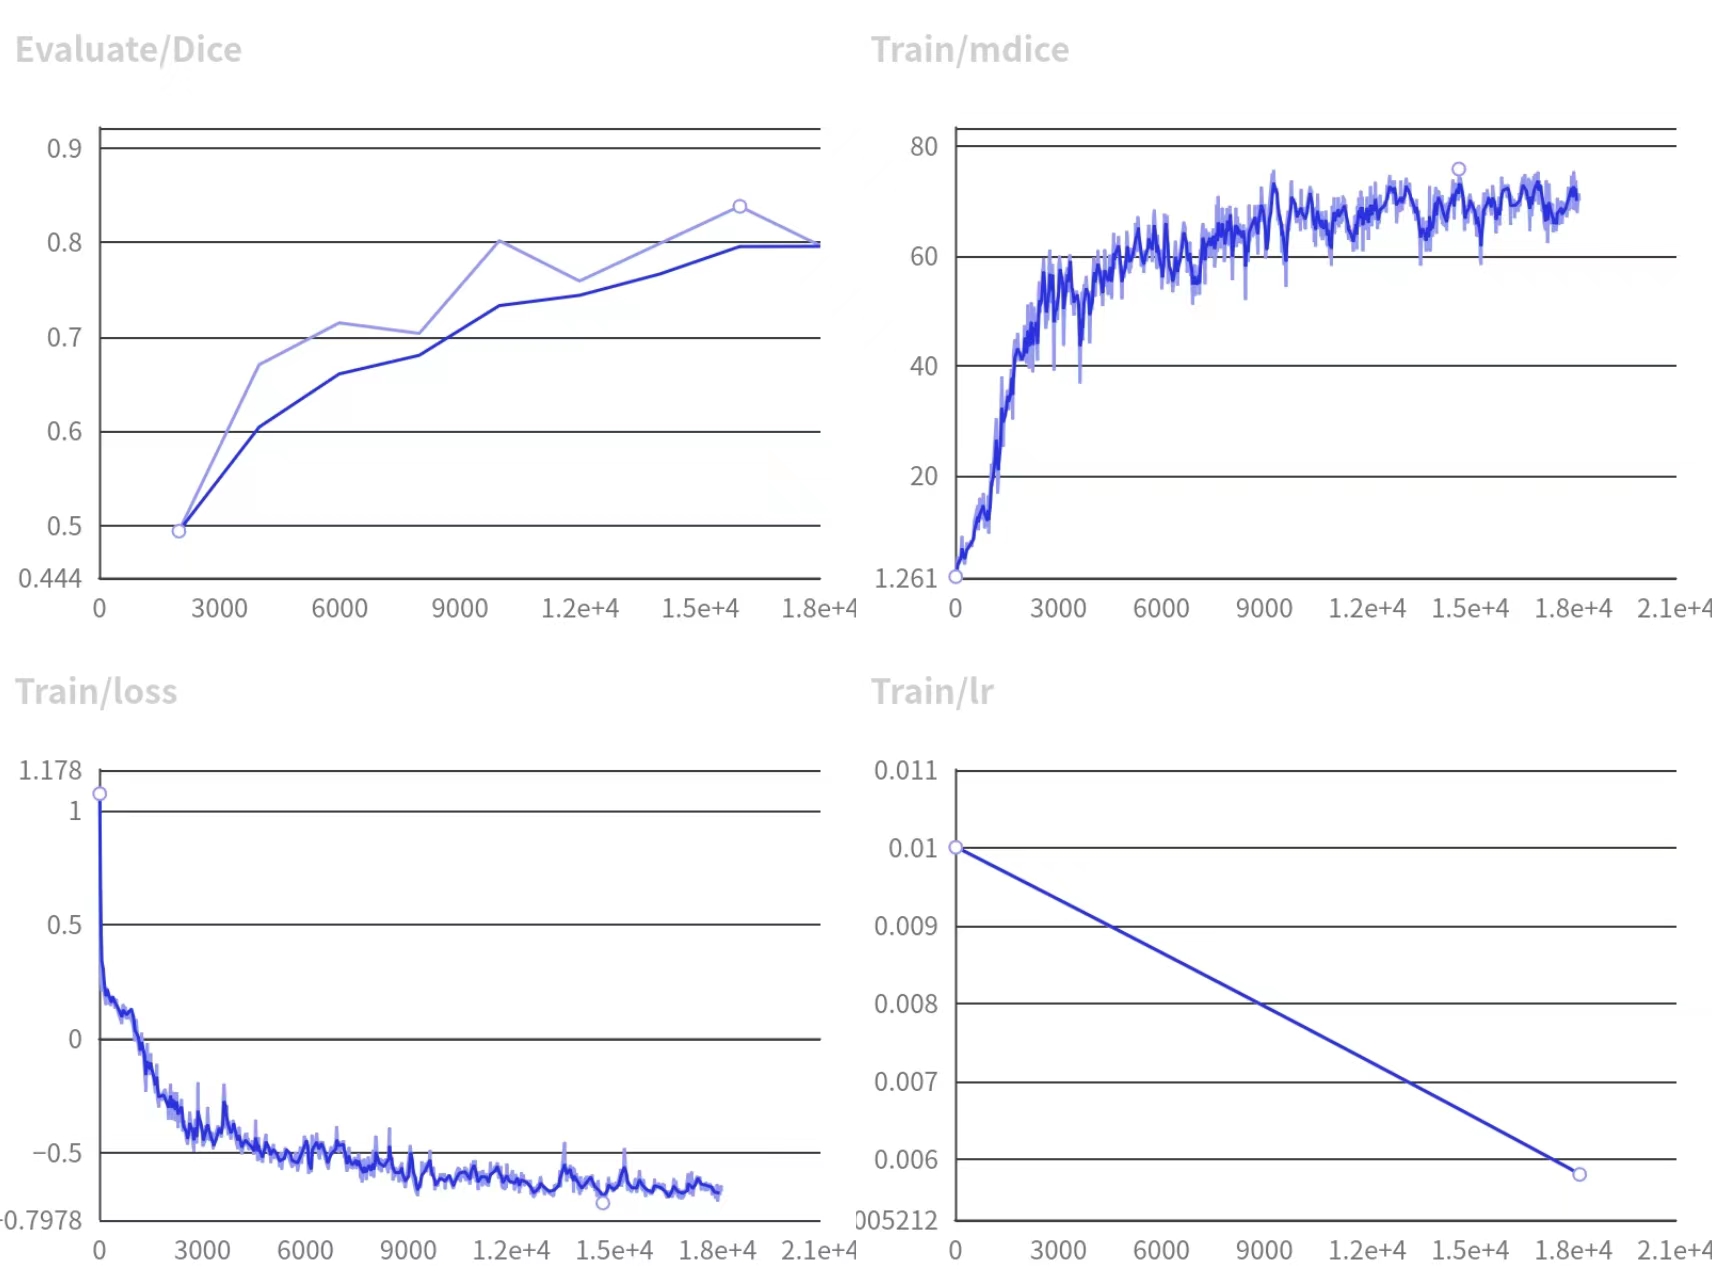
通过E1和E2对比发现,adamw可以更快收敛,并且在iter相同情况下表现更出色;
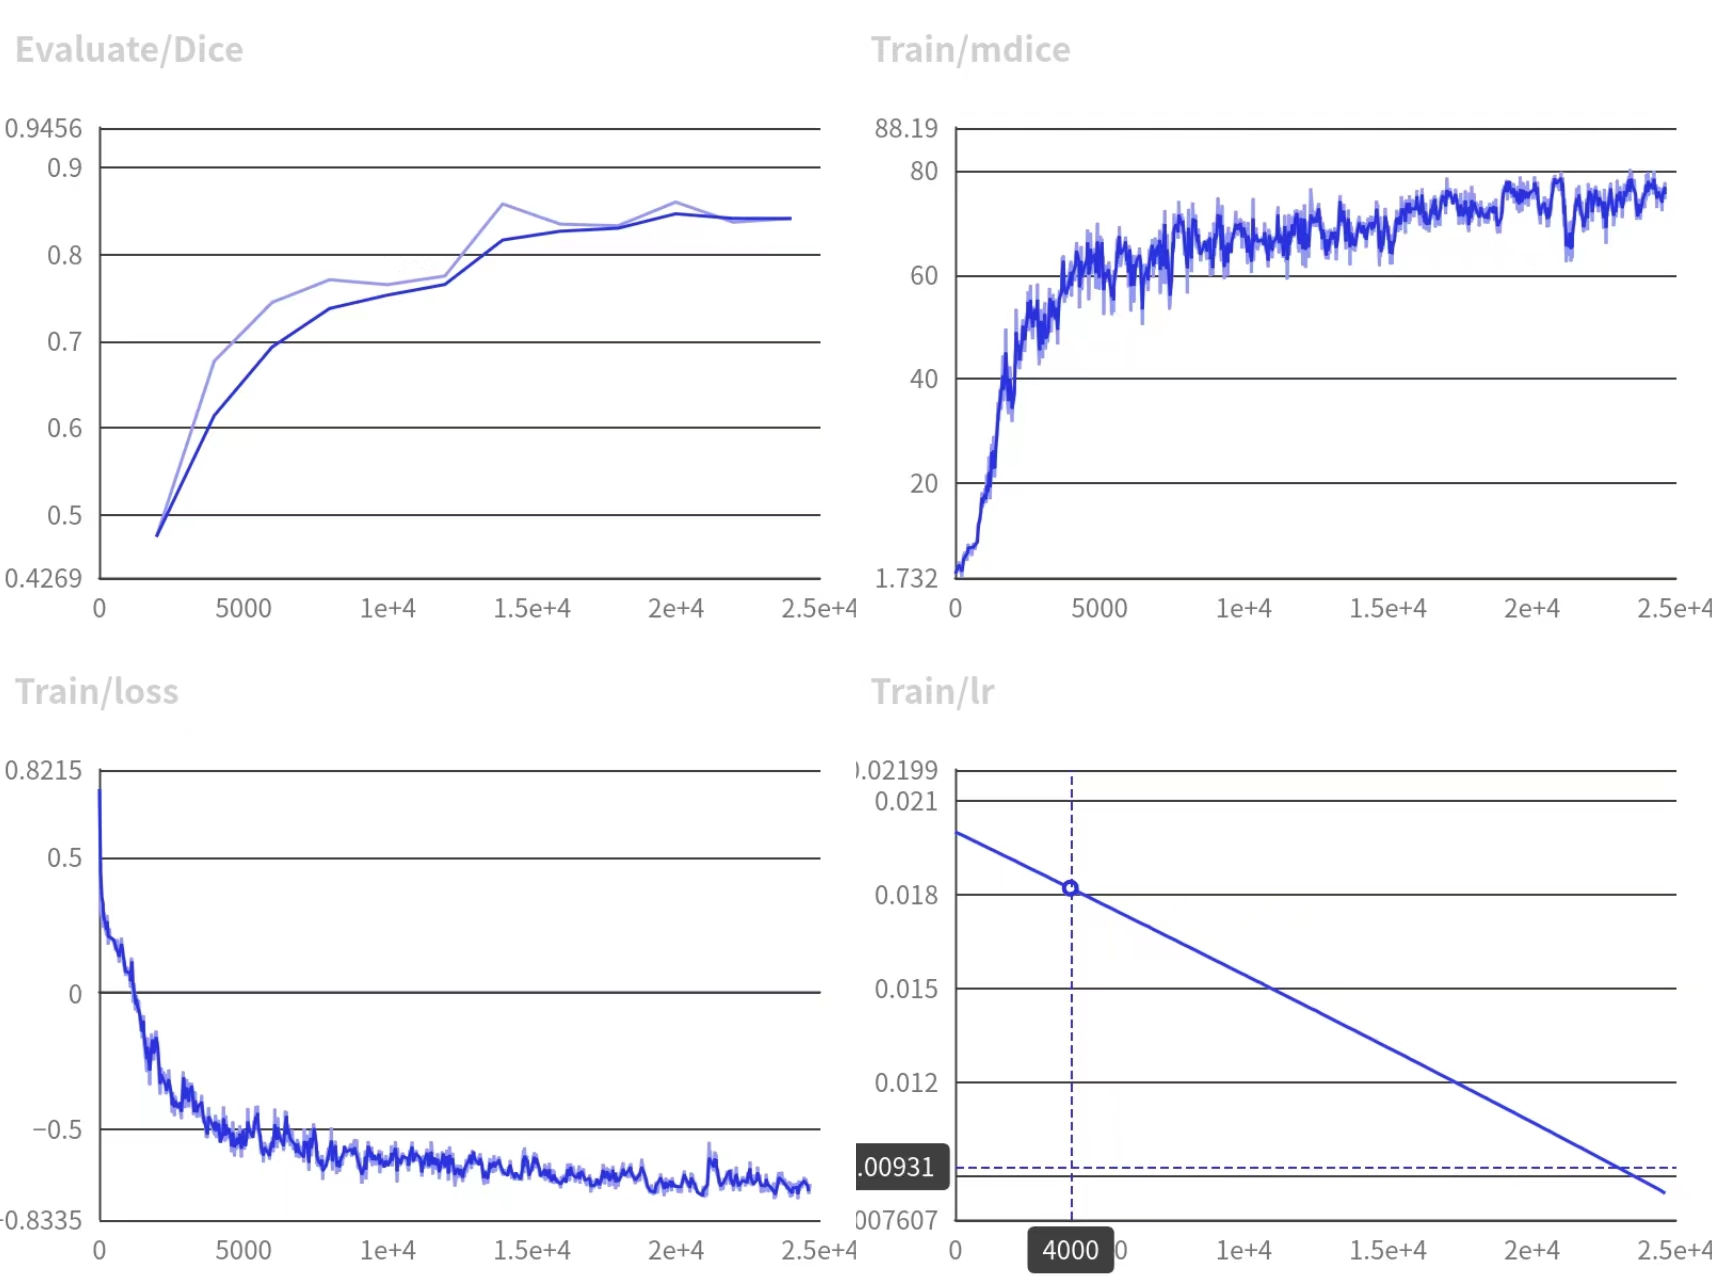
通过E2组和E3组对比发现,学习率增大效果反而没有原始学习率效果好。
E2、E3组的训练数据图如下:
optimizer = adamw; lr = 0.01
optimizer = adamw; lr = 0.02
🎈3. Coarse-to-Fine
考虑到unuet-cascade的lowres+fullres虽然有可能发挥出更好的性能,但是训练时间过长,因此仍然采用unet级联结构stage=0作为基础模型架构。
该任务中,我们采用了Coarse to Fine(粗细分割)策略,这并不是指的lower-fullres操作——先处理低分辨率数据再处理高分辨率图像,而是通过先粗分割再细分割的策略让模型更关注重要、感兴趣的部分。
我们首先通过粗分割得到测试数据集的初步分割结果,让模型预测出大致目标区域,然后根据这些区域切出感兴趣区域(ROI)。接着,在ROI范围内进行更精细的分割,关注细节特征,以提高分割准确性。
具体来说,首先用预测结果/label计算出目标区域的最小矩形框(rectangle)。再根据矩形框的中心点和半径,计算出感兴趣区域(ROI)的范围。接着,将原始图像、标签和预测结果切割到ROI的范围内,从而得到感兴趣的部分
伪代码如下
    # 声明变量
rectangle_indices <- nonzero_indices(target['arr'])
rectangle <- [    [min(rectangle_indices[0]), max(rectangle_indices[0])],
    [min(rectangle_indices[1]), max(rectangle_indices[1])],
    [min(rectangle_indices[2]), max(rectangle_indices[2])],
]
center <- [(a + b) / 2 for a, b in rectangle]
radius <- [(b - a) / 2 * zoom for a, b in rectangle]
start_position <- [r[0] for r in rectangle]

# 遍历
FOR EACH key IN d DO
    IF d[key]['arr'] IS None THEN
        CONTINUE  # 如果有空值则跳过本次循环,处理下一个键
    ENDIF

    # 裁剪感兴趣区域(ROI)
    d[key]['arr'] <- (
        d[key]['arr'][            rectangle[0][0] : rectangle[0][1],
            rectangle[1][0] : rectangle[1][1],
            rectangle[2][0] : rectangle[2][1],
        ]
    )
ENDFOR
train数据集ROI前后对比:
(以文件名:01a7d587-5815-479d-8292-9b4e6ee8f74b.nii为例)
left:roi前;right:roi后
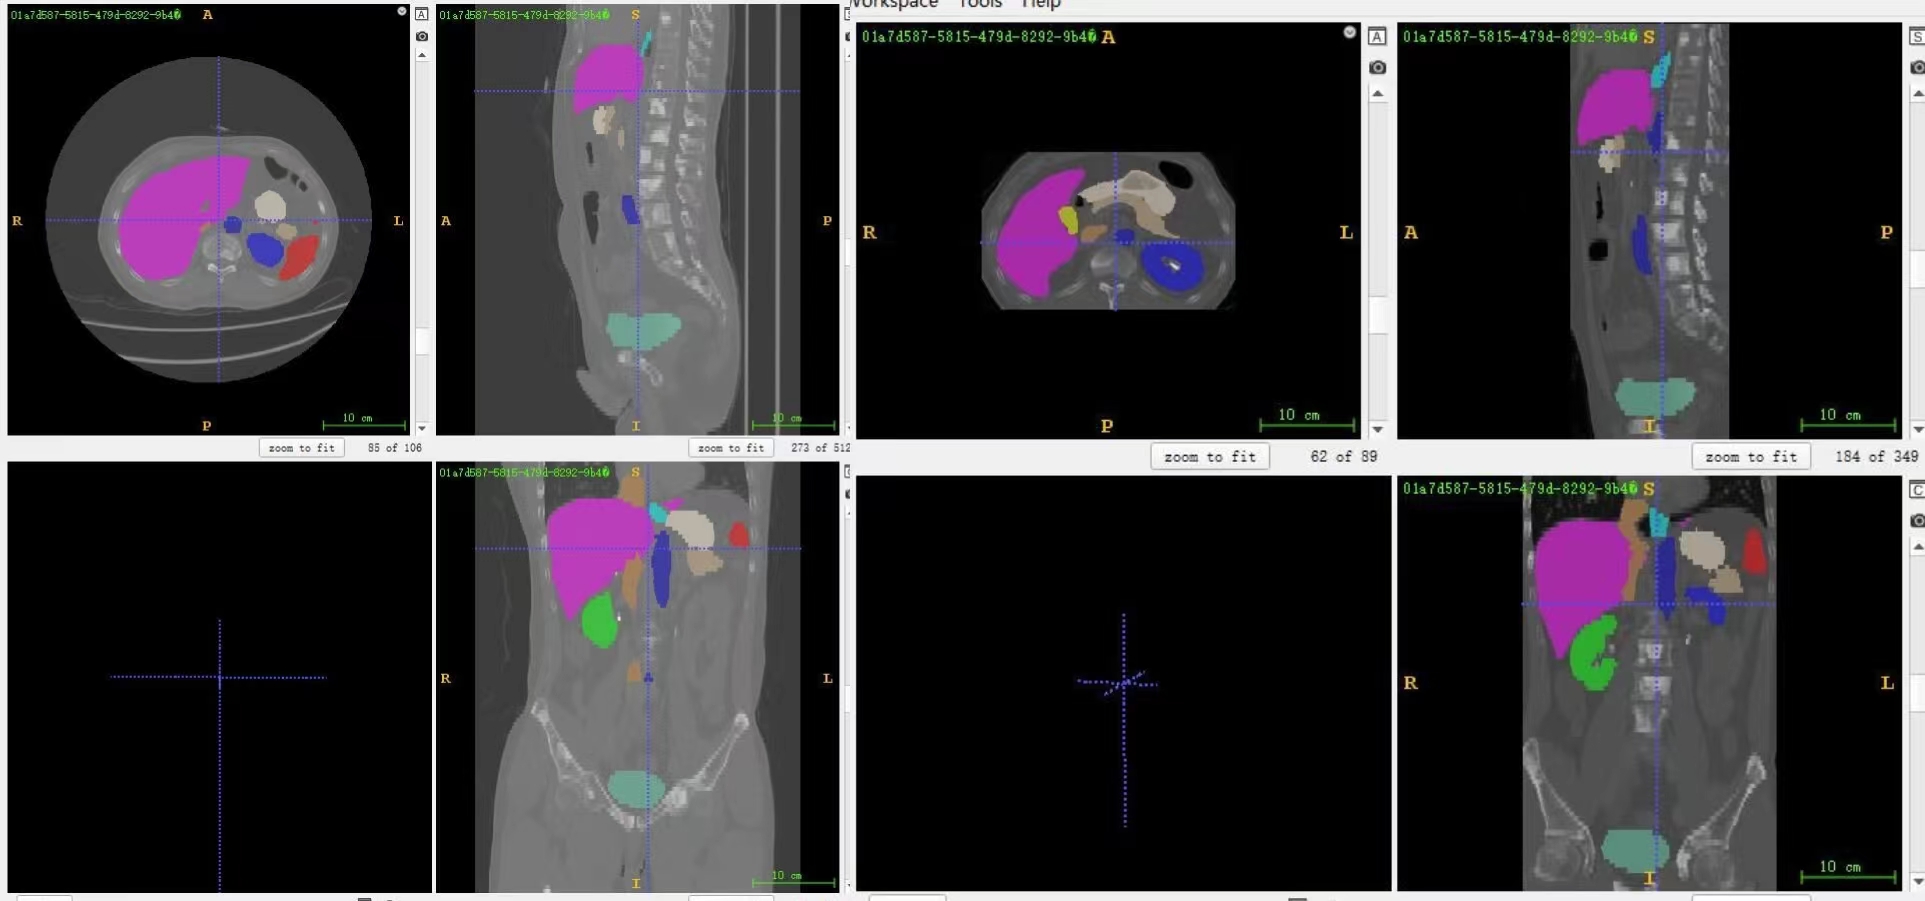
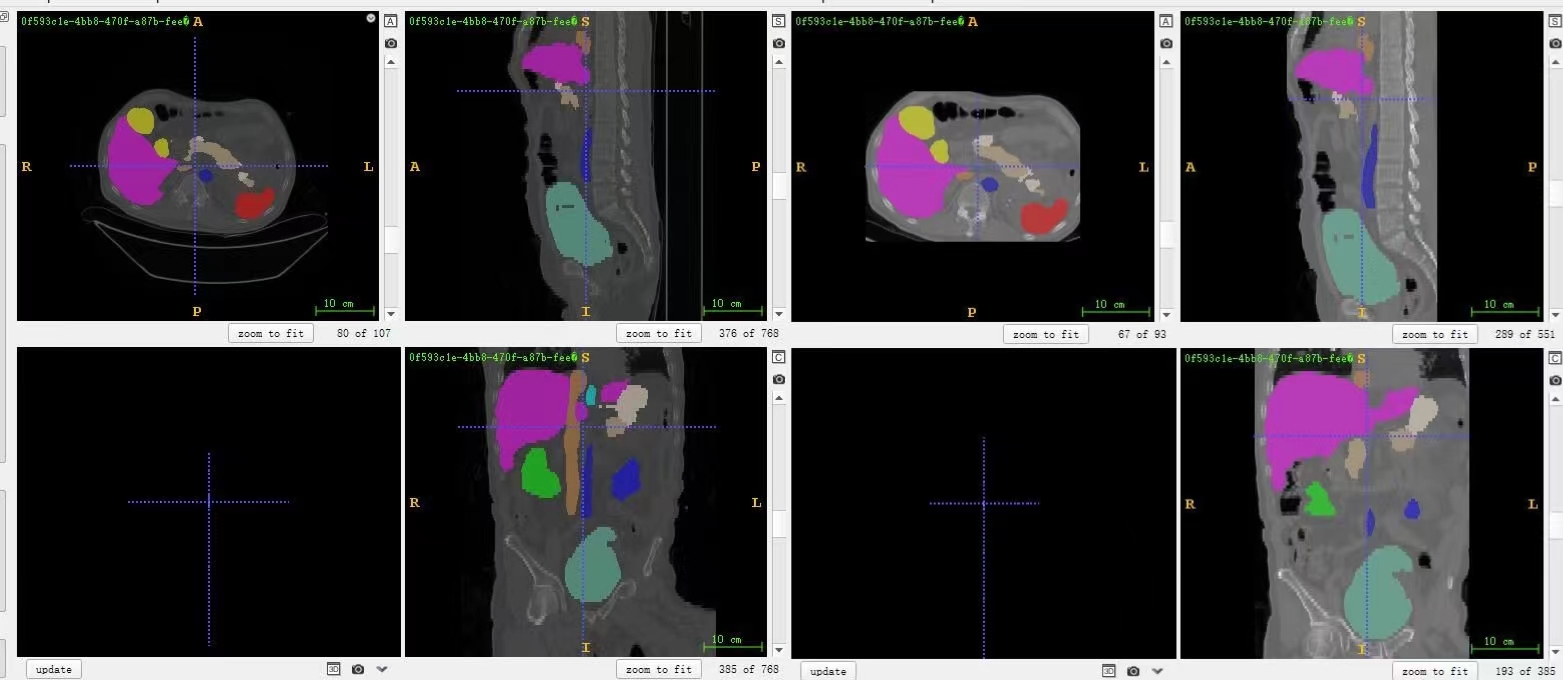
test数据集ROI前后对比:
(以0f593c1e-4bb8-470f-a87b-fee3dbd3b3ed.nii为例)
left:roi前;right:roi后
🎈4.Baseline & Coarse-to-fine的结果比较:
表一:改进后每一折的所有分类的平均dice
| fold0 | fold1 | fold2 | fold3 | fold4 | fold5 | fold6 | fold7 | fold8 | fold9 | MEAN | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| aver_dice | 0.8603 | 0.8591 | 0.8494 | 0.8541 | 0.8431 | 0.8516 | 0.8539 | 0.8256 | 0.8236 | 0.8762 | 0.850 |
表二:改进后10折mdice
| background | spleen | right kidney | left kidney | gall bladder | esophagus | liver | stomach | arota | postcava | pancreas | bladder | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| mdice(online) | 0.99175904 | 0.91310376 | 0.92185367 | 0.91565554 | 0.66577194 | 0.75998226 | 0.94889251 | 0.79217957 | 0.93097676 | 0.85524831 | 0.74284509 | 0.75815549 |
对比图曲线图:
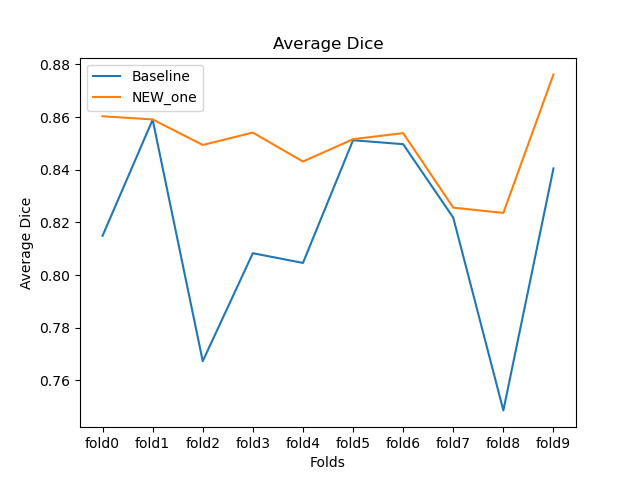
从上图不难看出,在iter=15000时,改进后的算法模型得到的结果更加稳定。后续在条件允许的情况下,我们组将探索增加叠代次数之后的效果。
四、运行流程Pipline
下面是运行项目的总体流程,为减少过多的运行结果展示,这里仅提供代码运行步骤。
具体实现可参考链接: https://aistudio.baidu.com/aistudio/projectdetail/6585522
In [ ]
#### step 1: 克隆PaddleSeg仓库
%cd ~/
!git clone --branch develop --depth 1 https://github.com/PaddlePaddle/PaddleSeg.git
%cd ~/PaddleSeg
#### step2: 解压数据到~/PaddleSeg/contrib/MedicalSeg/data/raw_data
!mkdir ~/PaddleSeg/contrib/MedicalSeg/data
!unzip -oq ~/data/data204195/base_train.zip -d ~/PaddleSeg/contrib/MedicalSeg/data/raw_data
#### step 3: 删除原本的数据集压缩包,节约内存
!rm -rf ~/data/data204195/base_train.zip
# 删除掉数据集中一个没用的文件夹,否则会报错
!rm -rf ~/PaddleSeg/contrib/MedicalSeg/data/raw_data/.ipynb_checkpoints
##### step 4: 安装依赖包
%cd ~/PaddleSeg/contrib/MedicalSeg/
!pip install 'protobuf<=3.20.0' -r requirements.txt # 避免冲突
!pip install medpy
In [ ]
#### step 5: 在yml文件里加上数据增强参数后,运行十折交叉验证,得到粗分割结果。可写入train.sh中并直接运行,这里为展示是十折训练所以没有考虑命令行简洁性。
!python train.py --config ~/configs/coarse/nnunet_1_fold2.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/cascade_lowres/fold2  --save_interval 1500 --use_vdl --do_eval    --resume_model output/cascade_lowres/fold2_adamw/iter_4500
!python train.py --config ~/configs/coarse/nnunet_1_fold0.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/cascade_lowres/fold0 --save_interval 1500 --use_vdl --do_eval    --resume_model output/cascade_lowres/fold0_adamw/iter_12000
!python train.py --config ~/configs/coarse/nnunet_1_fold1.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/cascade_lowres/fold1  --save_interval 1500 --use_vdl --do_eval
!python train.py --config ~/configs/coarse/nnunet_1_fold3.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/cascade_lowres/fold3  --save_interval 1500 --use_vdl --do_eval
!python train.py --config ~/configs/coarse/nnunet_1_fold4.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/cascade_lowres/fold4  --save_interval 1500 --use_vdl --do_eval
!python train.py --config ~/configs/coarse/nnunet_1_fold5.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/cascade_lowres/fold5  --save_interval 1500 --use_vdl --do_eval
!python train.py --config ~/configs/coarse/nnunet_1_fold6.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/cascade_lowres/fold6  --save_interval 1500 --use_vdl --do_eval
!python train.py --config ~/configs/coarse/nnunet_1_fold7.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/cascade_lowres/fold7 --save_interval 1500 --use_vdl --do_eval
!python train.py --config ~/configs/coarse/nnunet_1_fold8.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/cascade_lowres/fold8  --save_interval 1500 --use_vdl --do_eval
!python train.py --config ~/configs/coarse/nnunet_1_fold9.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/cascade_lowres/fold9 --save_interval 1500 --use_vdl --do_eval
In [ ]
#### step6: Get ROI
%cd ~/PaddleSeg/contrib/MedicalSeg/
!python get_ROI.py --roi_data './data/02-roi/raw_data' --predict_data '../../../submit'
# 同理删除掉数据集中一个没用的文件夹,否则会报错
!rm -rf ~/PaddleSeg/contrib/MedicalSeg/data/02-roi/raw_data/.ipynb_checkpoints
In [ ]
#### step7: Coarse-to-fine中细分割部分,该部分yml文件储存在 ~/configs/fine下
%cd ~/PaddleSeg/contrib/MedicalSeg/
!python train.py --config ~/configs/fine/nnunet_2_fold0.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/fine/fold0 --save_interval 1500 --use_vdl --do_eval     --resume_model output/fine/fold0/iter_3000

!python train.py --config ~/configs/fine/nnunet_2_fold1.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/fine/fold1 --save_interval 1500 --use_vdl --do_eval    --resume_model output/fine/fold1/iter_3000

!python train.py --config ~/configs/fine/nnunet_2_fold2.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/fine/fold2 --save_interval 1500 --use_vdl --do_eval     #--resume_model output/fine/fold0/iter_3000

!python train.py --config ~/configs/fine/nnunet_2_fold3.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/fine/fold3 --save_interval 1500 --use_vdl --do_eval     #--resume_model output/fine/fold0/iter_3000

!python train.py --config ~/configs/fine/nnunet_2_fold4.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/fine/fold4 --save_interval 1500 --use_vdl --do_eval     #--resume_model output/fine/fold0/iter_3000

!python train.py --config ~/configs/fine/nnunet_2_fold5.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/fine/fold5 --save_interval 1500 --use_vdl --do_eval     #--resume_model output/fine/fold0/iter_3000

!python train.py --config ~/configs/fine/nnunet_2_fold6.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/fine/fold6 --save_interval 1500 --use_vdl --do_eval     #--resume_model output/fine/fold0/iter_3000

!python train.py --config ~/configs/fine/nnunet_2_fold7.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/fine/fold7 --save_interval 1500 --use_vdl --do_eval     #--resume_model output/fine/fold0/iter_3000

!python train.py --config ~/configs/fine/nnunet_2_fold8.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/fine/fold8 --save_interval 1500 --use_vdl --do_eval     #--resume_model output/fine/fold0/iter_3000

!python train.py --config ~/configs/fine/nnunet_2_fold9.yml \
        --log_iters 20 --precision fp16 --nnunet --save_dir output/fine/fold9 --save_interval 1500 --use_vdl --do_eval     #--resume_model output/fine/fold0/iter_3000
In [ ]
# 为了防止内存溢出,请替换cascade预测下一阶段的部分代码
!mv ~/PaddleSeg/contrib/MedicalSeg/nnunet/utils/cascade_utils.py ~/PaddleSeg/contrib/MedicalSeg/nnunet/utils/cascade_utils_backup.py
!cp ~/cascade_utils.py ~/PaddleSeg/contrib/MedicalSeg/nnunet/utils/
##### step 8: 使用十折交叉划分好的数据集里的验证集来验证一下精度,生成summary.json文件
##################################还没写!!!1########################################
%cd ~/PaddleSeg/contrib/MedicalSeg/
!python nnunet/single_fold_eval.py --config ~/configs/nnunet_fold2.yml \
        --model_path output/cascade_lowres/fold2/iter_30000/model.pdparams --val_save_folder output/cascade_lowres_val \
        --precision fp16 --predict_next_stage
3️⃣第二部分
一、TransUNet
1. 网络介绍
TransUNet 是第一个从序列到序列预测的角度引入了自注意机制的医学图像分割框架。为了弥补 Transformer 所带来的特征分辨率损失,TransUNet采用混合 CNN-Transformer 架构,以利用CNN特征的详细高分辨率空间信息和 Transformer 编码的全局上下文。受到 U 形架构设计的启发,Transformer 编码的自注意特征被上采样,与从编码路径跳过的不同高分辨率CNN特征相结合,实现精确的定位。实证结果表明,与之前基于CNN的自注意方法相比,基于 Transformer 的架构更好地利用了自注意力。
网络的整体架构如下:
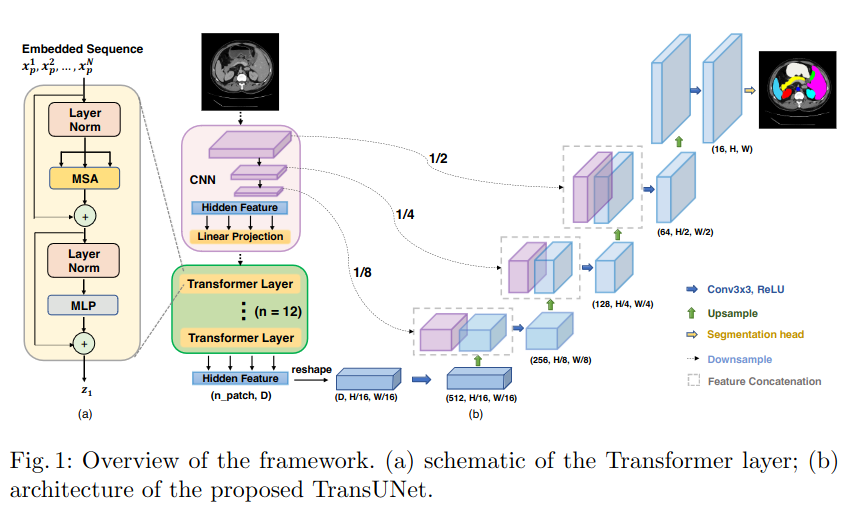
https://arxiv.org/abs/2102.04306
2. 数据结果分析
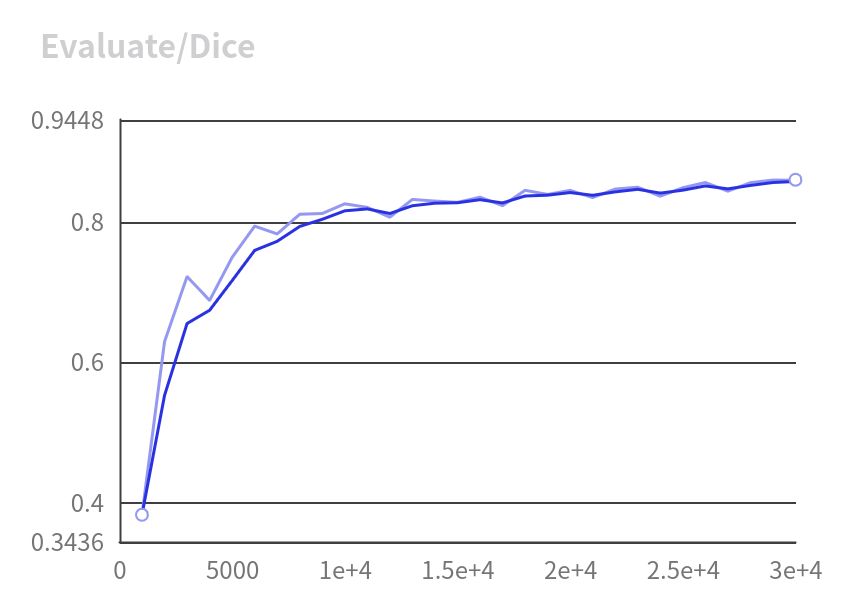
经过 30000 iter 的训练,模型在验证集上取得了非常好的效果, mDice 为 0.8589, 各个器官的 Dice 如下
[EVAL] Class dice:
[0.9977 0.9291 0.9212 0.9259 0.7739 0.6833 0.9631 0.7501 0.9169 0.8454 0.7745 0.8261]
[EVAL] The model with the best validation mDice (0.8589) was saved at iter 30000.
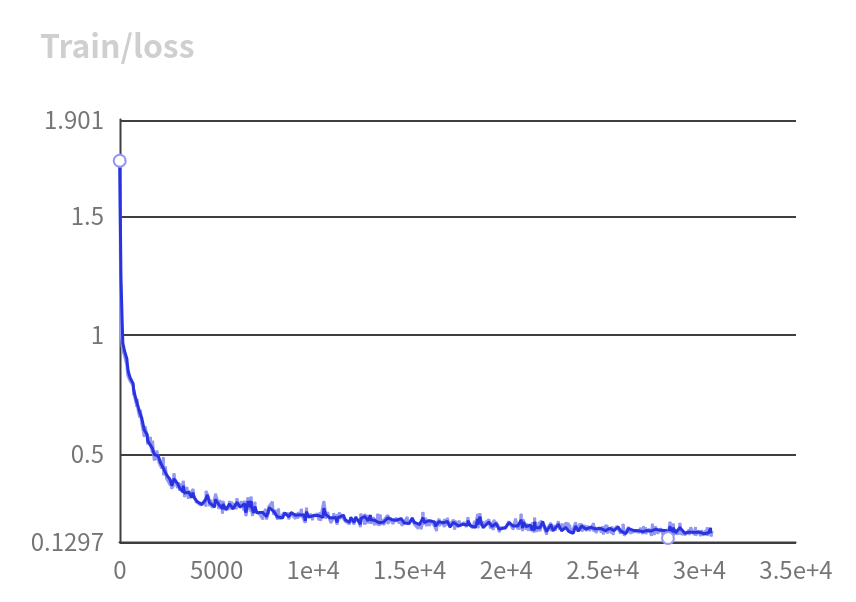
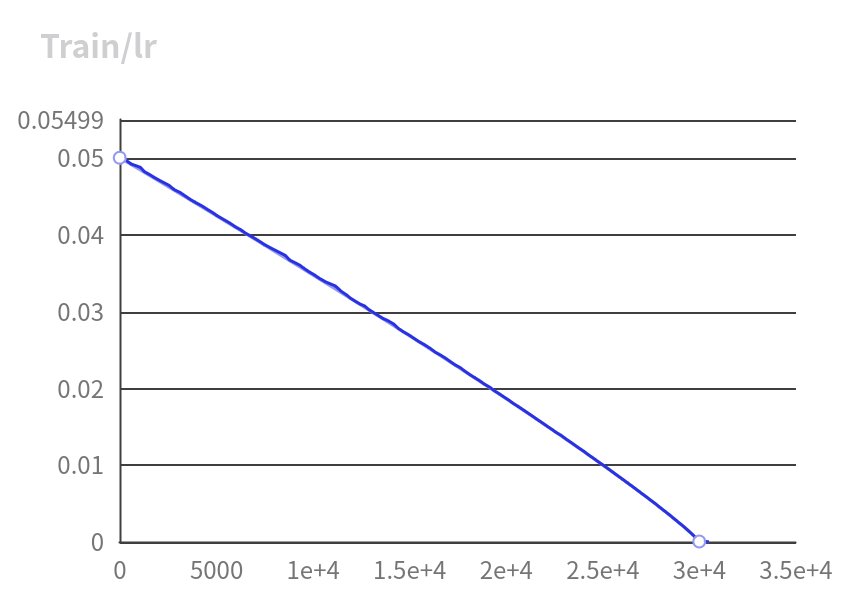
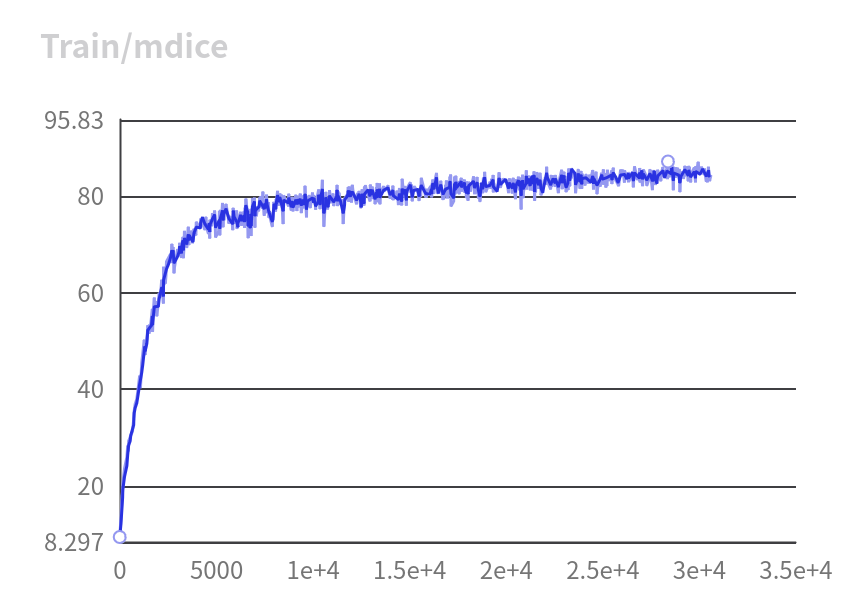
以下为训练过程的 loss 曲线、LR 曲线、mDice 曲线,以及验证集上的 mDice 曲线的图表
| 图表 | 图表 |
|---|---|
|
|
|
|
|
|
3. Pipline
完整的 notebook 见:https://aistudio.baidu.com/aistudio/projectdetail/6571955?contributionType=1&sUid=728413&shared=1&ts=1690764835117
这里仅展示代码,如需运行请点击上面的链接
mkdir -p ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training
unzip -oq ~/data/data204195/base_train.zip -d ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training
mv ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training/imagesTr ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training/img
mv ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training/labelsTr ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training/label
然后进行数据预处理,首先使用我们修改过的数据预处理脚本替换原来的数据预处理脚本,
我们做出的改动如下:
--- prepare_abdomen.py	2023-07-10 18:04:47.502445344 +0800
+++ prepare_abdomen.py.new	2023-07-30 08:25:04.504377042 +0800
@@ -61,20 +61,7 @@
 urls = {"Reg-Training-Training.zip": ""}

 label_map = {
-    "0": 0,
-    "1": 1,
-    "2": 2,
-    "3": 3,
-    "4": 4,
-    "5": 0,
-    "6": 5,
-    "7": 6,
-    "8": 7,
-    "9": 0,
-    "10": 0,
-    "11": 8,
-    "12": 0,
-    "13": 0,
+    str(i):i for i in range(12)
 }


@@ -165,7 +152,7 @@
         print("The preprocess time on {} is {}".format(self.gpu_tag,
                                                        time.time() - tic))

-    def generate_txt(self, train_split=0.6):
+    def generate_txt(self, train_split=0.9):
         """generate the train_list.txt and val_list.txt"""

         txtname = [
@@ -177,7 +164,7 @@
         self.write_txt(txtname[1], self.val_image_files_npy,
                        self.val_label_files_npy)

-    def train_val_split(self, train_split=0.6):
+    def train_val_split(self, train_split=0.9):
         image_files = np.array(self.image_files)
         label_files = np.array(self.label_files)
         np.random.seed(0)
@@ -201,13 +188,16 @@
             1: 'spleen',
             2: 'right kidney',
             3: 'left kidney',
-            4: 'gallbladder',
-            5: 'liver',
-            6: 'stomach',
-            7: 'aorta',
-            8: 'pancreas'
+            4: 'gall bladder',
+            5: 'esophagus',
+            6: 'liver',
+            7: 'stomach',
+            8: 'arota',
+            9: 'postcava',
+            10: 'pancreas',
+            11:  'bladder'
         },
-        dataset_name="Abdomen CT scans",
+        dataset_name="3D Smart Med",
         dataset_description="Under Institutional Review Board (IRB) supervision, 50 abdomen CT scans of were randomly selected from a combination of an ongoing colorectal cancer chemotherapy trial, and a retrospective ventral hernia study.",
         license_desc="https://creativecommons.org/licenses/by/4.0/legalcode",
         dataset_reference="https://www.synapse.org/#!Synapse:syn3193805/wiki/89480",
执行数据预处理:
cd ~/PaddleSeg/contrib/MedicalSeg
cp -f ~/prepare_abdomen.py tools/
python tools/prepare_abdomen.py
然后使用我们修改过的模型配置文件进行训练:
python train.py --config ~/transunet_abdomen_224_224_1_14k_1e-2.yml --do_eval --save_interval 1000 --has_dataset_json False --is_save_data False --num_workers 4 --log_iters 10 --use_vdl
4. 总结
TransUNet 的作者为了充分利用 Transformer 的优势而提出了TransUNet。它不仅将图像特征作为序列进行编码,从而获得强大的全局上下文信息,而且还通过采用U形混合架构设计,充分利用了低级 CNN 特征。作为主导的基于全卷积的医学图像分割方法的一个替代框架,TransUNet 在多个竞争方法中表现优异,包括基于 CNN 的自注意方法。其性能表现出色, 我们的训练还尚未展示出它完整的实力,从图表来看,继续训练的话,mDice 很有希望继续提升
二、SwinUNet
1. 网络介绍
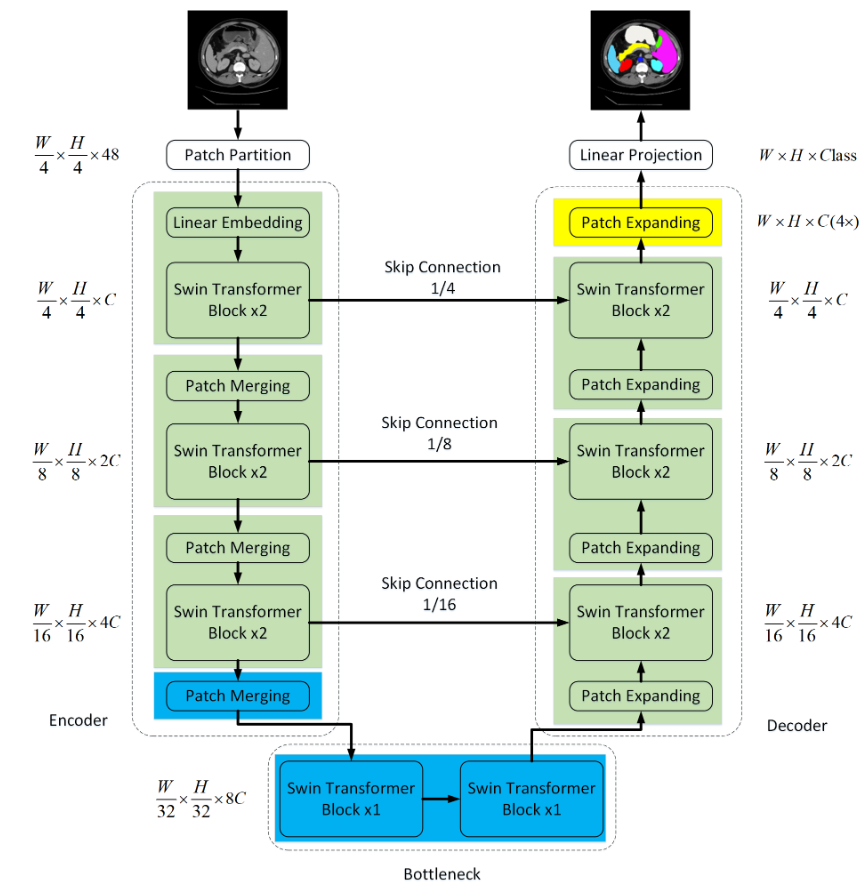
近年来,卷积神经网络(CNN)在医学图像分析方面取得了重大进展。特别是基于U形架构和跳跃连接的深度神经网络已广泛应用于多种医学图像任务。 然而,尽管CNN表现出色,由于卷积操作的局部性,它无法很好地学习全局和长程语义信息的相互作用。 Swin-Unet 是一种用于医学图像分割的纯Transformer网络,类似于Unet结构。
Swin-Unet 将分词后的图像块输入到基于 Transformer 的U形编码器-解码器结构中,并使用跳跃连接进行局部和全局语义特征学习。具体而言,它使用分层的 Swin Transformer 并采用滑动窗口作为编码器来提取上下文特征。而对称的基于 Swin Transformer 的解码器配合 patch expanding 层,用于进行上采样操作以恢复特征图的空间分辨率。
Swin-Unet 在多个数据集上获得了比 Trans-UNet 更好的结果,但是在我们的数据集上,它却比 Trans-UNet 表现的差。
Swin-UNet 的网络架构如下
https://arxiv.org/abs/2105.05537
2. 数据结果分析
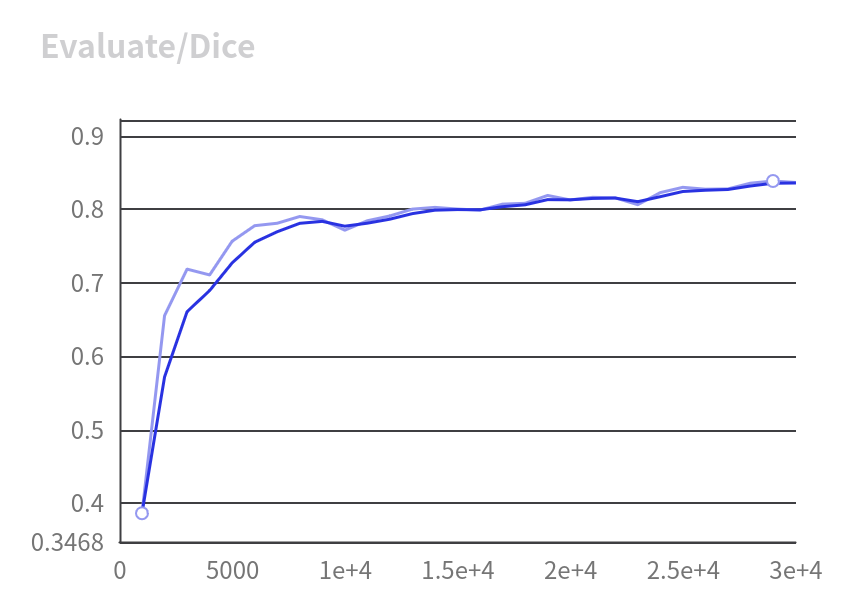
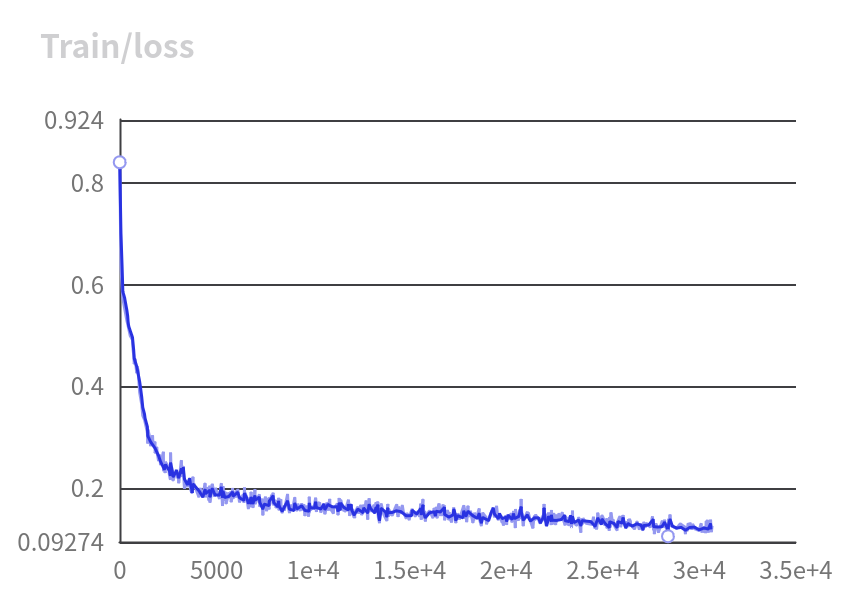
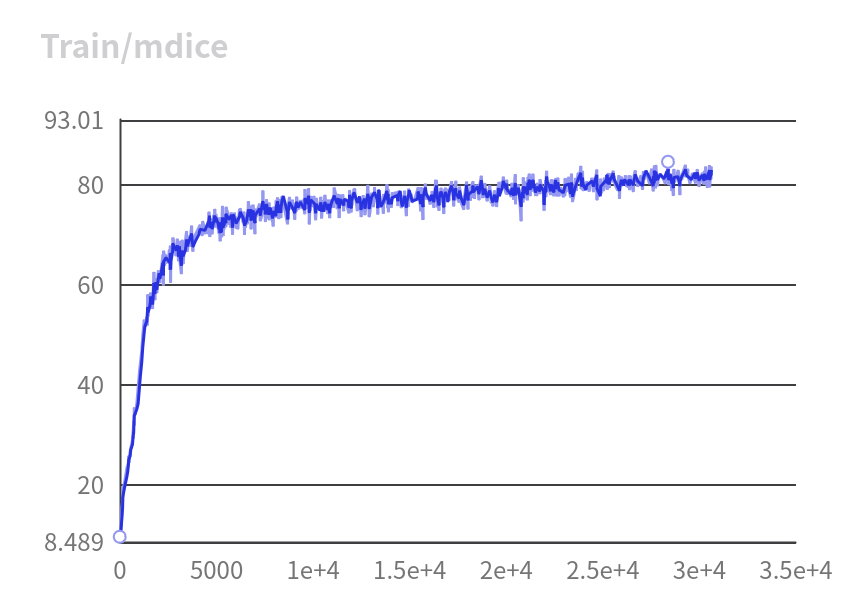
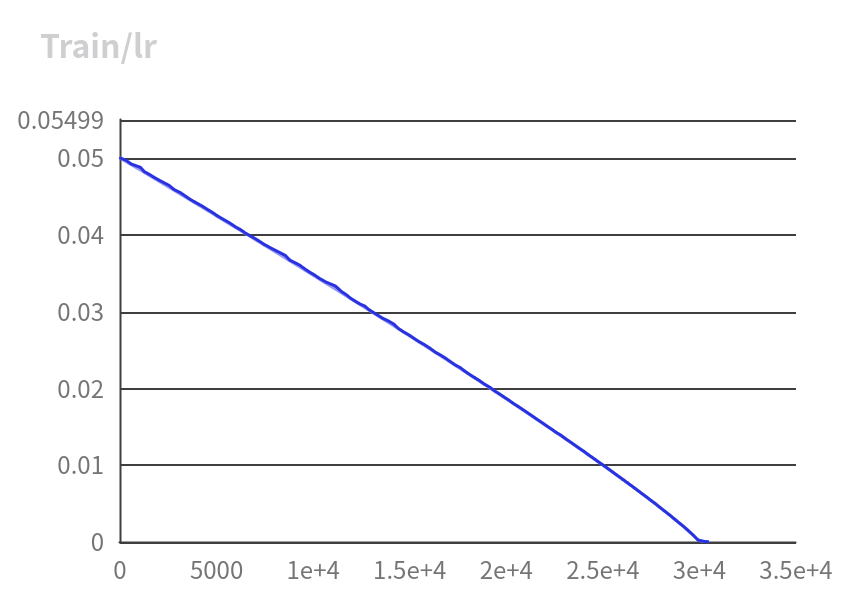
我们对模型进行了 30000 iter 的训练,最好的模型在验证集上的 mDice 为 0.8378,略逊于 Trans-UNet
[EVAL] #Images: 16, Dice: 0.8378, Loss: 0.104690
[EVAL] Class dice:
[0.9964 0.9219 0.905  0.9059 0.7626 0.6477 0.9577 0.7332 0.8827 0.8139 0.7326 0.7938]
[EVAL] The model with the best validation mDice (0.8378) was saved at iter 29000.
以下为训练过程的 loss 曲线、LR 曲线、mDice 曲线,以及验证集上的 mDice 曲线的图表
| 图表 | 图表 |
|---|---|
|
|
|
|
|
|
3. Pipline
完整的 notebook 见:https://aistudio.baidu.com/aistudio/projectdetail/6570400?contributionType=1&sUid=728413&shared=1&ts=1690768740187
这里仅展示代码,如需运行请点击上面的链接
mkdir -p ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training
unzip -oq ~/data/data204195/base_train.zip -d ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training
mv ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training/imagesTr ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training/img
mv ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training/labelsTr ~/PaddleSeg/contrib/MedicalSeg/data/abdomen/abdomen_raw/RawData/RawData/Training/label
然后进行数据预处理,使用我们修改过的数据预处理脚本替换原来的数据预处理脚本(和 Trans-UNet 的一样)
执行数据预处理:
cd ~/PaddleSeg/contrib/MedicalSeg
cp -f ~/prepare_abdomen.py tools/
python tools/prepare_abdomen.py
然后使用我们修改过的模型配置文件进行训练:
_base_: '/home/aistudio/PaddleSeg/contrib/MedicalSeg/configs/_base_/global_configs.yml'

train_dataset:
  type: Abdomen
  dataset_root: abdomen/abdomen_phase0
  result_dir: abdomen/abdomen_phase1
  transforms:
    - type: RandomFlip3D
      flip_axis: [1, 2]
    - type: RandomQuarterTurn3D
      rotate_planes: [[ 1, 2 ]]
    - type: RandomRotation3D
      degrees: 20
      rotate_planes: [[1, 2]]
    - type: Resize3D
      size: [1, 224, 224]
  mode: train
  num_classes: 12

val_dataset:
  type: Abdomen
  dataset_root: abdomen/abdomen_phase0
  result_dir: abdomen/abdomen_phase1
  num_classes: 12
  transforms:
    - type: Resize3D
      size: [1, 224, 224]
  mode: val
  dataset_json_path: data/abdomen/abdomen_raw/dataset.json

test_dataset:
  type: Abdomen
  dataset_root:  abdomen/abdomen_phase0
  result_dir:  abdomen/abdomen_phase1
  num_classes: 12
  transforms:
    - type: Resize3D
      size: [1, 224, 224]
  mode: val
  dataset_json_path: data/abdomen/abdomen_raw/dataset.json
_base_: 'abdomen.yml'

batch_size: 24
iters: 30000

model:
  type: SwinUNet
  backbone:
    type: SwinTransformer_tinier_patch4_window7_224
  num_classes: 12
  pretrained: https://paddleseg.bj.bcebos.com/paddleseg3d/synapse/abdomen/swinunet_abdomen_224_224_1_14k_5e-2/swinunet_pretrained.zip

optimizer:
  type: sgd
  momentum: 0.9
  weight_decay: 1.0e-4

lr_scheduler:
  type: PolynomialDecay
  learning_rate: 0.05
  end_lr: 0
  power: 0.9

loss:
  types:
    - type: MixedLoss
      losses:
        - type: CrossEntropyLoss
        - type: DiceLoss
      coef: [0.4, 0.6]
  coef: [1]

export:
  transforms:
    - type: Resize3D
      size: [ 1 ,224, 224 ]
  inference_helper:
    type: InferenceHelper2D
!python train.py --config ~/swinunet_abdomen_224_224_1_14k_5e-2.yml --do_eval --save_interval 1000 --has_dataset_json False --is_save_data False --num_workers 4 --log_iters 10 --use_vdl # --resume_model output/iter_14000
4. 总结
Swin-UNet 虽然名字里也有 UNet, 但是和 Trans-UNet 不同,它是一个全 Transformer 的网络结构,只不过是 U 型的,非常的新颖,按照论文里的说法它的效果应该是比 Trans-UNet 的效果要好的,但是在我们的数据集上并不是这样的,当然这可能与我们使用的参数也有关系。从图表上看,训练基本收敛了,但是也不排除继续训练能获得更高的 mDice 的可能性。
三、nnUNet
nnU-Net(no-new-Net)提出了3个网络,分别是2D U-Net、3D U-Net和级联Unet,并且这些U-Net只是对原始U-Net进行了很小的修改,并且没有使用各种扩展插件(残差连接、Dense连接还有各种注意力机制),作者认为更多的提升其实在于理解数据,构建一个适配于当前数据集的训练流程,包括数据集的预处理,模型结构的自适应调整,训练策略和推理策略。作者在各种任务上拿这个框架和目前的STOA方法进行了比较,且该方法不需要手动调参。最终nnUNet得到了最高的平均dice。
1. 网络介绍
- 网络结构
nnUNet与UNet的结构类似,只有微小的改动:使用Leaky ReLU(neg.slope 1e-2)取代ReLU,使用Instance normalization取代Batchnormalization,但是nnUNet会根据数据集自适应调整网络结构。
2D和3D U-Net可以生成全分辨率的结果,级联网络的第一级产生一个低分辨率结果,第二级结合第一级的结果进行微调。
级联3D U-Net:为了解决3D U-Net在大图像尺寸数据集上的缺陷,本文提出了级联模型。首先第一级3D U-Net在下采样的图像上进行训练,然后将结果上采样到原始的体素spacing。将上采样的结果作为一个额外的输入通道(独re编码)送入第二级3D U-Net,并使用基于图像块的策略在全分辨率的图像上进行训练。
网络拓扑的动态自适应:由于输入图像大小的不同,输入图像块大小和每个轴池化操作的数量必须能够自适应每个数据集去考虑充足的空间信息聚合。硬件的资源是有限的,因此需要在网络容量和Batch-size上做到权衡。
- 预处理
裁剪:将值为0的区域裁剪丢弃,为0的区域对大部分数据集来说是无用的,裁剪后可以有效地降低计算成本
重采样:不同的设备和设置会导致医学影像数据具有不同体素间距的数据,但CNN不能理解这种体素间距的概念,重采样使数据集的体素间距一致,所有病例都被重采样到相应数据集的体素间距中值,图像数据使用三阶样条差值,mask使用最近邻差值方法。
UNet Cascade采用特殊的Resample策略:中值尺寸大于显存限制下可处理尺寸的4倍时(batch-size=2),采用级联策略,对数据进行下采样(采样2的倍数,直到满足前面的要求);如果该数据集是各向异性的,先降采样高分辨率轴使得三轴相等,然后才对所有轴同时进行下采样直到满足上述要求。
归一化:
对于CT图像,首先搜集mask内的像素值,然后所有的数据截断到这些像素值的[0.5, 99.5]%,然后进行z-score标准化;
对于MRI图像,直接进行z-score标准化。
- 训练
损失函数:损失函数采用Dice_loss + cross entropy loss
其他训练参数:Adam优化器,250个batch/epoch;学习率调整策略:计算训练集和验证集的指数移动平均loss,如果训练集的指数移动平均loss在30个epoch内减少不够5e-3,则学习率衰减5倍;训练停止条件:当验证集指数移动平均loss在60个epoch内减少不够5e-3,或者学习率小于1e-6,则停止训练。
数据增强:用有限的训练数据训练大型神经网络时,必须特别注意防止过拟合。我们通过利用数据增强来解决这个问题:随机旋转、随机缩放、随机弹性变换、伽马校正、镜像。
Patch sampling:因为医疗图像中前景非常的小,使用patch训练很可能出现数据中不包含前景的情况,为了训练的稳定,强制一个batch数据中1/3的数据包含至少一个前景。
2.数据分析
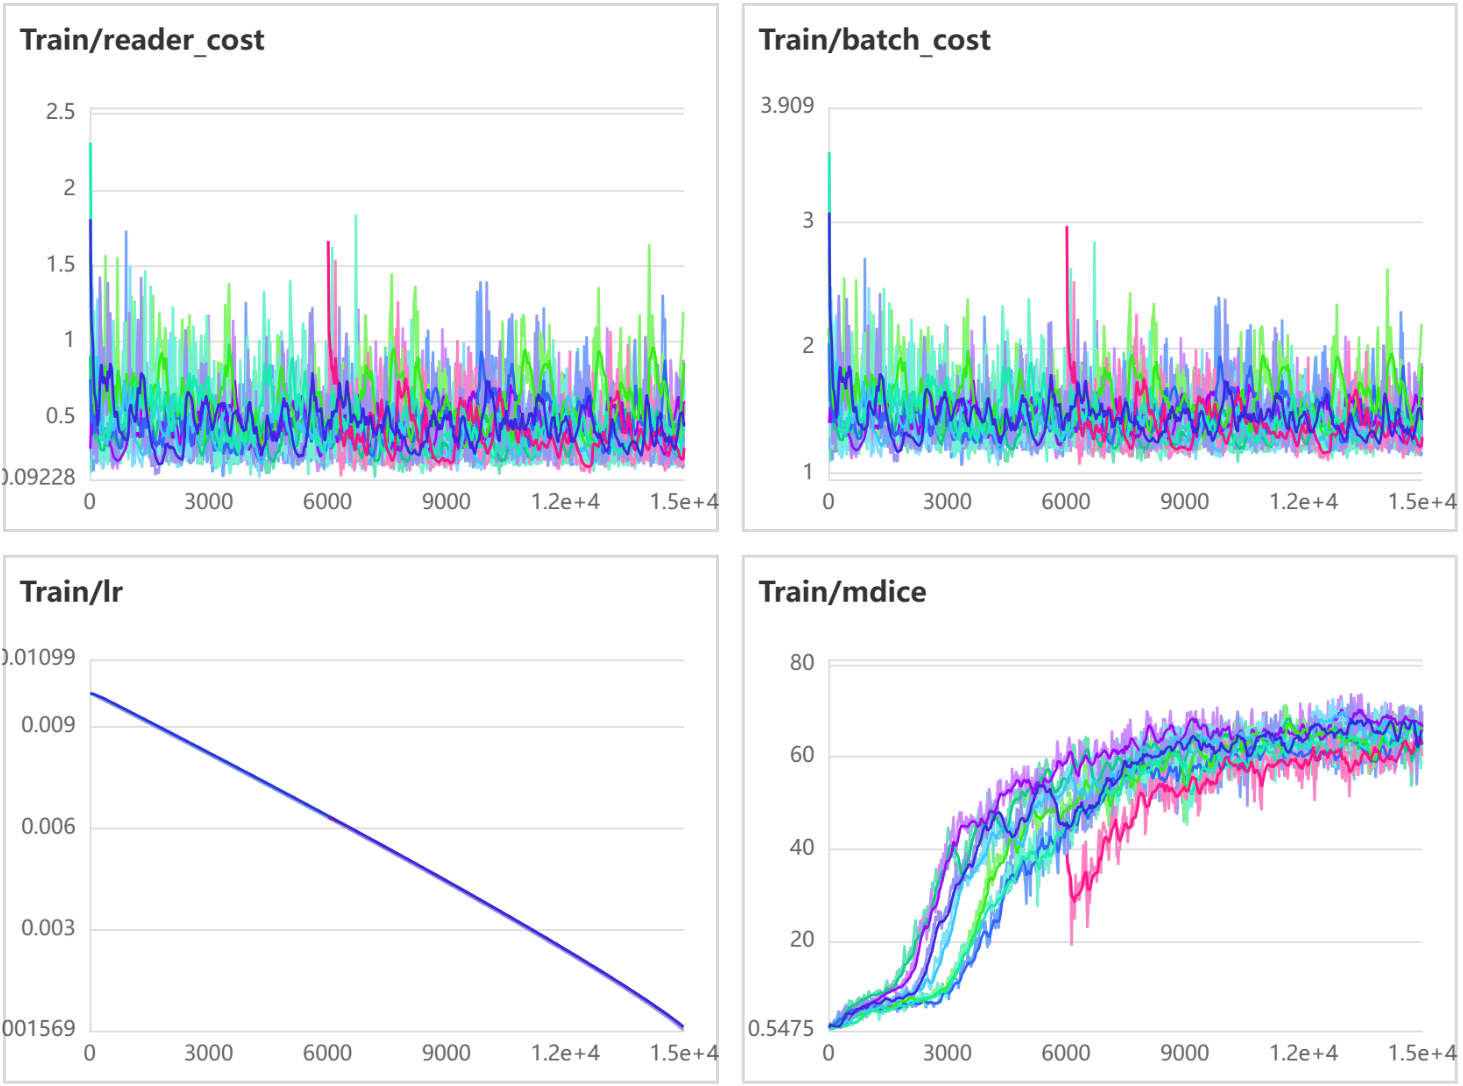
reader_cost:读取数据花费的时间.通过观察这个指标的变化,可以评估模型的计算效率,reade_cost集中在0.5上下,比较均匀。少数在1以上的模型计算负担较重,可能需要考虑优化模型的计算效率。
batch_cost: 网络运行花费的时间。通过观察这个指标的变化,可以评估模型的训练速度。集中在1到2之间,少数的batch_cost较高,可能需要考虑优化模型的训练过程。
lr:这个指标通常表示学习率(learning rate)。学习率是控制模型参数更新的速度,对模型的性能和收敛性有重要影响。通过观察学习率的变化,可以了解模型在训练过程中学习率的调整情况。初始learning rate为0.01,学习率多项式衰减。
mdice:这个指标表示模型在训练过程中的平均dice。Dice是医学图像比赛中使用频率最高的度量指标,它是一种集合相似度度量指标,通常用于计算两个样本的相似度.可以看到随着模型的训练,测试集上的损失函数值在下降并且m_dice在不断的升高,同样说明了模型的训练符合我们想要的预期。
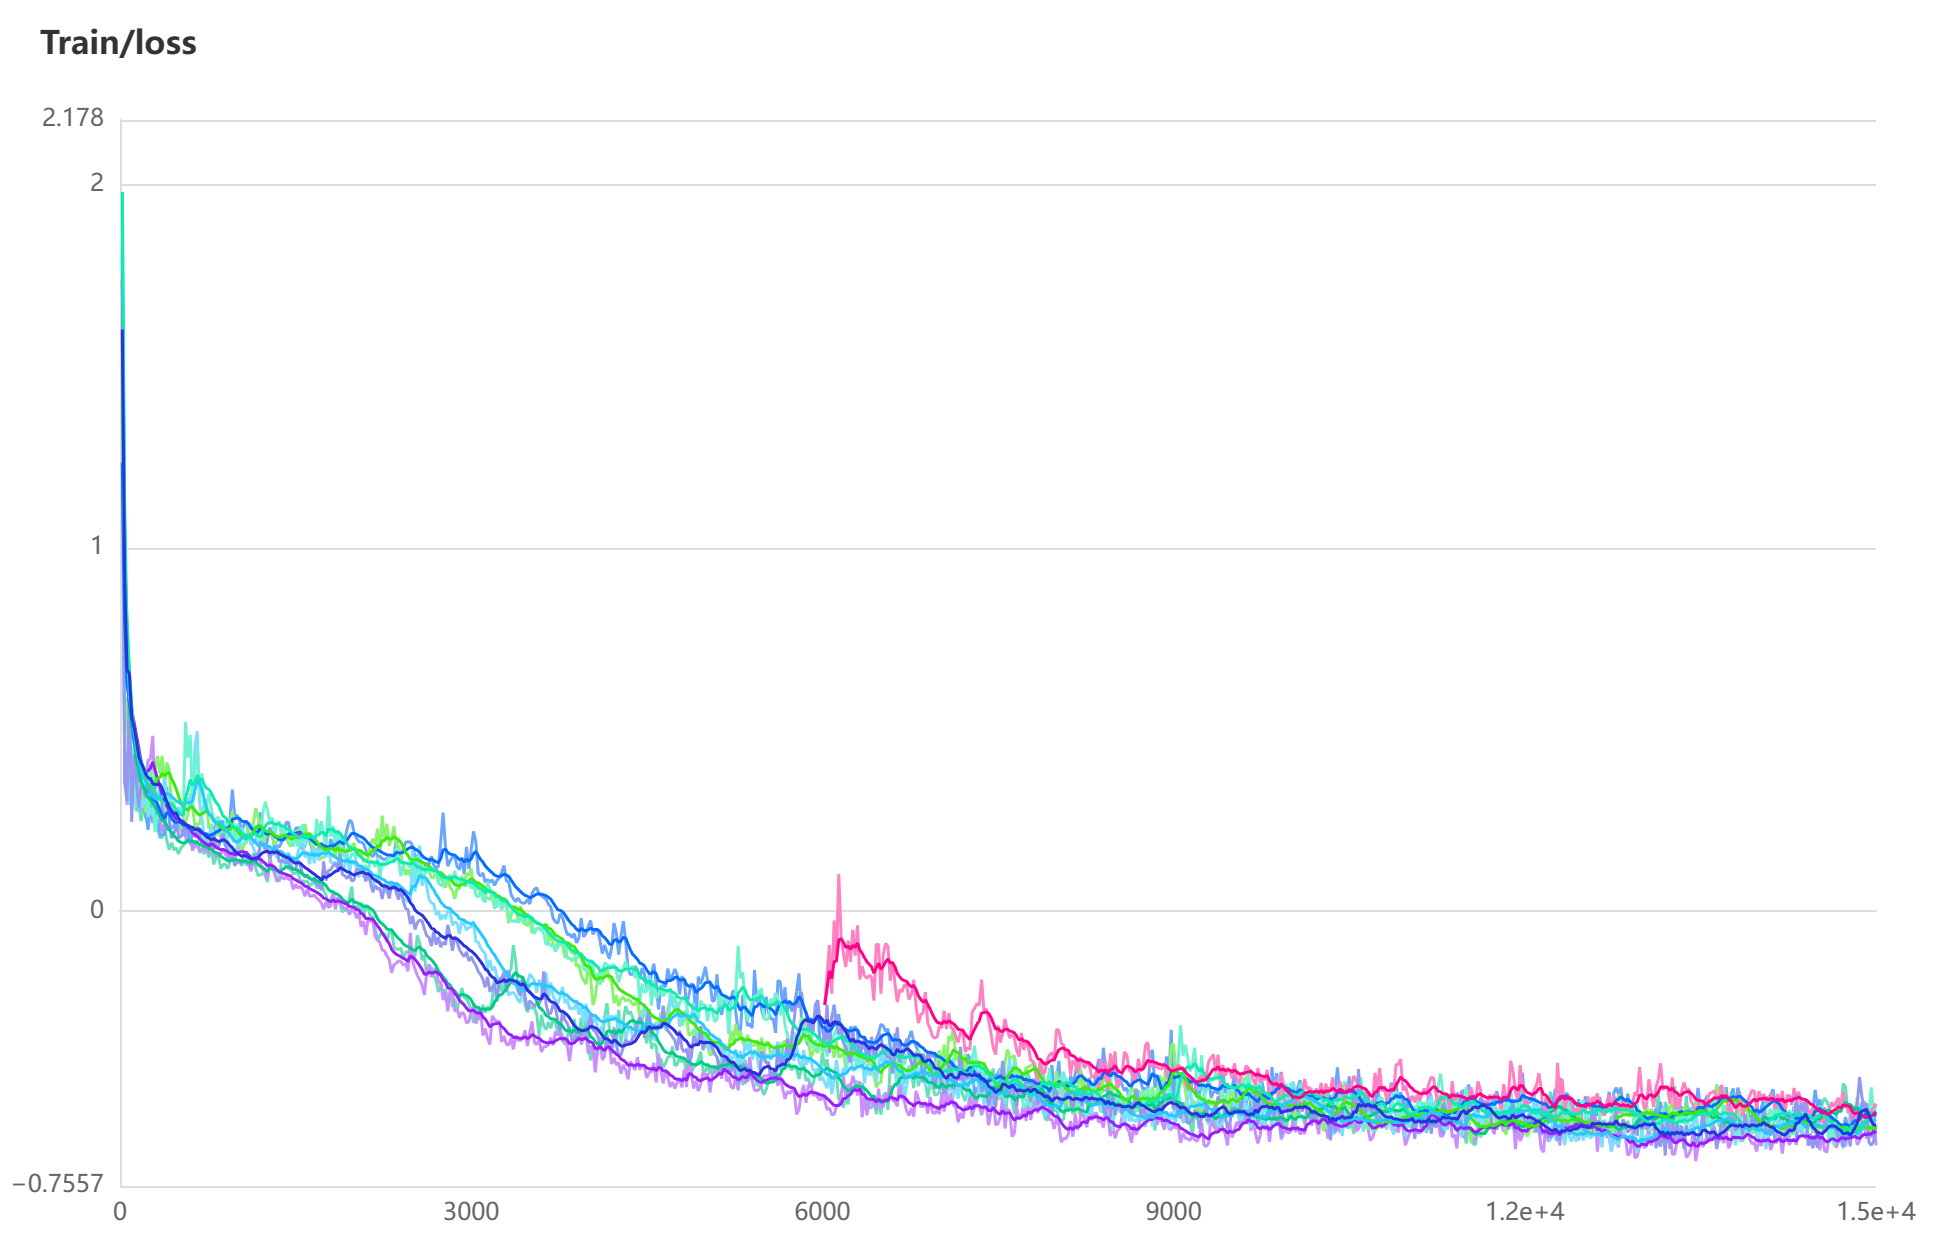
loss:随着网络的训练,损失函数的值趋势是先快速下降,然后缓慢下降并趋于稳定
| fold0 | fold1 | fold2 | fold3 | fold4 | fold5 | fold6 | fold7 | fold8 | fold9 | MEAN | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| aver_dice | 0.8149 | 0.859 | 0.7673 | 0.8083 | 0.8046 | 0.8512 | 0.8497 | 0.8218 | 0.7486 | 0.8405 | 0.82817 |
十折交叉验证结果dice得分都比较高,dice数值越高表示预测结果与真实标签越相似,平均预测结果与真实标签的相似度为0.82817,是一个相对较高的结果。
这里我们计算每个fold下的11类器官的平均dice系数:
| background | spleen | right kidney | left kidney | gall bladder | esophagus | liver | stomach | arota | postcava | pancreas | bladder | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| fold0 | 0.9968 | 0.9268 | 0.6701 | 0.7123 | 0.9249 | 0.9046 | 0.6476 | 0.597 | 0.9516 | 0.7373 | 0.9007 | 0.8096 |
| fold1 | 0.9969 | 0.9458 | 0.7769 | 0.7363 | 0.9378 | 0.9271 | 0.6879 | 0.7291 | 0.9525 | 0.8327 | 0.9316 | 0.8538 |
| fold2 | 0.9966 | 0.9062 | 0.6732 | 0.5976 | 0.8853 | 0.9124 | 0.5037 | 0.5579 | 0.9255 | 0.6896 | 0.8281 | 0.7321 |
| fold3 | 0.9964 | 0.9239 | 0.6318 | 0.6738 | 0.9176 | 0.8715 | 0.5698 | 0.7315 | 0.9366 | 0.7536 | 0.8994 | 0.7942 |
| fold4 | 0.9978 | 0.8986 | 0.6569 | 0.6483 | 0.9357 | 0.9392 | 0.5772 | 0.6436 | 0.947 | 0.7076 | 0.901 | 0.8024 |
| fold5 | 0.9978 | 0.9546 | 0.7421 | 0.8018 | 0.8956 | 0.9237 | 0.6431 | 0.713 | 0.9554 | 0.8401 | 0.9245 | 0.822 |
| fold6 | 0.9976 | 0.9433 | 0.7108 | 0.7724 | 0.9354 | 0.8985 | 0.7668 | 0.71 | 0.9617 | 0.7549 | 0.9244 | 0.8206 |
| fold7 | 0.9975 | 0.9059 | 0.6626 | 0.6245 | 0.9255 | 0.8869 | 0.6365 | 0.7363 | 0.942 | 0.7795 | 0.9365 | 0.8284 |
| fold8 | 0.9967 | 0.7636 | 0.5981 | 0.7239 | 0.8663 | 0.8041 | 0.5346 | 0.5588 | 0.8923 | 0.6455 | 0.8538 | 0.746 |
| fold9 | 0.9979 | 0.8859 | 0.7019 | 0.7785 | 0.9396 | 0.9485 | 0.6715 | 0.6701 | 0.9573 | 0.7792 | 0.9069 | 0.8489 |
3. Pipline
同第一部分前半部分训练步骤
注:nnU-Net 网络的读取过程
训练入口为 nnunet.core.train 函数,这里模型已经准备好,通过参数 cfg.model 传入。
在 ./train.py 第 155 行,对象 cfg 被创建,随后模型在第 190 行通过伪装为属性的方法 cfg.model 传入。
Config 类和 cfg.model 的定义位于 medicalseg\cvlibs\config.py 内。在 320 行中,通过方法 _load_object 创建函数。
阅读 _load_object 方法的定义可以知道,在 yml 文件中,有子属性 type 的对象会被 _load_object 递归读取。注意到官方提供的 yml 文件中,model 部分的定义如下:
model:
  type: NNUNet
  plan_path: data/preprocessed/nnUNetPlansv2.1_plans_3D.pkl
  stage: 0
  cascade: True
说明 NNUNet 作为 model 的一个 type,会在 model 被 _load_object 处理的时候读取,随后,在 medicalseg\cvlibs\config.py 的第 411 行,model['type'] (这里就等于字符串 NNUNet)被传入方法 ._load_component。
_load_component 的定义位于同个文件的第 393 行,随后在该函数中,检查 NNUNet 是否是 com_list 中被定义的模块(即,是否已经储存在哈希表内),如果被定义,则会调用对应的网络。这里 manager.MODELS 是一个预先定义的字典,而 NNUNet 在 MODELS 内,会调用 manager.MODELS['NNUNet'] 构造一个网络(具体为什么 NNUNet 属于 manager.MODELS,见下面一节的解释)。这里 manager.MODELS['NNUNet'] 就等同于文件 medicalseg\models\nnunet.py 中的 NNUNet 类(注意,不是对象)。
回到 medicalseg\cvlibs\config.py 的第 411 行,component 变量被赋值为类名 NNUNet。接下来,在 medicalseg\cvlibs\config.py 的第 413~423 行,yml 文件的其他参数被读取,并在 425 行作为 NNUNet 的形参传入。
也就是说,最终 medicalseg\cvlibs\config.py 的 320 行 _load_object 的返回值,等价于如下函数:
NNUNet(plan_path="data/preprocessed/nnUNetPlansv2.1_plans_3D.pkl", stage=0, cascade=True)
其中大部分 NNUNet 的参数已经储存在序列化文件 .pkl 内,里面压缩了一个字典。在 NNUNet 初始化时,该文件会被读取,也将根据这个文件设置参数的值。
最后这个已经初始化的 NNUNet 对象通过参数 cfg.model 返回,在 ./train.py 的第 190 行被传入 nnunet.core.train 函数,随后开始网络训练。
所以修改网络构造时,直接修改 medicalseg\models\nnunet.py 中 NNUNet 的定义即可。
NNUNet 被写入 manager.MODELS 的过程
manager 是一个辅助管理器,用于通过字符串调用对应的网络。它们于文件 medicalseg\cvlibs\manager.py 中被定义。在 MedicalSeg 中,一共定义了五个辅助 manager,都在文件 medicalseg\cvlibs\manager.py 中定义,其中 MODELS 与网络有关:
MODELS = ComponentManager("models")
在别的文件中调用这一对象时,通常加上文件名写成 manager.MODELS。
manager.MODELS 内储存了一个字典,调用网络时就从字典中提取网络。manager.MODELS['NNUNet'] 便通过字典返回了 NNUNet 这个网络。
那么 NNUNet 是如何加入字典内的呢?可以看到,medicalseg\models\nnunet.py 的 NNUNet 在被定义时,开头有一个修饰器:
@manager.MODELS.add_component
class NNUNet(nn.Layer):
    ...
正是这个修饰器将 NNUNet 写入了 manager.MODELS 内。这里上面的代码等价于如下代码:
class NNUNet(nn.Layer): # 定义了一个 NNUNet 类
    ...

NNUNet = manager.MODELS.add_component(NNUNet) # 传入 add_component 方法
而这里的 add_component 方法就将定义好的 NNUNet 类储存在了它的字典中。之后 manager.MODELS['NNUNet'] 就会返回 NNUNet 这个类。
四、VNet
1. 网络介绍
V-Net 是 U-Net 的一个改进网络,在结构上十分类似于 U-Net,也是一个主要用于医学图像分割的网络。相比于 U-Net,V-Net 的主要改进如下:
- V-Net 是针对3D图像提出的模型,而 U-Net 是针对 2D 图像提出的模型。类似于 NNUNet,VNet 使用了 Conv 3D 代替了 Conv 2D。
- V-Net 模仿 ResNet 引入了残差连接,用 PReLU 激活函数代替了 ReLU 函数,以增强网络的表达能力和收敛速度。
- V-Net 使用了一个 2x2 Conv 层代替下采样的池化(MaxPooling)层,进一步增强信息提取和抽象的能力。
V-Net 和 nnUNet 也有许多相似之处:
- V-Net 和 nnUNet 都是基于U-Net结构的 3D 医学图像分割网络。
- V-Net 和 nnUNet 都使用了Dice Loss 作为损失函数,可以处理前景和背景像素的数量不平衡的情况。
V-Net 的网络结构如图所示,作者将 U 形换成了 V 形,但本质上都是一个中间细两边粗的结构:
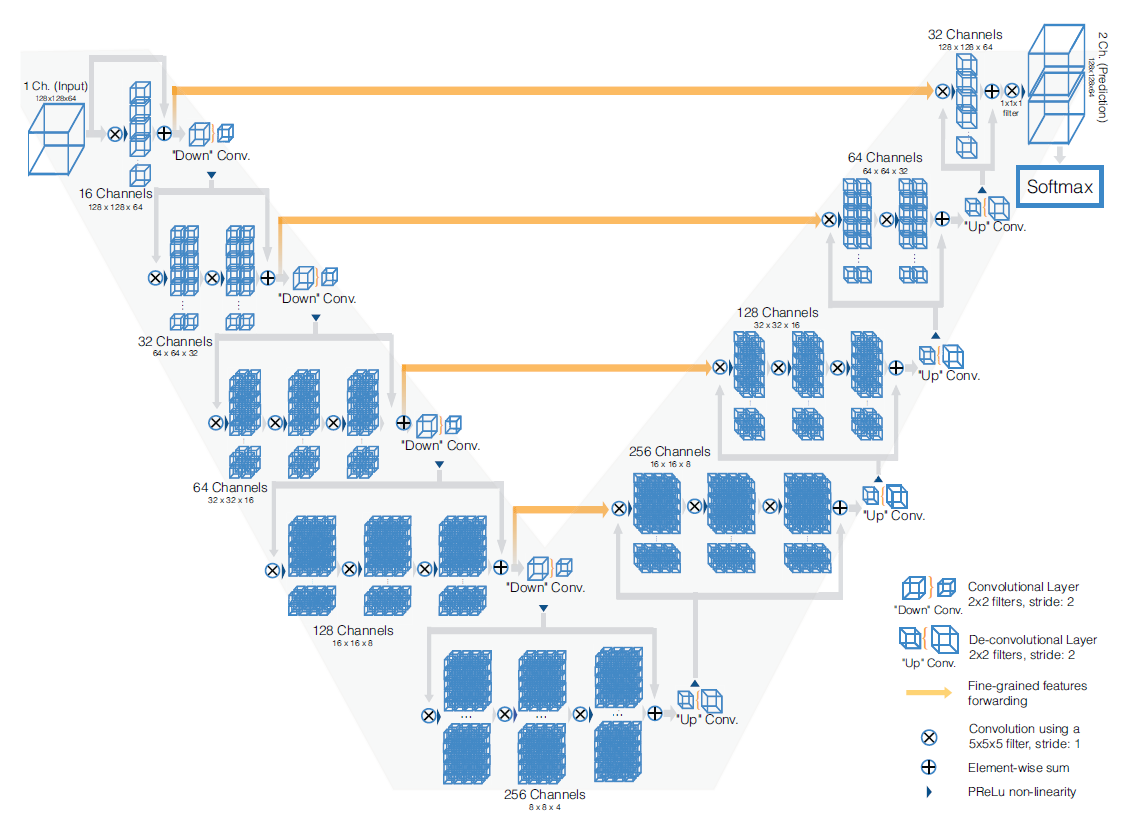
V-Net 的原始论文可参考链接 https://ieeexplore.ieee.org/abstract/document/7785132/
2. 数据结果分析
我们采用了 SGD 优化器,初始学习率取 0.05 并采用多项式衰减,进行了 30000 次 iter 的循环后,V-Net 的训练曲线如下:
| val dice | loss |
|---|---|
|
|
|
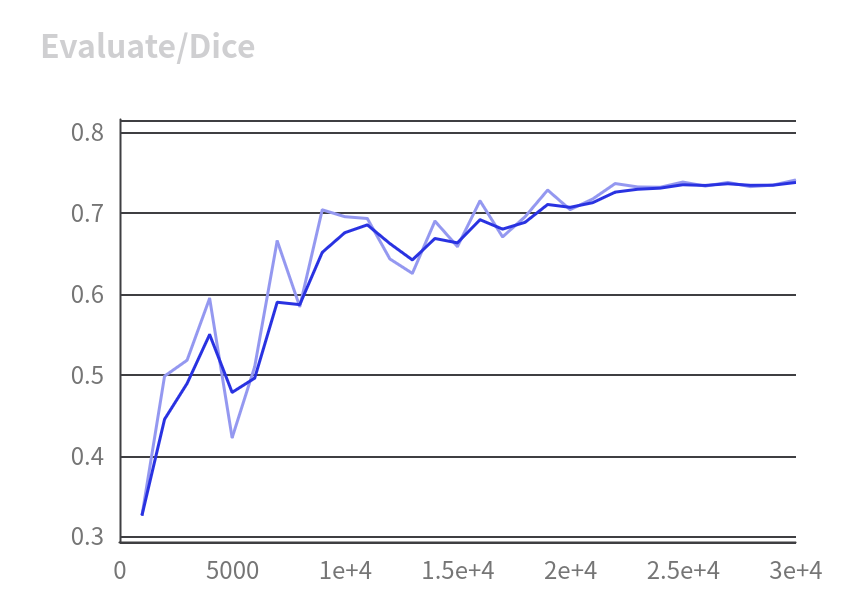
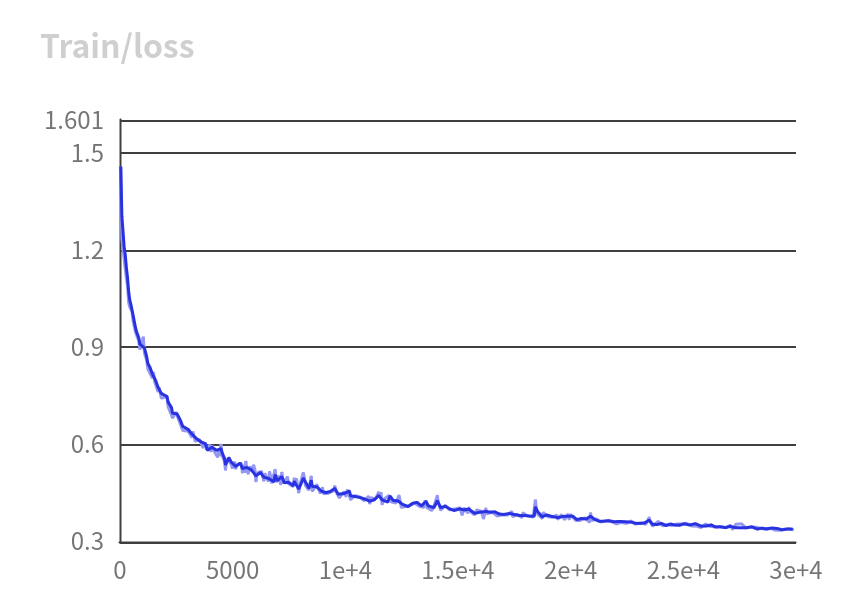
各个类别的 dice 值:
| background | spleen | right kidney | left kidney | gall bladder | esophagus | liver | stomach | arota | postcava | pancreas | bladder | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| dice(online) | 0.9945 | 0.8183 | 0.855 | 0.8588 | 0.4388 | 0.2249 | 0.9441 | 0.7753 | 0.8678 | 0.7536 | 0.6404 | 0.7198 |
从结果可以看出,V-Net 的 dice 最终只能达到 0.74 左右,不及 nnUNet baseline 的 0.8。结合 V-Net 论文并与 nnUNet 比较,我们可以认为 V-Net 的重心仍然放在网络结构的改进上。这些改进可能使得网络的效果略优于 U-Net,但仍然比不上两阶段训练的 nnUNet。
3. Pipline
具体的训练过程请参考我们的 VNet 训练项目:https://aistudio.baidu.com/aistudio/projectdetail/6588983 ,这里我们仅展示主要的数据处理和训练过程。
我们的数据预处理的过程和网络的配置参考了第十四届中国大学生服务外包创新创业大赛百度赛道的 baseline 代码(地址: https://aistudio.baidu.com/aistudio/projectdetail/5124112 )。
克隆仓库 PaddleSeg 并安装必要的 Python 包之后,首先将数据解压到指定位置:
mkdir -p ~/PaddleSeg/contrib/MedicalSeg/data/competition_raw/competition_dataset
unzip -oq ~/data/data204195/base_train.zip -d ~/PaddleSeg/contrib/MedicalSeg/data/competition_raw/competition_dataset
然后进行数据预处理,在家目录准备好与处理文件 prepare_data.py,将原始数据处理为 lung_coronaviurs 数据集格式:
cp ~/prepare_data.py ~/PaddleSeg/contrib/MedicalSeg/tools
cd ~/PaddleSeg/contrib/MedicalSeg
python tools/prepare_data.py
再准备一份网络配置文件 vnet.yml,同样置于 /home/aistudio 目录。prepare_data.py 和 vnet.yml 文件较大,在此不作展示,请点进项目链接查看文件。
然后便可以开始训练:
cd ~/PaddleSeg/contrib/MedicalSeg
python train.py --config ~/vnet.yml \
    --save_dir  output_vnet \
    --save_interval 200 --log_iters 5 \
    --num_workers 4 --do_eval --use_vdl \
    --keep_checkpoint_max 5  --seed 0 # --resume_model ./output_vnet/iter_13200
训练的参数将保存在 ~/PaddleSeg/contrib/MedicalSeg/vnet.yml,如果中途意外退出,可以从该文件夹读取参数继续训练。
4. 总结
VNet 的 dice 只有0.7左右,不及 nnUNet 的 dice 。这可能说明 VNet 的网络结构和训练策略不够优化,无法适应不同的数据集和任务。同时,VNet 作为一个较为简单的网络,参数量与 nnUNet 相当,相比其他 Transformer 网络并不多。但也不排除继续经过适当调参后 Dice 继续提升的可能。
VNet 作为一个轻量语义分割网络,有望继续在小型设备或实时任务中取得应用。
五、UNETR
1. 网络介绍
UNETR 是一种用于 3D 医学图像分割的新型架构。它利用 Transformer 作为编码器来学习输入体积的序列表示,并有效地捕获全局多尺度信息,同时也遵循了成功的“U 形”网络设计。Transformer 编码器直接通过不同分辨率的跳跃连接连接到解码器,以计算最终的语义分割输出。它在 Multi Atlas Labeling Beyond The Cranial Vault (BTCV) 数据集上进行了多器官分割,并在 Medical Segmentation Decathlon (MSD) 数据集上进行了脑肿瘤和脾脏分割任务的性能验证。它在 BTCV 排行榜上展示了新的最先进性能。
UNETR 的意思是 U-shape Net Transformer,实质上只采用了 U 形结构,和 U-Net 没有直接的联系。UNETR 的网络结构如图所示:
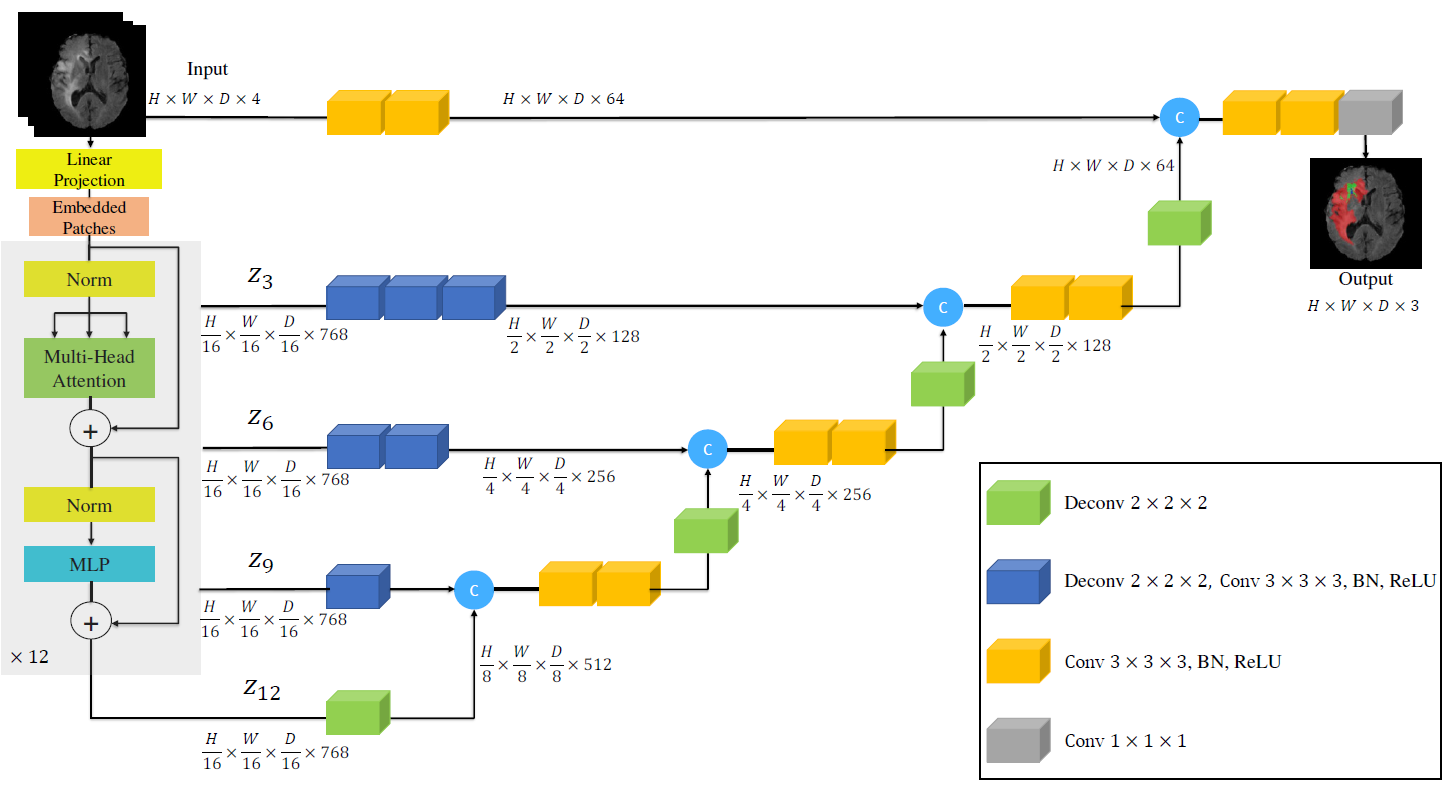
该网络的具体设计思路可以参考原论文 https://openaccess.thecvf.com/content/WACV2022/html/Hatamizadeh_UNETR_Transformers_for_3D_Medical_Image_Segmentation_WACV_2022_paper.html
2. 数据结果分析
采用 SGD 优化器,初始学习率为 0.05,训练 30000 个 iters 后,dice 和 loss 的变化如下:
| val dice | cross entropy | train dice loss |
|---|---|---|
|
|
|
|
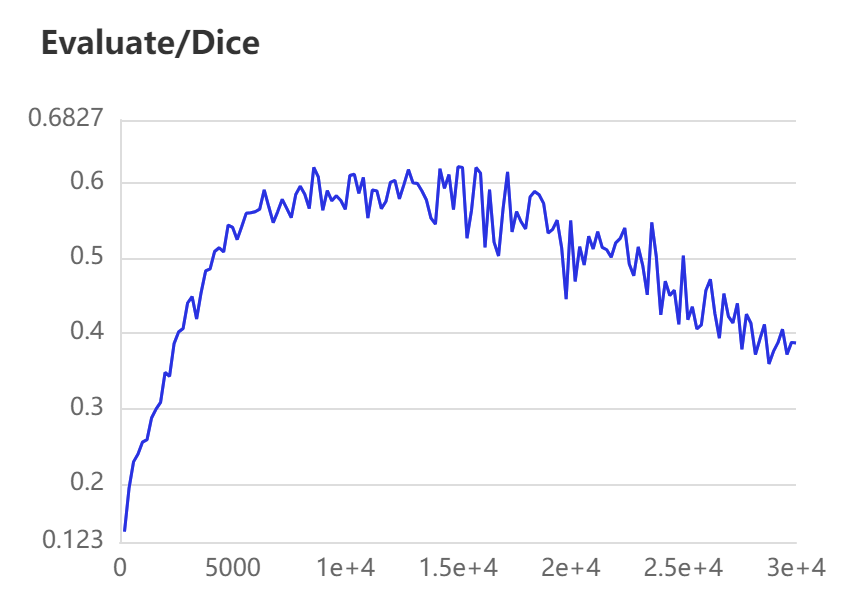
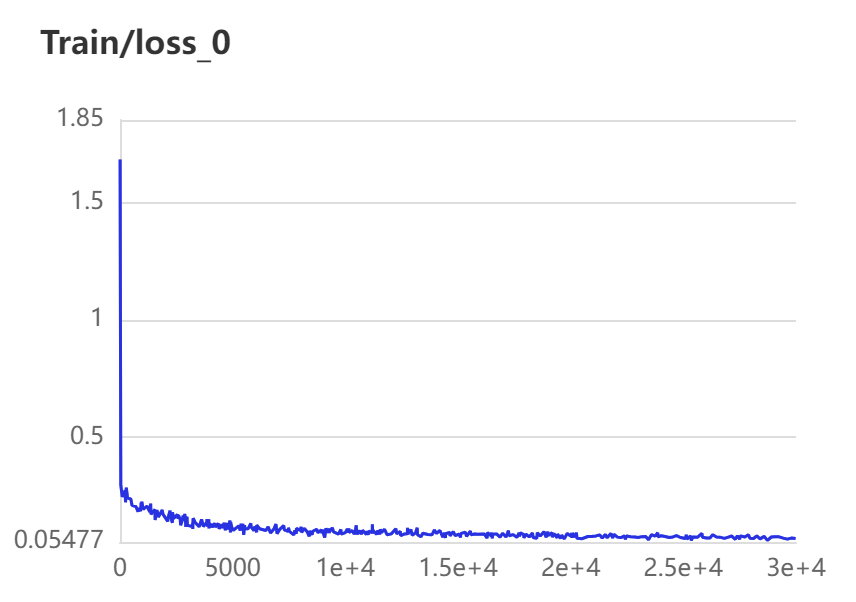
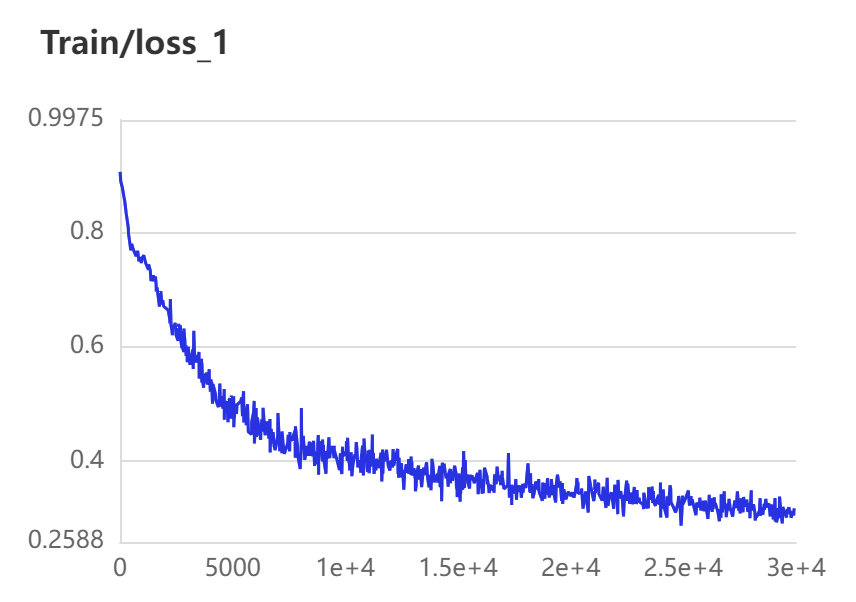
最优模型经过验证后,各个类别 dice 值为:
| background | spleen | right kidney | left kidney | gall bladder | esophagus | liver | stomach | arota | postcava | pancreas | bladder | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| dice(online) | 0.9911 | 0.7708 | 0.6734 | 0.6834 | 0.3001 | 0.1243 | 0.8765 | 0.578 | 0.7674 | 0.532 | 0.5385 | 0.6123 |
验证集上最优的 dice 停留在约 15000 iters 附近,最优的 dice 只达到 0.62,甚至不及没有引入 Transformer 的 VNet。
在 15000 iters 之后,尽管训练集上的 loss (包括交叉熵损失和 dice loss)都在下降优化,验证集上的 dice 却也不断下降,显示出过拟合的迹象。
由于训练资源的限制,我们并没有进一步调整参数,可能存表现更好的超参数。
3. Pipline
训练过程与 VNet 十分接近,不再阐述,仅仅需要将 yml 对应的模型修改为 UNETR:
model:
  type: UNETR
  img_shape: (128, 128, 128)
  in_channels: 1
  num_classes: 12
  embed_dim: 768
  patch_size: 16
  num_heads: 12
  dropout: 0.1
详细的训练过程见这一项目: https://aistudio.baidu.com/aistudio/projectdetail/6592278
4. 总结
UNETR 是一种用于 3D 医学图像分割的新型架构,它利用 Transformer 作为编码器来学习输入体积的序列表示,并有效地捕获全局多尺度信息,同时也遵循了成功的“U 型”网络设计。不过在我们的数据集上,UNETR 并没有取得很好的效果,其超参数配置和网络结构还存在进一步优化的空间。
六、nnFormer
1. 网络介绍
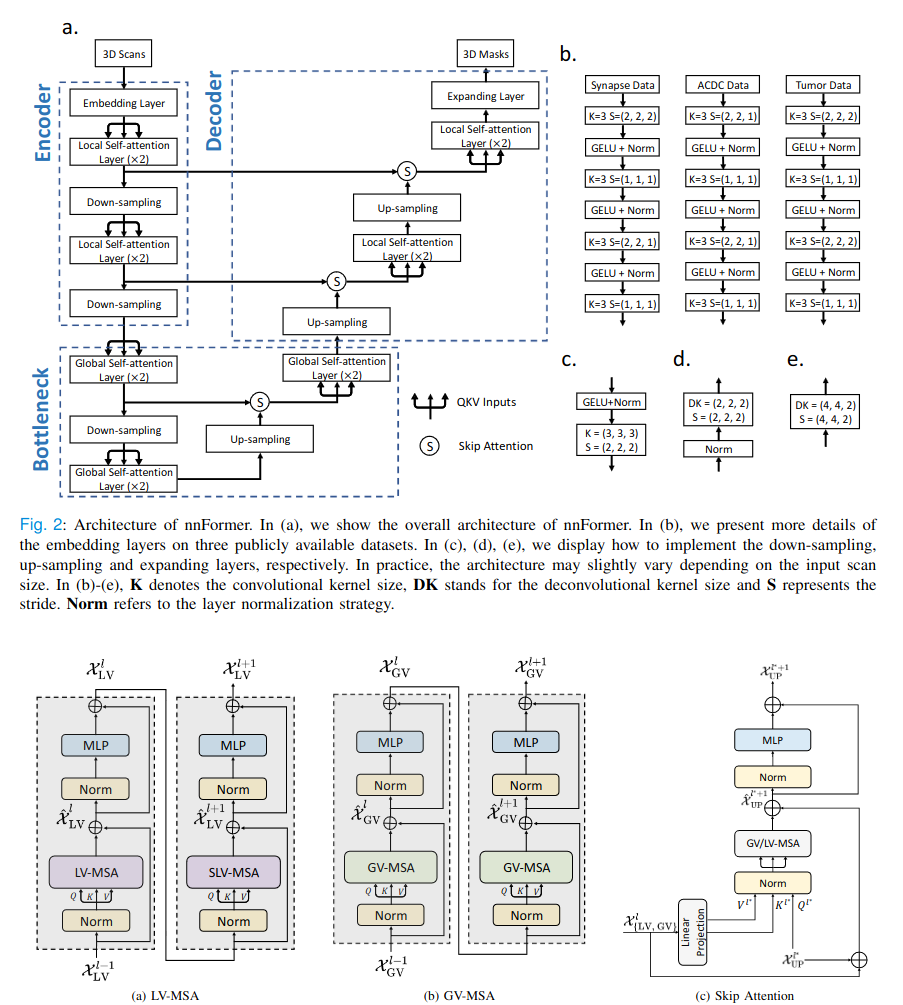
在自然语言处理领域,Transformer 已成为首选模型,但在医学图像处理领域却受到了很少的关注。鉴于 Transformer 能够利用较长的依赖关系,它有望帮助克服传统卷积神经网络在空间归纳偏差方面固有的缺点。然而,大多数最近提出的基于 Transformer 的分割方法只是将 Transformer 简单地视为辅助模块,用于将全局上下文编码为卷积表示。而 nnFormer 则是一种用于体积医学图像分割的 3D Transformer。
nnFormer 不仅利用交错的卷积和自注意操作的组合,还引入了基于局部和全局体积的自注意机制,用于学习体积表示。此外,nnFormer 提出使用跳跃注意(skip attention)来替代 U-Net 类似架构中跳跃连接中传统的连接/求和操作。实验表明,nnFormer 在三个公共数据集上显著优于之前基于 Transformer 的方法。
nnFormer 的网络架构如下图所示:
https://arxiv.org/abs/2109.03201
2. Pipline
完整的 notebook 见:https://aistudio.baidu.com/aistudio/projectdetail/6544295?contributionType=1&sUid=728413&shared=1&ts=1690769220517
这里仅展示代码,如需运行请点击上面的链接
首先解压数据集
mkdir -p ~/PaddleSeg/contrib/MedicalSeg/data/ACDCDataset/training
unzip -oq ~/data/data204195/base_train.zip -d ~/PaddleSeg/contrib/MedicalSeg/data/ACDCDataset/training
rm -rf ~/PaddleSeg/contrib/MedicalSeg/data/ACDCDataset/training/.ipynb_checkpoints
然后根据我们的数据集修改原有的数据预处理脚本,我们做出的改动如下:
--- prepare_acdc.py	2023-07-10 18:04:47.502445344 +0800
+++ prepare_data.py	2023-07-29 19:50:39.335975885 +0800
@@ -1,3 +1,5 @@
+# Adapted From https://github.com/PaddlePaddle/PaddleSeg/blob/develop/contrib/MedicalSeg/tools/prepare_acdc.py
+
 #    Copyright 2022 Division of Medical Image Computing, German Cancer Research Center (DKFZ), Heidelberg, Germany
 #
 #    Licensed under the Apache License, Version 2.0 (the "License");
@@ -12,12 +14,16 @@
 #    See the License for the specific language governing permissions and
 #    limitations under the License.

+BASE_DIR = '/home/aistudio/PaddleSeg/contrib/MedicalSeg'
+
+
 import nibabel as nib
 import shutil
 import os.path as osp
 from preprocess_utils.file_and_folder_operations import *
 from preprocess_utils.geometry import *
 from preprocess_utils.path_utils import join_paths
+import numpy as np

 from tqdm import tqdm

@@ -28,7 +34,7 @@
     def __init__(self,
                  dataset_root=f"data/ACDCDataset",
                  raw_dataset_dir=f"training/",
-                 clean_dataset_dir=f"clean_data",
+                 clean_dataset_dir=f"training/",
                  phase_dir=f"ACDCDataset_phase0"):
         super().__init__()

@@ -36,7 +42,7 @@
         self.clean_folder = join_paths(dataset_root, clean_dataset_dir)
         self.phase_path = join_paths(dataset_root, phase_dir)

-    def generate_txt(self, split=0.2):
+    def generate_txt(self, split=0.1):
         """generate the train_list.txt and val_list.txt"""

         txtname = [
@@ -76,7 +82,7 @@
                                   np.array(shape))).astype(int)
             new_data_array = resize_image(data_arrary, new_shape)
             new_label_array = resize_segmentation(label_array, new_shape)
-            #将数据从hwd转化为dhw
+            #????hwd???dhw
             new_data_array = np.transpose(new_data_array, [2, 0, 1])
             new_label_array = np.transpose(new_label_array, [2, 0, 1])
             np.save(
@@ -88,34 +94,6 @@
                            filename.replace(r".nii.gz", '.npy')),
                 new_label_array)

-    def clean_raw_data(self):
-
-        maybe_mkdir_p(join(self.clean_folder, "imagesTr"))
-        maybe_mkdir_p(join(self.clean_folder, "labelsTr"))
-
-        # train
-        all_train_files = []
-        patient_dirs_train = subfolders(self.folder, prefix="patient")
-        for p in patient_dirs_train:
-            current_dir = p
-            data_files_train = [
-                i for i in subfiles(
-                    current_dir, suffix=".nii.gz")
-                if i.find("_gt") == -1 and i.find("_4d") == -1
-            ]
-            corresponding_seg_files = [
-                i[:-7] + "_gt.nii.gz" for i in data_files_train
-            ]
-            for d, s in zip(data_files_train, corresponding_seg_files):
-                patient_identifier = os.path.split(d)[1][:-7]
-                all_train_files.append(patient_identifier + "_0000.nii.gz")
-                shutil.copy(d,
-                            join(self.clean_folder, "imagesTr",
-                                 patient_identifier + "_0000.nii.gz"))
-                shutil.copy(s,
-                            join(self.clean_folder, "labelsTr",
-                                 patient_identifier + "_0000.nii.gz"))
-

 if __name__ == '__main__':
     if len(sys.argv) == 2:
@@ -123,6 +101,5 @@
     else:
         prep = PrepACDC()
     new_spacing = [1.52, 1.52, 6.35]
-    prep.clean_raw_data()
     prep.load_save(new_spacing)
-    prep.generate_txt()
+    prep.generate_txt()
\ No newline at end of file
执行数据预处理:
cd ~/PaddleSeg/contrib/MedicalSeg/
cp ~/prepare_data.py ~/PaddleSeg/contrib/MedicalSeg/tools
python tools/prepare_data.py
数据预处理需要很长时间,请耐心等待
为了让 nnFormer 能够在我们的数据集上运行起来,我们比对着 nnFormer 原始的 pytorch 代码修正了 paddleseg 的 nnFormer 代码:
我们做出的改动如下:
--- nnformer.py 2023-07-10 18:04:47.489109427 +0800
+++ nnformerNew.py 2023-07-29 19:58:58.977840957 +0800
@@ -16,6 +16,11 @@
# See the License for the specific language governing permissions and
# limitations under the License.
+from medicalseg.utils import utils
+from medicalseg.cvlibs import manager
+import paddle.nn.functional as F
+import paddle.nn as nn
+import paddle
import os
import sys
import numpy as np
@@ -24,81 +29,9 @@
sys.path.append(
os.path.join(os.path.dirname(os.path.realpath(__file__)), "../.."))
-import paddle
-import paddle.nn as nn
-import paddle.nn.functional as F
-from medicalseg.cvlibs import manager
-from medicalseg.utils import utils
-
-
-class PatchMerging(nn.Layer):
- def __init__(self, dim, norm_layer=nn.LayerNorm, tag=None):
- super().__init__()
- self.dim = dim
- if tag == 0:
- self.reduction = nn.Conv3D(
- dim,
- dim * 2,
- kernel_size=[1, 3, 3],
- stride=[1, 2, 2],
- padding=[0, 1, 1])
- elif tag == 1:
- self.reduction = nn.Conv3D(
- dim,
- dim * 2,
- kernel_size=[3, 3, 3],
- stride=[2, 2, 2],
- padding=[1, 1, 1])
- else:
- self.reduction = nn.Conv3D(
- dim,
- dim * 2,
- kernel_size=[3, 3, 3],
- stride=[2, 2, 2],
- padding=[0, 1, 1])
-
- self.norm = norm_layer(dim)
-
- def forward(self, x, S, H, W):
- B, L, C = x.shape
- assert L == H * W * S, "input feature has wrong size"
- x = x.reshape([B, S, H, W, C])
- x = F.gelu(x)
- x = self.norm(x)
- x = x.transpose([0, 4, 1, 2, 3])
- x = self.reduction(x)
- x = x.transpose([0, 2, 3, 4, 1]).reshape((B, -1, 2 * C))
- return x
-
-
-class PatchExpanding(nn.Layer):
- def __init__(self, dim, norm_layer=nn.LayerNorm, tag=None):
- super().__init__()
- self.dim = dim
- self.norm = norm_layer(dim)
- assert tag in [0, 1, 2
- ], "Invalid `tag` value! `tag` must be 0, 1, or 2."
- if tag == 0:
- self.up = nn.Conv3DTranspose(dim, dim // 2, [1, 2, 2], [1, 2, 2])
- elif tag == 1:
- self.up = nn.Conv3DTranspose(dim, dim // 2, [2, 2, 2], [2, 2, 2])
- elif tag == 2:
- self.up = nn.Conv3DTranspose(
- dim, dim // 2, [2, 2, 2], [2, 2, 2], output_padding=[1, 0, 0])
-
- def forward(self, x, S, H, W):
- B, L, C = x.shape
- assert L == H * W * S, "input feature has wrong size"
-
- x = x.reshape((B, S, H, W, C))
-
- x = self.norm(x)
- x = x.transpose((0, 4, 1, 2, 3))
- x = self.up(x)
- x = x.transpose((0, 2, 3, 4, 1)).reshape((B, -1, C // 2))
-
- return x
+def to_3tuple(x):
+ return (x, x, x)
class MLP(nn.Layer):
@@ -148,25 +81,144 @@
def window_partition(x, window_size):
B, S, H, W, C = x.shape
x = x.reshape([
- B, S // window_size[0], window_size[0], H // window_size[1],
- window_size[1], W // window_size[2], window_size[2], C
+ B, S // window_size, window_size, H // window_size,
+ window_size, W // window_size, window_size, C
])
x = x.transpose([0, 1, 3, 5, 2, 4, 6, 7])
- x = x.reshape([-1, window_size[0], window_size[1], window_size[2], C])
+ x = x.reshape([-1, window_size, window_size, window_size, C])
return x
def window_reverse(windows, window_size, S, H, W):
B = int(windows.shape[0] /
- (S * H * W / window_size[0] / window_size[1] / window_size[2]))
+ (S * H * W / window_size / window_size / window_size))
x = windows.reshape(
- (B, S // window_size[0], H // window_size[1], W // window_size[2],
- window_size[0], window_size[1], window_size[2], -1))
+ (B, S // window_size, H // window_size, W // window_size,
+ window_size, window_size, window_size, -1))
x = x.transpose((0, 1, 4, 2, 5, 3, 6, 7)).reshape((B, S, H, W, -1))
return x
+class SwinTransformerBlock_kv(nn.Layer):
+ def __init__(self,
+ dim,
+ input_resolution,
+ num_heads,
+ window_size=7,
+ shift_size=0,
+ mlp_ratio=4.,
+ qkv_bias=True,
+ qk_scale=None,
+ drop=0.,
+ attn_drop=0.,
+ drop_path=0.,
+ act_layer=nn.GELU,
+ norm_layer=nn.LayerNorm):
+ super().__init__()
+ self.dim = dim
+ self.input_resolution = input_resolution
+ self.num_heads = num_heads
+ self.window_size = window_size
+ self.shift_size = shift_size
+ self.mlp_ratio = mlp_ratio
+ if min(self.input_resolution) <= self.window_size:
+ self.shift_size = 0
+ self.window_size = min(self.input_resolution)
+ assert 0 <= self.shift_size < self.window_size, "shift_size must in 0-window_size"
+
+ self.norm1 = norm_layer(dim)
+ self.attn = WindowAttention_kv(
+ dim,
+ window_size=to_3tuple(self.window_size),
+ num_heads=num_heads,
+ qkv_bias=qkv_bias,
+ qk_scale=qk_scale,
+ attn_drop=attn_drop,
+ proj_drop=drop)
+
+ self.drop_path = DropPath(drop_path) if drop_path > 0. else nn.Identity(
+ )
+ self.norm2 = norm_layer(dim)
+ mlp_hidden_dim = int(dim * mlp_ratio)
+ self.mlp = MLP(in_features=dim,
+ hidden_features=mlp_hidden_dim,
+ act_layer=act_layer,
+ drop=drop)
+
+ def forward(self, x, mask_matrix, skip=None, x_up=None):
+ B, L, C = x.shape
+ S, H, W = self.input_resolution
+ assert L == S * H * W, "input feature has wrong size"
+
+ shortcut = x
+ skip = self.norm1(skip)
+ x_up = self.norm1(x_up)
+
+ skip = skip.reshape((B, S, H, W, C))
+ x_up = x_up.reshape((B, S, H, W, C))
+ x = x.reshape((B, S, H, W, C))
+ # Pad feature maps to multiples of window size
+ pad_r = (
+ self.window_size - W % self.window_size) % self.window_size
+ pad_b = (
+ self.window_size - H % self.window_size) % self.window_size
+ pad_g = (
+ self.window_size - S % self.window_size) % self.window_size
+
+ skip = F.pad(skip, (0, pad_r, 0, pad_b, 0, pad_g), data_format="NDHWC")
+ _, Sp, Hp, Wp, _ = skip.shape
+ x_up = F.pad(x_up, (0, pad_r, 0, pad_b, 0, pad_g), data_format="NDHWC")
+
+ # cyclic shift
+ if self.shift_size > 0:
+ skip = paddle.roll(skip, shifts=(-self.shift_size, -
+ self.shift_size, -self.shift_size), dims=(1, 2, 3))
+ x_up = paddle.roll(x_up, shifts=(-self.shift_size, -
+ self.shift_size, -self.shift_size), dims=(1, 2, 3))
+ attn_mask = mask_matrix
+ else:
+ skip = skip
+ x_up = x_up
+ attn_mask = None
+
+ skip = window_partition(skip, self.window_size)
+ skip = skip.reshape((-1, self.window_size * self.window_size *
+ self.window_size, C))
+ x_up = window_partition(x_up, self.window_size)
+ x_up = x_up.reshape((-1, self.window_size * self.window_size *
+ self.window_size, C))
+ # W-MSA/SW-MSA
+ attn_windows = self.attn(skip, x_up, mask=attn_mask, pos_embed=None)
+
+ attn_windows = attn_windows.reshape(
+ (-1, self.window_size, self.window_size, self.window_size,
+ C))
+ shifted_x = window_reverse(attn_windows, self.window_size, Sp, Hp,
+ Wp) # B H' W' C
+
+ if self.shift_size > 0:
+ x = paddle.roll(
+ shifted_x,
+ shifts=(self.shift_size, self.shift_size,
+ self.shift_size),
+ axis=(1, 2, 3))
+ else:
+ x = shifted_x
+
+ if pad_r > 0 or pad_b > 0 or pad_g > 0:
+ x = x[:, :S, :H, :W, :]
+
+ x = x.reshape((B, S * H * W, C))
+
+ # FFN
+ x = shortcut + self.drop_path(x)
+ x = x + self.drop_path(self.mlp(self.norm2(x)))
+
+ return x
+
+
class WindowAttention_kv(nn.Layer):
+
def __init__(self,
dim,
window_size,
@@ -201,12 +253,12 @@
relative_coords[:, :, 0] += self.window_size[0] - 1
relative_coords[:, :, 1] += self.window_size[1] - 1
relative_coords[:, :, 2] += self.window_size[2] - 1
- relative_coords[:, :, 0] *= (2 * self.window_size[1] - 1) * (
- 2 * self.window_size[2] - 1)
- relative_coords[:, :, 1] *= 2 * self.window_size[2] - 1
+ relative_coords[:, :, 0] *= 3 * self.window_size[1] - 1
+ relative_coords[:, :, 1] *= 2 * self.window_size[1] - 1
relative_position_index = relative_coords.sum(-1)
- self.register_buffer("relative_position_index", relative_position_index)
+ self.register_buffer("relative_position_index",
+ relative_position_index)
self.kv = nn.Linear(dim, dim * 2, bias_attr=qkv_bias)
self.attn_drop = nn.Dropout(attn_drop)
@@ -222,7 +274,7 @@
relative_position_bias = paddle.index_select(x=table, index=index)
return relative_position_bias
- def forward(self, skip, x_up, mask=None):
+ def forward(self, skip, x_up, pos_embed=None, mask=None):
B_, N, C = skip.shape
kv = self.kv(skip)
@@ -235,7 +287,7 @@
(0, 2, 1, 3))
k, v = kv[0], kv[1]
q = q * self.scale
- attn = paddle.matmul(q, k, transpose_y=True)
+ attn = paddle.matmul(q, k, transpose_y=True) # contiguous
relative_position_bias = self.get_relative_pos_bias_from_pos_index()
relative_position_bias = relative_position_bias.reshape([
self.window_size[0] * self.window_size[1] * self.window_size[2],
@@ -256,6 +308,8 @@
attn = self.attn_drop(attn)
x = paddle.matmul(attn, v).transpose([0, 2, 1, 3]).reshape([B_, N, C])
+ if pos_embed is not None:
+ x = x + pos_embed
x = self.proj(x)
x = self.proj_drop(x)
return x
@@ -301,7 +355,8 @@
relative_coords[:, :, 1] *= 2 * self.window_size[1] - 1
relative_position_index = relative_coords.sum(-1)
- self.register_buffer("relative_position_index", relative_position_index)
+ self.register_buffer("relative_position_index",
+ relative_position_index)
self.qkv = nn.Linear(dim, dim * 3, bias_attr=qkv_bias)
self.attn_drop = nn.Dropout(attn_drop)
@@ -327,7 +382,7 @@
q, k, v = qkv[0], qkv[1], qkv[2]
q = q * self.scale
attn = paddle.matmul(q, k, transpose_y=True)
- #qkv.shape:[B_,N,3*C]
+ # qkv.shape:[B_,N,3*C]
relative_position_bias = self.get_relative_pos_bias_from_pos_index()
relative_position_bias = relative_position_bias.reshape([
self.window_size[0] * self.window_size[1] * self.window_size[2],
@@ -356,115 +411,8 @@
return x
-class SwinTransformerBlock_kv(nn.Layer):
- def __init__(self,
- dim,
- input_resolution,
- num_heads,
- window_size=7,
- shift_size=0,
- mlp_ratio=4.,
- qkv_bias=True,
- qk_scale=None,
- drop=0.,
- attn_drop=0.,
- drop_path=0.,
- act_layer=nn.GELU,
- norm_layer=nn.LayerNorm):
- super().__init__()
- self.dim = dim
- self.input_resolution = input_resolution
- self.num_heads = num_heads
- self.window_size = window_size
- self.shift_size = shift_size
- self.mlp_ratio = mlp_ratio
- if tuple(self.input_resolution) == tuple(self.window_size):
- self.shift_size = [0, 0, 0]
-
- self.norm1 = norm_layer(dim)
- self.attn = WindowAttention_kv(
- dim,
- window_size=self.window_size,
- num_heads=num_heads,
- qkv_bias=qkv_bias,
- qk_scale=qk_scale,
- attn_drop=attn_drop,
- proj_drop=drop)
-
- self.drop_path = DropPath(drop_path) if drop_path > 0. else nn.Identity(
- )
- self.norm2 = norm_layer(dim)
- mlp_hidden_dim = int(dim * mlp_ratio)
- self.mlp = MLP(in_features=dim,
- hidden_features=mlp_hidden_dim,
- act_layer=act_layer,
- drop=drop)
-
- def forward(self, x, mask_matrix, skip=None, x_up=None):
- assert self.shift_size == [0, 0, 0]
- B, L, C = x.shape
- S, H, W = self.input_resolution
- assert L == S * H * W, "input feature has wrong size"
-
- shortcut = x
- skip = self.norm1(skip)
- x_up = self.norm1(x_up)
-
- skip = skip.reshape((B, S, H, W, C))
- x_up = x_up.reshape((B, S, H, W, C))
-
- # Pad feature maps to multiples of window size
- pad_r = (
- self.window_size[2] - W % self.window_size[2]) % self.window_size[2]
- pad_b = (
- self.window_size[1] - H % self.window_size[1]) % self.window_size[1]
- pad_g = (
- self.window_size[0] - S % self.window_size[0]) % self.window_size[0]
-
- skip = F.pad(skip, (0, pad_r, 0, pad_b, 0, pad_g), data_format="NDHWC")
- _, Sp, Hp, Wp, _ = skip.shape
- x_up = F.pad(x_up, (0, pad_r, 0, pad_b, 0, pad_g), data_format="NDHWC")
-
- skip = window_partition(skip, self.window_size)
- skip = skip.reshape((-1, self.window_size[0] * self.window_size[1] *
- self.window_size[2], C))
- x_up = window_partition(x_up, self.window_size)
- x_up = x_up.reshape((-1, self.window_size[0] * self.window_size[1] *
- self.window_size[2], C))
- # W-MSA/SW-MSA
- attn_windows = self.attn(skip, x_up)
-
- attn_windows = attn_windows.reshape(
- (-1, self.window_size[0], self.window_size[1], self.window_size[2],
- C))
- shifted_x = window_reverse(attn_windows, self.window_size, Sp, Hp,
- Wp) # B H' W' C
-
- if min(self.shift_size) > 0:
- x = paddle.roll(
- shifted_x,
- shifts=(self.shift_size[0], self.shift_size[1],
- self.shift_size[2]),
- axis=(1, 2, 3))
- else:
- x = shifted_x
-
- if pad_r > 0 or pad_b > 0 or pad_g > 0:
- x = x[:, :S, :H, :W, :]
-
- x = x.reshape((B, S * H * W, C))
-
- # FFN
- x = shortcut + self.drop_path(x)
- x = x + self.drop_path(self.mlp(self.norm2(x)))
-
- return x
-
-
class SwinTransformerBlock(nn.Layer):
- def __init__(self,
- dim,
- input_resolution,
+ def __init__(self, dim, input_resolution,
num_heads,
window_size,
shift_size=0,
@@ -483,13 +431,17 @@
self.window_size = window_size
self.shift_size = shift_size
self.mlp_ratio = mlp_ratio
- if tuple(self.input_resolution) == tuple(self.window_size):
+ if min(self.input_resolution) <= self.window_size:
# If window size is larger than input resolution, we don't partition windows
- self.shift_size = [0, 0, 0]
+ self.shift_size = 0
+ self.window_size = min(self.input_resolution)
+
+ assert 0 <= self.shift_size < self.window_size, "shift_size must in 0-window_size"
+
self.norm1 = norm_layer(dim)
self.attn = WindowAttention(
dim,
- window_size=self.window_size,
+ window_size=to_3tuple(self.window_size),
num_heads=num_heads,
qkv_bias=qkv_bias,
qk_scale=qk_scale,
@@ -508,6 +460,7 @@
def forward(self, x, mask_matrix):
B, L, C = x.shape
S, H, W = self.input_resolution
+ # print(f"x of {x.shape}, input_res = {self.input_resolution}")
assert L == S * H * W, "input feature has wrong size"
shortcut = x
@@ -515,21 +468,21 @@
x = x.reshape([B, S, H, W, C])
pad_r = (
- self.window_size[2] - W % self.window_size[2]) % self.window_size[2]
+ self.window_size - W % self.window_size) % self.window_size
pad_b = (
- self.window_size[1] - H % self.window_size[1]) % self.window_size[1]
+ self.window_size - H % self.window_size) % self.window_size
pad_g = (
- self.window_size[0] - S % self.window_size[0]) % self.window_size[0]
+ self.window_size - S % self.window_size) % self.window_size
x = F.pad(x, (0, pad_r, 0, pad_b, 0, pad_g), data_format="NDHWC")
_, Sp, Hp, Wp, _ = x.shape
- if min(self.shift_size) > 0:
+ if self.shift_size > 0:
shifted_x = paddle.roll(
x,
shifts=[
- -self.shift_size[0], -self.shift_size[1],
- -self.shift_size[2]
+ -self.shift_size, -self.shift_size,
+ -self.shift_size
],
axis=[1, 2, 3])
attn_mask = mask_matrix
@@ -539,24 +492,24 @@
x_windows = window_partition(shifted_x, self.window_size)
x_windows = x_windows.reshape(
- (-1, self.window_size[0] * self.window_size[1] *
- self.window_size[2], C))
+ (-1, self.window_size * self.window_size *
+ self.window_size, C))
# W-MSA/SW-MSA
attn_windows = self.attn(x_windows, mask=attn_mask, pos_embed=None)
attn_windows = attn_windows.reshape(
- (-1, self.window_size[0], self.window_size[1], self.window_size[2],
+ (-1, self.window_size, self.window_size, self.window_size,
C))
shifted_x = window_reverse(attn_windows, self.window_size, Sp, Hp,
Wp) # B H' W' C
# Reverse cyclic shift
- if min(self.shift_size) > 0:
+ if self.shift_size > 0:
x = paddle.roll(
shifted_x,
shifts=[
- self.shift_size[0], self.shift_size[1], self.shift_size[2]
+ self.shift_size, self.shift_size, self.shift_size
],
axis=[1, 2, 3])
else:
@@ -574,6 +527,54 @@
return x
+class PatchMerging(nn.Layer):
+
+ def __init__(self, dim, norm_layer=nn.LayerNorm):
+ super().__init__()
+ self.dim = dim
+ self.reduction = nn.Conv3D(
+ dim,
+ dim * 2,
+ kernel_size=3,
+ stride=2,
+ padding=1)
+
+ self.norm = norm_layer(dim)
+
+ def forward(self, x, S, H, W):
+ B, L, C = x.shape
+ assert L == H * W * S, "input feature has wrong size"
+ x = x.reshape([B, S, H, W, C])
+ x = F.gelu(x)
+ x = self.norm(x)
+ x = x.transpose([0, 4, 1, 2, 3])
+ x = self.reduction(x)
+ x = x.transpose([0, 2, 3, 4, 1]).reshape((B, -1, 2 * C))
+ return x
+
+
+class PatchExpanding(nn.Layer):
+ def __init__(self, dim, norm_layer=nn.LayerNorm):
+ super().__init__()
+ self.dim = dim
+
+ self.norm = norm_layer(dim)
+ self.up = nn.Conv3DTranspose(dim, dim // 2, 2, 2)
+
+ def forward(self, x, S, H, W):
+ B, L, C = x.shape
+ assert L == H * W * S, "input feature has wrong size"
+
+ x = x.reshape((B, S, H, W, C))
+
+ x = self.norm(x)
+ x = x.transpose((0, 4, 1, 2, 3))
+ x = self.up(x)
+ x = x.transpose((0, 2, 3, 4, 1)).reshape((B, -1, C // 2))
+
+ return x
+
+
class BasicLayer(nn.Layer):
def __init__(self,
dim,
@@ -588,15 +589,11 @@
attn_drop=0.,
drop_path=0.,
norm_layer=nn.LayerNorm,
- downsample=True,
- i_layer=None):
+ downsample=True):
super().__init__()
self.window_size = window_size
- self.shift_size = [
- window_size[0] // 2, window_size[1] // 2, window_size[2] // 2
- ]
+ self.shift_size = window_size // 2
self.depth = depth
- self.i_layer = i_layer
self.blocks = nn.LayerList([
SwinTransformerBlock(
@@ -604,7 +601,7 @@
input_resolution=input_resolution,
num_heads=num_heads,
window_size=window_size,
- shift_size=[0, 0, 0] if (i % 2 == 0) else self.shift_size,
+ shift_size=0 if (i % 2 == 0) else window_size // 2,
mlp_ratio=mlp_ratio,
qkv_bias=qkv_bias,
qk_scale=qk_scale,
@@ -616,32 +613,45 @@
])
if downsample is not None:
-
- if i_layer == 1:
- self.downsample = downsample(
- dim=dim, norm_layer=norm_layer, tag=1)
- elif i_layer == 2:
- self.downsample = downsample(
- dim=dim, norm_layer=norm_layer, tag=2)
- elif i_layer == 0:
- self.downsample = downsample(
- dim=dim, norm_layer=norm_layer, tag=0)
- else:
- self.downsample = None
+ self.downsample = downsample(
+ dim=dim, norm_layer=norm_layer)
else:
self.downsample = None
def forward(self, x, S, H, W):
-
- attn_mask = None
+ # calculate attention mask for SW-MSA
+ Sp = int(np.ceil(S / self.window_size)) * self.window_size
+ Hp = int(np.ceil(H / self.window_size)) * self.window_size
+ Wp = int(np.ceil(W / self.window_size)) * self.window_size
+ img_mask = paddle.zeros(
+ (1, Sp, Hp, Wp, 1)) # 1 Hp Wp 1
+ s_slices = (slice(0, -self.window_size),
+ slice(-self.window_size, -self.shift_size),
+ slice(-self.shift_size, None))
+ h_slices = (slice(0, -self.window_size),
+ slice(-self.window_size, -self.shift_size),
+ slice(-self.shift_size, None))
+ w_slices = (slice(0, -self.window_size),
+ slice(-self.window_size, -self.shift_size),
+ slice(-self.shift_size, None))
+ cnt = 0
+ for s in s_slices:
+ for h in h_slices:
+ for w in w_slices:
+ img_mask[:, s, h, w, :] = cnt
+ cnt += 1
+
+ mask_windows = window_partition(img_mask, self.window_size)
+ mask_windows = mask_windows.reshape((-1,
+ self.window_size * self.window_size * self.window_size))
+ attn_mask = mask_windows.unsqueeze(1) - mask_windows.unsqueeze(2)
+ attn_mask = paddle.where(attn_mask == 0, paddle.to_tensor(
+ 0.0), paddle.where(attn_mask != 0, paddle.to_tensor(-100.0), attn_mask))
for blk in self.blocks:
x = blk(x, attn_mask)
if self.downsample is not None:
x_down = self.downsample(x, S, H, W)
- if self.i_layer != 1 and self.i_layer != 2:
- Ws, Wh, Ww = S, (H + 1) // 2, (W + 1) // 2
- else:
- Ws, Wh, Ww = S // 2, (H + 1) // 2, (W + 1) // 2
+ Ws, Wh, Ww = (S + 1) // 2, (H + 1) // 2, (W + 1) // 2
return x, S, H, W, x_down, Ws, Wh, Ww
else:
return x, S, H, W, x, S, H, W
@@ -661,13 +671,10 @@
attn_drop=0.,
drop_path=0.,
norm_layer=nn.LayerNorm,
- upsample=True,
- i_layer=None):
+ upsample=True):
super().__init__()
self.window_size = window_size
- self.shift_size = [
- window_size[0] // 2, window_size[1] // 2, window_size[2] // 2
- ]
+ self.shift_size = window_size // 2
self.depth = depth
self.blocks = nn.LayerList()
@@ -677,7 +684,7 @@
input_resolution=input_resolution,
num_heads=num_heads,
window_size=window_size,
- shift_size=[0, 0, 0],
+ shift_size=0,
mlp_ratio=mlp_ratio,
qkv_bias=qkv_bias,
qk_scale=qk_scale,
@@ -693,7 +700,7 @@
input_resolution=input_resolution,
num_heads=num_heads,
window_size=window_size,
- shift_size=self.shift_size,
+ shift_size=window_size // 2,
mlp_ratio=mlp_ratio,
qkv_bias=qkv_bias,
qk_scale=qk_scale,
@@ -703,24 +710,41 @@
if isinstance(drop_path, list) else drop_path,
norm_layer=norm_layer))
- self.i_layer = i_layer
- if i_layer == 1:
- self.Upsample = upsample(dim=2 * dim, norm_layer=norm_layer, tag=1)
- elif i_layer == 0:
- self.Upsample = upsample(dim=2 * dim, norm_layer=norm_layer, tag=2)
- else:
- self.Upsample = upsample(dim=2 * dim, norm_layer=norm_layer, tag=0)
+ self.Upsample = upsample(dim=2 * dim, norm_layer=norm_layer)
def forward(self, x, skip, S, H, W):
x_up = self.Upsample(x, S, H, W)
x = skip + x_up
- if self.i_layer == 1:
- S, H, W = S * 2, H * 2, W * 2
- elif self.i_layer == 0:
- S, H, W = (S * 2) + 1, H * 2, W * 2
- else:
- S, H, W = S, H * 2, W * 2
- attn_mask = None
+ S, H, W = S * 2, H * 2, W * 2
+ # calculate attention mask for SW-MSA
+ Sp = int(np.ceil(S / self.window_size)) * self.window_size
+ Hp = int(np.ceil(H / self.window_size)) * self.window_size
+ Wp = int(np.ceil(W / self.window_size)) * self.window_size
+ img_mask = paddle.zeros(
+ (1, Sp, Hp, Wp, 1)) # 1 Hp Wp 1
+ s_slices = (slice(0, -self.window_size),
+ slice(-self.window_size, -self.shift_size),
+ slice(-self.shift_size, None))
+ h_slices = (slice(0, -self.window_size),
+ slice(-self.window_size, -self.shift_size),
+ slice(-self.shift_size, None))
+ w_slices = (slice(0, -self.window_size),
+ slice(-self.window_size, -self.shift_size),
+ slice(-self.shift_size, None))
+ cnt = 0
+ for s in s_slices:
+ for h in h_slices:
+ for w in w_slices:
+ img_mask[:, s, h, w, :] = cnt
+ cnt += 1
+
+ # nW, window_size, window_size, 1
+ mask_windows = window_partition(img_mask, self.window_size)
+ mask_windows = mask_windows.reshape((-1,
+ self.window_size * self.window_size * self.window_size)) # 3d��3��winds�˻�����Ŀ�Ǻܴ�ģ�����winds����̫��
+ attn_mask = mask_windows.unsqueeze(1) - mask_windows.unsqueeze(2)
+ attn_mask = paddle.where(attn_mask == 0, paddle.to_tensor(
+ 0.0), paddle.where(attn_mask != 0, paddle.to_tensor(-100.0), attn_mask))
x = self.blocks[0](x, attn_mask, skip=skip, x_up=x_up)
for i in range(self.depth - 1):
x = self.blocks[i + 1](x, attn_mask)
@@ -775,8 +799,8 @@
self.in_chans = in_chans
self.embed_dim = embed_dim
- stride1 = [1, patch_size[1] // 2, patch_size[2] // 2]
- stride2 = [1, patch_size[1] // 2, patch_size[2] // 2]
+ stride1 = [patch_size[0], patch_size[1] // 2, patch_size[2] // 2]
+ stride2 = [patch_size[0] // 2, patch_size[1] // 2, patch_size[2] // 2]
self.proj1 = Project(in_chans, embed_dim // 2, stride1, 1, nn.GELU,
nn.LayerNorm, False)
self.proj2 = Project(embed_dim // 2, embed_dim, stride2, 1, nn.GELU,
@@ -807,7 +831,8 @@
Ws, Wh, Ww = x.shape[2], x.shape[3], x.shape[4]
x = x.flatten(2).transpose([0, 2, 1])
x = self.norm(x)
- x = x.transpose([0, 2, 1]).reshape((-1, self.embed_dim, Ws, Wh, Ww))
+ x = x.transpose([0, 2, 1]).reshape(
+ (-1, self.embed_dim, Ws, Wh, Ww))
return x
@@ -820,7 +845,6 @@
depths=[2, 2, 2, 2],
num_heads=[4, 8, 16, 32],
window_size=7,
- down_stride=[[2, 2, 2], [2, 2, 2], [2, 2, 2], [2, 2, 2]],
mlp_ratio=4.,
qkv_bias=True,
qk_scale=None,
@@ -843,6 +867,7 @@
in_chans=in_chans,
embed_dim=embed_dim,
norm_layer=norm_layer if self.patch_norm else None)
+
self.pos_drop = nn.Dropout(p=drop_rate)
dpr = np.linspace(0, drop_path_rate, sum(depths)).tolist()
@@ -852,9 +877,9 @@
layer = BasicLayer(
dim=int(embed_dim * 2**i_layer),
input_resolution=(
- pretrain_img_size[0] // down_stride[i_layer][0],
- pretrain_img_size[1] // down_stride[i_layer][1],
- pretrain_img_size[2] // down_stride[i_layer][2]),
+ pretrain_img_size[0] // patch_size[0] // 2 ** i_layer,
+ pretrain_img_size[1] // patch_size[1] // 2 ** i_layer,
+ pretrain_img_size[2] // patch_size[2] // 2 ** i_layer),
depth=depths[i_layer],
num_heads=num_heads[i_layer],
window_size=window_size[i_layer],
@@ -866,8 +891,7 @@
drop_path=dpr[sum(depths[:i_layer]):sum(depths[:i_layer + 1])],
norm_layer=norm_layer,
downsample=PatchMerging
- if (i_layer < self.num_layers - 1) else None,
- i_layer=i_layer)
+ if (i_layer < self.num_layers - 1) else None)
self.layers.append(layer)
num_features = [int(embed_dim * 2**i) for i in range(self.num_layers)]
self.num_features = num_features
@@ -909,7 +933,6 @@
depths=[2, 2, 2],
num_heads=[24, 12, 6],
window_size=4,
- up_stride=[[2, 2, 2], [2, 2, 2], [2, 2, 2]],
mlp_ratio=4.,
qkv_bias=True,
qk_scale=None,
@@ -930,10 +953,10 @@
for i_layer in range(self.num_layers)[::-1]:
layer = BasicLayer_up(
dim=int(embed_dim * 2**(len(depths) - i_layer - 1)),
- input_resolution=(pretrain_img_size[0] // up_stride[i_layer][0],
- pretrain_img_size[1] // up_stride[i_layer][1],
- pretrain_img_size[2] //
- up_stride[i_layer][2]),
+ input_resolution=(pretrain_img_size[0] // patch_size[0] // 2 ** (len(depths) - i_layer - 1),
+ pretrain_img_size[1] // patch_size[1] // 2 ** (
+ len(depths) - i_layer - 1),
+ pretrain_img_size[2] // patch_size[2] // 2 ** (len(depths) - i_layer - 1)),
depth=depths[i_layer],
num_heads=num_heads[i_layer],
window_size=window_size[i_layer],
@@ -944,8 +967,7 @@
attn_drop=attn_drop_rate,
drop_path=dpr[sum(depths[:i_layer]):sum(depths[:i_layer + 1])],
norm_layer=norm_layer,
- upsample=PatchExpanding,
- i_layer=i_layer)
+ upsample=PatchExpanding)
self.layers.append(layer)
self.num_features = [
int(embed_dim * 2**i) for i in range(self.num_layers)
@@ -1006,16 +1028,15 @@
"""
def __init__(self,
- crop_size=[14, 160, 160],
- embedding_dim=96,
+ crop_size=[64, 128, 128],
+ embedding_dim=192,
input_channels=1,
- num_classes=4,
+ num_classes=14,
conv_op=nn.Conv3D,
depths=[2, 2, 2, 2],
- num_heads=[3, 6, 12, 24],
+ num_heads=[6, 12, 24, 48],
patch_size=[2, 4, 4],
- window_size=[[3, 5, 5], [3, 5, 5], [7, 10, 10], [3, 5, 5]],
- down_stride=[[1, 2, 2], [1, 2, 2], [1, 2, 2], [2, 2, 2]],
+ window_size=[4, 4, 8, 4],
deep_supervision=True):
super(nnFormer, self).__init__()
self.img_shape = crop_size
@@ -1032,7 +1053,6 @@
num_heads = num_heads
patch_size = patch_size
window_size = window_size
- down_stride = down_stride
self.model_down = Encoder(
pretrain_img_size=crop_size,
@@ -1041,20 +1061,17 @@
patch_size=patch_size,
depths=depths,
num_heads=num_heads,
- in_chans=input_channels,
- down_stride=down_stride)
+ in_chans=input_channels)
self.decoder = Decoder(
pretrain_img_size=crop_size,
embed_dim=embed_dim,
window_size=window_size[::-1][1:],
patch_size=patch_size,
num_heads=num_heads[::-1][1:],
- depths=depths[::-1][1:],
- up_stride=down_stride[::-1][1:])
+ depths=depths[::-1][1:])
self.final = []
if self.do_ds:
-
for i in range(len(depths) - 1):
self.final.append(
final_patch_expanding(
@@ -1077,40 +1094,15 @@
if self.do_ds:
for i in range(len(out)):
- out_put = F.interpolate(
+ seg_outputs.append(F.interpolate(
self.final[-(i + 1)](out[i]),
size=paddle.shape(x)[2:],
data_format='NCDHW',
- mode='trilinear')
+ mode='trilinear'))
- seg_outputs.append(out_put)
+ # shapes = [x.shape for x in seg_outputs[::-1]]
+ # print("Final shapes: ", shapes)
return seg_outputs[::-1]
else:
seg_outputs.append(self.final[0](out[-1]))
- return seg_outputs
-
-
-if __name__ == "__main__":
- embedding_dim = 96
- depths = [2, 2, 2, 2]
- num_heads = [3, 6, 12, 24]
- embedding_patch_size = [1, 4, 4]
- window_size = [[3, 5, 5], [3, 5, 5], [7, 10, 10], [3, 5, 5]]
- down_stride = [[1, 4, 4], [1, 8, 8], [2, 16, 16], [4, 32, 32]]
- net = nnFormer(
- crop_size=[14, 160, 160],
- embedding_dim=embedding_dim,
- input_channels=1,
- num_classes=2,
- conv_op=nn.Conv3D,
- depths=depths,
- num_heads=num_heads,
- patch_size=embedding_patch_size,
- window_size=window_size,
- down_stride=down_stride,
- deep_supervision=True)
-
- input = paddle.rand([1, 1, 14, 160, 160])
- out = net(input)
- for index, i in enumerate(out):
- print("{} out.shape:{}".format(index, i.shape))
+ return seg_outputs[-1]
相比于 ACDC 的配置,我们扩展了深度和 embedding 的维度,调整了部分参数, 同时根据我们修正后的 nnFormer 模型修正了部分参数。
_base_: 'acdc_4e-4.yml'

model:
  type: nnFormer
  crop_size: [64,160,160]
  embedding_dim: 192
  input_channels: 1
  num_classes: 12
  depths: [2, 2, 2, 2]
  num_heads: [3, 6, 12, 24]
  patch_size: [2, 4, 4]
  window_size: [4,8,8,4]
  deep_supervision: True
我们没有足够的算力去训练该模型,所以我们使用的参数值仅供参考。
cp ~/nnFormerNew.py medicalseg/models/nnformer.py
python train.py --config ~/nnformer_acdc_160_160_14_250k.yml --save_interval 2000 --num_workers 4 --do_eval --log_iters 250 --is_save_data False --has_dataset_json False
3. 总结
nnFormer 是一个十分新颖的 3D Transformer。遗憾的是我们并没有充足的算力去训练该模型,不过我们修改了数据预处理脚本、nnFormer 的代码还有配置文件,使得该网络能够在我们的数据集上进行训练,欢迎有兴趣的读者尝试训练该模型,注意因为我们没有足够的算力去训练该模型,所以我们使用的参数值仅供参考。
4️⃣第三部分:总结
我们小组使用了 PaddlePaddle 的 MedicalSeg 作为工具,实现了 NNUNet 的改进,并比较了多个 MedicalSeg 中不同网络在同一数据集的表现,各个网络在 iters = 15000 时验证集上的 dice 如图所示:
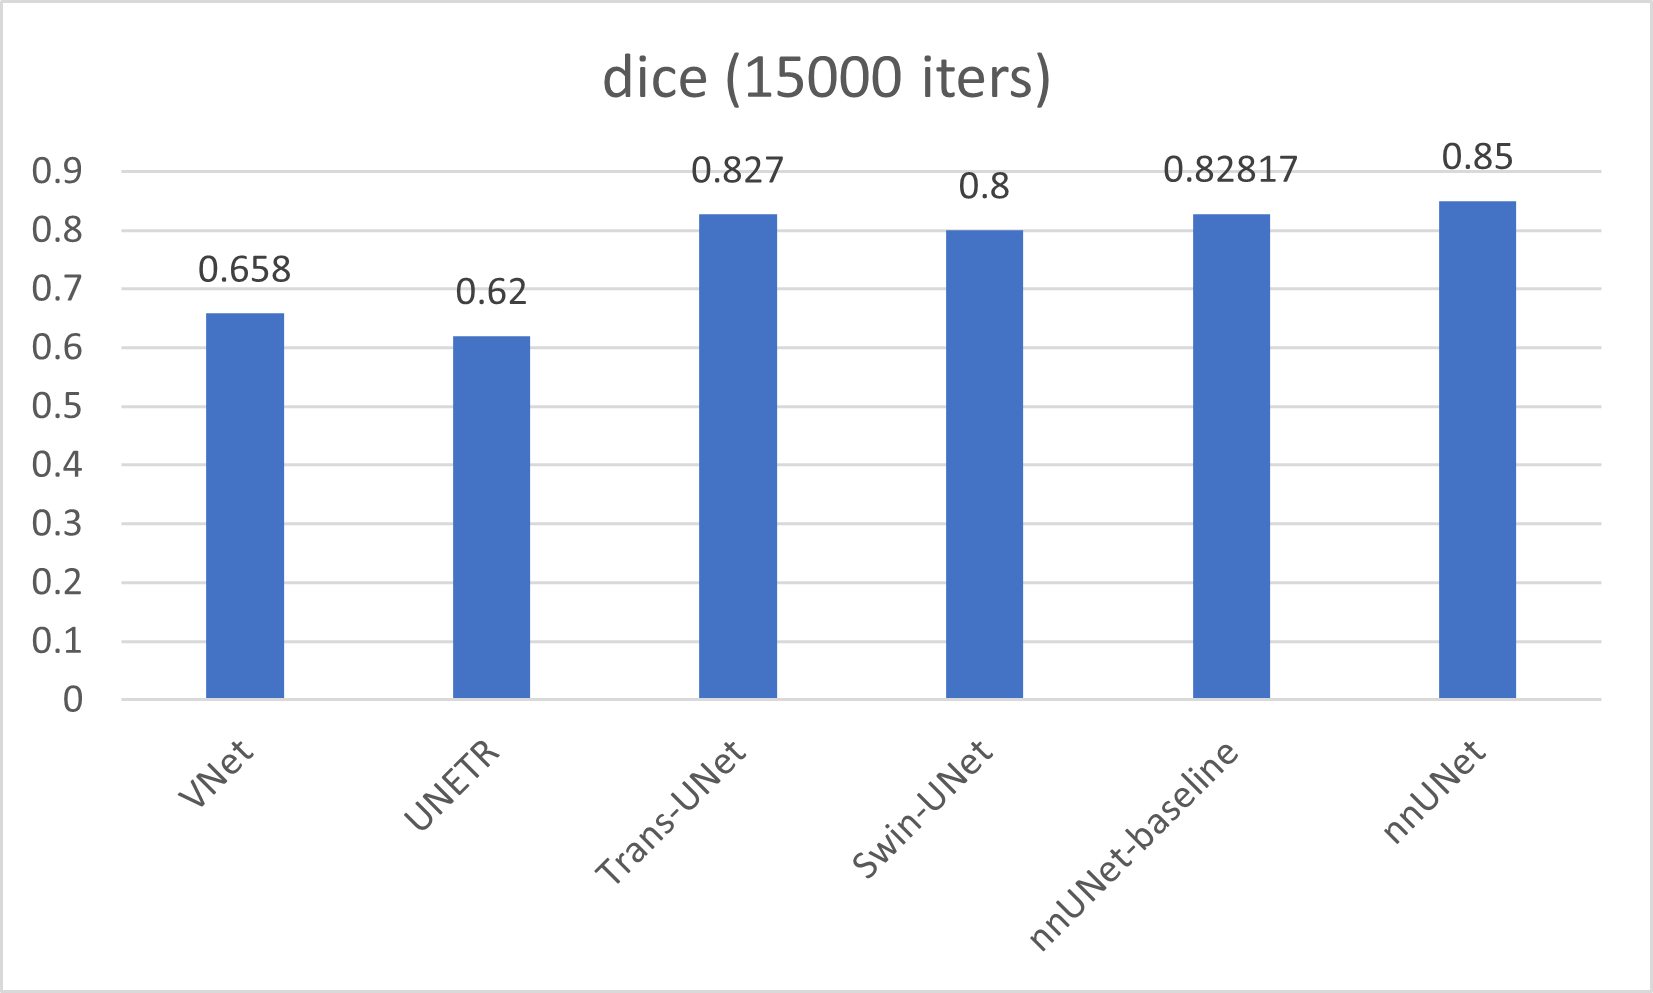
验证集上的结果表明,nnUNet 作为一个简单的全卷积网络,其验证集效果可以与 trans-UNet 等使用 Transformer 的网络持平(dice 均达到 0.85 左右)。nnUNet 兼具轻量和实用的特点,在医学图像分割方面具有很强的性能和泛化能力,应用前景广泛。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)