合肥工业大学人工智能原理课程实验-手写数字识别
目录
1.实验内容
MNIST数据集是一组由美国高中生和人口调查局员工手写的70000个数字的图片。每张图片都用其代表的数字标记。这个数据集被广为使用,因此也被称作是机器学习领域的“Hello World”。
➢ 任务输入:一系列手写数字图片,其中每张图片都是28x28的像素矩阵。
➢ 任务输出:经过了大小归一化和居中处理,输出对应的0~9的数字标签。
➢ 方法不限,要求提交整个算法源代码,模型结果,算法分析等内容。
2.实验环境
- 硬件
RedmiG 2022版 显存16GB 内存512GB cpu:3050
- 软件(运行环境)
显卡:NVIDIA显卡,CUDA 11.7。
系统与环境:Windows11操作系统,Anaconda3的base虚拟环境。
IDE:Pycharm Community集成开发环境
深度学习框架:PyTorch深度学习框架,基于GPU版本。
3.实验思路(算法分析)
本次实验中我采用深度学习中的卷积神经网络实现对手写数字的识别,卷积神经网络是被设计用来处理多维组数据的,如常见的彩色图像就是三个颜色通道组合。手写数字图片是典型的2D型图像数据,使用卷积神经网络可以有效通过训练提取去手写提数字的特征
卷积神经网络(CNN),是人工神经网络的一种。它是一种特殊的对图像识别的方式,属于非常有效的带有前向反馈的网络。
常规的神经网络不能很好地适应所有的图像,例如在CIFAR-10的训练集中,图片的大小只有32*32*3(32宽32高3颜色通道),那么通过输入层后的第一个隐藏层的神经元将达到3072个。看似可以接受的数字,当隐藏层由一层上升到两层三层甚至更多时,后面隐藏层每一个神经元全连接权值与输入积的加和计算量将膨胀到无法想象。与此同时,除了效率的低下外,大量的参数还会导致过拟合的发生。与常规神经网络不同,卷积神经网络的各层中的神经元是3维排列的:宽度、高度和深度(此处的深度不是网络结构的层数),是一种立体结构。在卷积网络最后的输出层里,会把三维结构的数据转换为在深度方向的一维分类值。
卷积神经网络诞生的主要目的是为了识别二维图形,它的网络结构对平移、比例缩放、倾斜或其他形式的变形具有高度不变性。卷积神经网络是近些年来发展迅速,备受器重的一种高效识别算法。它的应用范围也不仅仅局限于图像识别领域,也应用到了人脸识别、文字识别等方向。
以手写数字识别为例,CNN识别过程如下:
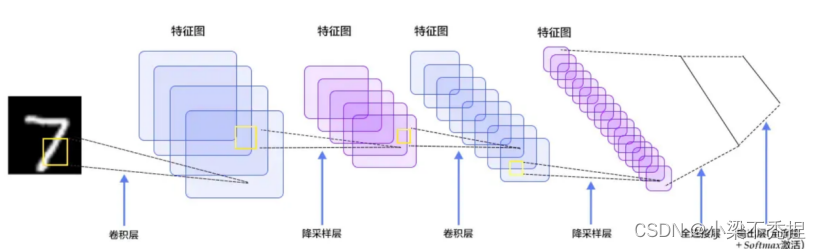
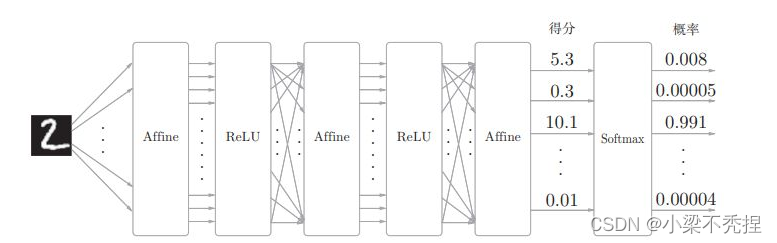
思路如下:
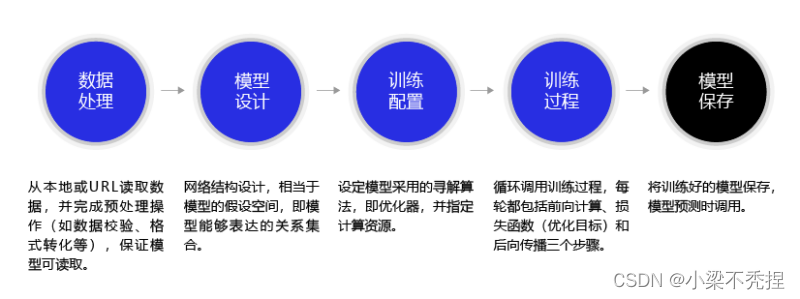
1.准备数据,这些需要准备DataLoader
2.构建模型,这里可以使用torch构造一个深层的神经网络
3.模型的训练
4.模型的保存,保存模型,后续持续使用
5.模型的评估,使用测试集,观察模型的好坏
整个手写数字识别过程的思路可用下图概括表示:
4.实验步骤、过程
step1:下载数据集、读取数据
step2:搭建神经网络(确定输出层、隐藏层(层数)、输出层的结构)
step3:初始化偏置和权重
step4:设置损失函数、激活函数
step5:设置超参数
step6:神经网络训练数据(通过误差反向传播求导、学习)
step7:测试验证数据集(确定Loss、精确度)
下面来具体实现每一步的操作:
step1:下载数据集、读取数据
首先需要导入 torch和torchvision包
# 导入必要的库
import torch # 导入PyTorch库,用于构建神经网络
import torchvision # 导入torchvision,提供数据集和图像处理工具
from torch.utils.data import DataLoader # 导入数据加载器,用于批量加载数据
import torch.nn as nn # 导入神经网络模块
import torch.nn.functional as F # 导入功能性API,如激活函数
import torch.optim as optim # 导入优化器模块
import matplotlib.pyplot as plt # 导入matplotlib,用于绘图
导入就绪后,我们可以继续准备将要使用的数据。但在那之前,还需要将定义超参数--将使用的实验。在这里,epoch的数量定义了我们将循环整个训练数据集的次数,而learning_rate和momentum是我们稍后将使用的优化器的超参数。
# 定义训练的超参数
n_epochs = 3 # 训练周期数
batch_size_train = 64 # 训练时批量大小
batch_size_test = 1000 # 测试时批量大小
learning_rate = 0.01 # 学习率
momentum = 0.5 # 动量,用于SGD优化器
log_interval = 10 # 打印日志的间隔
random_seed = 1 # 随机种子,用于复现结果
torch.manual_seed(random_seed) # 设置随机种子
对于可重复的实验,我们必须为任何使用随机数产生的东西设置随机种子——如numpy和random!
现在我们还需要数据集的dataloader。这就是导入TorchVision发挥作用的地方。它让我们用一种方便的方式来加载MNIST数据集。我们将使用batch_size=64进行训练,并使用size=1000对这个数据集进行测试。下面的Normalize()转换使用的值0.1307和0.3081是MNIST数据集的全局平均值和标准偏差,这里我们将它们作为给定值。
TorchVision提供了许多方便的转换,比如裁剪或标准化。
# 加载并准备MNIST数据集
train_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('./data/', train=True, download=True,
                               transform=torchvision.transforms.Compose([
                                   torchvision.transforms.ToTensor(),
                                   torchvision.transforms.Normalize(
                                       (0.1307,), (0.3081,))
                               ])),
    batch_size=batch_size_train, shuffle=True) # 打乱数据
test_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('./data/', train=False, download=True,
                               transform=torchvision.transforms.Compose([
                                   torchvision.transforms.ToTensor(),
                                   torchvision.transforms.Normalize(
                                       (0.1307,), (0.3081,))
                               ])),
    batch_size=batch_size_test, shuffle=True)
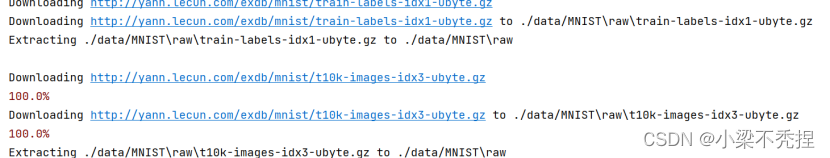
将数据集下载到目录下的data文件夹里:
数据下载完毕后是这样的:
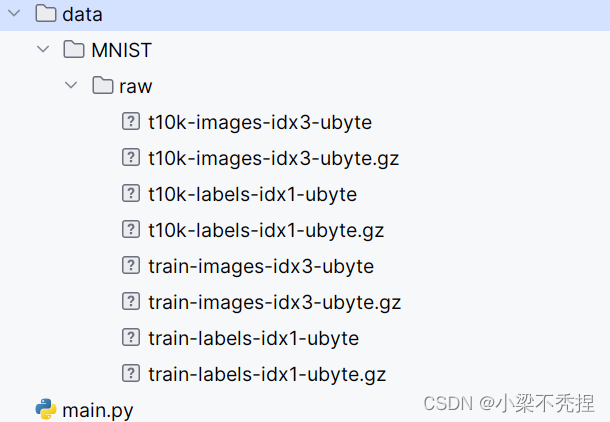
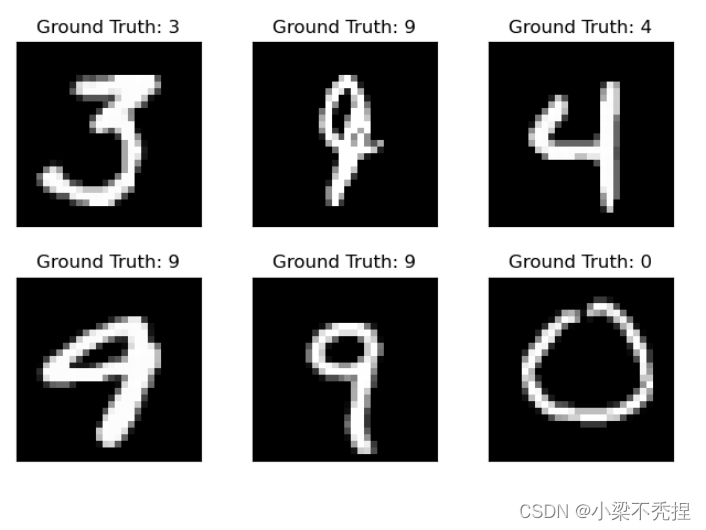
我们已经知道此处使用MNIST数据集,包含60000个训练样本和10000个测试样本。分为图片和标签,每张图片是一个 28 × 28 28 \times 2828×28 的像素矩阵,标签是0~9一共10种数字。每个样本的格式为[data, label]。
现在来看一下数据集的一个样本是什么样的:
step2:搭建神经网络(确定输出层、隐藏层(层数)、输出层的结构)
现在开始建立我们的网络。使用两个2d卷积层,然后是两个全连接(或线性)层。作为激活函数,我们将选择整流线性单元(简称ReLUs),作为正则化的手段,我们将使用两个dropout层。定义一个名为`Net`的神经网络类,继承自`nn.Module`。这个网络包含两个卷积层(`conv1`和`conv2`)、一个Dropout层(`conv2_drop`)、两个全连接层(`fc1`和`fc2`)。
1. `__init__`方法用于初始化网络结构。它首先调用父类的`__init__`方法,然后定义了两个卷积层(`conv1`和`conv2`),一个Dropout层(`conv2_drop`),以及两个全连接层(`fc1`和`fc2`)。
2. `forward`方法定义了数据在网络中的传播过程。首先对输入数据`x`进行两次卷积操作,然后使用ReLU激活函数和最大池化操作进行特征提取。接着,将特征图展平为一维向量,并通过全连接层进行处理。最后,使用Dropout层防止过拟合,并输出经过Softmax函数处理的结果。
class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(1, 10, kernel_size=5) # 第一个卷积层,1个输入通道,10个输出通道,5x5卷积核
        self.conv2 = nn.Conv2d(10, 20, kernel_size=5) # 第二个卷积层,10个输入通道,20个输出通道,5x5卷积核
        self.conv2_drop = nn.Dropout2d() # Dropout层,防止过拟合
        self.fc1 = nn.Linear(320, 50) # 全连接层,320个输入,50个输出
        self.fc2 = nn.Linear(50, 10) # 全连接层,50个输入,10个输出

    def forward(self, x): # 前向传播
        x = F.relu(F.max_pool2d(self.conv1(x), 2)) # ReLU激活函数和最大池化
        x = F.relu(F.max_pool2d(self.conv2_drop(self.conv2(x)), 2)) # 第二个卷积层后接Dropout和池化
        x = x.view(-1, 320) # 展平特征图
        x = F.relu(self.fc1(x)) # 第一个全连接层后接ReLU
        x = F.dropout(x, training=self.training) # Dropout层
        x = self.fc2(x) # 第二个全连接层
        return F.log_softmax(x, dim=1) # 输出层使用log-softmax
step3:模型训练
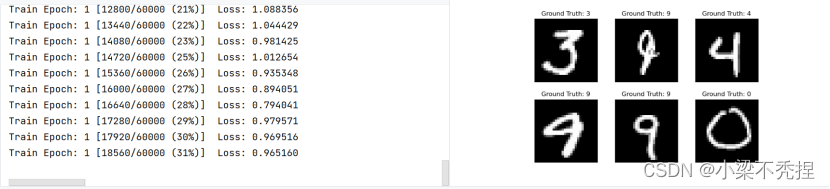
首先确保网络处于训练模式。然后,每个epoch对所有训练数据进行一次迭代。加载单独批次由DataLoader处理。
使用optimizer.zero_grad()手动将梯度设置为零,因为PyTorch在默认情况下会累积梯度。然后生成网络的输出(前向传递),并计算输出与真值标签之间的负对数概率损失。现在收集一组新的梯度,并使用optimizer.step()将其传播回每个网络参数。
具体实现过程如下:
1. 首先,创建一个名为`network`的神经网络对象,这里使用的是自定义的`Net`类。
2. 然后,创建一个优化器对象`optimizer`,使用随机梯度下降(SGD)算法来更新网络参数。学习率(`learning_rate`)和动量(`momentum`)作为优化器的参数传入。
3. 初始化一些列表变量,用于存储训练过程中的损失值和计数器。
4. 定义一个名为`train`的函数,该函数接受一个参数`epoch`,表示当前训练的轮数。
5. 在`train`函数中,首先将网络设置为训练模式(`network.train()`)。
6. 使用`enumerate`函数遍历训练数据加载器(`train_loader`),每次迭代返回一个批次的数据和目标标签。
7. 对于每个批次的数据,执行以下操作:
使用优化器的`zero_grad()`方法清除梯度。
将输入数据传递给神经网络,得到输出结果。
计算输出结果与目标标签之间的负对数似然损失(`F.nll_loss(output, target)`)。
使用`loss.backward()`方法计算损失关于网络参数的梯度。
使用优化器的`step()`方法根据梯度更新网络参数。
8. 如果当前批次索引(`batch_idx`)可以被日志间隔(`log_interval`)整除,则执行以下操作:
打印当前训练轮数、批次索引、数据集大小、进度百分比以及当前批次的损失值。
将当前批次的损失值添加到`train_losses`列表中。
计算并添加当前批次的计数器值到`train_counter`列表中。
使用`torch.save()`方法保存网络的状态字典(`network.state_dict()`)和优化器的状态字典(`optimizer.state_dict()`)到文件中。
- 最后,调用`train(1)`函数开始训练过程,传入初始轮数为1。
step4: 测试循环
1.初始化变量test_loss和correct,分别用于存储测试损失和正确预测的数量。
使用torch.no_grad()上下文管理器来关闭梯度计算,以减少内存消耗并加速计算。
2.遍历测试数据集test_loader中的每个数据批次(data和target)。
3.将输入数据data传递给神经网络模型,得到输出结果output。
4.使用负对数似然损失函数(F.nll_loss)计算当前批次的损失值,并将其累加到test_loss中。
5.找到输出结果output中概率最大的类别索引,将其赋值给pred。
比较pred和目标标签target是否相等,统计相等的数量,并将其累加到correct中。
6.计算平均损失值test_loss,即所有批次损失值之和除以批次数量。
将平均损失值添加到test_losses列表中。
7.最后打印测试集的平均损失值、正确预测的数量、总样本数量以及准确率(正确预测数量占总样本数量的比例)。
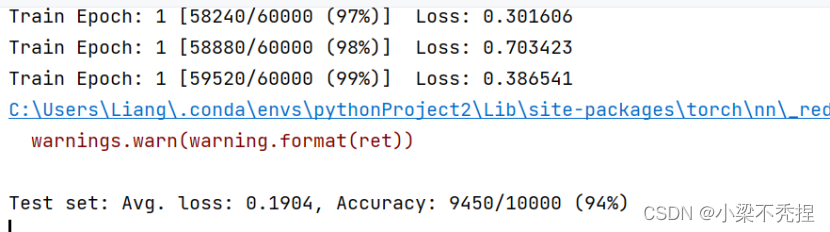
经测试,损失度为0.1904,正确率为94%,初步满足实验要求.
Step5:模型评估
评估的过程和训练的过程相似,但是:
不需要计算梯度
需要收集损失和准确率,用来计算平均损失和平均准确率
损失的计算和训练时候损失的计算方法相同
准确率的计算:
模型的输出为[batch_size,10]的形状
其中最大值的位置就是其预测的目标值(预测值进行过sotfmax后为概率,sotfmax中分母都是相同的,分子越大,概率越大)
最大值的位置获取的方法可以使用torch.max,返回最大值和最大值的位置
返回最大值的位置后,和真实值([batch_size])进行对比,相同表示预测成功
5.实验数据记录与分析
训练曲线结果如下图表示:
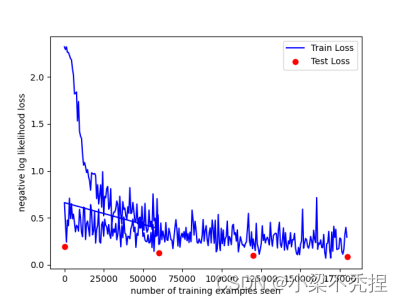
从训练曲线来看,看起来甚至可以继续训练几个epoch!
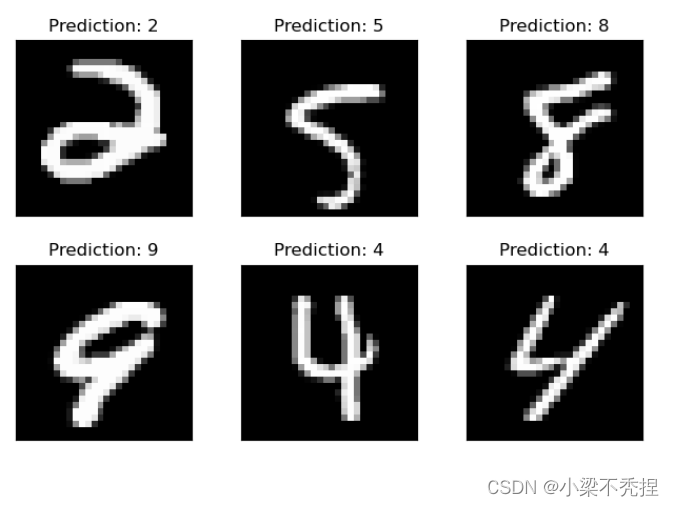
使用神经网络对测试数据进行预测,并将预测结果可视化再来看看几个例子:
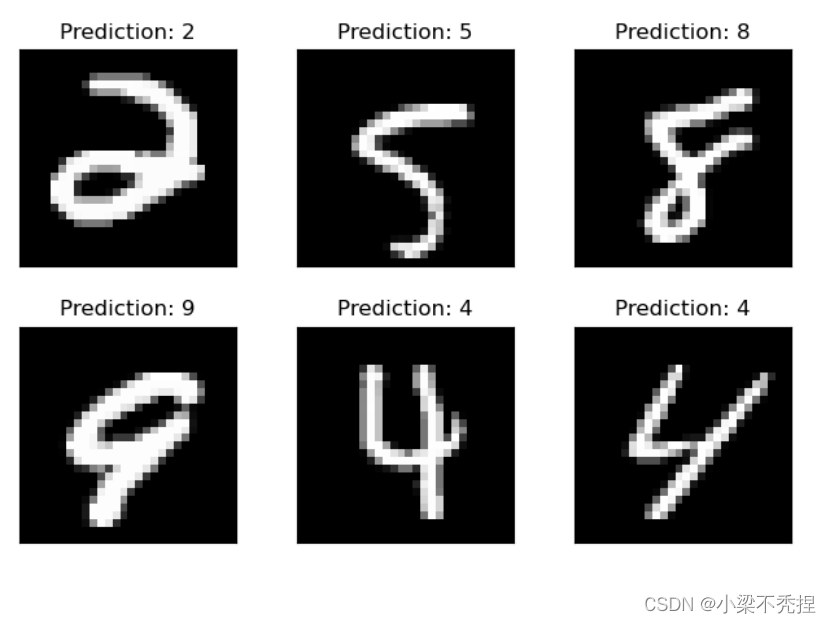
经分析,模型对于这些例子的预测结果似乎是正确的
6.实验结果与评价
继续进行多轮训练后,模型的精确度从最开始的94%提升到了98%,较好地满足实验要求,取得了不错的效果.
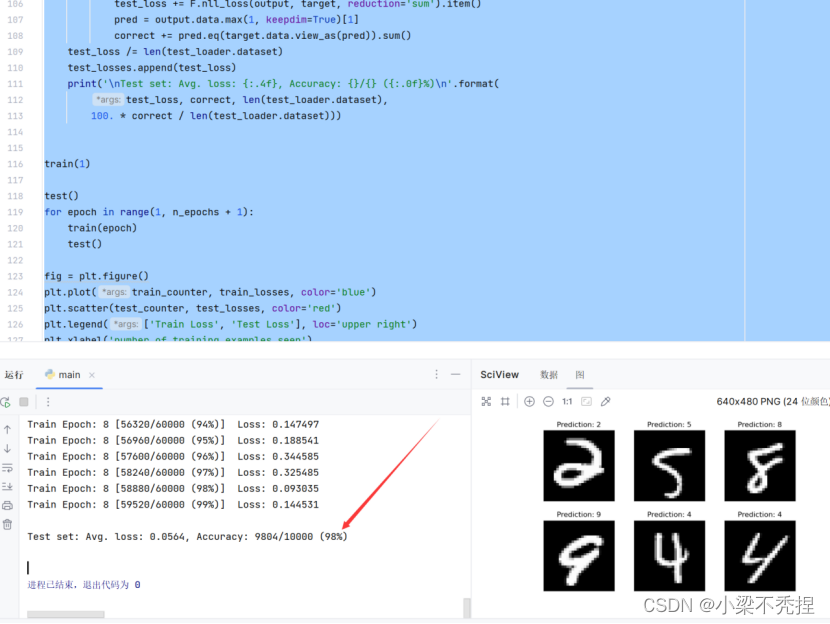
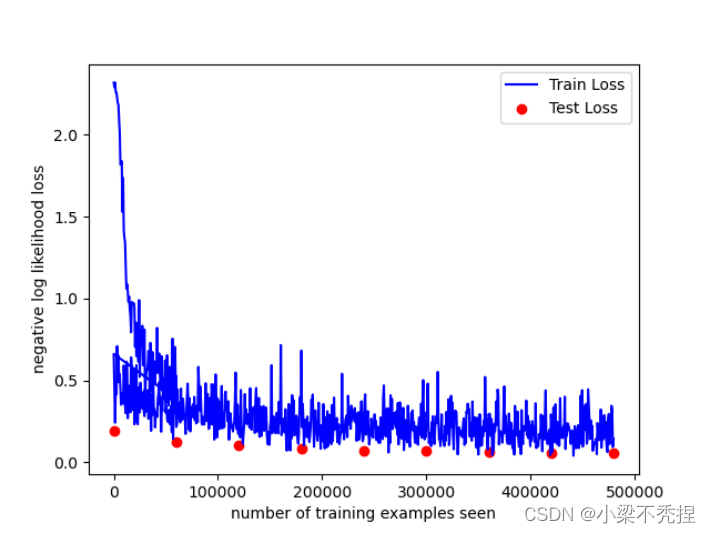
实验结果表明,该CNN在MNIST数据集上的表现较好,训练损失和测试损失都在可接受的范围内。通过观察损失曲线,可以发现随着训练轮数的增加,训练损失逐渐减小,而测试损失保持不变或略有上升。这说明网络在训练过程中已经学会了一些有效的特征表示,但在测试集上的性能可能受到过拟合的影响。
为了改进模型性能,可以尝试以下方法:
增加网络的复杂度,例如增加卷积层的数量或调整卷积核的大小。
使用正则化技术,如L1或L2正则化,以减少过拟合。
使用数据增强技术,如旋转、缩放和平移,以提高模型的泛化能力。
调整学习率和动量等超参数,以优化训练过程。
7.实验体会与收获
一、学到深度学习环境搭建的方法
在搭建环境过程中 我遇到很多问题,这困恼了好几天,第一天配环境的时候配了好半天都没有弄明白,还差点把电脑搞崩溃了,连小小的配环境都搞不定,这令我心情非常沮丧,第二天我再度查阅相关资料,发现使用pytorch+pycharm比较简单不容易出错,然后我开始上手搭建环境,但是在这过程中还遇到很多问题,比如内存不足,下载到一半就卡住,环境变量的设置等等难题,我都一一查阅了相关资料,逐一去解决,功夫不负有心人哈哈,最后环境终于搭建好了!
1. PyTorch:这是一个基于Python的科学计算库,主要针对两类人群,一类是作为NumPy的替代品,可以利用GPU的性能进行计算;另一类是研究人员和工程师,他们需要高级的深度神经网络和自动求导功能。
2. PyCharm:这是一个强大的Python IDE,具有调试、语法高亮、Project管理、代码跳转、智能提示、自动完成、单元测试、版本控制等功能。
3. Anaconda:这是一个用于科学计算的Python发行版,支持Linux, Mac, Windows系统,提供了包管理与环境管理的功能,可以很方便地解决多版本python并存、切换以及各种第三方包安装问题。
二、学习到深度学习领域的很多知识
在环境搭建完成后,我开始着手神经网络的搭建。我选择了卷积神经网络(CNN)来进行手写数字识别。CNN是一种前馈神经网络,它的人工神经元可以响应一部分覆盖范围内的周围单元,对于大型图像处理有着显著优势。
我首先定义了一个卷积层,然后是一个ReLU激活函数,接着是一个最大池化层。这样的结构我重复了几次,最后加上了一个全连接层和一个Softmax层进行分类。在搭建过程中,我深入理解了卷积、池化、全连接等概念,也体会到了神经网络设计的乐趣。
在神经网络搭建完成后,我开始进行模型的训练和评估。我使用了MNIST数据集,这是一个包含了0-9手写数字的大型数据库,常被用来训练各种图像处理系统。
我先将数据加载到内存中,然后进行了数据预处理,包括归一化和批处理。接着,我定义了损失函数和优化器,开始了模型的训练。在训练过程中,我注意到了学习率、批次大小、迭代次数等因素对模型性能的影响,也学会了如何通过调整这些参数来优化模型。
在模型训练完成后,我对模型进行了评估。我使用了准确率和损失度作为评估指标,发现模型在训练集上的准确率达到了98%,在测试集上的准确率也达到了98%。
三、增强了动手编程的能力
手写数字识别实验相当于编程的"Hello World",理解掌握了这个实验,就接触到了深度学习的门槛,感谢老师布置这么一个实验,让我又学到了一个非常棒的知识,实践出真知,通过实践才能更好地锻炼自己的操作动手能力,才能在这过程中发现自己知识的不足,才能倒逼自己更加努力地去学习一些之前没有接触的领域,这一点我感到非常棒。
在实验过程中,常常会遇到很多代码报错的问题,通过分析代码与查阅资料,我不断修改代码,最终成功将模型跑出来了。在这个过程,我的动手能力得到了提升,也更加坚定了我对于人工智能这个专业的自信心。
我们处在一个人工智能迅猛发展的时代,唯有不断更新自我,不断超越自我,才能在人工智能时代脱颖而出,成为弄潮儿,干出属于自己的一份成就。
知不足而奋进,望远山而力行!
参考书籍:
[1]周志华. 机器学习[M]. 2016年1月第1版. 北京:清华大学出版社, 2016.
[2]赵卫东, 董亮. 机器学习[M]. 2018年8月第1版. 北京:人民邮电出版社, 2018.
[3]李航. 统计学习方法[M]. 2019年5月第2版. 北京:清华大学出版社, 2019.
[4]阿斯顿·张(Aston Zhang), 李沐(Mu Li), [美]扎卡里·C.立顿(Zachary C.Lipton), 等. 动手学深度学习[M]. 2019年6月第1版. 北京:人民邮电出版社, 2019.
[5][美]Ian Goodfellow [加]Yoshua Bengio [加]Aaron Courville. 深度学习[M]. 2017年8月第1版. 北京:人民邮电出版社, 2017.
8.附录
源代码:
# 导入必要的库
import torch # 导入PyTorch库,用于构建神经网络
import torchvision # 导入torchvision,提供数据集和图像处理工具
from torch.utils.data import DataLoader # 导入数据加载器,用于批量加载数据
import torch.nn as nn # 导入神经网络模块
import torch.nn.functional as F # 导入功能性API,如激活函数
import torch.optim as optim # 导入优化器模块
import matplotlib.pyplot as plt # 导入matplotlib,用于绘图

# 定义训练的超参数
n_epochs = 3 # 训练周期数
batch_size_train = 64 # 训练时批量大小
batch_size_test = 1000 # 测试时批量大小
learning_rate = 0.01 # 学习率
momentum = 0.5 # 动量,用于SGD优化器
log_interval = 10 # 打印日志的间隔
random_seed = 1 # 随机种子,用于复现结果
torch.manual_seed(random_seed) # 设置随机种子

# 加载并准备MNIST数据集
train_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('./data/', train=True, download=True,
                               transform=torchvision.transforms.Compose([
                                   torchvision.transforms.ToTensor(),
                                   torchvision.transforms.Normalize(
                                       (0.1307,), (0.3081,))
                               ])),
    batch_size=batch_size_train, shuffle=True) # 打乱数据
test_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('./data/', train=False, download=True,
                               transform=torchvision.transforms.Compose([
                                   torchvision.transforms.ToTensor(),
                                   torchvision.transforms.Normalize(
                                       (0.1307,), (0.3081,))
                               ])),
    batch_size=batch_size_test, shuffle=True)

# 查看测试数据
examples = enumerate(test_loader)
batch_idx, (example_data, example_targets) = next(examples)

# 使用matplotlib显示测试图像
fig = plt.figure()
for i in range(6):
    plt.subplot(2, 3, i + 1)
    plt.tight_layout()
    plt.imshow(example_data[i][0], cmap='gray', interpolation='none')
    plt.title("Ground Truth: {}".format(example_targets[i]))
    plt.xticks([])
    plt.yticks([])
plt.show()

# 定义卷积神经网络结构
class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(1, 10, kernel_size=5) # 第一个卷积层,1个输入通道,10个输出通道,5x5卷积核
        self.conv2 = nn.Conv2d(10, 20, kernel_size=5) # 第二个卷积层,10个输入通道,20个输出通道,5x5卷积核
        self.conv2_drop = nn.Dropout2d() # Dropout层,防止过拟合
        self.fc1 = nn.Linear(320, 50) # 全连接层,320个输入,50个输出
        self.fc2 = nn.Linear(50, 10) # 全连接层,50个输入,10个输出

    def forward(self, x): # 前向传播
        x = F.relu(F.max_pool2d(self.conv1(x), 2)) # ReLU激活函数和最大池化
        x = F.relu(F.max_pool2d(self.conv2_drop(self.conv2(x)), 2)) # 第二个卷积层后接Dropout和池化
        x = x.view(-1, 320) # 展平特征图
        x = F.relu(self.fc1(x)) # 第一个全连接层后接ReLU
        x = F.dropout(x, training=self.training) # Dropout层
        x = self.fc2(x) # 第二个全连接层
        return F.log_softmax(x, dim=1) # 输出层使用log-softmax

# 创建网络实例
network = Net()
optimizer = optim.SGD(network.parameters(), lr=learning_rate, momentum=momentum)

# 初始化损失记录列表
train_losses = []
train_counter = []
test_losses = []
test_counter = [i * len(train_loader.dataset) for i in range(n_epochs + 1)]

# 定义训练函数
def train(epoch):
    network.train() # 设置为训练模式
    for batch_idx, (data, target) in enumerate(train_loader):
        optimizer.zero_grad() # 清空过往梯度
        output = network(data) # 前向传播
        loss = F.nll_loss(output, target) # 计算损失
        loss.backward() # 反向传播
        optimizer.step() # 更新参数
        if batch_idx % log_interval == 0:
            print('Train Epoch: {} [{}/{} ({:.0f}%)]\tLoss: {:.6f}'.format(epoch, batch_idx * len(data),
                                                                           len(train_loader.dataset),
                                                                           100. * batch_idx / len(train_loader),
                                                                           loss.item()))
            train_losses.append(loss.item())
            train_counter.append((batch_idx * 64) + ((epoch - 1) * len(train_loader.dataset)))
            torch.save(network.state_dict(), './model.pth')
            torch.save(optimizer.state_dict(), './optimizer.pth')


def test():
    network.eval()
    test_loss = 0
    correct = 0
    with torch.no_grad():
        for data, target in test_loader:
            output = network(data)
            test_loss += F.nll_loss(output, target, reduction='sum').item()
            pred = output.data.max(1, keepdim=True)[1]
            correct += pred.eq(target.data.view_as(pred)).sum()
    test_loss /= len(test_loader.dataset)
    test_losses.append(test_loss)
    print('\nTest set: Avg. loss: {:.4f}, Accuracy: {}/{} ({:.0f}%)\n'.format(
        test_loss, correct, len(test_loader.dataset),
        100. * correct / len(test_loader.dataset)))


train(1)

test()
for epoch in range(1, n_epochs + 1):
    train(epoch)
    test()

fig = plt.figure()
plt.plot(train_counter, train_losses, color='blue')
plt.scatter(test_counter, test_losses, color='red')
plt.legend(['Train Loss', 'Test Loss'], loc='upper right')
plt.xlabel('number of training examples seen')
plt.ylabel('negative log likelihood loss')

examples = enumerate(test_loader)
batch_idx, (example_data, example_targets) = next(examples)
with torch.no_grad():
    output = network(example_data)
fig = plt.figure()
for i in range(6):
    plt.subplot(2, 3, i + 1)
    plt.tight_layout()
    plt.imshow(example_data[i][0], cmap='gray', interpolation='none')
    plt.title("Prediction: {}".format(output.data.max(1, keepdim=True)[1][i].item()))
    plt.xticks([])
    plt.yticks([])
plt.show()

continued_network = Net()
continued_optimizer = optim.SGD(network.parameters(), lr=learning_rate, momentum=momentum)

network_state_dict = torch.load('model.pth')
continued_network.load_state_dict(network_state_dict)
optimizer_state_dict = torch.load('optimizer.pth')
continued_optimizer.load_state_dict(optimizer_state_dict)

for i in range(4, 9):
    test_counter.append(i * len(train_loader.dataset))
    train(i)
    test()

fig = plt.figure()
plt.plot(train_counter, train_losses, color='blue')
plt.scatter(test_counter, test_losses, color='red')
plt.legend(['Train Loss', 'Test Loss'], loc='upper right')
plt.xlabel('number of training examples seen')
plt.ylabel('negative log likelihood loss')
plt.show()

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献5条内容

所有评论(0)