”还怕抢课手速慢?抢不到课?“-”树维教务系统“-基于requests爬虫搭载多线程进行的退改选课,js逆向教程来啦(附源码)
·
免费分享,制作不易,烦请大家点个免费的关注和赞!谢谢
一、对要爬虫的网页分析:
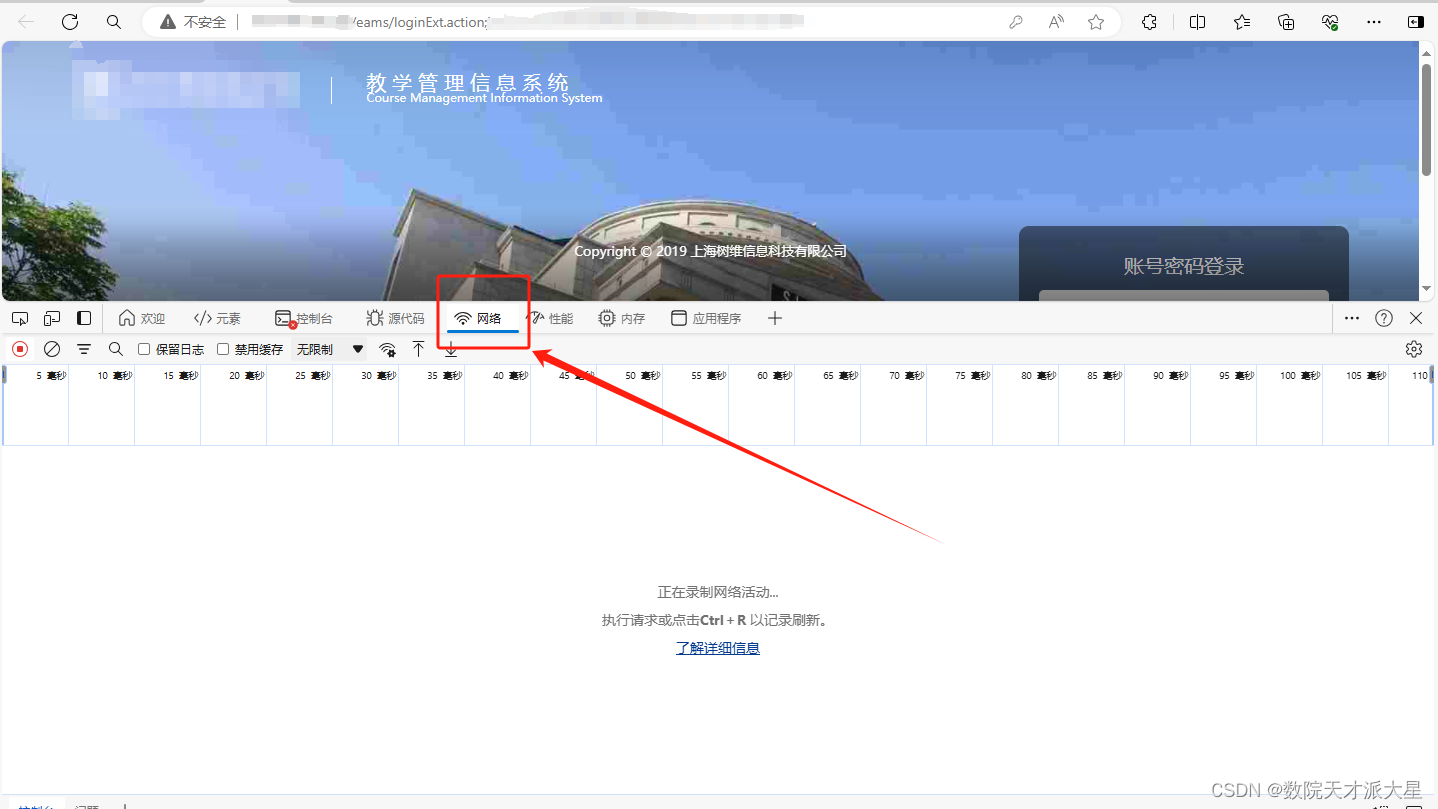
首先打开”开发者工具“,如图所示,找到这个网络选项(如果是英文版应该是Network),在这里进行抓包,输入账号密码后找到登录的数据包,附图如下:
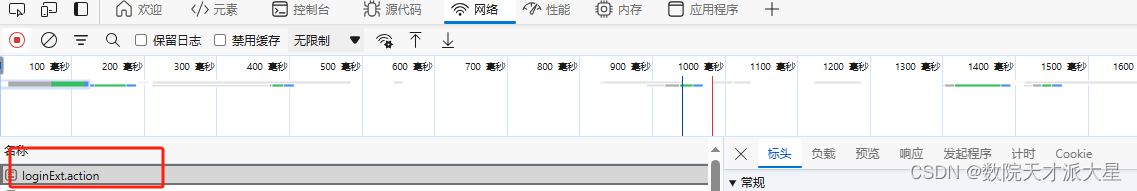
红框中的LoginExt.action就是要找的登录数据包了,接下来带着大家一步一步地分析登录的请求包,看下图:
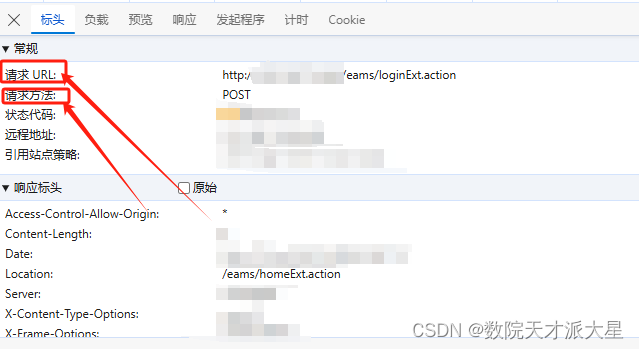
我们必须得到的是请求URL和请求方法(一般登录都是post方法),然后再看看我们它所需要的负载,也就是要请求时携带的数据,见下图:
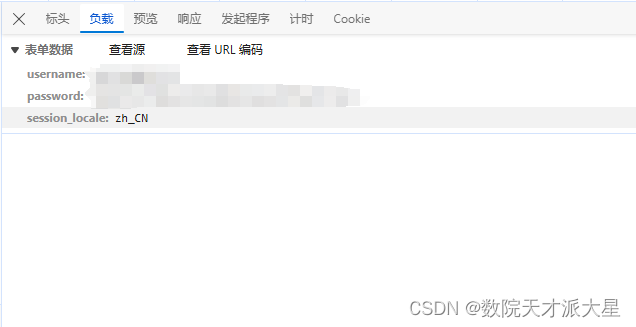
可以看到,它所要携带的数据其实就是password和username(账号和密码),什么?你问我为什么打码?因为我不想被加学分铁铁!
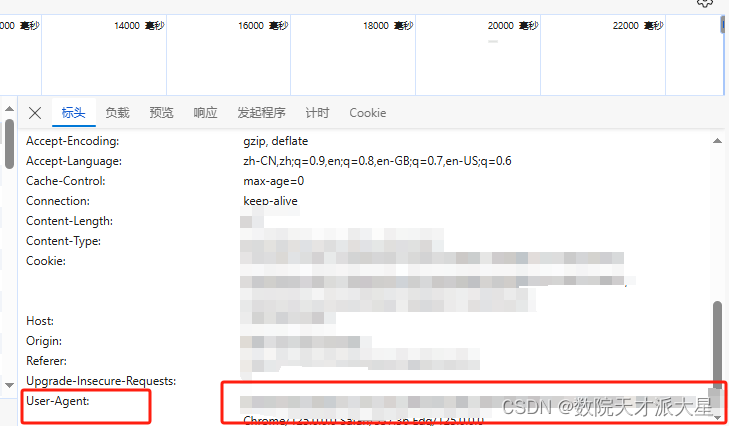
红框中也是必备的一个参数header,如果不加可能会被服务器识别为爬虫而拒绝请求。
到这里我们就已经得到了登录所需的全部数据,即:请求登录的URL丶请求方法丶password丶username丶header(上图User-Agent)。
二丶进行登录请求:
代码如下:
import  requests

URL="http://212.112.123.244/eams/loginExt.action"    ##请复制粘贴自己的登录请求URL

head={"Use-Agent":"Windows:Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/"
                  "537.36 (KHTML, like Gecko) Chrome/93.0.4577.63 Safari/537.36"}##请复制自己的header

data1={
    "password":"123",##密码
    "username":"123" ##账号(学号)
}
response=requests.post(url=URL,headers=head,data=data1)
print(response.text)
如果你的运行结果是这个:
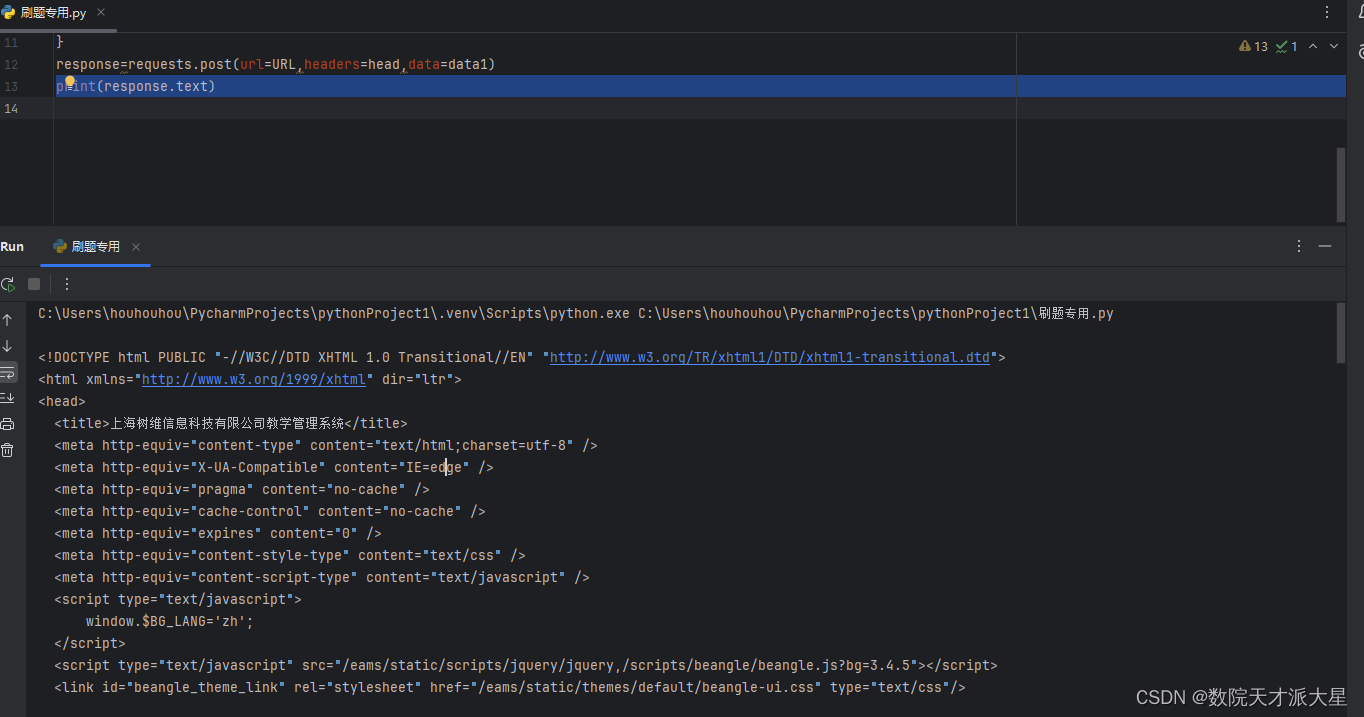
恭喜你!你已经成功地触摸到了抢课的”冰山一角“,也许你会看到此时并没有真正登录进去(即使你输入账号密码),因为这个网站在进行登录时会先把密码加密,再进行请求登录:
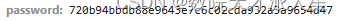 这就是加密后的密码,也即是说,你的密码必须和它一样,才能登录成功,下面就要涉及到解密了。
三丶js逆向解密真正登录(预告:确信!):
由于期末暂时不更新,放假更!
需要源码私聊(适用于SIAS或是同官网院校)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 20
 0
- 0


 已为社区贡献1条内容

所有评论(0)