Python爬虫---爬取豆瓣top250的数据和可视化
·
1.导入相应的库
import requests
headers = {
        'User-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/1'
}
response = requests.get('https://movie.douban.com/top250',headers=headers)
response
response.text
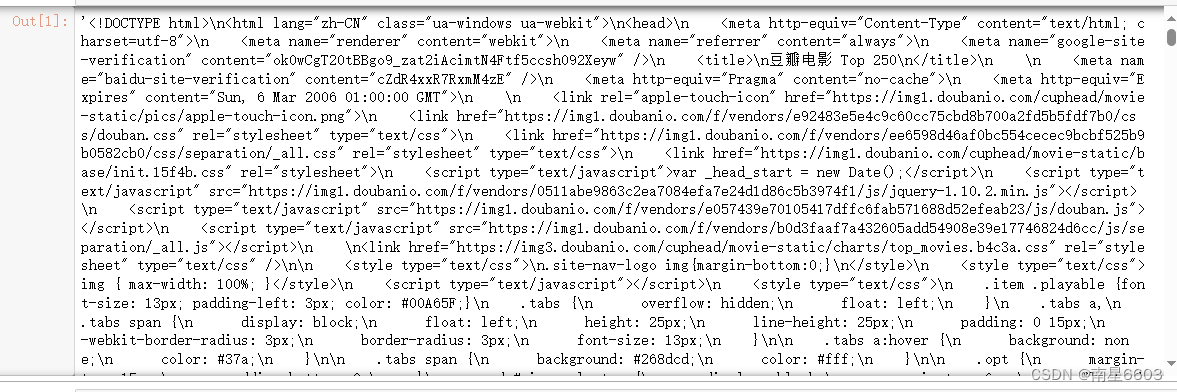
2.使用正则表达式解析
import re
title = re.findall('<span class="title">(.*?)</span>', response.text,re.S)
title
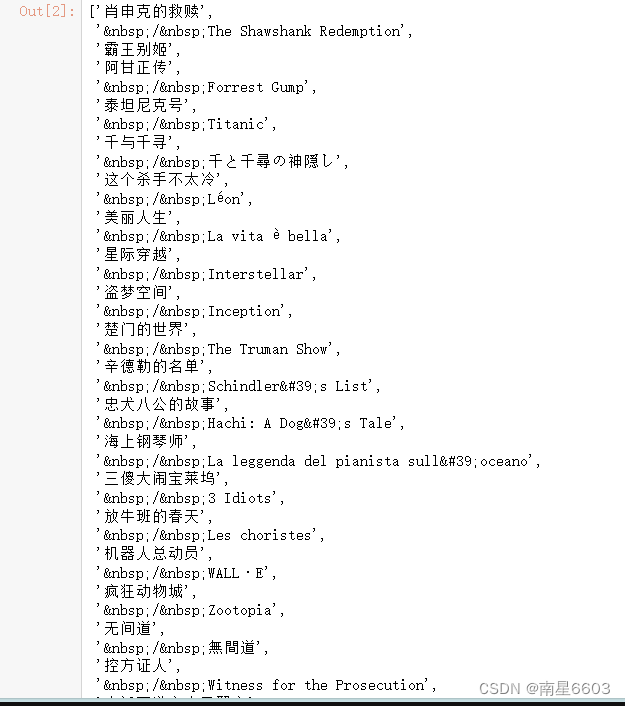
或者,使用BeautifulSoup解析(推荐)
import requests
from bs4 import BeautifulSoup
import csv

'''爬取豆瓣电影top20'''
def top250_crawer(url,sum):
    headers = {
        'User-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/1'

    }

    response = requests.get(url,headers = headers)
    soup = BeautifulSoup(response.text, 'html.parser')
    # print(soup)
    movie_items = soup.find_all('div', class_='item')
    i = sum+1
    for item in movie_items:
         title = item.select_one('.title').text
         # print(title)
         rating = item.select_one('.rating_num').text
         data = item.select('.bd p')[0].text.split('\n')
         time = data[2].replace(' ','').split('/')[0]
         country = data[2].replace(' ','').split('/')[1]
         print(str(i)+'.'+title+','+country+','+time)

         i +=1

url = 'https://movie.douban.com/top250'
sum =0
'遍历10页数据,250条结果'
for a in range(10):
    if sum == 0 :
        top250_crawer(url,sum)
        sum +=25
    else:
        page = '?start='+str(sum)+'&filter='
        new_url = url+page
        top250_crawer(new_url,sum)
        sum +=25
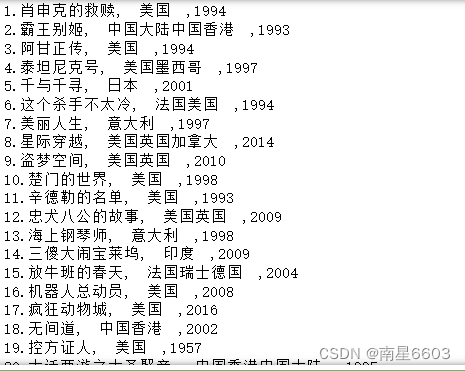
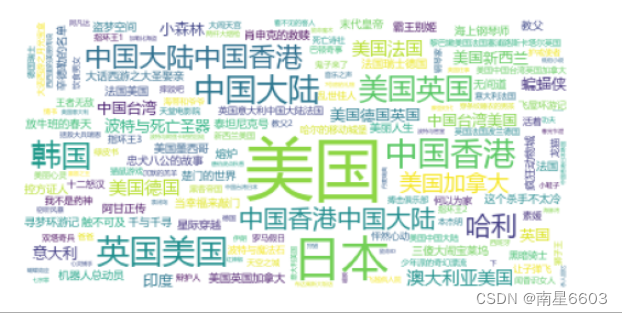
4.将获取到的豆瓣评分数据以词云的方式展示
import jieba
import matplotlib.pyplot as plt
import PIL.Image as image
from wordcloud import WordCloud,STOPWORDS
import numpy as np
with open('./豆瓣电影评分数据.txt', 'r', encoding='utf-8') as f:
    content = f.read()
word_list=jieba.cut(content)
new_list="".join(word_list)
wordcloud=WordCloud(background_color="white",font_path="C:\Windows\Fonts\msyh.ttc").generate(new_list)
plt.imshow(wordcloud)
plt.axis("off")
plt.show()

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)