机器学习的一般步骤(Kaggle中墨尔本房屋价格预测)
·
文章目录
🍉Kaggle机器学习:https://www.kaggle.com/code/dansbecker/how-models-work
在Kaggle中,一般对.csv文件进行处理,下面是机器学习的一般步骤:
| 流程 | 代码 |
|---|---|
| 1.读取数据 | pd.read_csv(file_path) |
| 2.获取主要属性 | home_data.columns |
| 3.拟合模型 | iowa_model.fit(X, y) |
| 4.预测 | iowa_model.predict(X) |
| 5.计算误差 | mean_absolute_error(y, predictions) |
| 6.保存模型 | output.to_csv('submission.csv', index=False) |
1. 读取数据
例如读取墨尔本的房屋数据(通过街道、年份等来预测价格)
数据链接[百度云]:链接:https://pan.baidu.com/s/1aipYsy3BRpFqrrKXZR6p8w?pwd=nyk3 提取码:nyk3
–来自百度网盘超级会员V1的分享
import pandas as pd

# Path of the file to read
iowa_file_path = '../input/home-data-for-ml-course/train.csv'

# Fill in the line below to read the file into a variable home_data
home_data = pd.read_csv(iowa_file_path)
1.1 查看数据的信息
🍊使用.describe()命令查看数据汇总的统计信息,获取数据的最大值、最小值和平均值等等
# 输出汇总的统计信息
home_data.describe()
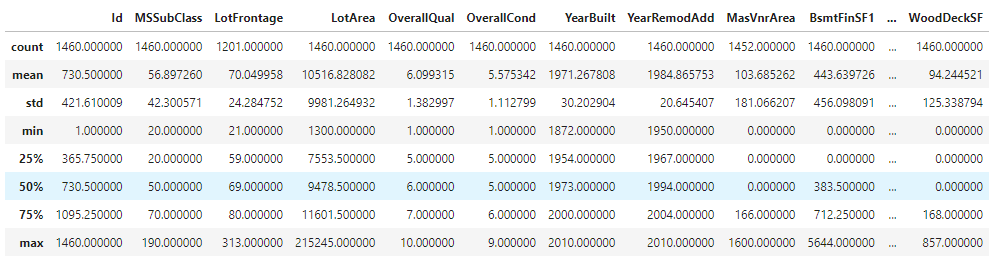
🍊使用.head()命令查看数据的前5行数据
# 查看数据的前5行数据
home_data.head()
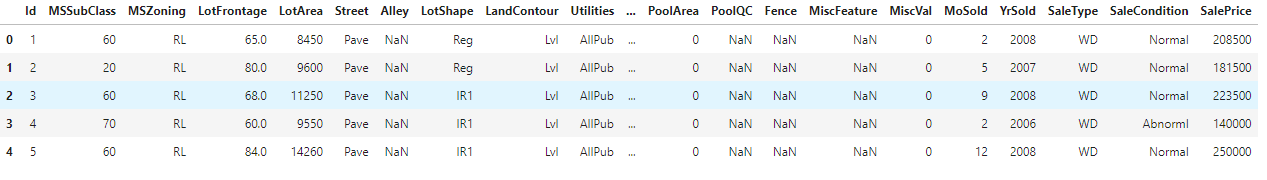
1.2 划分数据集
有时候需要对一个数据集进行训练集和测试集的划分,以便验证模型的可泛化性
使用 train_test_split 函数拆分数据,给它给予参数 random_state=1
# 引入划分函数
from sklearn.model_selection import train_test_split

# 进行数据的划分
train_X, val_X, train_y, val_y = train_test_split(X, y, random_state=1)
2. 获取数据的属性
- 使用
.columns命令获取列属性
# 输出数据的列属性
home_data.columns
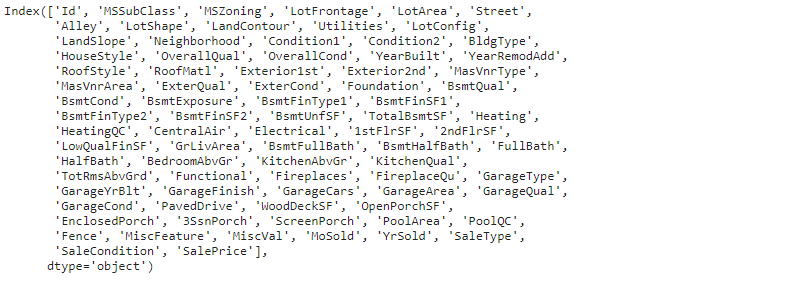
- 使用
.SalePrice命令获取实际的售卖价格y
# 获取实际的售卖价格
y = home_data.SalePrice
- 通过以下属性
"LotArea", "YearBuilt", "1stFlrSF", "2ndFlrSF", "FullBath", "BedroomAbvGr", "TotRmsAbvGrd"来预测房价,构成模型的输入数据X
# 创建属性列表
feature_names = ["LotArea", "YearBuilt", "1stFlrSF", "2ndFlrSF", "FullBath", "BedroomAbvGr", "TotRmsAbvGrd"]

# 选择“feature_names”中特征对应的数据
X = home_data[feature_names]
3. 拟合模型
模型选择一个即可
3.1 决策树模型
使用决策树DecisionTreeRegress模型,对上面的X和y进行拟合
from sklearn.tree import DecisionTreeRegressor
# 定义模型
# 为了模型的再现性,在指定模型时为random_state设置一个数值
iowa_model = DecisionTreeRegressor(random_state=1)

# 拟合模型
iowa_model.fit(X, y)
3.2 随机森林模型
使用决策树RandomForestRegressor模型,对上面的X和y进行拟合
# 引入随机森林和平均绝对误差
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_absolute_error

# 定义随机森林模型
rf_model = RandomForestRegressor(random_state=1)

# 拟合模型
rf_model.fit(X, y)
4. 做出预测
使用模型的 predict 命令使用 X 作为数据进行预测。将结果保存到名为 predictions 的变量中
# 使用predict命令进行价格预测
predictions = iowa_model.predict(X)

# 查看预测价格
print(predictions)
# 查看实际价格
print(y.head())
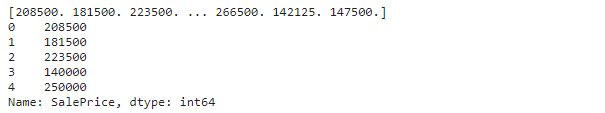
5. 计算误差
5.1 计算数据的平均绝对误差
# 引入函数
from sklearn.metrics import mean_absolute_error

# 计算平均绝对误差
mae = mean_absolute_error(y, predictions)

# 输出误差
print("Validation MAE for Decision Tree Model: {}".format(mae))
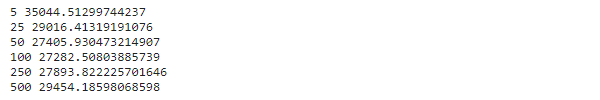
5.2 输出不同叶节点下的误差
# 定义获取误差的函数
def get_mae(max_leaf_nodes, train_X, val_X, train_y, val_y):
    model = DecisionTreeRegressor(max_leaf_nodes=max_leaf_nodes, random_state=0)
    model.fit(train_X, train_y)
    preds_val = model.predict(val_X)
    mae = mean_absolute_error(val_y, preds_val)
    return(mae)

# 输出不同叶节点下的误差
candidate_max_leaf_nodes = [5, 25, 50, 100, 250, 500]
for leaf_nodes in candidate_max_leaf_nodes:
    mae = get_mae(leaf_nodes, train_X, val_X, train_y, val_y)
    print(leaf_nodes, mae)
6. 保存模型
对训练的模型进行保存,生成一个CSV文件
output = pd.DataFrame({'Id': test_data.Id,
                       'SalePrice': test_preds})
output.to_csv('submission.csv', index=False)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献5条内容

所有评论(0)