人工智能/机器学习基础知识——自编码器(AutoEncoder,AE)
Auto-Encoder(AutoEncoder AE)
自编码器
-
自编码器将数据映射到特征空间得到每个样本的编码,并希望这组编码可以重构出原来的样本
-
Encoder
编码器
f:RD→RM f: \mathbb{R}^{D} \rightarrow \mathbb{R}^{M} f:RD→RM
-
Decoder
解码器
g:RM→RD g: \mathbb{R}^{M} \rightarrow \mathbb{R}^{D} g:RM→RD
-
目标函数:最小化重构错误(Reconstruction Error)
L=∑n=1N∥x(n)−g(f(x(n)))∥2=∑n=1N∥x(n)−f∘g(x(n))∥2 \begin{aligned} \mathcal{L} &=\sum_{n=1}^{N}\left\|\boldsymbol{x}^{(n)}-g\left(f\left(\boldsymbol{x}^{(n)}\right)\right)\right\|^{2} \\ &=\sum_{n=1}^{N}\left\|\boldsymbol{x}^{(n)}-f \circ g\left(\boldsymbol{x}^{(n)}\right)\right\|^{2} \end{aligned} L=n=1∑Nx(n)−g(f(x(n)))2=n=1∑Nx(n)−f∘g(x(n))2
-
One Simple Example
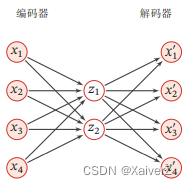
z=f(W(1)x+b(1)) z=f\left(\boldsymbol{W}^{(1)} \boldsymbol{x}+\boldsymbol{b}^{(1)}\right) z=f(W(1)x+b(1))
x′=f(W(2)za+b(2)) \boldsymbol{x}^{\prime}=f\left(\boldsymbol{W}^{(2)} z_{a}+\boldsymbol{b}^{(2)}\right) x′=f(W(2)za+b(2))
L=∑n=1N∥x(n)−x′(n)∥2+λ∥W∥F2 \mathcal{L}=\sum_{n=1}^{N} \| \boldsymbol{x}^{(n)}-\boldsymbol{x}^{\prime(n)}\left\|^{2}+\lambda\right\| \boldsymbol{W} \|_{F}^{2} L=n=1∑N∥x(n)−x′(n)2+λW∥F2
-
使用自编码器是为了得到有效的数据表示,因此在训练结束后,我们一般会去掉解码器,只保留编码器.编码器的输出可以直接作为后续机器学习模型的输入
Sparse Auto-Encoder
稀疏自编码器
-
编码向量zzz的维度MMM大于输入样本xxx的维度DDD,且zzz尽可能稀疏
-
稀疏性度量函数
-
L0L_0L0范数
ρ(z)=∑m=1MI(∣zm∣>0) \rho(z)=\sum_{m=1}^{M} \mathbf{I}\left(\left|z_{m}\right|>0\right) ρ(z)=m=1∑MI(∣zm∣>0)
-
L1L_1L1范数
ρ(z)=∑m=1M∣zm∣ \rho(\boldsymbol{z})=\sum_{m=1}^{M}\left|z_{m}\right| ρ(z)=m=1∑M∣zm∣
-
对数函数
ρ(z)=∑m=1Mlog(1+zm2) \rho(z)=\sum_{m=1}^{M} \log \left(1+z_{m}^{2}\right) ρ(z)=m=1∑Mlog(1+zm2)
-
指数函数
ρ(z)=∑m=1M−exp(−zm2) \rho(\boldsymbol{z})=\sum_{m=1}^{M}-\exp \left(-z_{m}^{2}\right) ρ(z)=m=1∑M−exp(−zm2)
-
-
目标函数
L=∑n=1N∥x(n)−x′(n)∥2+ηρ(Z)+λ∥W∥2 \mathcal{L}=\sum_{n=1}^{N} \| \boldsymbol{x}^{(n)}-\boldsymbol{x}^{\prime(n)}\left\|^{2}+\eta \rho(\boldsymbol{Z})+\lambda\right\| \boldsymbol{W} \|^{2} L=n=1∑N∥x(n)−x′(n)2+ηρ(Z)+λW∥2
Z=[z(1),⋯ ,z(N)]\boldsymbol{Z}=\left[\boldsymbol{z}^{(1)}, \cdots, \boldsymbol{z}^{(N)}\right]Z=[z(1),⋯,z(N)]表示所有训练样本的编码,ρ(Z)\rho(\boldsymbol{Z})ρ(Z)为稀疏性度量函数-
这里的稀疏性度量函数还可以定义为一组训练样本中每一个神经元激活的概率。给定NNN个训练样本,隐藏层第jjj个神经元平均活性值为
ρ^j=1N∑n=1Nzj(n) \hat{\rho}_{j}=\frac{1}{N} \sum_{n=1}^{N} z_{j}^{(n)} ρ^j=N1n=1∑Nzj(n)
ρ^j\hat{\rho}_{j}ρ^j可以近似看作第jjj个神经元激活的概率 -
我们希望ρ^j\hat{\rho}_{j}ρ^j接近于一个事先给定的值ρ∗\rho^{*}ρ∗,例如0.050.050.05,可以通过KL散度来衡量两者的差异
KL(ρ∗∥ρ^j)=ρ∗logρ∗ρ^j+(1−ρ∗)log1−ρ∗1−ρ^j \mathrm{KL}\left(\rho^{*} \| \hat{\rho}_{j}\right)=\rho^{*} \log \frac{\rho^{*}}{\hat{\rho}_{j}}+\left(1-\rho^{*}\right) \log \frac{1-\rho^{*}}{1-\hat{\rho}_{j}} KL(ρ∗∥ρ^j)=ρ∗logρ^jρ∗+(1−ρ∗)log1−ρ^j1−ρ∗
-
故稀疏性度量函数可定义为
ρ(Z)=∑j=1pKL(ρ∗∥ρ^j) \rho(\boldsymbol{Z})=\sum_{j=1}^{p} \operatorname{KL}\left(\rho^{*} \| \hat{\rho}_{j}\right) ρ(Z)=j=1∑pKL(ρ∗∥ρ^j)
-
Stacked Auto-Encoder(SAE)
堆叠自编码器
Denoising Auto-Encoder(DAE)
降噪自编码器
- 通过引入噪声来增加编码鲁棒性
Variational Auto-Encoder(VAE)
变分自编码器

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献10条内容

所有评论(0)