人工智能/机器学习基础知识——决策树(Decision Tree)
决策树
-
学习流程
- 关键在于每次划分到叶节点时,可能子集中仍包含多个类别的样本,此时选择最多样本的类别作为叶节点标记
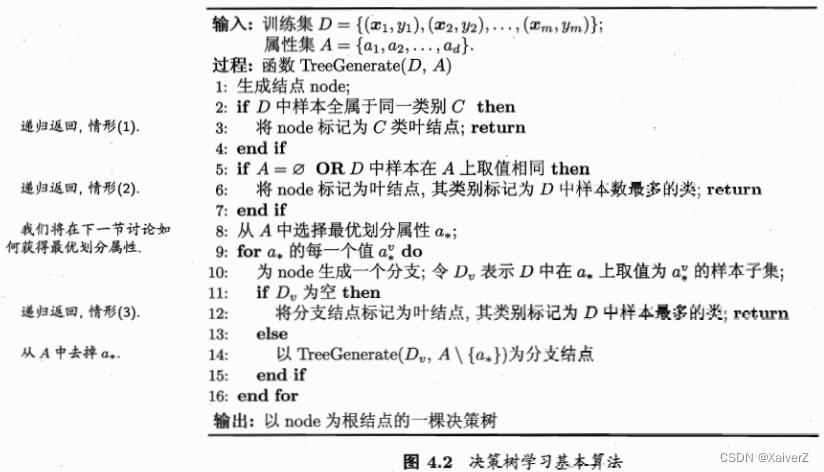
划分选择
如何选择最优划分属性,使决策树的分支节点所包含的样本尽可能属于同一类别,即节点的“纯度”(Purity)越来越高
信息增益
Information Gain
-
信息熵(Information Entropy)
度量样本集合纯度
Ent(D)=−∑k=1∣Y∣pklog2pk \operatorname{Ent}(D)=-\sum_{k=1}^{|\mathcal{Y}|} p_{k} \log _{2} p_{k} Ent(D)=−k=1∑∣Y∣pklog2pk
其中,pkp_kpk表示当前样本集合DDD中第kkk类样本所占的比例。Ent(D)Ent(D)Ent(D)的值越小,则DDD的纯度越高(Ent(D)Ent(D)Ent(D)最小值为0,最大值为log2∣Y∣log_{2}|\mathcal{Y}|log2∣Y∣) -
信息增益(Information Gain)
属性aaa对样本集DDD进行划分所获得的信息增益
Gain(D,a)=Ent(D)−∑v=1V∣Dv∣∣D∣Ent(Dv) \operatorname{Gain}(D, a)=\operatorname{Ent}(D)-\sum_{v=1}^{V} \frac{\left|D^{v}\right|}{|D|} \operatorname{Ent}\left(D^{v}\right) Gain(D,a)=Ent(D)−v=1∑V∣D∣∣Dv∣Ent(Dv)
VVV表示属性aaa划分产生的分支节点数-
一般而言,信息增益越大,则意味着使用属性a来进行划分所获得的“纯度提升”越大。因此可以根据信息增益来选择划分属性:
a∗=argmaxa∈AGain(D,a) a_{*}=\underset{a \in A}{\arg \max } \operatorname{Gain}(D, a) a∗=a∈AargmaxGain(D,a)
-
ID3决策树算法就是以信息增益为准则来选择划分属性
-
增益率(Gain Ratio)
C4.5决策树使用增益率选择划分属性
Gainratio(D,a)=Gain(D,a)IV(a) \operatorname{Gain}_{\operatorname{ratio}}(D, a)=\frac{\operatorname{Gain}(D, a)}{\operatorname{IV}(a)} Gainratio(D,a)=IV(a)Gain(D,a)
IV(a)=−∑v=1V∣Dv∣∣D∣log2∣Dv∣∣D∣
\operatorname{IV}(a)=-\sum_{v=1}^{V} \frac{\left|D^{v}\right|}{|D|} \log _{2} \frac{\left|D^{v}\right|}{|D|}
IV(a)=−v=1∑V∣D∣∣Dv∣log2∣D∣∣Dv∣
IV(a)IV(a)IV(a)称为属性aaa的固有值(Intrinsic Value),属性aaa的可能取值数目越多,则IV(a)IV(a)IV(a)的值通常会越大
- 信息增益准则对可取值数目较多的属性有所偏好,但增益率准则却对可取值数目较少的属性有所偏好。因此C4.5算法并不是直接选择增益率最大的候选划分属性,而是先从划分候选属性中找出信息增益高于平均水平的属性,再从中选择增益率最高的
基尼指数(Gini Index)
CART(Classification and Regression Tree)决策树使用基尼指数来选择划分属性
-
数据集D的纯度可用基尼值来度量
- 基尼值反映了从数据集D中随机抽取两个样本,其类别标记不一致的概率。因此Gini(D)Gini(D)Gini(D)越小,则数据集D的纯度越高
Gini(D)=∑k=1∣Y∣∑k′≠kpkpk′=1−∑k=1∣Y∣pk2 \begin{aligned} \operatorname{Gini}(D) &=\sum_{k=1}^{|\mathcal{Y}|} \sum_{k^{\prime} \neq k} p_{k} p_{k^{\prime}} \\ &=1-\sum_{k=1}^{|\mathcal{Y}|} p_{k}^{2} \end{aligned} Gini(D)=k=1∑∣Y∣k′=k∑pkpk′=1−k=1∑∣Y∣pk2
- 基尼指数定义
Gini_index(D,a)=∑v=1V∣Dv∣∣D∣Gini(Dv) \text{Gini\_index}(D, a)=\sum_{v=1}^{V} \frac{\left|D^{v}\right|}{|D|} \operatorname{Gini}\left(D^{v}\right) Gini_index(D,a)=v=1∑V∣D∣∣Dv∣Gini(Dv)
- 选择基尼指数最小的作为划分属性
a∗=argmina∈AGini_index(D,a) a_{*}=\underset{a \in A}{\arg \min } \operatorname{Gini}\_\operatorname{index}(D, a) a∗=a∈AargminGini_index(D,a)
剪枝处理(Pruning)
缓解过拟合
泛化性能在验证集上评估
-
预剪枝(Prepruning)
在决策树生成过程中,在节点划分前先进行估计,若当前节点划分不能带来泛化性能提升,则停止划分并将当前节点标记为叶节点
- 虽然在一定程度上降低了过拟合的风险,显著减少决策树的训练时间开销和测试时间开销,但也可能会导致泛化性能下降,带来欠拟合的风险
-
后剪枝(Postpruning)
先生成一棵完整的决策树,自底向上对非叶节点进行考察,若将该节点对应的子树替换为叶节点能提升泛化性能,则将该子树替换为叶节点
- 后剪枝一般比预剪枝保留更多的分支,一般情况下后剪枝欠拟合的风险较小,泛化性能往往优于预剪枝决策树。但后剪枝是在完全生成决策树后进行的,并且要自底向上遍历非叶节点,因此训练时间开销比未剪枝和预剪枝决策树都要大得多
连续与缺失值
-
连续值处理
二分法(C4.5采用的策略)
-
假设某属性a在样本集D中有n个取值,将它们从小到大排列,以如下公式考虑划分点的选择
Ta={ai+ai+12∣1⩽i⩽n−1} T_{a}=\left\{\frac{a^{i}+a^{i+1}}{2} \mid 1 \leqslant i \leqslant n-1\right\} Ta={2ai+ai+1∣1⩽i⩽n−1}
即把属性a紧邻的两个取值的中位点当作划分点 -
与离散值不同的是,我们需要依次考虑每个划分点,依次计算在每个划分点之下的各种系数,如信息增益、基尼指数等,而后取最大值(因为连续值考虑的是二叉分支,而离散值直接考虑了多叉分支,所以对于连续值不能一次性考虑所有划分点,需要针对每一个划分点依次考虑)
Gain(D,a)=maxt∈TaGain(D,a,t)=maxt∈TaEnt(D)−∑λ∈{−,+}∣Dtλ∣∣D∣Ent(Dtλ) \begin{aligned} \operatorname{Gain}(D, a) &=\max _{t \in T_{a}} \operatorname{Gain}(D, a, t) \\ &=\max _{t \in T_{a}} \operatorname{Ent}(D)-\sum_{\lambda \in\{-,+\}} \frac{\left|D_{t}^{\lambda}\right|}{|D|} \operatorname{Ent}\left(D_{t}^{\lambda}\right) \end{aligned} Gain(D,a)=t∈TamaxGain(D,a,t)=t∈TamaxEnt(D)−λ∈{−,+}∑∣D∣DtλEnt(Dtλ)
-
与离散属性不同,连续属性还可作为后代结点的划分属性(只不过该属性的划分点不能再用了而已)
-
-
缺失值处理
总体思想是利用完整无缺失值的样本的分布来预测整体带有缺失值的数据集的分布
C4.5采取了这种解决方案
-
DDD:训练集;D~\tilde{D}D~:DDD在属性aaa中没有缺失值的样本;D~v\tilde{D}^vD~v:D~\tilde{D}D~中在属性aaa上取值为ava^vav的样本子集;D~k\tilde{D}_kD~k:表示D~\tilde{D}D~中属于第kkk类的样本子集;假定为每个样本赋予一个初始权重wxw_xwx
ρ=∑x∈D~wx∑x∈Dwxp~k=∑x∈D~kwx∑x∈D~wx(1⩽k⩽∣Y∣),r~v=∑x∈D~vwx∑x∈Dˉwx(1⩽v⩽V) \begin{aligned} \rho &=\frac{\sum_{\boldsymbol{x} \in \tilde{D}} w_{\boldsymbol{x}}}{\sum_{\boldsymbol{x} \in D} w_{\boldsymbol{x}}} \\ \tilde{p}_{k} &=\frac{\sum_{\boldsymbol{x} \in \tilde{D}_{k}} w_{\boldsymbol{x}}}{\sum_{\boldsymbol{x} \in \tilde{D}} w_{\boldsymbol{x}}} \quad(1 \leqslant k \leqslant|\mathcal{Y}|), \\ \tilde{r}_{v} &=\frac{\sum_{\boldsymbol{x} \in \tilde{D}^{v}} w_{\boldsymbol{x}}}{\sum_{\boldsymbol{x} \in \bar{D}} w_{\boldsymbol{x}}} \quad(1 \leqslant v \leqslant V) \end{aligned} ρp~kr~v=∑x∈Dwx∑x∈D~wx=∑x∈D~wx∑x∈D~kwx(1⩽k⩽∣Y∣),=∑x∈Dˉwx∑x∈D~vwx(1⩽v⩽V)
对于属性aaa,ρρρ表示无缺失值样本所占的比例,p~k\tilde{p}_kp~k表示无缺失值样本中第kkk类所占的比例,r~v\tilde{r}_vr~v表示无缺失值样本中在属性aaa上取值ava^vav的样本所占的比例 -
基于上述定义,推广信息增益:
Gain(D,a)=ρ×Gain(D~,a)=ρ×(Ent(D~)−∑v=1Vr~vEnt(D~v)) \begin{aligned} \operatorname{Gain}(D, a) &=\rho \times \operatorname{Gain}(\tilde{D}, a) \\ &=\rho \times\left(\operatorname{Ent}(\tilde{D})-\sum_{v=1}^{V} \tilde{r}_{v} \operatorname{Ent}\left(\tilde{D}^{v}\right)\right) \end{aligned} Gain(D,a)=ρ×Gain(D~,a)=ρ×(Ent(D~)−v=1∑Vr~vEnt(D~v))
Ent(D~)=−∑k=1∣Y∣p~klog2p~k \operatorname{Ent}(\tilde{D})=-\sum_{k=1}^{|\mathcal{Y}|} \tilde{p}_{k} \log _{2} \tilde{p}_{k} Ent(D~)=−k=1∑∣Y∣p~klog2p~k
-
若样本xxx在划分属性aaa上的取值已知,则将xxx划入与其取值对应的子节点,且权值保持为wxw_xwx;若未知,则将其同时划入所有子节点,且权值分别调整为r~v⋅wx\tilde{r}_v · w_xr~v⋅wx
-
多变量决策树
Multivariate Decision Tree
-
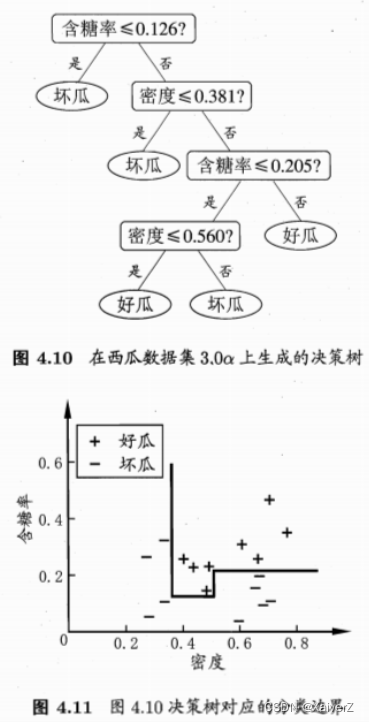
将每个属性aaa视为坐标空间的一个坐标轴,nnn个属性就可描述成nnn维空间中的一个点,而非叶节点可描述成坐标空间中的分类边界,单变量决策树(Univariate Decision Tree)的决策边界与坐标轴平行
-
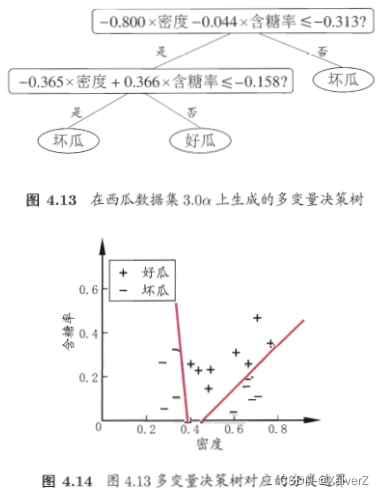
多变量决策树非叶节点不再仅针对某个属性,而是各种属性的线性组合

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 15
 0
- 0


 已为社区贡献10条内容

所有评论(0)