机器学习实验一:k-近邻算法 实验
目录
一、k-近邻算法概述
1. k-近邻算法的定义
k-近邻算法是一种常用的监督学习算法,用于分类和回归任务。它采用测量不同特征值之间的距离方法进行分类,适用于数值型和标称型数据。其优点是精度高、对异常值不敏感、无数据输入假定;缺点是计算复杂度高、空间复杂度高。
k-近邻算法(kNN)的工作原理:存在一个样本数据集合,也称作训练样本集,并且样本集中每个数据都存在标签,即我们知道样本集中每一数据与所属分类的对应关系。输入没有标签的新数据后,将新数据的每个特征与样本集中数据对应的特征进行比较,然后算法提取样本集中特征最相似数据(最近邻)的分类标签。一般来说,我们只选择样本数据集中前k个最相似的数据,这就是k-近邻算法中k的出处,通常k是不大于20的整数。最后,选择k个最相似数据中出现次数最低的分类,作为新数据的分类。
2.k-近邻算法的关键要素
1.距离度量方法
已知数据和测试数据的距离有多种度量方式,比如曼哈顿距离,欧式距离,余弦距离等。在KNN算法中常使用的距离计算方式是欧式距离,以计算两个向量点 A(x1,y1)和B(x2,y2)的距离为例,计算公式如下:
2.k值的影响
选择合适的k值对算法的性能影响较大,通常通过交叉验证等方法来确定最优的k值。
对于kNN算法,如果k值设置得太小,kNN模型可能会对训练数据中的噪声反应过激,导致在训练集上表现得非常好,但在测试集上表现不佳。这种情况可以看作是kNN的一种“过拟合”。例如,当k=1时,模型可能会对训练数据中的每一个点都找到一个非常接近的“邻居”,这可能会导致模型在新数据上表现不佳。
如果k值设置得太大,模型可能会忽略掉很多有用的局部信息,导致模型变得过于泛化,不能很好地反映训练数据的真实分布。这种情况可以看作是kNN的一种“欠拟合”。例如,当k的值接近于训练集的大小时,模型几乎就是在做简单的多数投票,忽略了每个测试样本周围的局部信息。
二、kNN实现鸢尾花分类
(一)实验过程
1.导入模块
import pandas as pd
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
2.获取数据集
利用sklearn.datasets.load_*从本地获取小规模数据集
#Iris数据集是最常见的分类实验数据集,也被称为鸢尾花卉数据集
# 加载鸢尾花数据集(特征值有4种 目标值有3种)
iris = load_iris()
3.数据集显示及基本处理
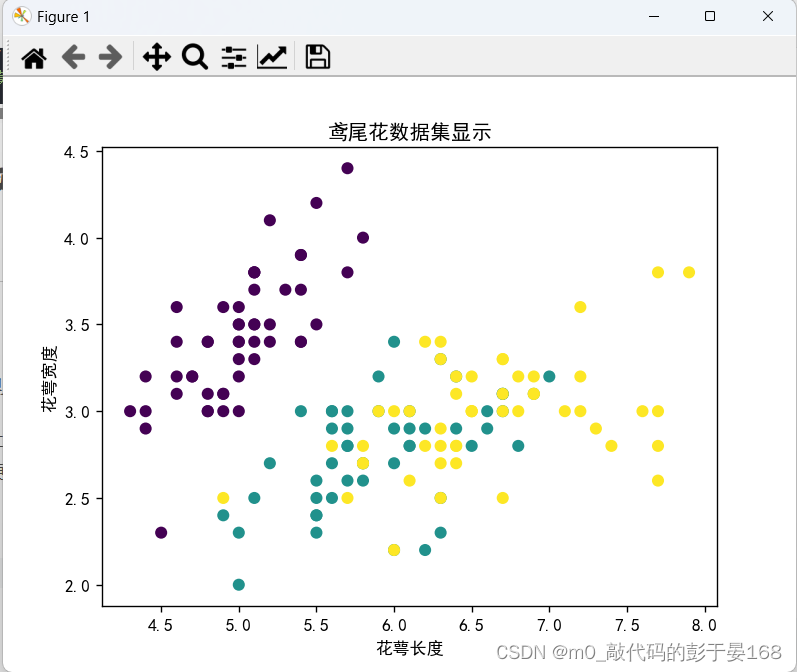
对数据集进行数据类型转换,并可视化数据散点图 ;
利用sklearn中train_test_split()函数将数据集拆分为训练集和测试集;
# 数据类型转换,把数据集用DataFrame存储
df = pd.DataFrame(data=iris.data, columns=iris.feature_names)
df['target'] = iris.target

# 可视化数据散点图 c表示颜色,不同颜色对应不同的鸢尾花种类
#通过设置font.sans-serif 参数为'SimHei'(黑体),确保在图形中正确显示中文
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.figure()
plt.scatter(df.iloc[:, 0], df.iloc[:, 1], c=df['target'])
plt.title('鸢尾花数据集显示')
plt.xlabel('花萼长度')
plt.ylabel('花萼宽度')
plt.show()

# 划分训练集和测试集
# x:数据集的特征值,y:数据集的目标值
x_train, x_test, y_train, y_test = train_test_split(df[iris.feature_names], df['target'], test_size=0.2, random_state=25)
鸢尾花数据集展示
4.构造kNN分类器
# 定义kNN分类器,n_neighbors表示选取的最近邻数目(k值最好不超过20 可任选)
knn = KNeighborsClassifier( n_neighbors=5 )
5.模型评估
# 模型评估
knn.fit(x_train, y_train)
# 用kNN分类器对测试集进行预测
y_pred = knn.predict(x_test)

# 方法1:比对测试集的预测值和真实值
#print("测试集的预测值:\n", y_pred)
#print("预测值和真实值对比:\n", y_pred==y_test )

# 方法2:直接输出准确率
accuracy = accuracy_score(y_test, y_pred)
print("模型预测的准确率:\n", accuracy)
模型评估运行结果如下所示:

6.探究不同K值对于准确率的影响
# 探究k值影响
model_new = {
    KNeighborsClassifier(n_neighbors=2),
    KNeighborsClassifier(n_neighbors=3),
    KNeighborsClassifier(n_neighbors=4),
    KNeighborsClassifier(n_neighbors=5),
    KNeighborsClassifier(n_neighbors=6),
    KNeighborsClassifier(n_neighbors=7),
    KNeighborsClassifier(n_neighbors=8),
    KNeighborsClassifier(n_neighbors=9),
    KNeighborsClassifier(n_neighbors=10),
}
score_list = []	# 定义一个列表
for model in model_new:	# 一一迭代
    model.fit(x_train,y_train)	# 训练
    y_pred = model.predict(x_test)
    score = accuracy_score(y_test, y_pred)
    score_list.append(score)	# 保存准确率
# 不同k值对模型评估准确率影响的柱状图
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.figure()
plt.bar(range(len(score_list)),score_list)
plt.title('不同K值准确率')
plt.show()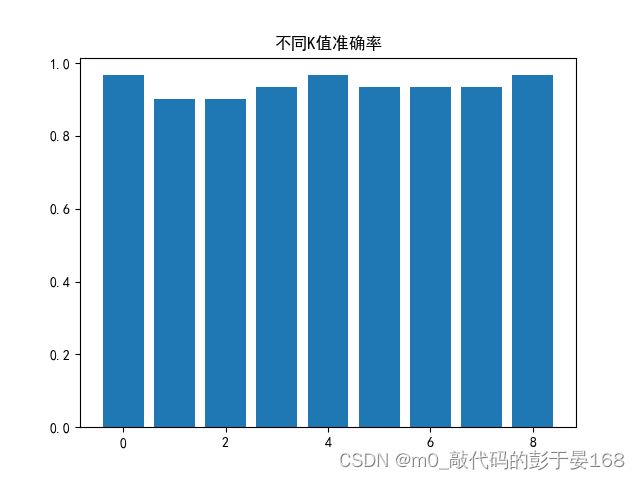
(二)案例全代码
import pandas as pd
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

#Iris数据集是最常见的分类实验数据集,也被称为鸢尾花卉数据集
# 加载鸢尾花数据集(特征值有4种 目标值有3种)
iris = load_iris()

# 数据类型转换,把数据集用DataFrame存储
df = pd.DataFrame(data=iris.data, columns=iris.feature_names)
df['target'] = iris.target

# 可视化数据散点图 c表示颜色,不同颜色对应不同的鸢尾花种类
#通过设置font.sans-serif 参数为'SimHei'(黑体),确保在图形中正确显示中文
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.figure()
plt.scatter(df.iloc[:, 0], df.iloc[:, 1], c=df['target'])
plt.title('鸢尾花数据集显示')
plt.xlabel('花萼长度')
plt.ylabel('花萼宽度')
plt.show()

# 划分训练集和测试集
# x:数据集的特征值,y:数据集的目标值
x_train, x_test, y_train, y_test = train_test_split(df[iris.feature_names], df['target'], test_size=0.2, random_state=25)

# 定义kNN分类器,n_neighbors表示选取的最近邻数目
knn = KNeighborsClassifier( n_neighbors=5 )

# 模型评估
knn.fit(x_train, y_train)
# 用kNN分类器对测试集进行预测
y_pred = knn.predict(x_test)

# 方法1:比对测试集的预测值和真实值
#print("测试集的预测值:\n", y_pred)
#print("预测值和真实值对比:\n", y_pred==y_test )

# 方法2:直接输出准确率
accuracy = accuracy_score(y_test, y_pred)
print("模型预测的准确率:\n", accuracy)

# 探究k值影响
model_new = {
    KNeighborsClassifier(n_neighbors=2),
    KNeighborsClassifier(n_neighbors=3),
    KNeighborsClassifier(n_neighbors=4),
    KNeighborsClassifier(n_neighbors=5),
    KNeighborsClassifier(n_neighbors=6),
    KNeighborsClassifier(n_neighbors=7),
    KNeighborsClassifier(n_neighbors=8),
    KNeighborsClassifier(n_neighbors=9),
    KNeighborsClassifier(n_neighbors=10),
}
score_list = []	# 定义一个列表
for model in model_new:	# 一一迭代
    model.fit(x_train,y_train)	# 训练
    y_pred = model.predict(x_test)
    score = accuracy_score(y_test, y_pred)
    score_list.append(score)	# 保存准确率
# 不同k值对模型评估准确率影响的柱状图
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.figure()
plt.bar(range(len(score_list)),score_list)
plt.title('不同K值准确率')
plt.show()
总结
使用kNN算法对鸢尾花数据集进行了分类,并评估了分类器的性能。从实验结果来看,模型在测试集上达到了较高的准确率,说明kNN算法对于鸢尾花数据集的分类还是有效的。
但是,虽然kNN算法简单易懂且易于实现,但它也有一些局限性,比如对数据的预处理和特征选择较为敏感,以及在大规模数据集上计算复杂度较高等。因此,在选择分类算法时,我们需要根据具体的应用场景和数据特点进行权衡和选择。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献1条内容

所有评论(0)