周志华西瓜书《机器学习》习题提示——第4章
习题提示
4.1:
参考4.5 决策树算法中涉及的准则(叶子、划分、剪枝)中基于“最小训练误差”选择划分属性。
4.2:参考4.5 决策树算法中涉及的准则(叶子、划分、剪枝)。
涉及的准则有三类:
(1)叶子学习准则:即标识叶子结点的类别准则,如,以落入该叶子结点中样本最多的类别为叶子结点的类别,当出现并列“最多”时,以某种偏好确定。
(2)划分选择(选择划分属性)准则。
(3)剪枝准则。
本题是讨论(2),类比信息增益准则,即可构造出“最小训练误差”准则,即4.5 决策树算法中涉及的准则(叶子、划分、剪枝)图4.6 划分选择。
其中,
D
=
D
a
1
⋃
D
a
2
⋃
⋯
⋃
D
a
V
D=D_a^1\bigcup D_a^2\bigcup \cdots \bigcup D_a^V
D=Da1⋃Da2⋃⋯⋃DaV表示
D
D
D的基于
a
a
a的划分,将
D
a
1
,
D
a
2
,
⋯
,
D
a
V
D_a^1,D_a^2,\cdots,D_a^V
Da1,Da2,⋯,DaV“视为”叶子结点(图中虚线椭圆表示),则叶子结点可按上述学习准则确定其类别。 不妨记叶子结点
D
a
k
D_a^k
Dak的类别为
[
D
a
k
]
[D_a^k]
[Dak],则该叶子结点的训练误差为:
E
(
D
a
k
)
=
∑
x
∈
D
a
k
I
(
f
(
x
)
≠
[
D
a
k
]
)
\begin{align} E(D_a^k)=\sum_{x \in D_a^k}\mathbb{I} (f(x)\neq [D_a^k])\tag{1} \end{align}
E(Dak)=x∈Dak∑I(f(x)=[Dak])(1)
则
D
D
D基于
a
a
a划分的训练误差为:
E
(
D
,
a
)
=
∑
k
=
1
V
E
(
D
a
k
)
\begin{align} E(D,a)=\sum_{k=1}^VE(D_a^k)\tag{2} \end{align}
E(D,a)=k=1∑VE(Dak)(2)
则最小训练误差准则为:
a
∗
=
arg
min
a
∈
A
E
(
D
,
a
)
\begin{align} a_*=\mathop{\arg\min}\limits_{a \in A}E(D,a)\tag{3} \end{align}
a∗=a∈AargminE(D,a)(3)
缺点:偏好选择那些可取值较多的属性(与信息增益准则的偏好相同)。
4.3:参考4.5 决策树算法中涉及的准则(叶子、划分、剪枝)
编制基于信息熵的属性选择函数(如下三者之一):
1)信息增益准则
2)增益率准则
3)二者联合:用信息增益筛选出高于平均水平的属性,再从中选择增益率最高的
在【西瓜书图4.2】的决策树基本算法中的第8行改为调用上述函数,实现属性选择。
4.4:参考4.5 决策树算法中涉及的准则(叶子、划分、剪枝)
(1)思路同4.3题,只须将选择函数改为基尼指数实现。
(2)决策树基本算法中加入剪枝函数。
4.5:
在决策树基本算法中调用对率回归选择函数,编制该函数的要点如下:
(1)引入软件包中的对率回归函数(逻辑回归函数);
(2)对于
(
D
,
a
)
(D,a)
(D,a),当其中
a
a
a为连续属性时,使用该对率回归函数划分:
D
=
D
+
⋃
D
−
D=D^+ \bigcup D^-
D=D+⋃D−,则有:
G
a
i
n
(
D
,
a
)
=
E
n
t
(
D
)
−
∣
D
+
∣
∣
D
∣
E
n
t
(
D
+
)
−
∣
D
−
∣
∣
D
∣
E
n
t
(
D
−
)
\begin{align} Gain(D,a) =Ent(D)-\frac{|D^+|}{|D|}Ent(D^+)-\frac{|D^-|}{|D|}Ent(D^-) \tag{4} \end{align}
Gain(D,a)=Ent(D)−∣D∣∣D+∣Ent(D+)−∣D∣∣D−∣Ent(D−)(4)
(3)对于 a a a为离散属性,则由【西瓜书式(4.2)】求 G a i n ( D , a ) Gain(D,a) Gain(D,a)。
(4)比较该结点所有属性的信息增益
G
a
i
n
(
D
,
a
)
Gain(D,a)
Gain(D,a),即得选择:
a
∗
=
arg
min
a
∈
A
G
a
i
n
(
D
,
a
)
\begin{align} a_*=\mathop{\arg\min}\limits_{a \in A}Gain(D,a)\tag{5} \end{align}
a∗=a∈AargminGain(D,a)(5)
4.6:分解为如下步骤:
(1)数据下载;
(2)将数据集分拆为训练集 S S S和多个测试集 T i T_i Ti;
(3)用训练集 S S S及上述三题方法,训练出三颗决策树(树1,树2,树3);
(4)预剪枝得三颗树,后剪枝又得三颗树;
(5)用每个测试集
T
i
T_i
Ti对这些决策树进行测试,测试结果(如,误差率)填入表1中。
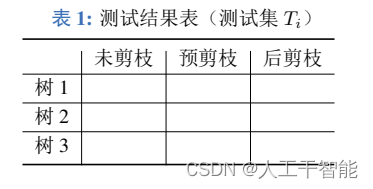
(6)由表1,对未剪枝、预剪枝、后剪枝三种情况比较,得测试结果排序表(参考【西瓜书表2.5,p.42】)
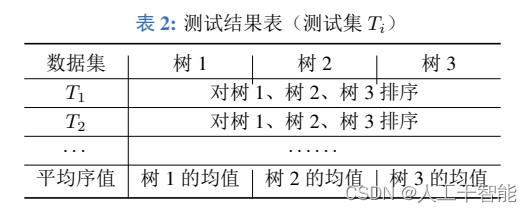
(7)由表2即可构造统计量进行检验,即【西瓜书p.42-44】的Friedman检验和Nemenyi后续检验。
4.7:
参见4.1 决策树算法(不是规划论中的决策树)中,基于“栈”的深度优先搜索。
4.8:
参见4.1 决策树算法(不是规划论中的决策树)最后的讨论:为加强控制溢出所作的修改。
4.9:
参见4.3 连续值的处理与缺失值的处理中式(4.26 )。
4.10:【西瓜书数据集3.0 α \alpha α】是全连续属性,而【西瓜书数据集3.0】是连续属性与离散属性混合,这里讨论一种混合处理方法。
将所有连续属性放在一起形成一个组合属性 c = ( a 1 , a 2 , ⋯ , a m ) c=(a_1,a_2,\cdots,a_m) c=(a1,a2,⋯,am), a i a_i ai为连续属性,如,题目中 c = ( 密度 , 含糖量 ) c=(\text{密度},\text{含糖量}) c=(密度,含糖量), c c c为超平面上一块区域。 这时属性集变为 A ∪ { c } A\cup\{c\} A∪{c},其中, A A A为离散属性组成的集合。
对 ( D , c ) (D,c) (D,c)使用线性分类器得到 D − D^- D−与 D + D^+ D+的划分,即可计算出 E n t ( D − ) Ent(D^-) Ent(D−)与 E n t ( D + ) Ent(D^+) Ent(D+),由【西瓜书(4.2)式】计算 G a i n ( D , c ) Gain(D,c) Gain(D,c),将它与离散属性 a a a的 G a i n ( D , a ) Gain(D,a) Gain(D,a)一起参与择优。
a ∗ = arg max a ∈ A ∪ { c } G a i n ( D , a ) a_*=\mathop{\arg\max}\limits_{a \in A\cup\{c\}}Gain(D,a) a∗=a∈A∪{c}argmaxGain(D,a)
再将上述 a ∗ a_* a∗应用到某一决策树算法中去即得。 需要注意的是:对于组合属性 c c c,由于它是连续的,故选中它作为划分属性时,并不能像离散属性那样使它消去,而是使它的取值区域变小(不等式表达)。
本文为原创,您可以:
- 点赞(支持博主)
- 收藏(待以后看)
- 转发(他考研或学习,正需要)
- 评论(或讨论)
- 引用(支持原创)
- 不侵权

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献14条内容

所有评论(0)