知识图谱-实体抽取
命名实体识别(Named Entity Recognition,简称NER)是信息抽取、问答系统、句法分析、机器翻译等应用领域的重要基础工具,在自然语言处理技术走向实用化的过程中占有重要地位。一般来说,命名实体识别的任务就是识别出待处理文本中三大类(实体类、时间类和数字类)、七小类(人名、机构名、地名、时间、日期、货币和百分比)命名实体。
举个简单的例子,在句子“小明早上8点去学校上课。”中,对其进行命名实体识别,应该能提取信息
人名:小明,时间:早上8点,地点:学校。
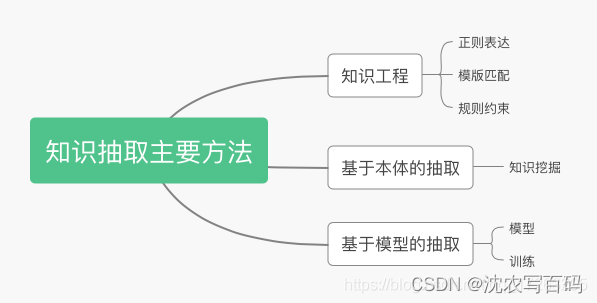
https://www.cnblogs.com/zhongzihao/p/11328665.html
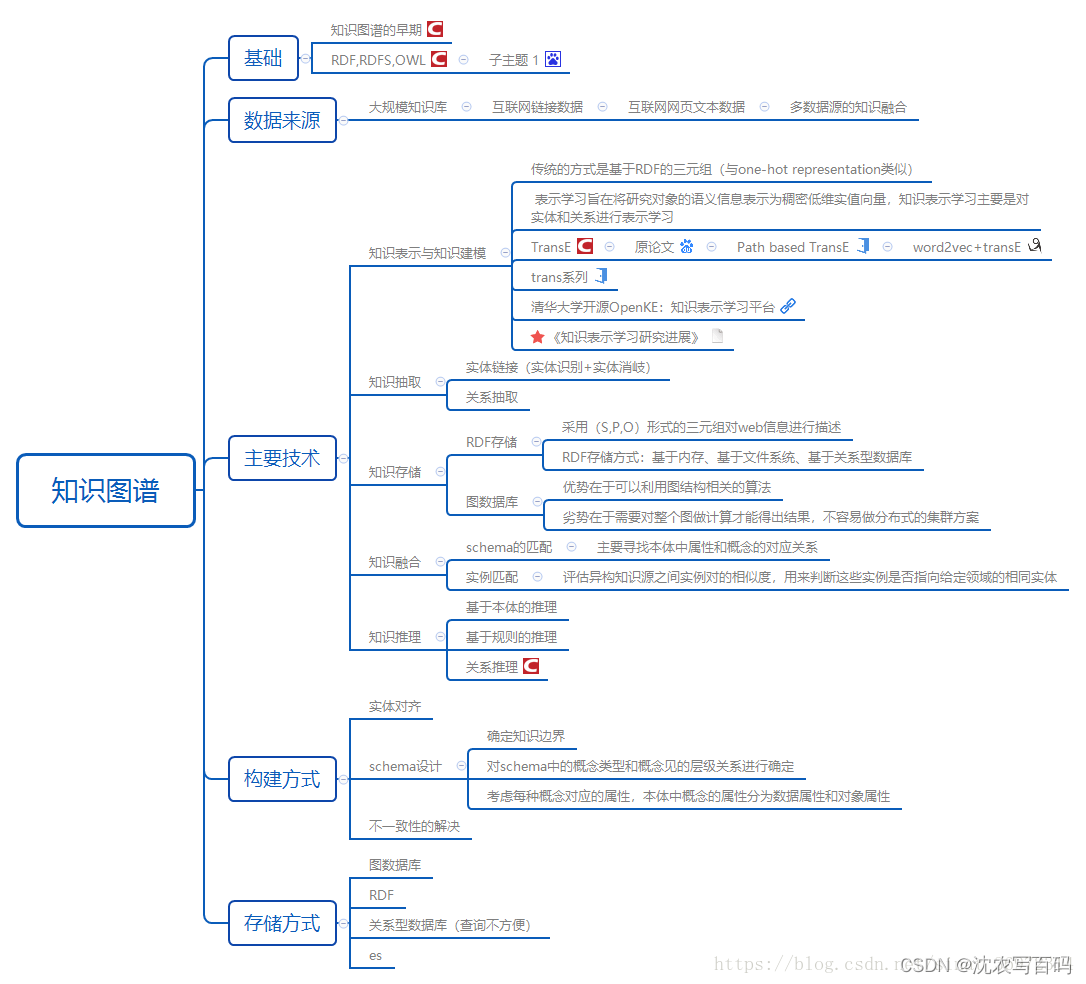
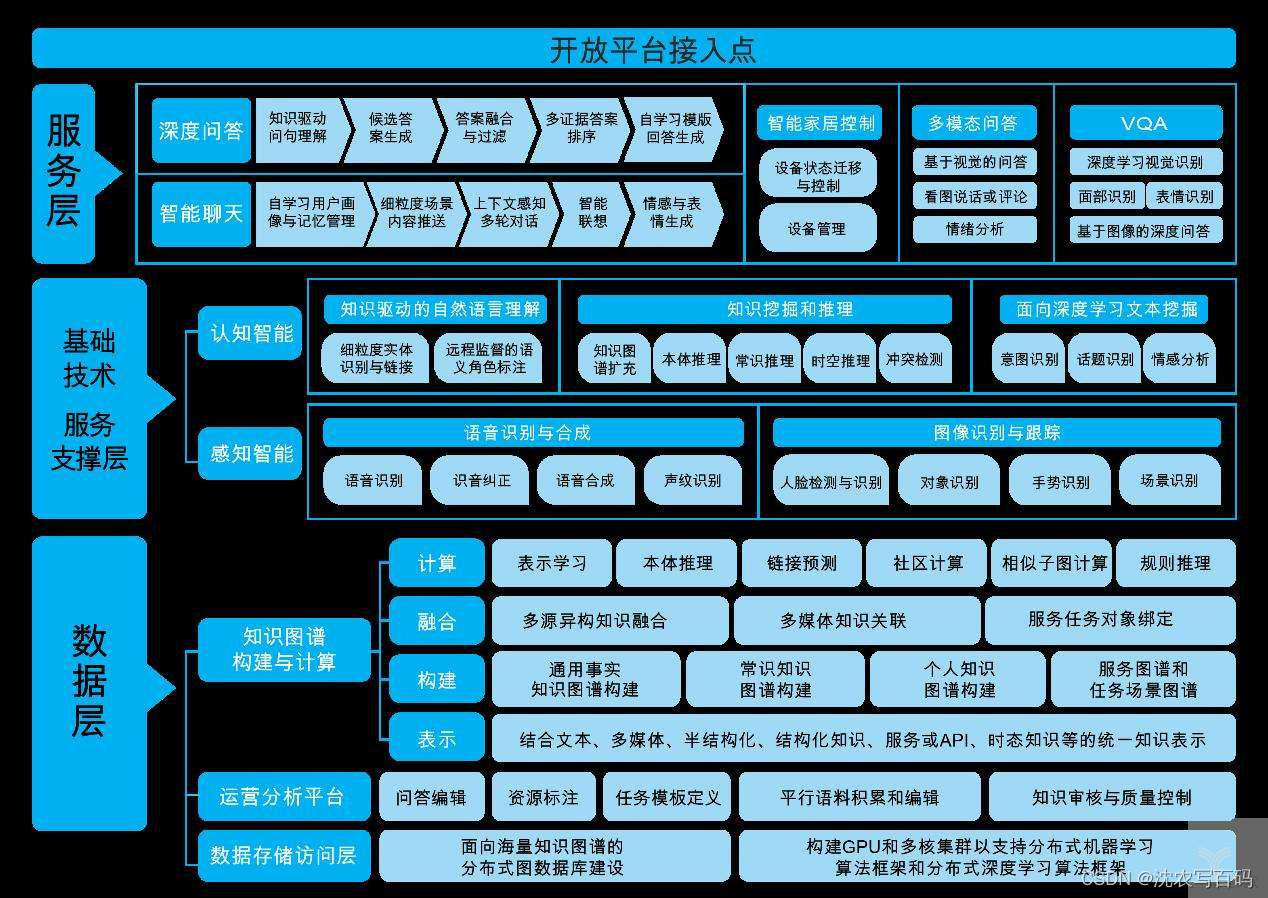
5.知识图谱的案例
农业知识图谱构建:https://github.com/qq547276542/Agriculture_KnowledgeGraph
知识图谱本体设计轻量级工具
简介:微软开源项目SmartKG
GitHub 上的地址为https://github.com/microsoft/smartkg
官方安装文档
https://blog.csdn.net/weixin_42691585/article/details/107424028
3、NER 评价指标
我们说过 NER 可以当做是多分类的任务,所以用于评估 NER模型效果的指标自然也可以使用多分类适用的指标了,比如 F1 值就是常用的指标。
正确率 = 识别出的正确实体数 / 识别出的实体数
召回率 = 识别出的正确实体数 / 样本的实体数
这两者的取值都在 0 和 1 之间,数值越接近1,正确率或召回率就越高。正确率和召回率有时会出现矛盾的情况,这是需要综合考虑它们的加权调和平均值,也就是 F 值 ,其中最常用的 F1 值,当 F1 值较高时说明试验方法比较有效。F1 值定义如下:
F1值 = (2 * 正确率 * 召回率)/(正确率 + 召回率)
正确率 = 识别出的正确实体数 / 识别出的实体数
召回率 = 识别出的正确实体数 / 样本的实体数

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献9条内容

所有评论(0)