【大数据集群搭建-CDH-(4)CDH部署前的环境准备】CDH版本进行大数据集群各组件环境部署-(4)CDH部署前的环境准备
【大数据集群搭建-CDH-(4)环境准备】CDH版本进行大数据集群各组件环境部署-(4)环境准备
1)集群资源规划
1.1.业务集群规划思路
-
一般而言,一个集群上很少只跑一个业务,大多数情况都是多个业务共享集群,实际上就是共享系统软硬件资源。
这里通常涉及两大问题,其一是业务之间资源隔离问题,就是将各个业务在逻辑上隔离开来,互相不受影响,这个问题产生于业务共享场景下一旦某一业务一段时间内流量猛增必然会因为过度消耗系统资源而影响其他业务;其二就是共享情况下如何使得系统资源利用率最高,理想情况下当然希望集群中所有软硬件资源都得到最大程度利用。
因为业务隔离场景是不尽相同的,这里主要针对后者进行讲解:使得集群系统资源最大化利用,那首先要看业务对系统资源的需求情况。经过对线上业务的梳理,通常可将这些业务分为如下几类:
(1)硬盘容量敏感型业务:这类业务对读写延迟以及吞吐量都没有很大的要求,唯一的需要就是硬盘容量。比如大多数离线读写分析业务,上层应用一般每隔一段时间批量写入大量数据,然后读取也是定期批量读取大量数据。特点:离线写、离线读,需求硬盘容量
(2)带宽敏感型业务:这类业务大多数写入吞吐量很大,但对读取吞吐量没有什么要求。比如日志实时存储业务,上层应用通过kafka将海量日志实时传输过来,要求能够实时写入,而读取场景一般是离线分析或者在业务遇到异常的时候对日志进行检索。特点:在线写、离线读,需求带宽
(3)IO敏感型业务:相比前面两类业务来说,IO敏感型业务一般都是较为核心的业务。这类业务对读写延迟要求较高,尤其对于读取延迟通常在100ms以内,部分业务可能要求更高。比如在线消息存储系统、历史订单系统、实时推荐系统等。特点:在(离)线写、在线读,需求内存、高IO介质
(4)对于CPU资源,HBase本身就是CPU敏感型系统,主要用于数据块的压缩/解压缩,基本所有业务都对CPU有共同的需求,而单纯的HDFS存储对CPU要求不高
-
一个集群想要资源利用率最大化,一个思路就是各个业务之间‘扬长避短’,合理搭配,各取所需。实际上就是上述几种类型的业务能够混合分布,建议不要将同一种类型的业务太多分布在同一个集群。因此一个集群理论上资源利用率比较高效的配置为:硬盘敏感型业务 + 带宽敏感型业务 + IO敏感型业务。
-
另外,集群业务规划的时候除了考虑资源使用率最大化这个问题之外,还需要考虑实际运维的需求。建议将核心业务和非核心业务分布在同一个集群,强烈建议不要将太多核心业务同时分布在同一个集群。这主要有两方面的考虑:
(1)一方面是因为核心业务共享资源必然会产生竞争,一旦出现竞争无论哪个核心业务出现问题都不是我们愿意看到的;
(2)另一方面在特殊场景下方便运维童鞋进行降级处理,比如类似于淘宝双十一这类大促活动,某个核心业务预期会有很大的流量涌入,为了保证核心业务的平稳,在资源共享的情况下只能牺牲其他非核心业务,在和非核心业务方充分交流沟通的基础上限制这些业务的资源使用,在流量极限的时候甚至可以直接停掉这些非核心业务。试想,如果是很多核心业务共享集群的话,哪个核心业务愿意轻易让路?
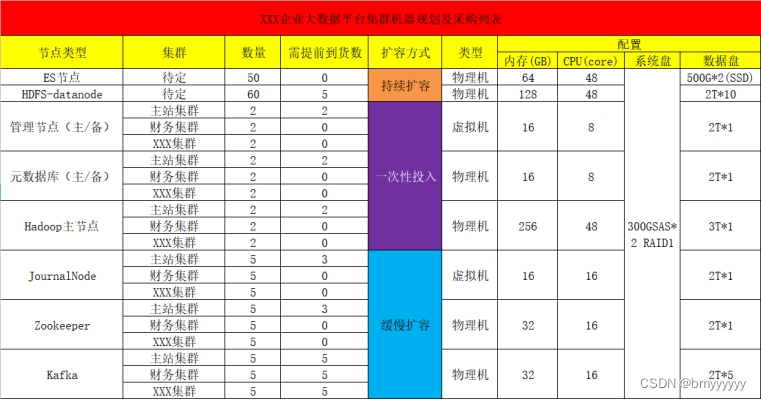
1.2.真实集群规划
-
Hadoop 集群实际上就是在一组通过网络连接的物理计算机组成的集群上安装部署Hadoop 相关的软件。所以,Hadoop 集群规划包括两大模块:
(1) 物理集群规划
(2) 软件集群规划
根据实际业务需求,确定哪些软件运行在哪些物理机上,最终以一个整体来对外提供大数据的相关服务。
1.2.1.物理集群规划
-
Hadoop 物理集群规划主要解决的两个问题:
(1)准备什么样的物理计算机?——机器选型
(2)准备多少台物理计算机?——集群规模
1.2.1.1.机器选型
(1)小型机:价格在百万级别以上,成本太高,Hadoop 的初衷是致力于运行在廉价的机器之上,
这违背了 Hadoop 的初衷。所以不推荐使用。
(2)PCServer:综合考虑价格和性能,这是第一选择。
(3)云主机(比如阿里云、腾讯云):一般创业初期的互联网公司会选用,因为资金不足,
且数据量是逐步增大,可以采用此方式。
(4)普通 PC:稳定性不好,可用于实验环境。
(5)虚拟机:无奈,学习使用。
总结:
(1)企业开发环境物理集群优选 PCServer
(2)学习实验环境物理集群优选虚拟机
1.2.1.2.集群规模
-
影响集群规模的因素:
(1)功能性需求
-
数据量包括现有的全量数据、一定时期内的增量数据、数据的副本个数、临时数据、日志数据、安装包等等。
(2)每台计算机的资源配置
(3)非功能性需求
1) 可靠性需求 2) 可用性需求 3) 容错性需求 -
比如,目前公司过去一年历史数据量为500G,为了保证可靠地容错性,至少要冗余3份,冗余后为1500G。
-
除此之外,还要考虑数据的不断增长,根据历史数据推算,每年用户量增长1倍,明年一年(或未来三年,根据公司财力来进行规划)内数据将达到3000G,加上1500G历史数据,共需存储4500G。再加上日志数据和软件临时数据等,需提前准备至少5000G(5T)的磁盘容量。假设每台服务器500G的SSD容量,则需要至少10台服务器。
-
总结:
(1)根据实际业务需求的不同,企业物理集群规模大小也各不相同。几台、十几台、几十台、成百上千台的都有。
(2)目前先部署三个节点的分布式集群。
1.2.2.软件集群规划
涉及到软件选型,及之后的主机规划。
1.2.2.1.软件选型
- 即选择使用什么样的软件?哪个版本?是否稳定?各个软件之间是否兼容?
项目软件选型:
jdk:Jdk1.8Scala2.11.8
CDH 6.2.1:
zookeeper-3.4.5-cdh6.2.1、hadoop-3.0.0-cdh6.2.1,hive-2.1.1-cdh6.2.1、hue-4.3.0-cdh6.2.1sqoop-1.4.7-cdh6.2.1
Mysql 5.7
1.2.2.2.主机规划
- 主机规划即哪台机器上部署哪些软件。
| Hadoop01/192.168.52.150 | Hadoop02/192.168.52.151 | Hadoop03/192.168.52.152 | |
|---|---|---|---|
| CM管理服务 | ✔ | ✘ | ✘ |
| NameNode | ✔ | ✘ | ✘ |
| DataNode | ✔ | ✔ | ✔ |
| SecondNameNode | ✘ | ✔ | ✘ |
| ResourceManager | ✔ | ✘ | ✘ |
| NodeManager | ✔ | ✔ | ✔ |
| JobHistory Server | ✔ | ✘ | ✘ |
| Zookeeper | ✔ | ✔ | ✔ |
| Hive | ✘ | ✘ | ✔ |
| Oozie | ✘ | ✔ | ✘ |
| Hue | ✘ | ✘ | ✔ |
| Sqoop | ✔ | ✔ | ✔ |
-
总结:
(1)单节点集群是把所有软件都部署在同一台机器上
(2)分布式集群是按照主机规划把对应的软件部署在对应的机器上
| Hadoop01 | Hadoop02 | Hadoop03 | Hadoop04 | Hadoop05 | |
|---|---|---|---|---|---|
| CM管理服务 | ✔ | ✘ | ✘ | ✘ | ✘ |
| NameNode | ✔ | ✘ | ✘ | ✘ | ✘ |
| DataNode | ✔ | ✔ | ✔ | ✔ | ✔ |
| SecondNameNode | ✘ | ✔ | ✘ | ✘ | ✘ |
| ResourceManager | ✔ | ✘ | ✘ | ✘ | ✘ |
| NodeManager | ✔ | ✔ | ✔ | ✔ | ✔ |
| JobHistory Server | ✔ | ✘ | ✘ | ✘ | ✘ |
| Zookeeper | ✔ | ✔ | ✔ | ✔ | ✔ |
| Hive | ✔ | ✘ | ✘ | ✘ | ✘ |
| Oozie | ✘ | ✔ | ✘ | ✘ | ✘ |
| Hue | ✘ | ✘ | ✔ | ✘ | ✘ |
| Sqoop | ✔ | ✔ | ✔ | ✔ | ✔ |
| RegionServer | ✔ | ✔ | ✔ | ✔ | ✔ |
1.3 测试集群
-
目标:部署三个节点的 Hadoop 集群
-
任务:
(1)安装三台虚拟机——Hadoop 物理集群部署
(2)在虚拟机上安装 Hadoop——Hadoop 软件集群部署
2)Linux虚拟机环境
| 节点 | 内存 | CPU | 硬盘 |
|---|---|---|---|
| hadoop01 | 12G | 4 | 50 |
| hadoop02 | 3G | 2 | 50 |
| hadoop03 | 1G | 1 | 50 |
3)CM前置工具
3.1.下载包
3.1.1.CDH包
下载地址:https://archive.cloudera.com/cdh6/6.2.1/parcels/
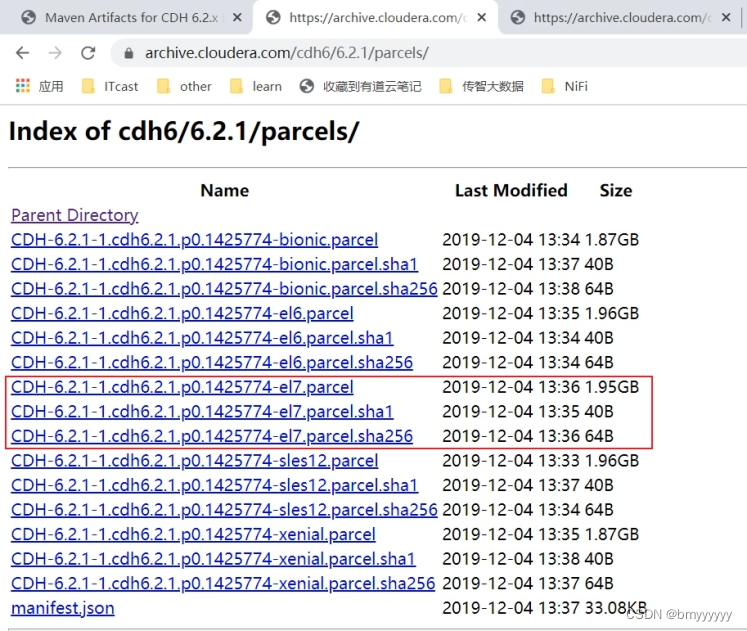
只需要下载对应系统下的包即可,我们使用的是Centos7,所以只需要下载后缀为el7的三个包即可。
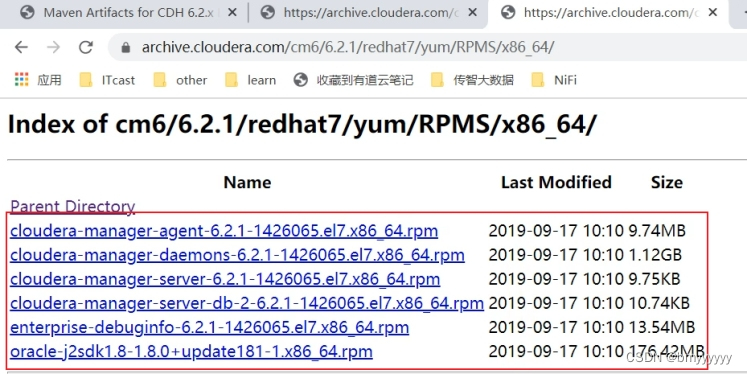
3.1.2.CM包
下载地址: https://archive.cloudera.com/cm6/6.2.1/redhat7/yum/RPMS/x86_64/
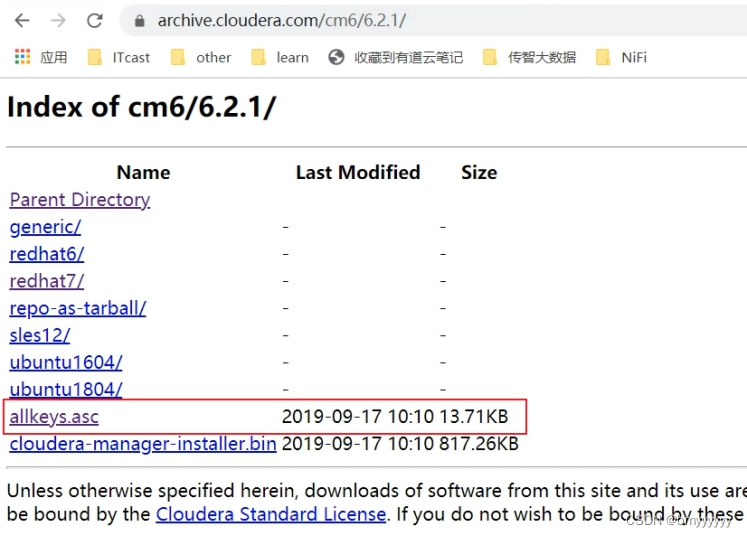
3.1.3.秘钥文件
下载地址:https://archive.cloudera.com/cm6/6.2.1/
3.2.安装依赖包
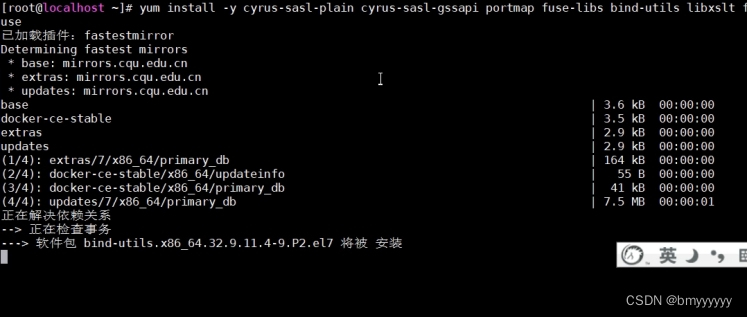
如果不提前安装这些依赖包,在后面安装CM的时候可能会出现异常。
yum install -y cyrus-sasl-plain cyrus-sasl-gssapi portmap fuse-libs bind-utils libxslt fuse

yum install -y /lib/lsb/init-functions createrepo deltarpm python-deltarpm

yum install -y mod_ssl openssl-devel python-psycopg2 MySQL-python
可以三台虚拟机同时进行安装。
3.3.安装httpd
只需要在部署本地yum源的机器上安装即可,不用三台全部安装。
yum install httpd

yum install createrepo
3.4.配置host
3.4.1.linux
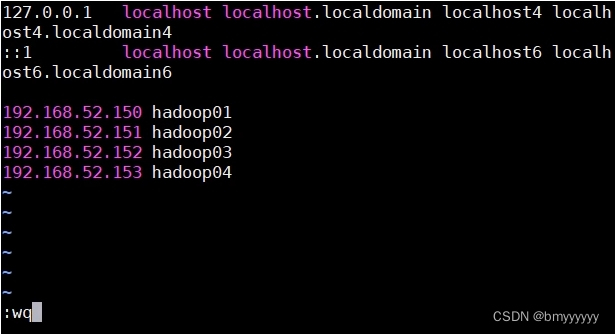
每一台linux服务器都需要进行配置:
vim /etc/hosts

192.168.52.150 hadoop01

192.168.52.151 hadoop02

192.168.52.152 hadoop03

192.168.52.153 hadoop04
3.4.2.windows
打开hosts文件:【C:\Windows\System32\drivers\etc\hosts】
添加一下内容:
#教育数仓

192.168.52.150 hadoop01

192.168.52.151 hadoop02

192.168.52.152 hadoop03
3.5.关闭防火墙
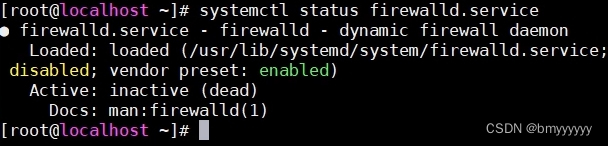
三台都要执行。
#查看防火墙状态:绿的running表示防火墙开启
systemctl status firewalld.service

#执行关闭命令:
systemctl stop firewalld.service

#再次执行查看防火墙命令:
systemctl status firewalld.service

#执行开机禁用防火墙自启命令:
systemctl disable firewalld.service
完成。
3.6.关闭selinux
三台都要执行。
#临时生效
setenforce 0

#永久生效
#将SELINUX=enforcing改为SELINUX=disabled
vim /etc/selinux/config
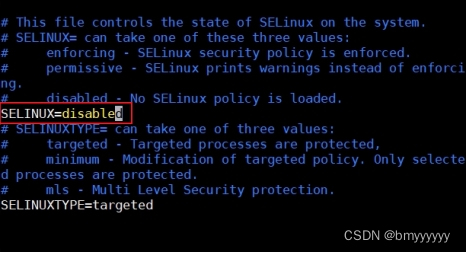
在配置文件中第一次设置时需要重启服务器。
reboot
3.7.安装httpd服务
因为在实际的生产环境中,很有可能是不能联网的,或者从外网下载的速度较慢。这时我们通过本地的镜像来进行安装,效率会大大提升。
只在第一台服务器执行即可。
#前面已执行过
yum install httpd -y

#启动httpd服务
systemctl start httpd.service

#进入域名根目录
cd /var/www/html/

#需要创建和官网路径一致的目录,yum安装时才能够正确的找到
mkdir -p cm6/6.2.1/redhat7/yum/RPMS/x86_64/

#创建CDH6相同的目录
mkdir -p cdh6/6.2.1/parcels/

#然后将cdh6 和 cm6 都放到对应新建好的目录下
#上传cm6中的文件到目录:
cd /var/www/html/cm6/6.2.1/redhat7/yum/RPMS/x86_64/

#上传cdh6中的文件到目录:
cd /var/www/html/cdh6/6.2.1/parcels/
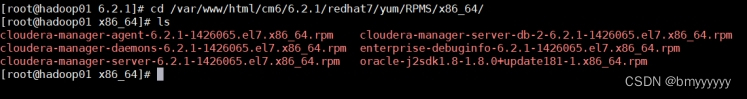
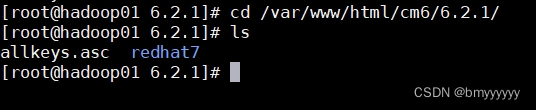
#上传allkeys.asc文件到目录:
cd /var/www/html/cm6/6.2.1/
访问测试:http://hadoop01/cm6/6.2.1/redhat7/yum/RPMS/x86_64/
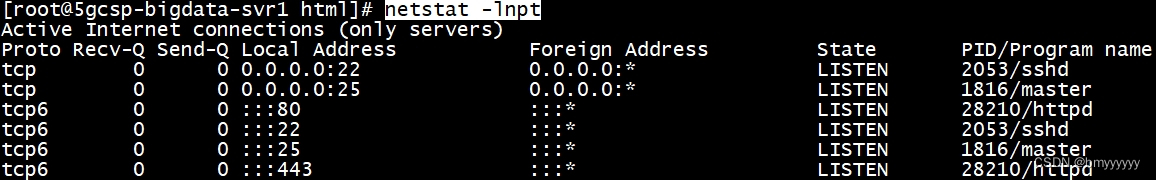
如果访问不了,显示没有权限,依次执行以下命令排除问题
netstat -lnpt
systemctl status firewalld

这五个命令主要用来查看,可以不执行:
find  / -name httpd

find  / -name httpd.conf

vi /etc/httpd/conf/httpd.conf

su - apache

cat /etc/passwd

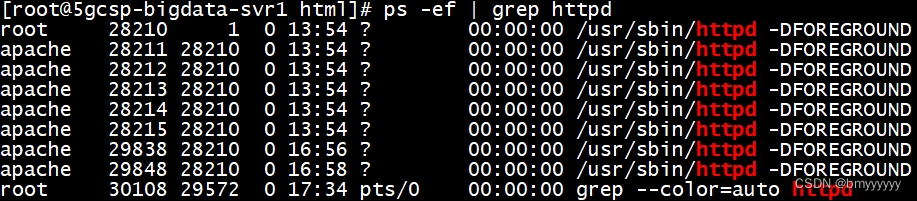
ps -ef | grep httpd
发现是apache的权限,而我们/var/www/html权限是root的,所以才没有权限访问
chown -R apache:apache cdh6 cm6
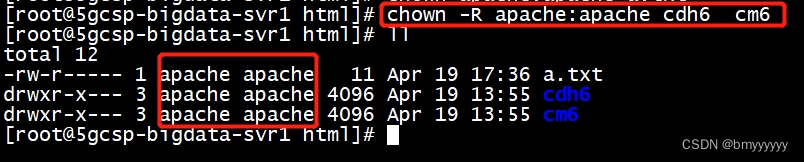
然后再次访问即可
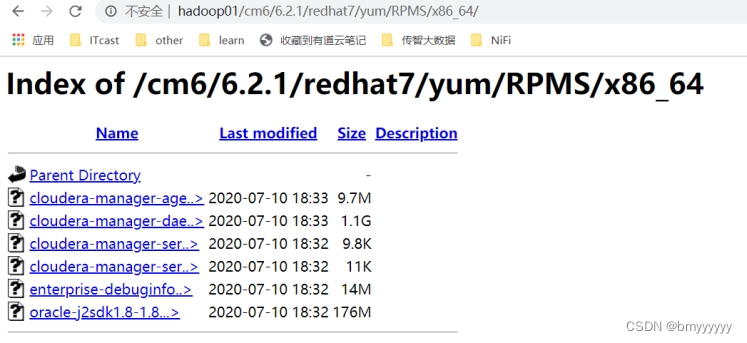
3.8.生成repodata目录
只在第一台服务器执行即可。
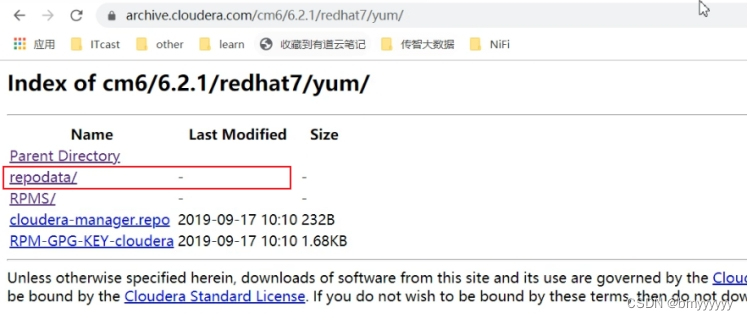
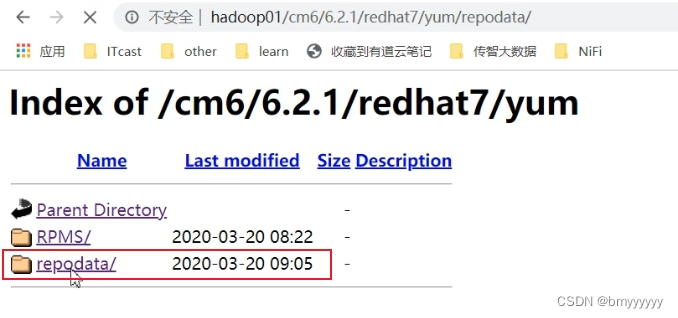
可以看到在官网的地址中,有一个repodata目录,而我们新搭建的http服务中是没有的。此文件夹是不能直接复制的,需要使用脚本生成出来,是对现有文件结构的描述。如果http中的文件内容有变更,需要删除后重新生成repodata目录,以在web中生效。
cd /var/www/html/cm6/6.2.1/redhat7/yum

createrepo .
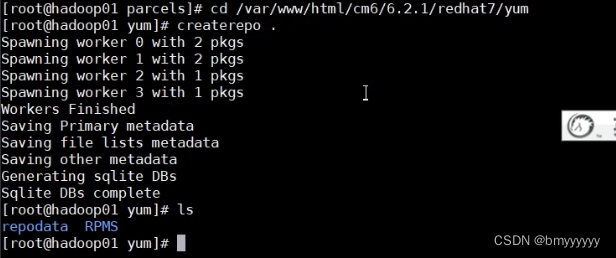
访问web链接,确认repodata目录已存在:
3.9.配置本地yum源
只在第一台服务器执行即可。
\#baseurl这个地址要是我们生成的地址,否则报错!
cd /etc/yum.repos.d/

vim cloudera-manager.repo

[cloudera-manager]
name=Cloudera Manager
baseurl=http://5gcsp-bigdata-svr1/cm6/6.2.1/redhat7/yum/
gpgcheck=0
enabled=1

#执行命令
yum clean all
yum list | grep cloudera
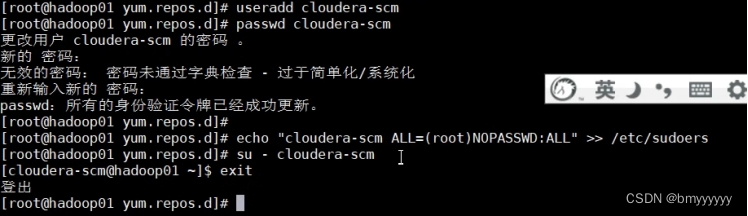
3.10.创建cloudera-scm用户
centos7要求必须有,centos6没有要求,每一台服务器都需要执行。
useradd cloudera-scm

passwd cloudera-scm

pwd: test123456

#免密钥登录
echo "cloudera-scm ALL=(root)NOPASSWD:ALL" >> /etc/sudoers

#测试用户
su - cloudera-scm
exit
3.11.安装mysql服务
安装Mysql后续作为元数据库使用。
只在第一台安装即可。
3.11.1.下载repo,并安装mysql-server
这三条命令不用执行
cd /etc/yum.repos.d/

rpm -qa|grep -i mysql

rpm -e --nodeps 包名
安装mysql服务,如果有rpm文件可以直接通过rpm问价进行安装
rpm -ivh mysql-community-common-5.7.25-1.el7.x86_64.rpm

rpm -ivh mysql-community-libs-5.7.25-1.el7.x86_64.rpm --nodeps --force

rpm -ivh mysql-community-client-5.7.25-1.el7.x86_64.rpm

rpm -ivh mysql-community-server-5.7.25-1.el7.x86_64.rpm --nodeps --force
查看是否有mariadb,如果有的话可以删除,防止和mysql冲突
rpm -qa | grep mariadb

rpm -e  mariadb包名 --nodeps

wget -i -c http://dev.mysql.com/get/mysql57-community-release-el7-10.noarch.rpm

yum -y install mysql57-community-release-el7-10.noarch.rpm

#这个步骤需要网络,并根据网速会花些时间,安装完成后会覆盖之前的mariadb。
yum -y install mysql-community-server

#如果提示-bash: wget: 未找到命令,则先运行:
yum -y install wget
3.11.2.mysql设置
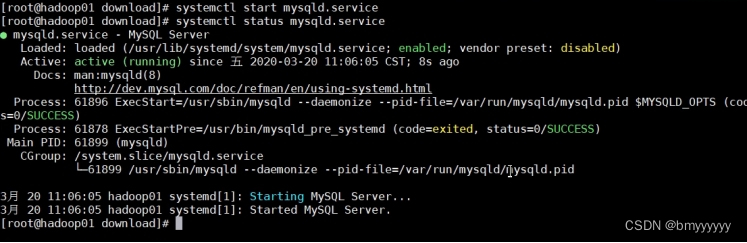
启动:
systemctl start mysqld.service
查看运行情况:
systemctl status mysqld.service
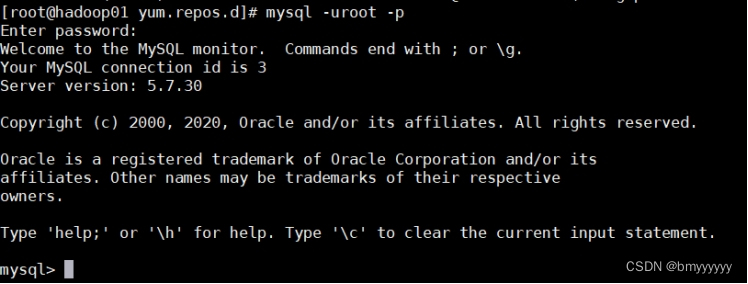
3.11.3.登录mysql
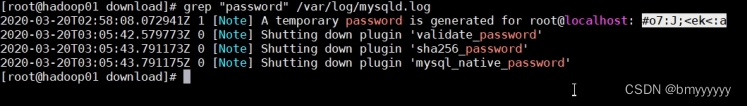
查看mysql密码
grep "password" /var/log/mysqld.log
登录mysql
mysql -uroot -p
3.11.4.修改密码
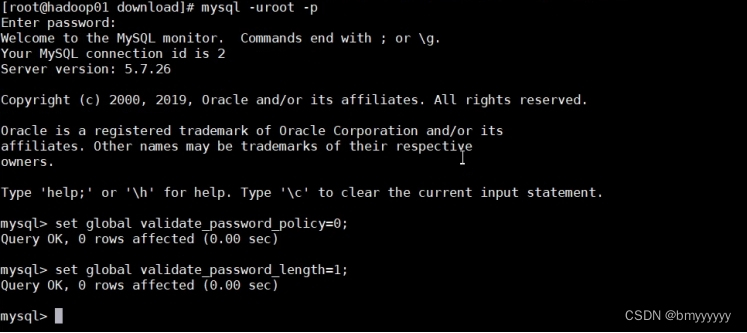
取消mysql密码规范限制
set global validate_password_policy=0;

set global validate_password_length=1;
重设密码
alter user 'root'@'localhost' identified by '123456';

flush privileges;
3.11.5.卸载repo包
此时还有一个问题,因为安装了yum repository,以后每次yum都会自动更新,耗费时间,所以卸载掉:
yum -y remove mysql57-community-release-el7-10.noarch
3.11.6.设置mysql权限
create database scm DEFAULT CHARACTER SET utf8;

#如果由于数据库更新导致下面命令报错,输入如下命令
#mysql_upgrade -u root -p 123456

grant all PRIVILEGES on *.* TO 'root'@'%' IDENTIFIED BY '123456' WITH GRANT OPTION;

grant all PRIVILEGES on *.* TO 'root'@'localhost' IDENTIFIED BY '123456' WITH GRANT OPTION;

grant all PRIVILEGES on *.* TO 'root'@'5gcsp-bigdata-svr1' IDENTIFIED BY '123456' WITH GRANT OPTION;

flush privileges;
【其他相关文章】
【大数据集群搭建-Apache】Apache版本进行大数据集群各组件环境部署
【大数据集群搭建-CDH-(1)虚拟机基础环境配置】CDH版本进行大数据集群各组件环境部署-(1)虚拟机基础环境配置
【大数据集群搭建-CDH-(2)ClouderManager相关介绍】CDH版本进行大数据集群各组件环境部署-(2)ClouderManager相关介绍
【大数据集群搭建-CDH-(3)VMware-Linux磁盘扩容】CDH版本进行大数据集群各组件环境部署-(3)VMware-Linux磁盘扩容
【大数据集群搭建-CDH-(4)CDH部署前的环境准备】CDH版本进行大数据集群各组件环境部署-(4)CDH部署前的环境准备

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献10条内容

所有评论(0)