自然语言处理NLP文本分类顶会论文阅读笔记(二)
笔记目录
- 文本分类
- 命名实体识别
- LSTM-CRF
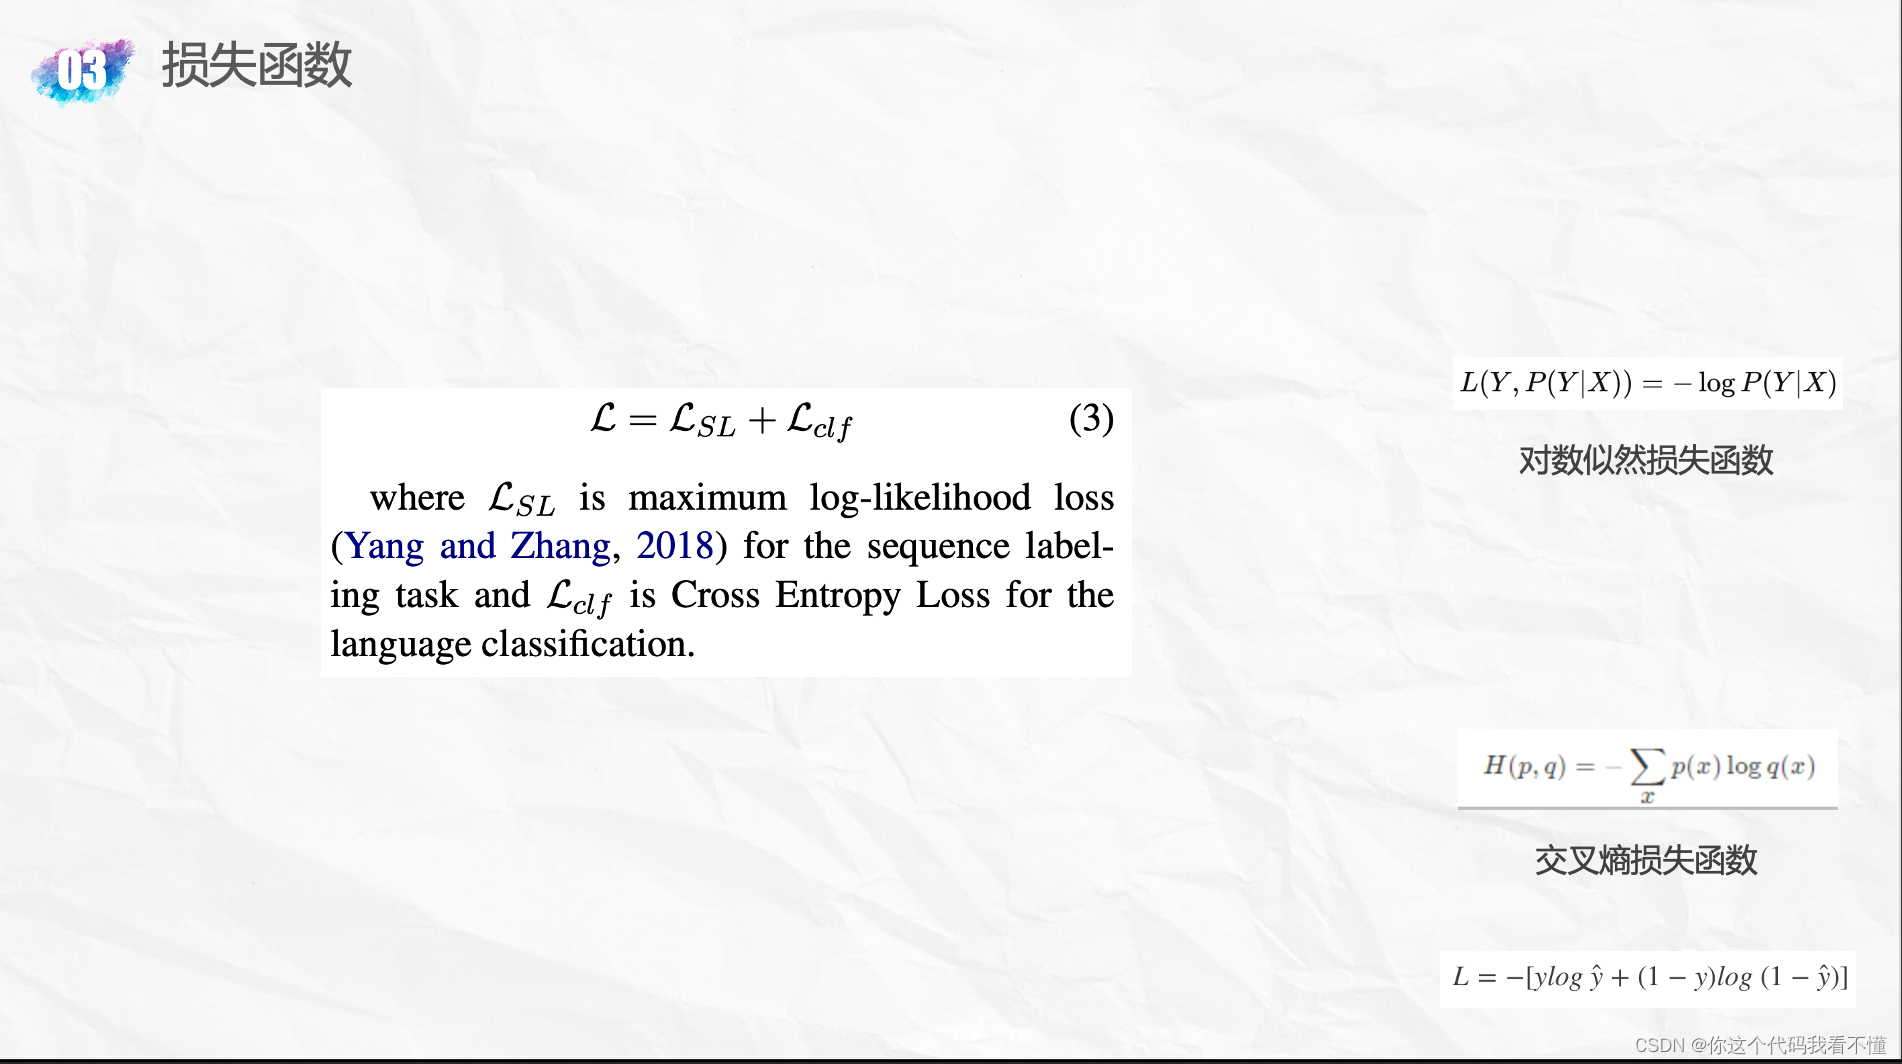
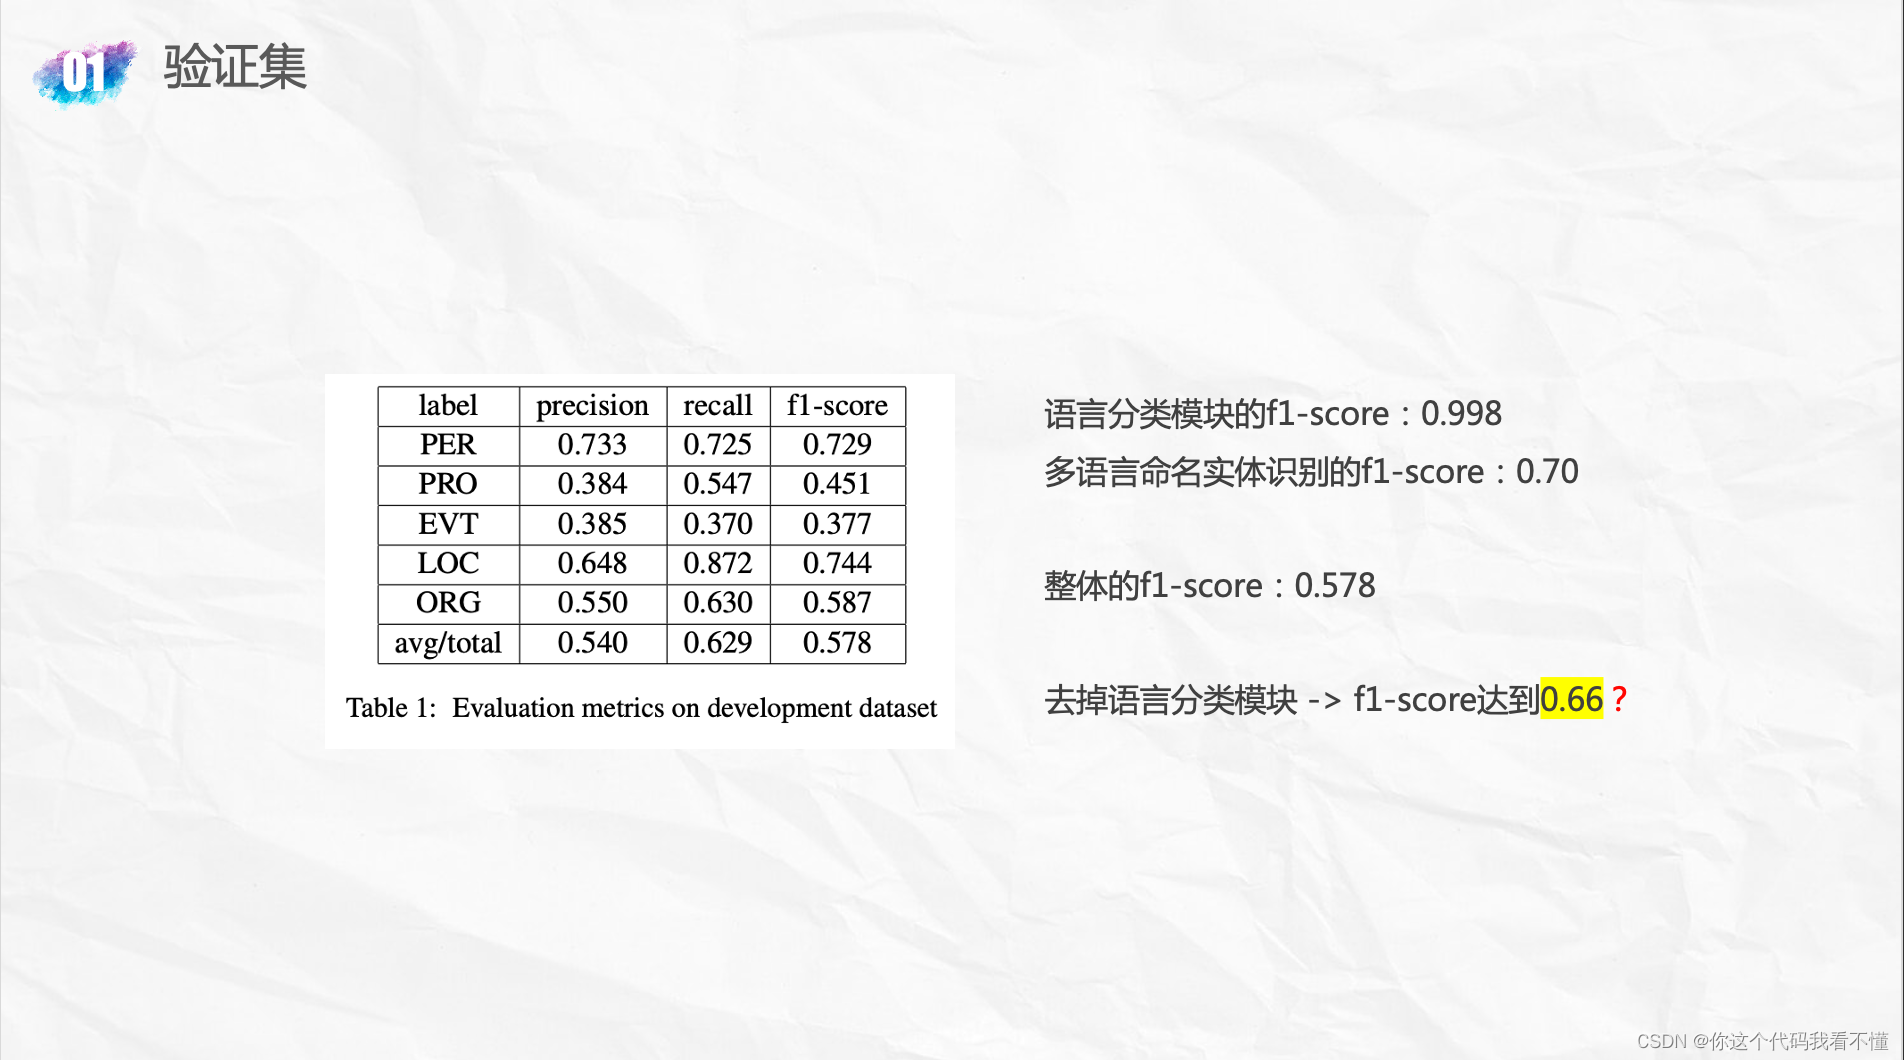
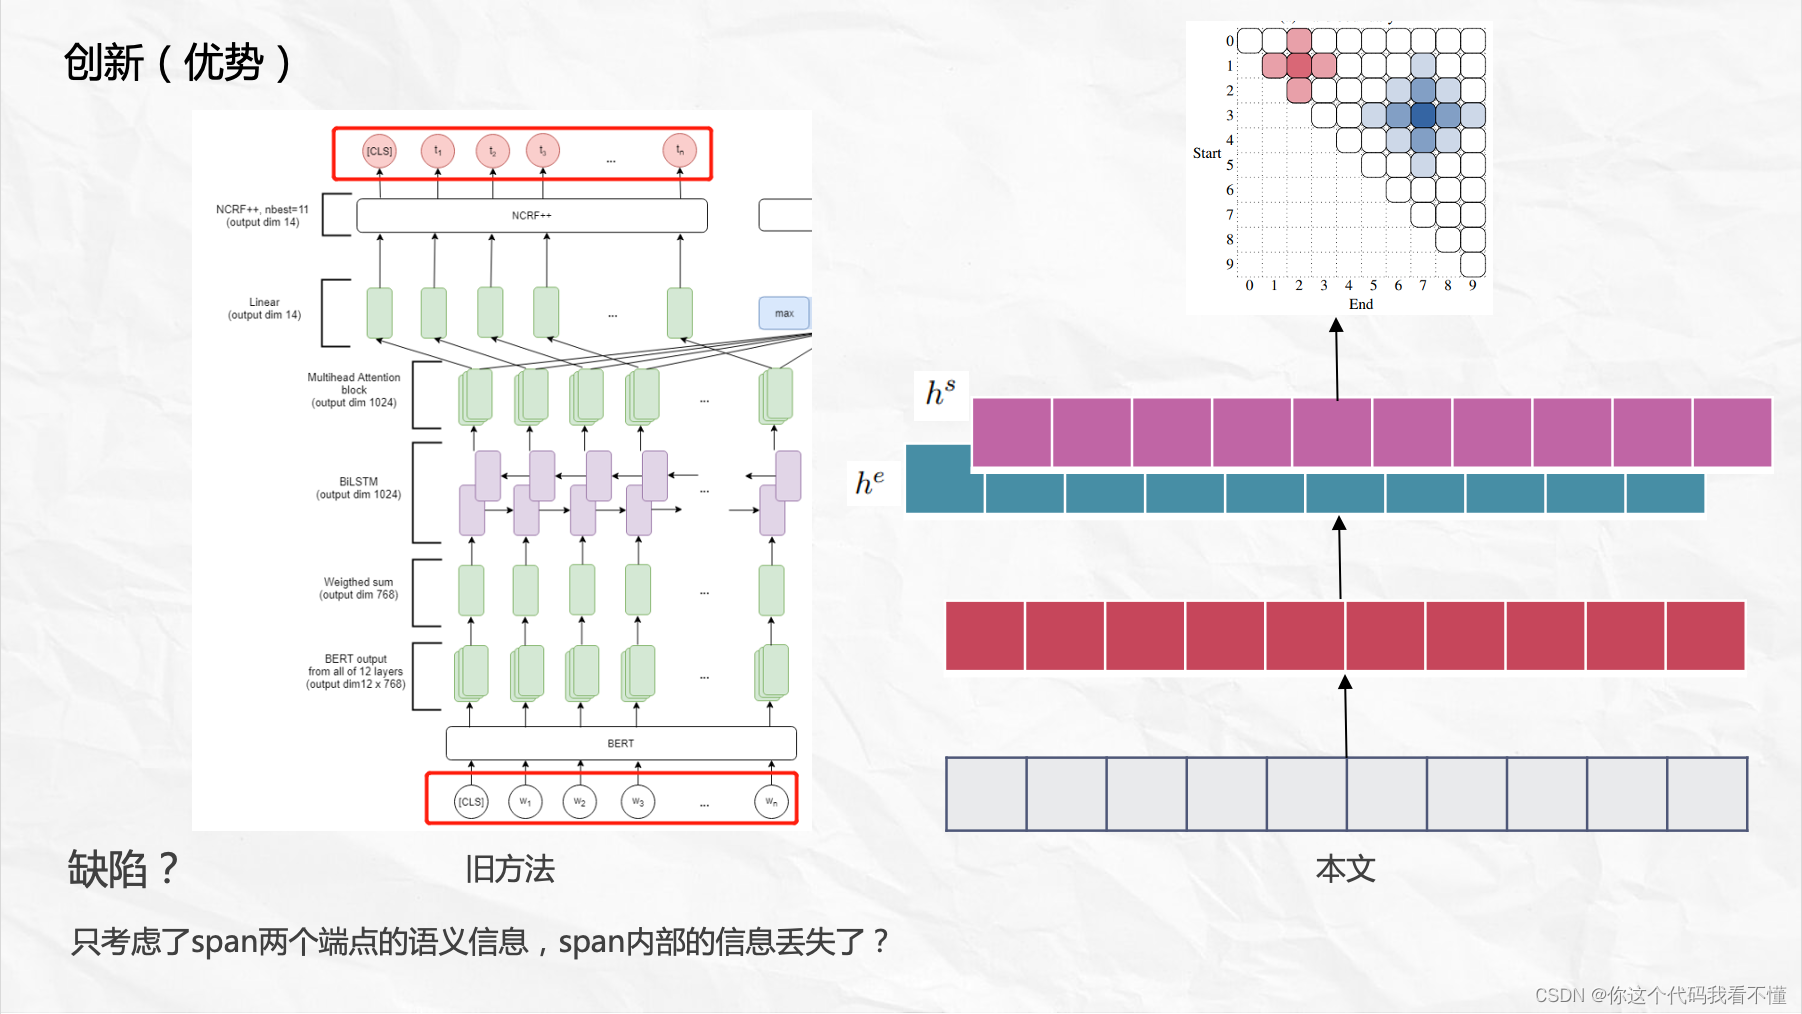
- Multilingual Named Entity Recognition Using Pretrained Embeddings, Attention Mechanism and NCRF
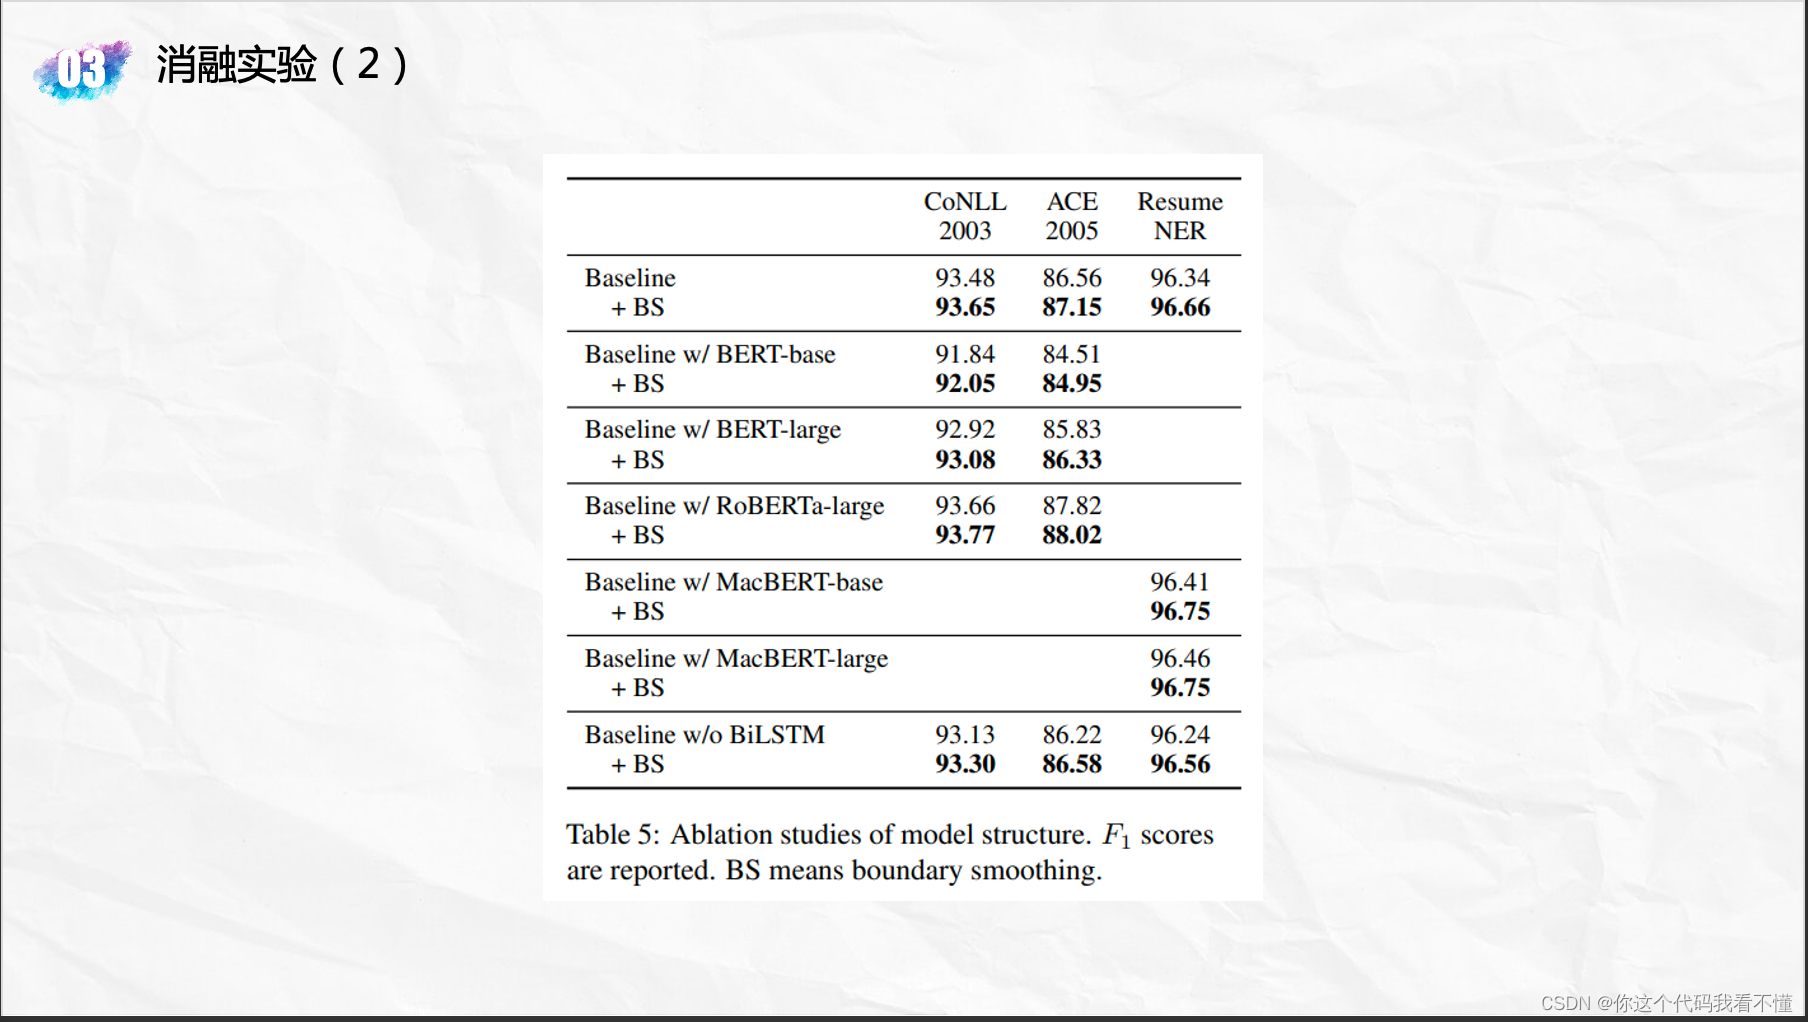
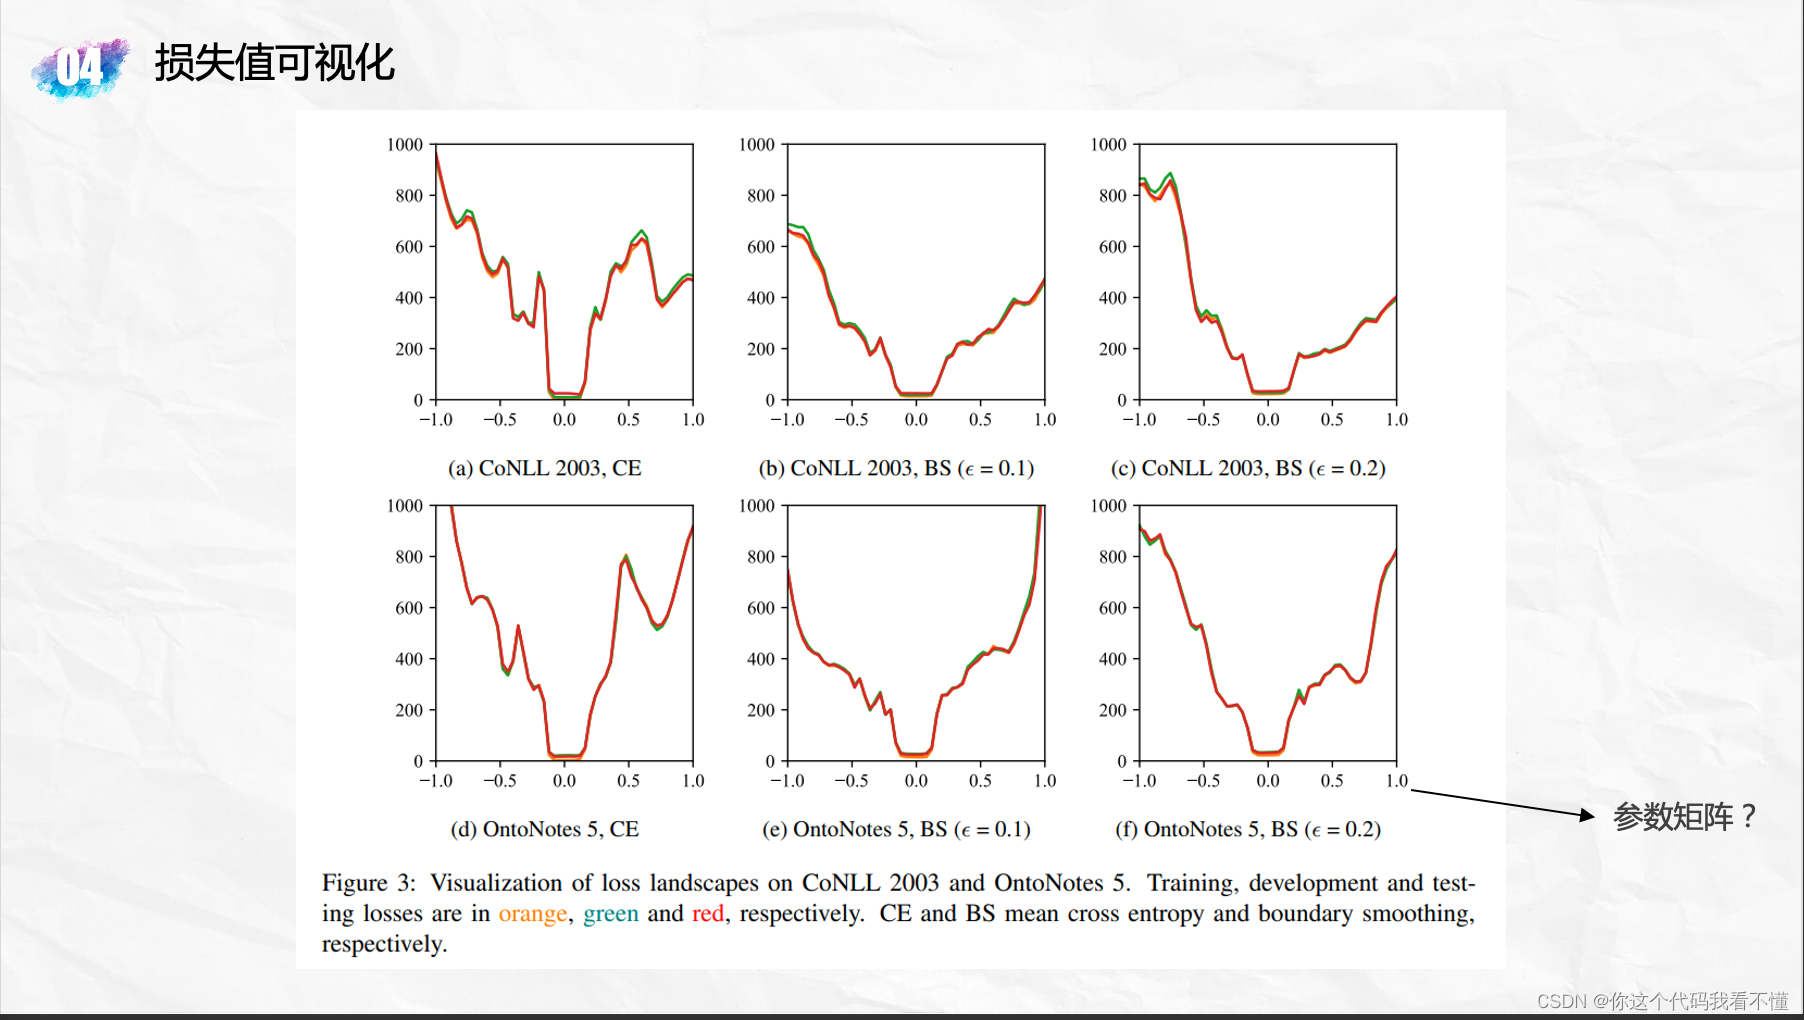
- Boundary Smoothing for Named Entity Recognition
- Bottom-Up Constituency Parsing and Nested Named Entity Recognition with Pointer Networks
- SimCSE: Simple Contrastive Learning of Sentence Embeddings
- Learning Transferable Visual Models From Natural Language Supervision
- FNet: Mixing Tokens with Fourier Transforms
- How to Fine-Tune BERT for Text Classification?
- Unified Structure Generation for Universal Information Extraction
- Sequencer: Deep LSTM for Image Classification
- Transformer Quality in Linear Time
- ChatGPT
- Recurrent Memory Transformer
- Diffusion+
- Scalable Diffusion Models with Transformers
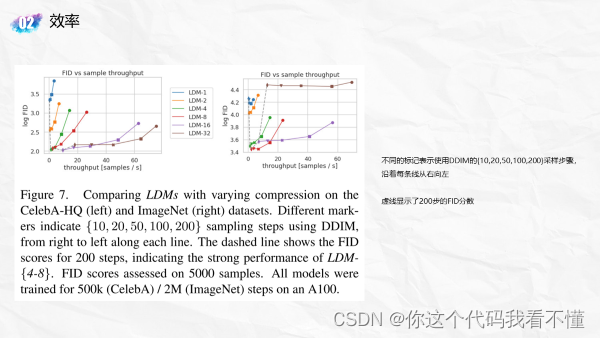
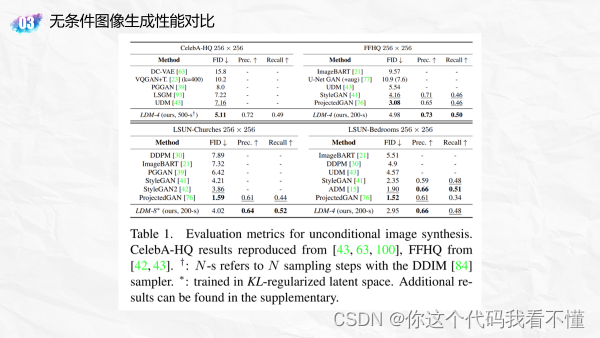
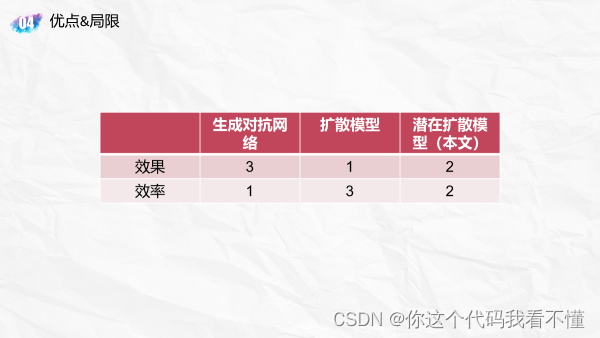
- High-Resolution Image Synthesis with Latent Diffusion Models
文本分类
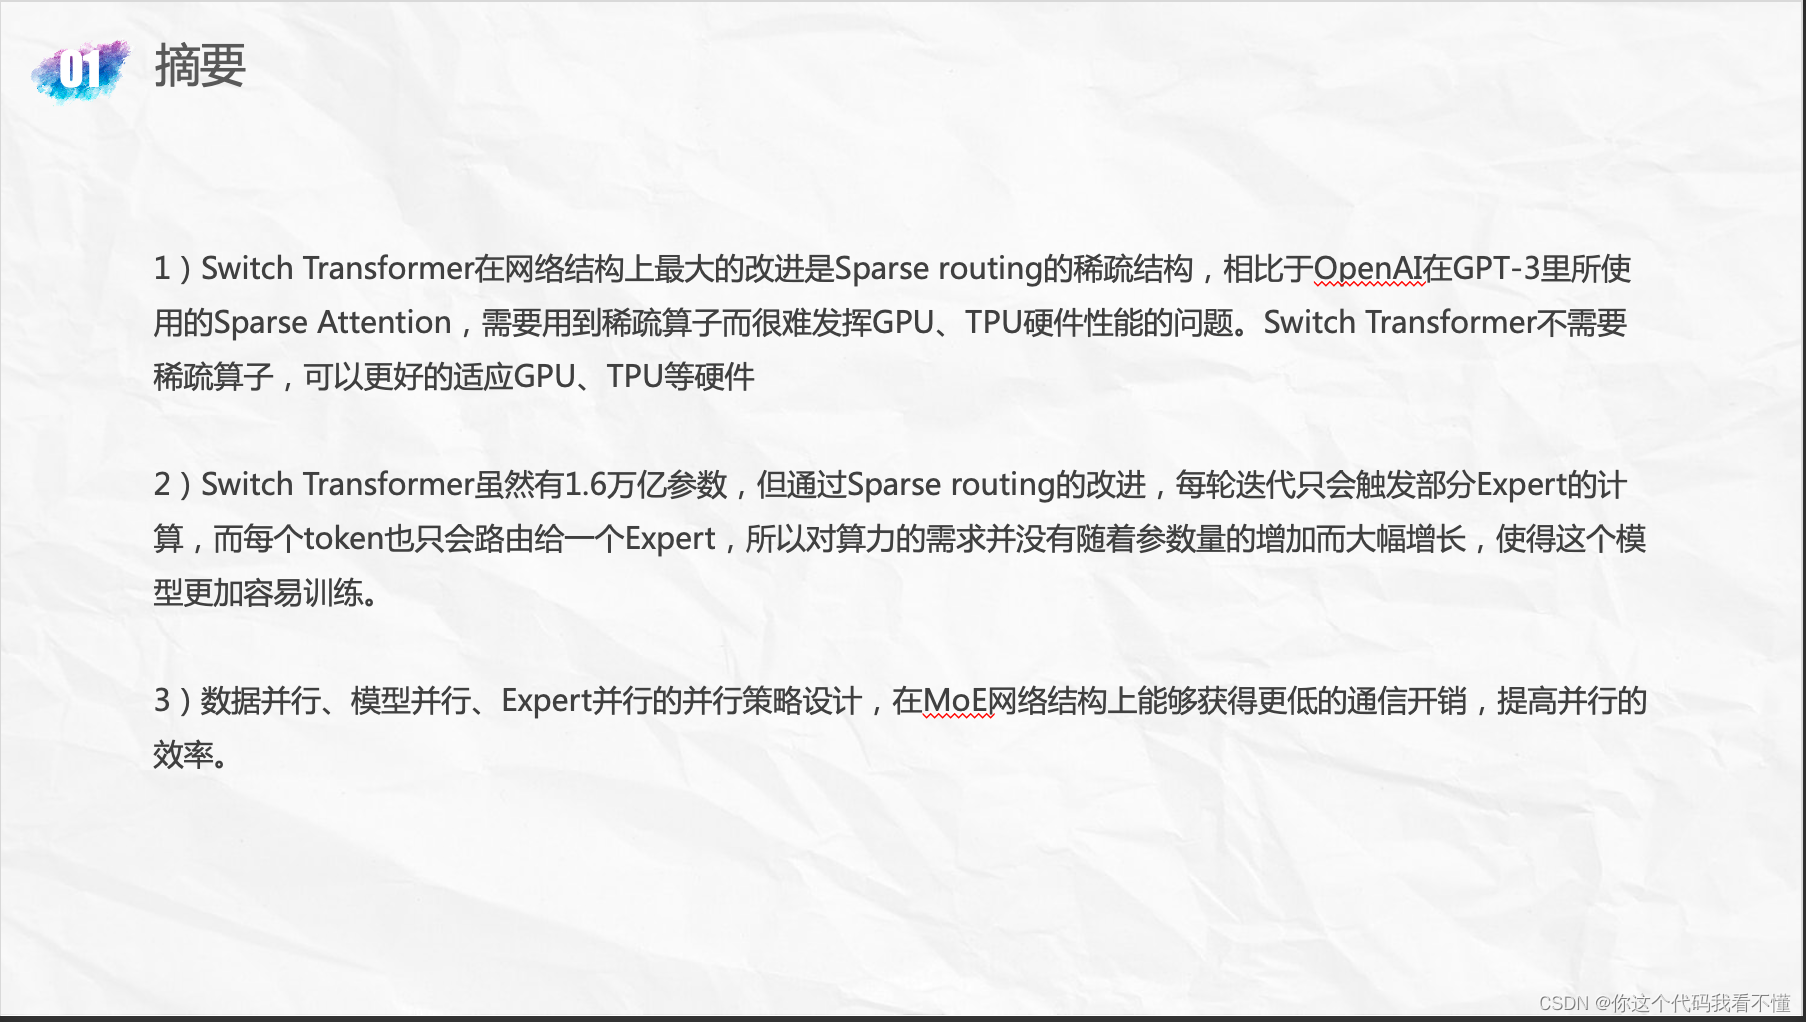
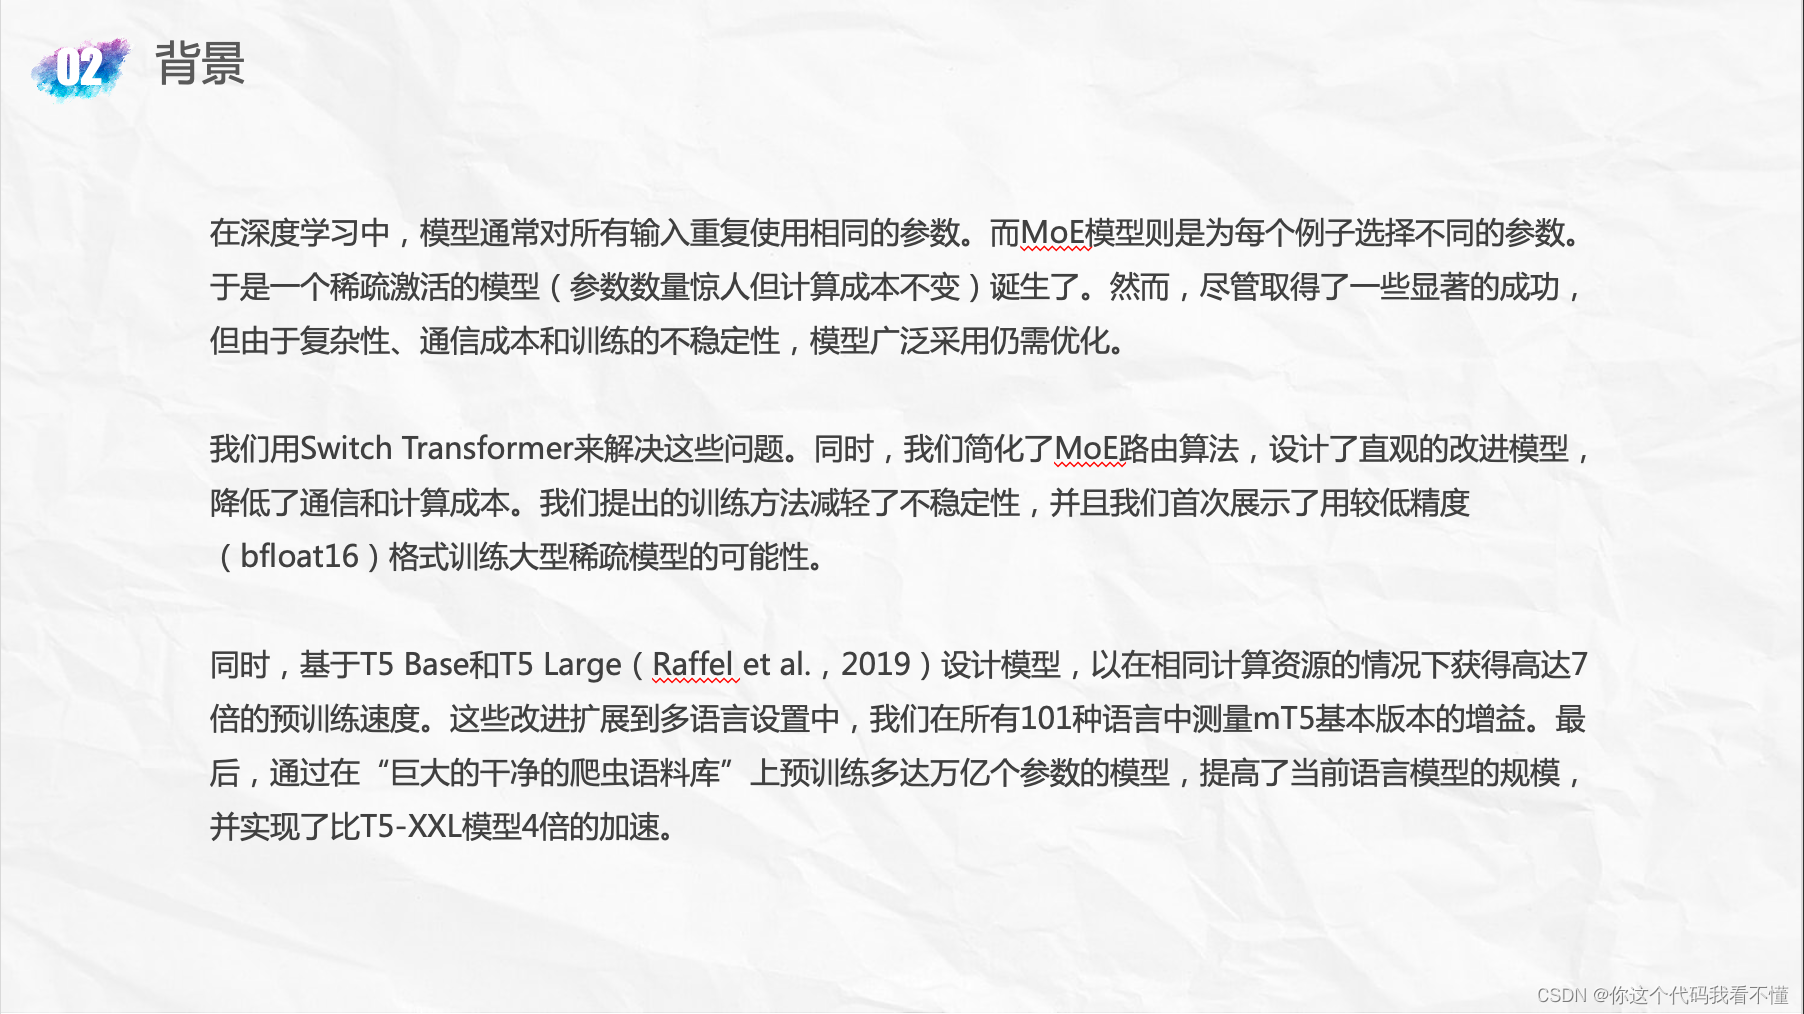
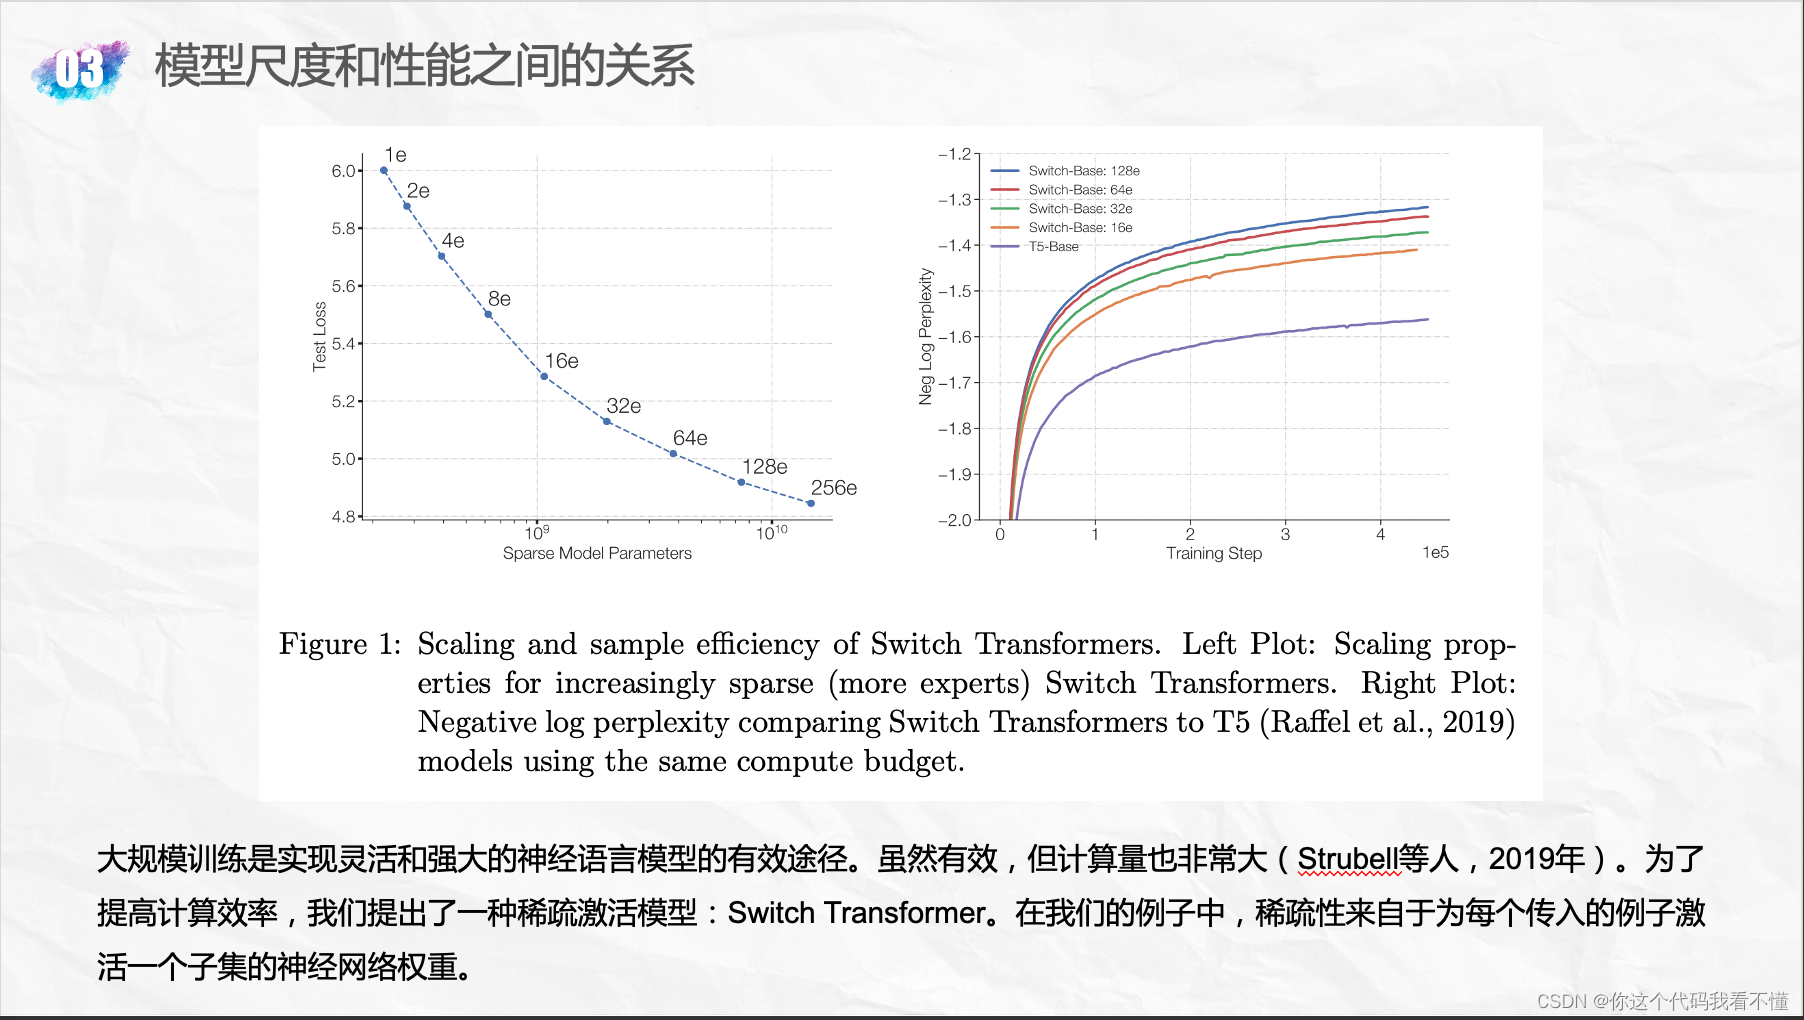
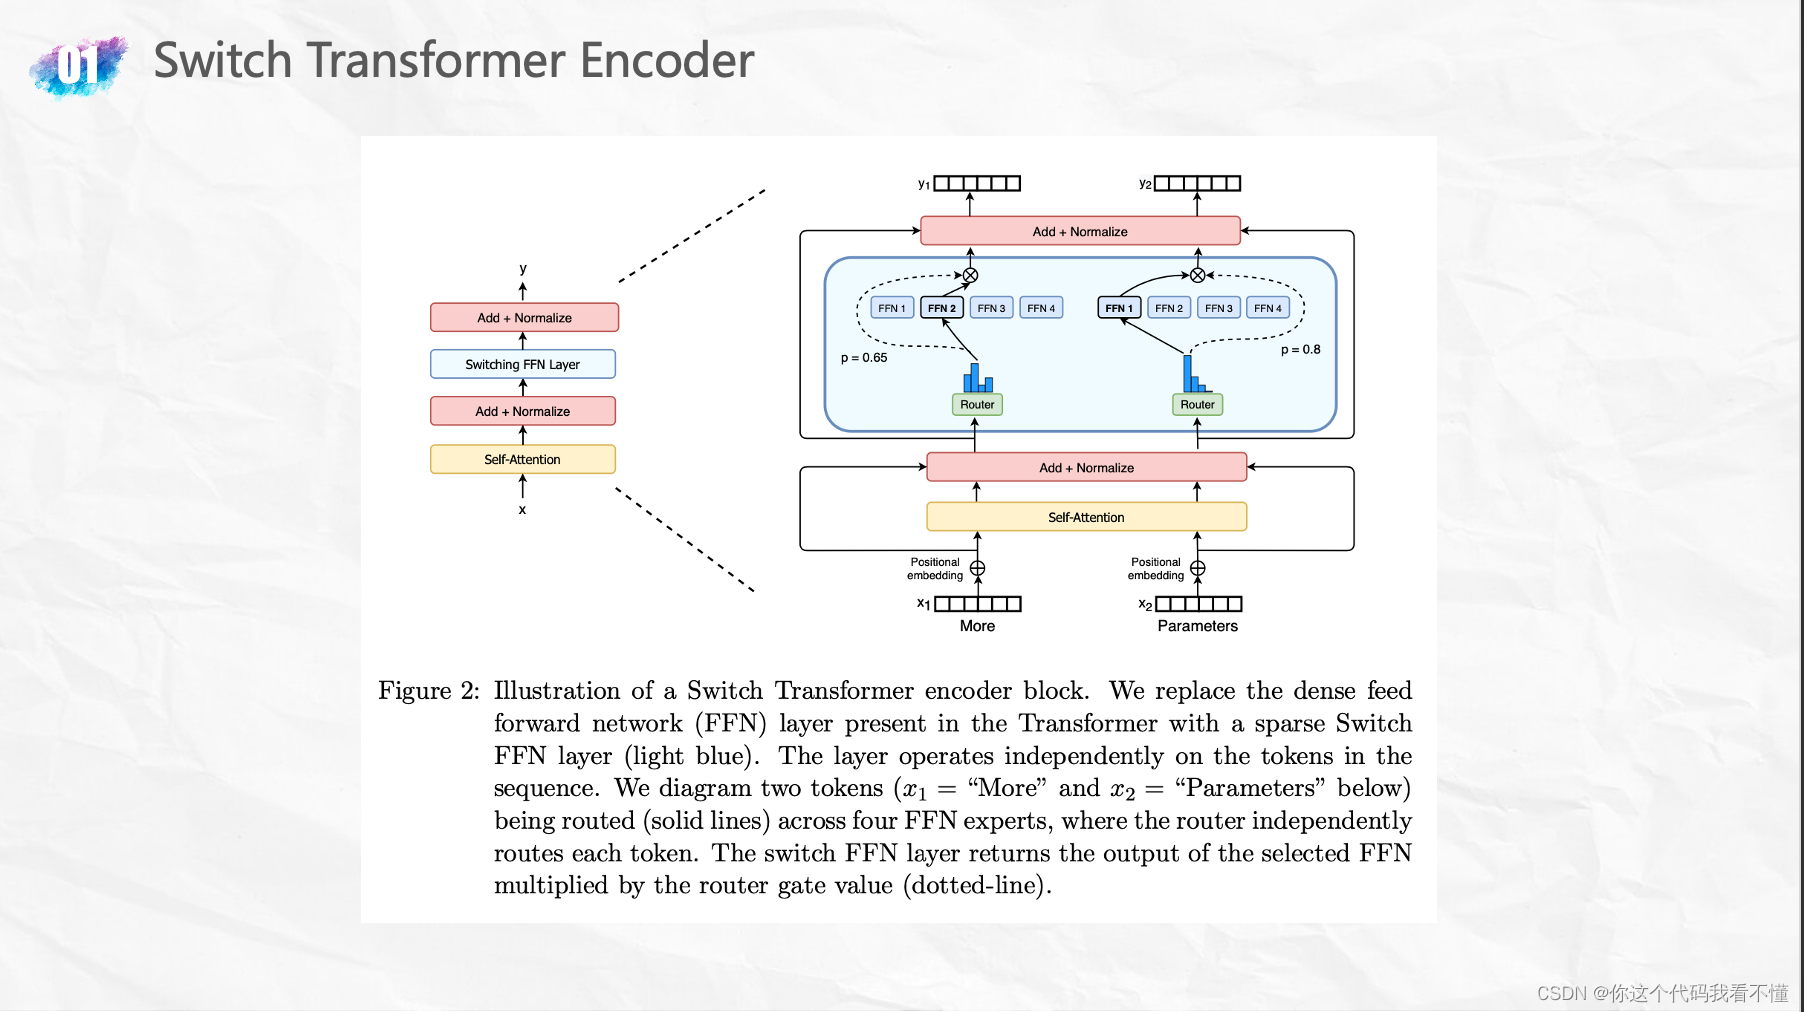
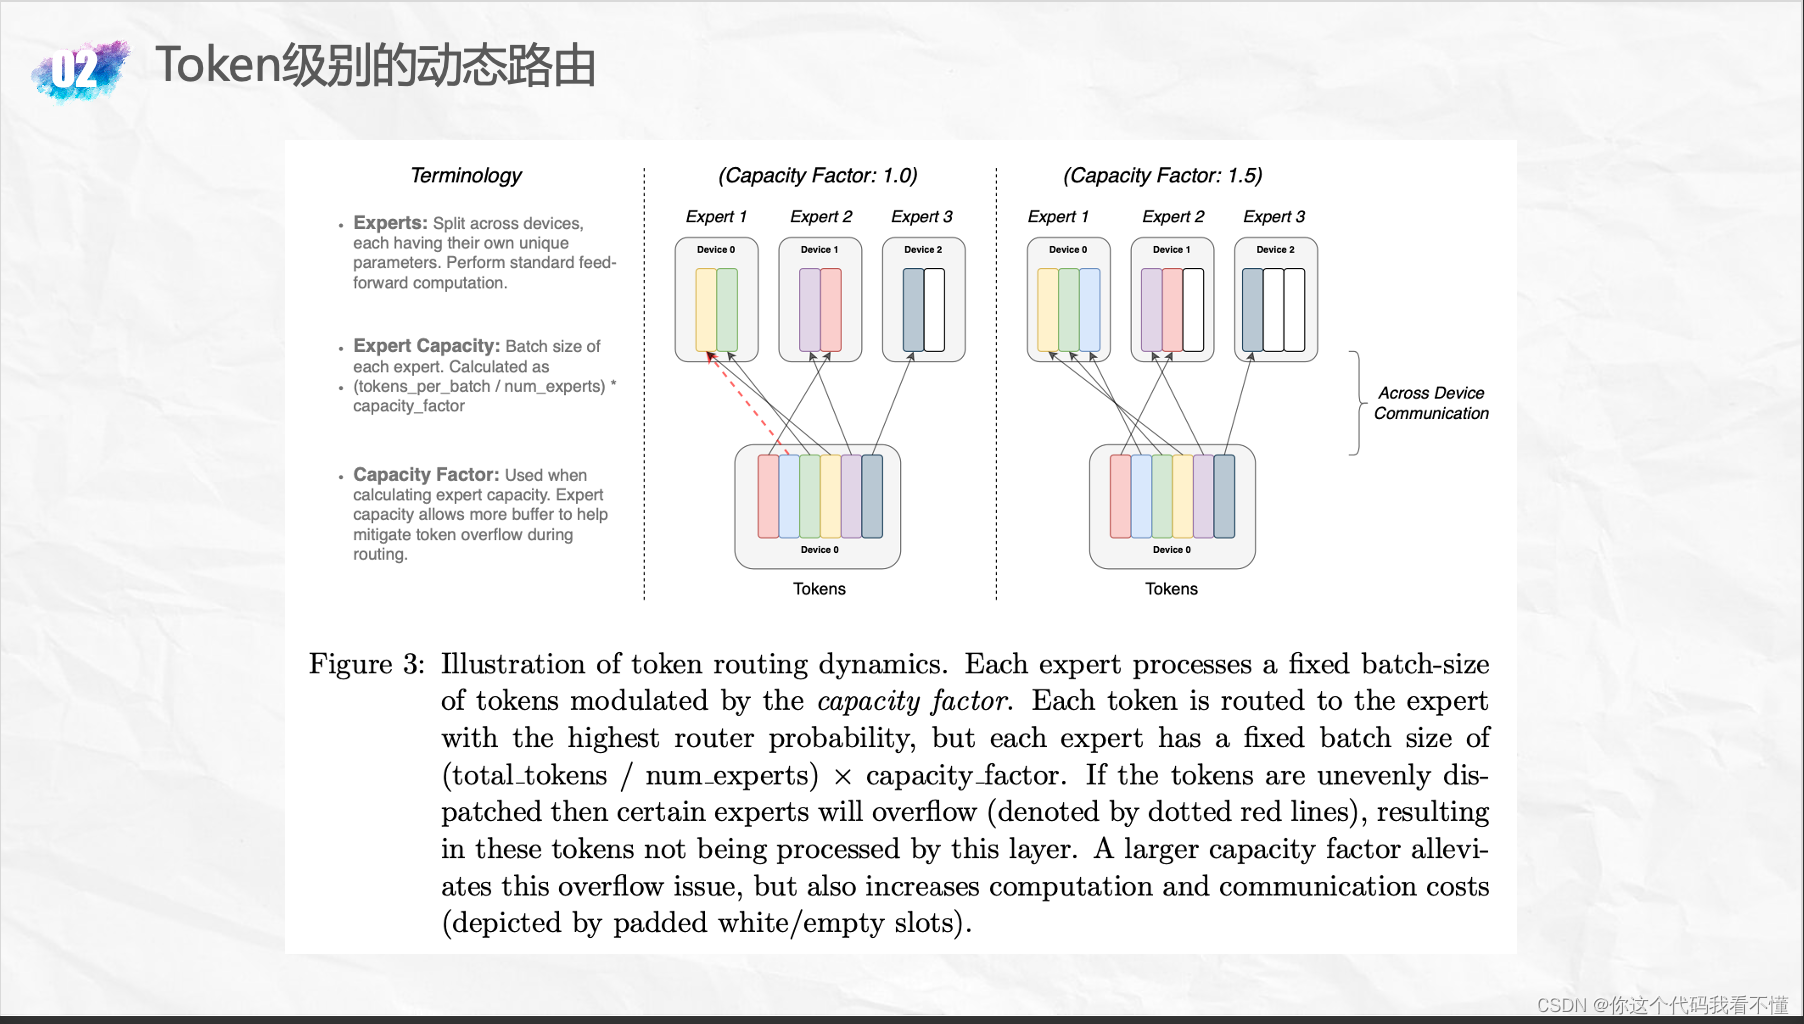
Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
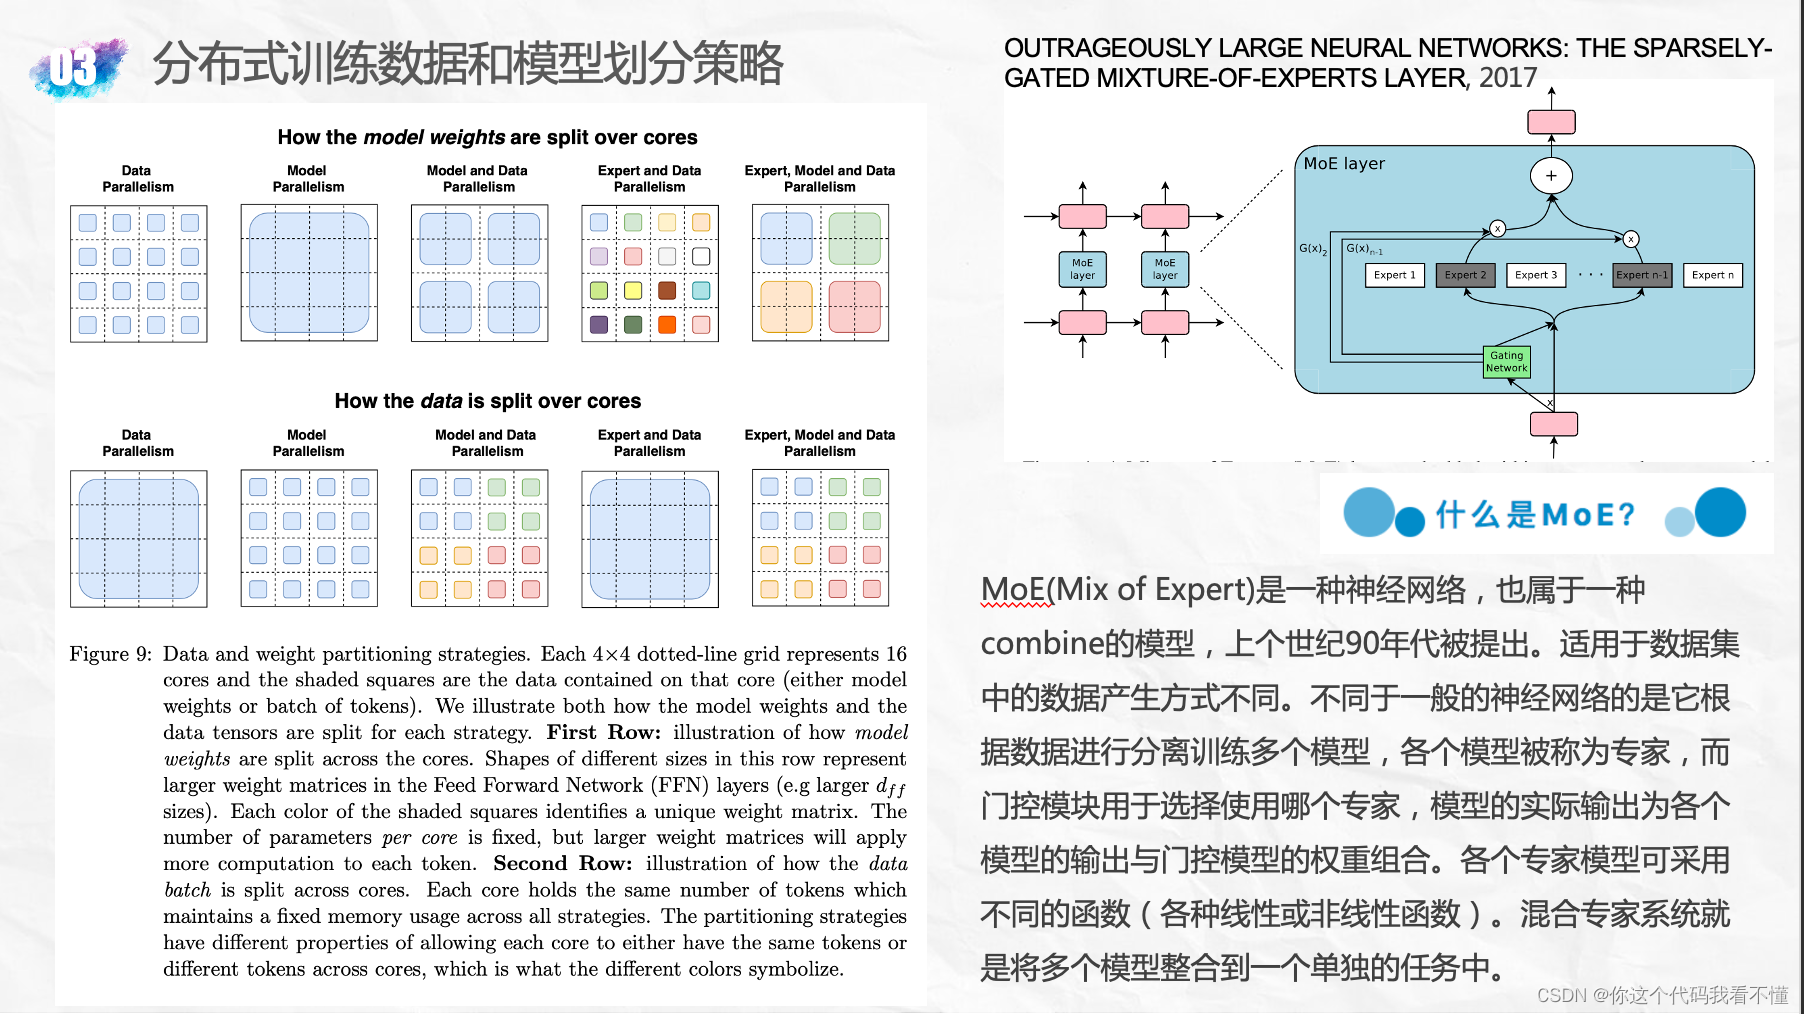
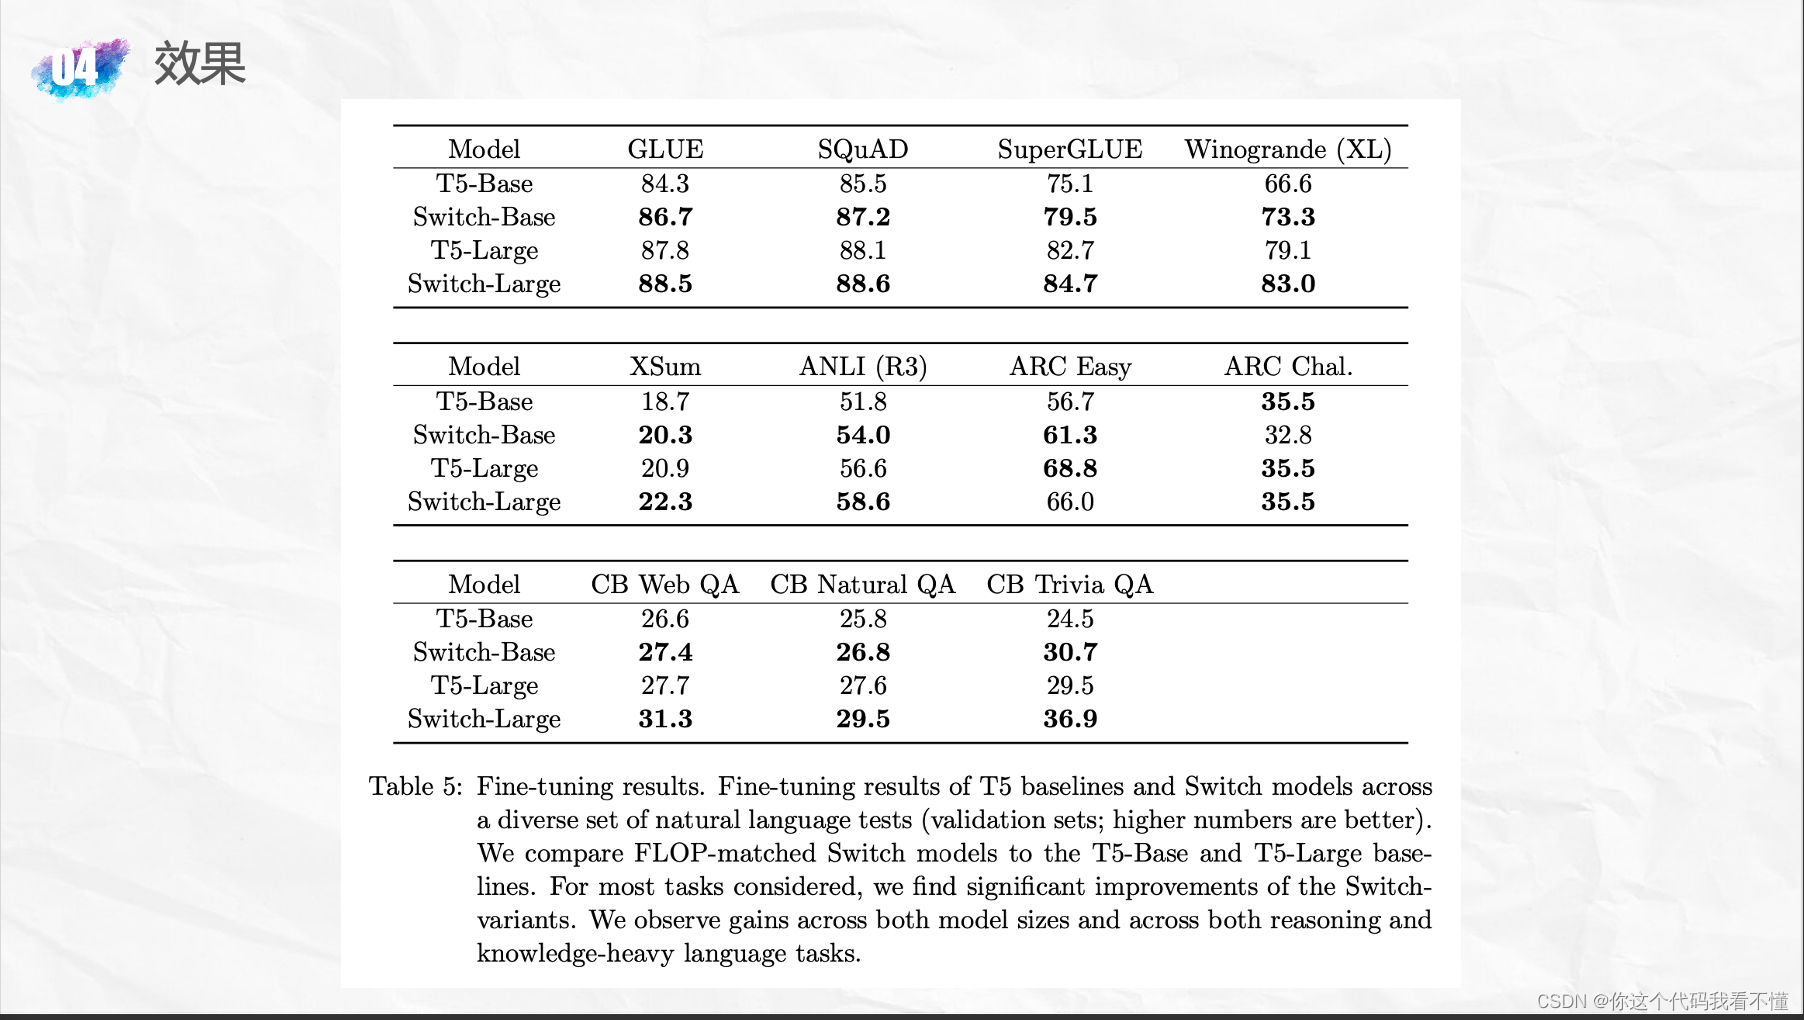
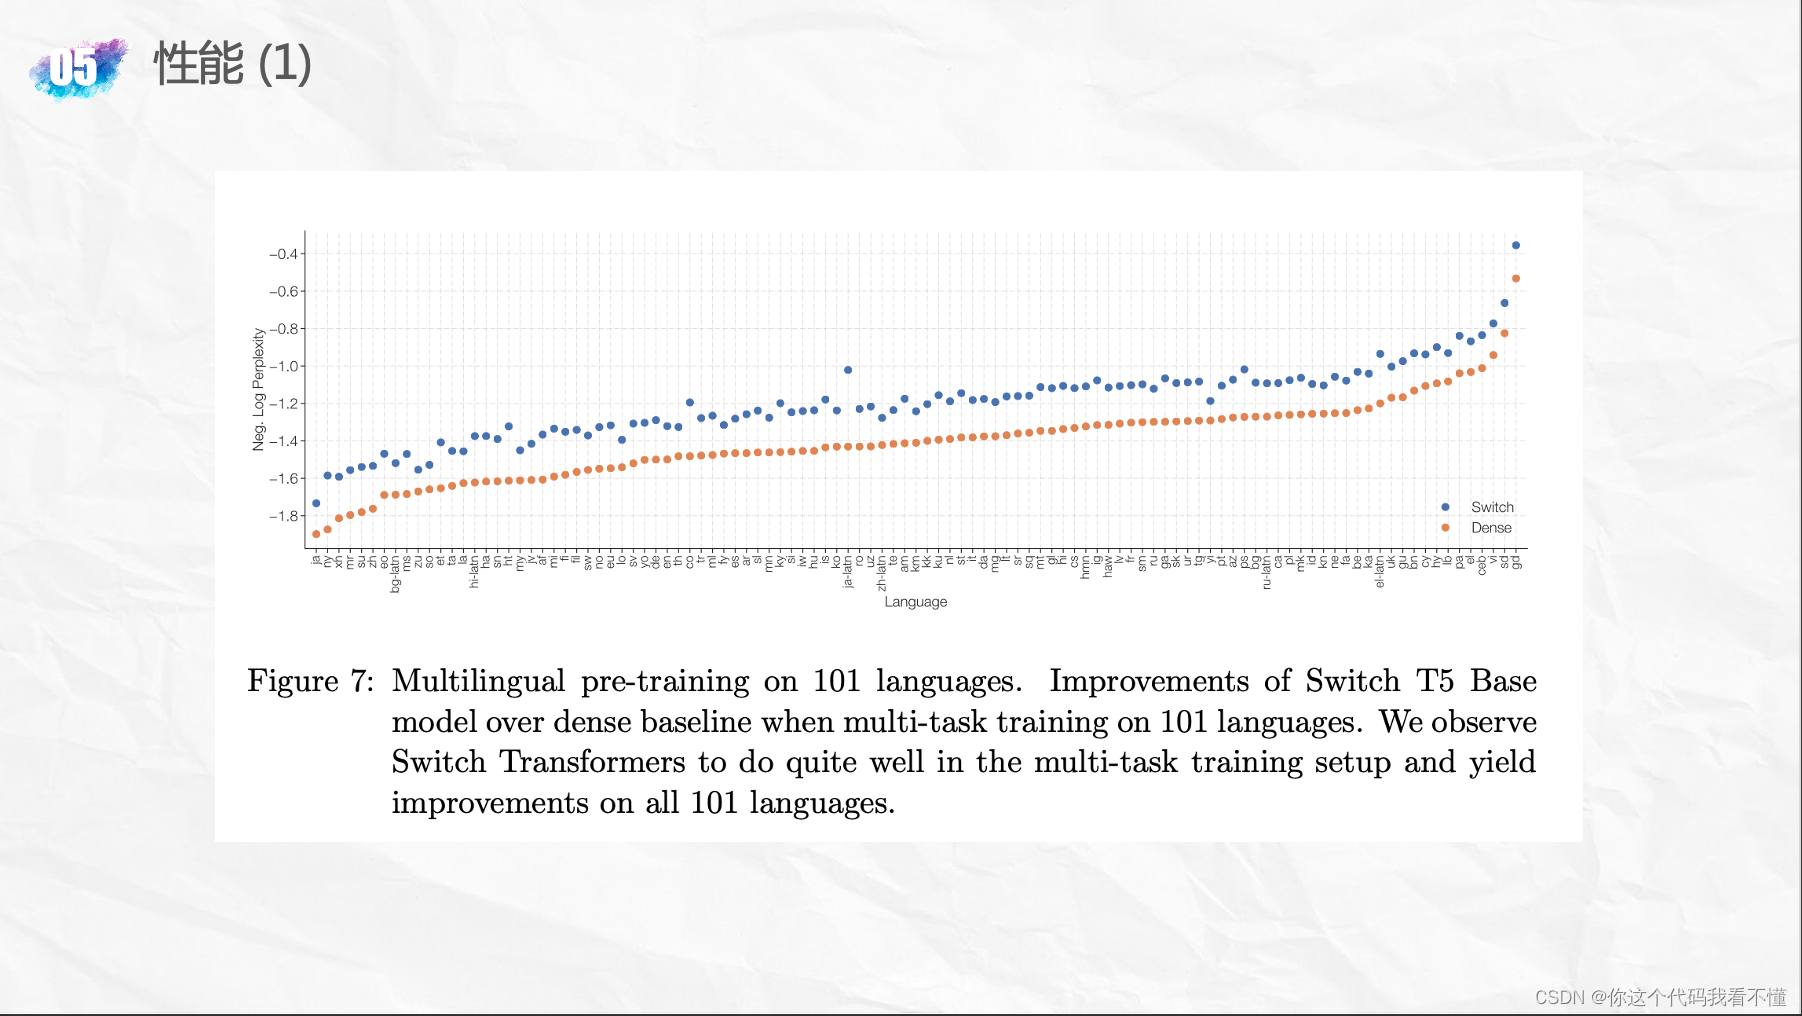
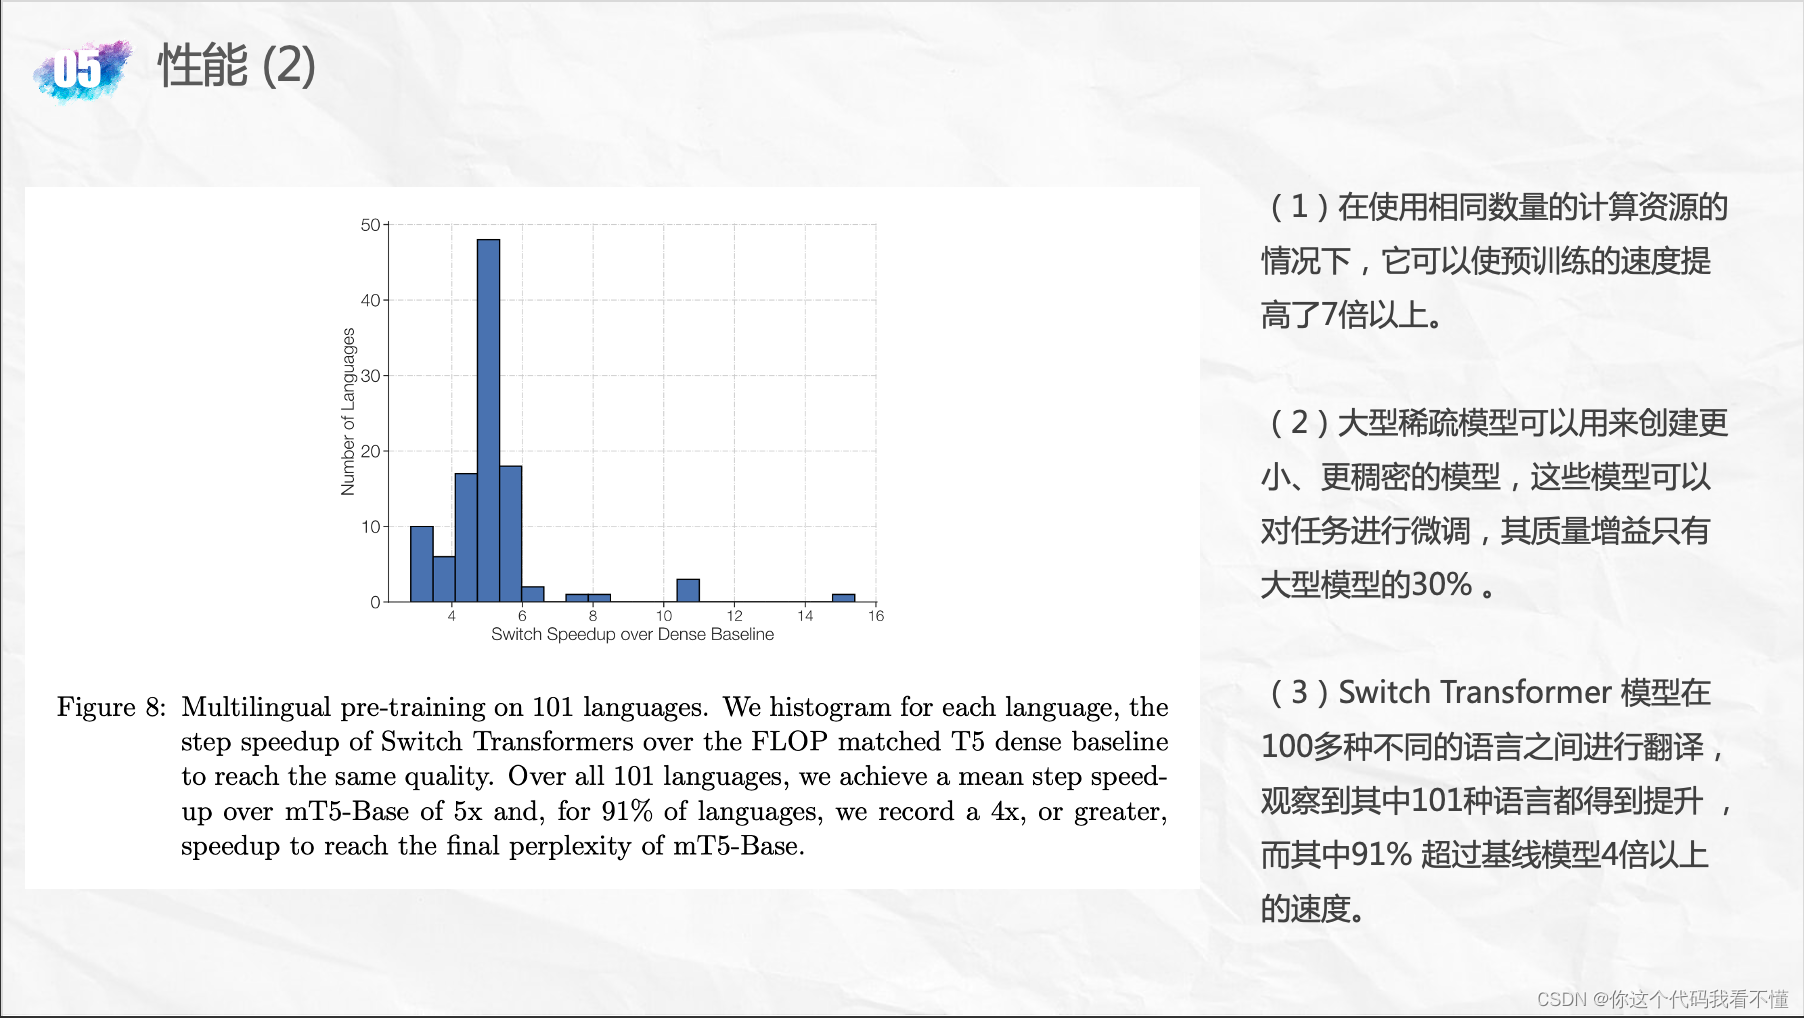
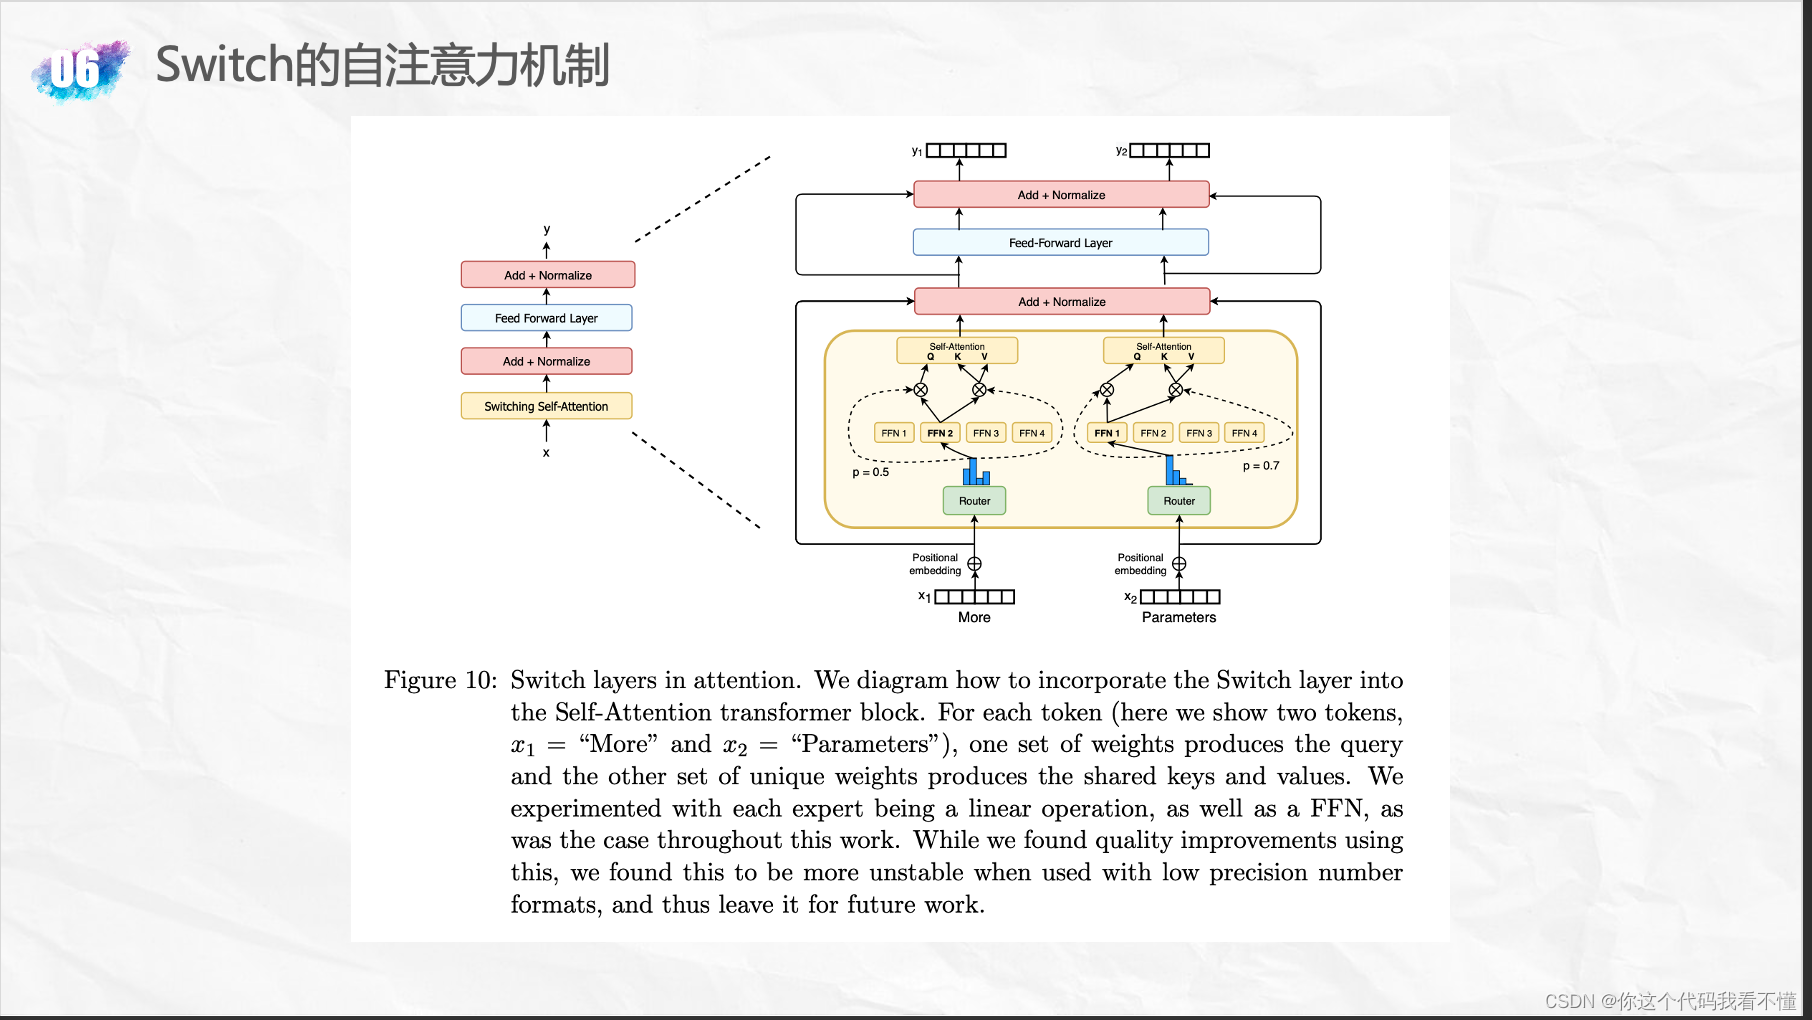
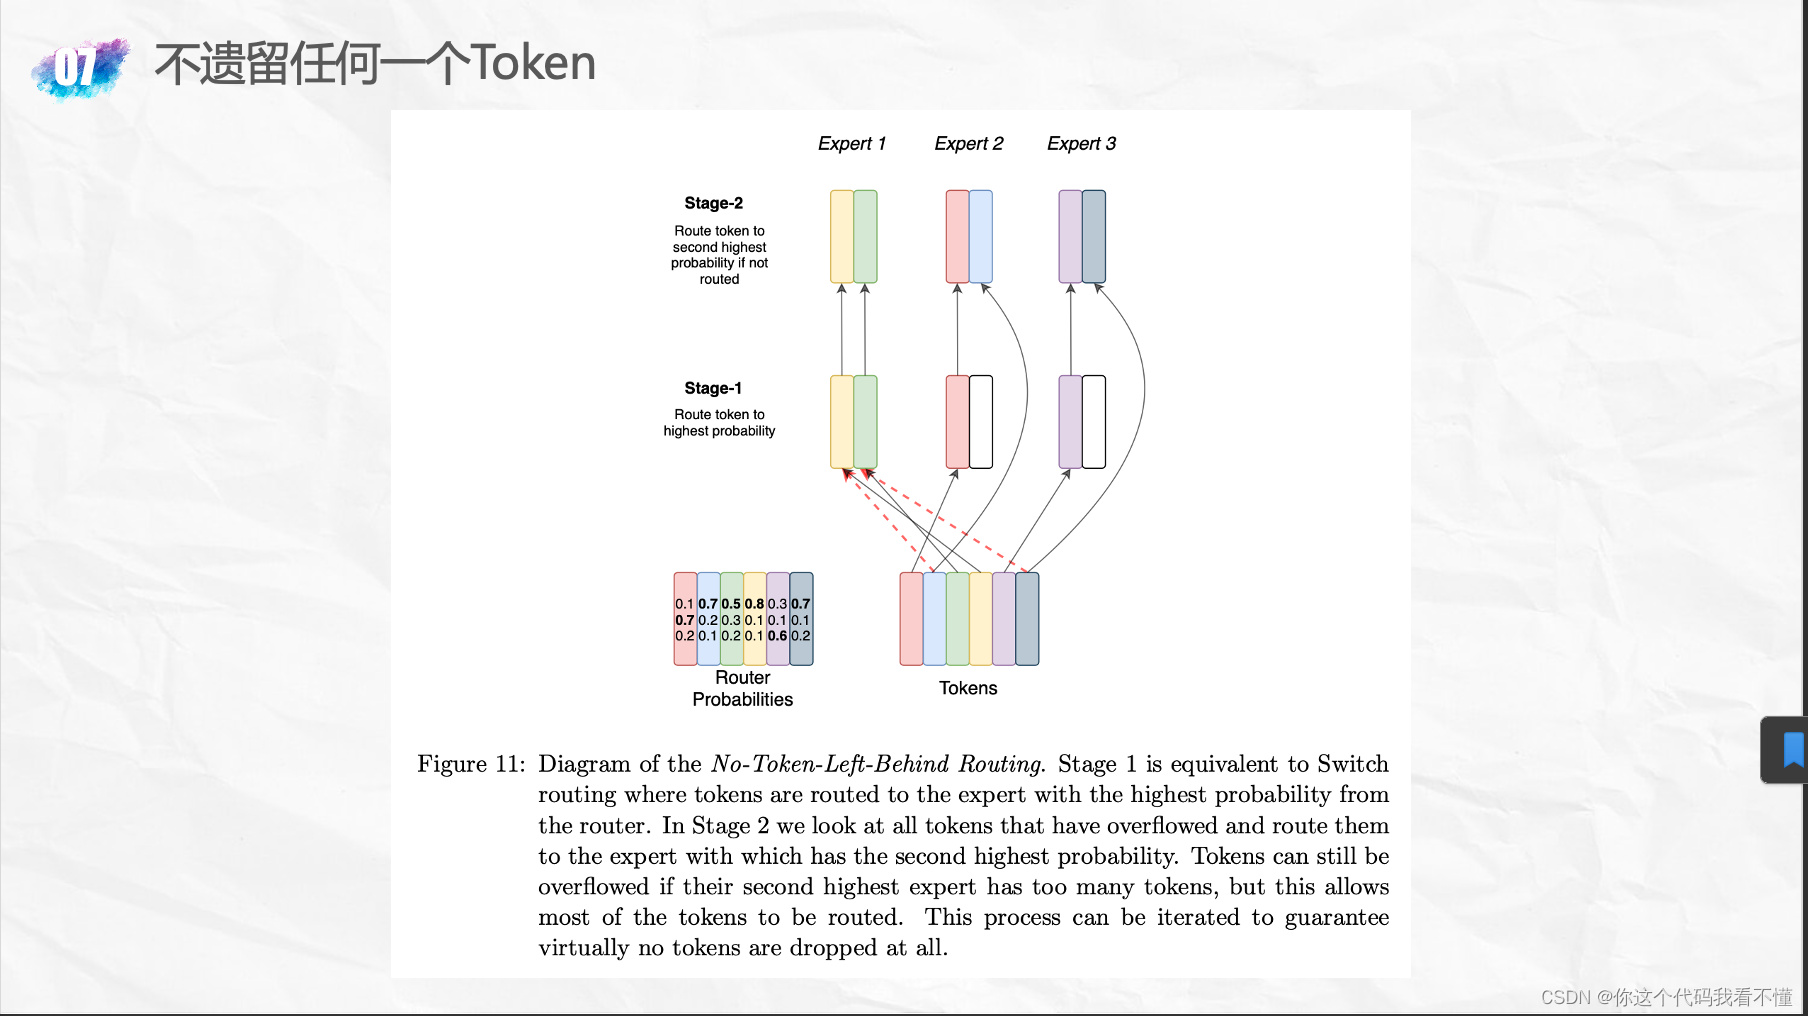
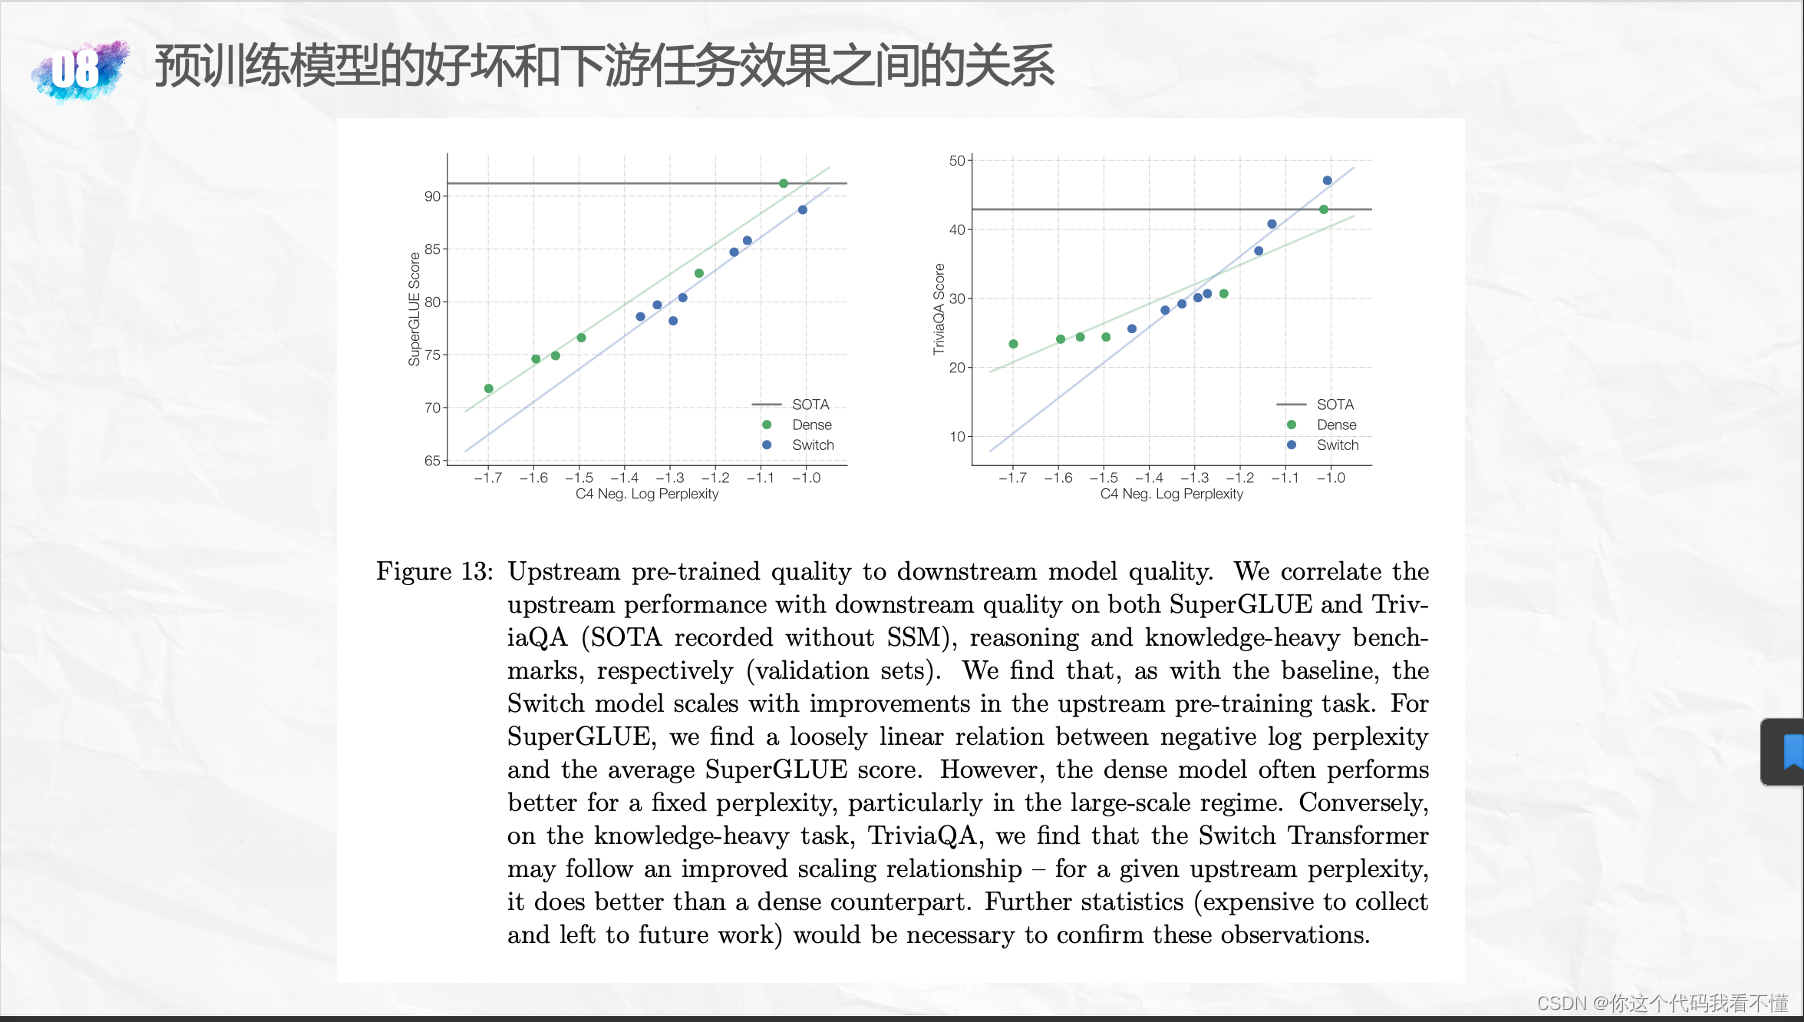
- 损失函数的物理意义:预测值与标签值之间的差距(从这个意义上说,损失值应当大于等于0)(排除一些特殊的损失函数)
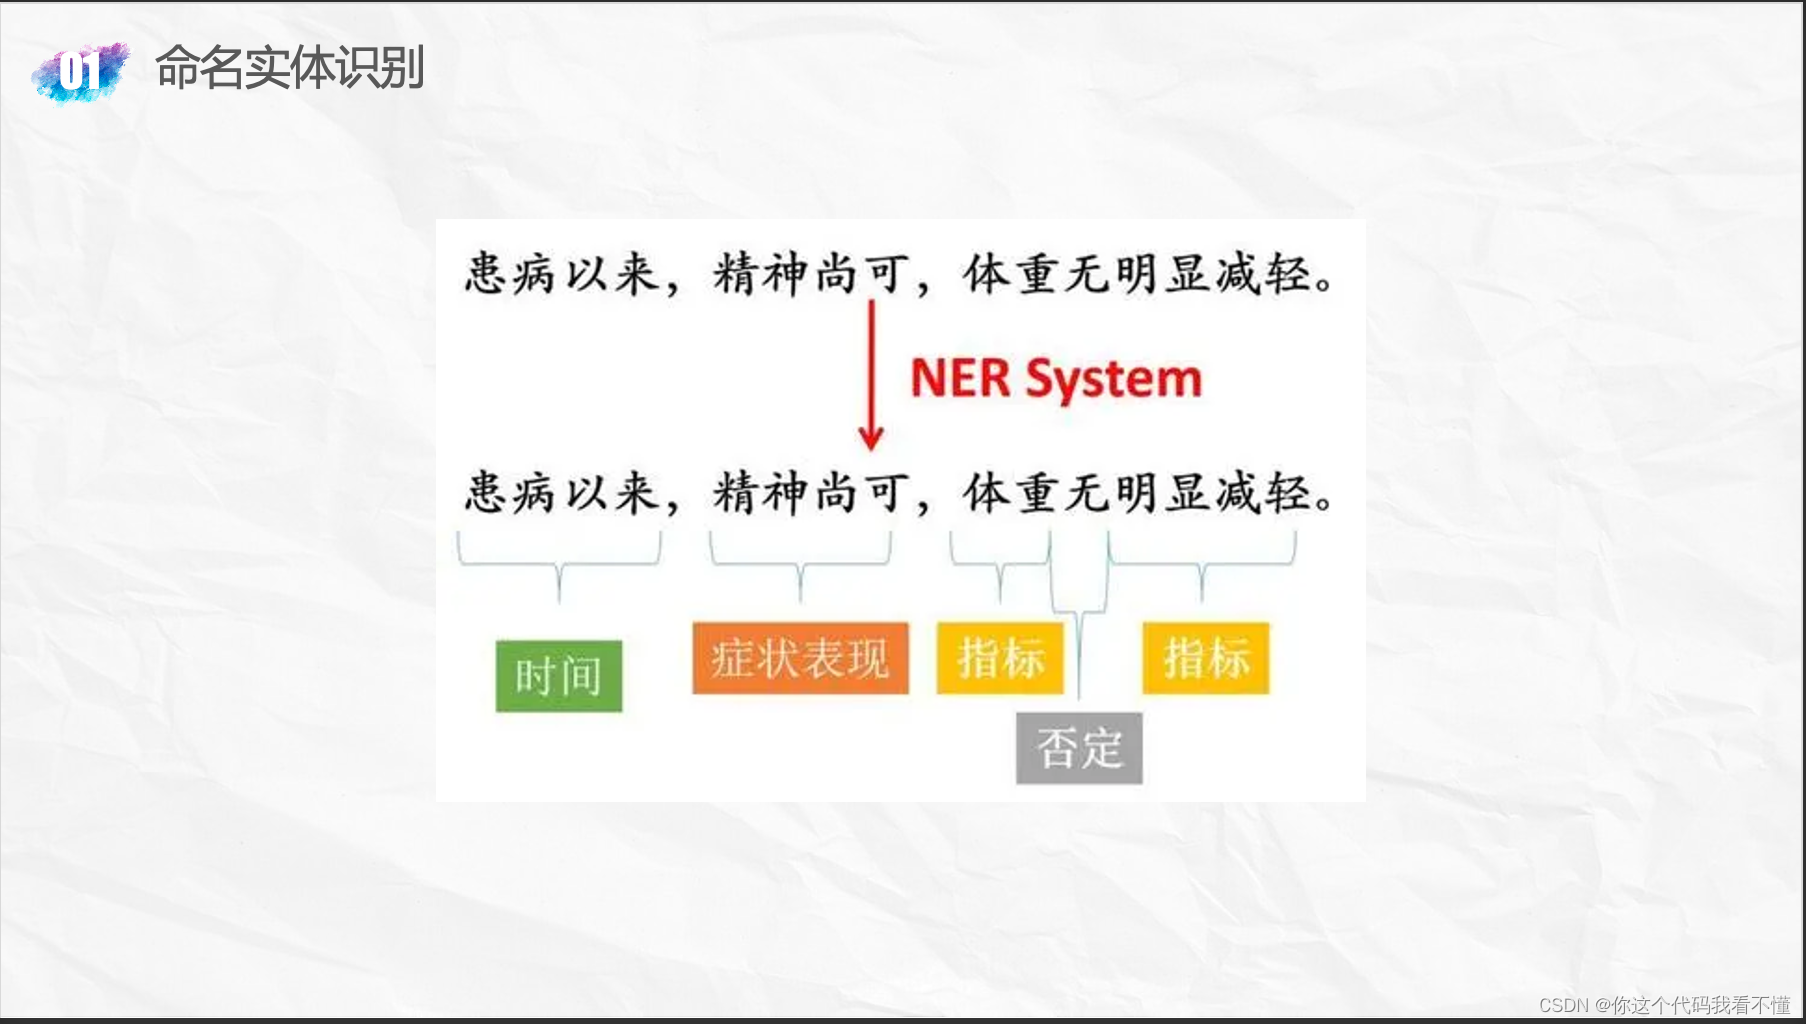
命名实体识别
LSTM-CRF
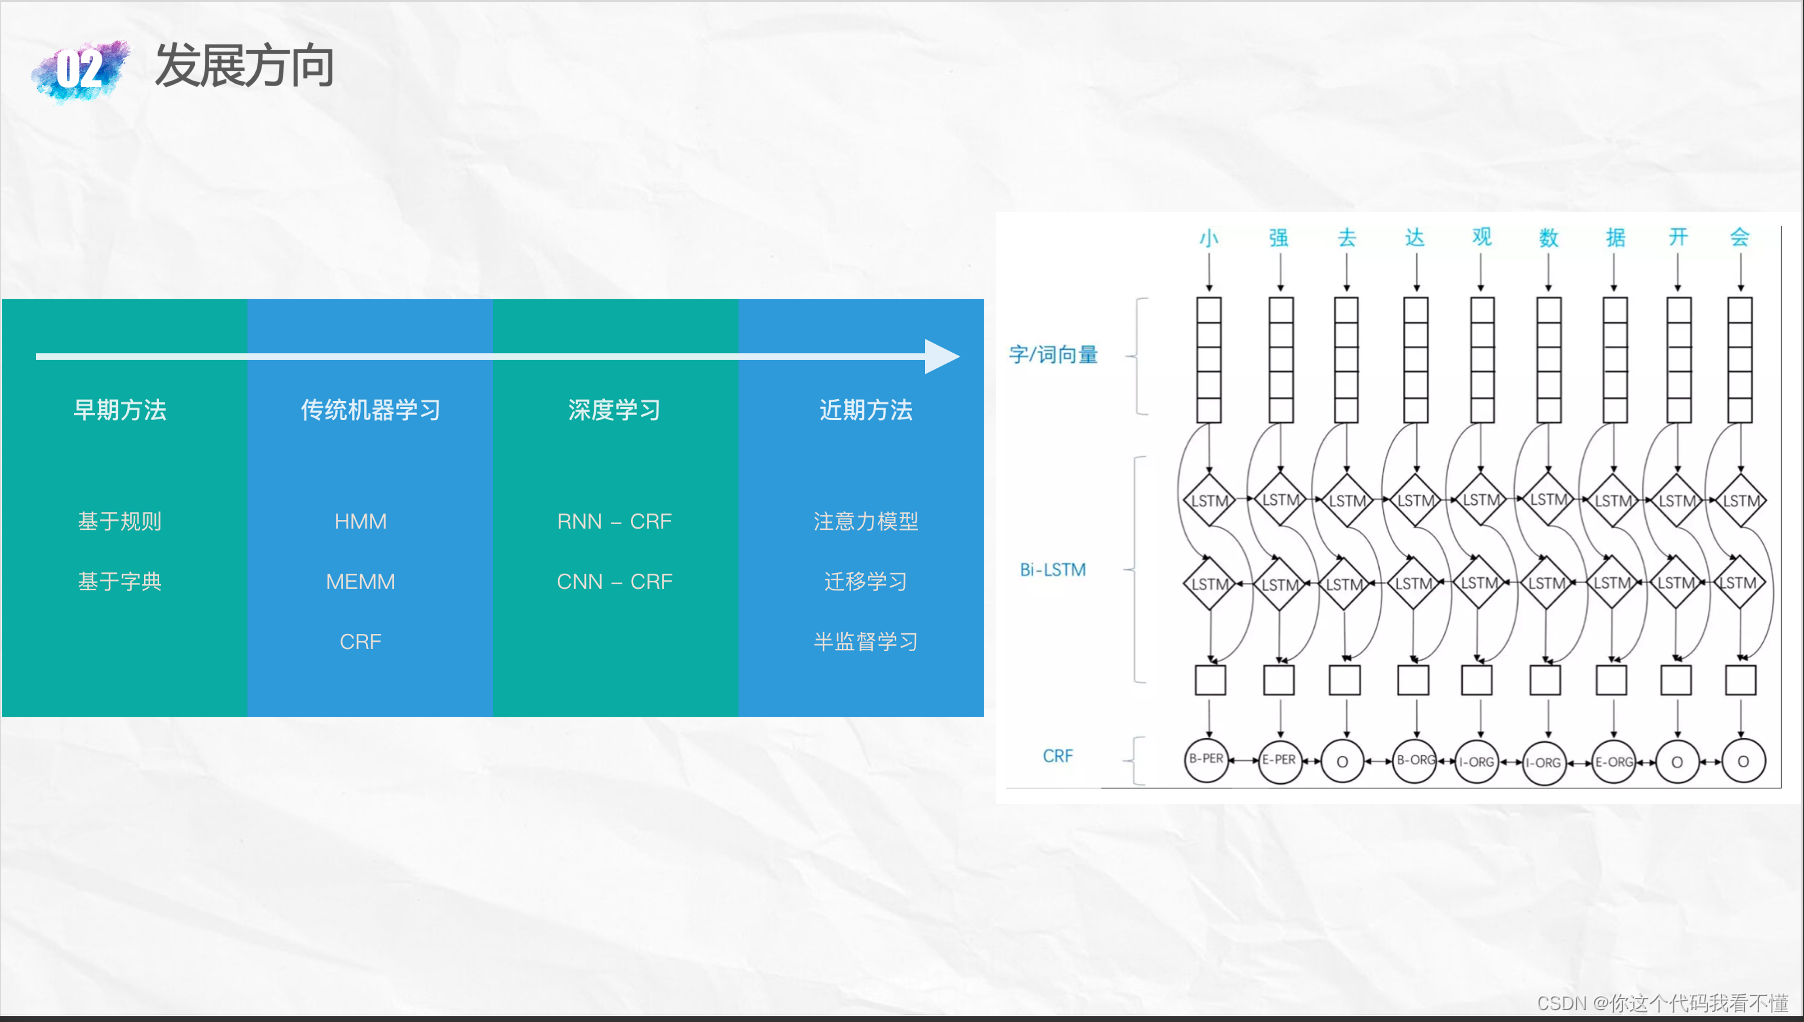
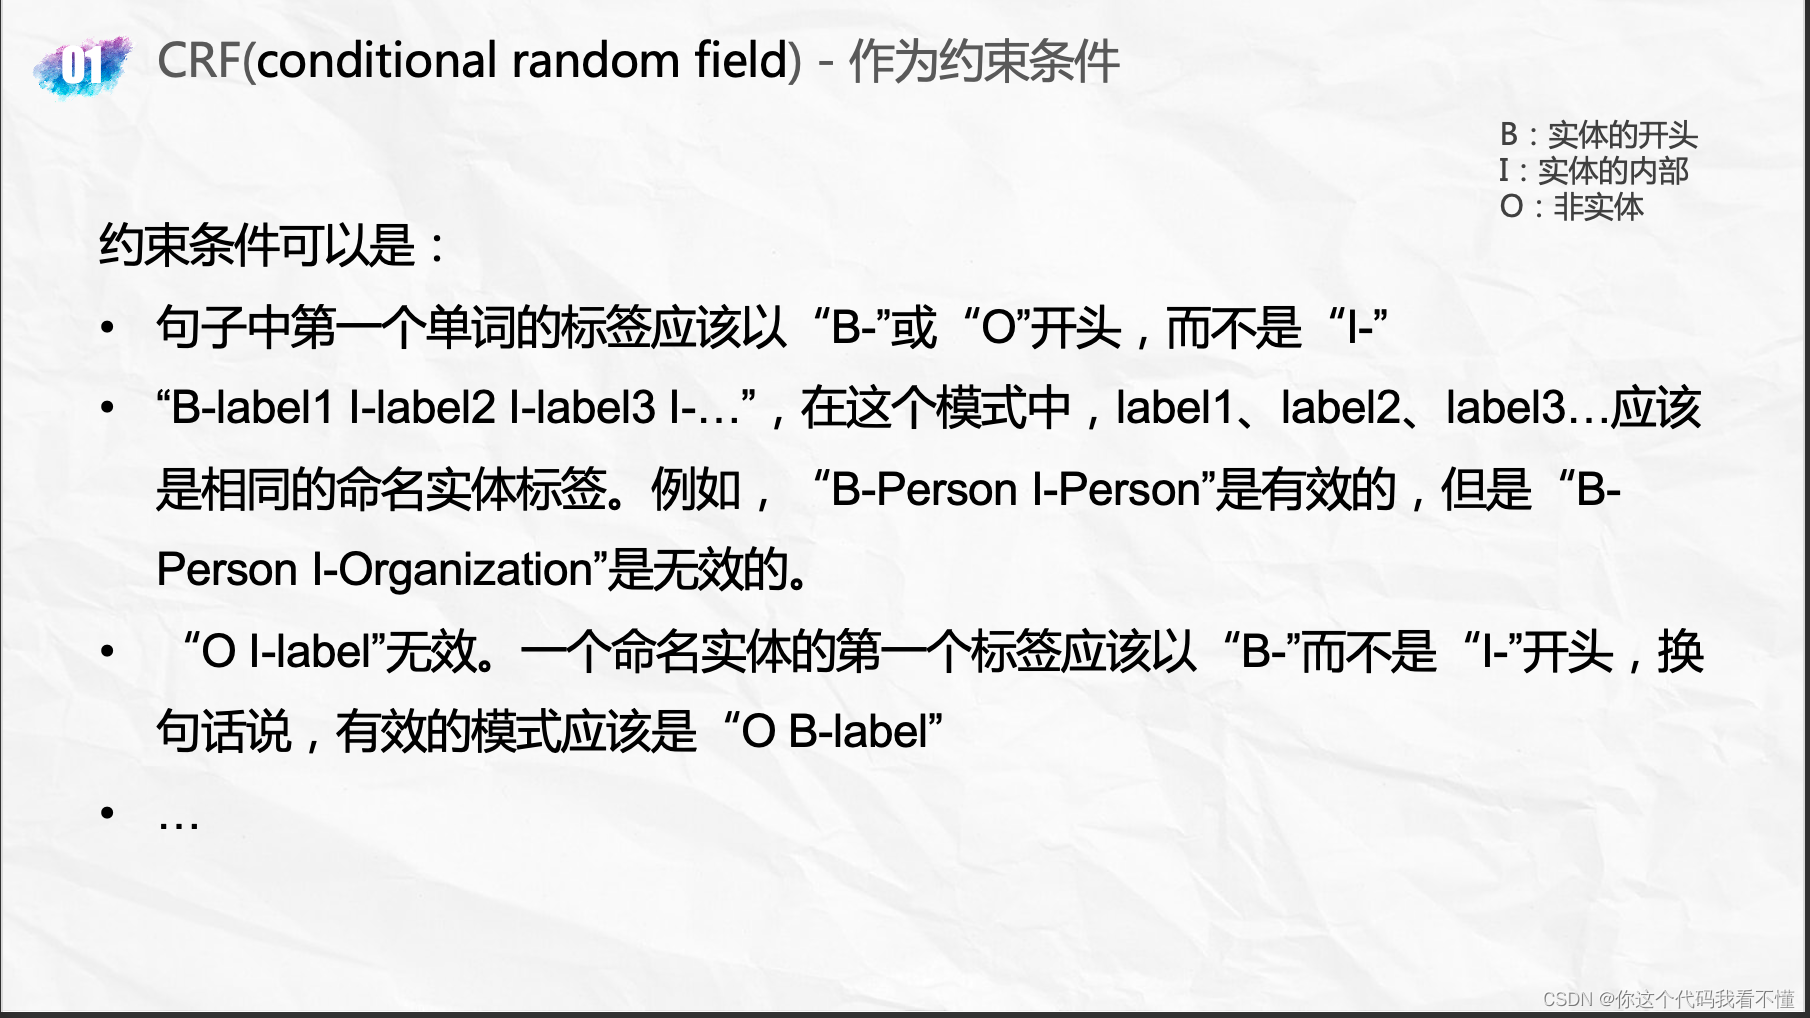
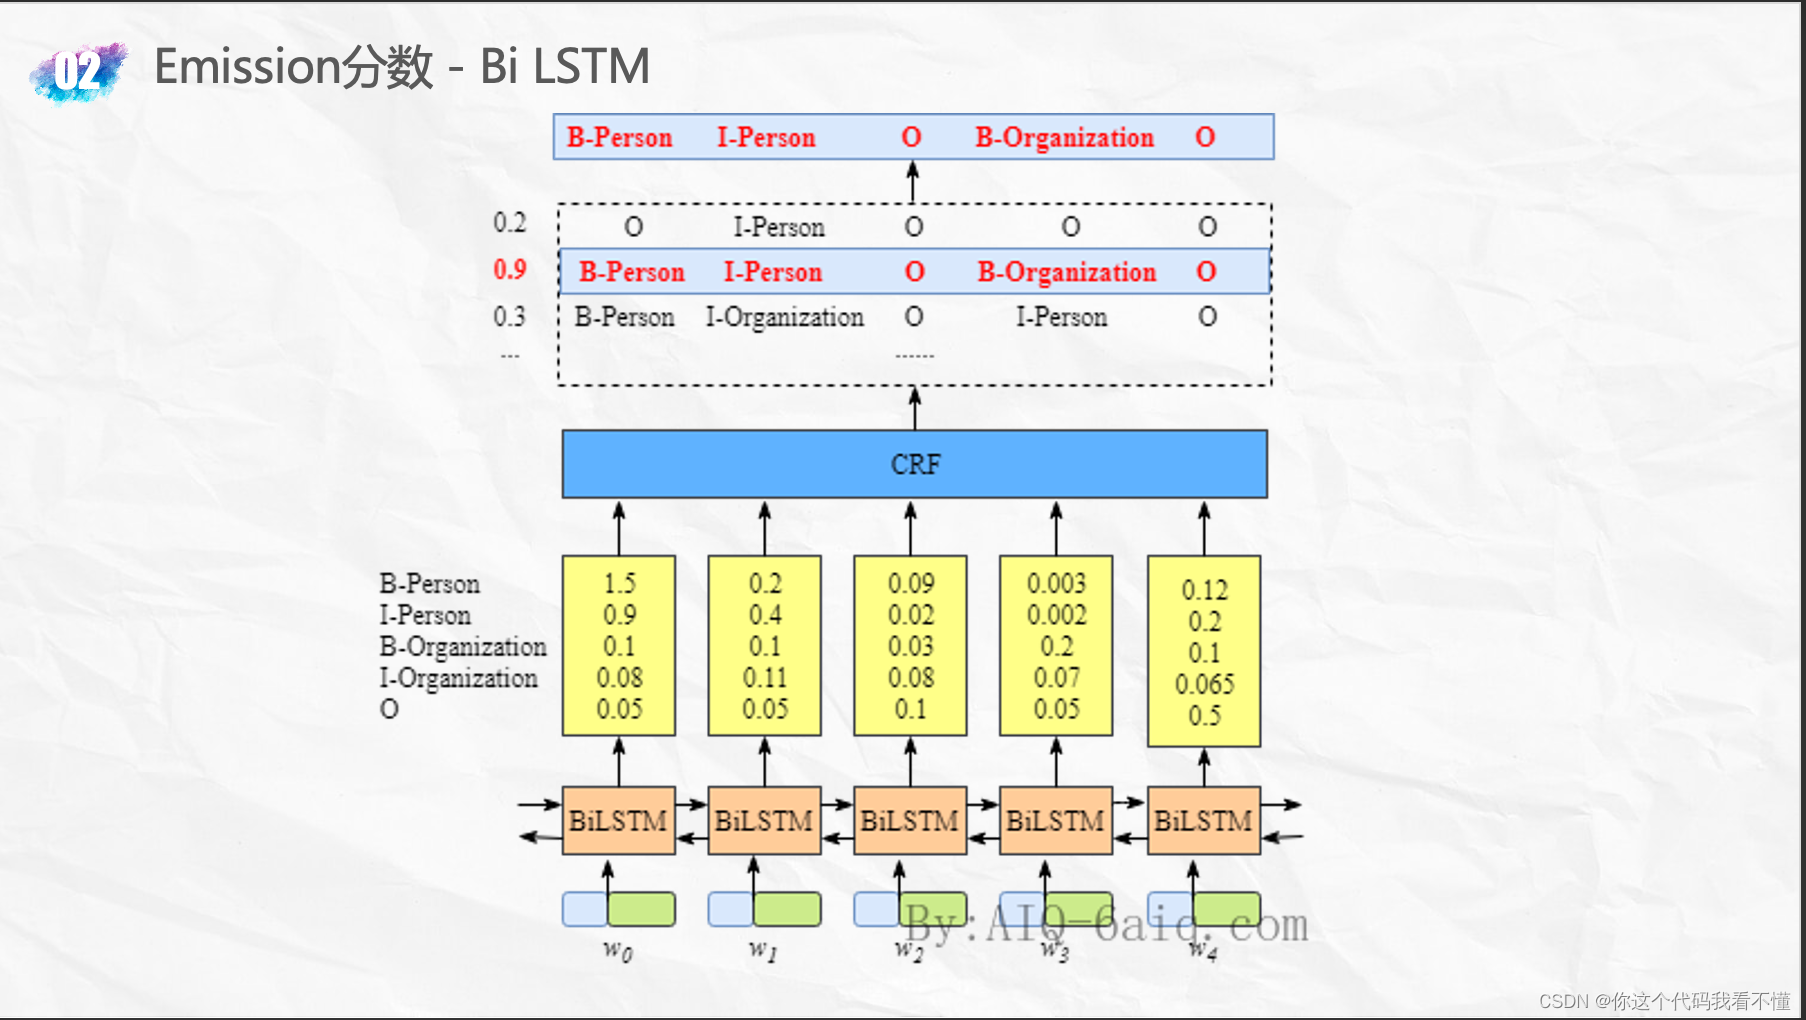
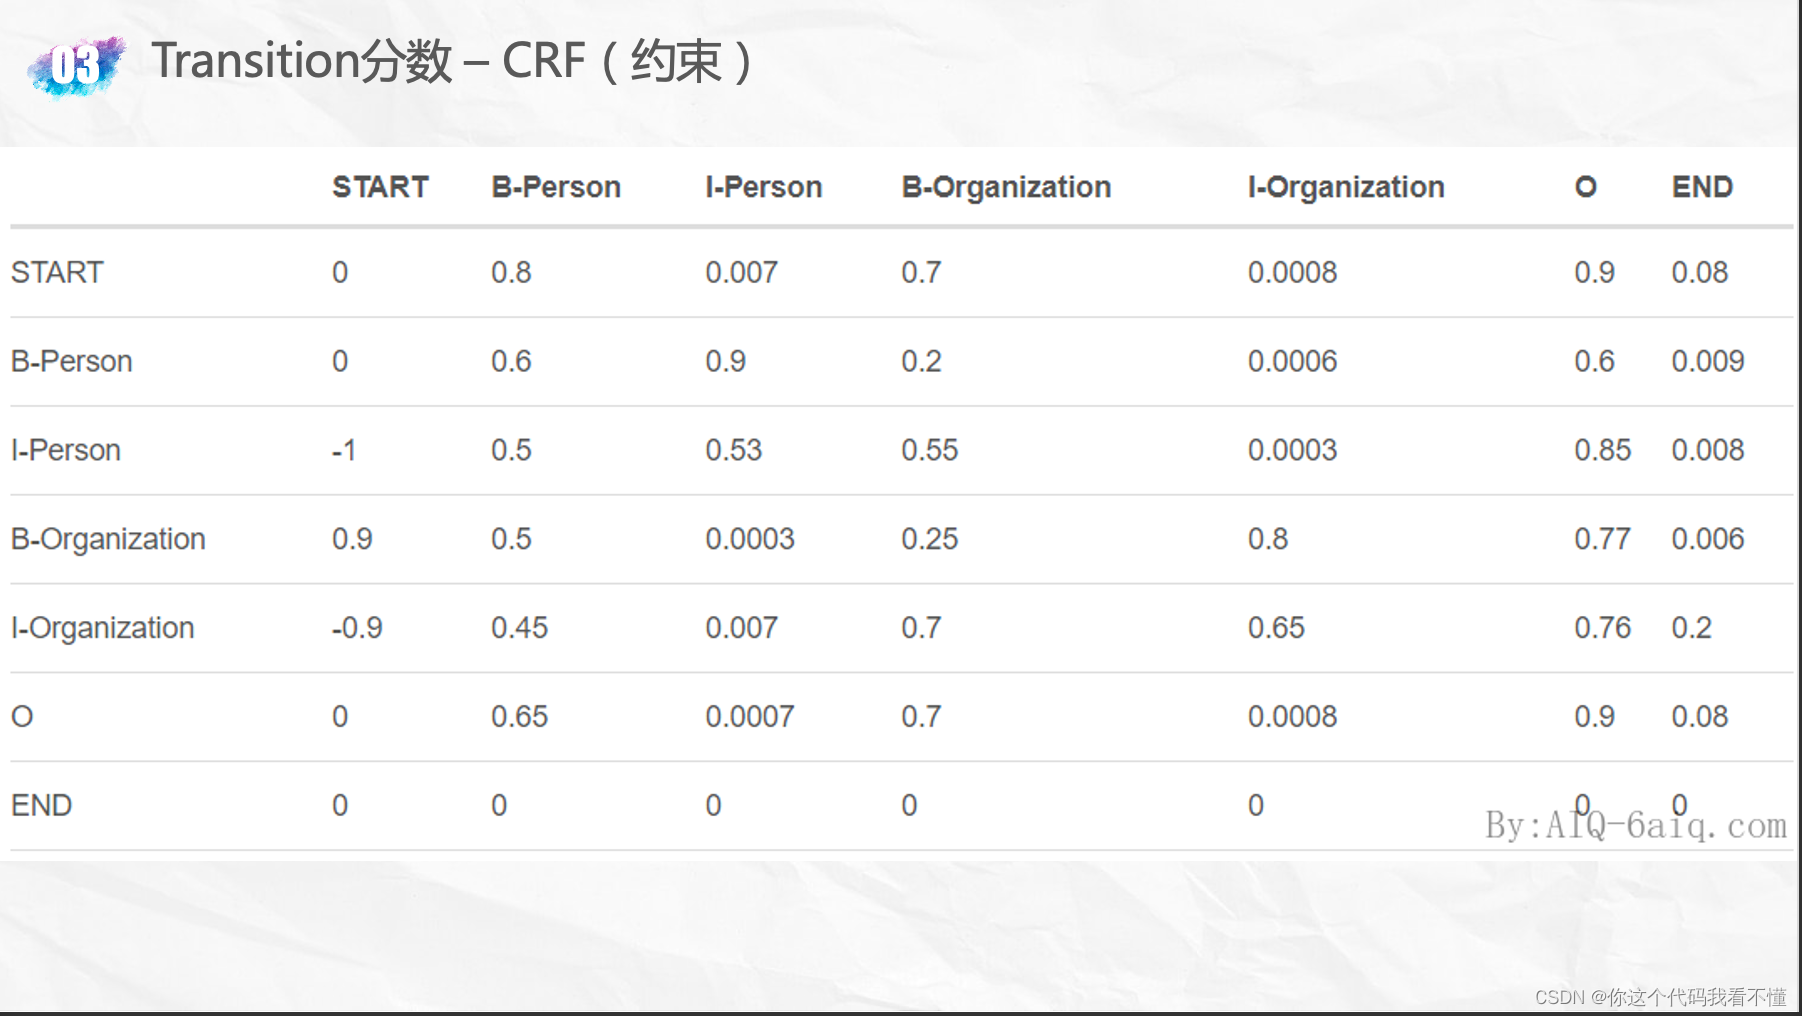
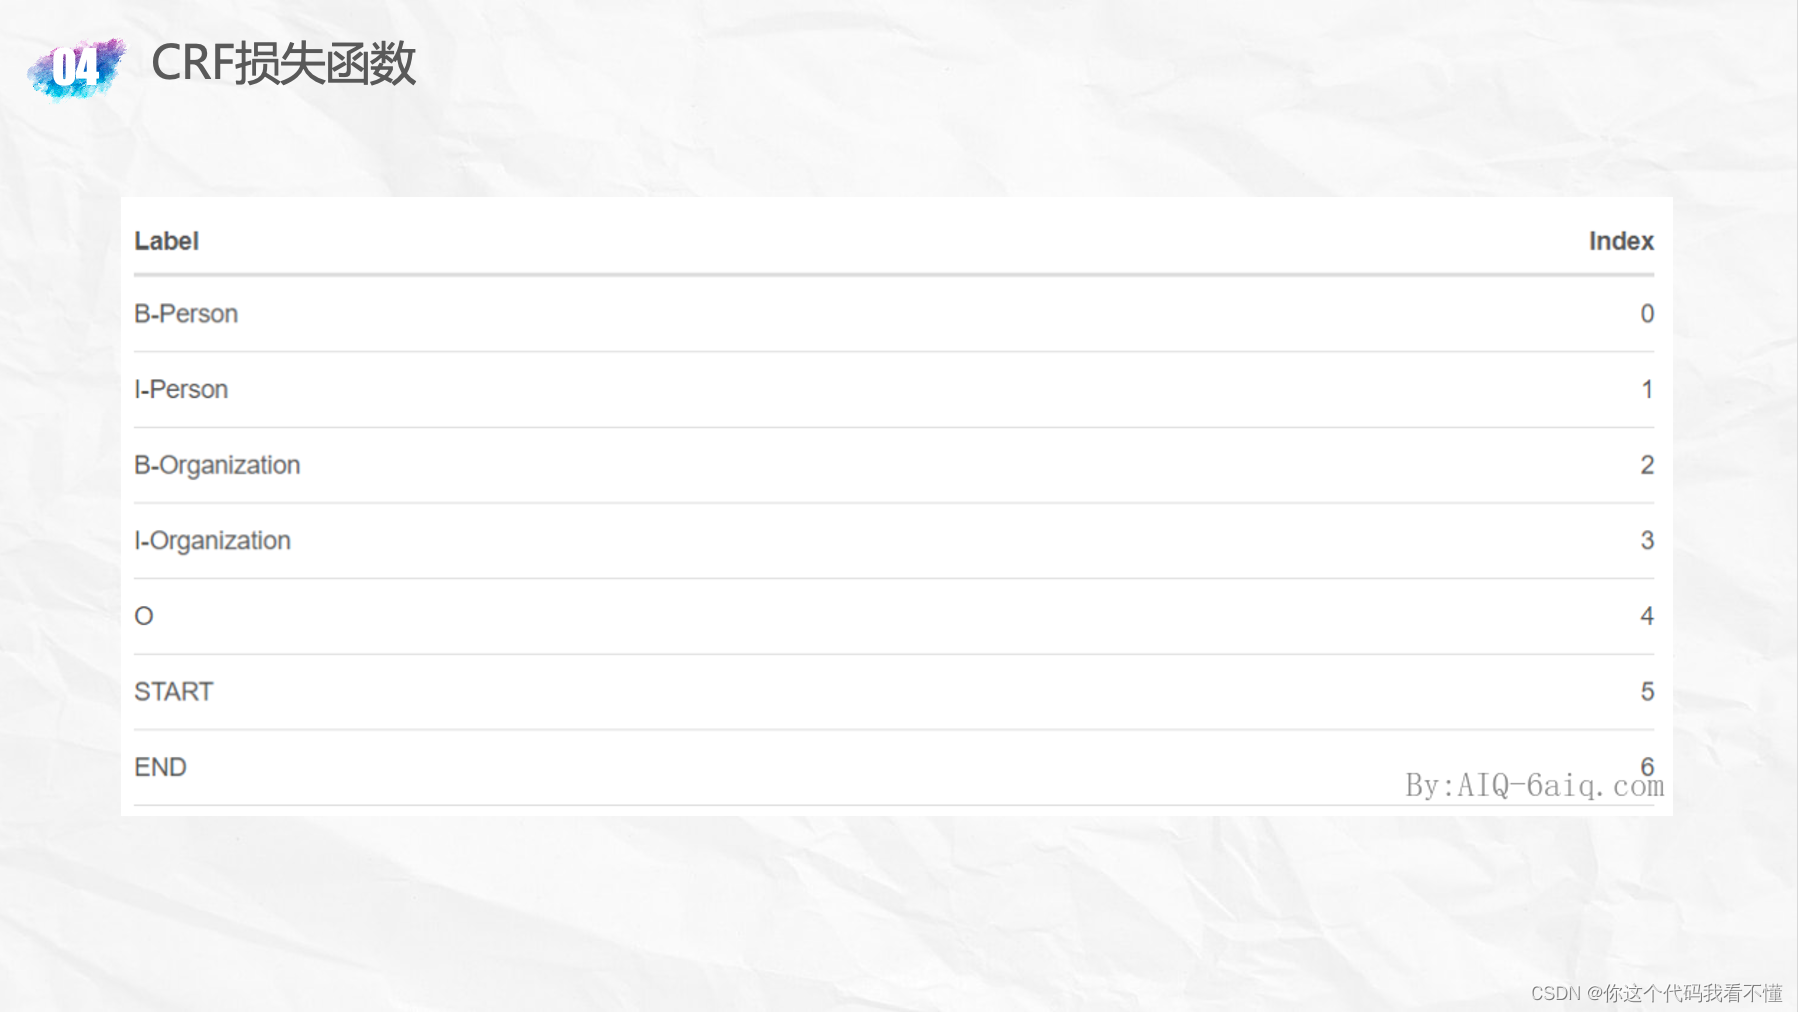
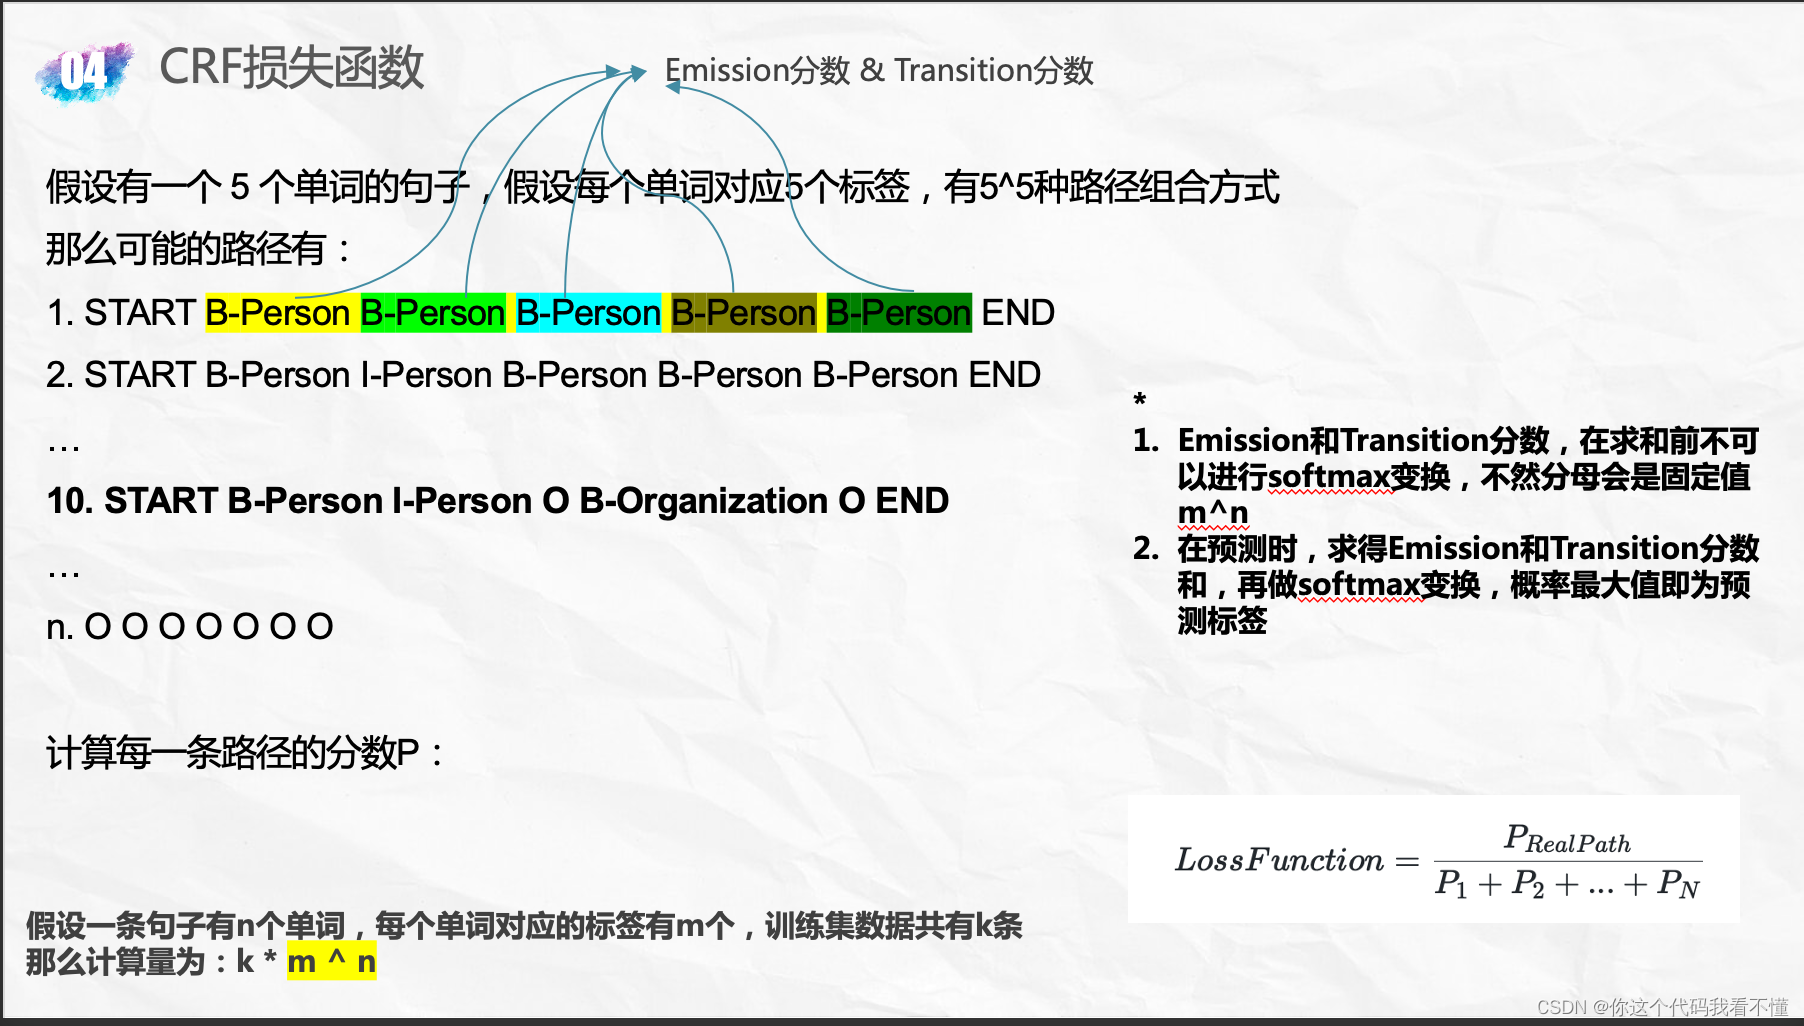
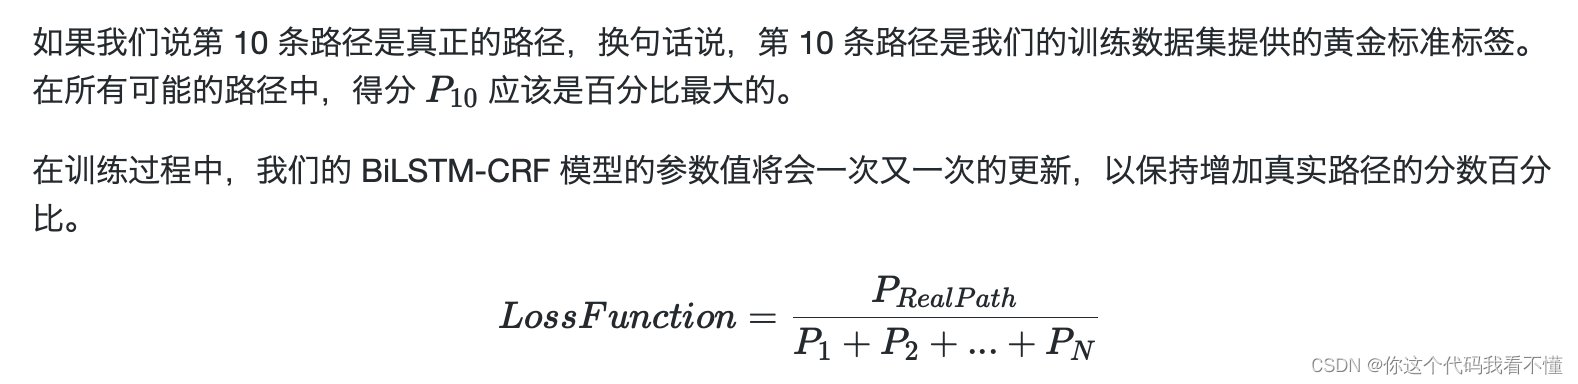
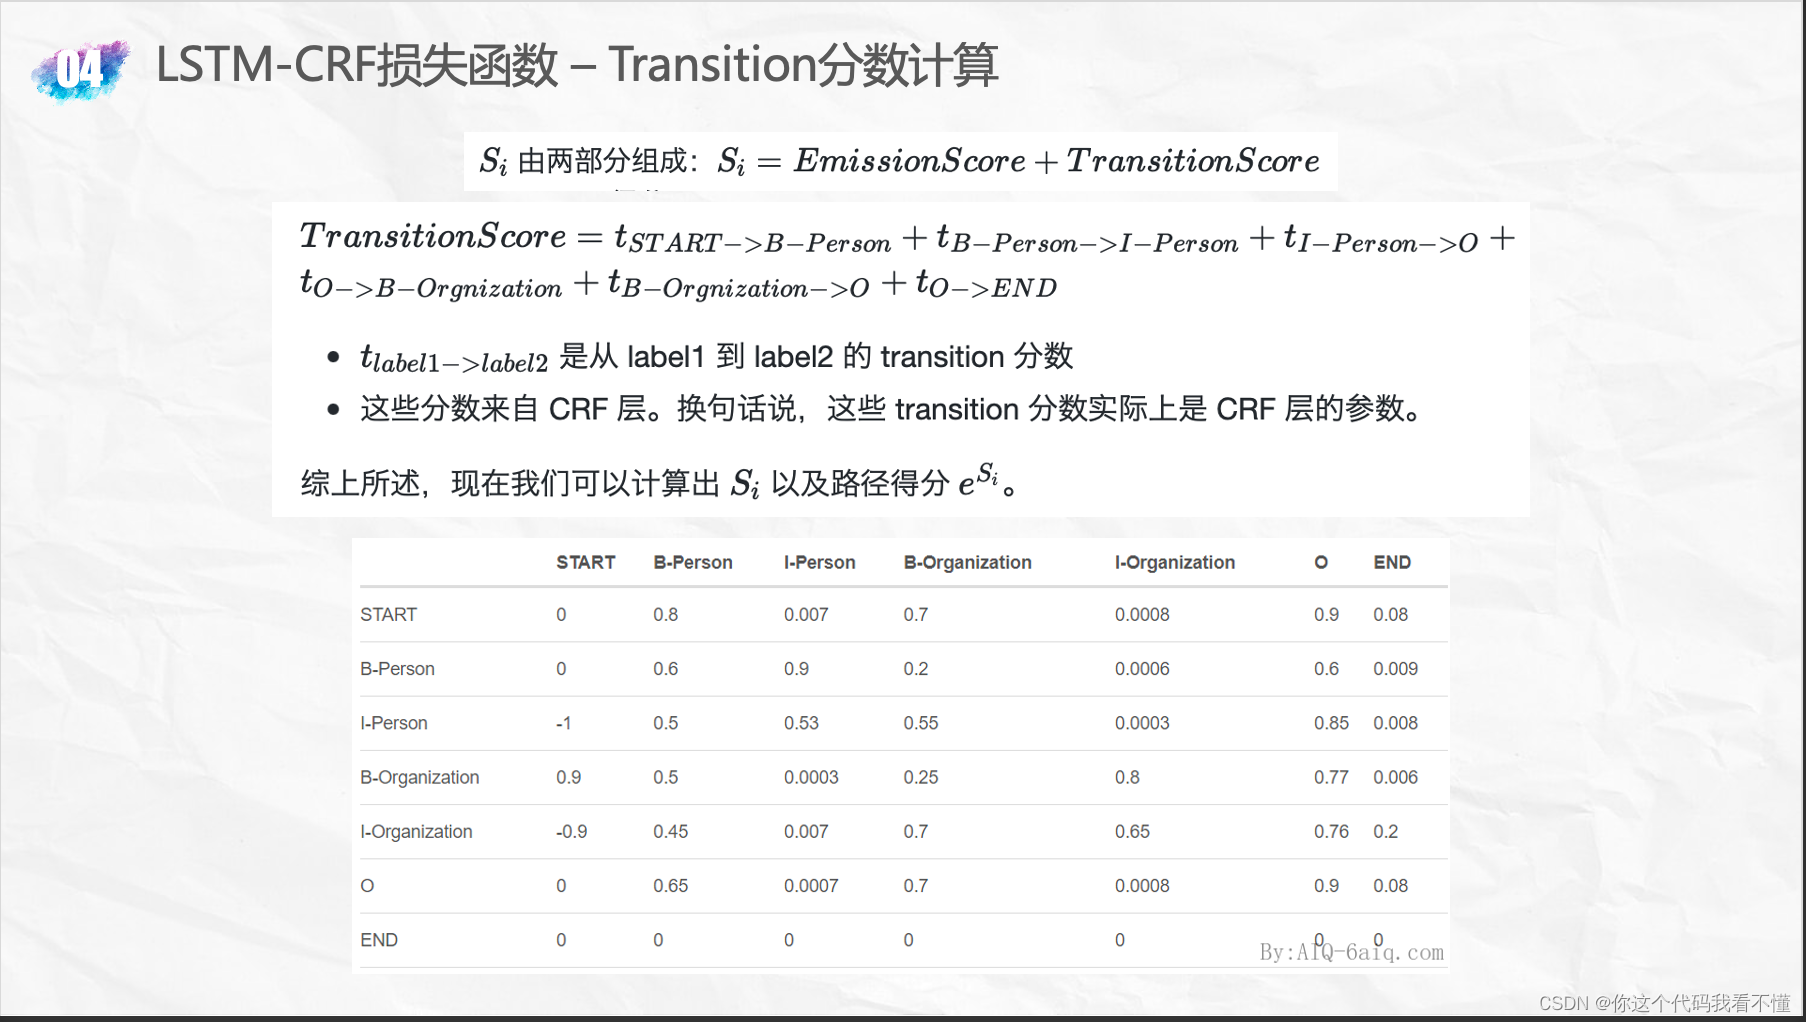
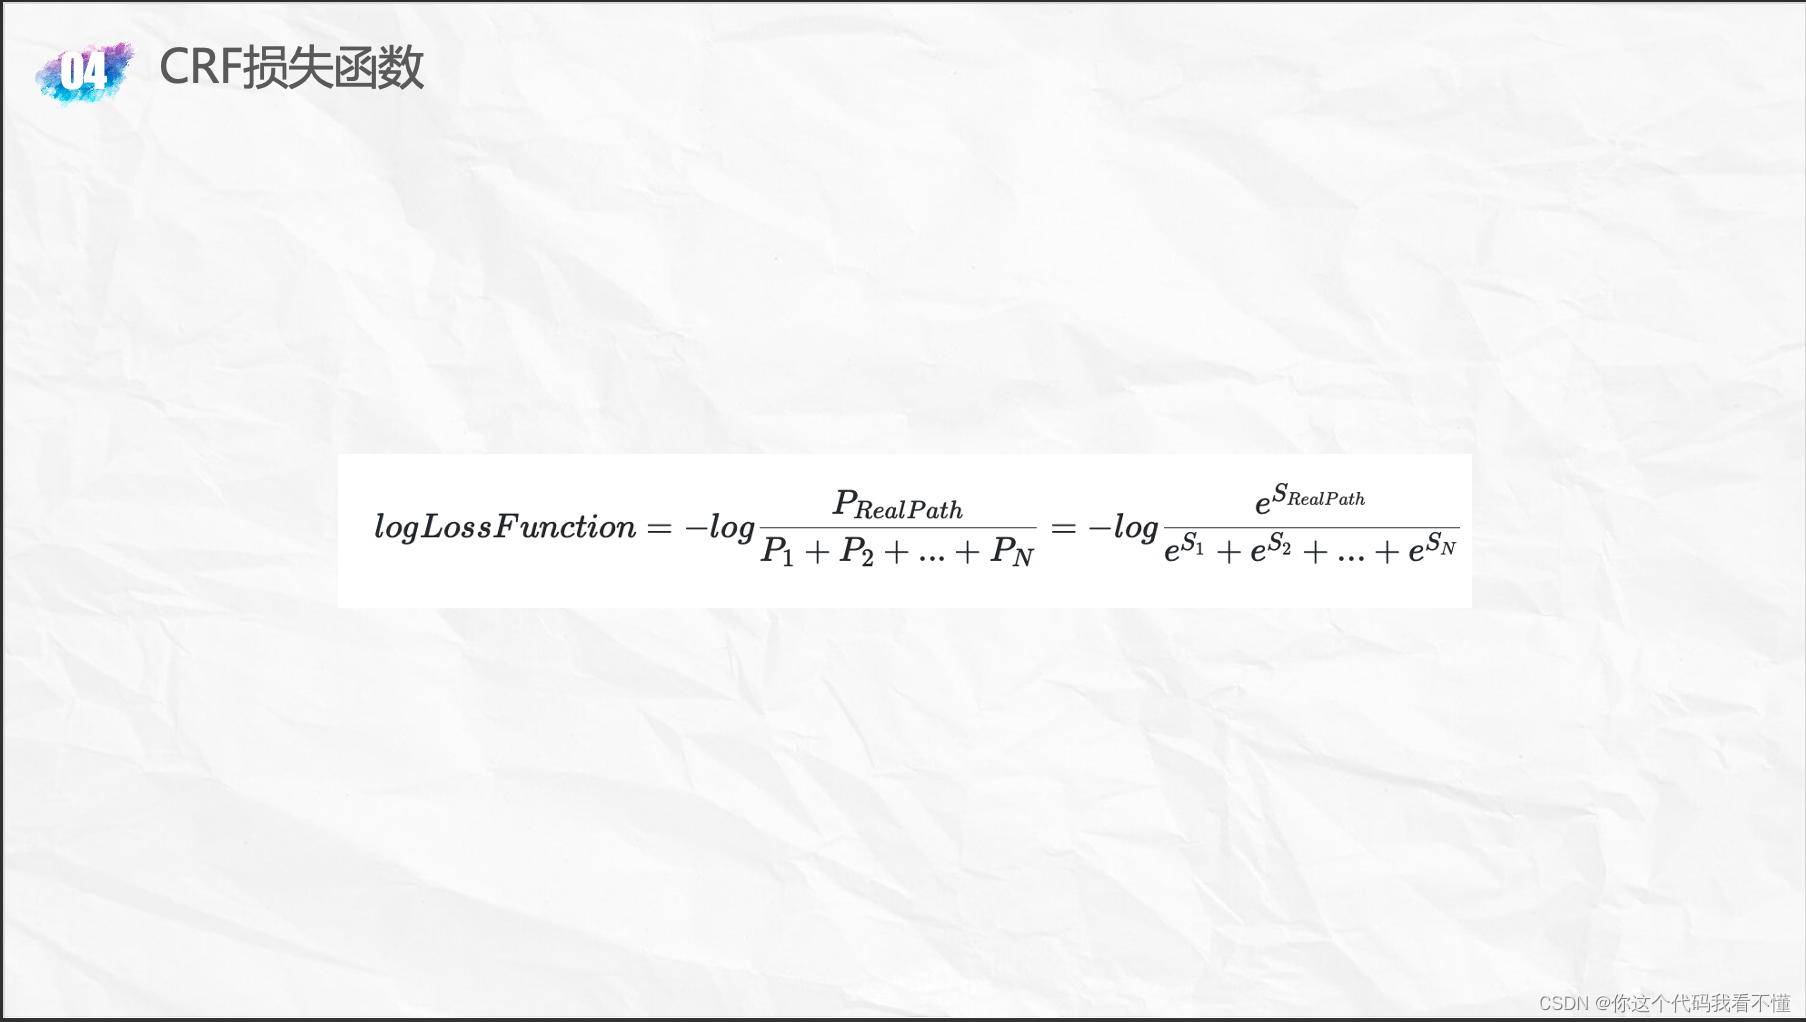
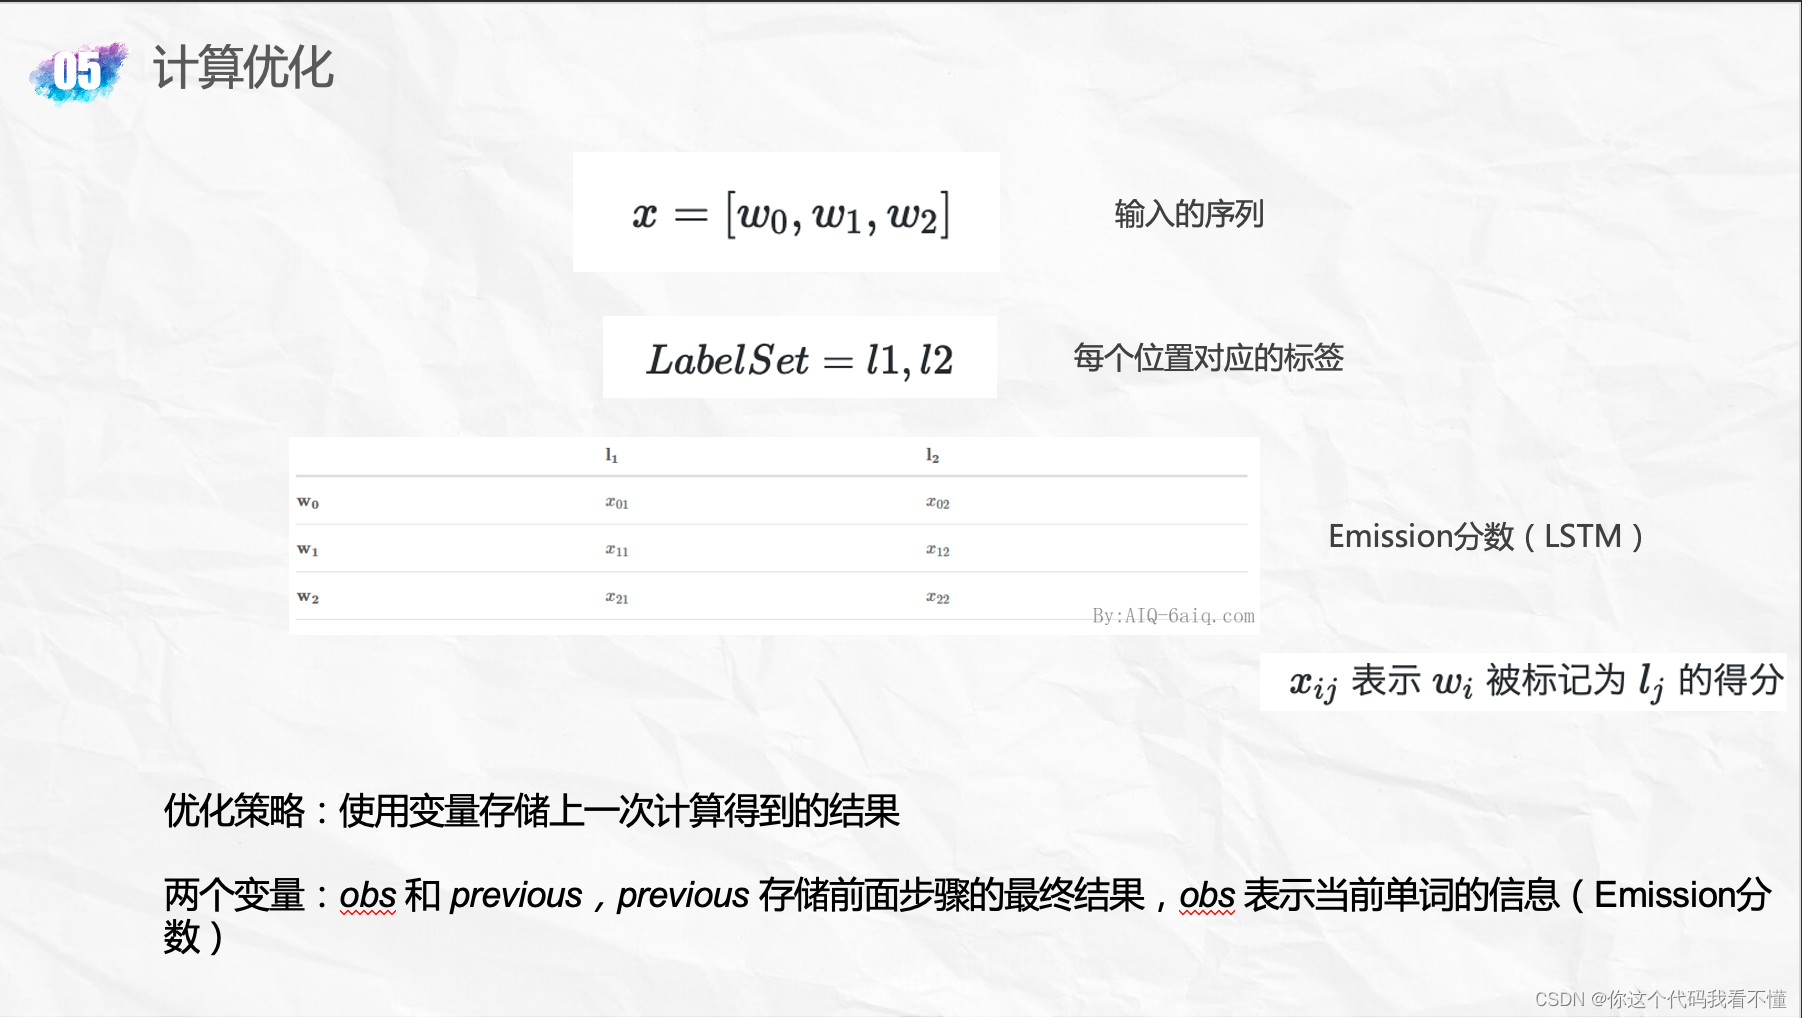
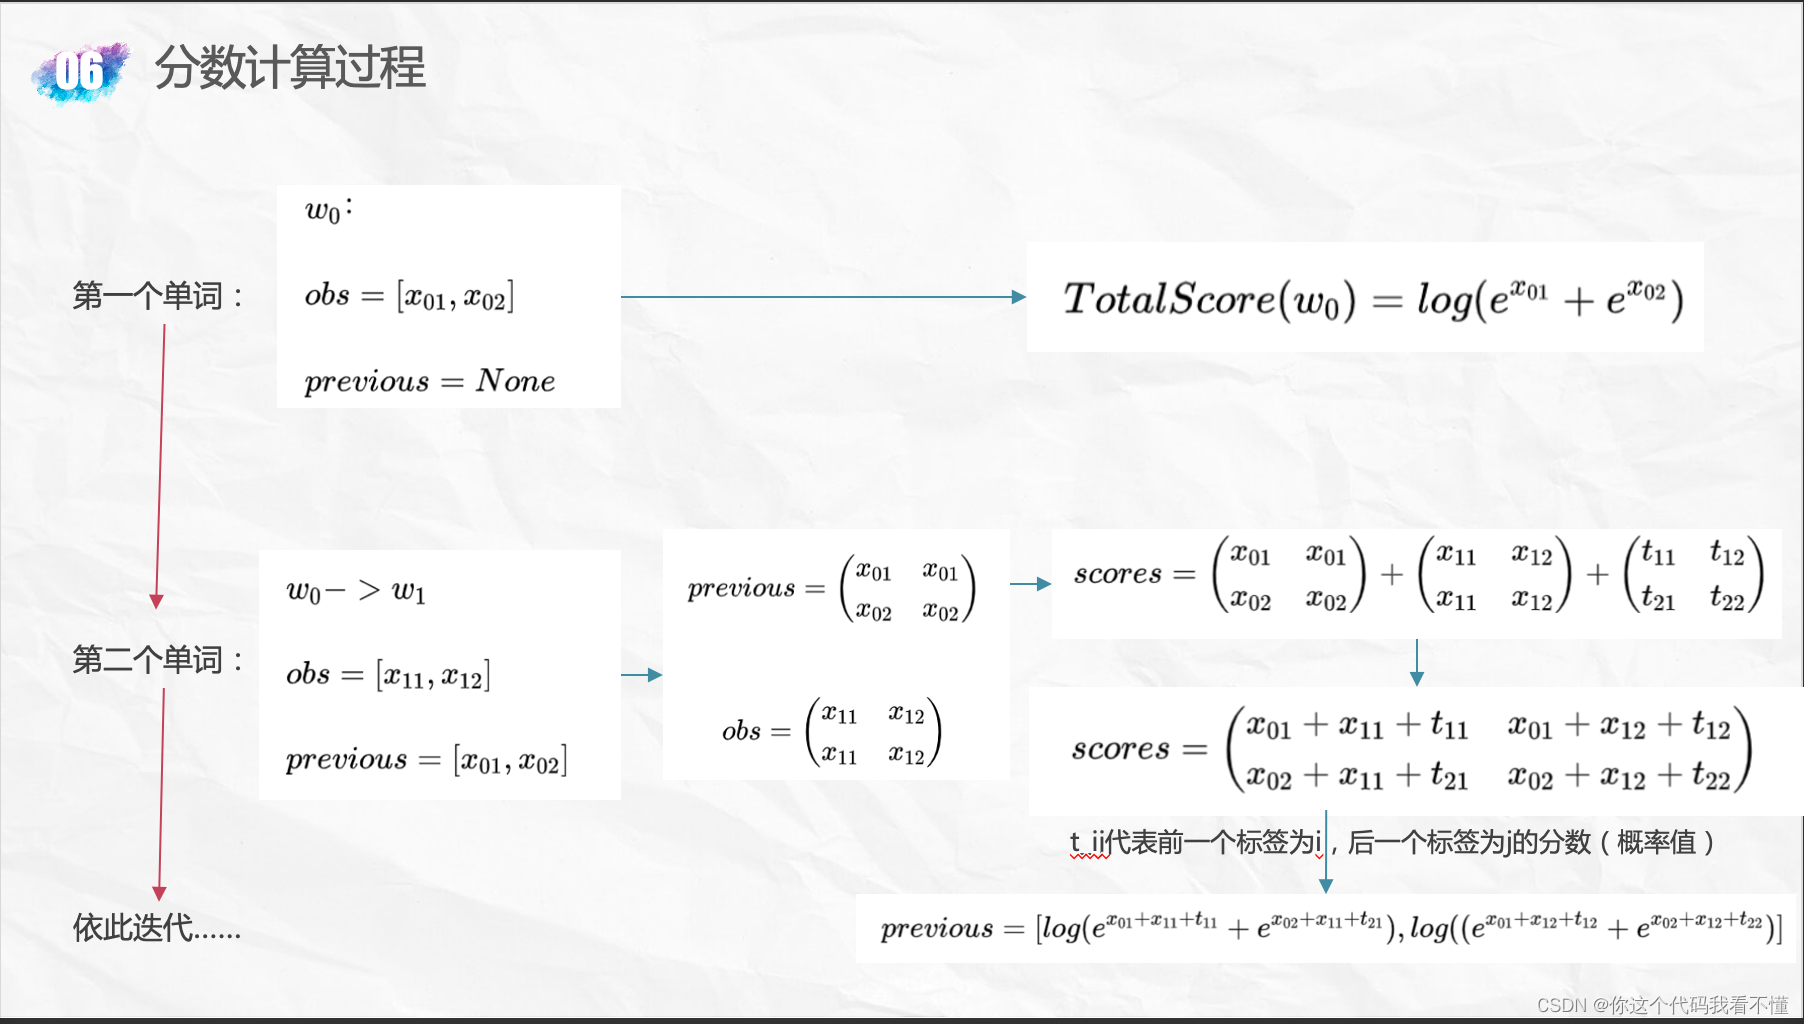
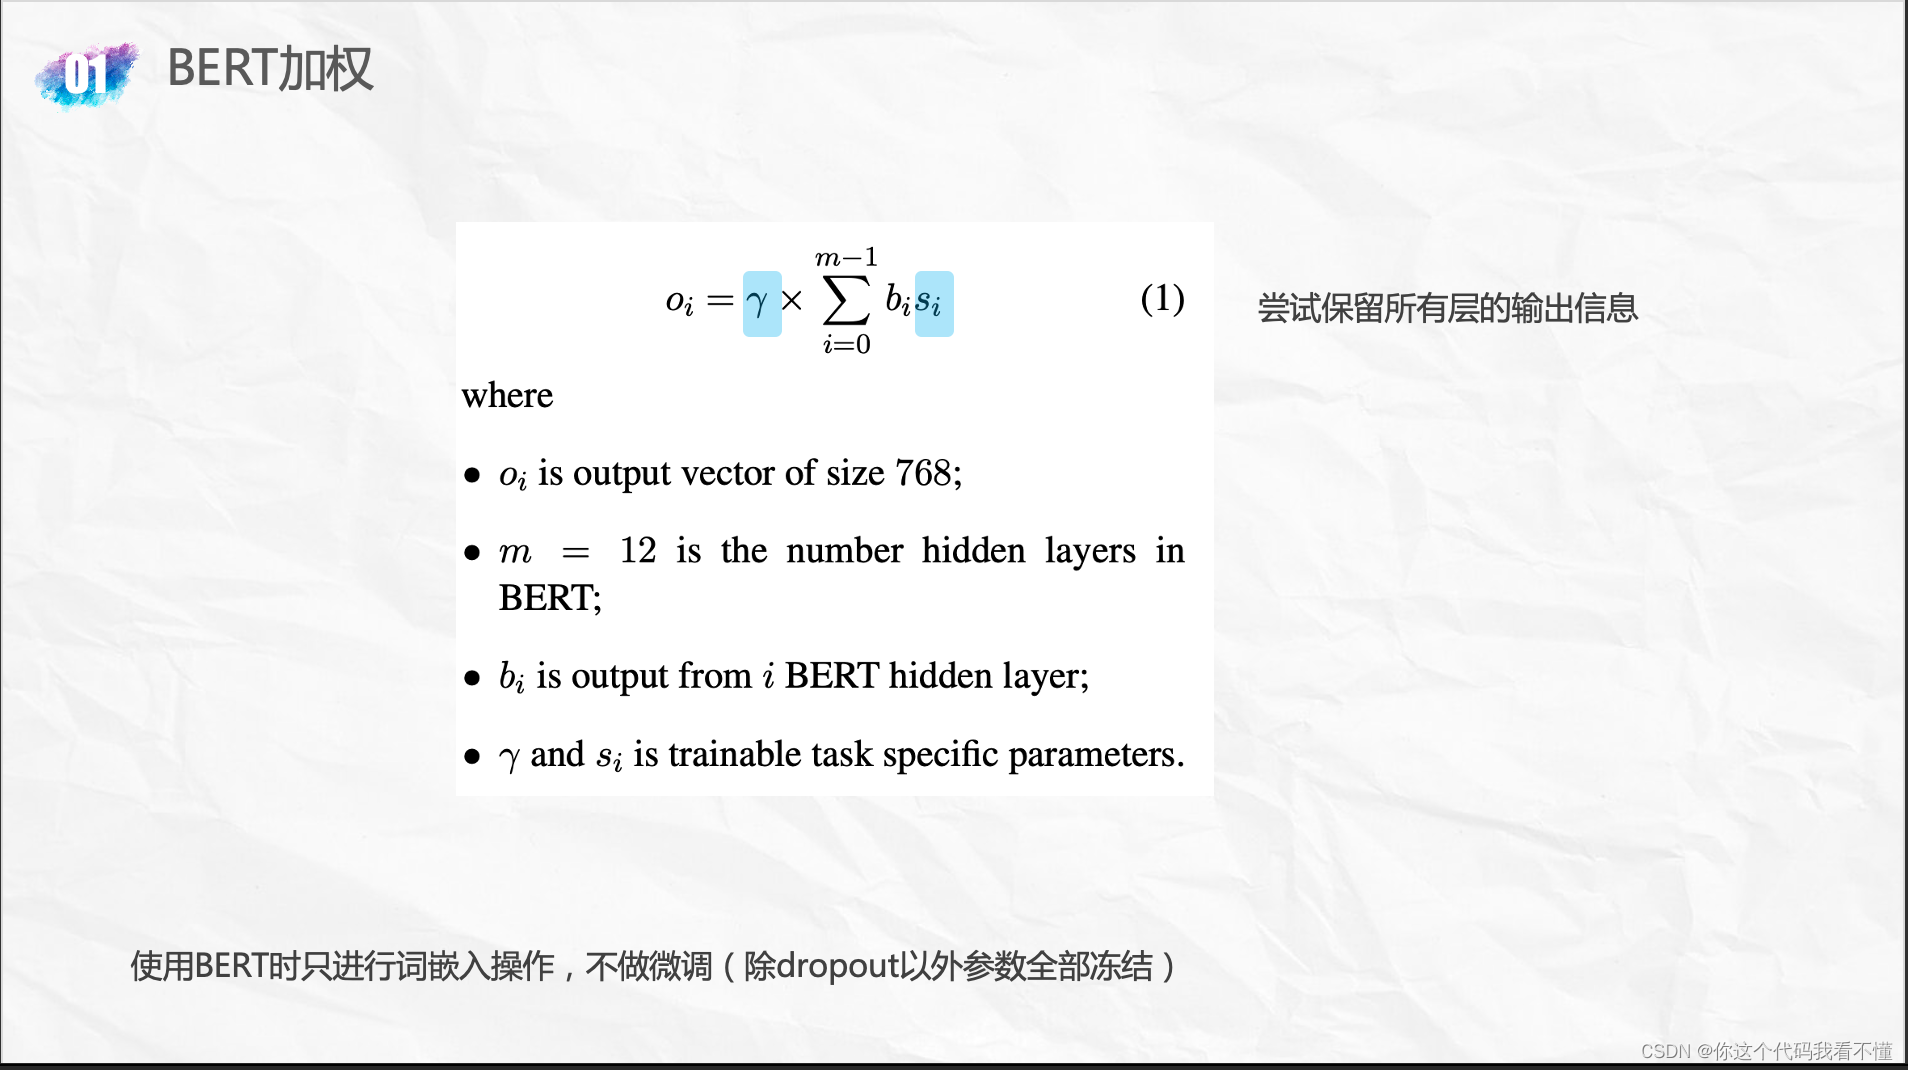
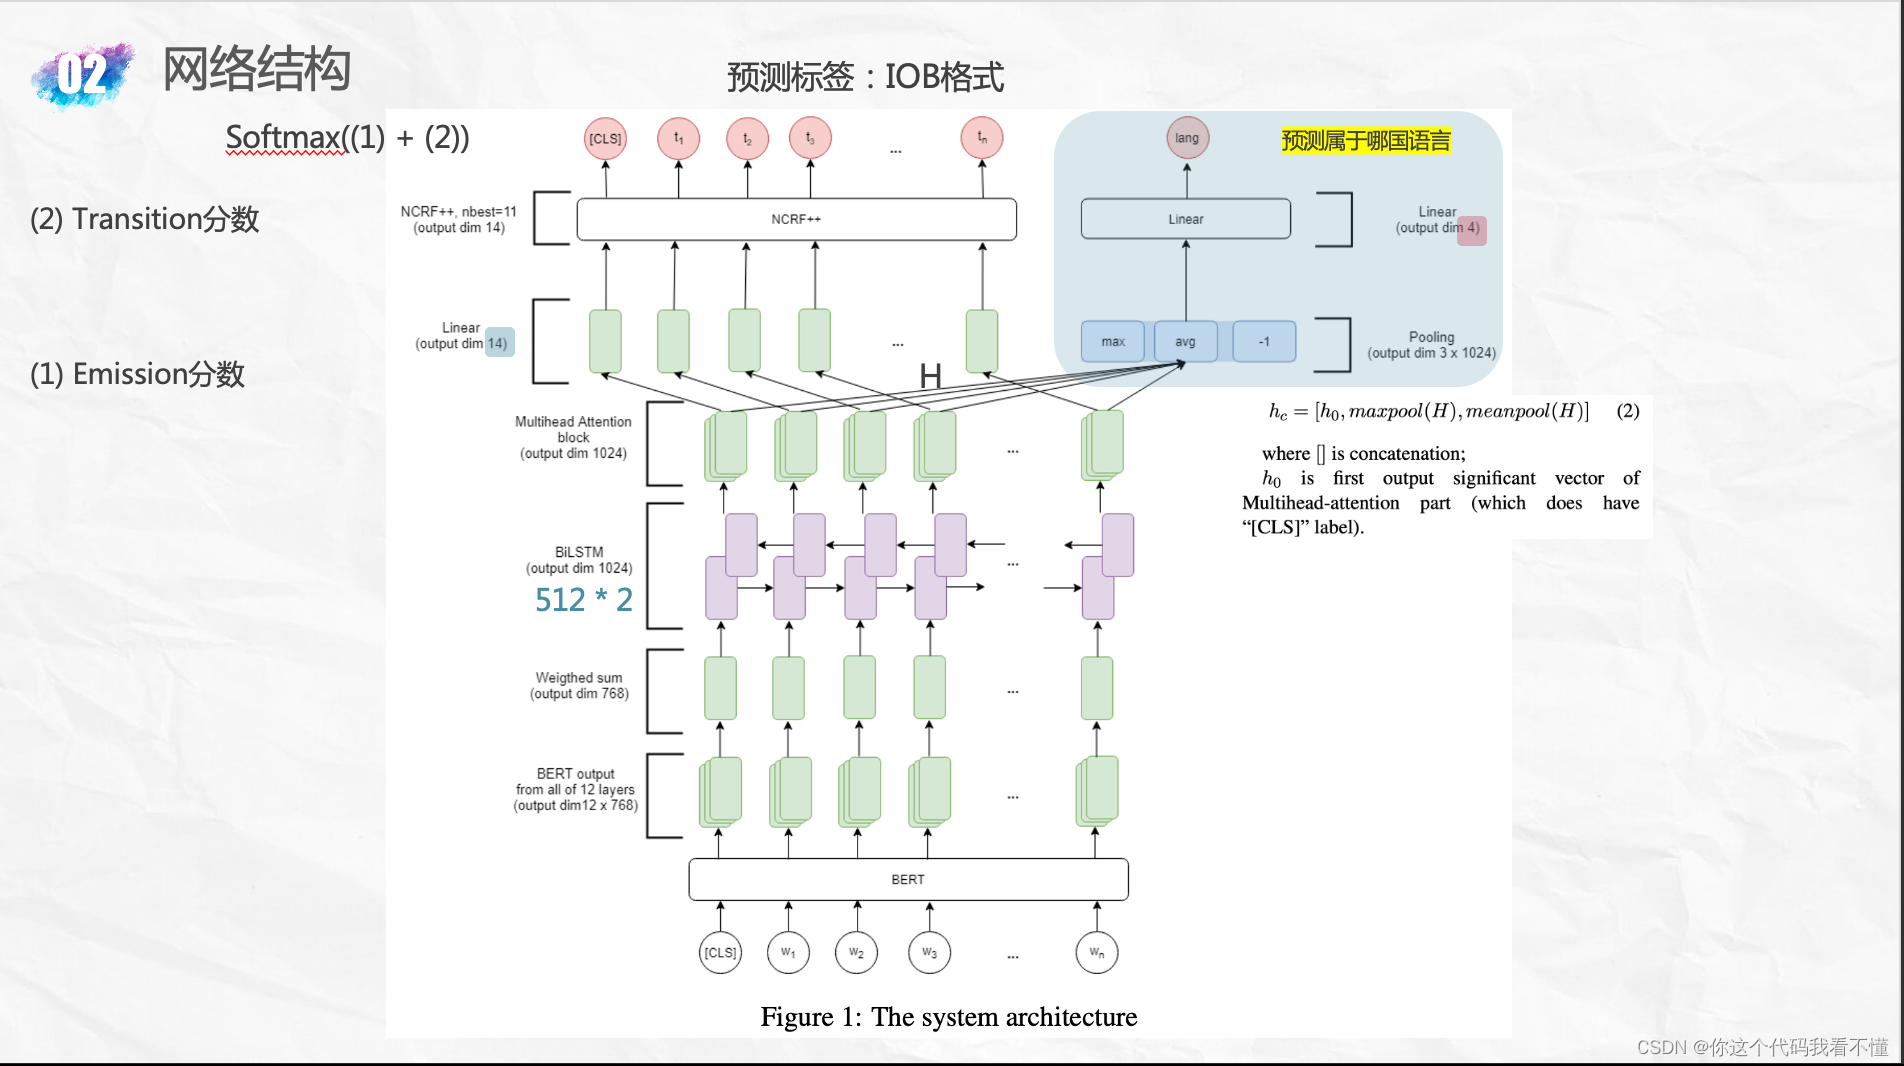
Multilingual Named Entity Recognition Using Pretrained Embeddings, Attention Mechanism and NCRF
- 非极大值抑制
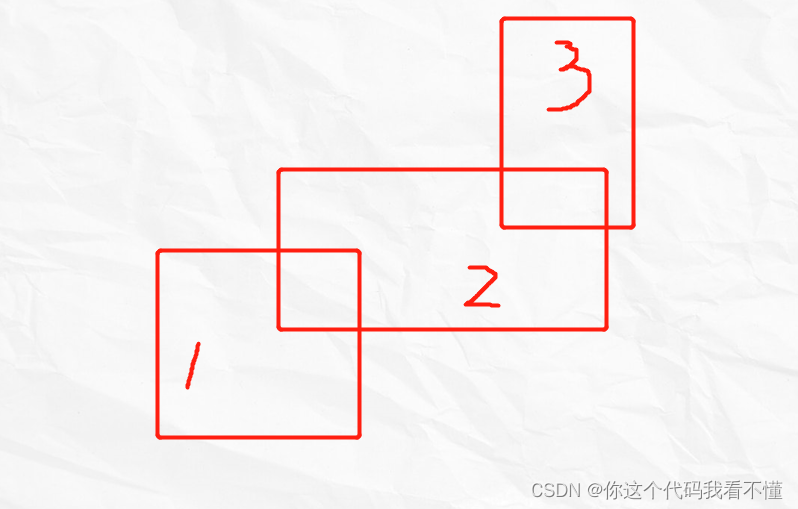
bounding box的选取顺序对结果会产生影响。
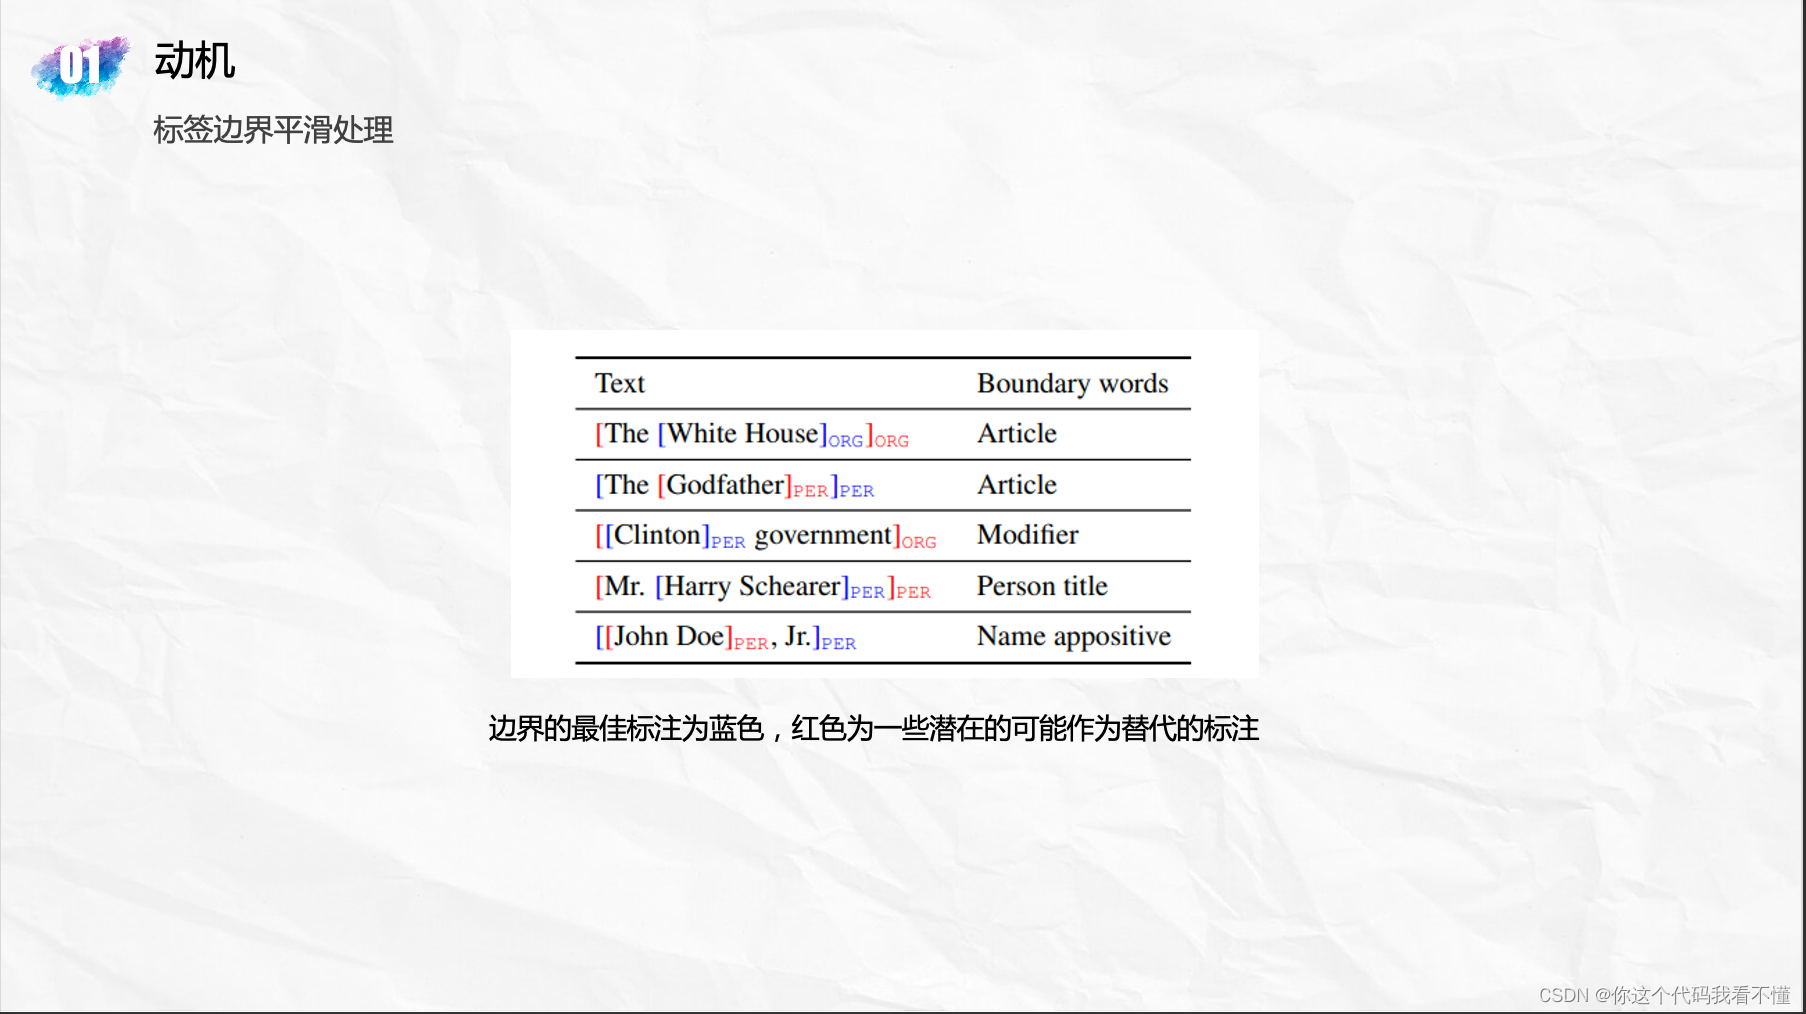
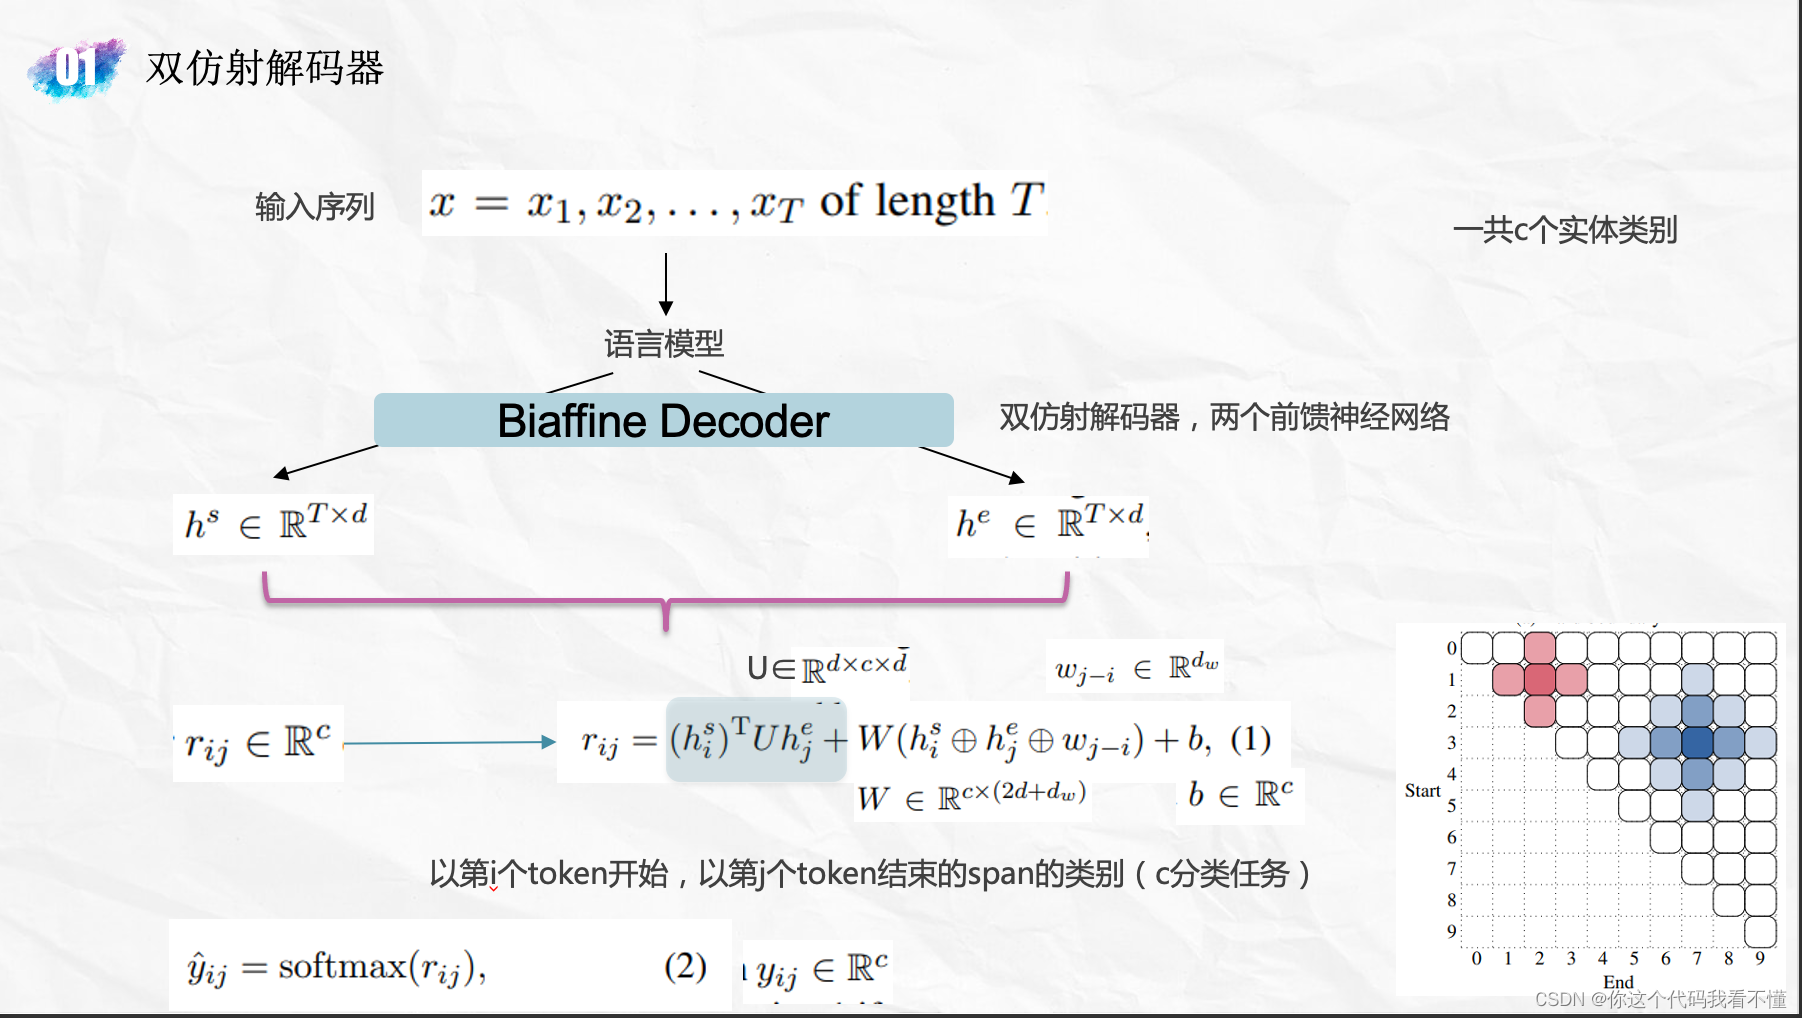
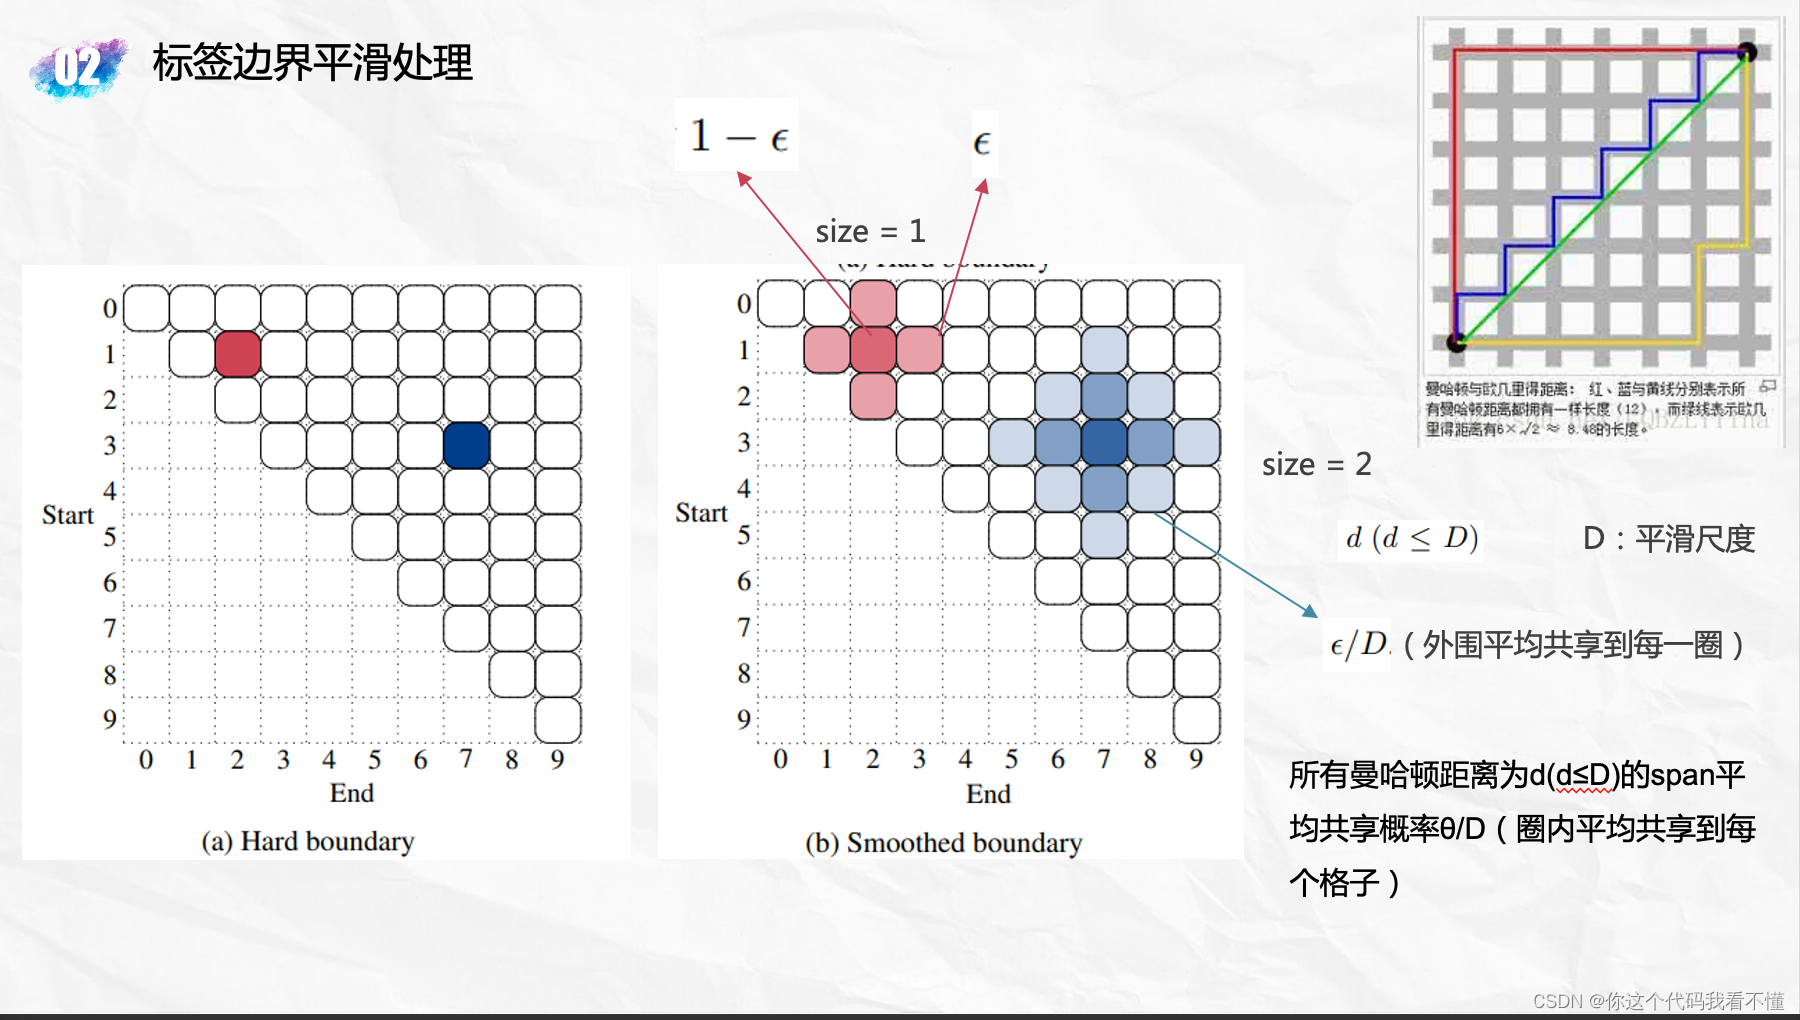
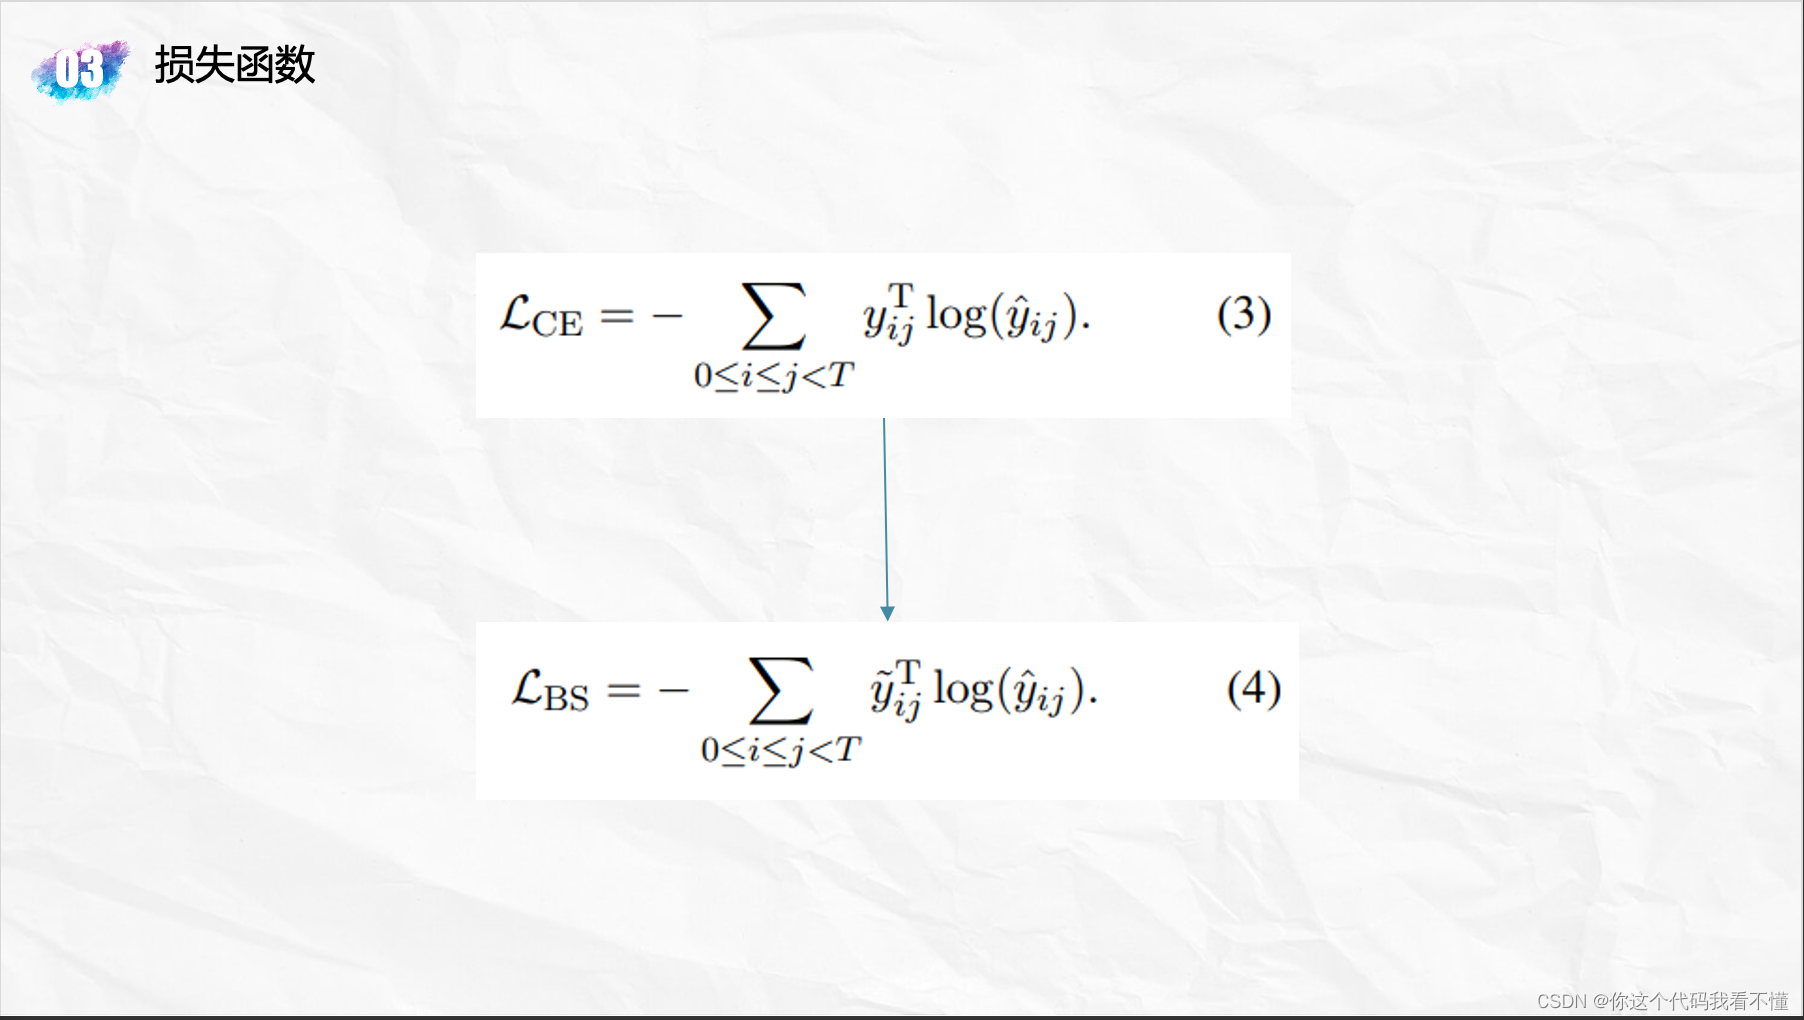
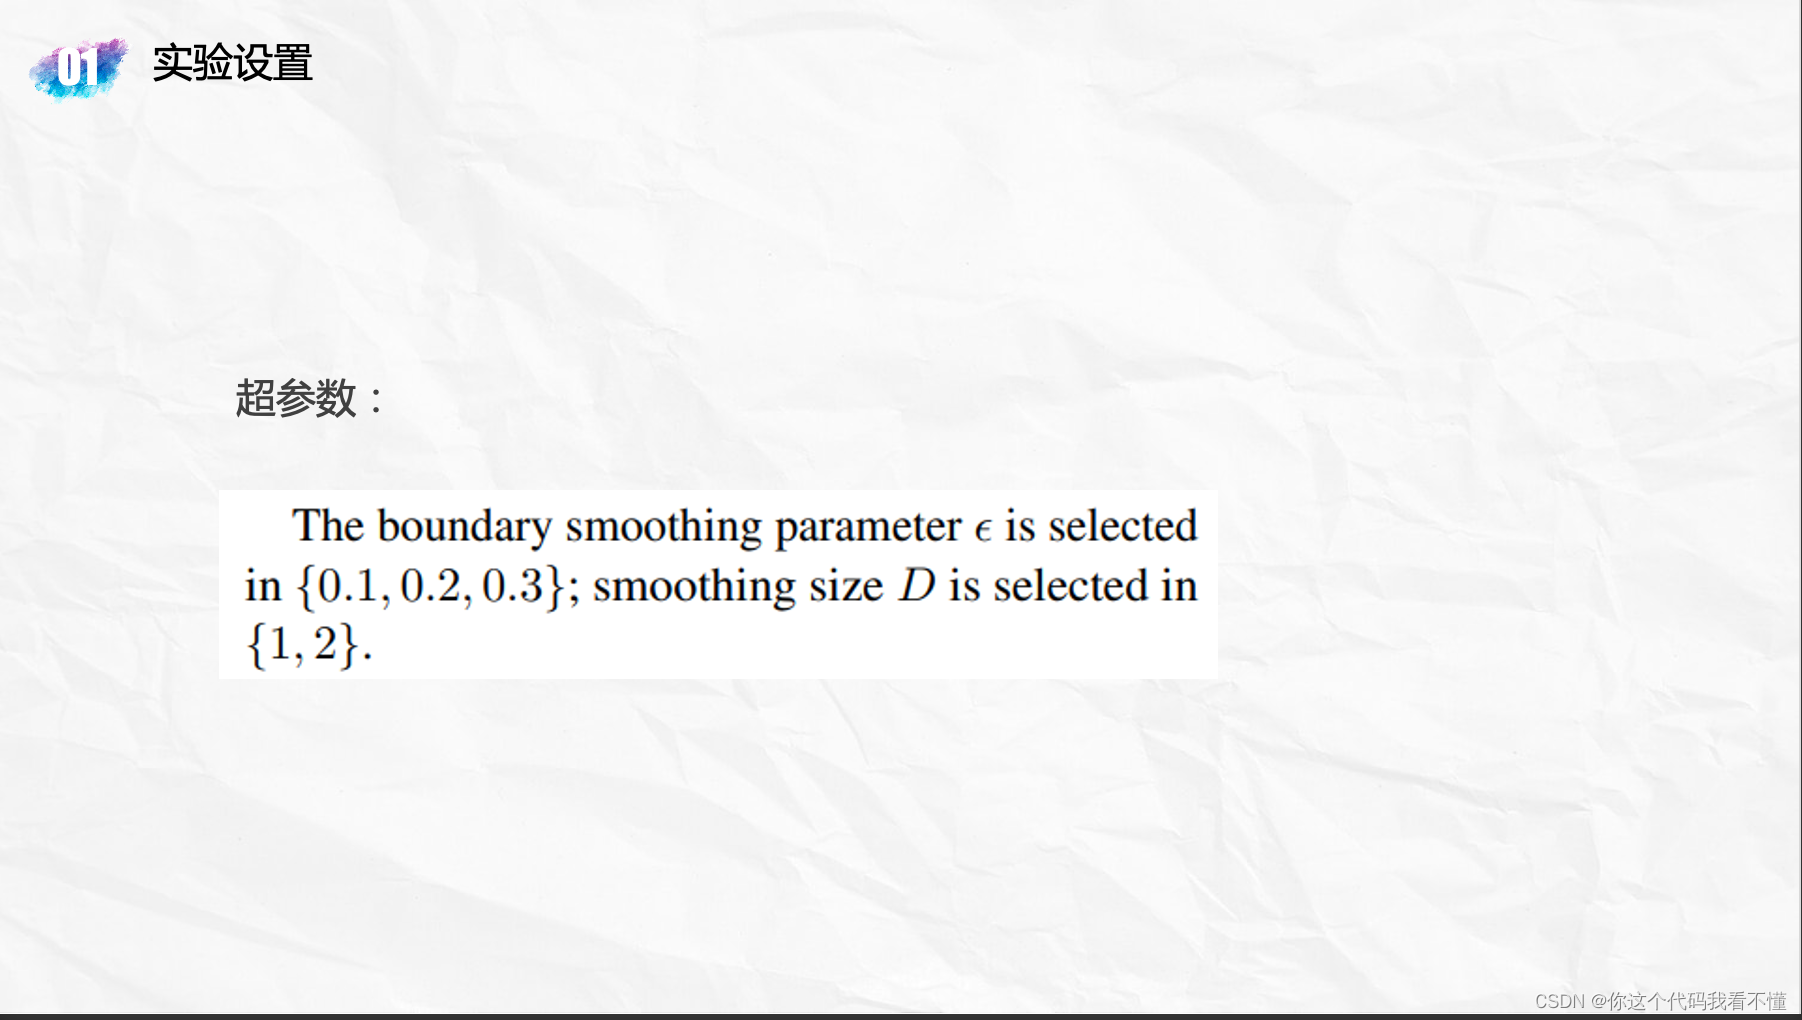
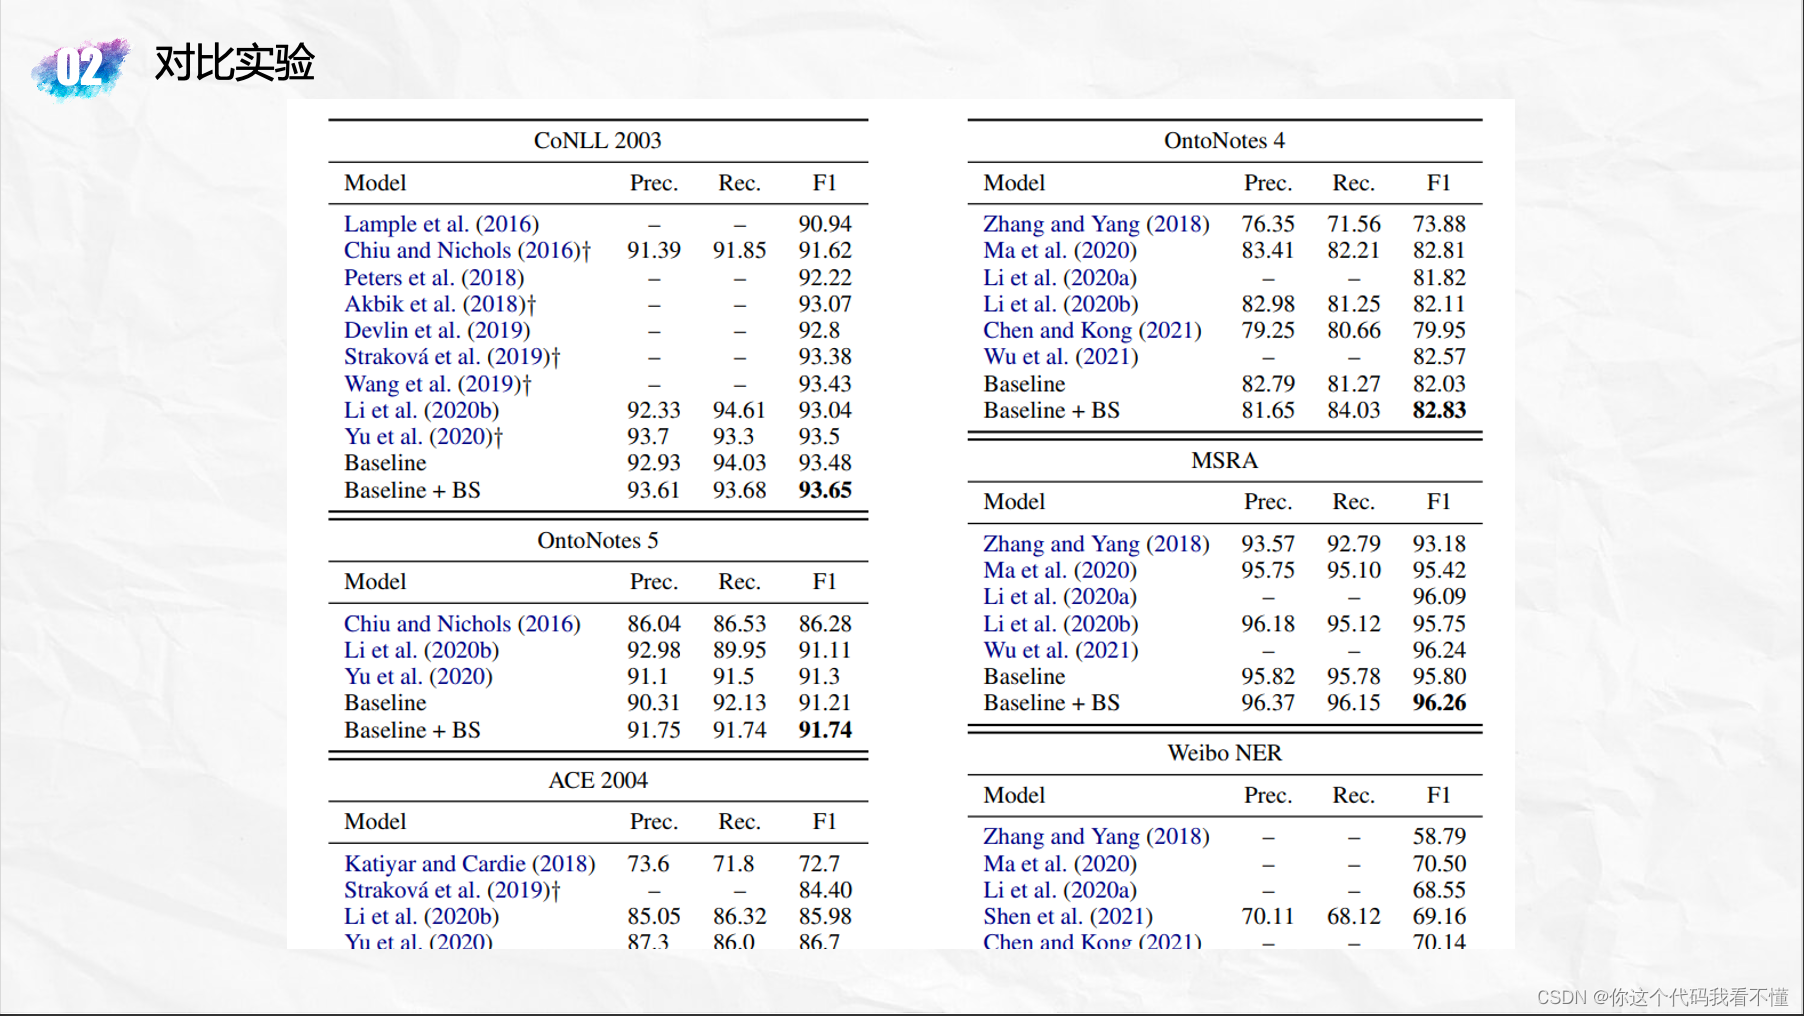
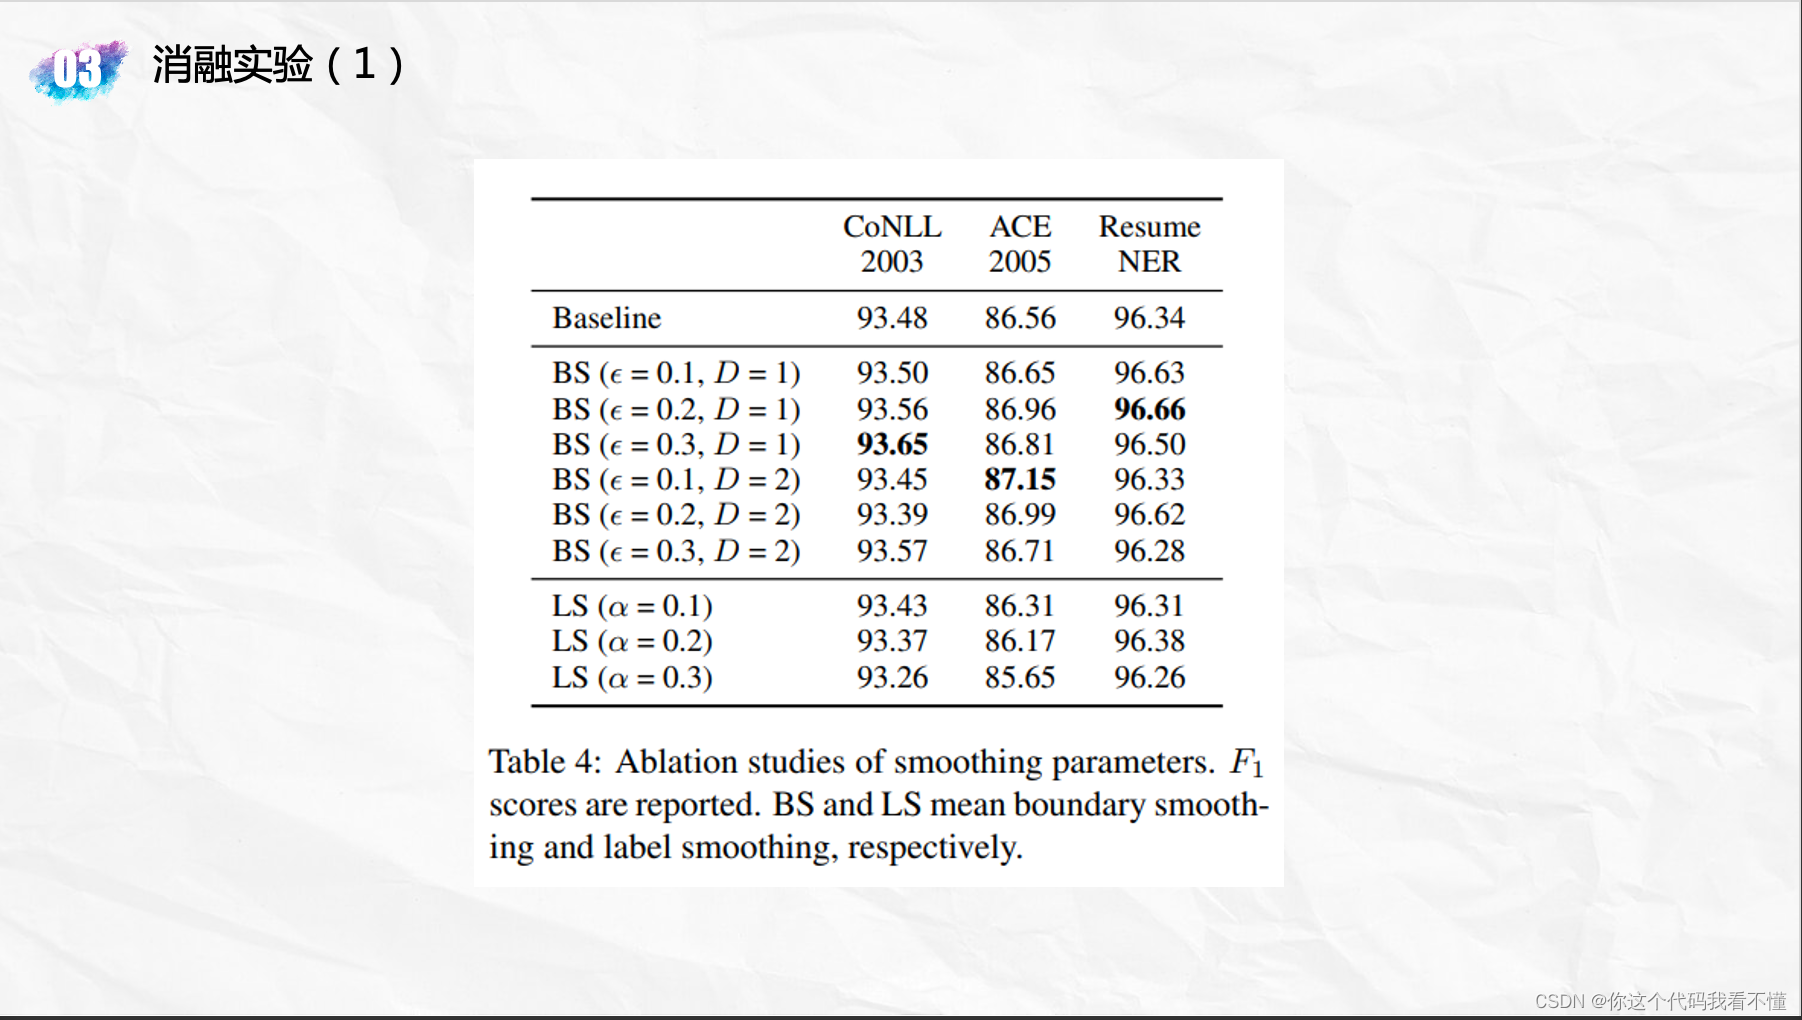
Boundary Smoothing for Named Entity Recognition
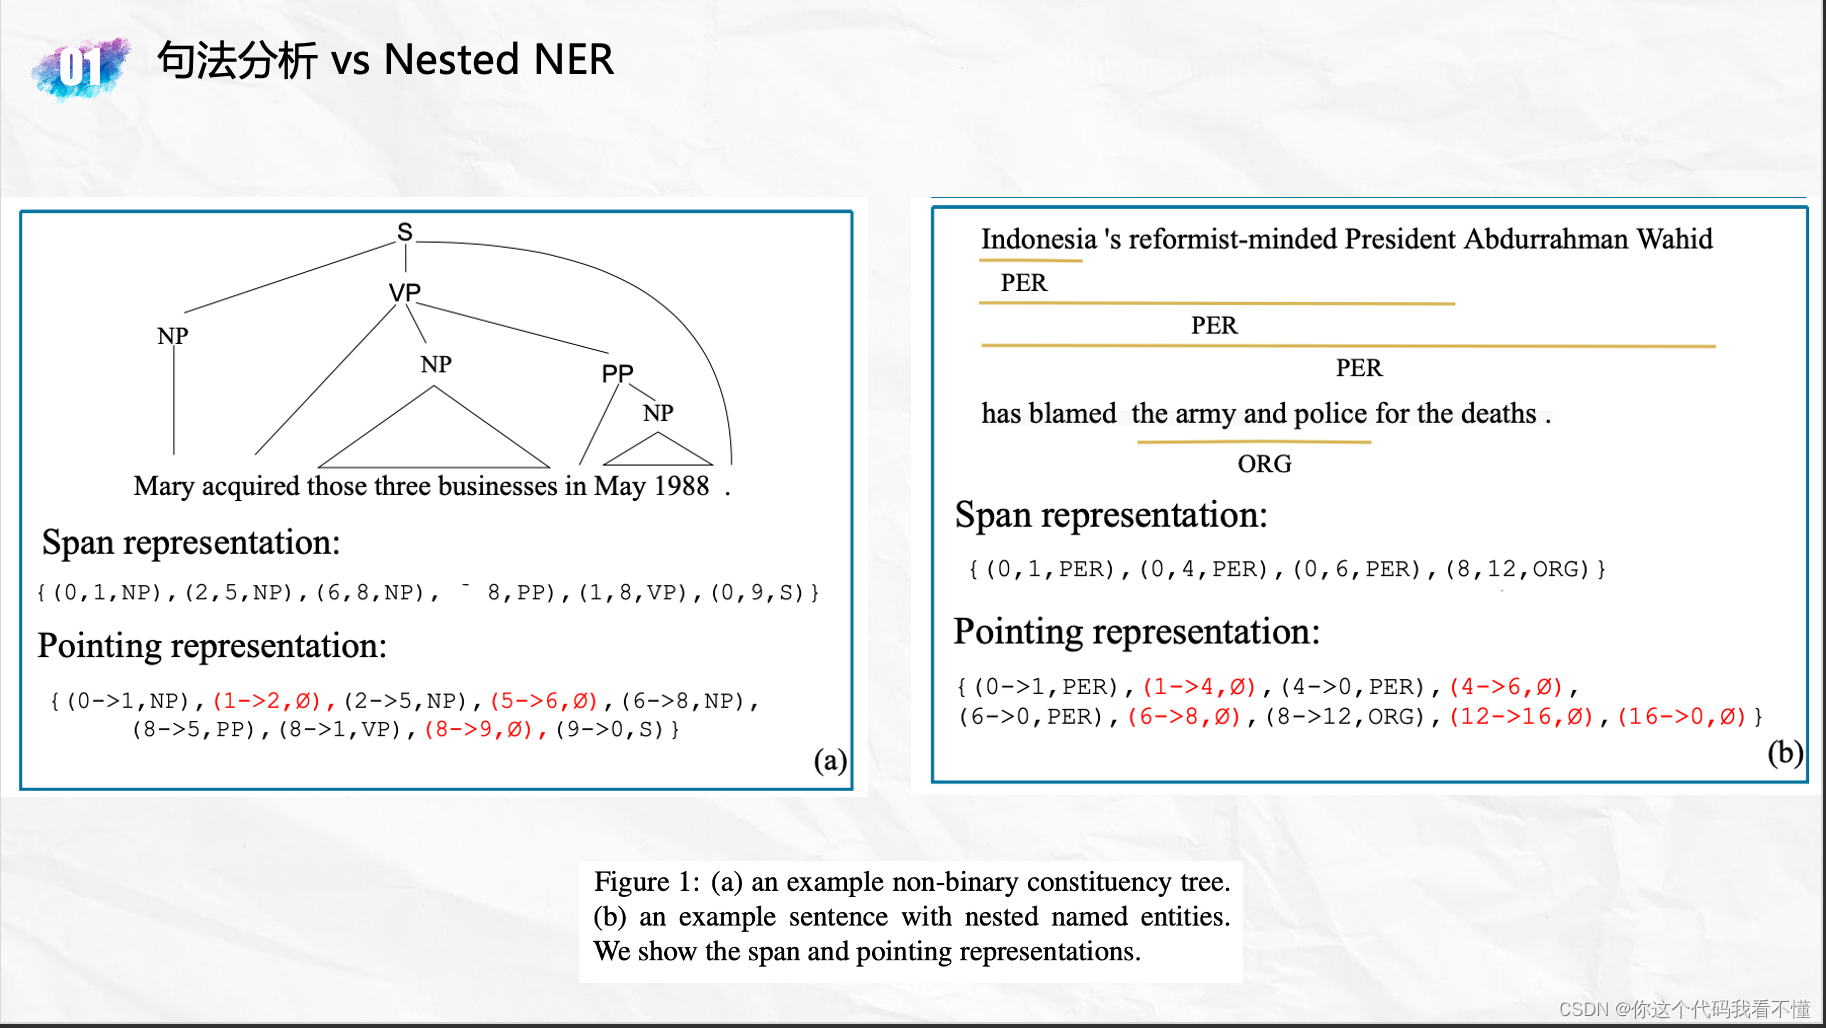
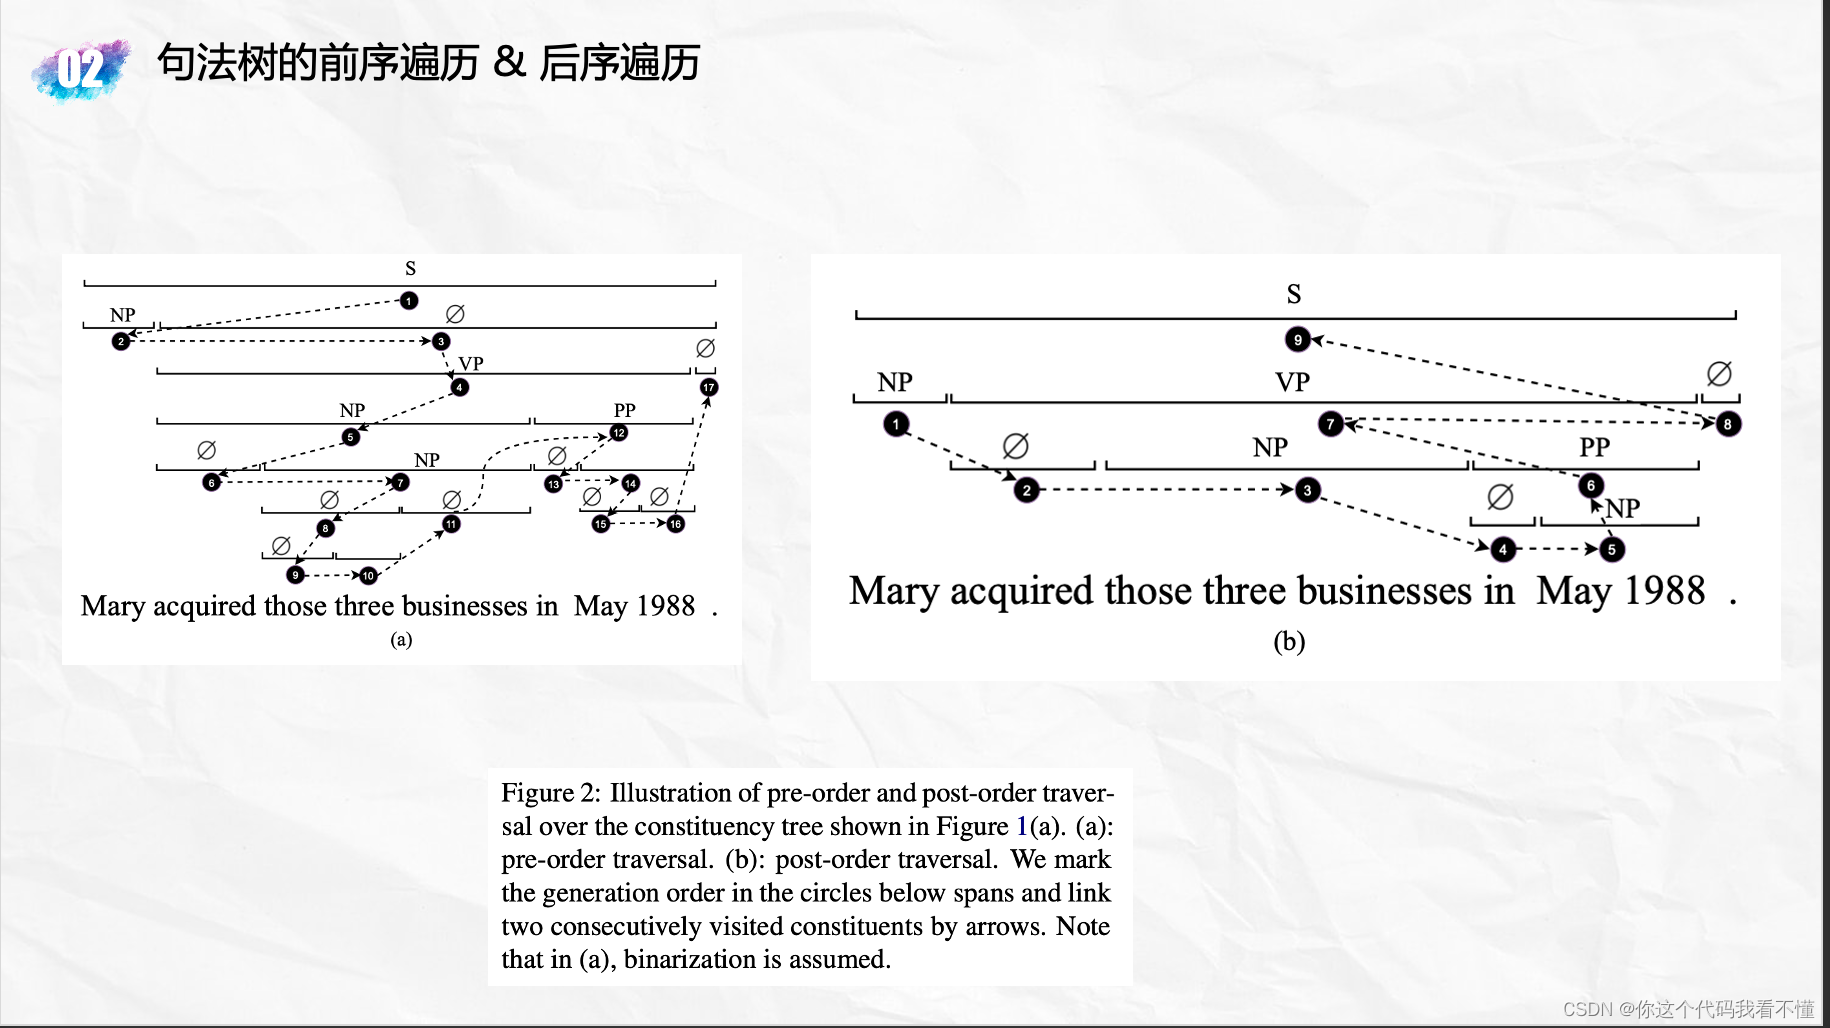
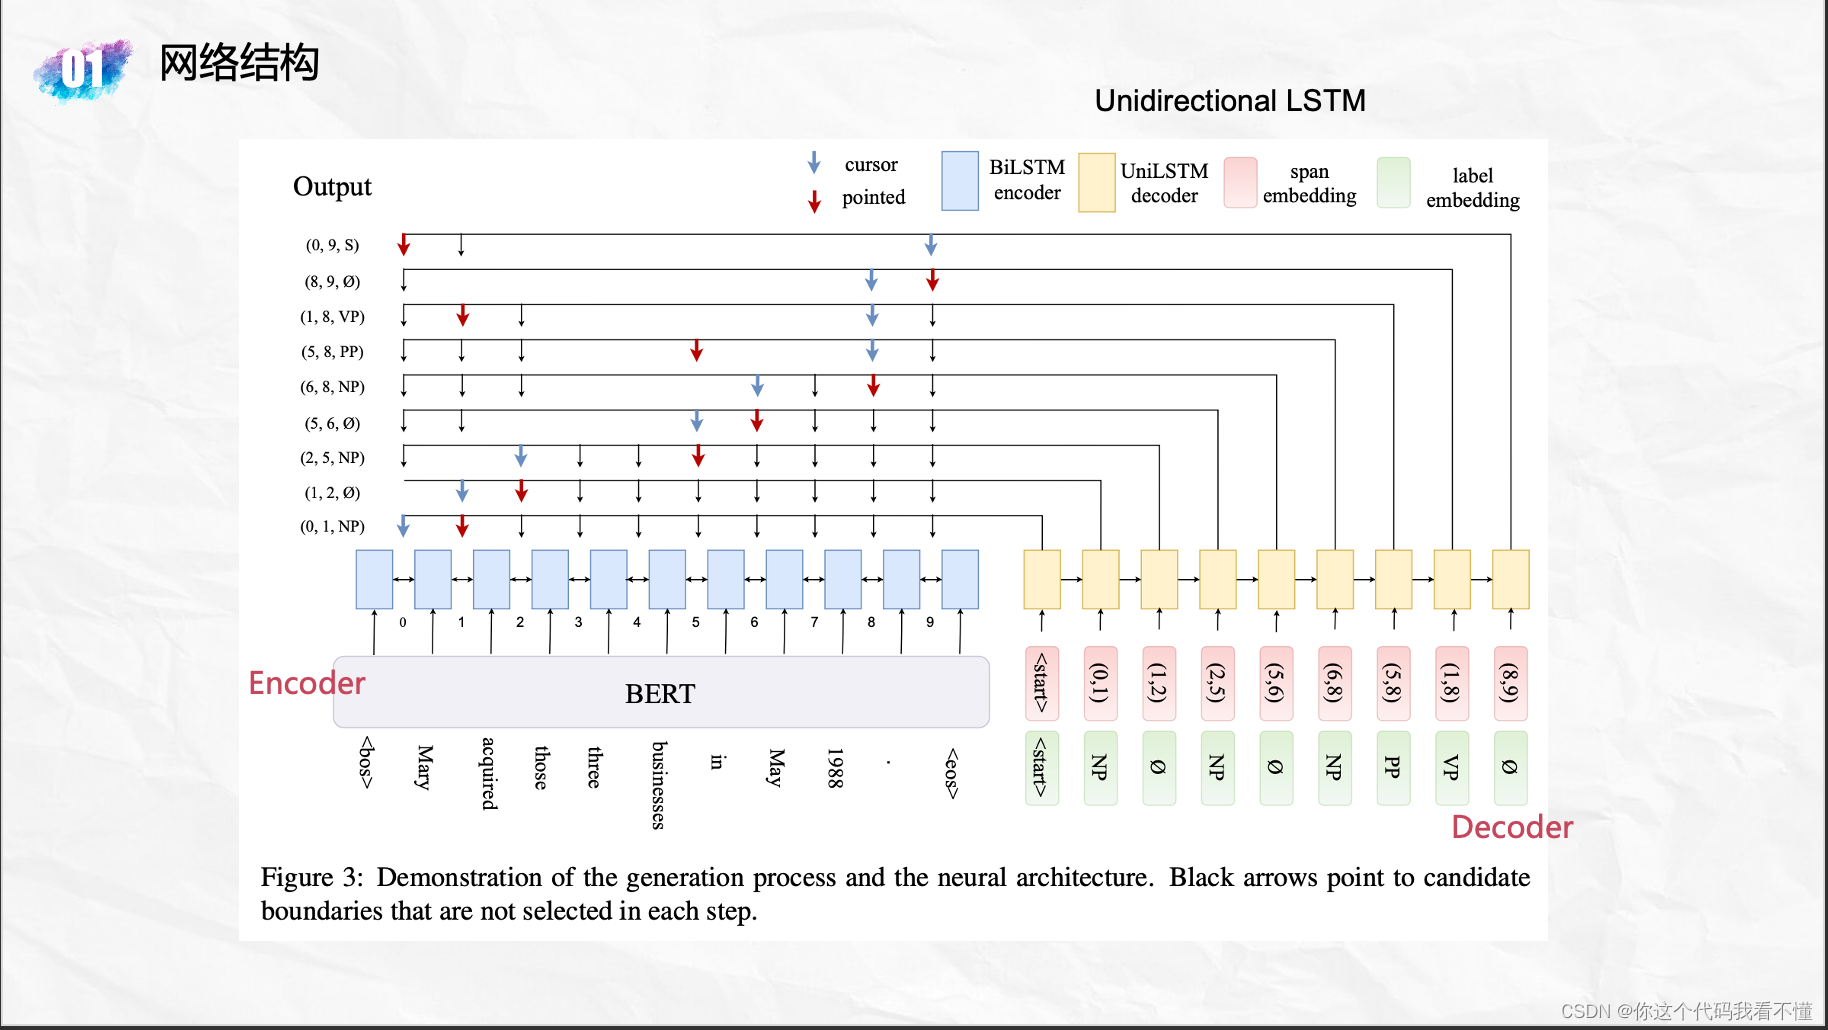
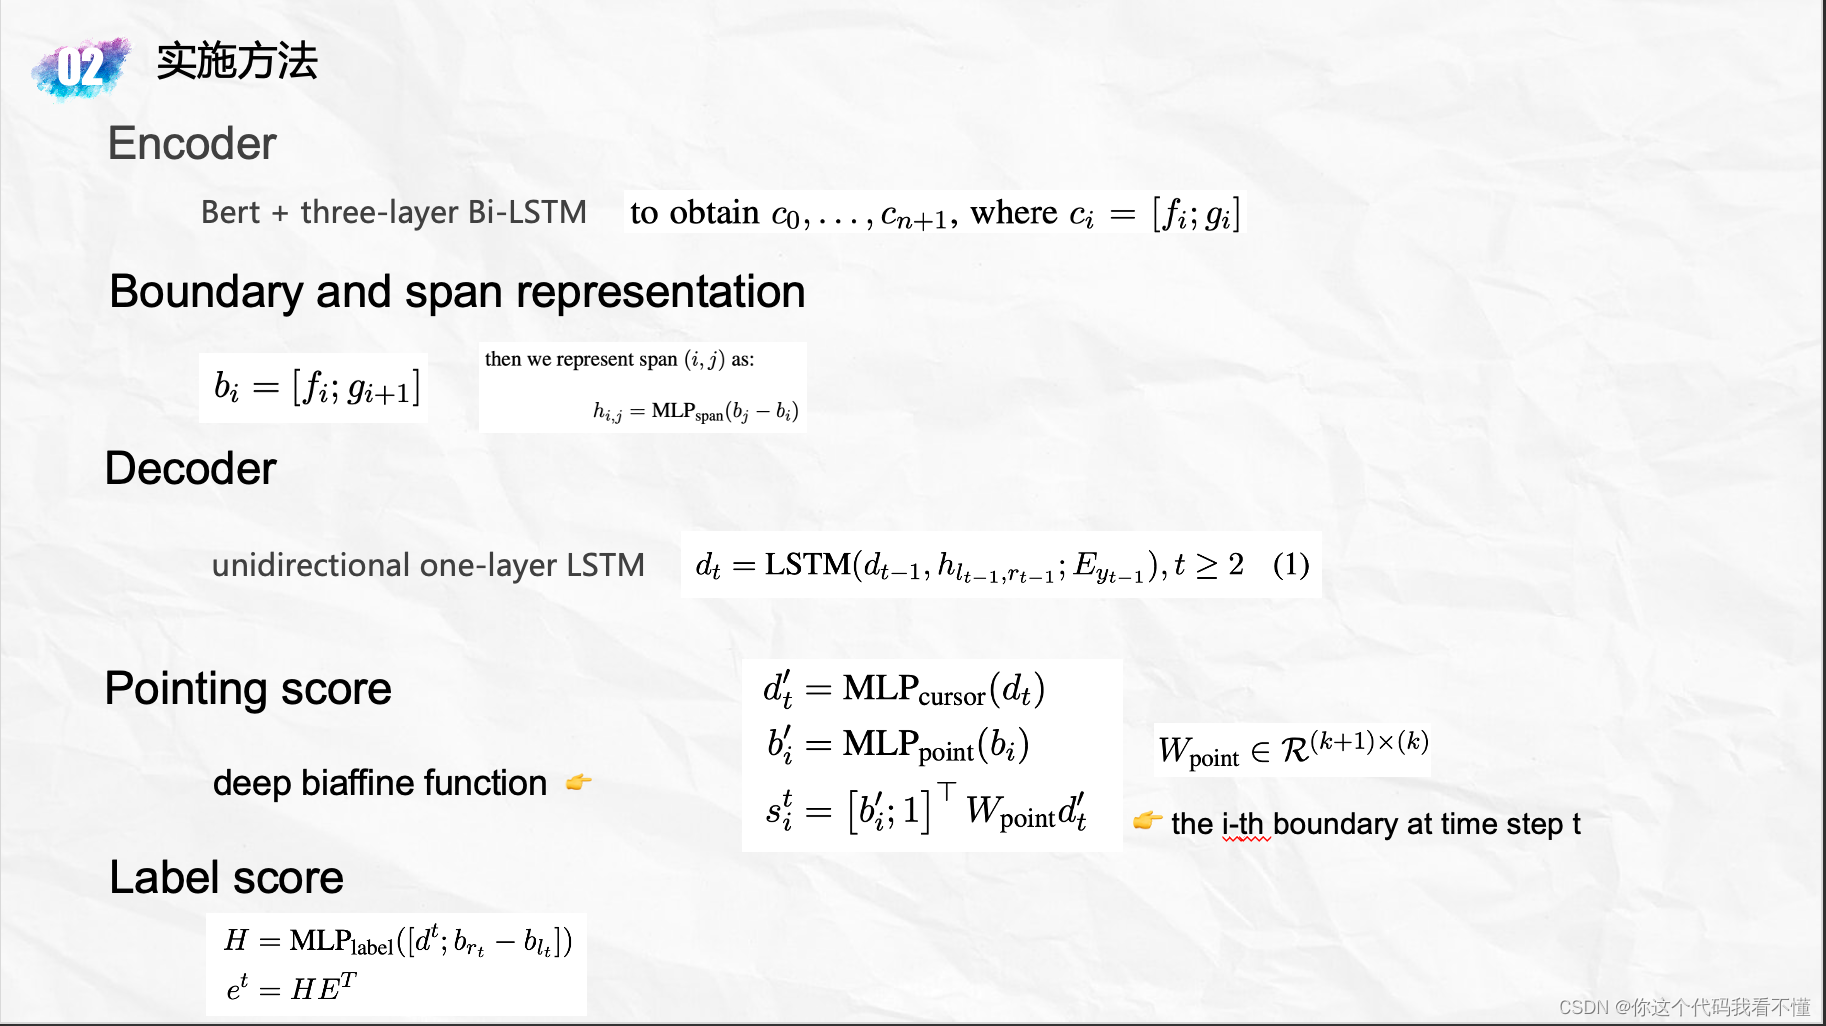
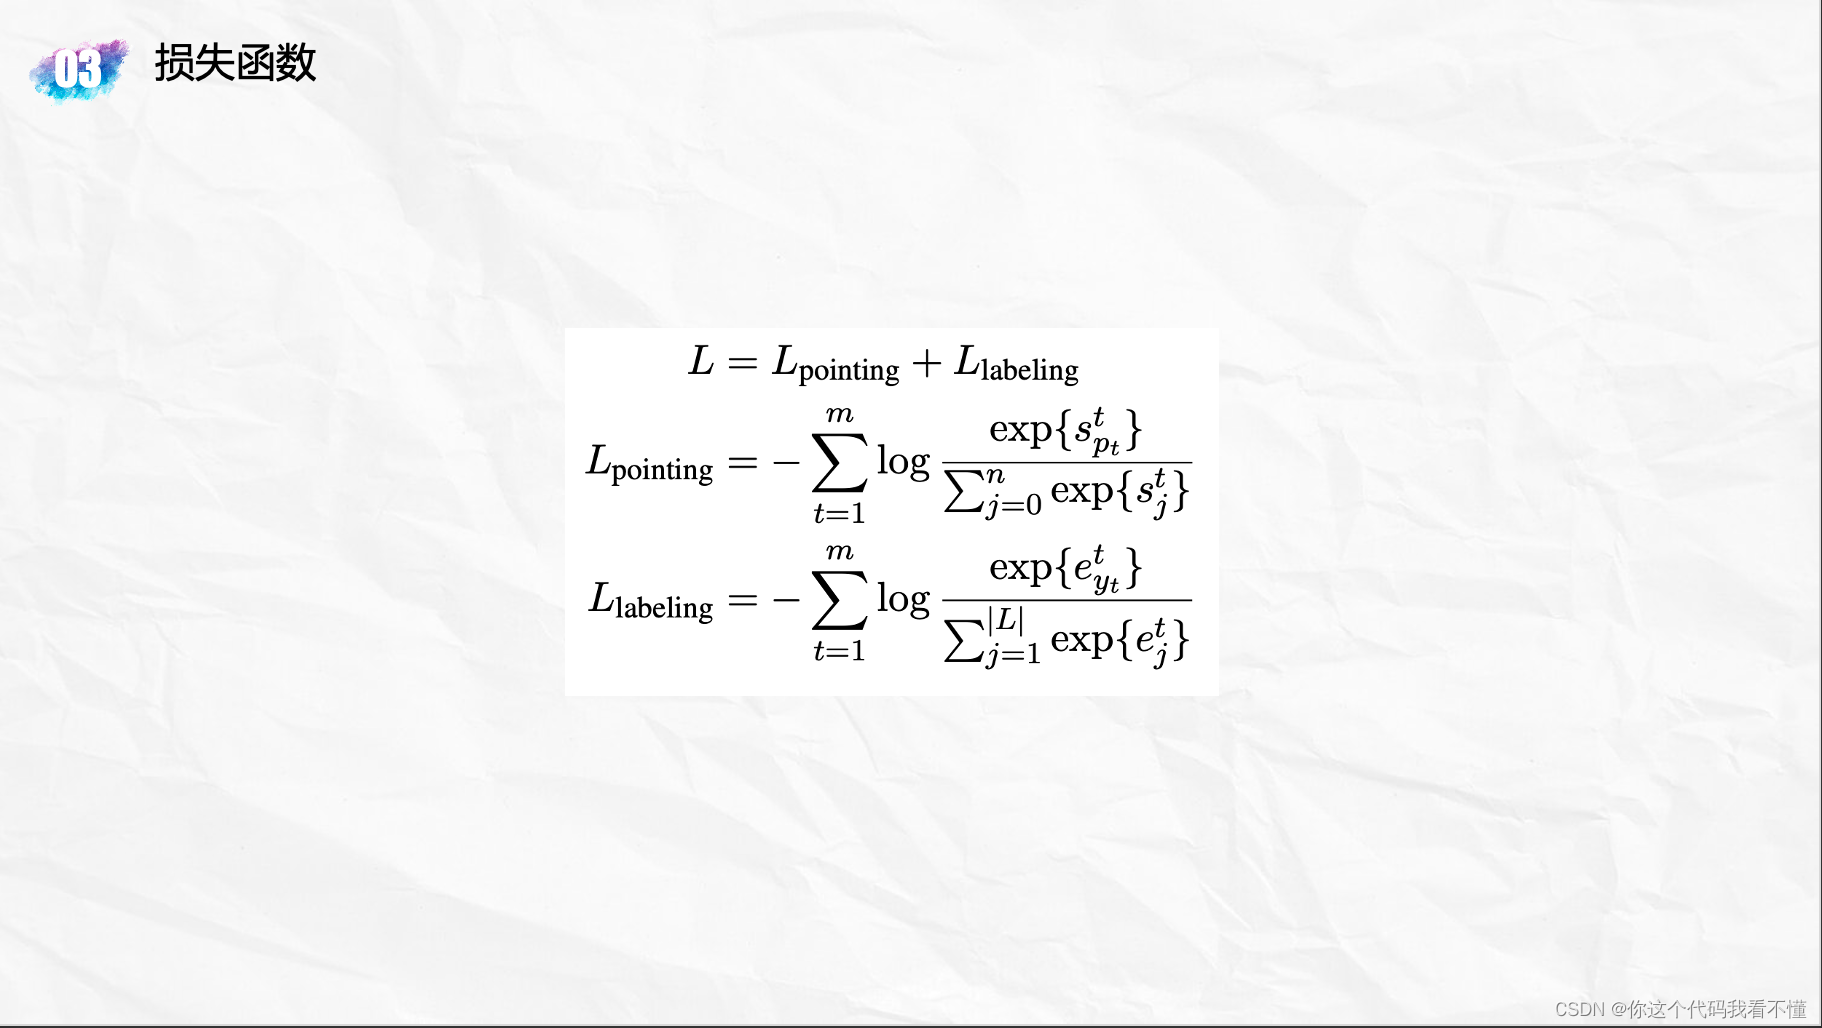
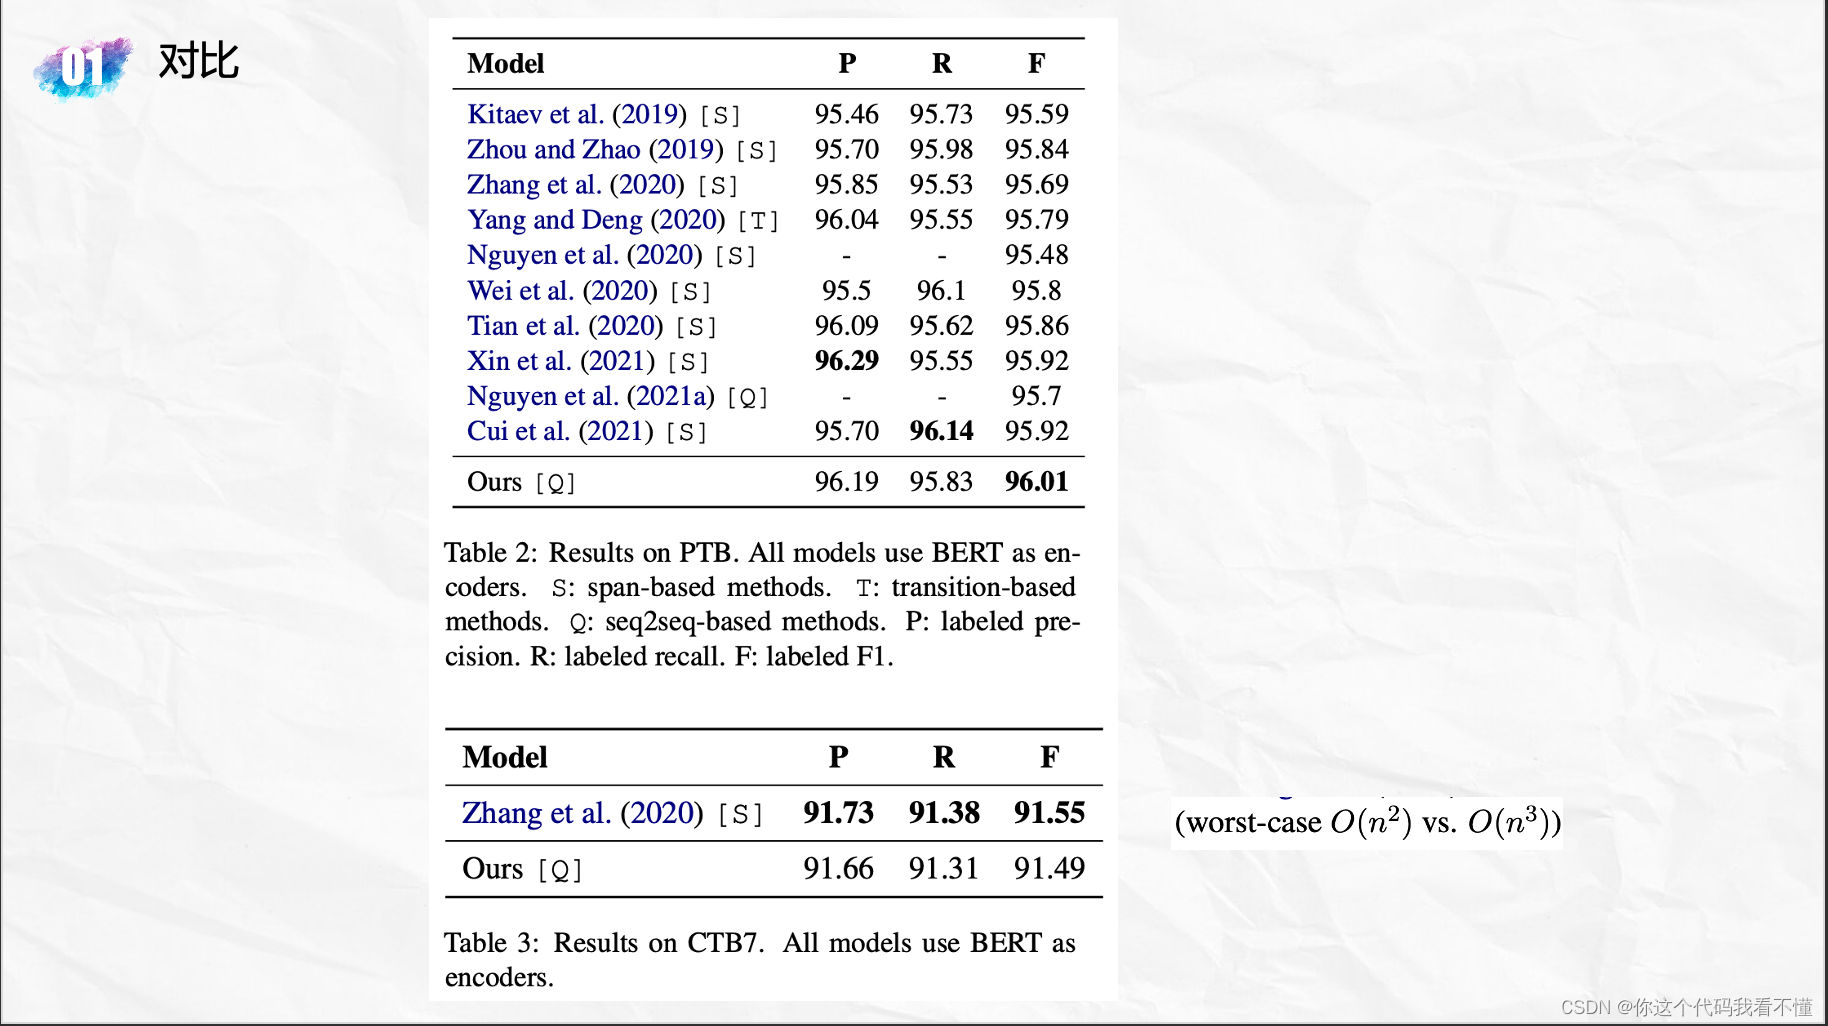
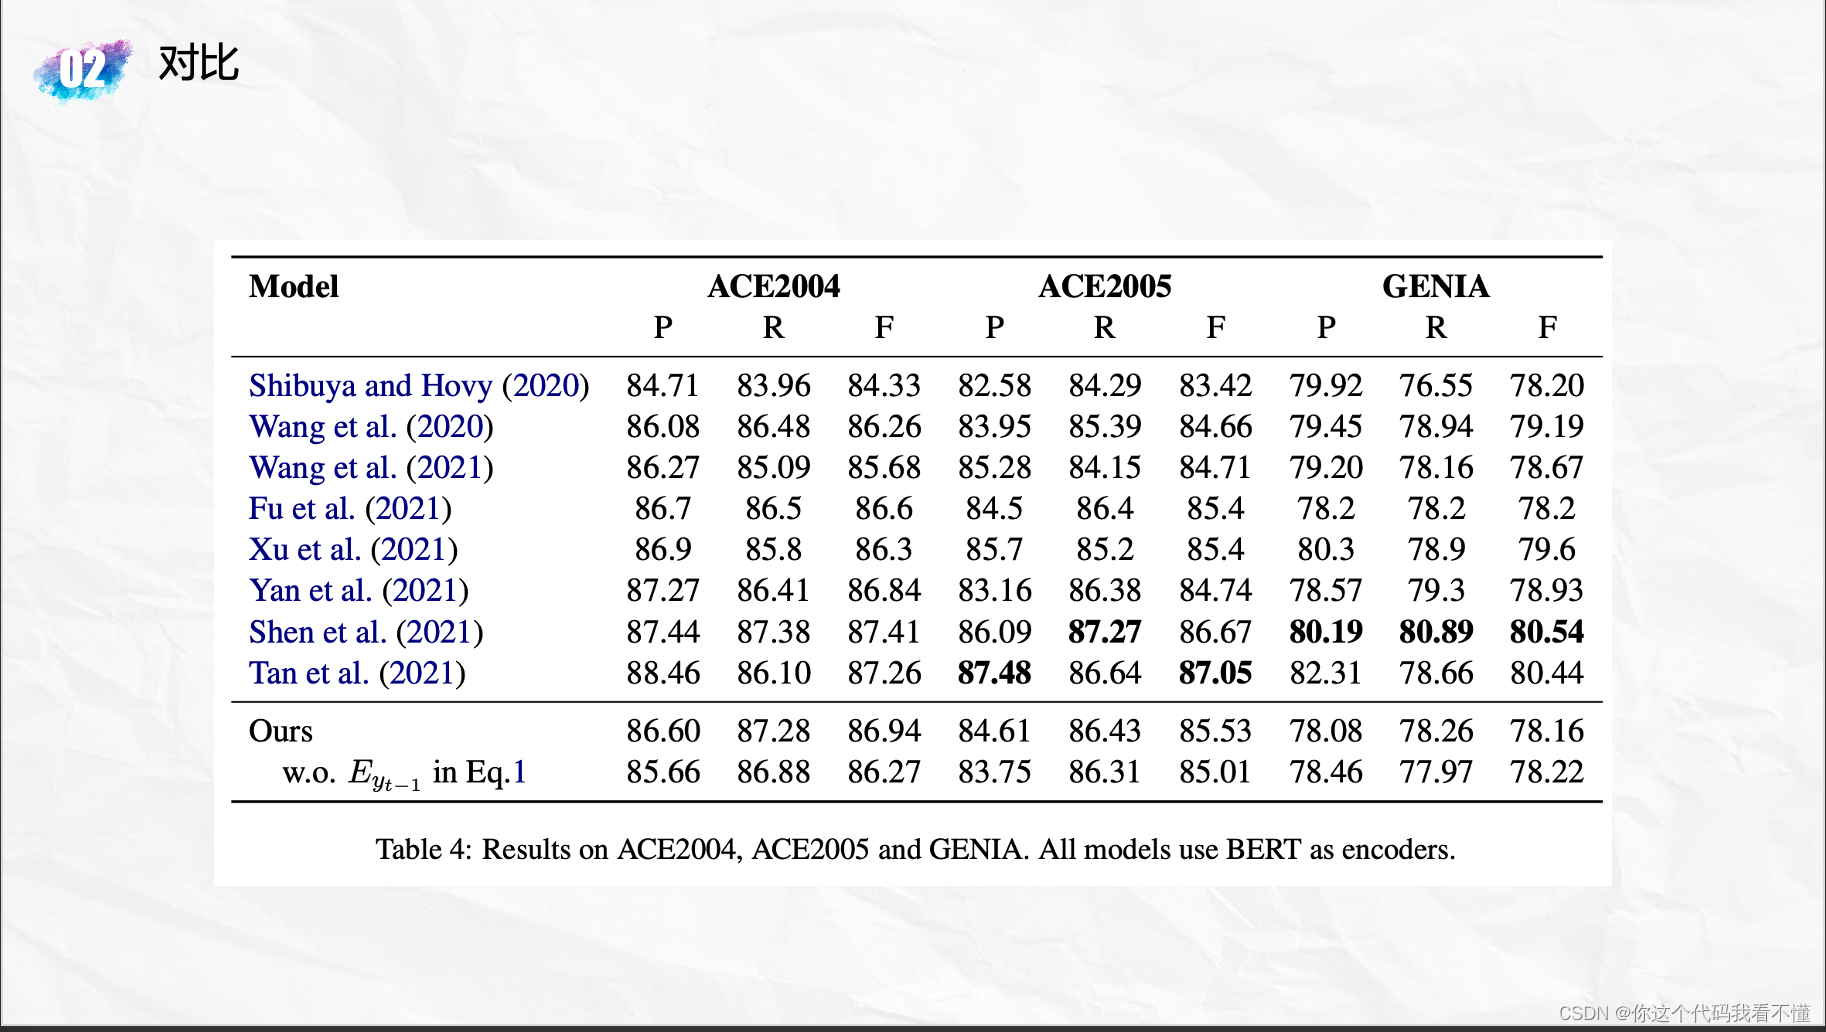
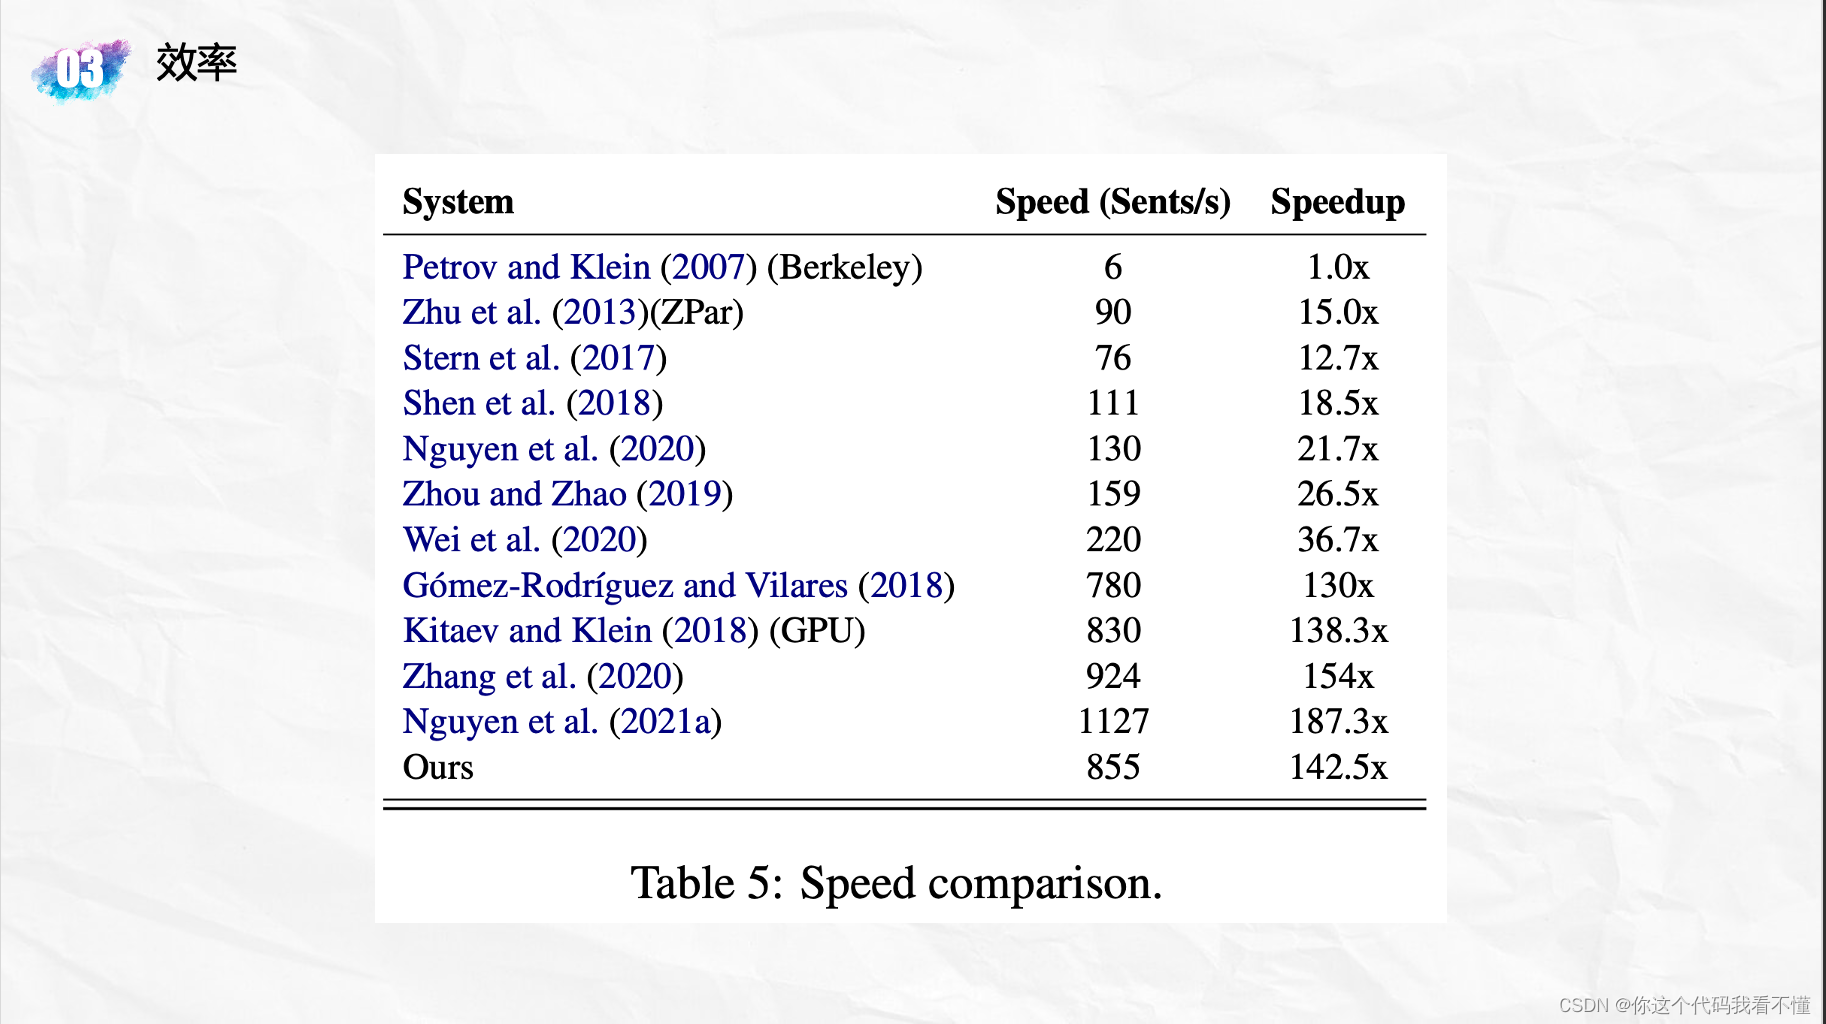
Bottom-Up Constituency Parsing and Nested Named Entity Recognition with Pointer Networks
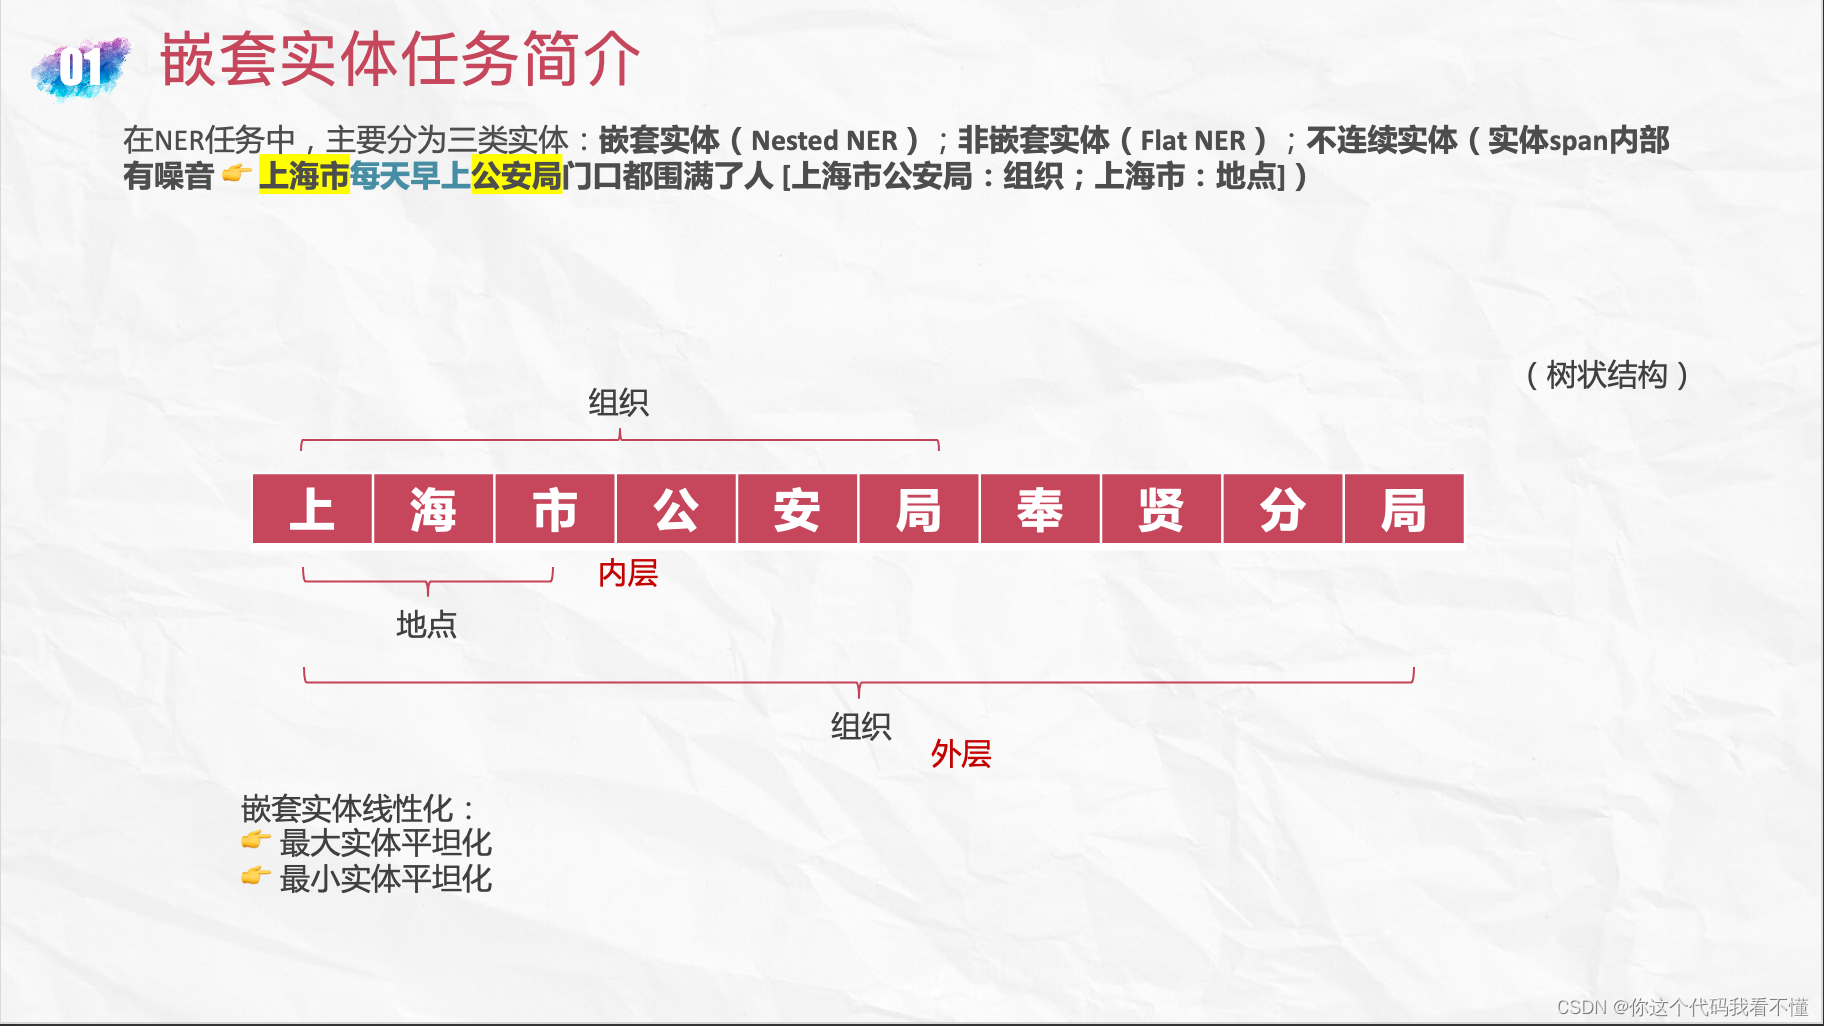
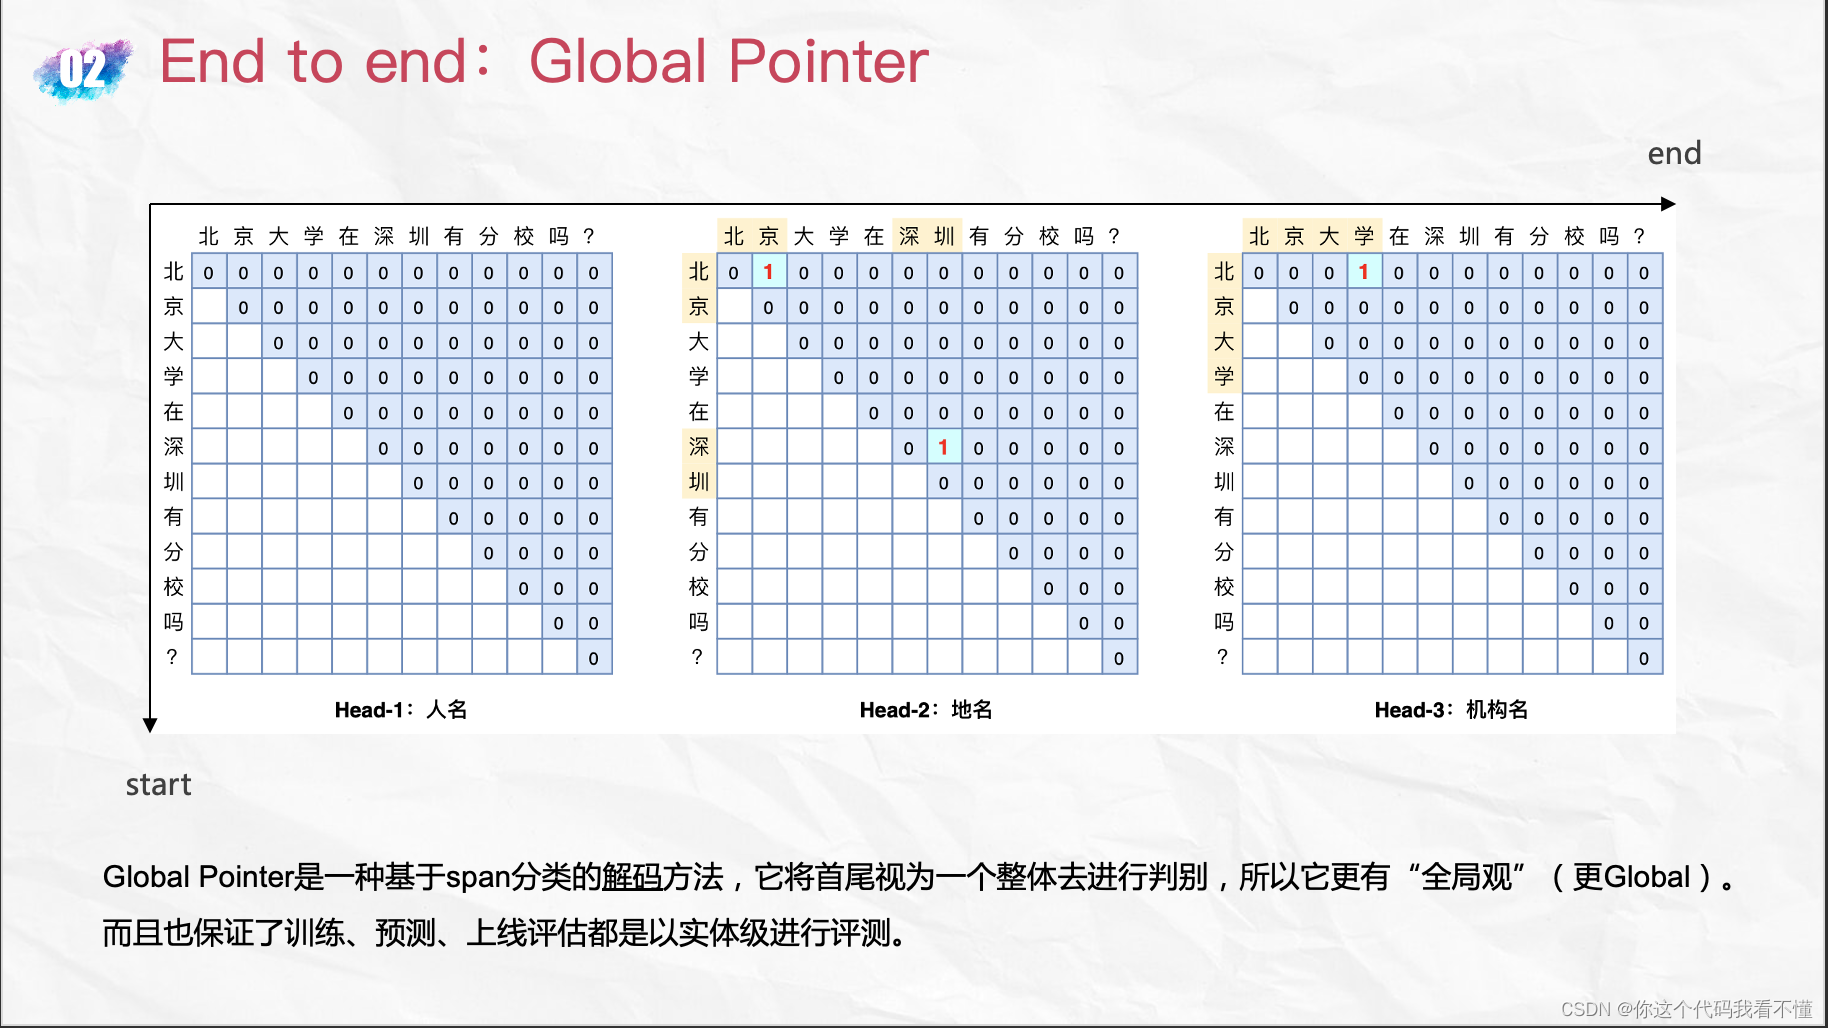
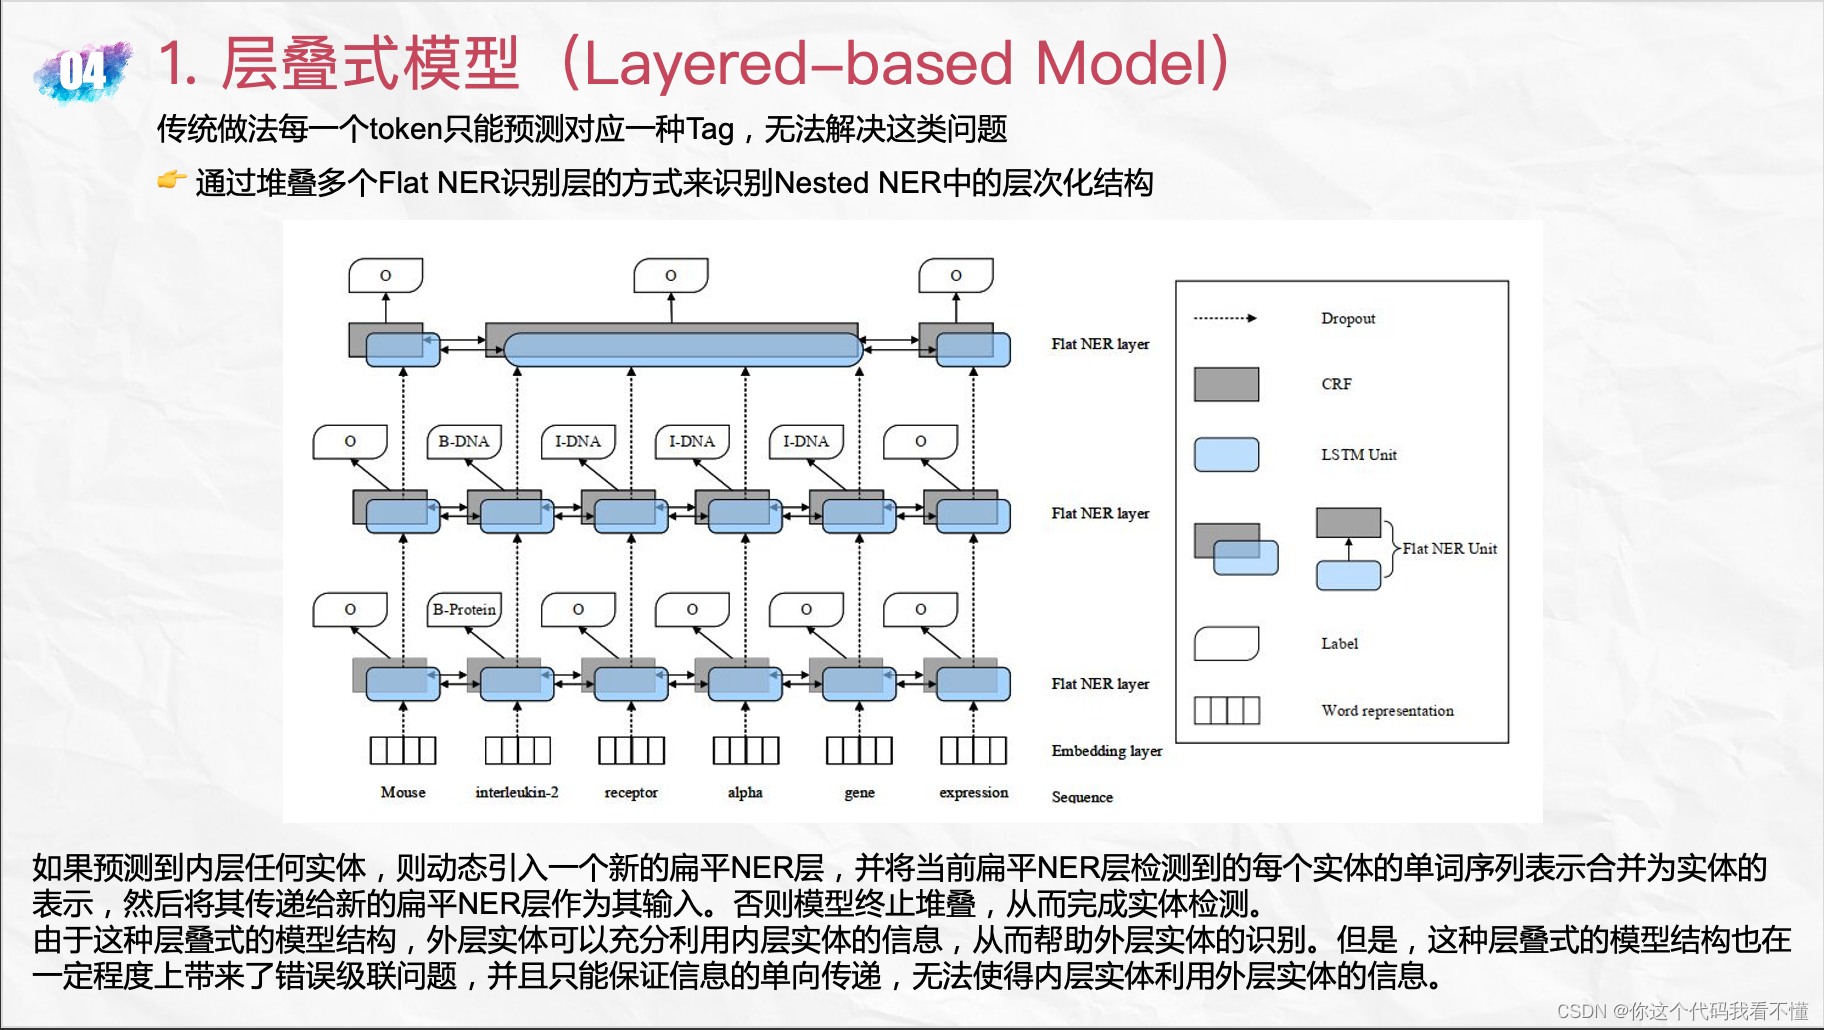
[1] Ju M, Miwa M, Ananiadou S. A neural layered model for nested named entity recognition[C]//Procee
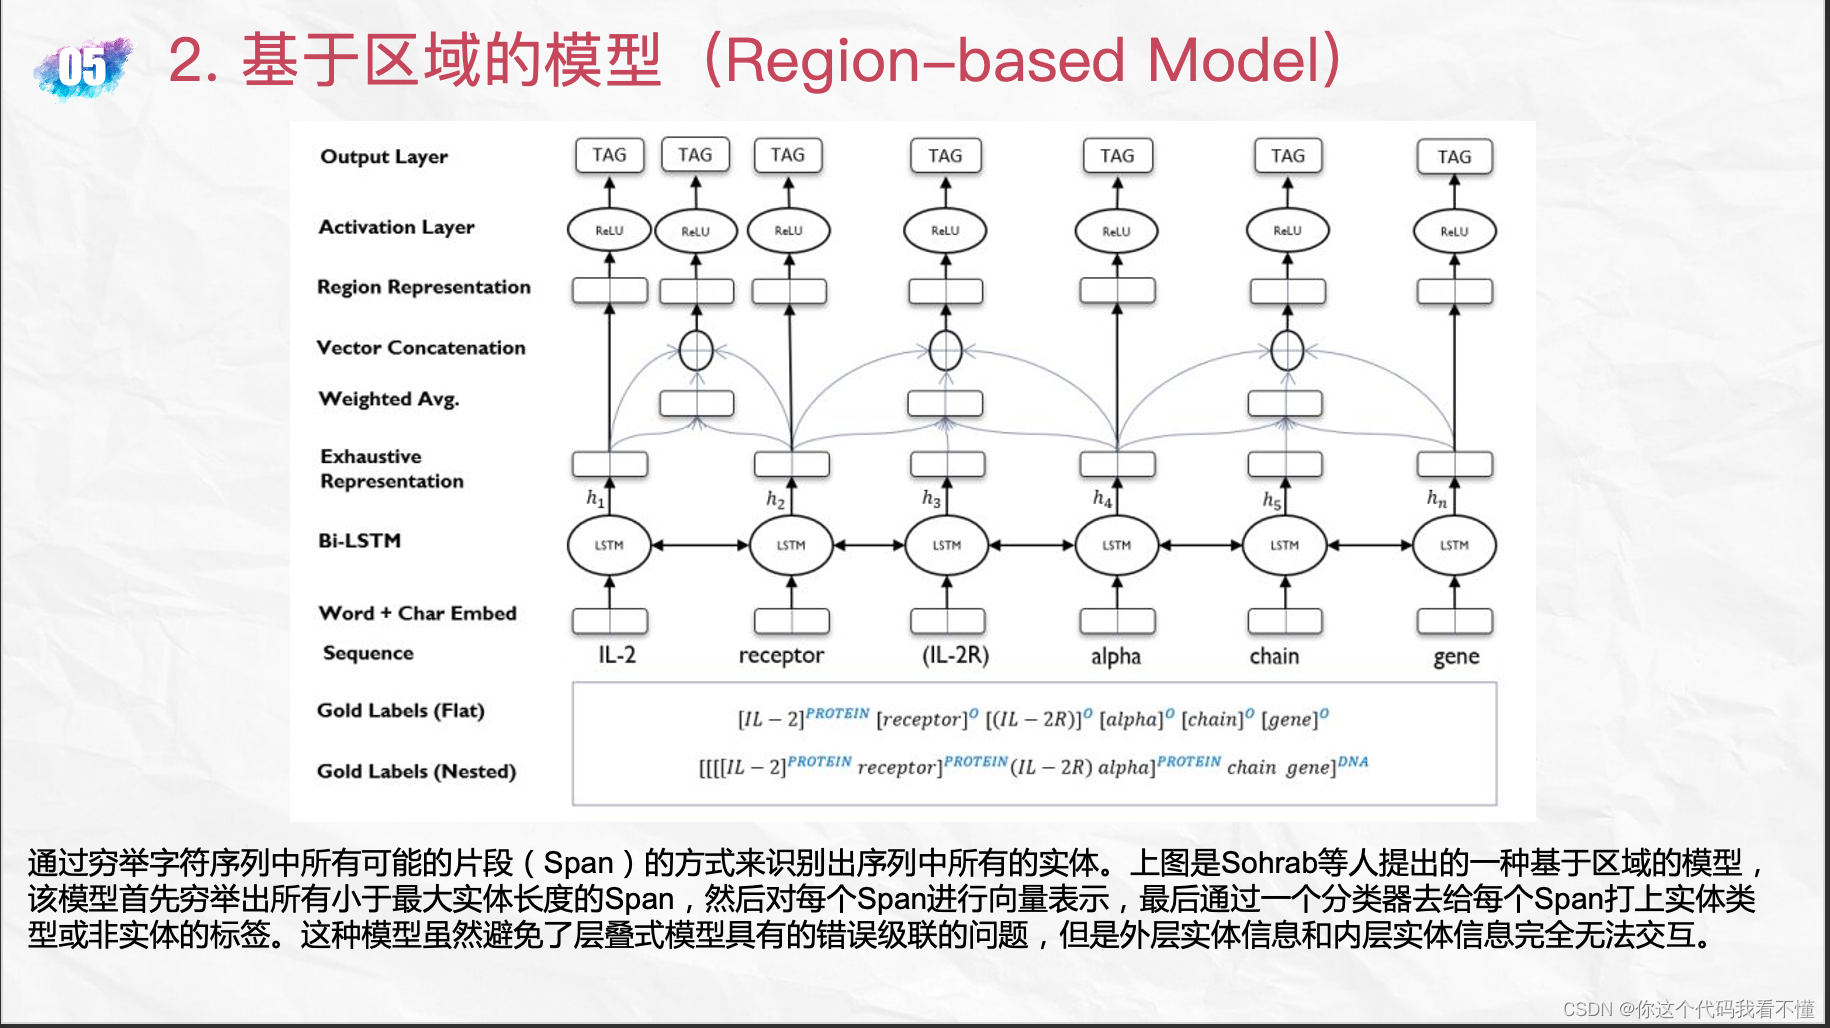
[2] Sohrab M G, Miwa M. Deep exhaustive model for nested named entity recognition[C]//Proceedings of
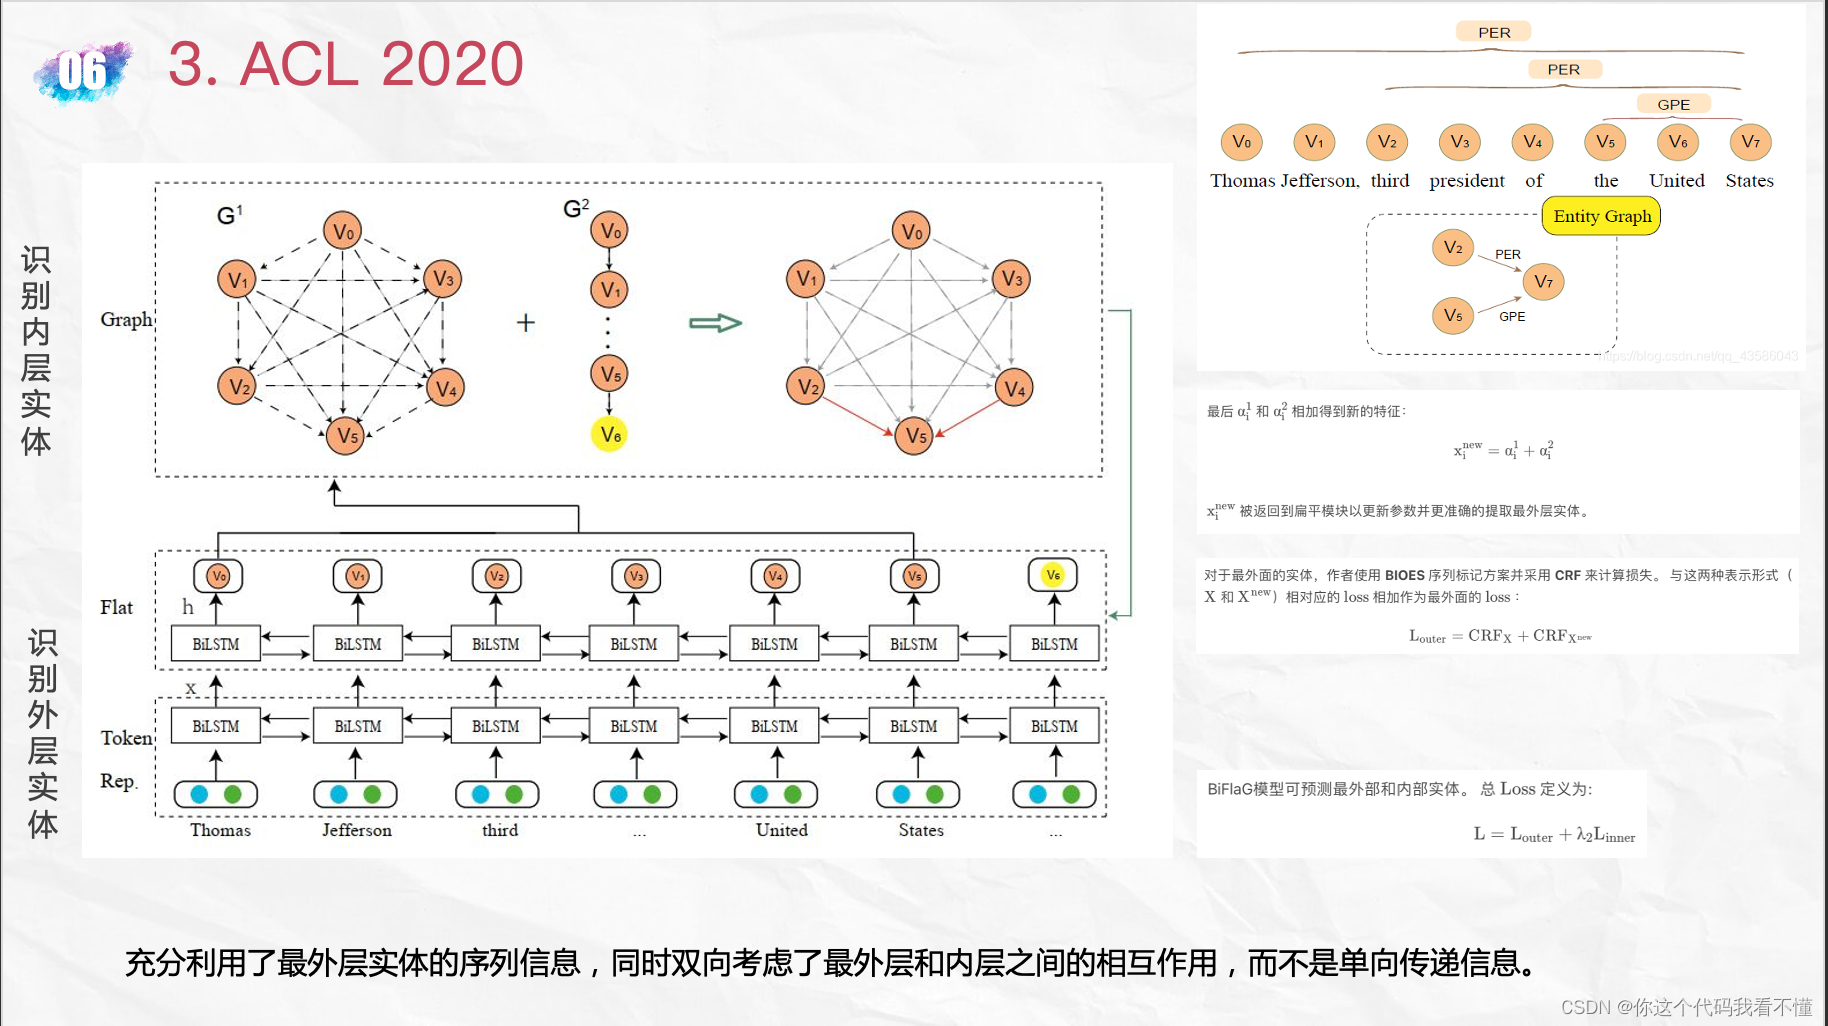
[4] Luo Y, Zhao H. Bipartite Flat-Graph Network for Nested Named Entity Recognition[J]. arXiv prepri
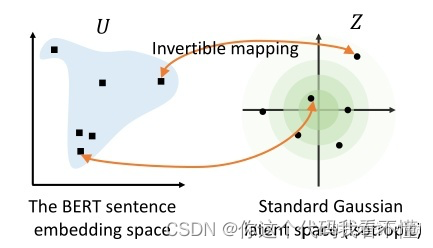
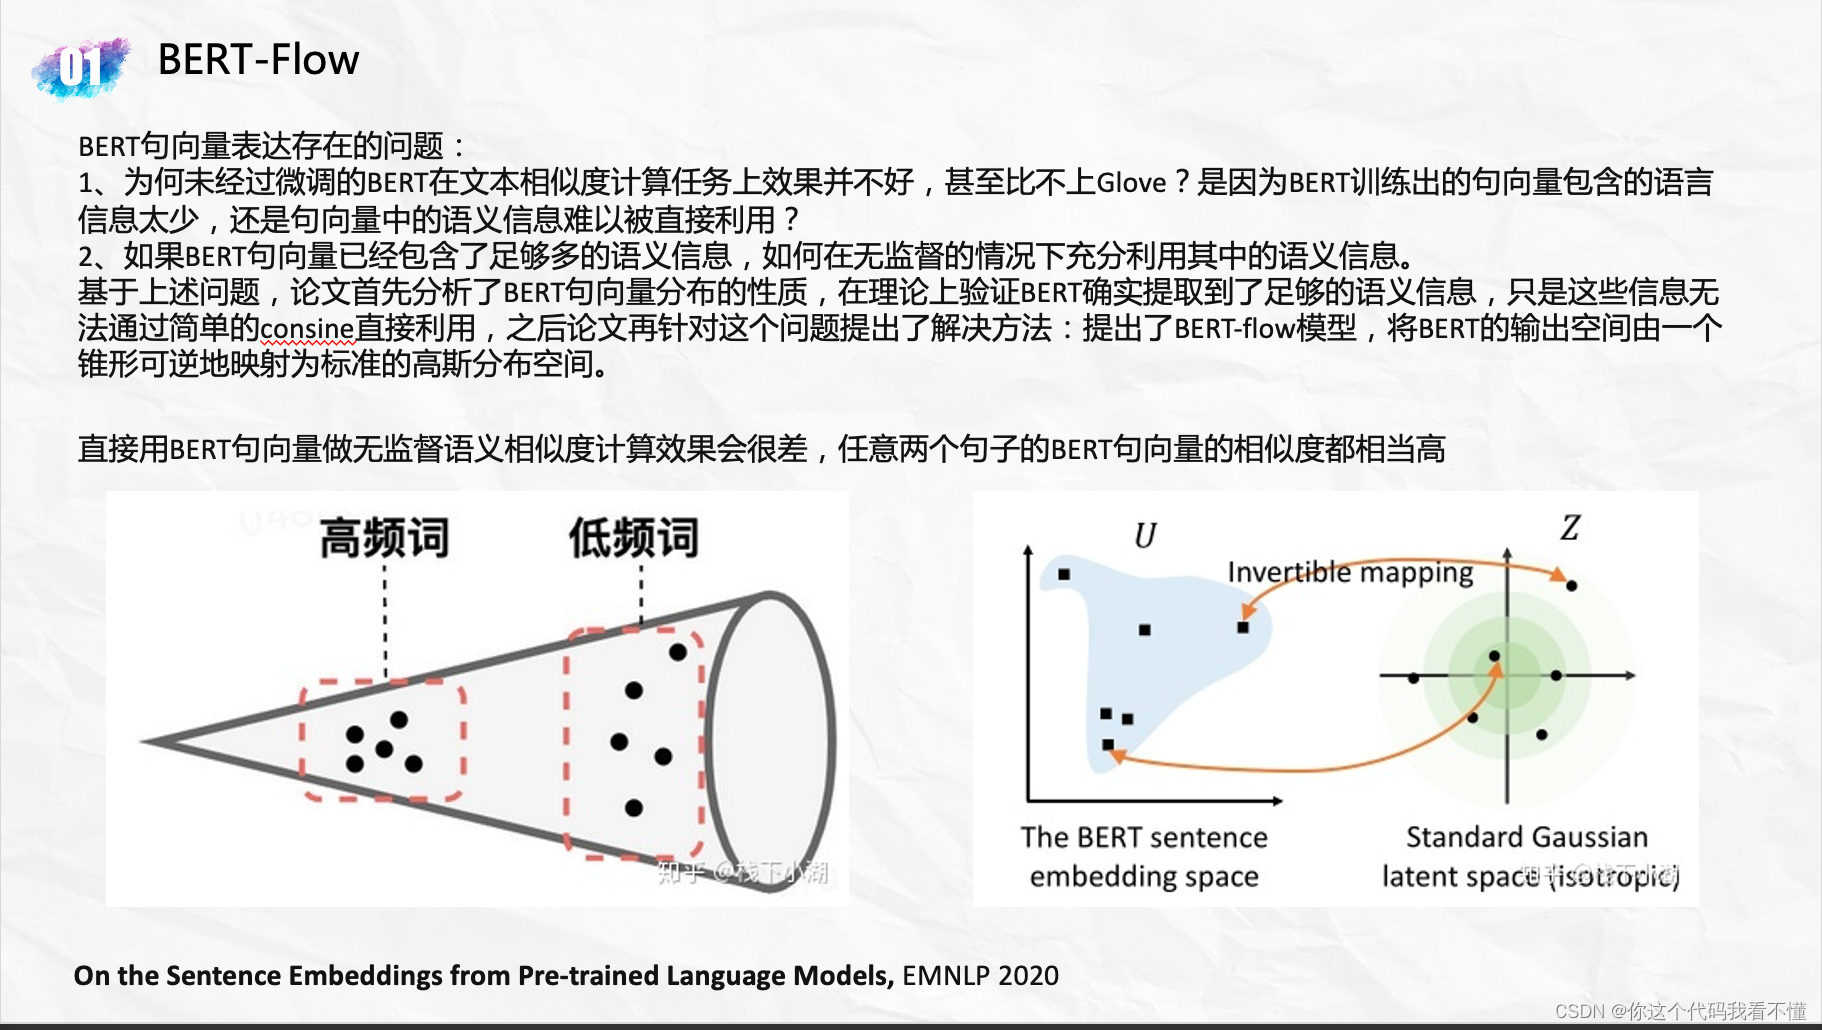
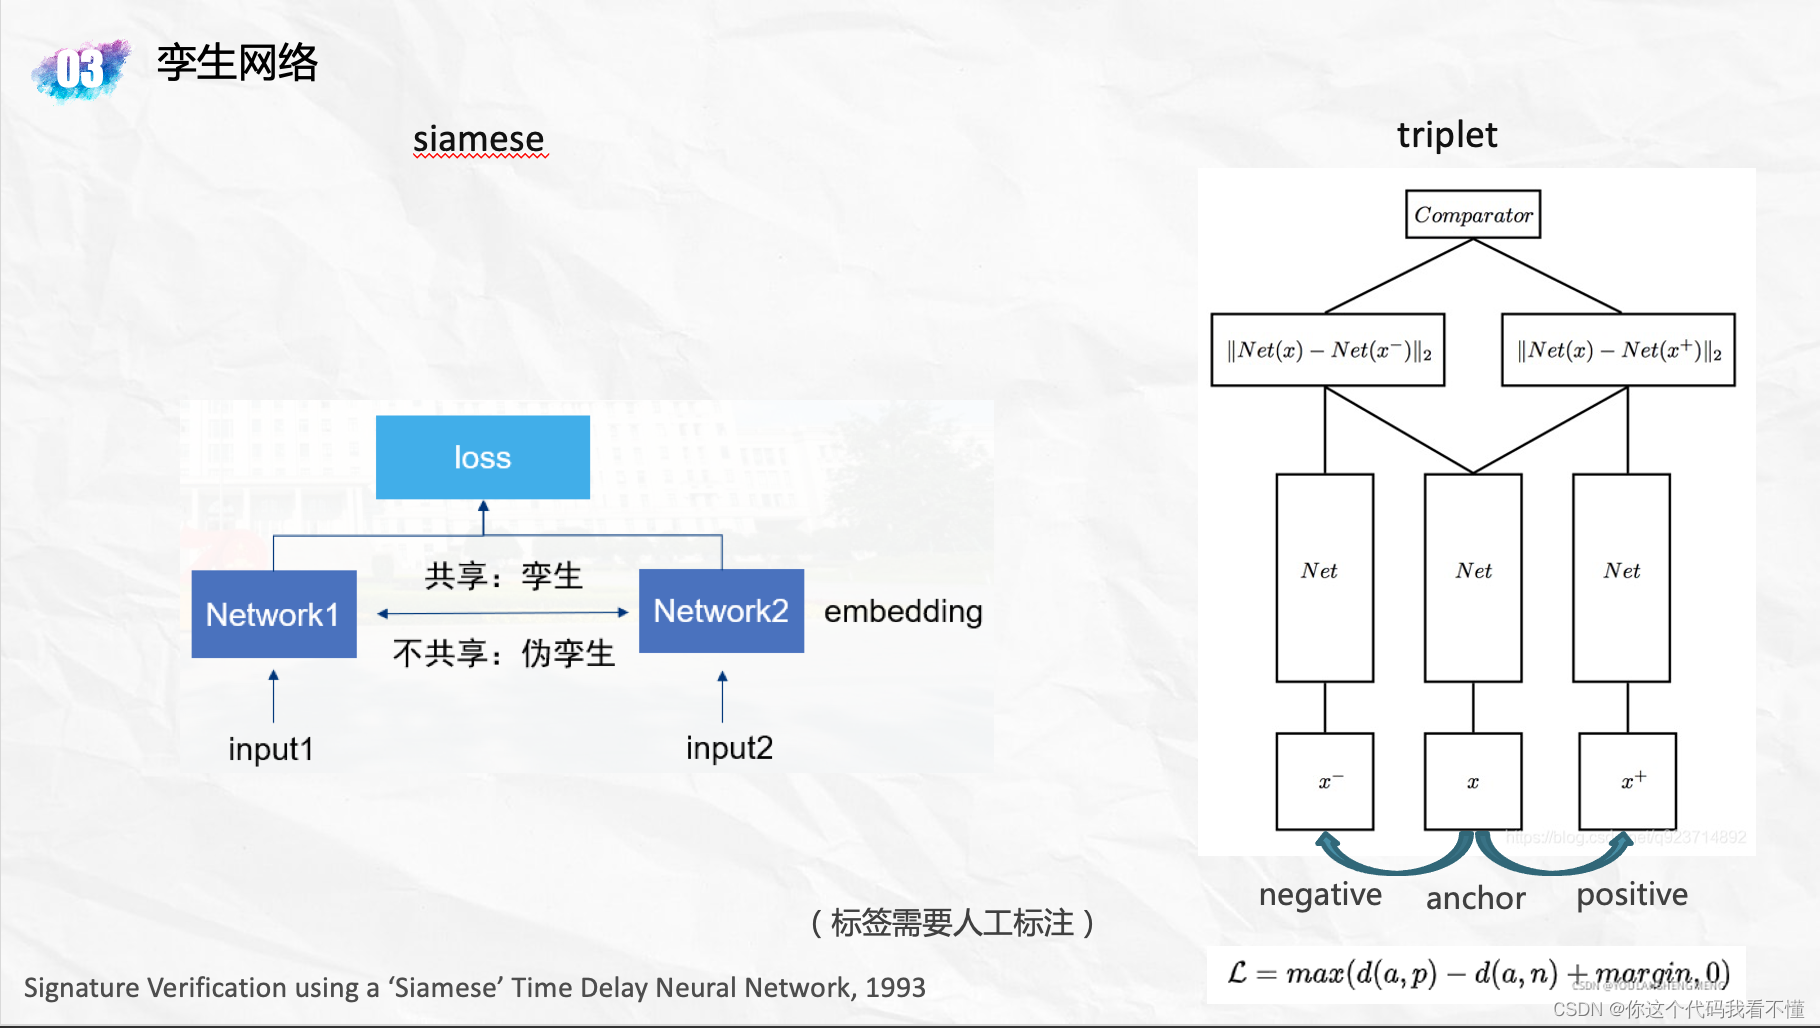
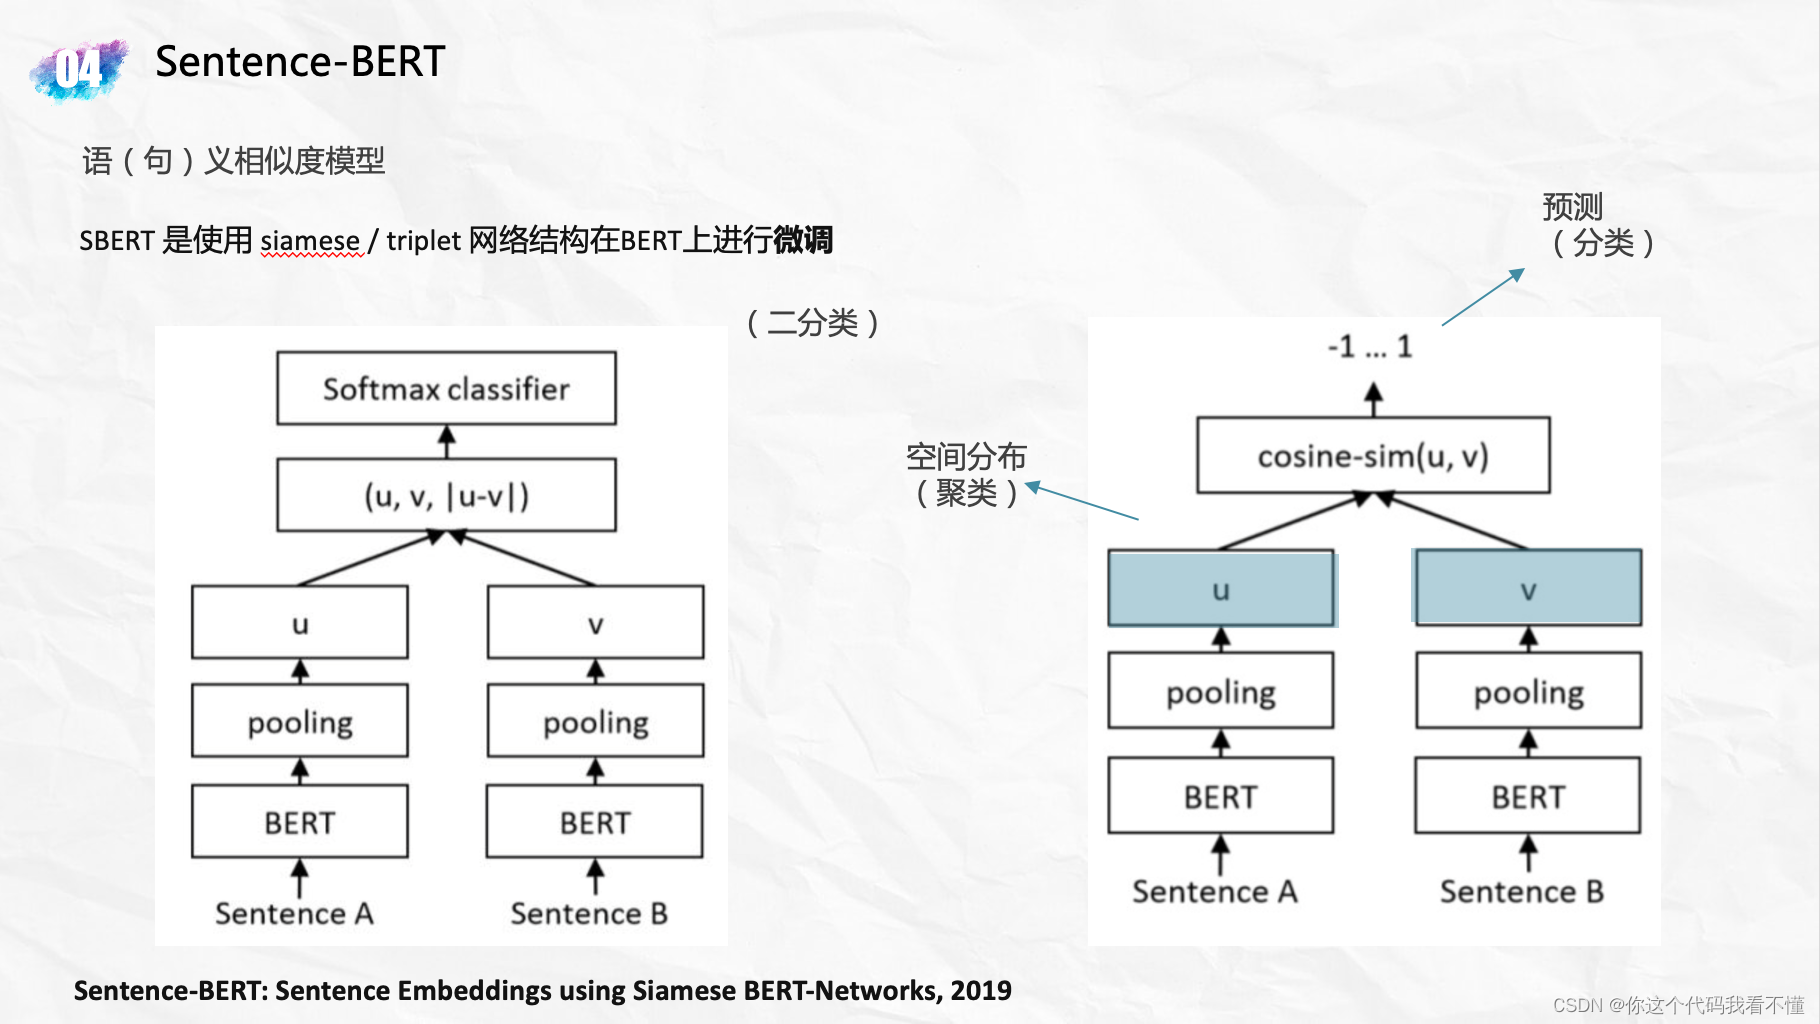
- BERT-Flow:
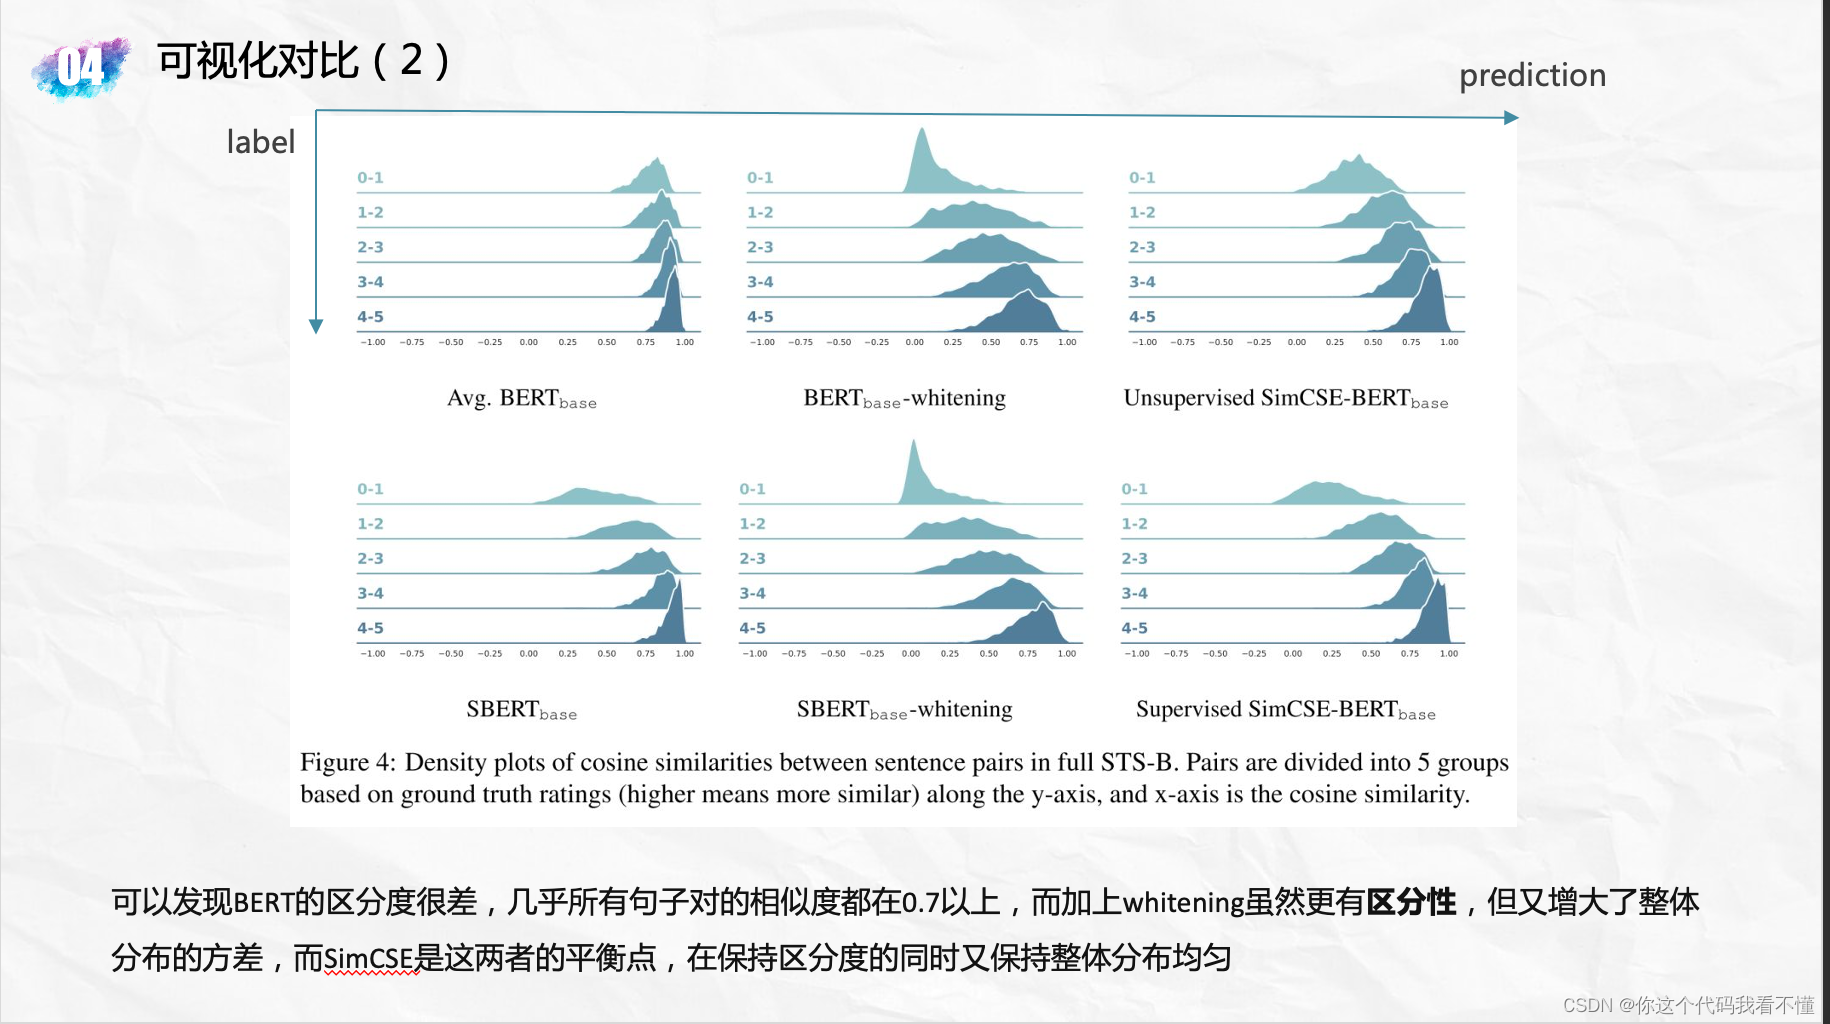
因为高词频的词和低频词的空间分布特性,导致了相似度计算时,相似度过高或过低的问题。
在句子级:如果两个句子都是由高频词组成,那么它们存在共现词时,相似度可能会很高,而如果都是由低频词组成时,得到的相似度则可能会相对较低;在单词级:假设两个词在语义上是等价的,但是它们的词频差异导致了它们空间上的距离偏差,这时词向量的距离就不能很好的表征语义相关度。
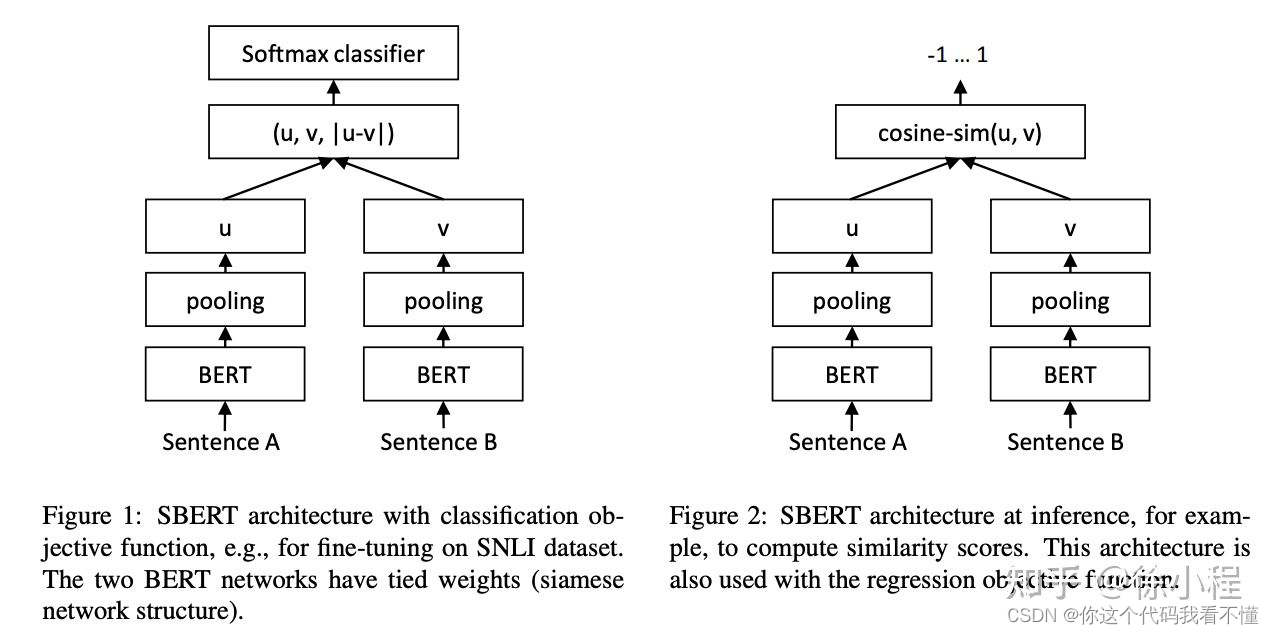
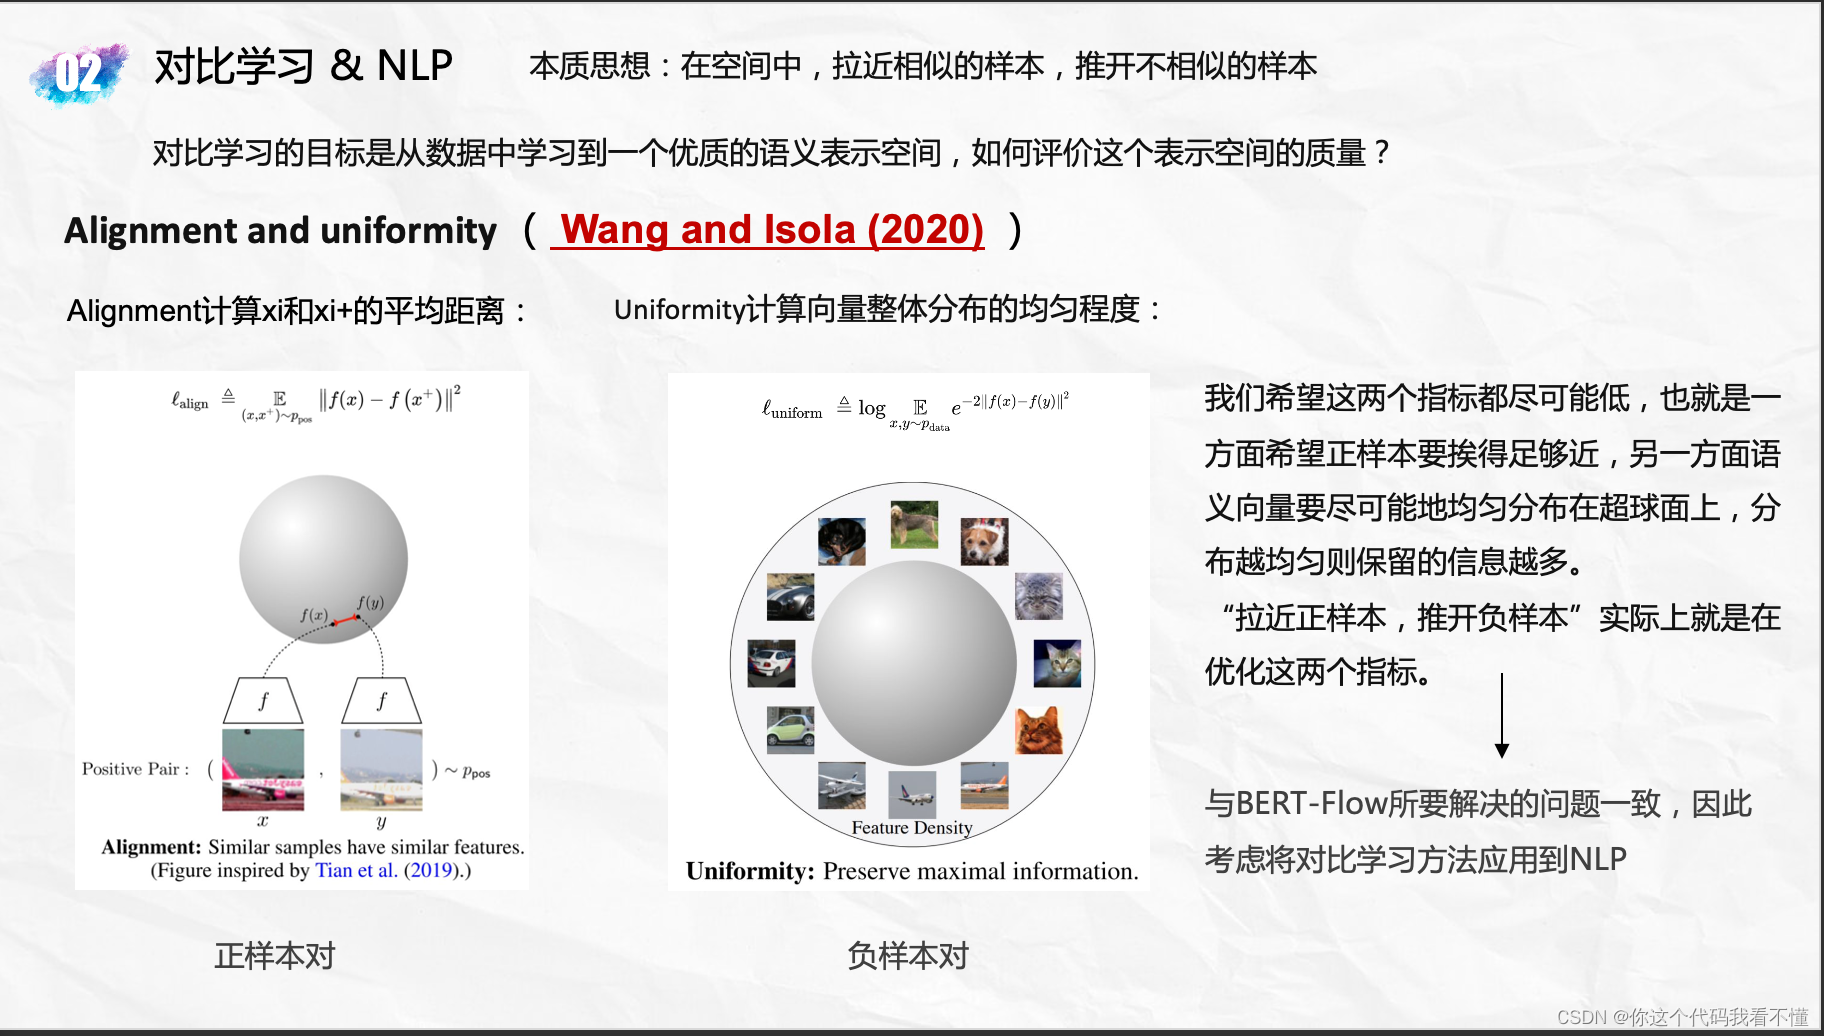
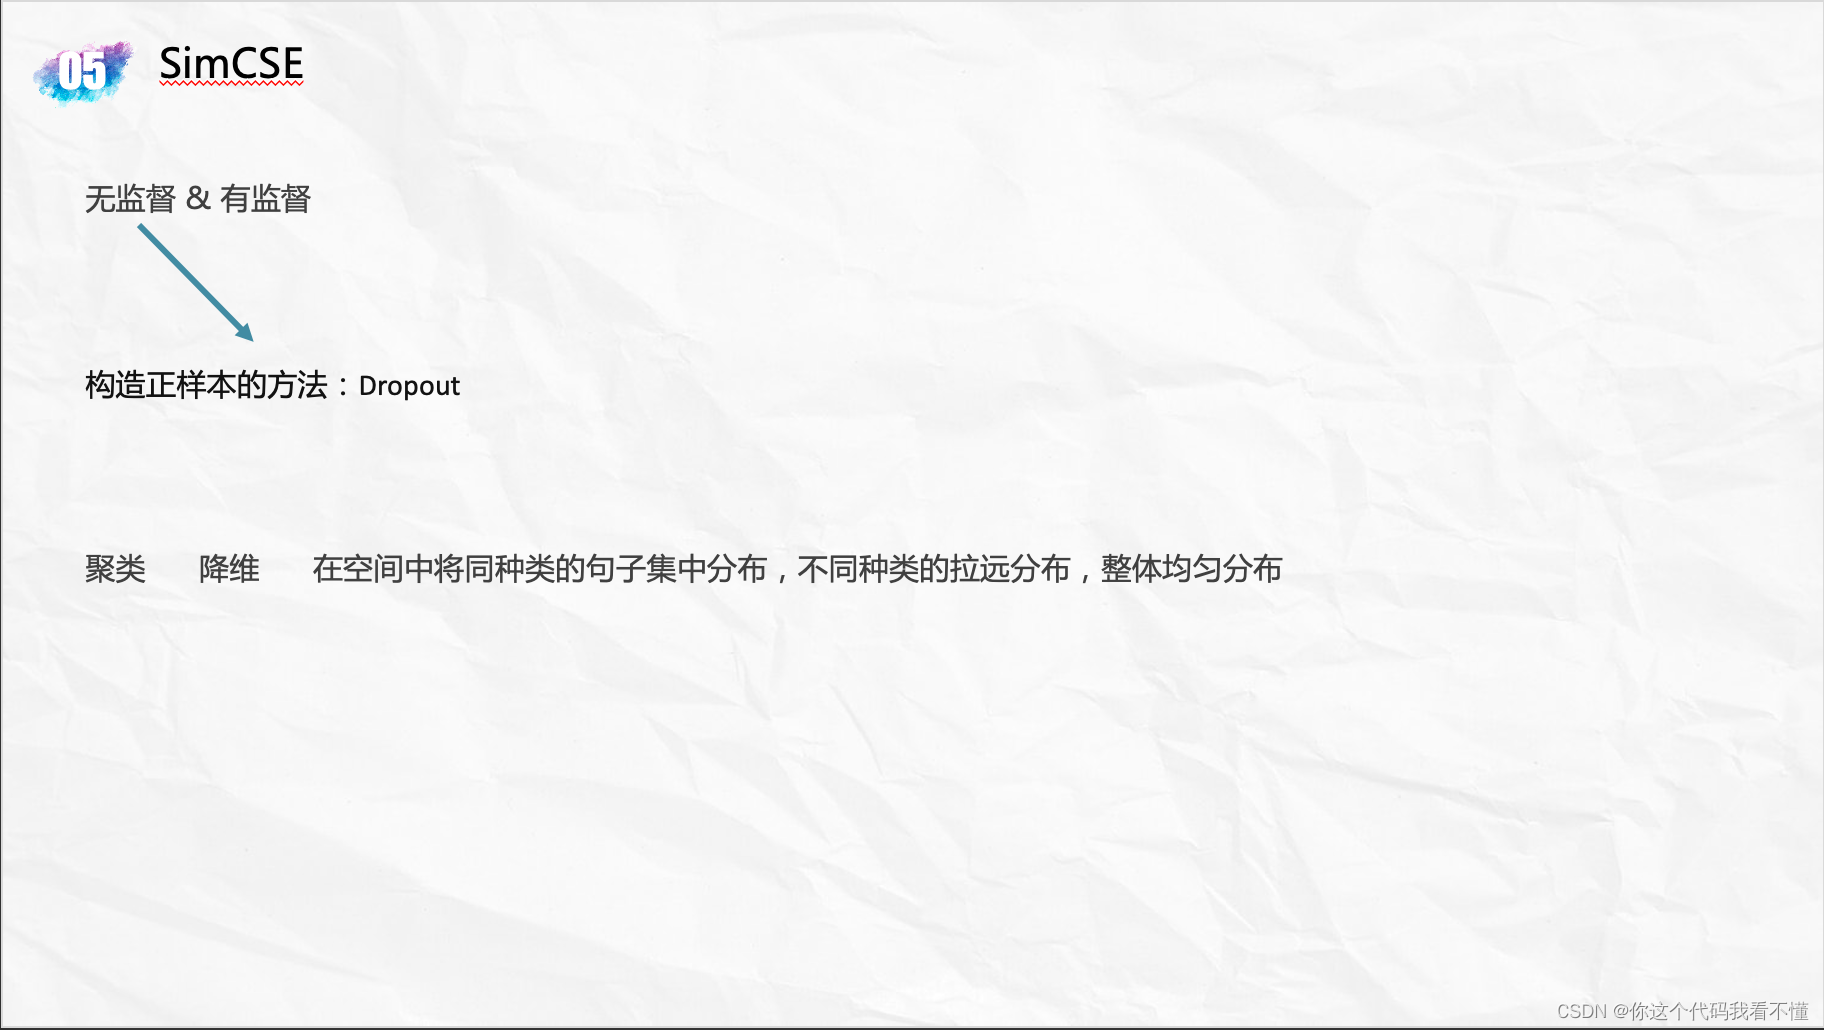
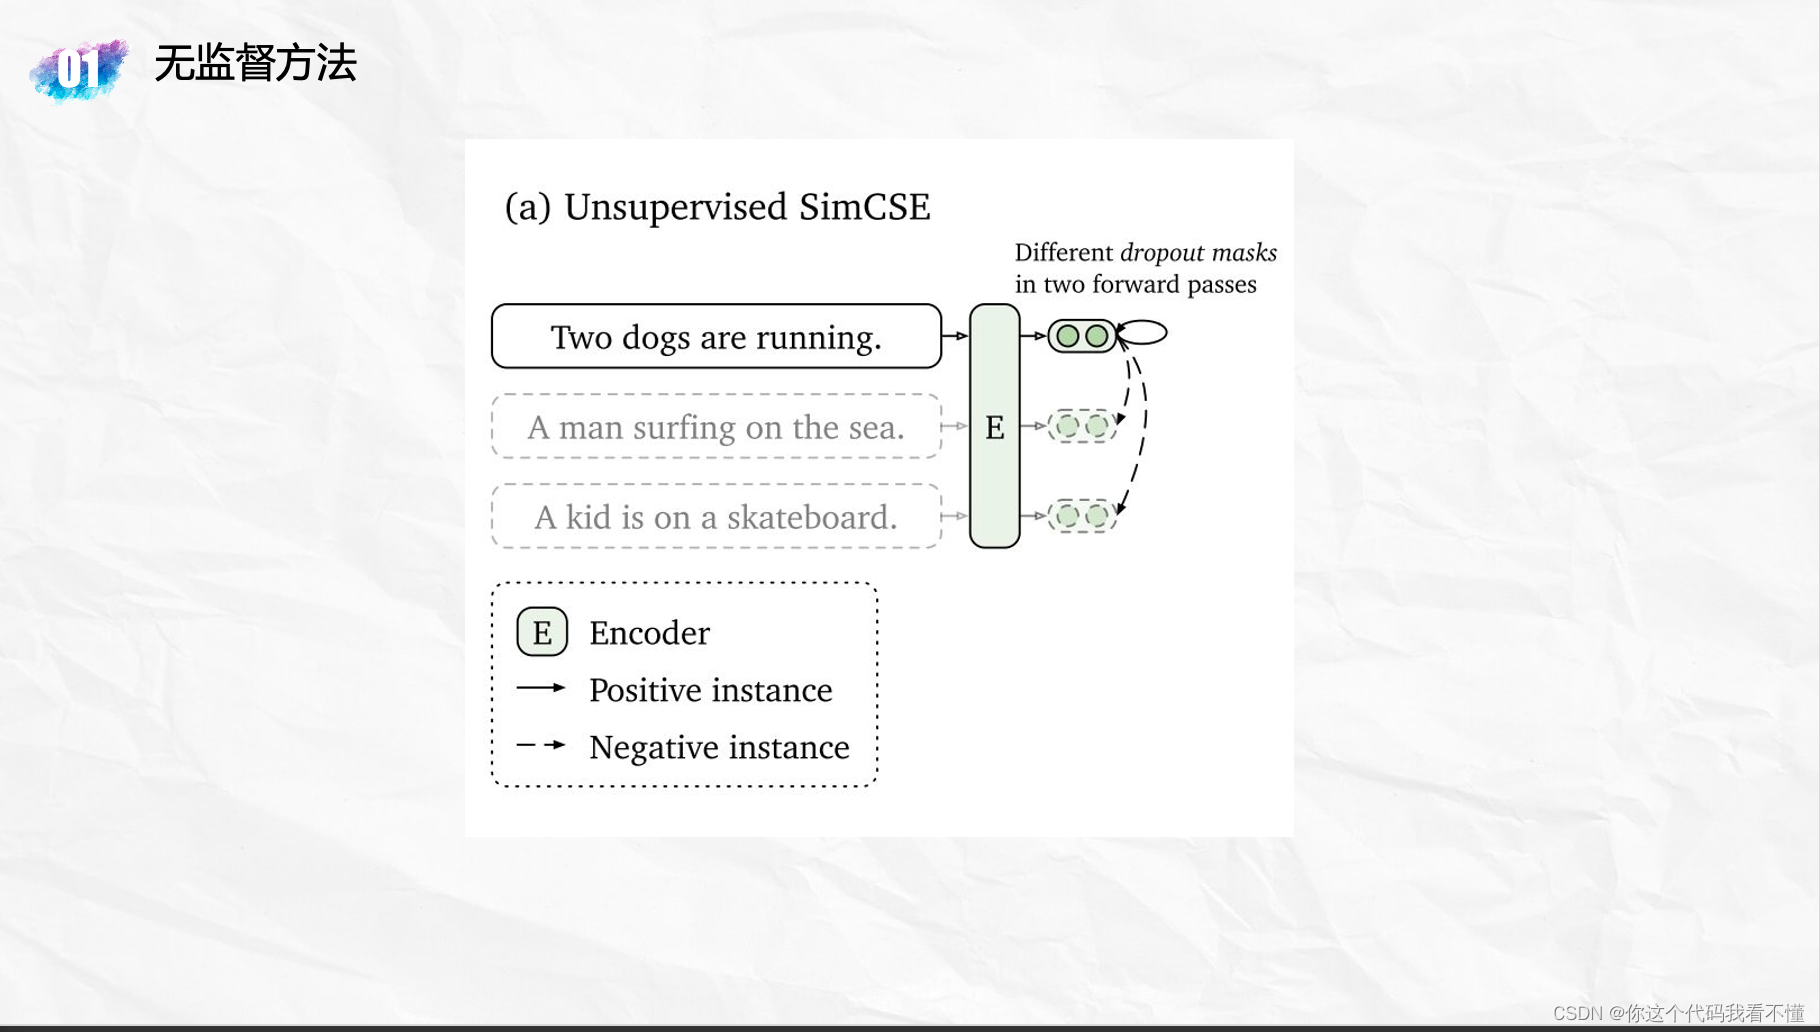
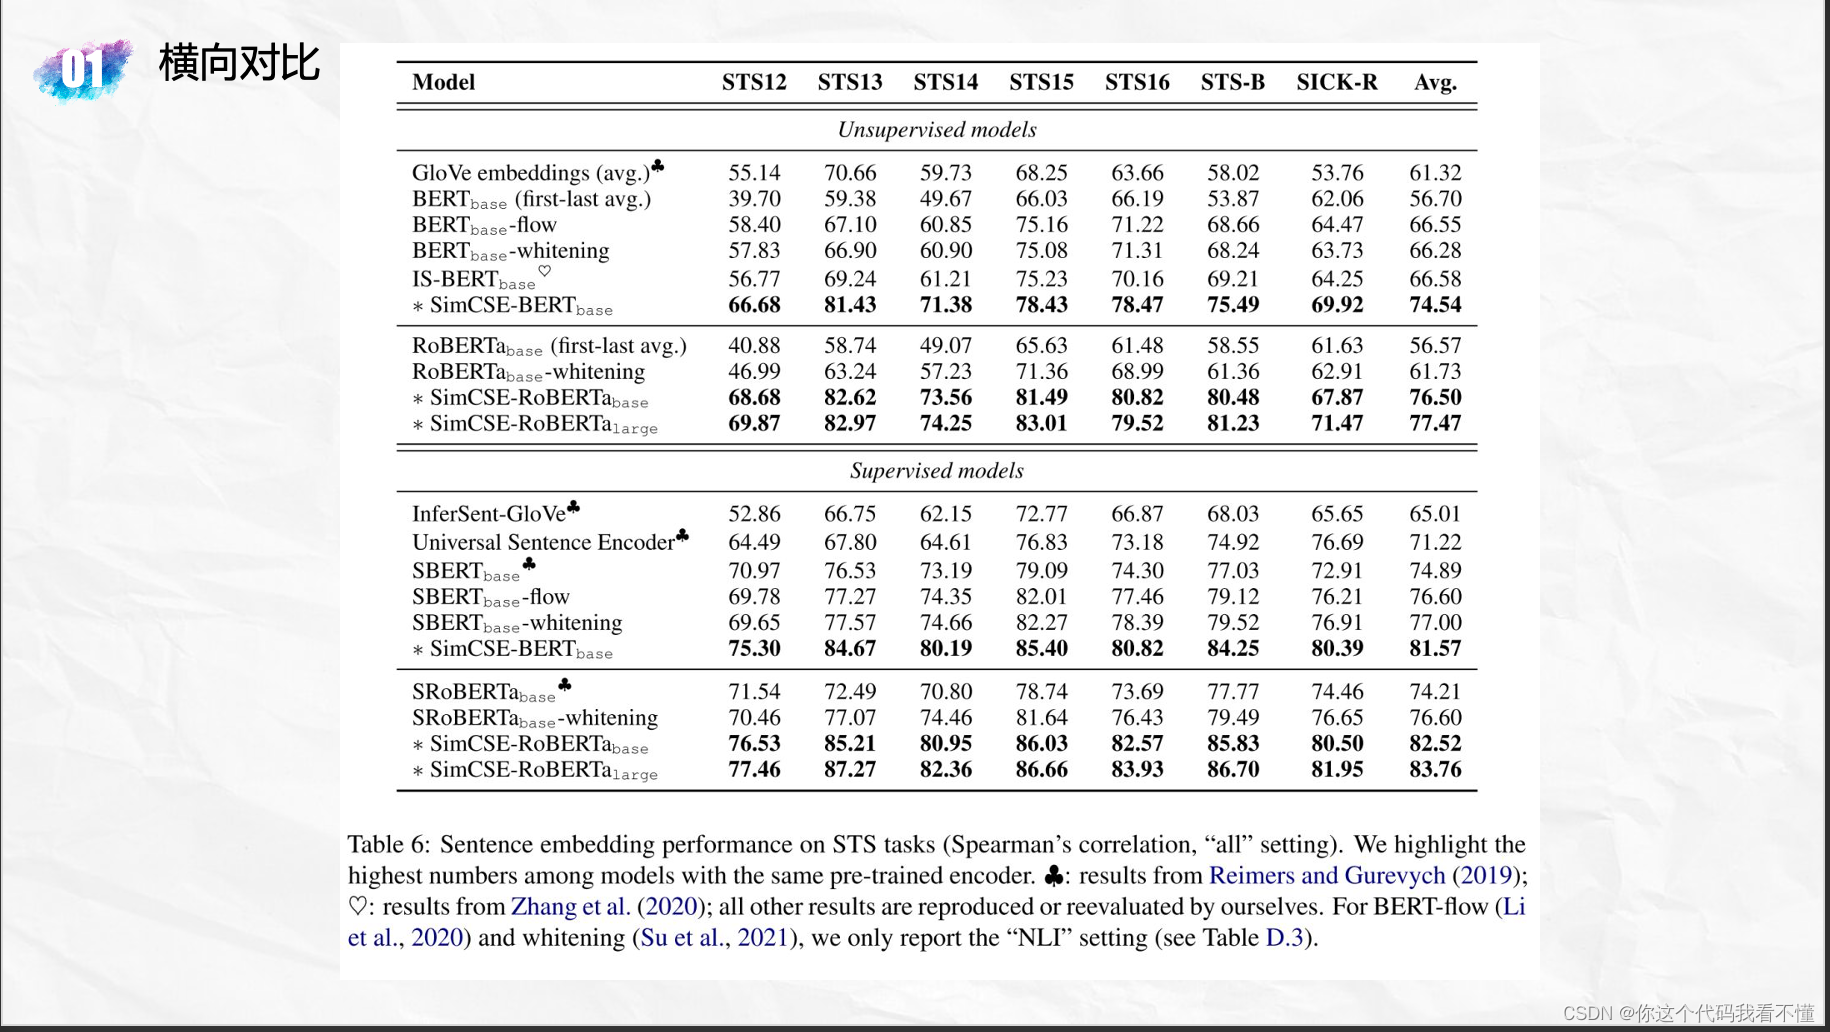
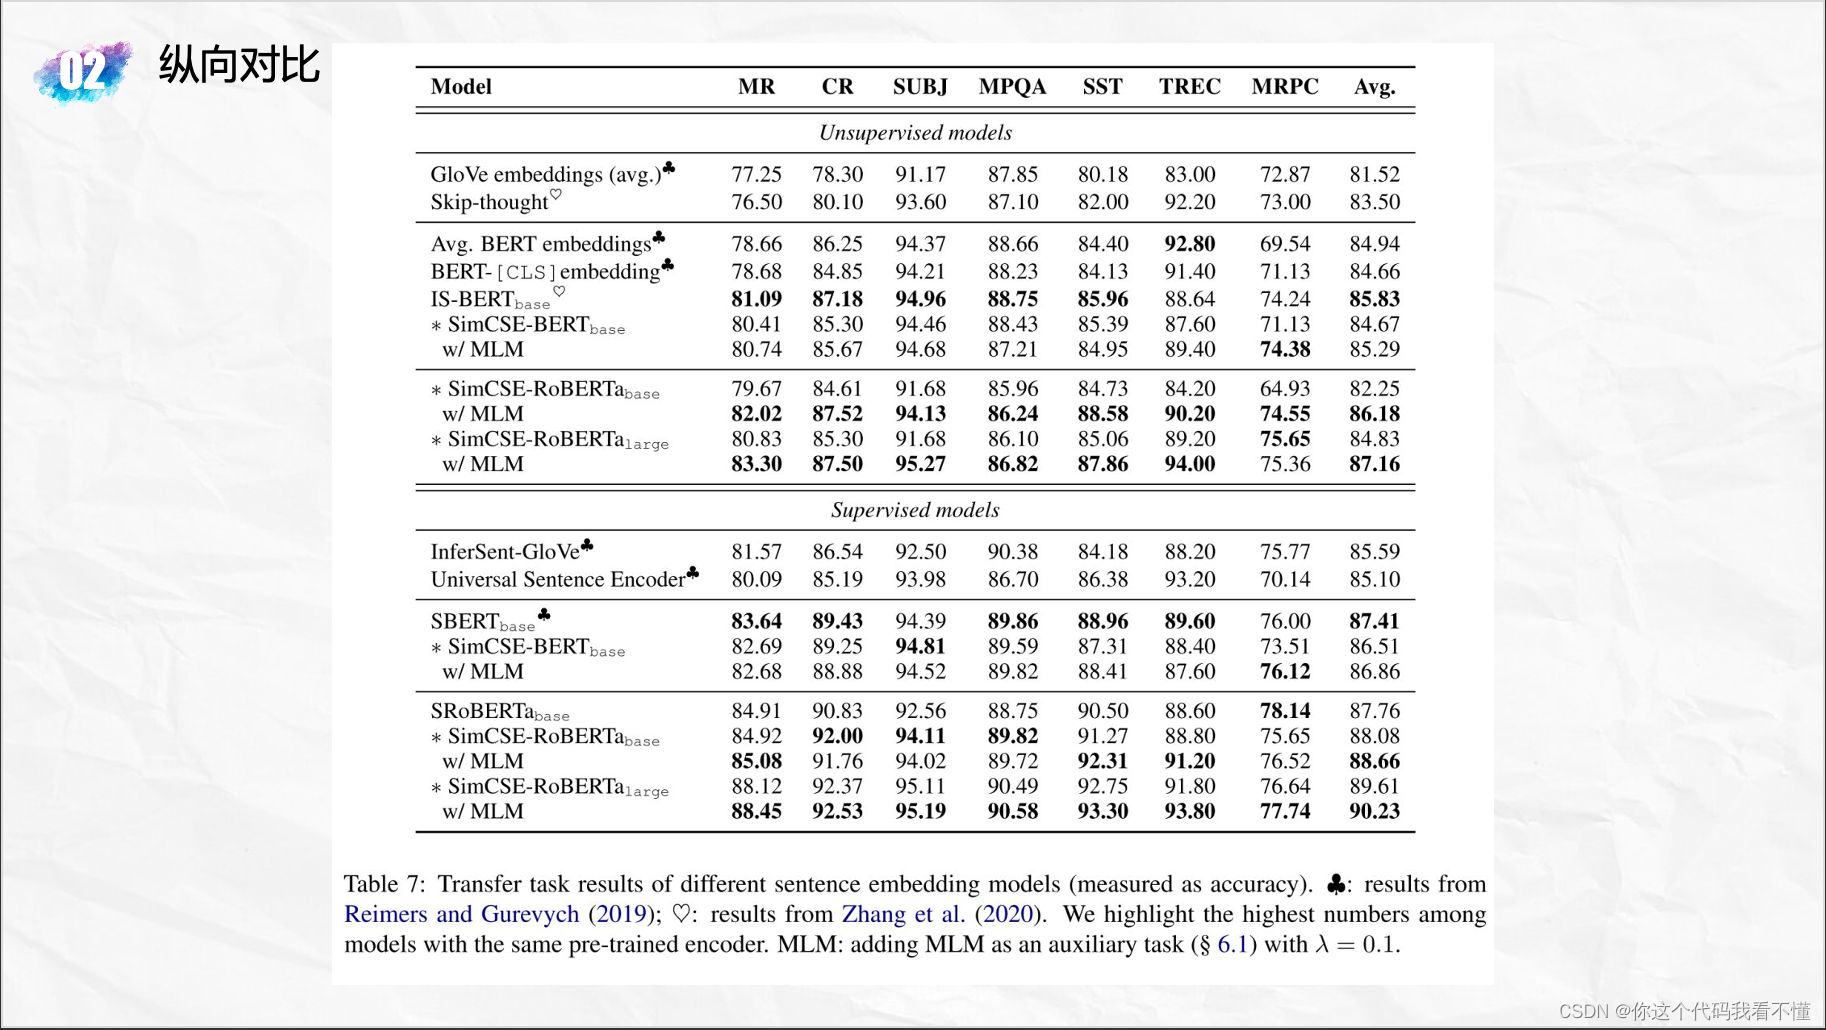
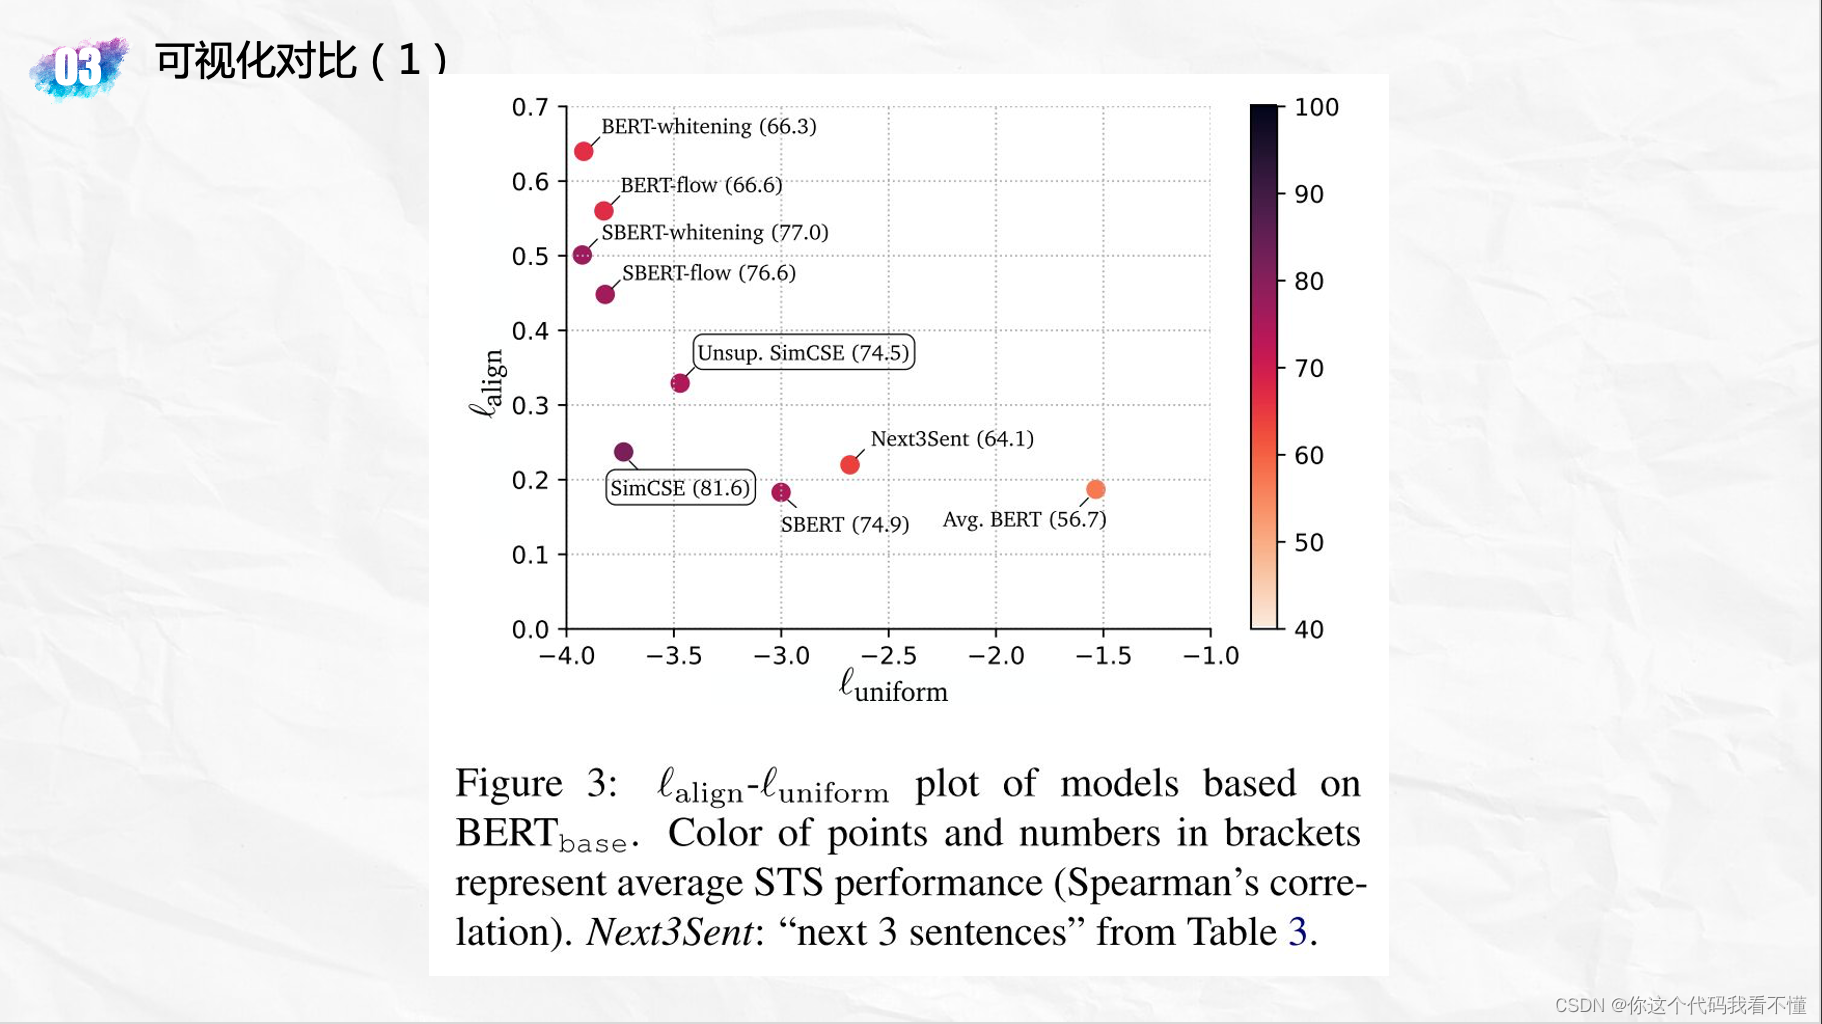
SimCSE: Simple Contrastive Learning of Sentence Embeddings
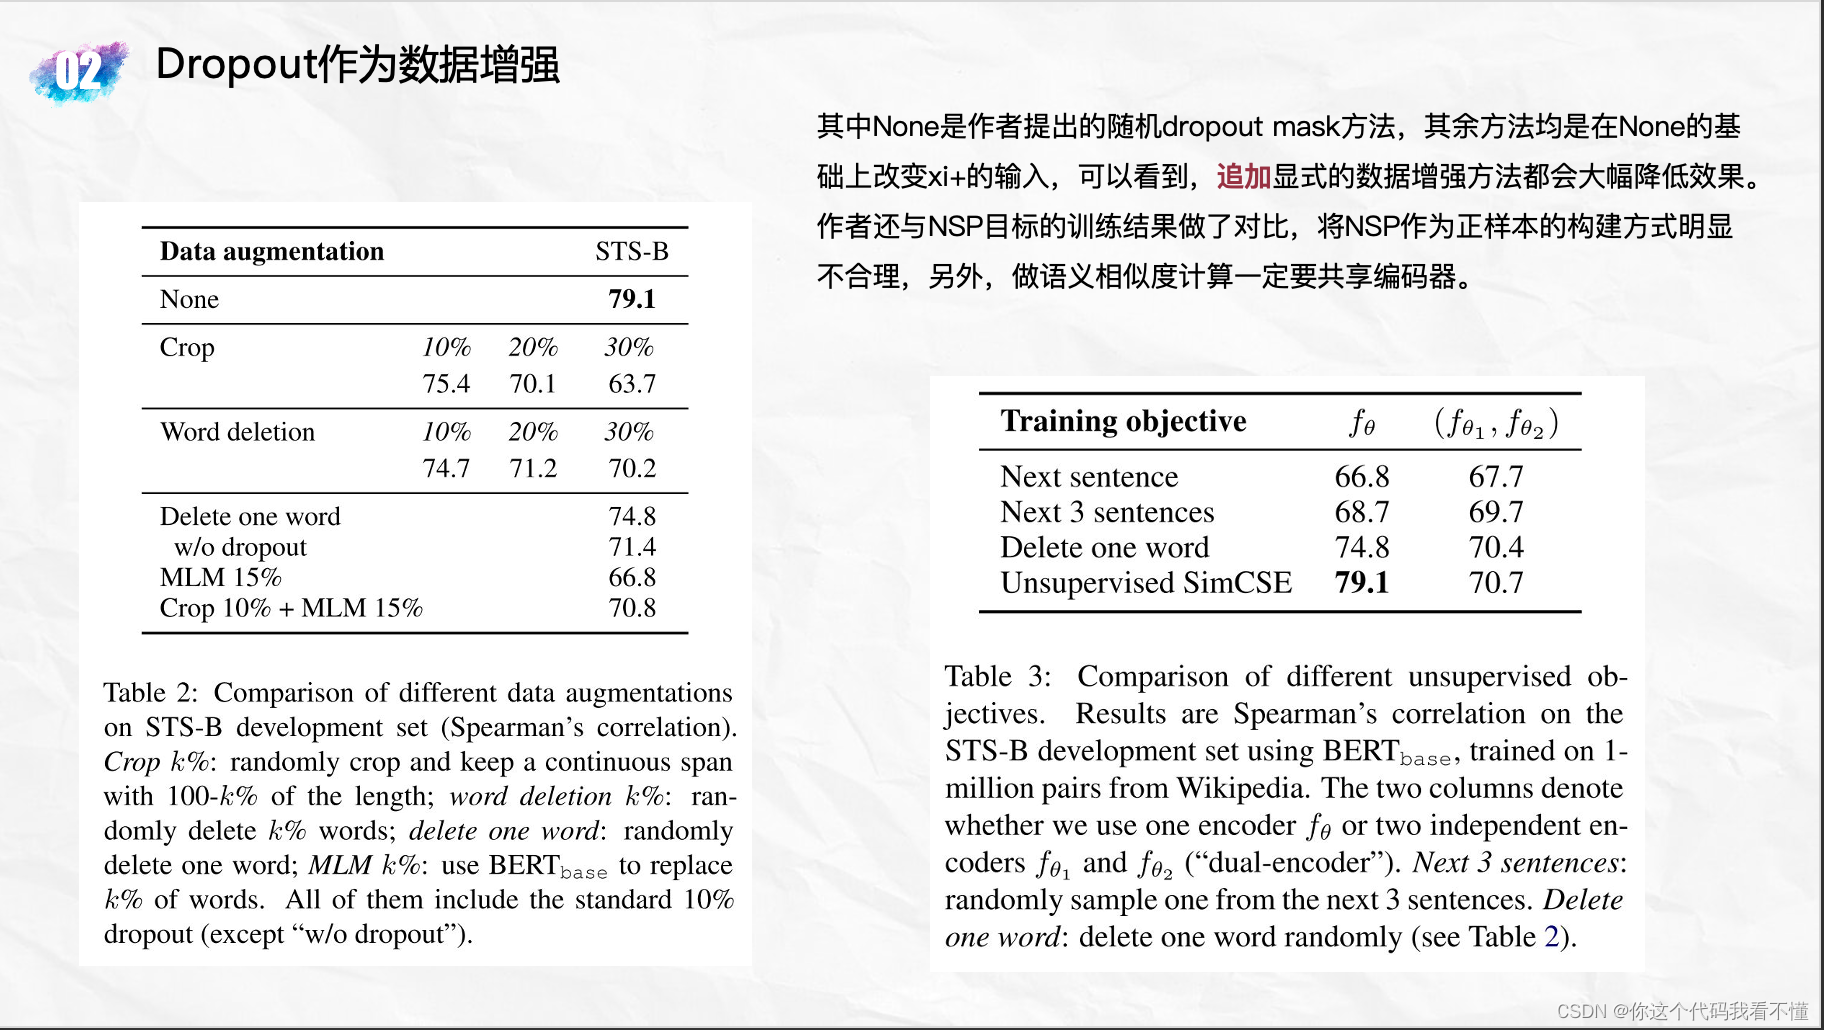
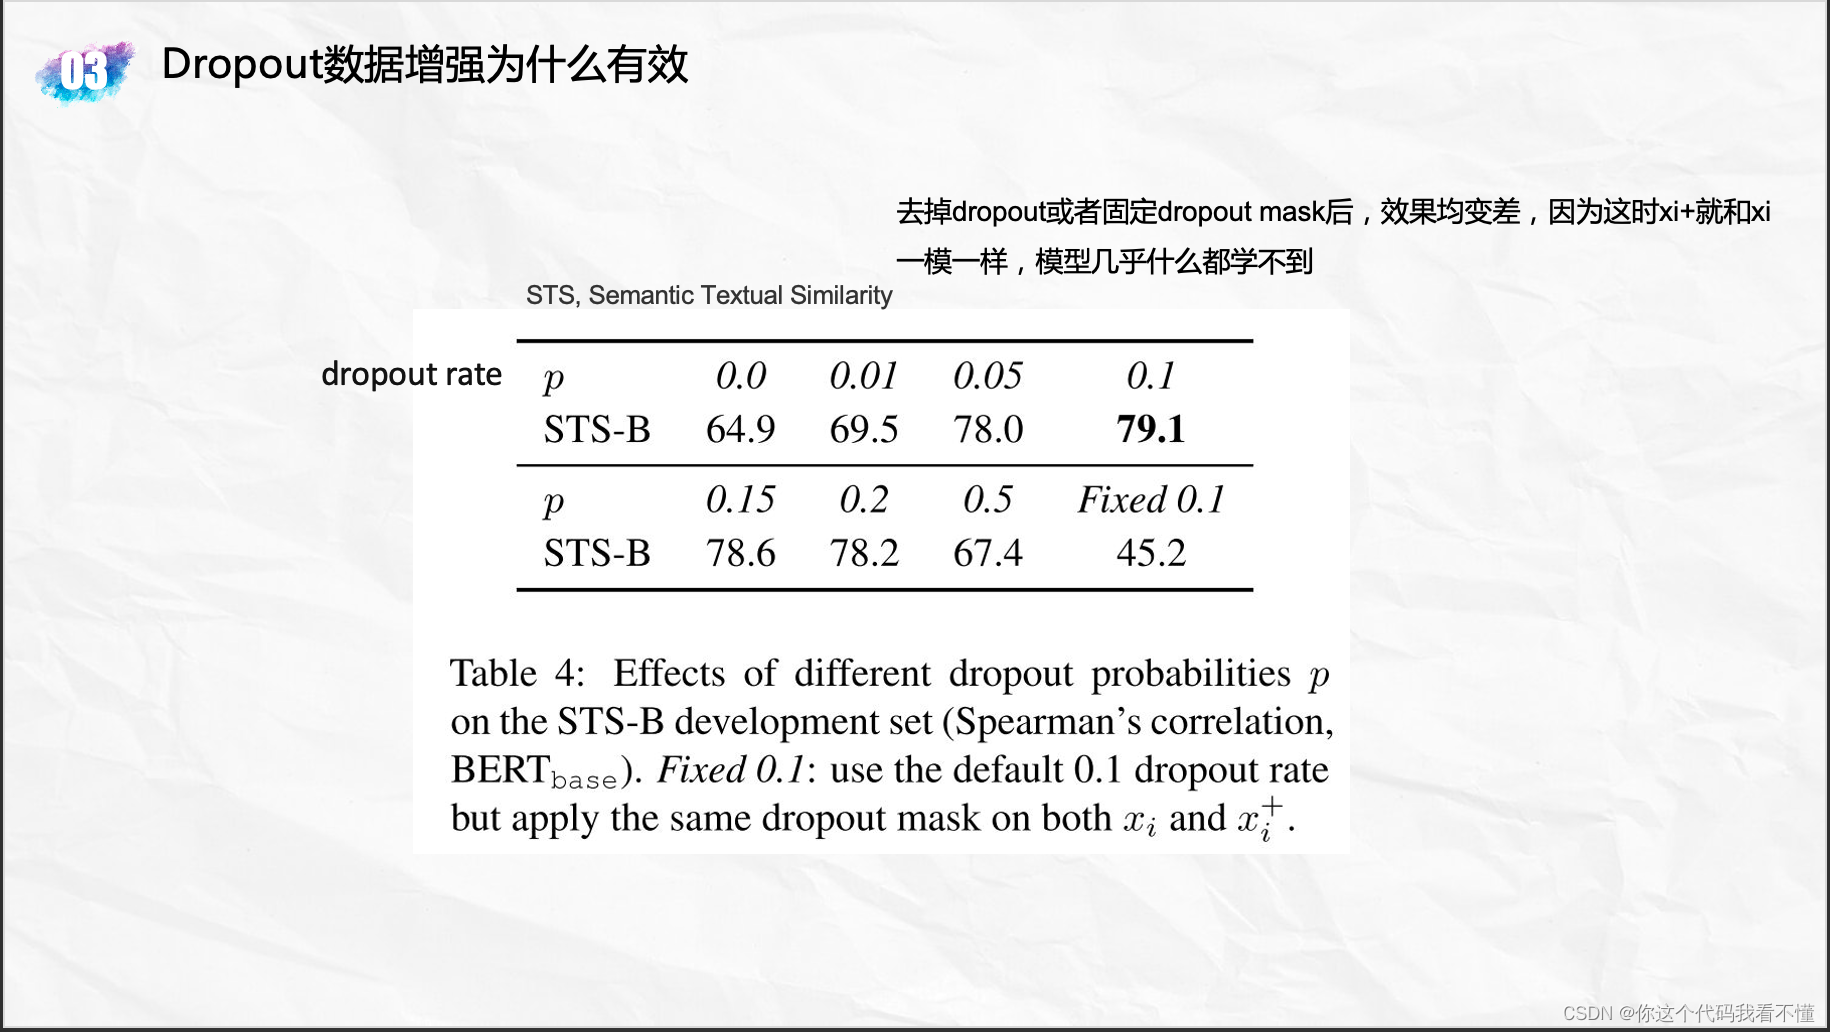
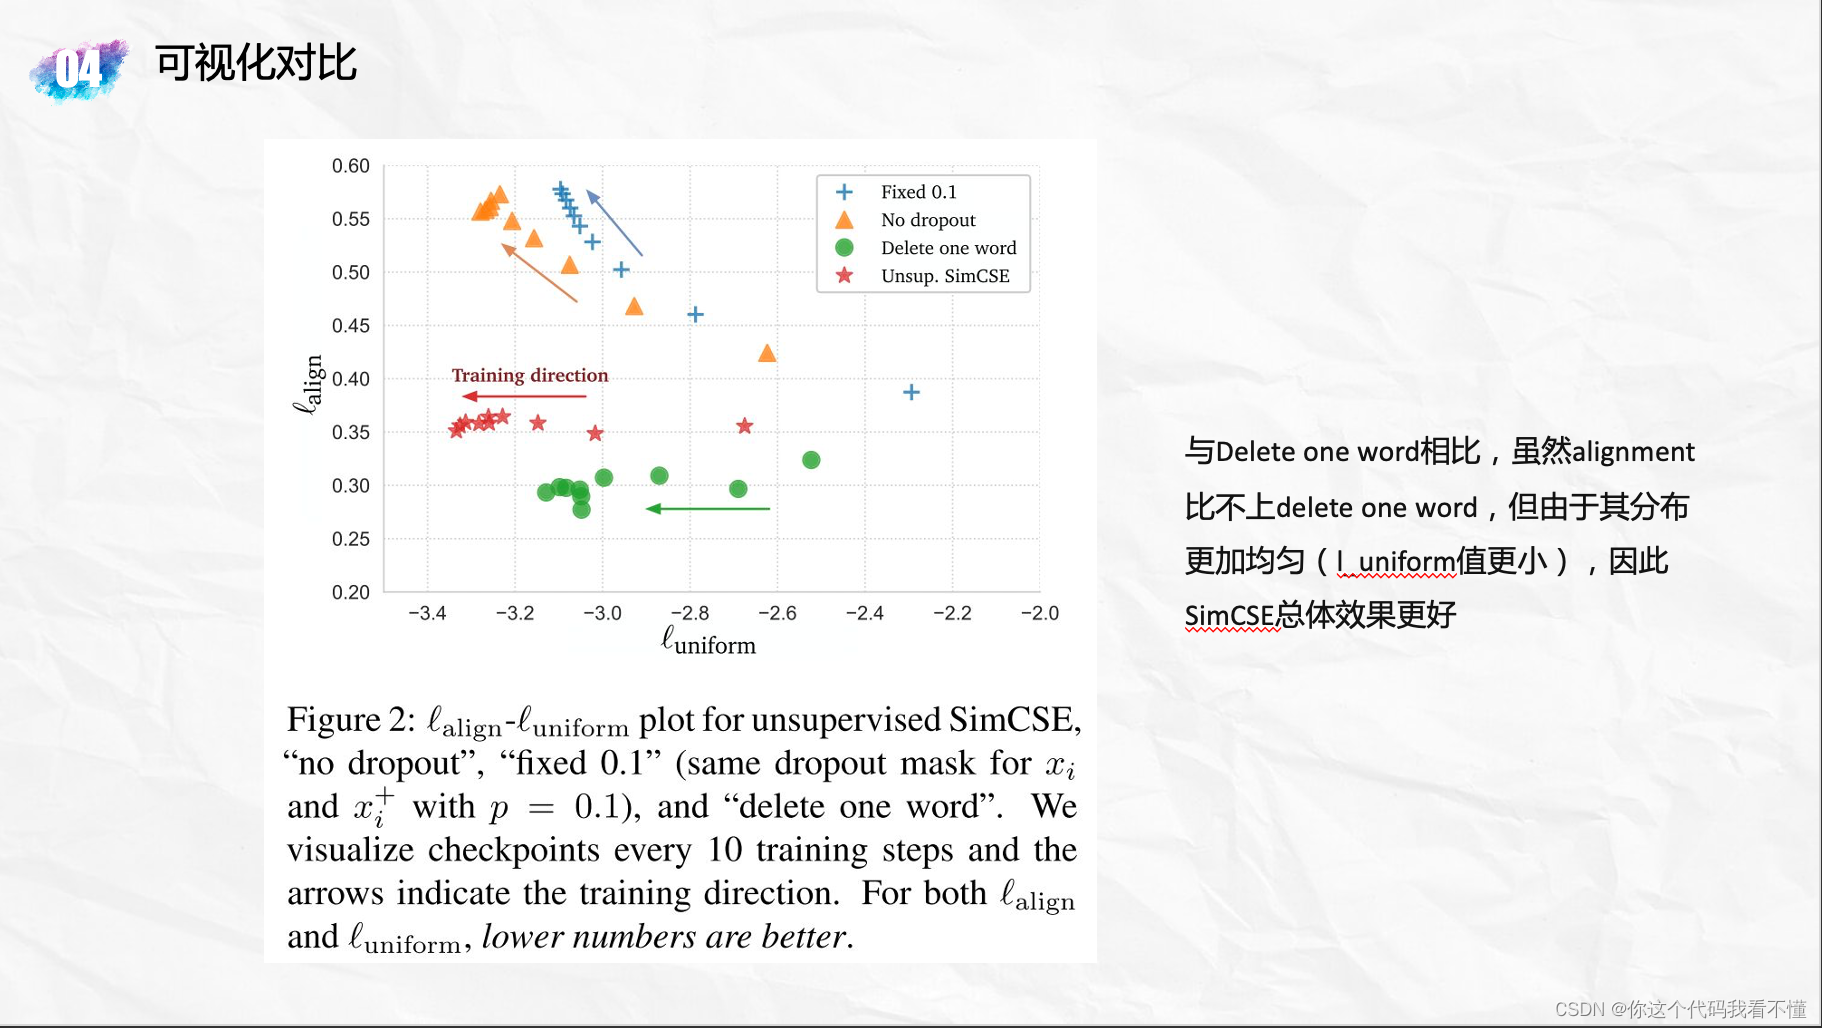
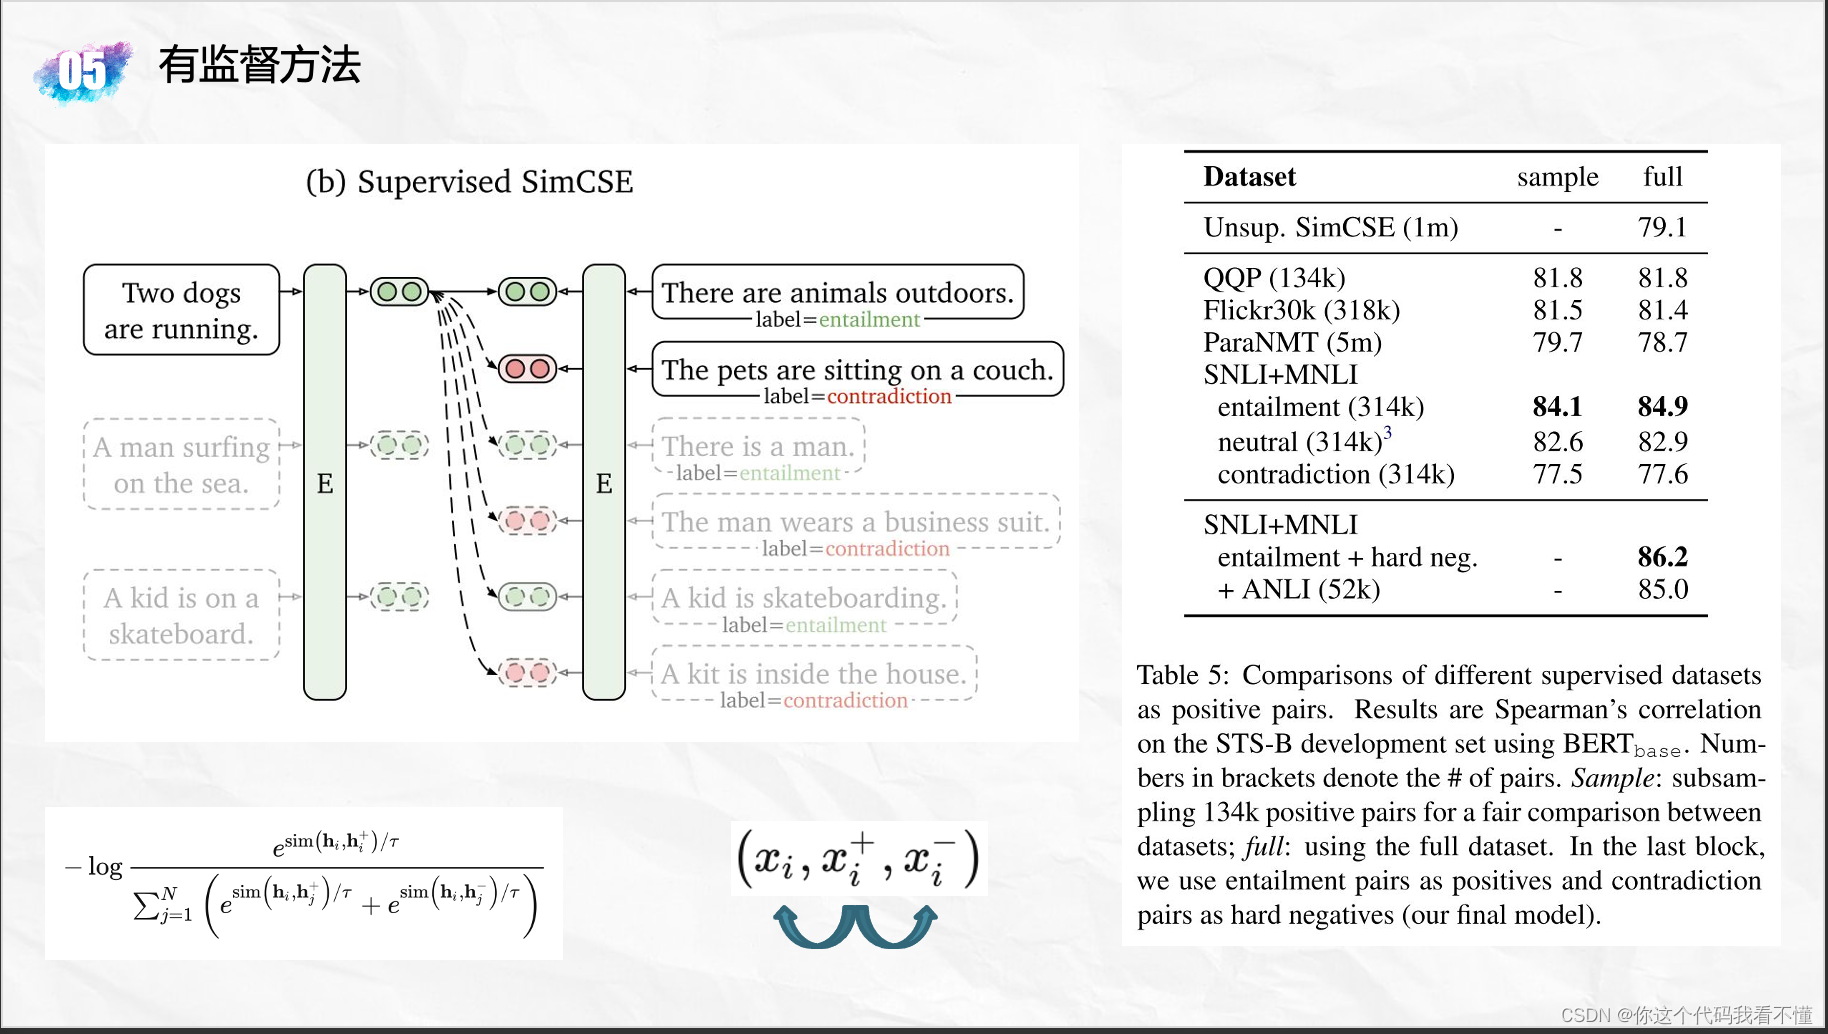

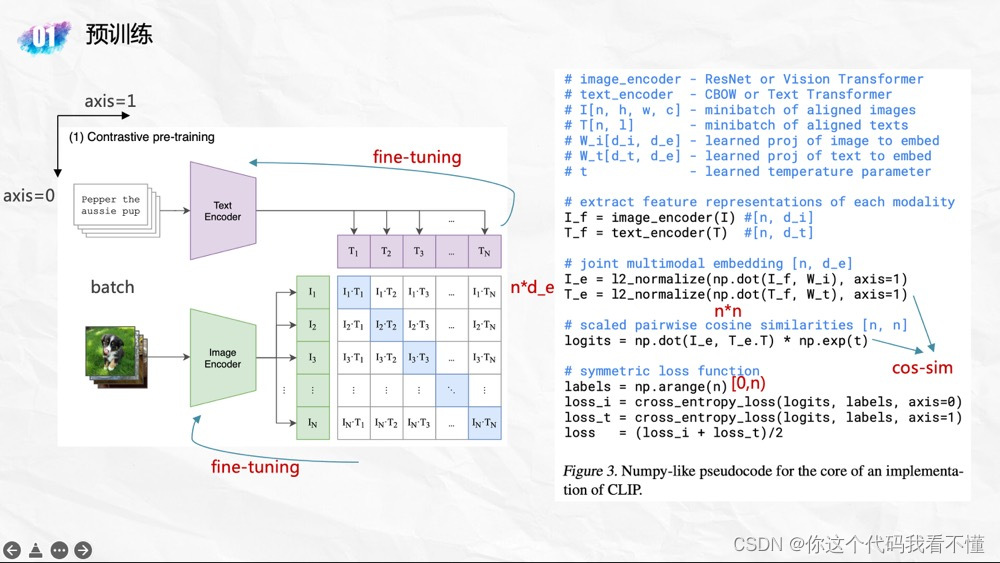
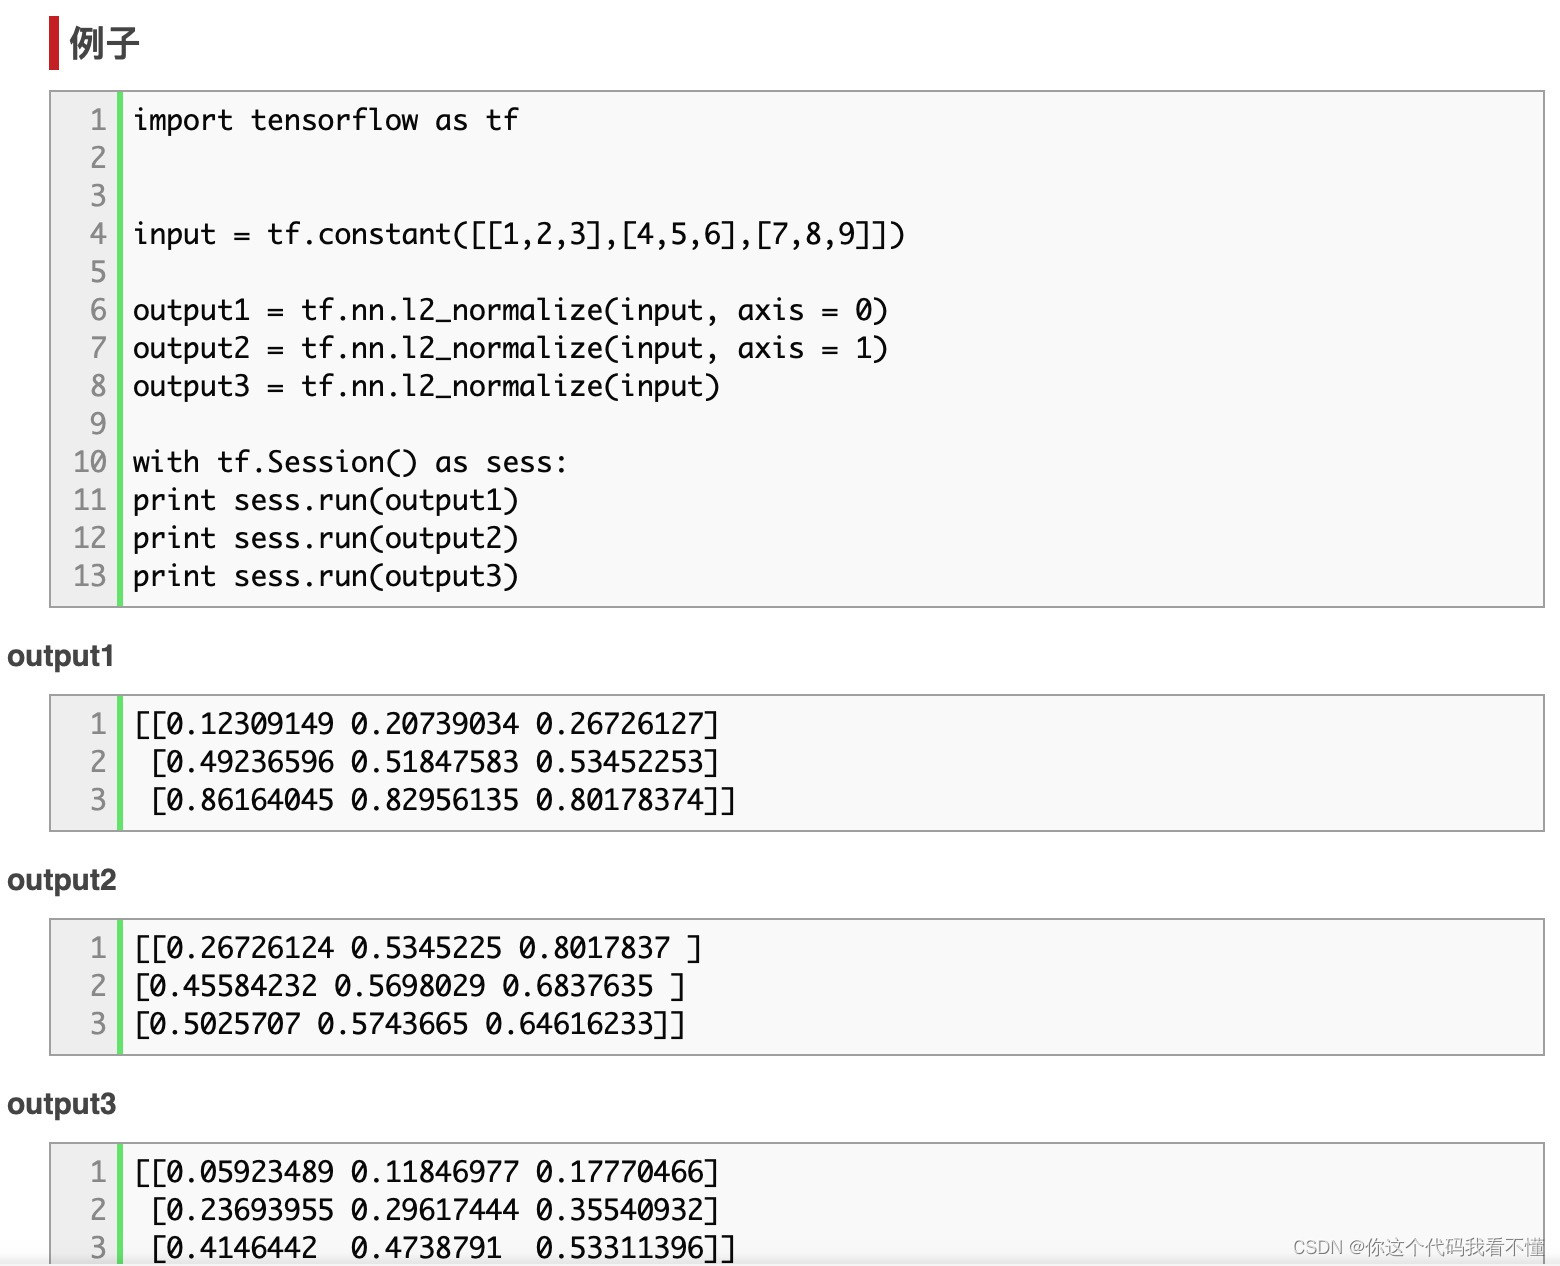
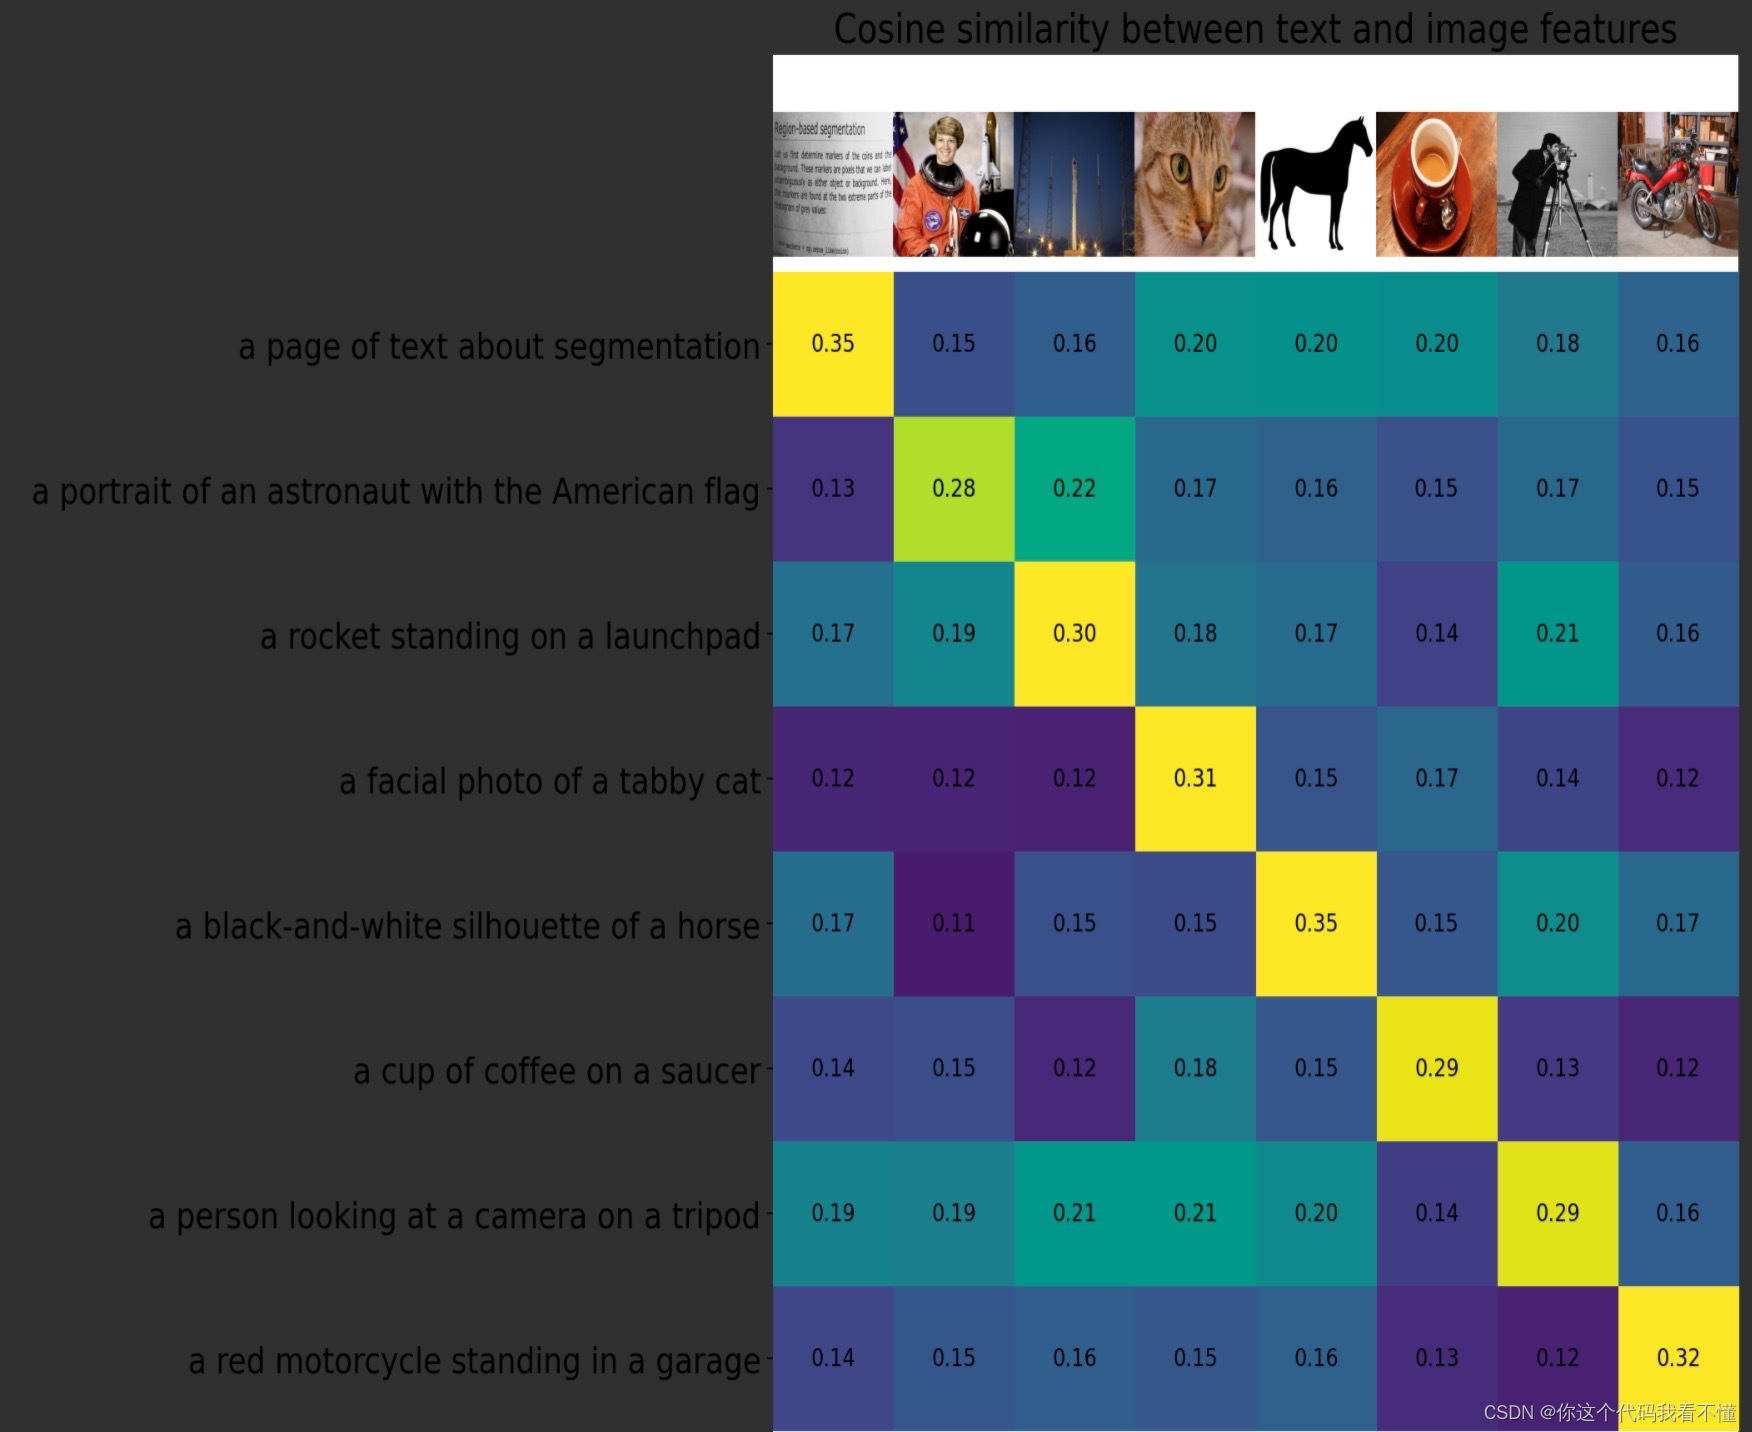
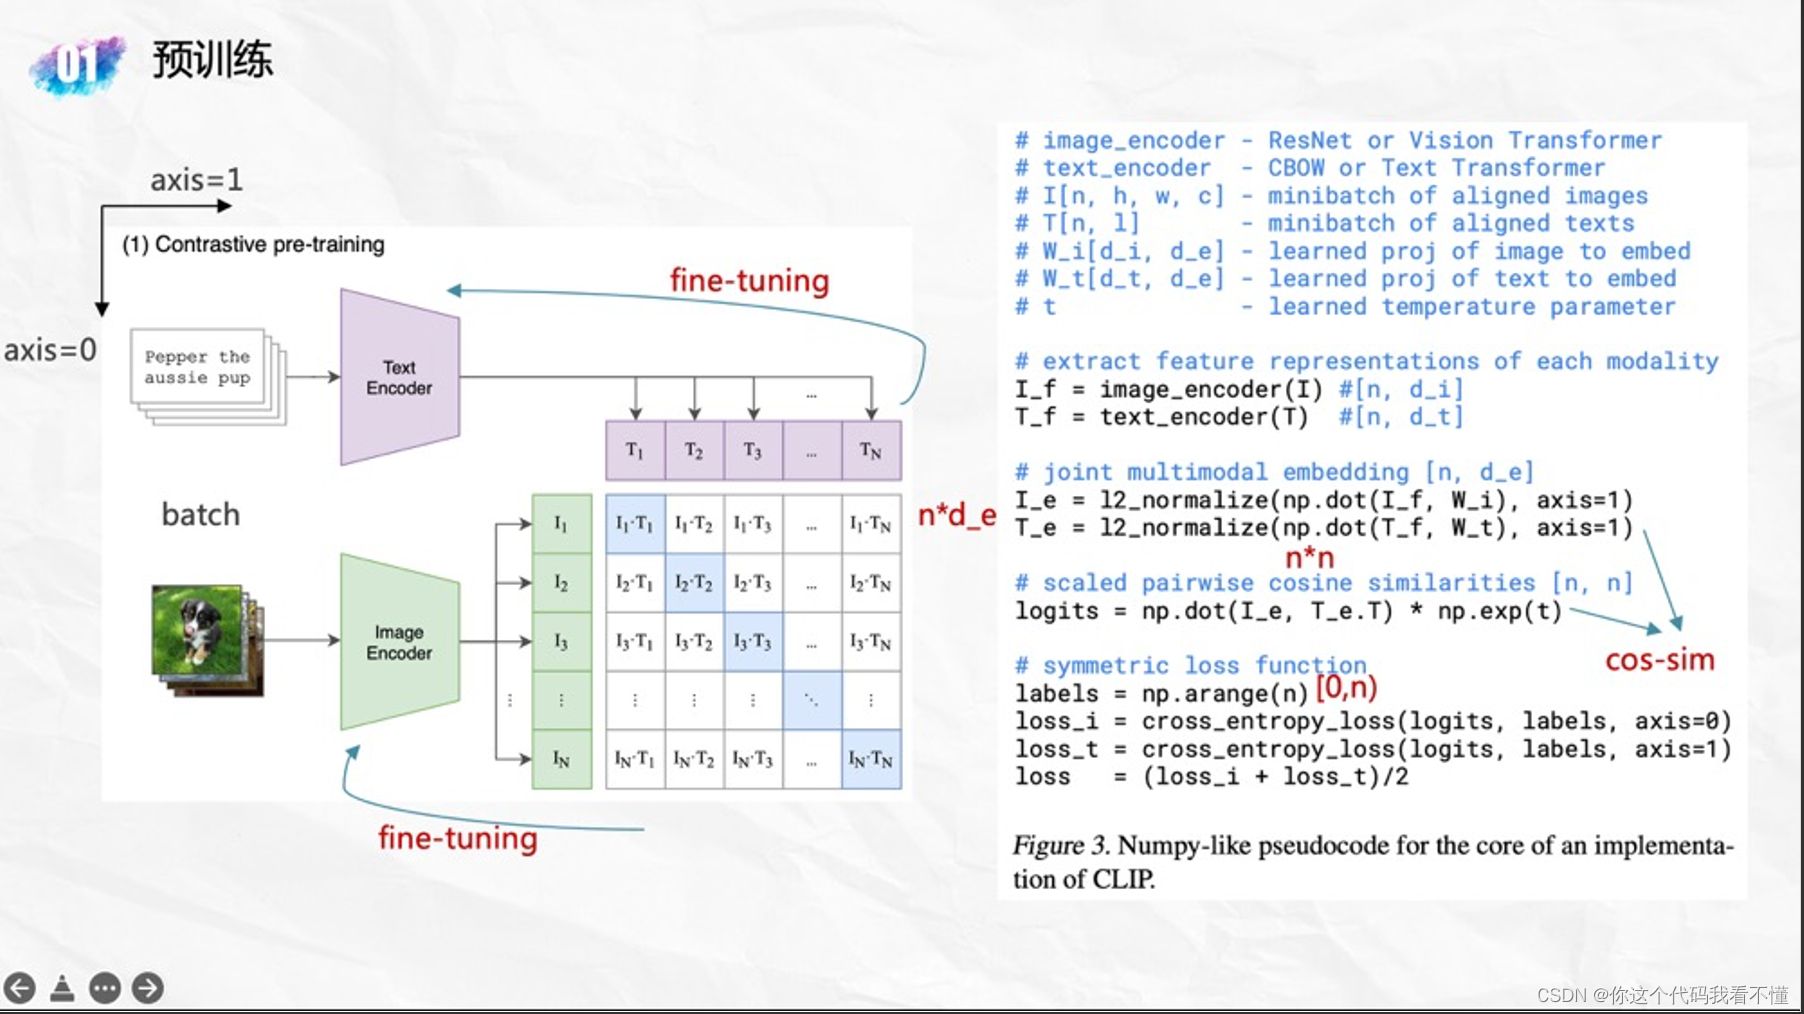
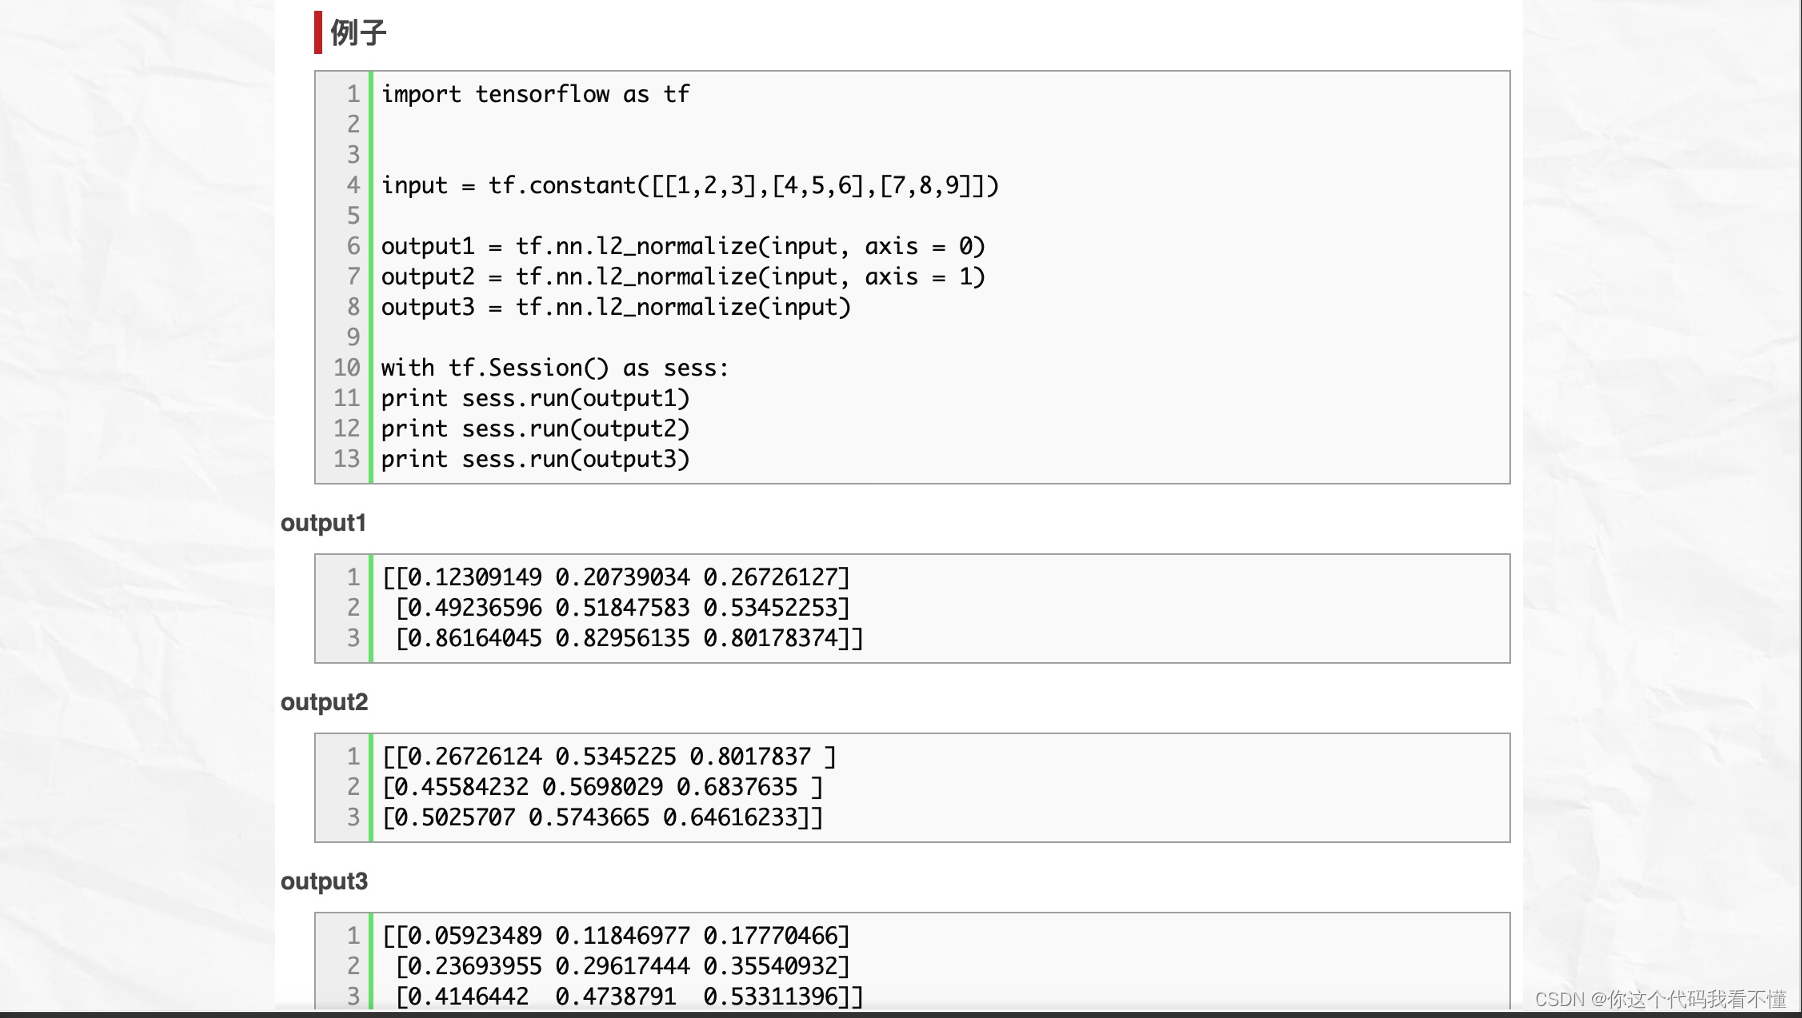
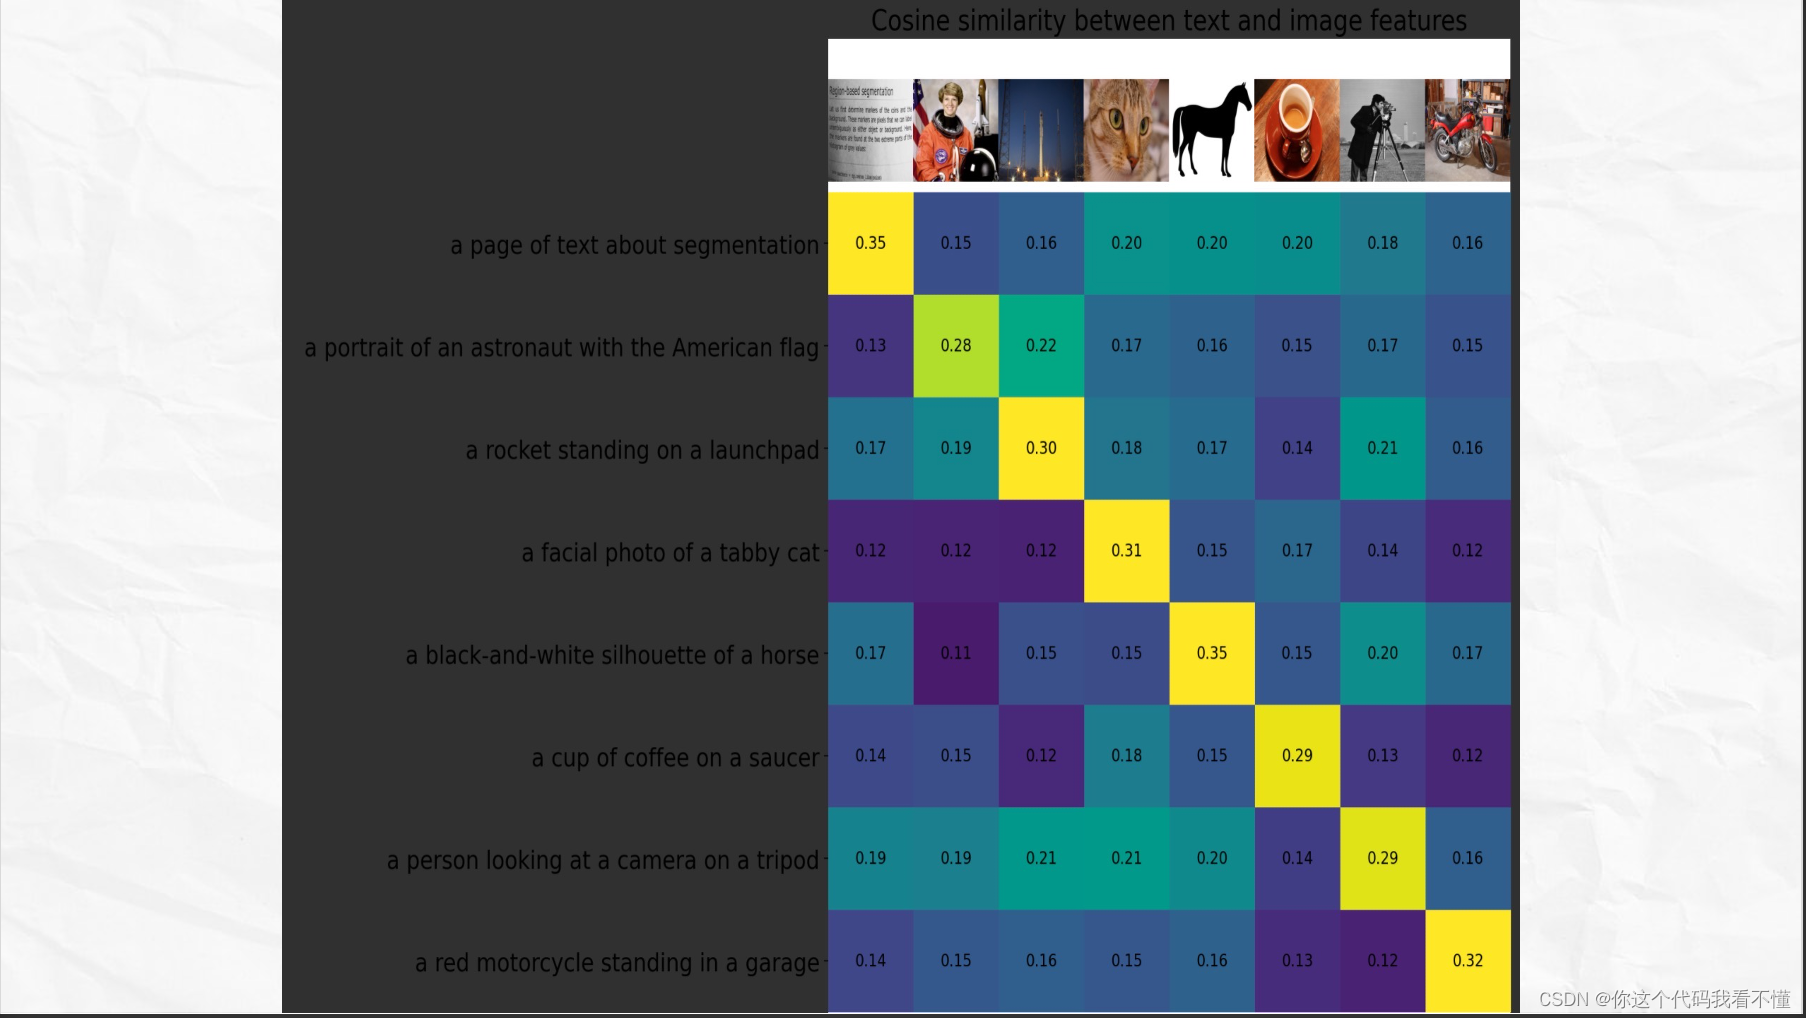
Learning Transferable Visual Models From Natural Language Supervision
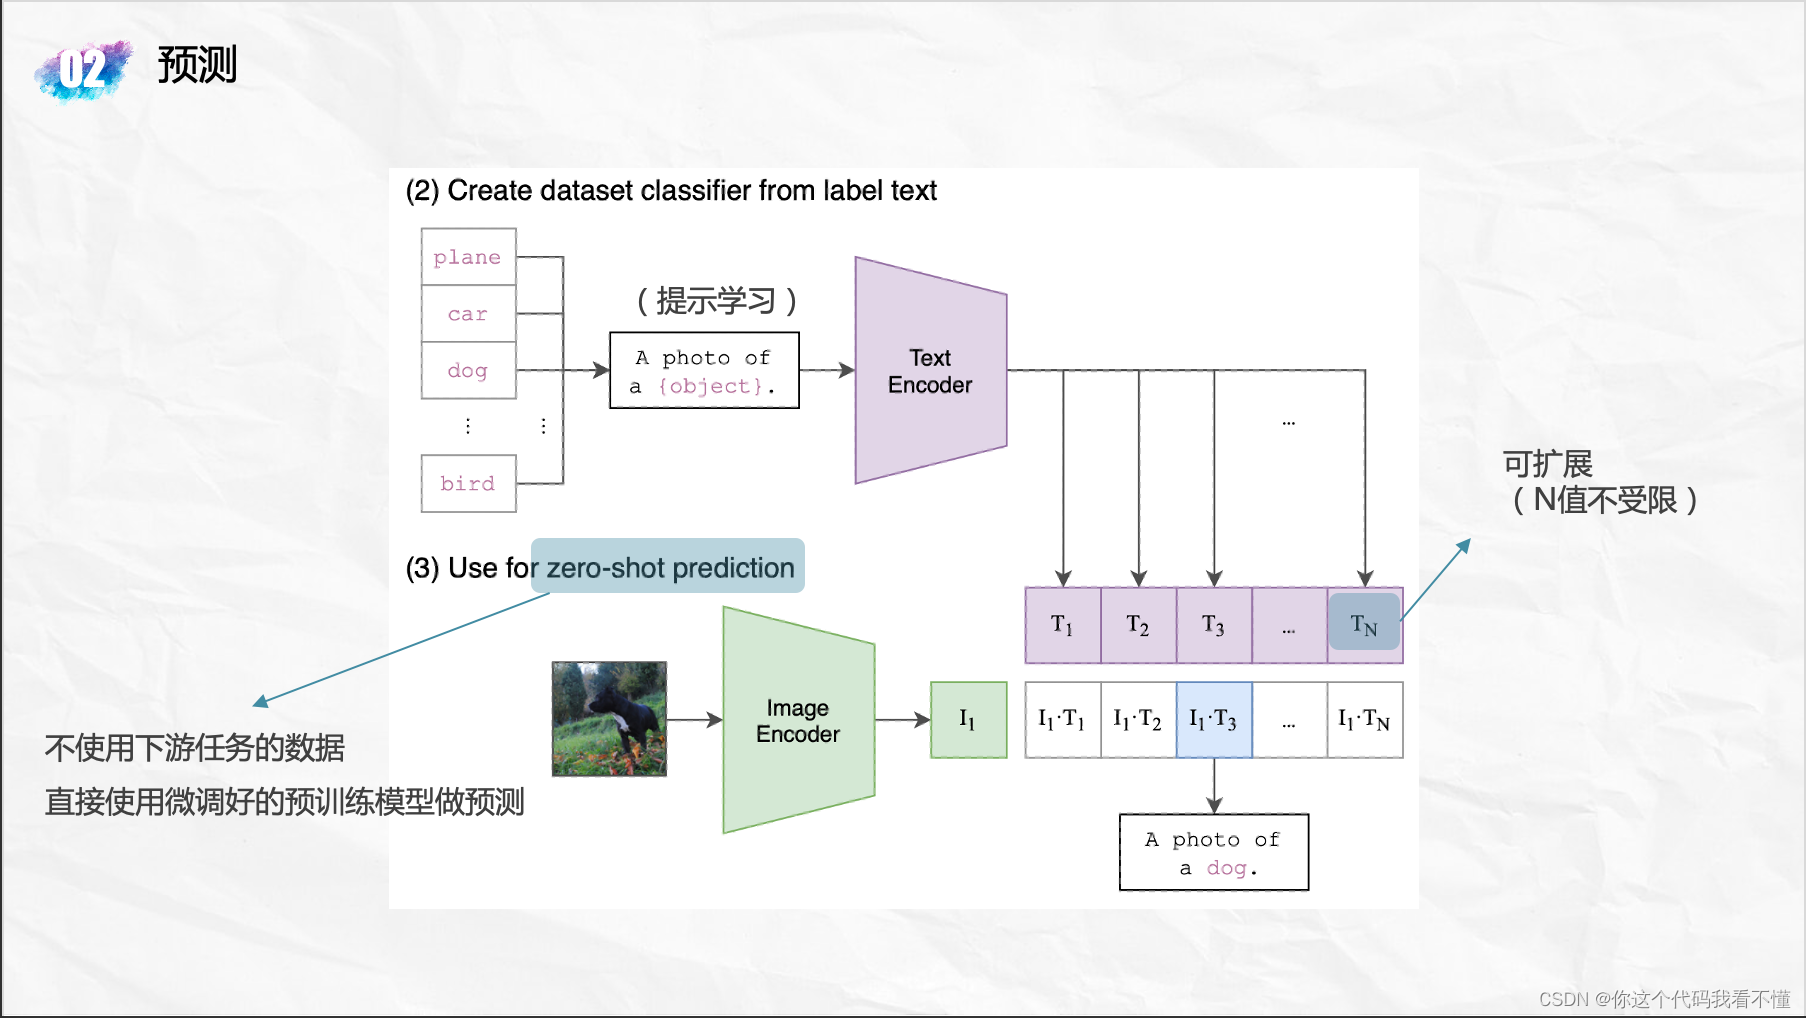
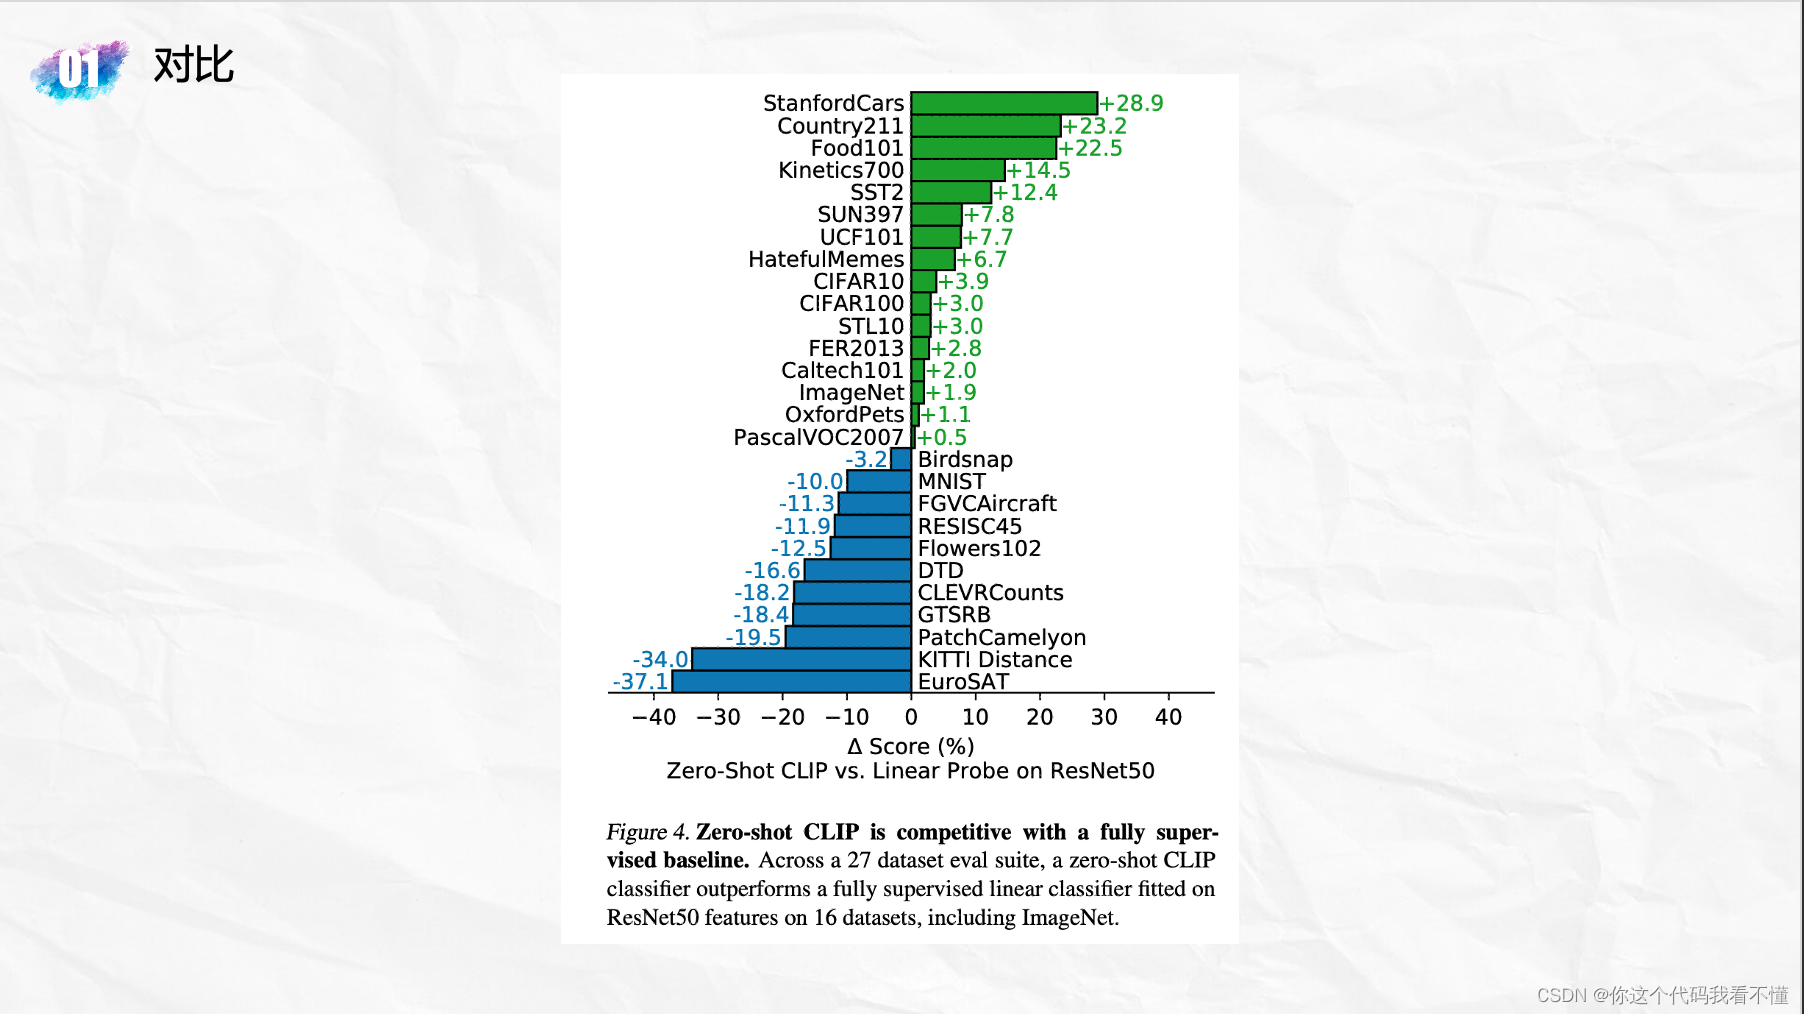
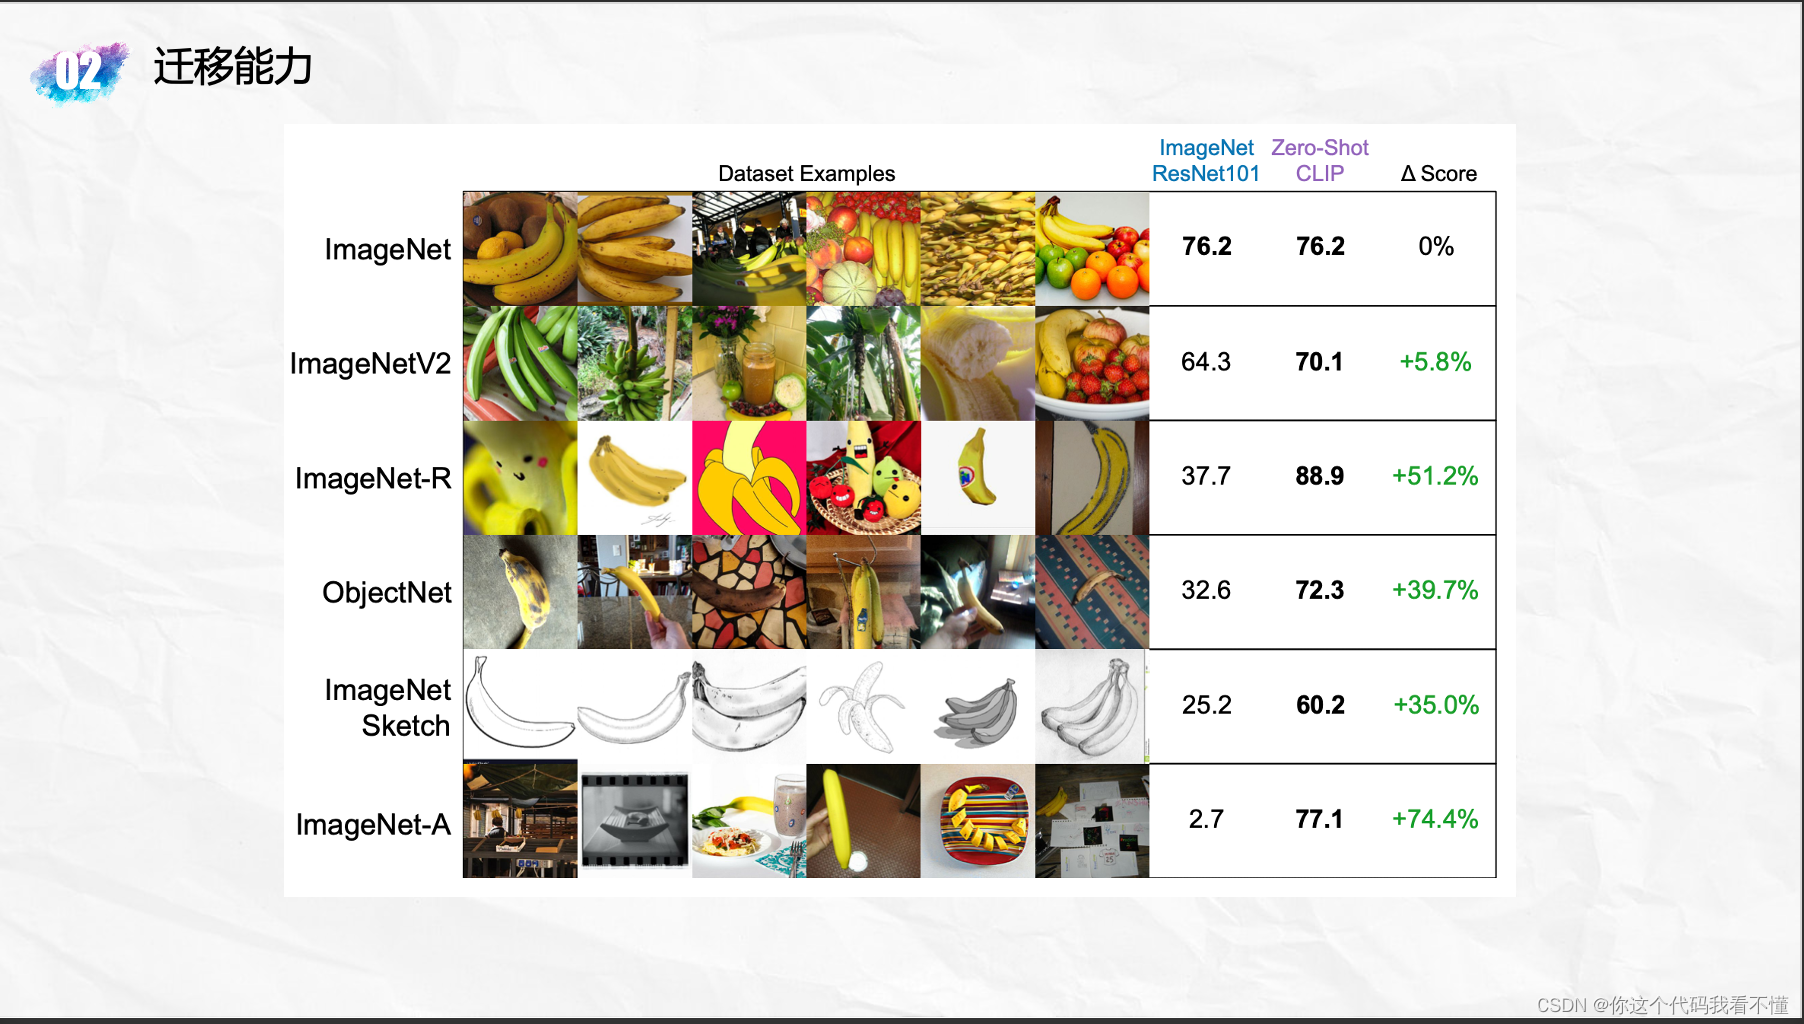
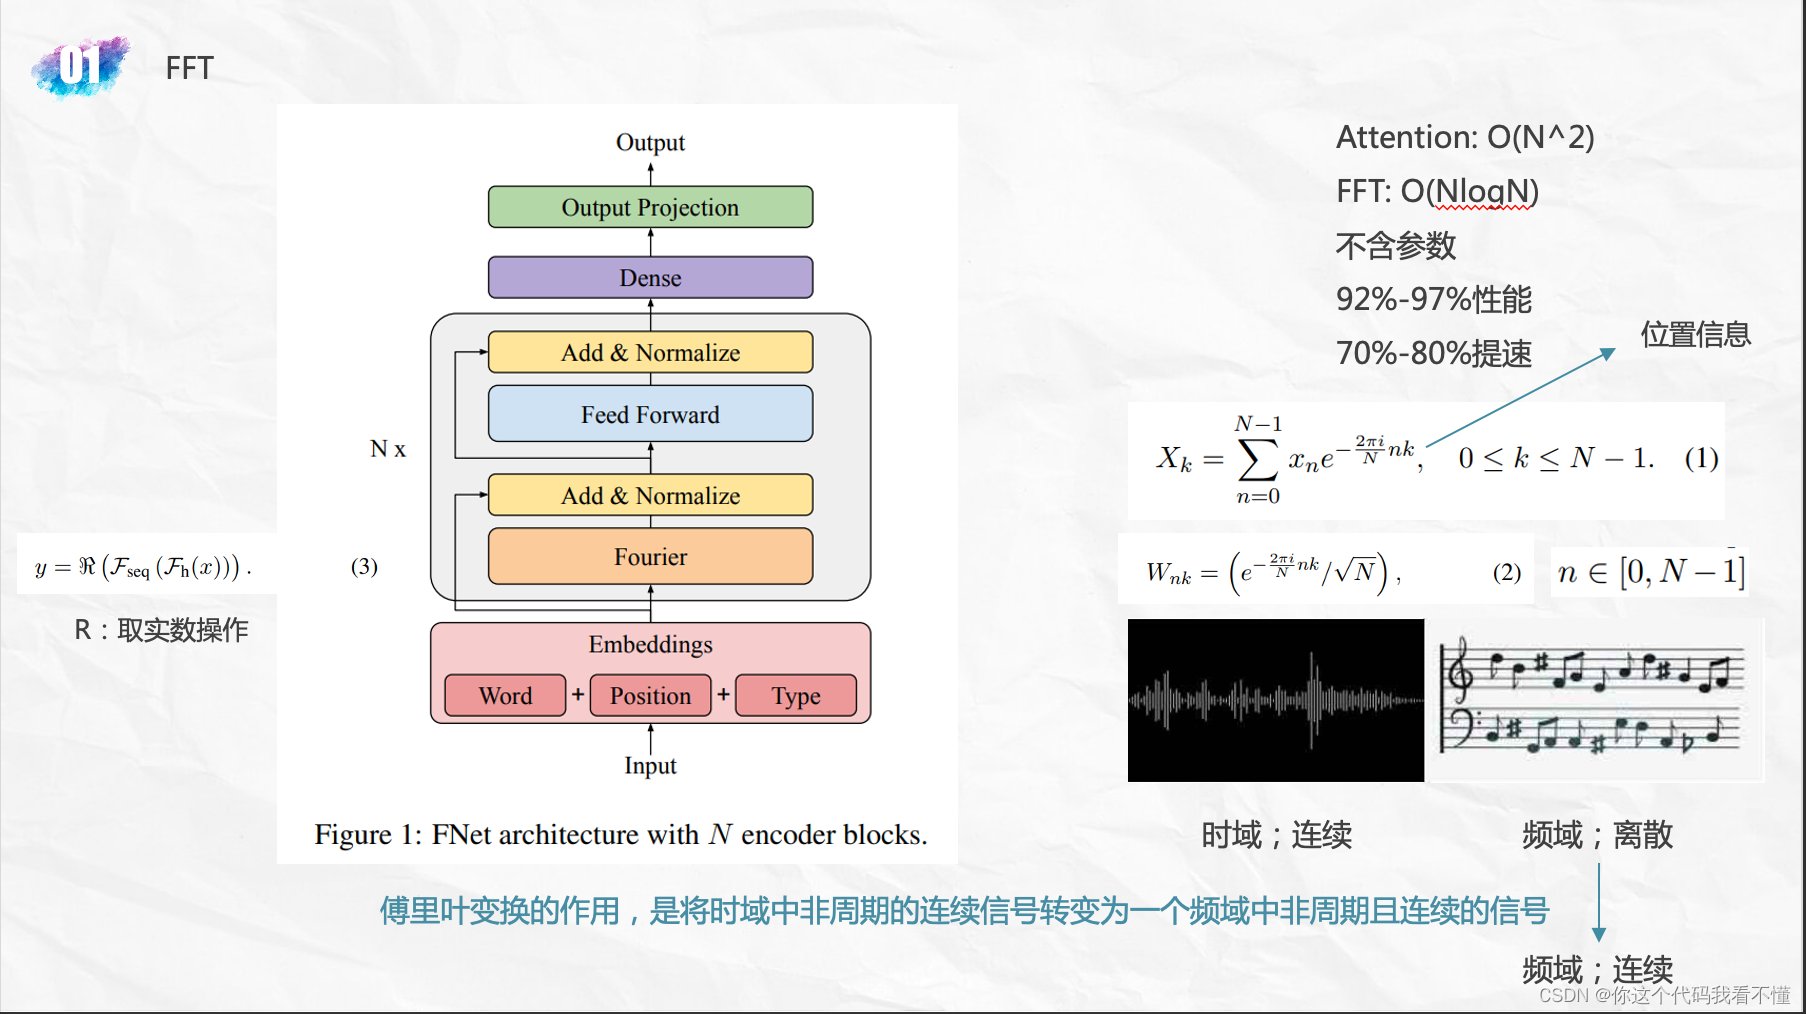
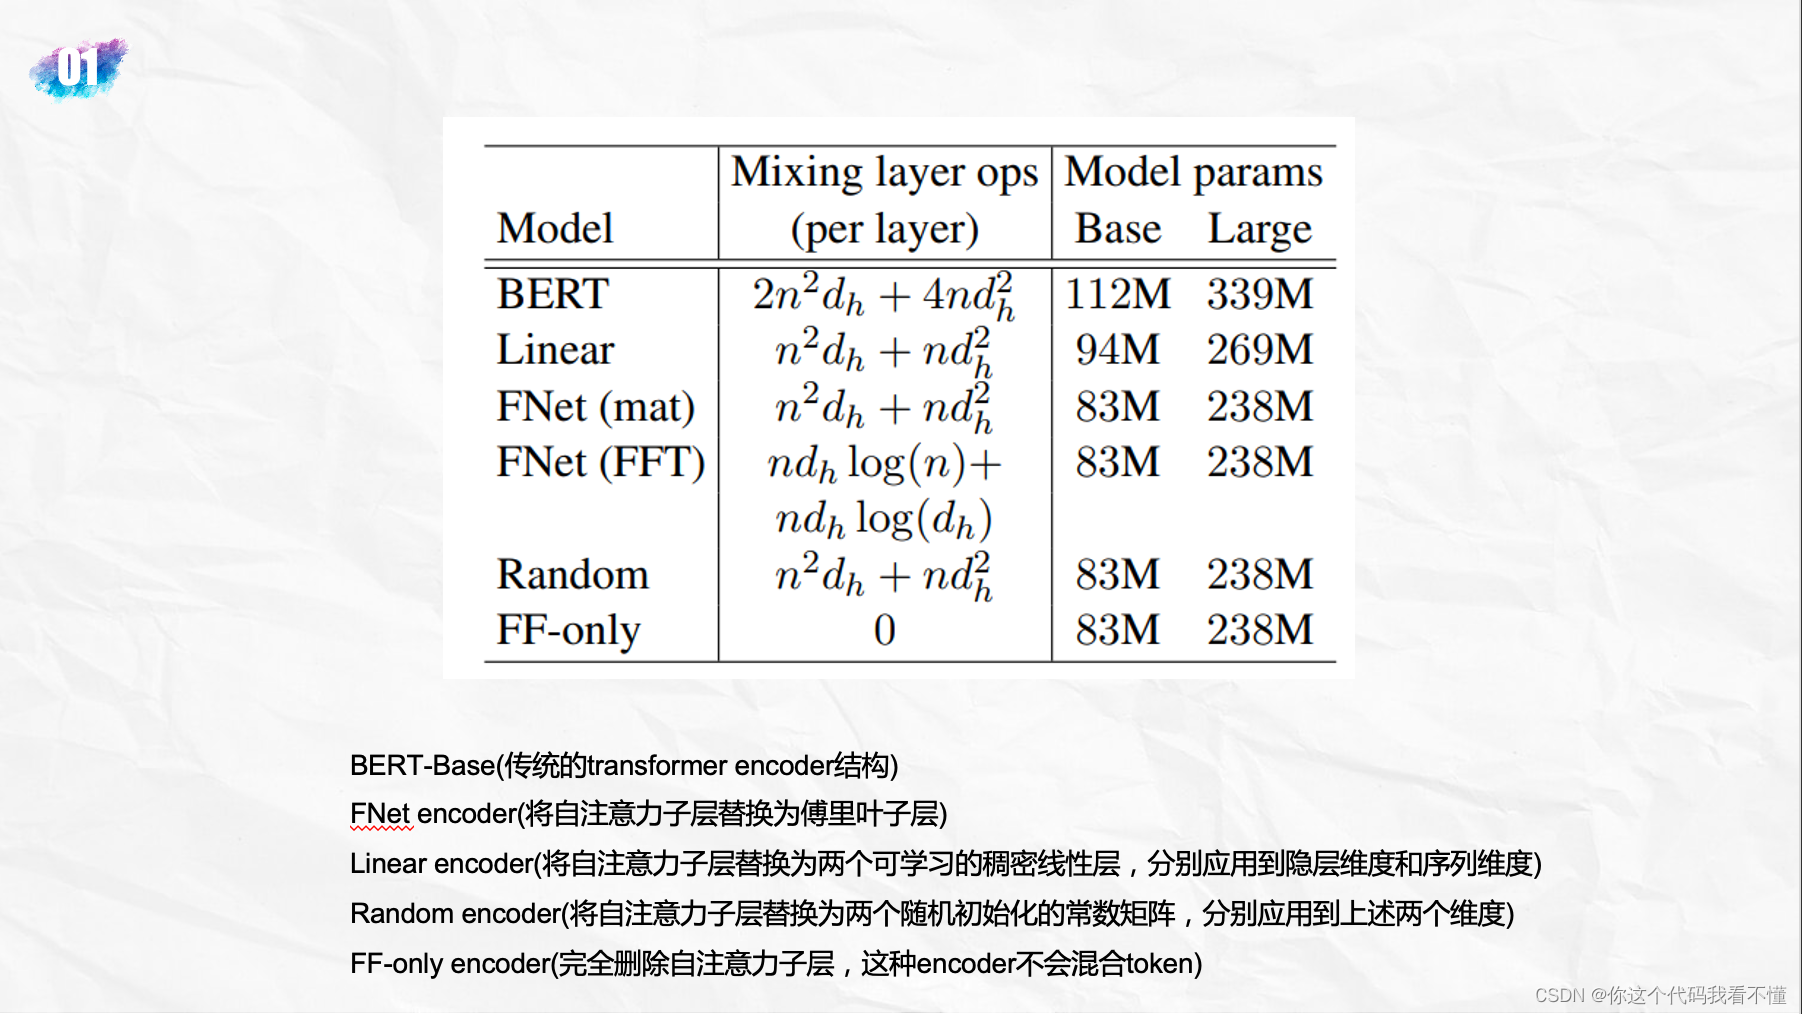
FNet: Mixing Tokens with Fourier Transforms
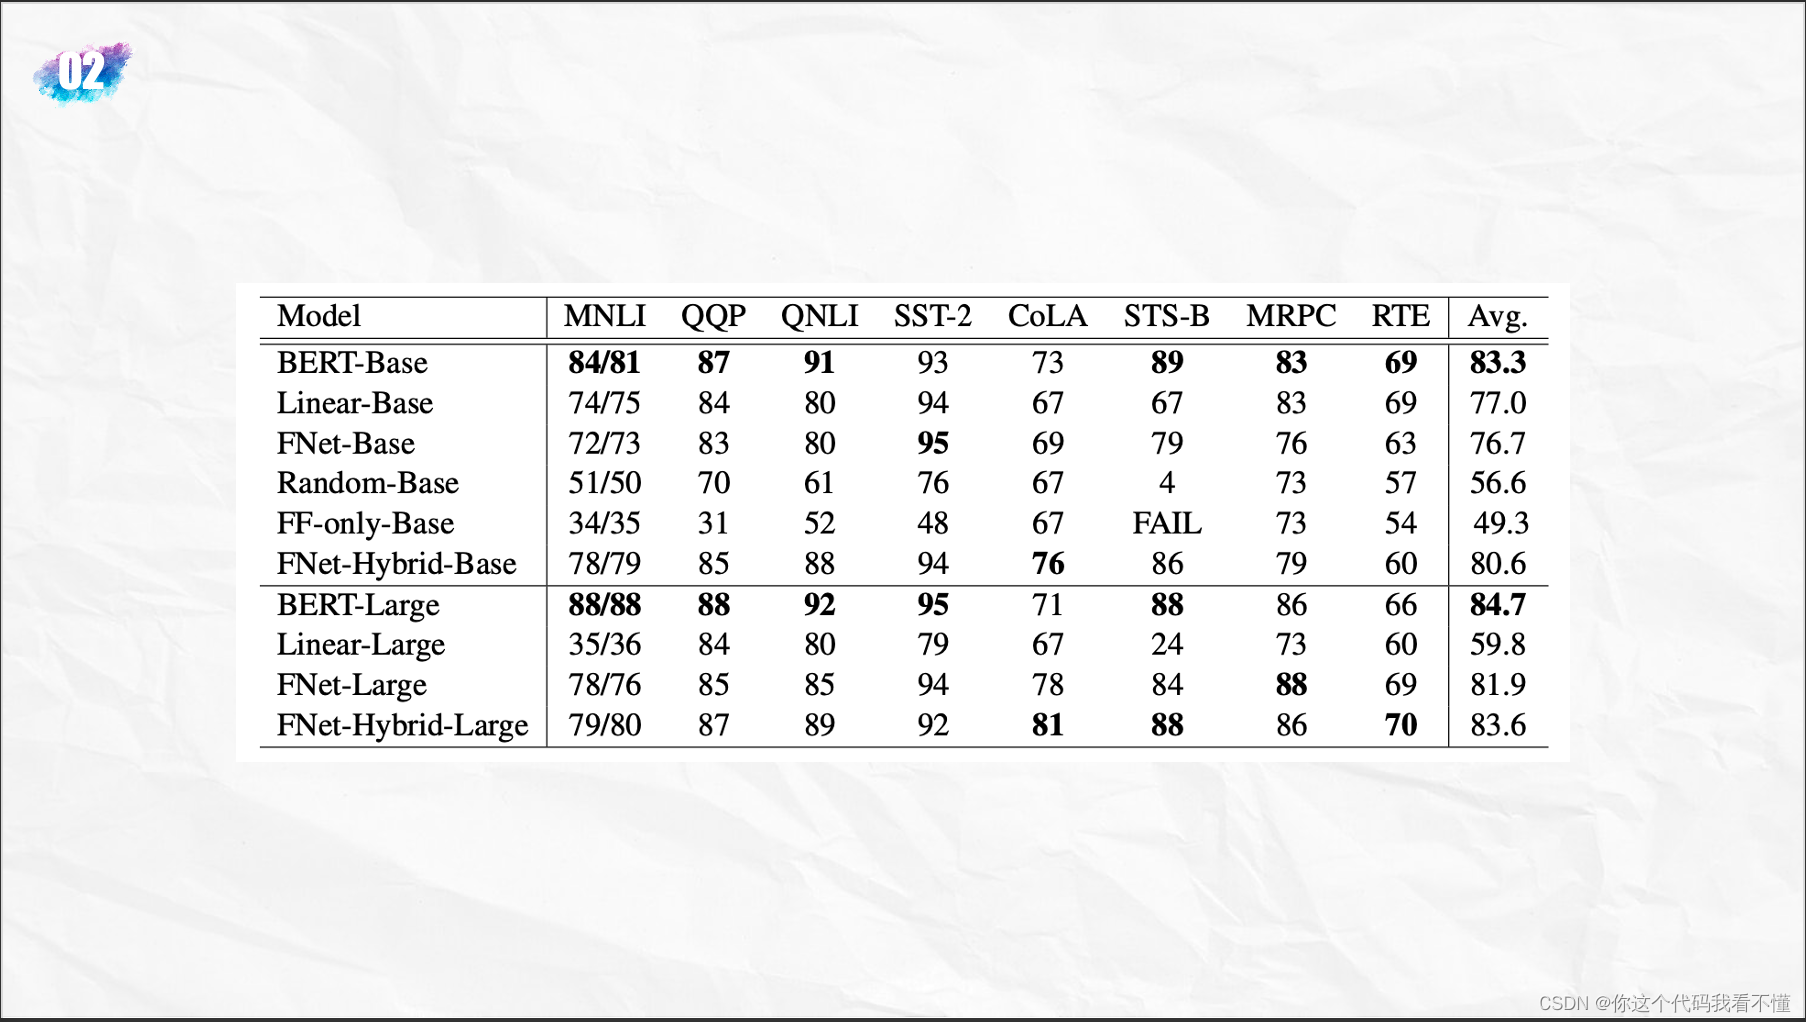
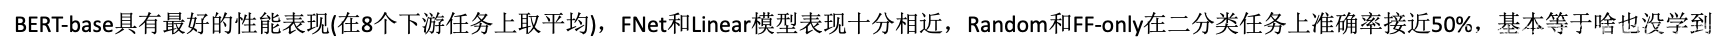
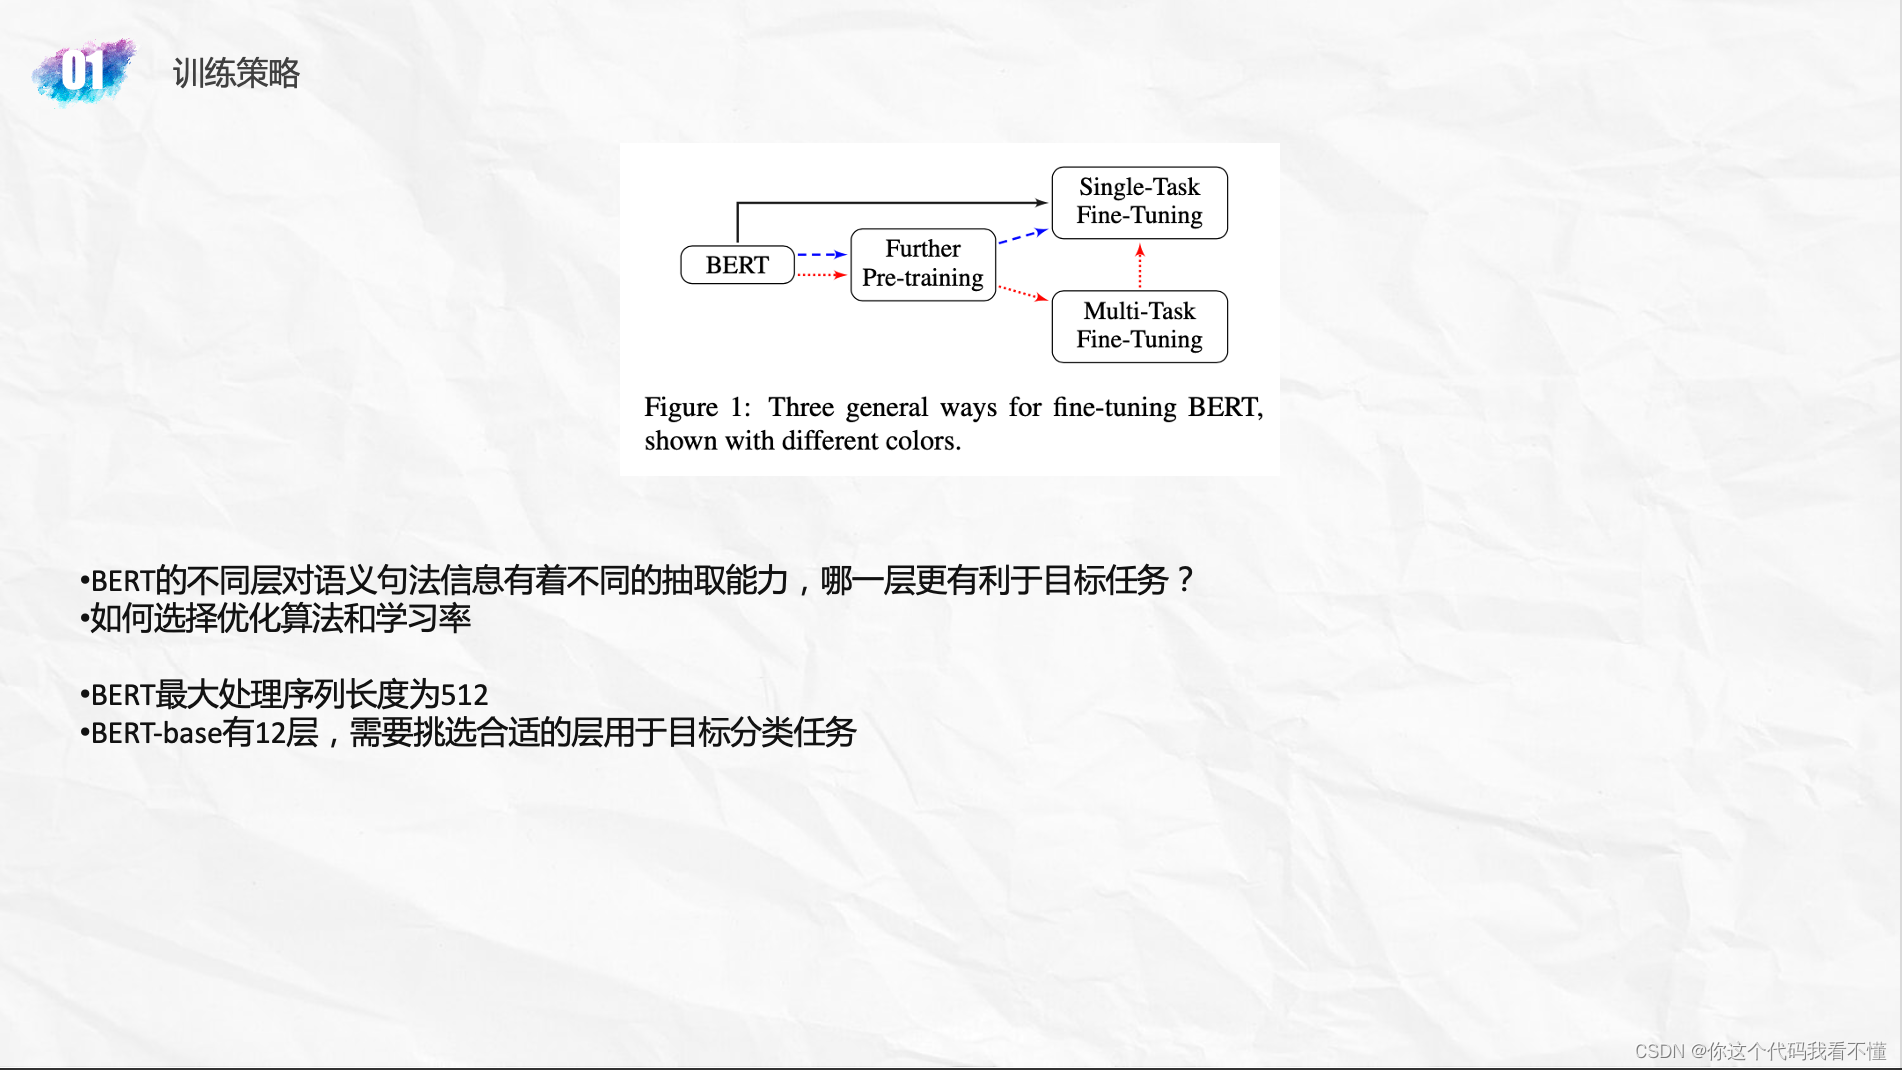
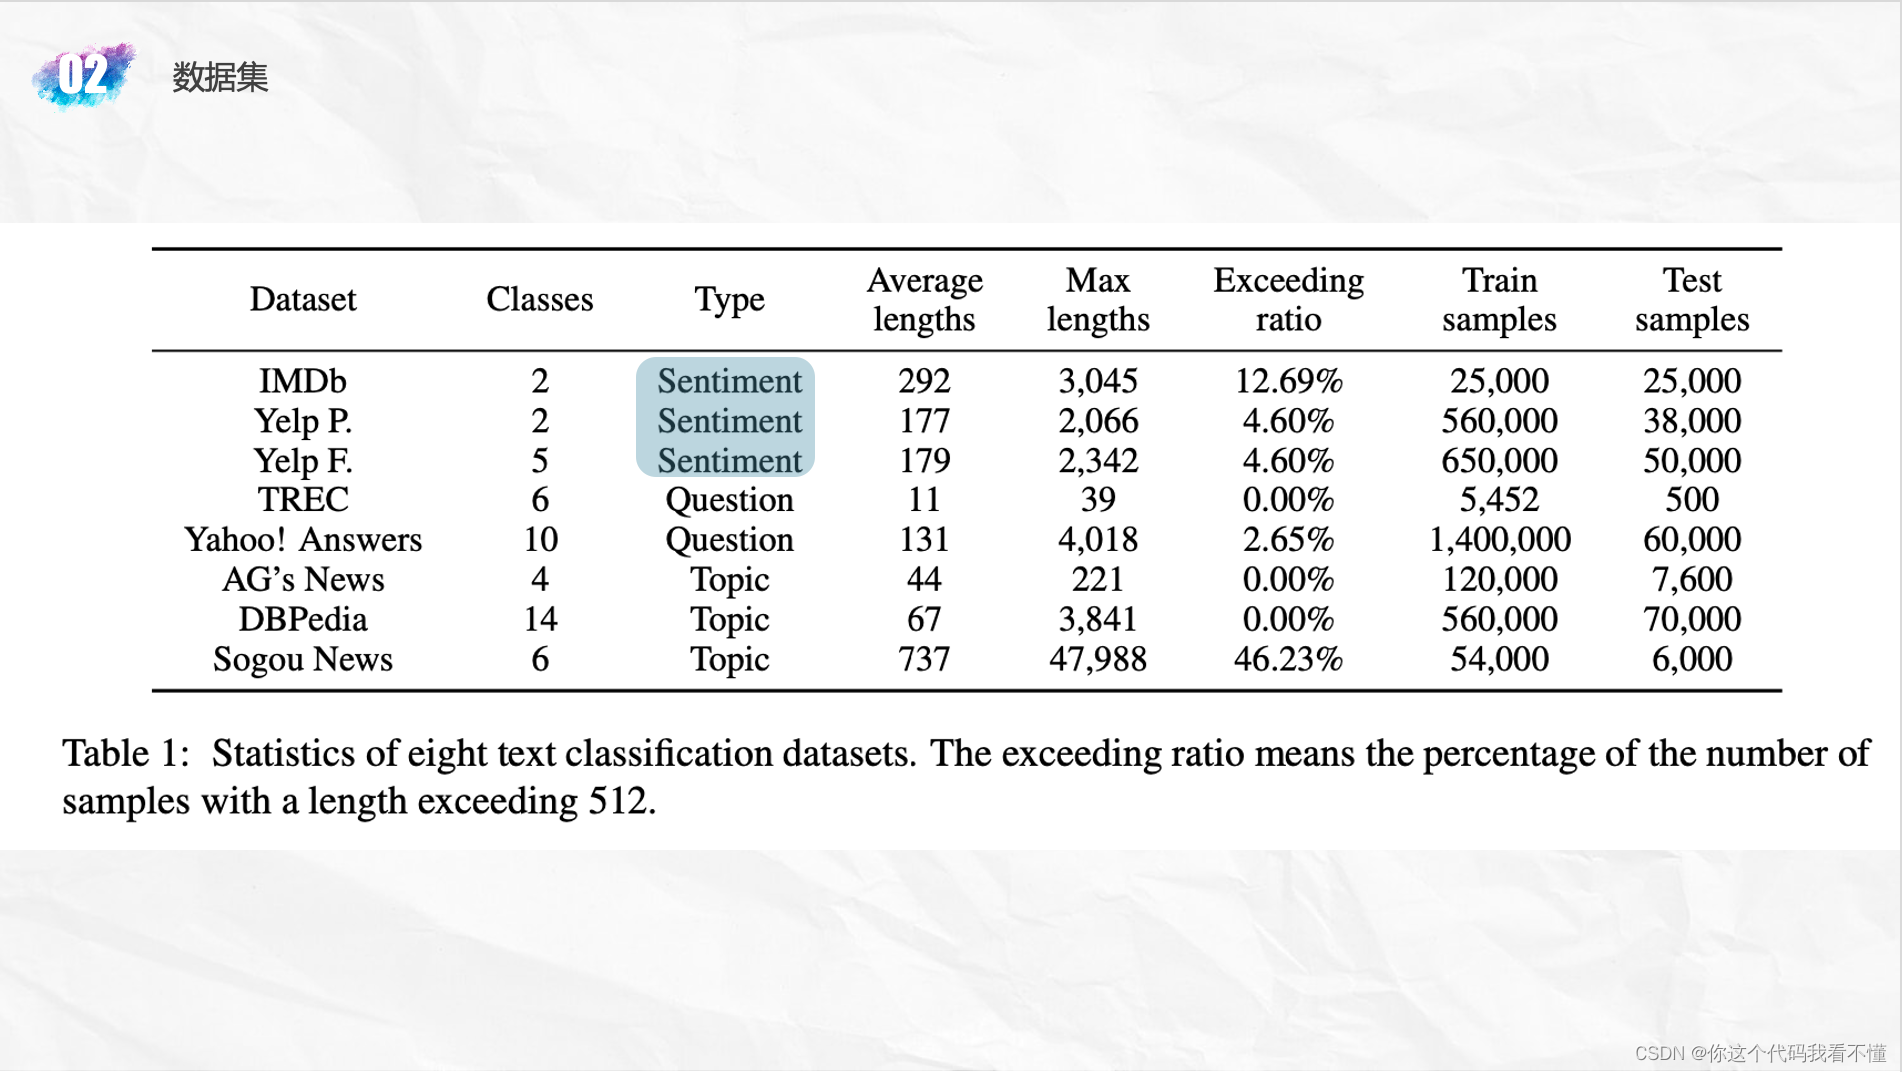
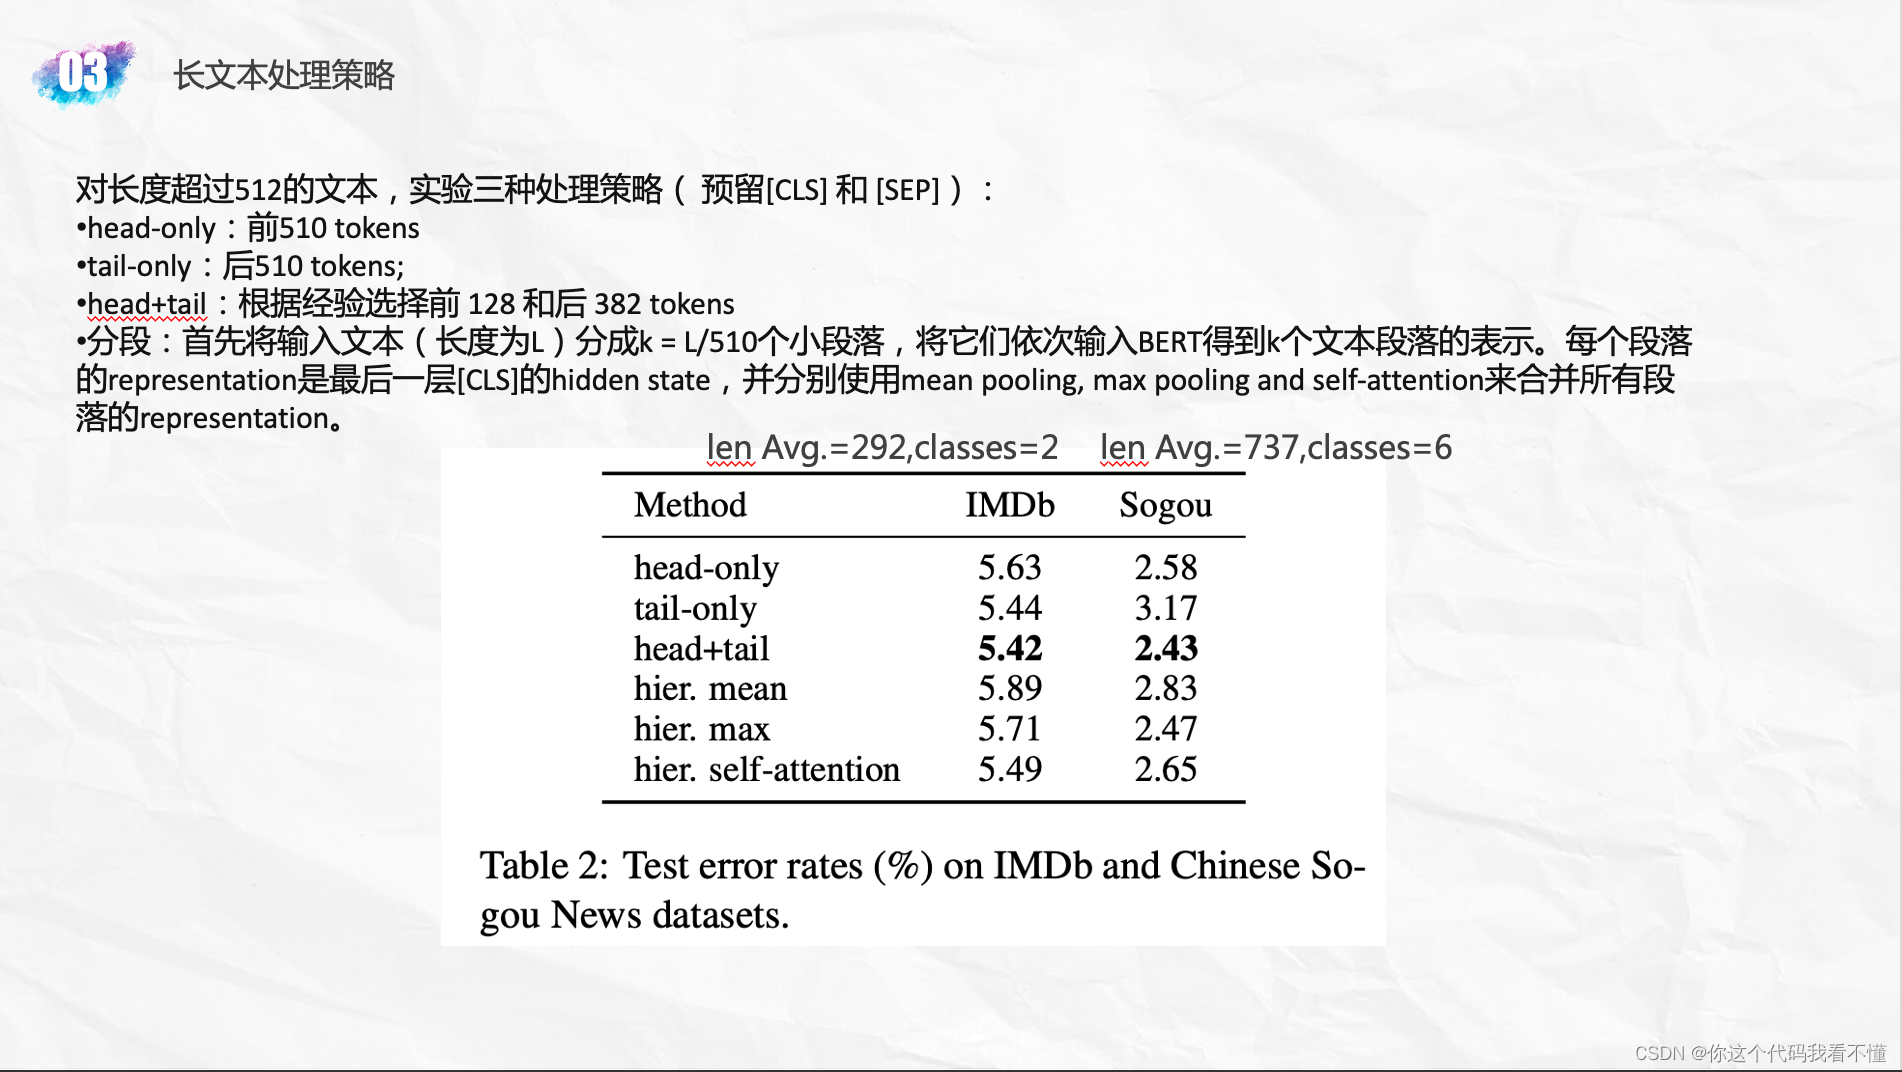
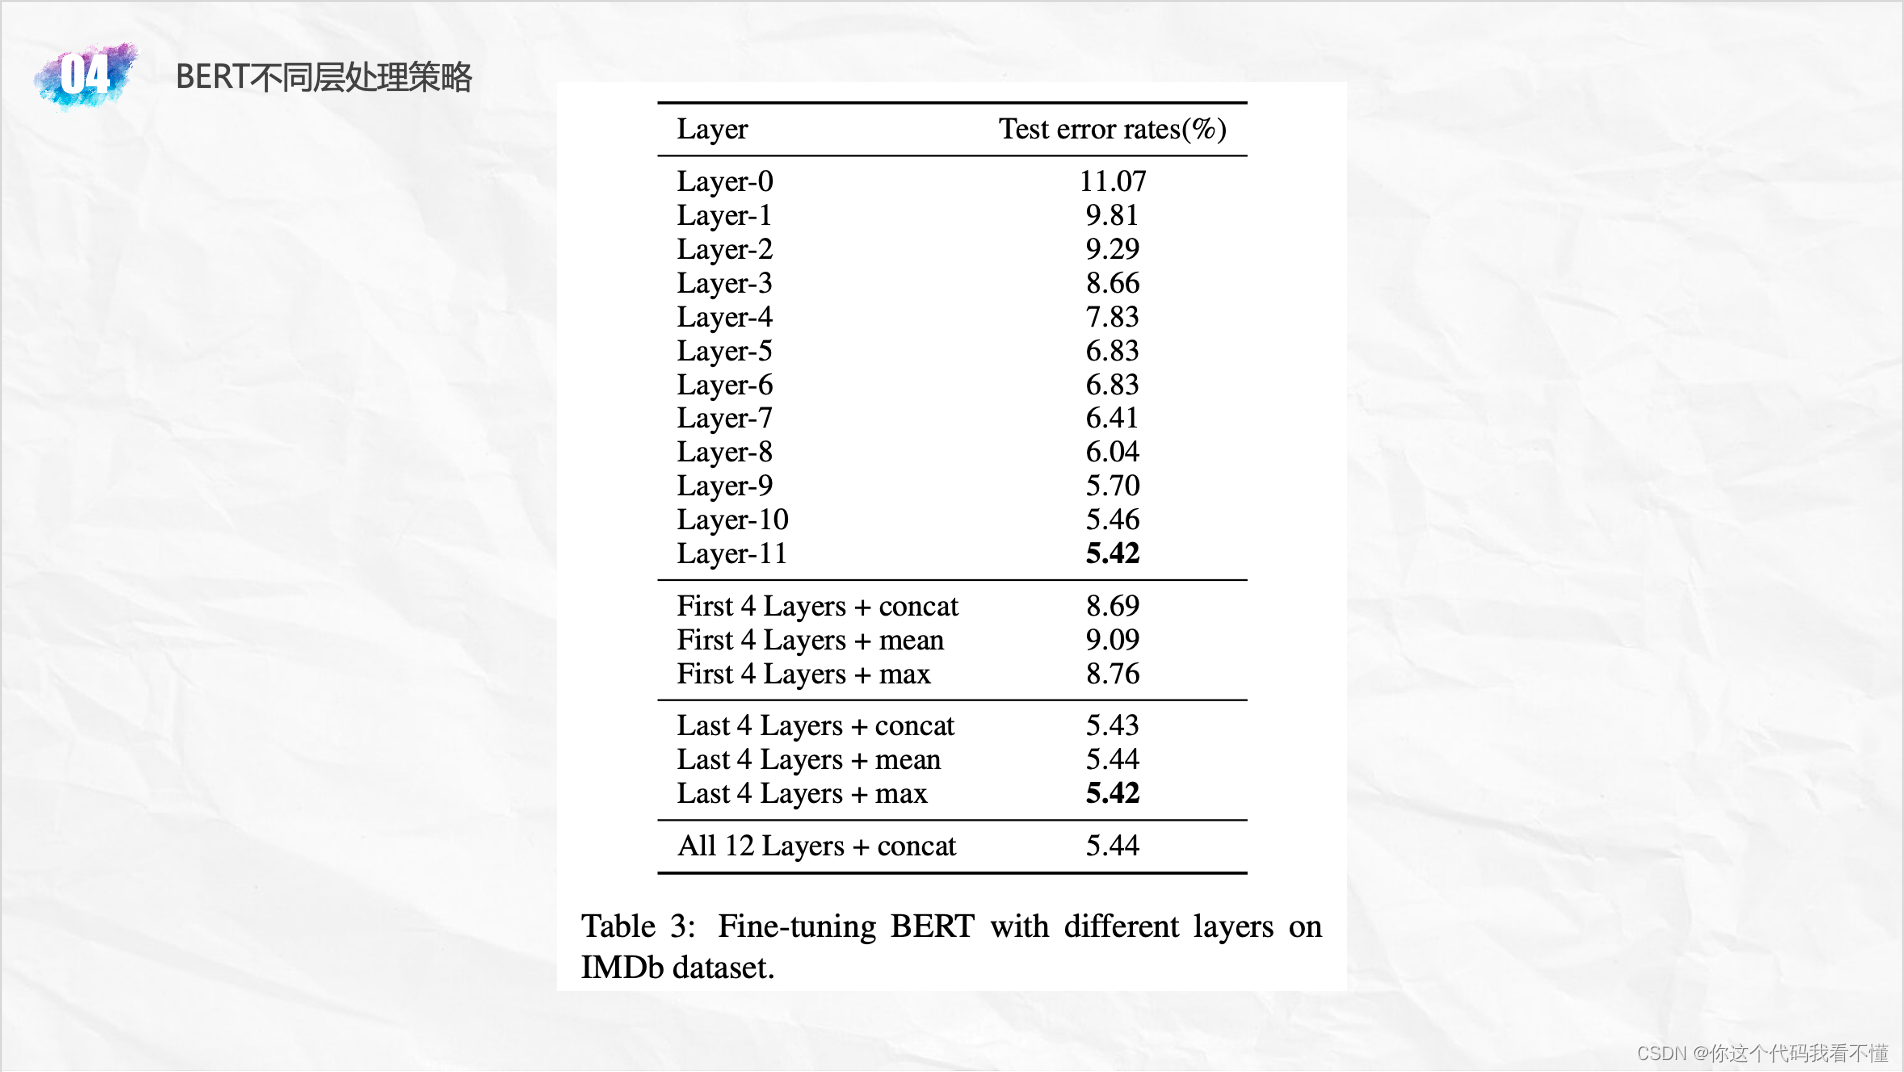
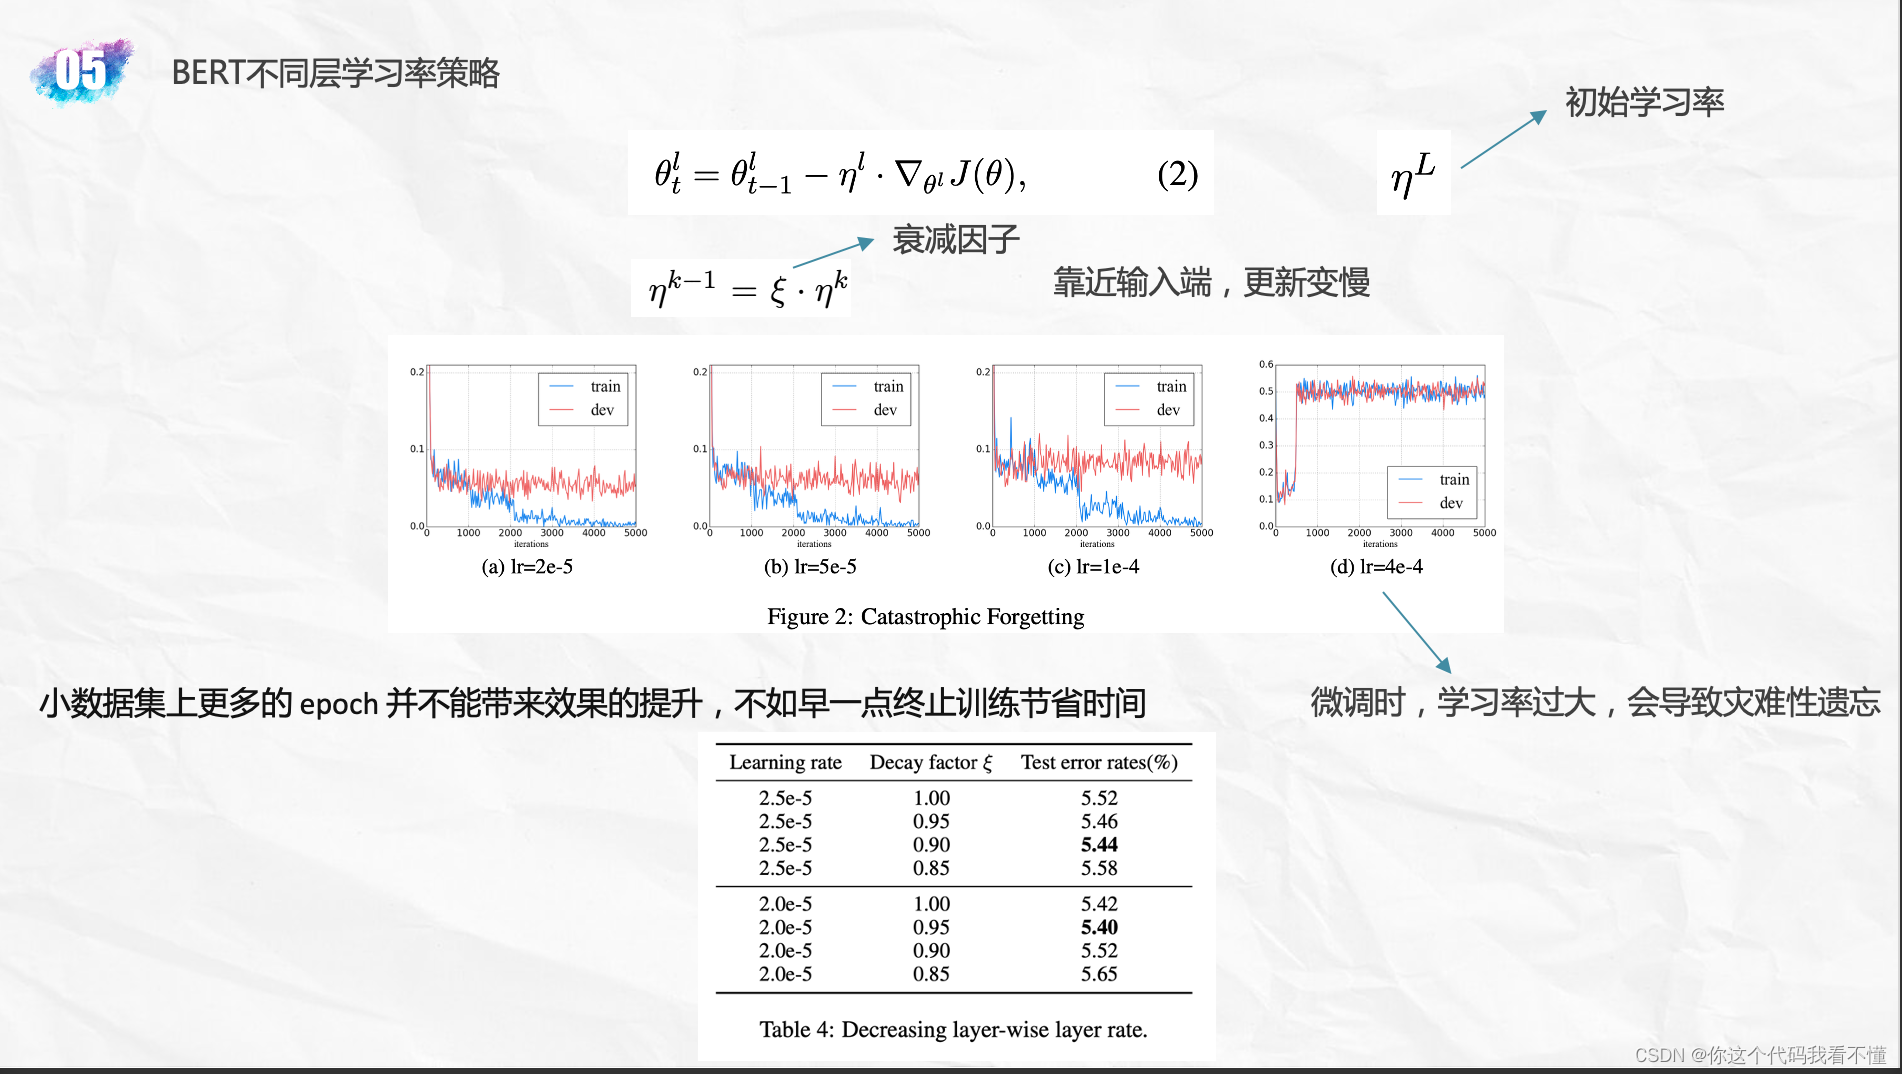
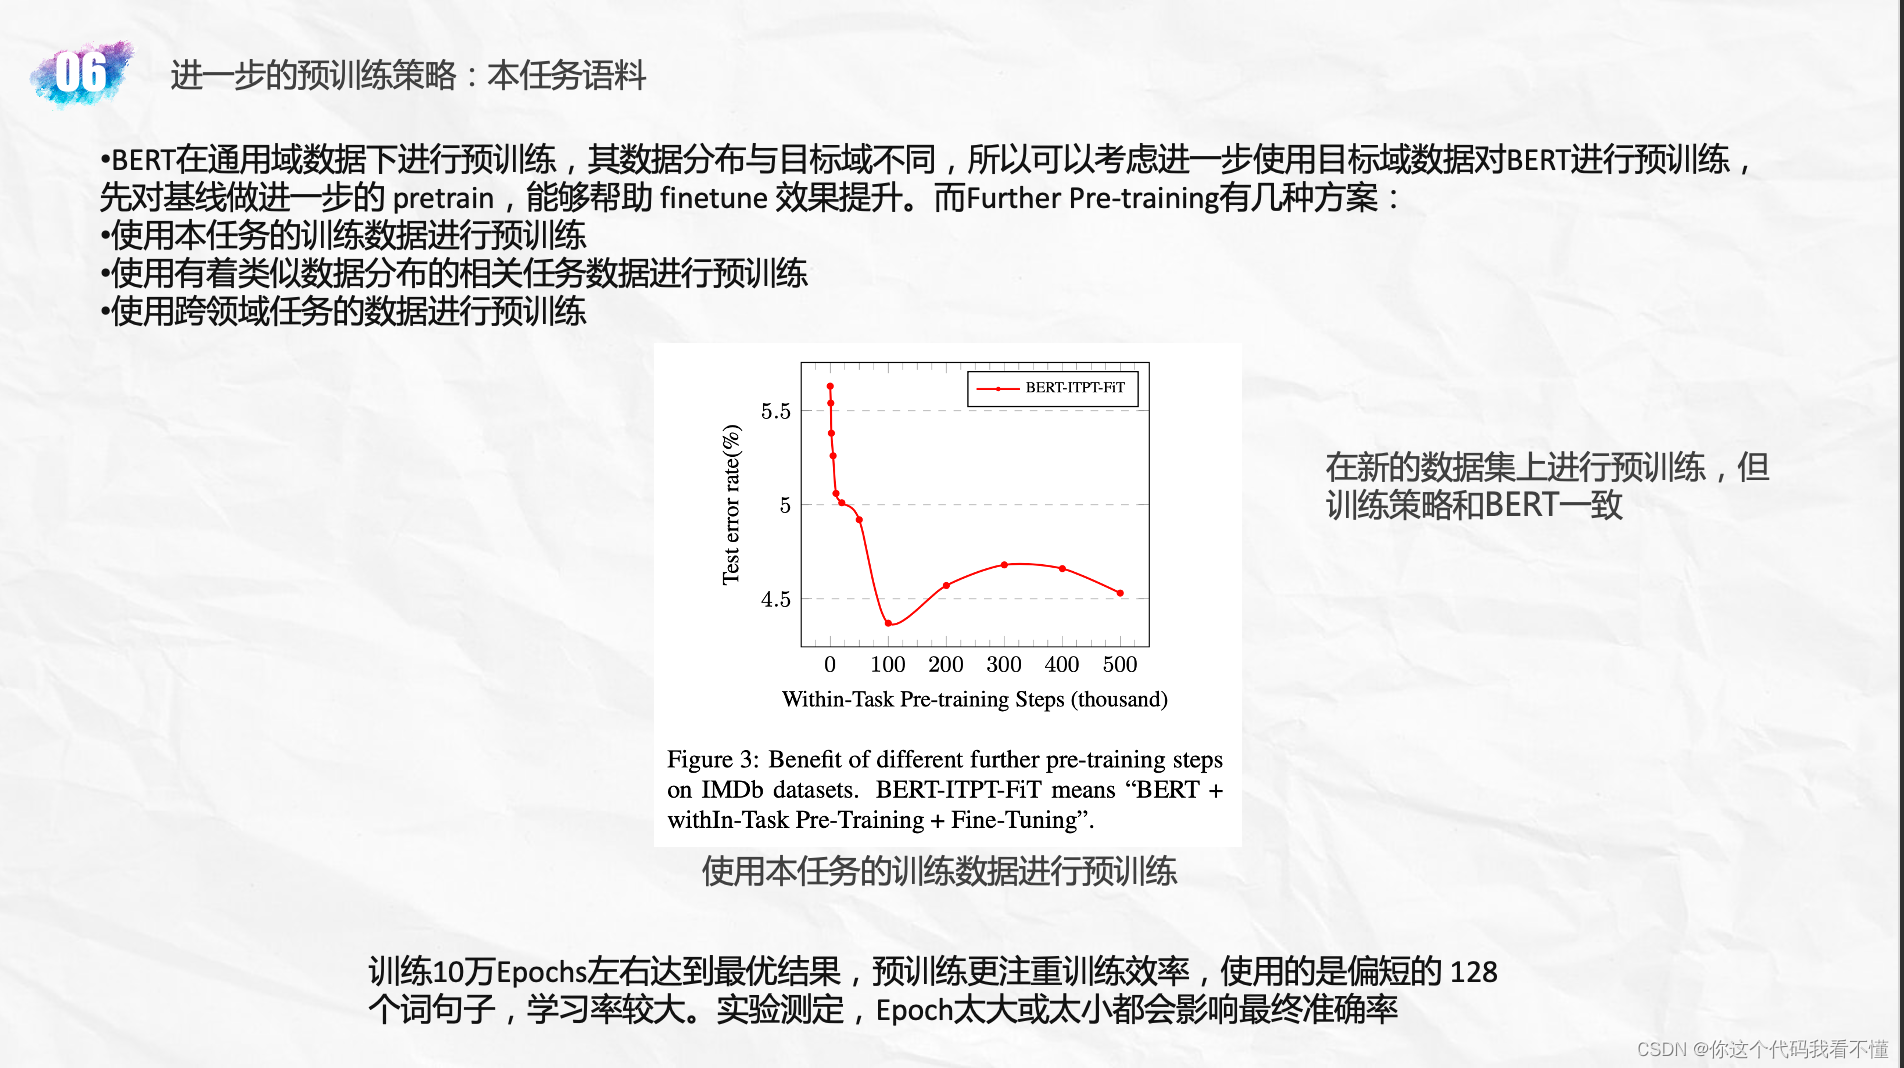
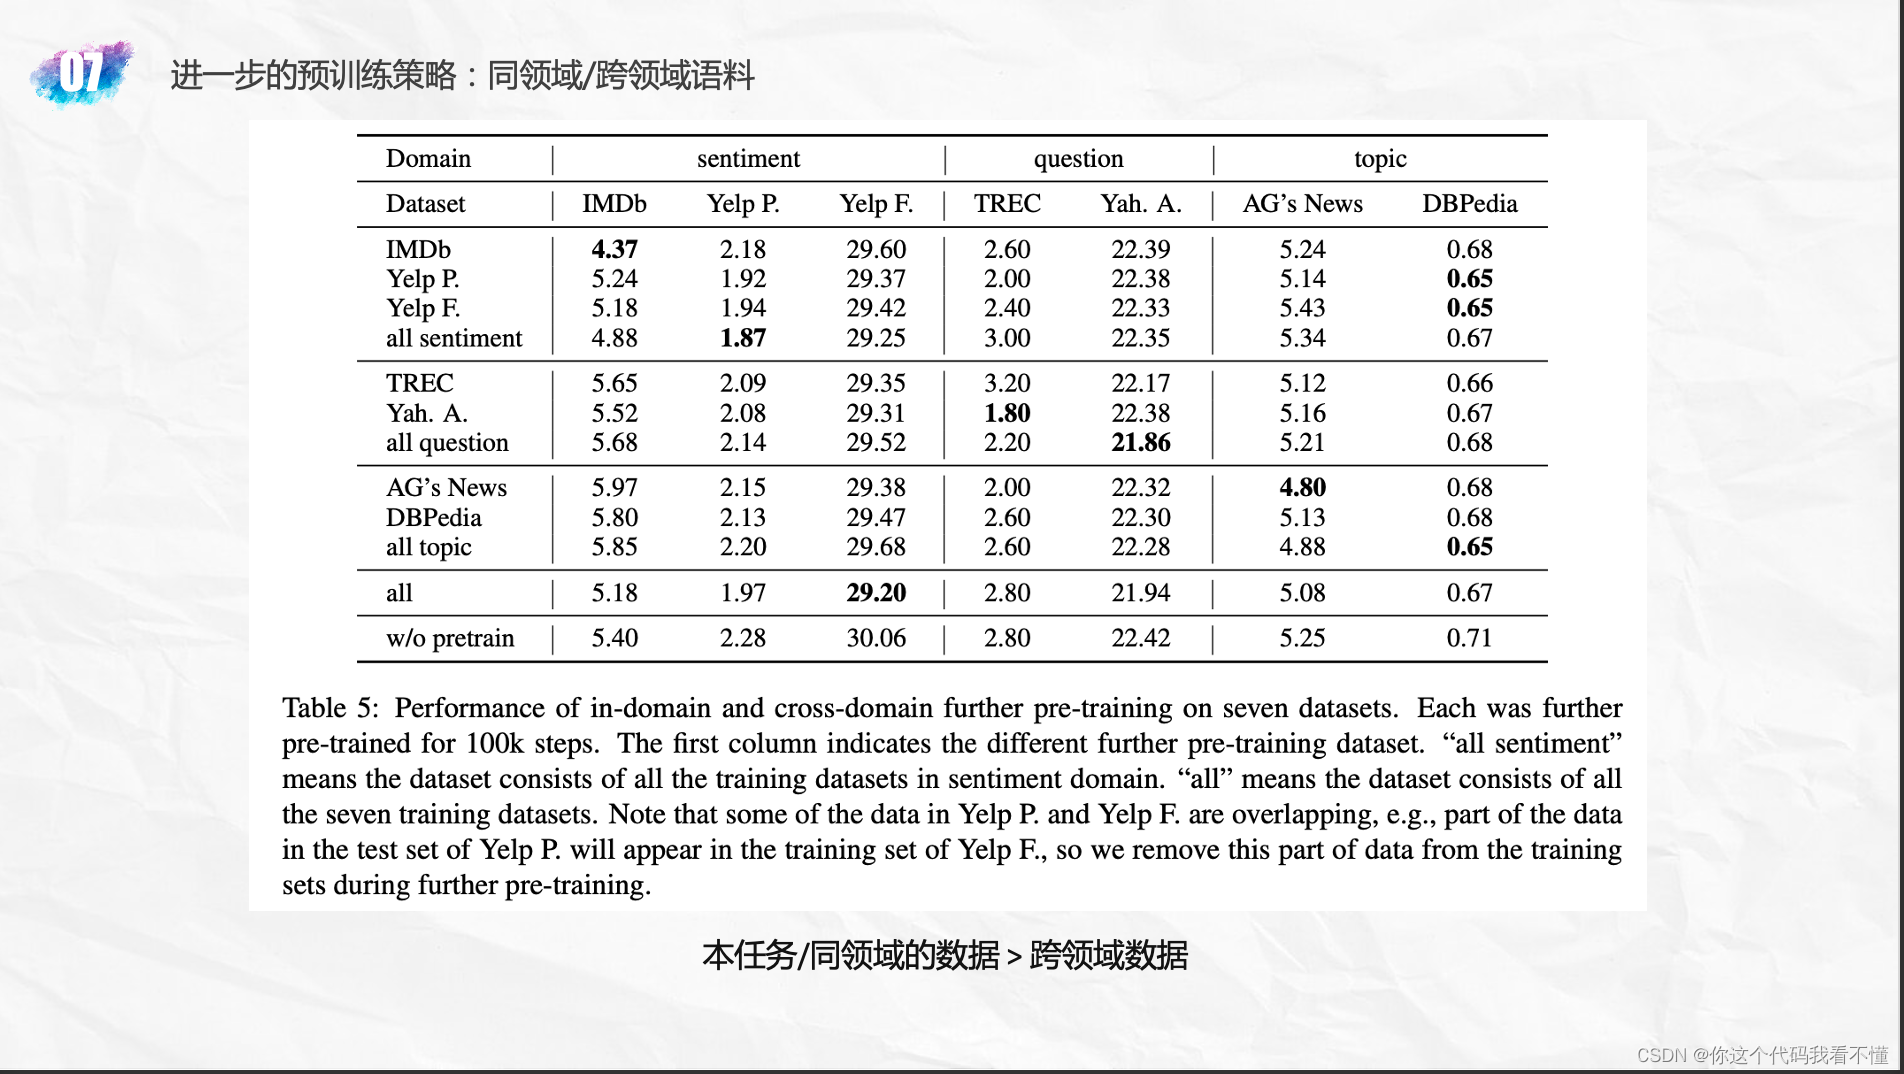
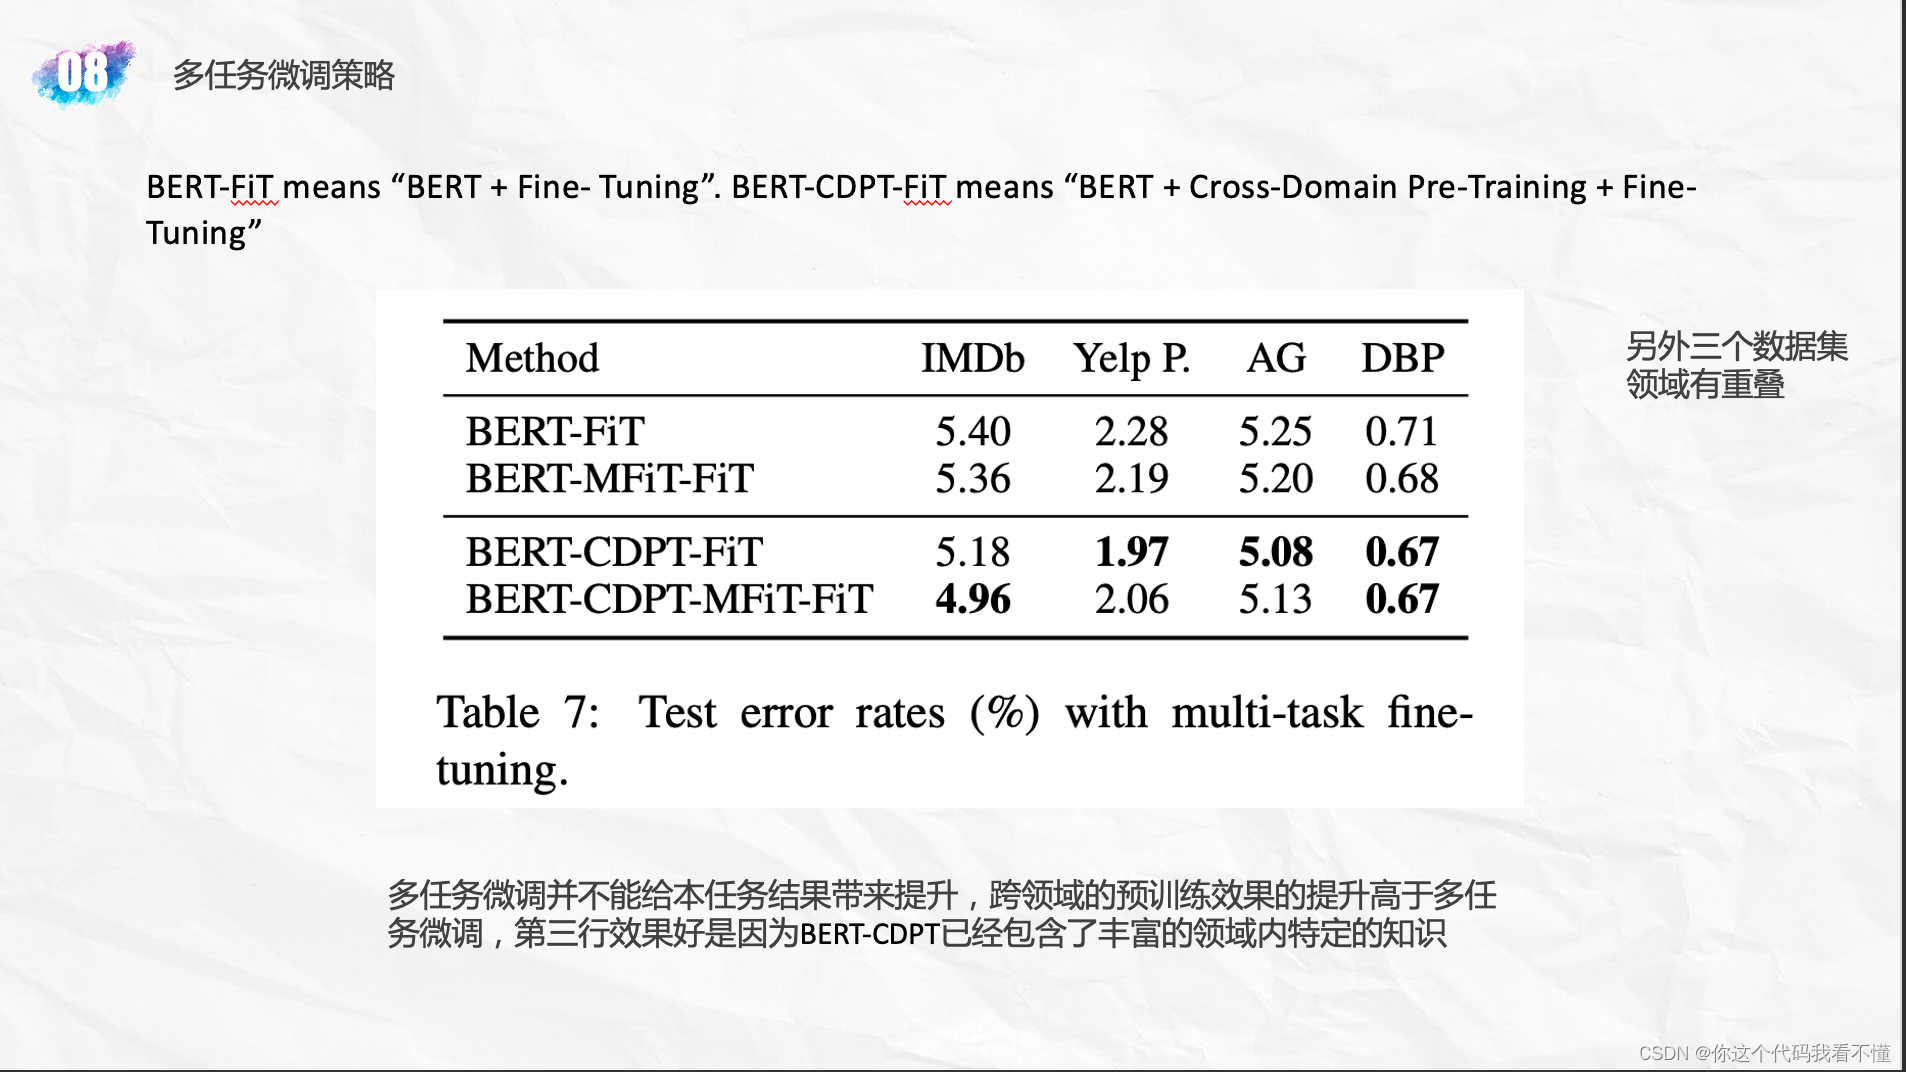
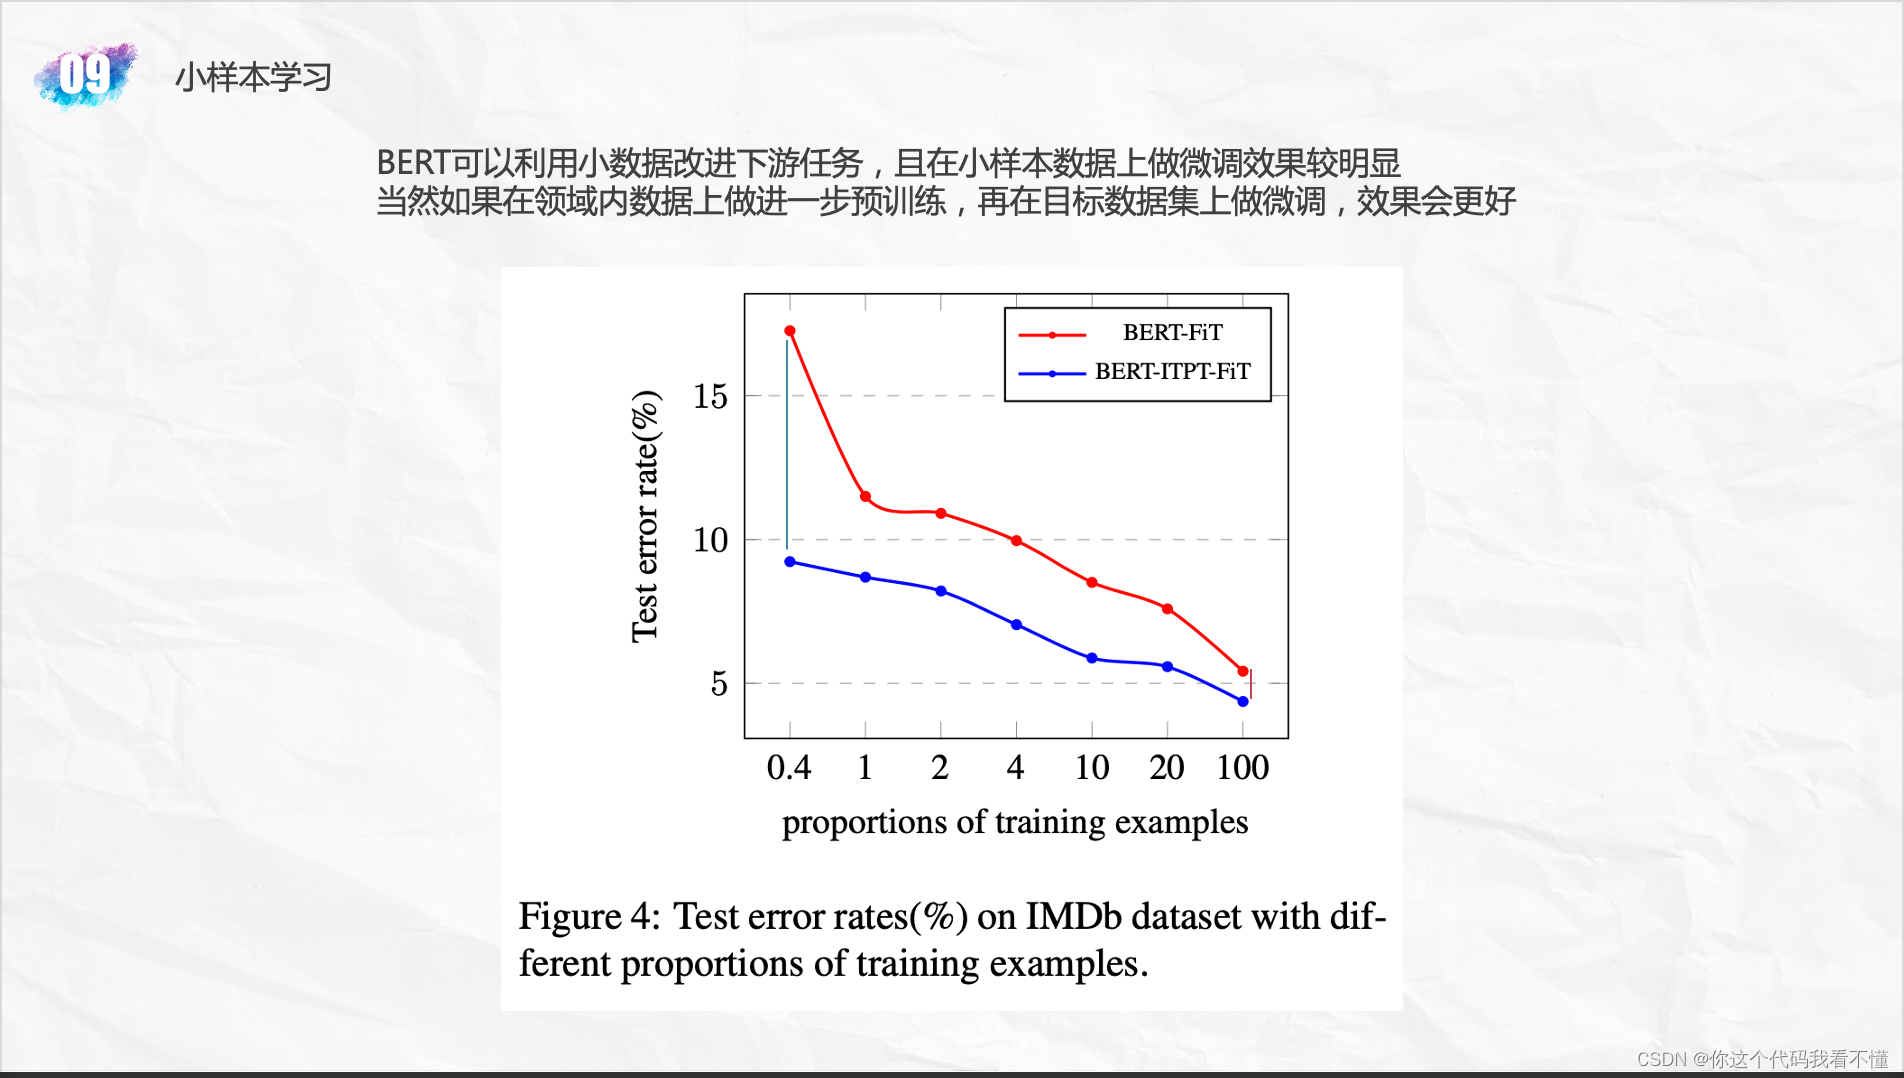
How to Fine-Tune BERT for Text Classification?
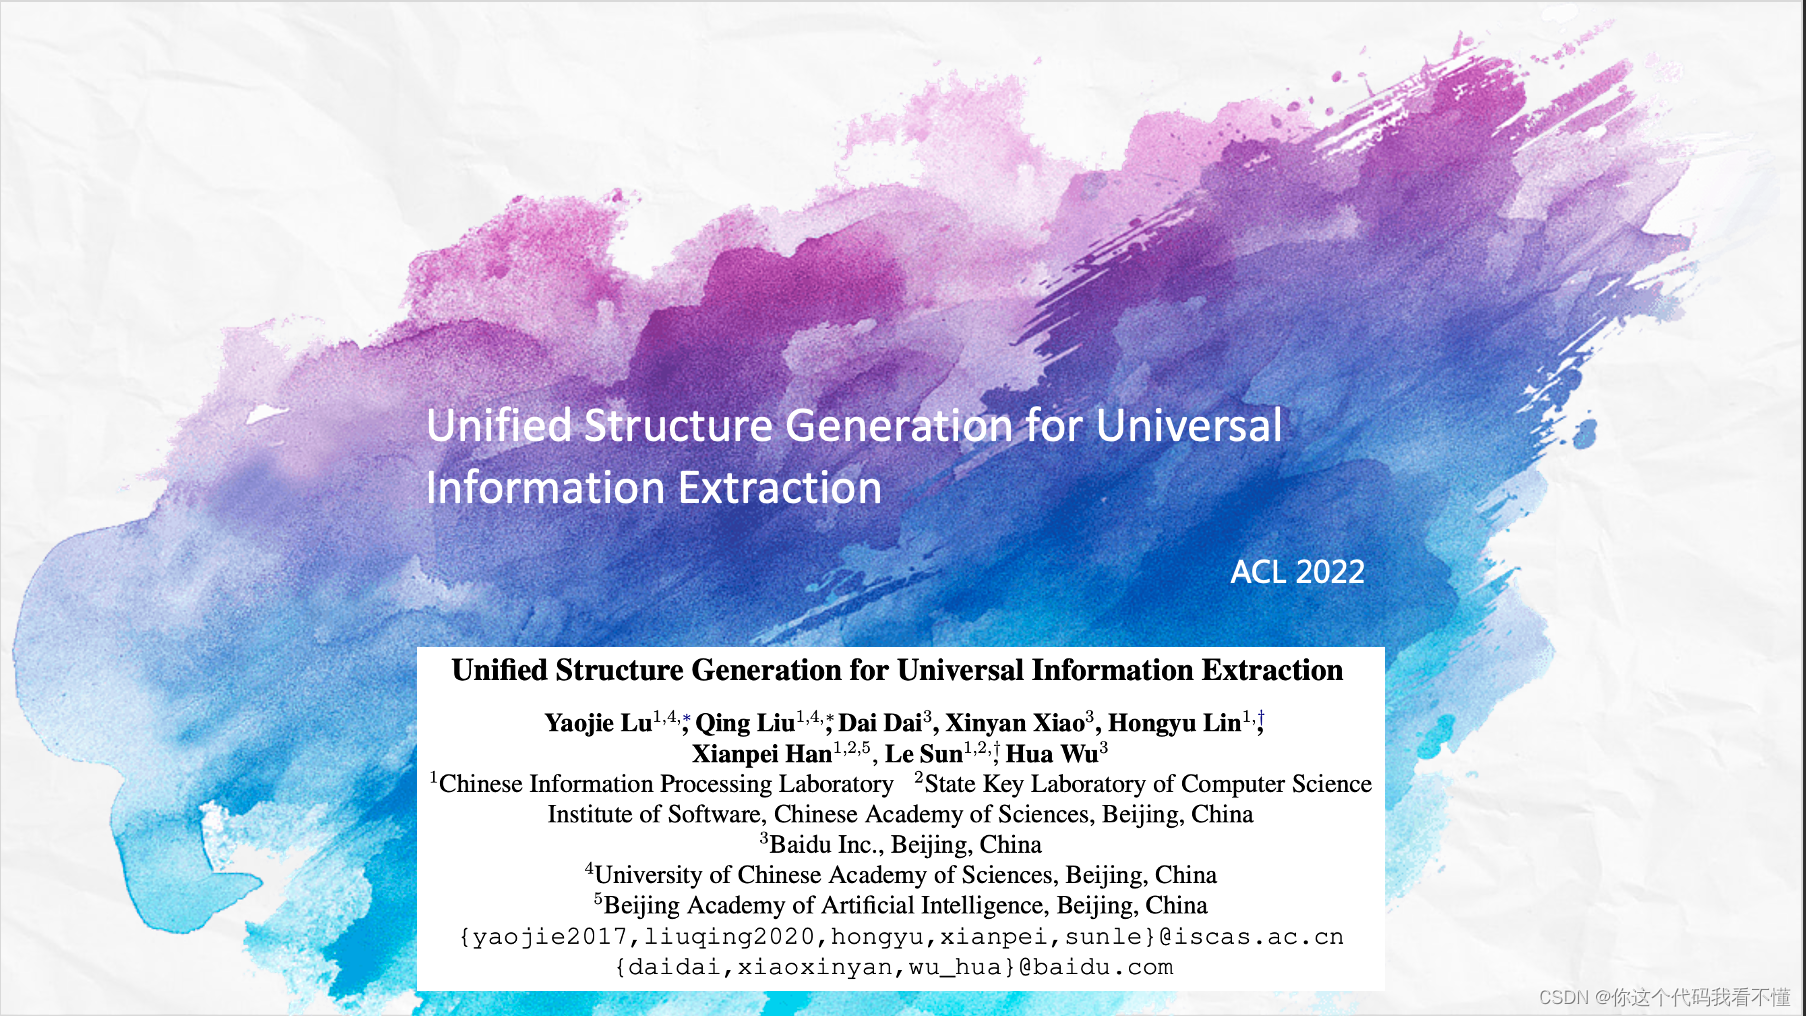
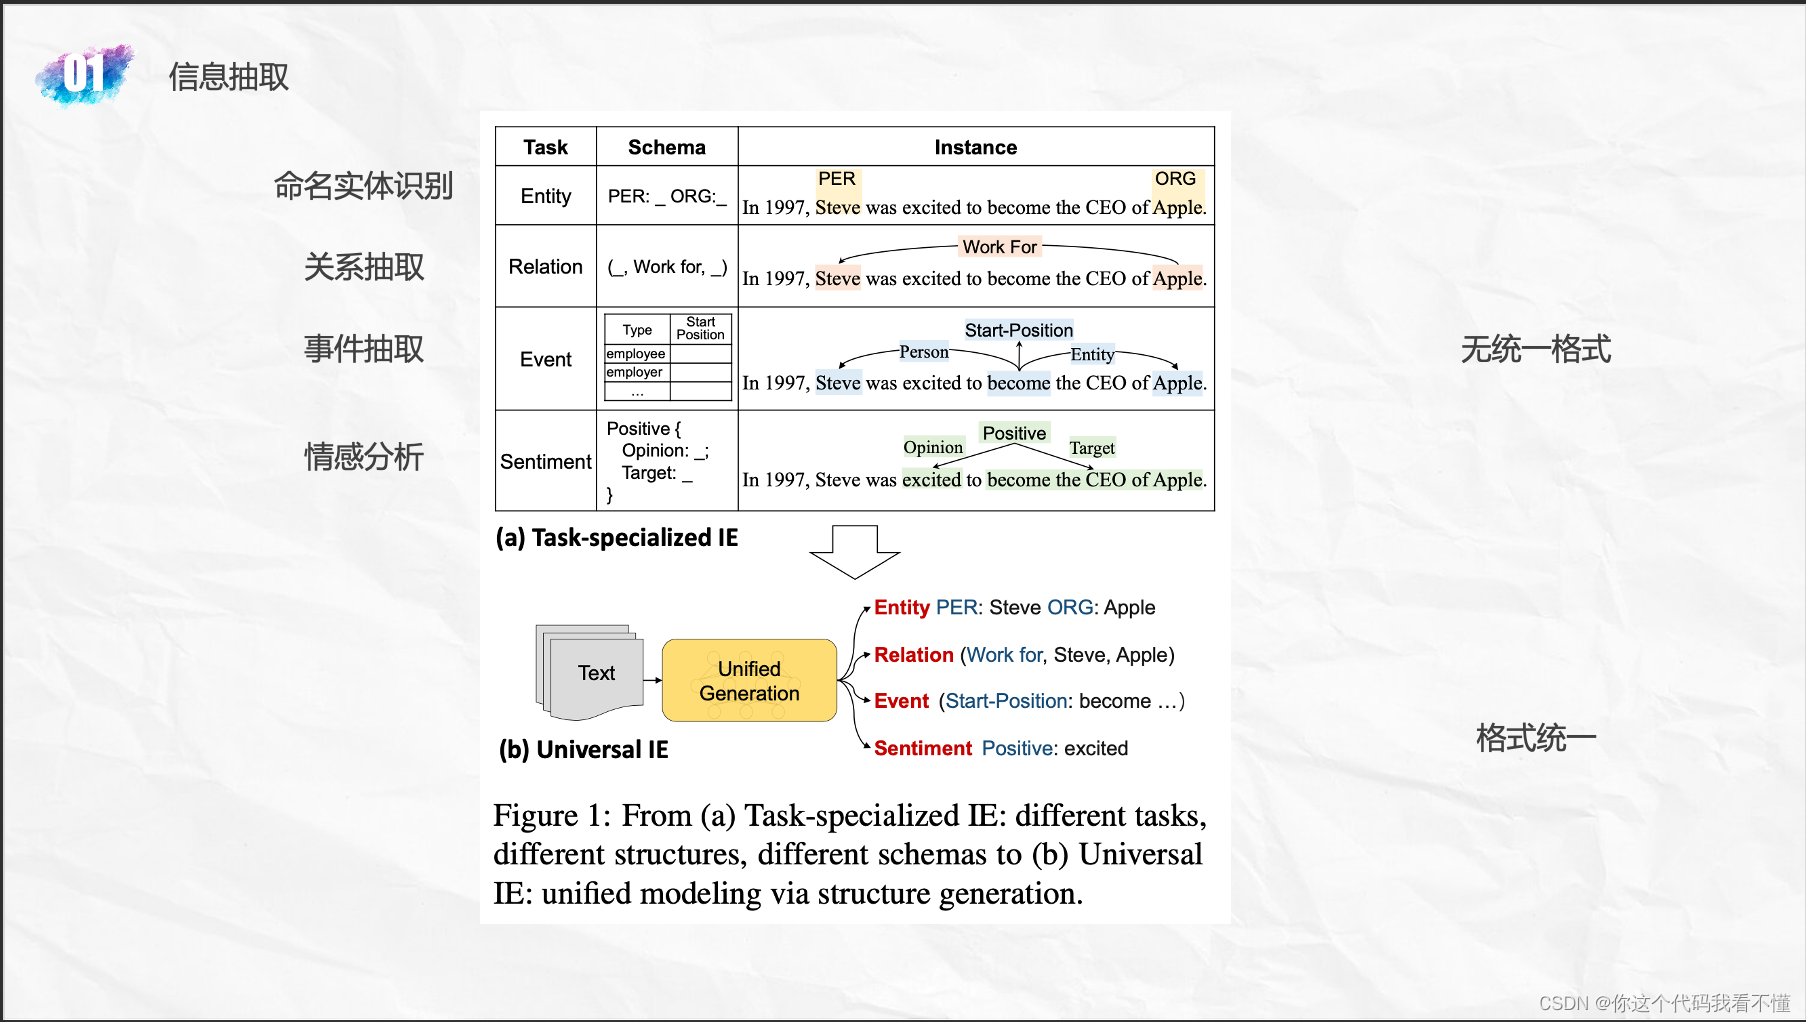
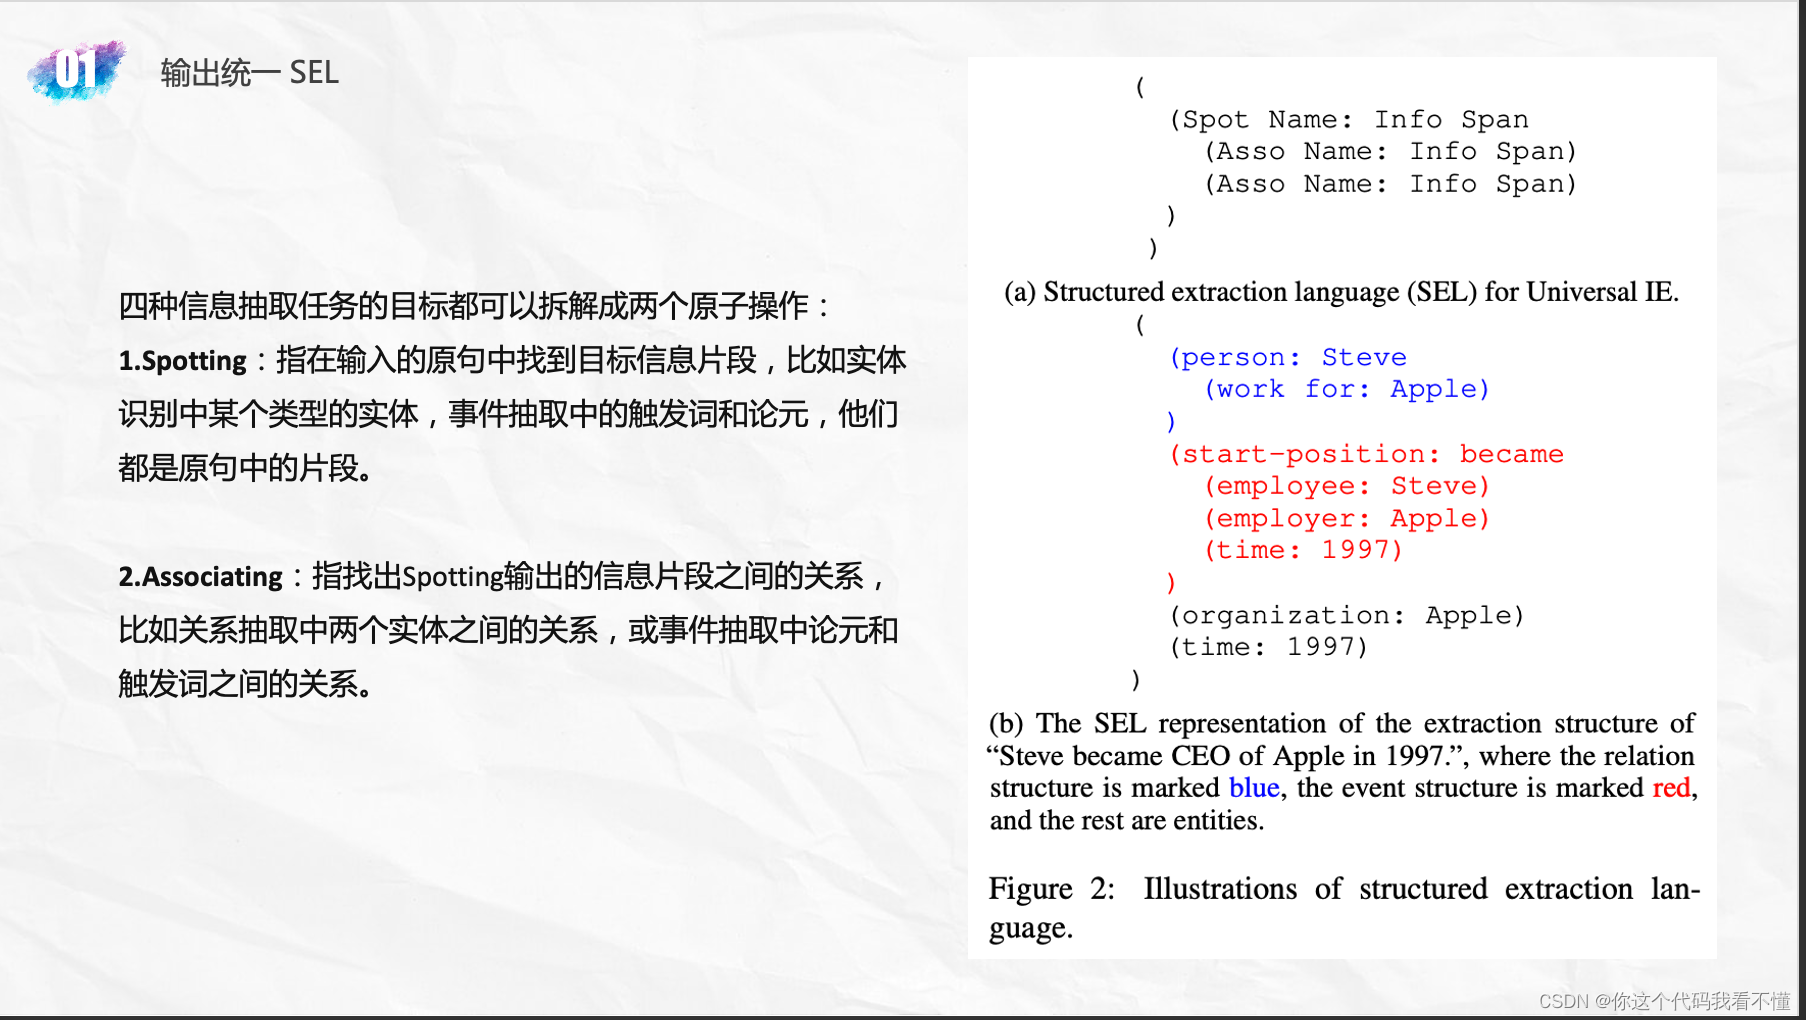
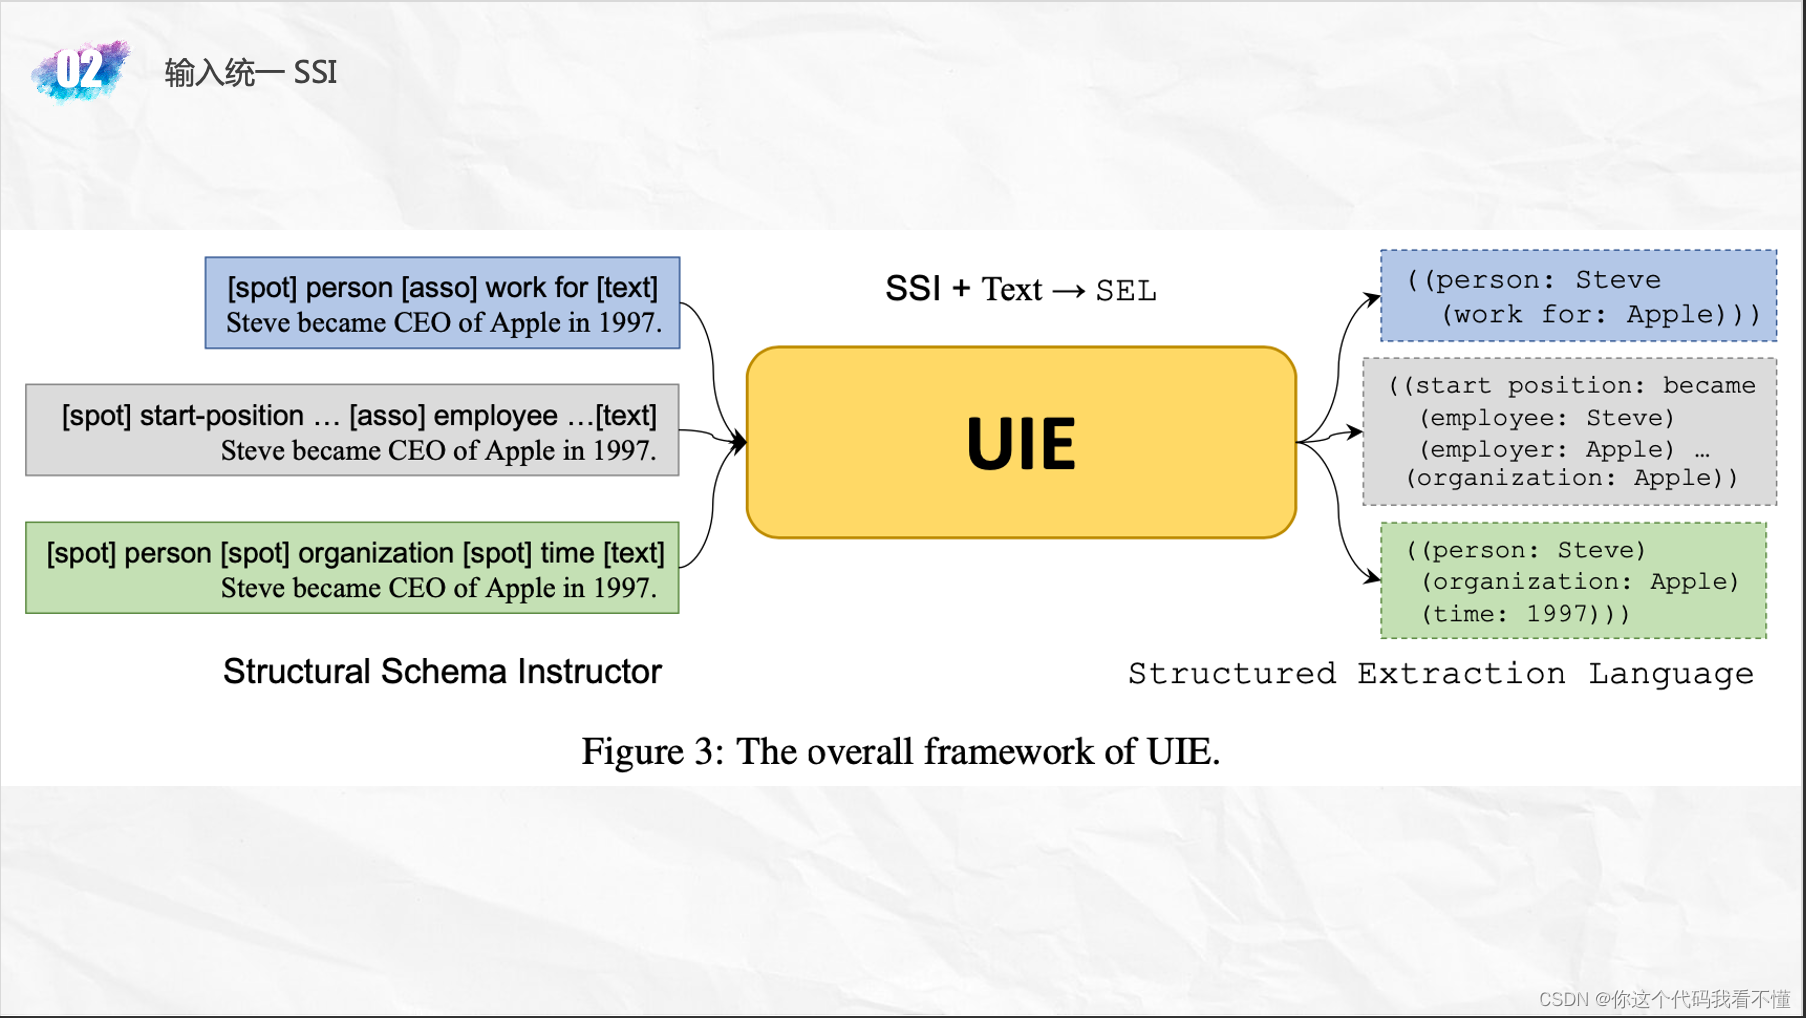
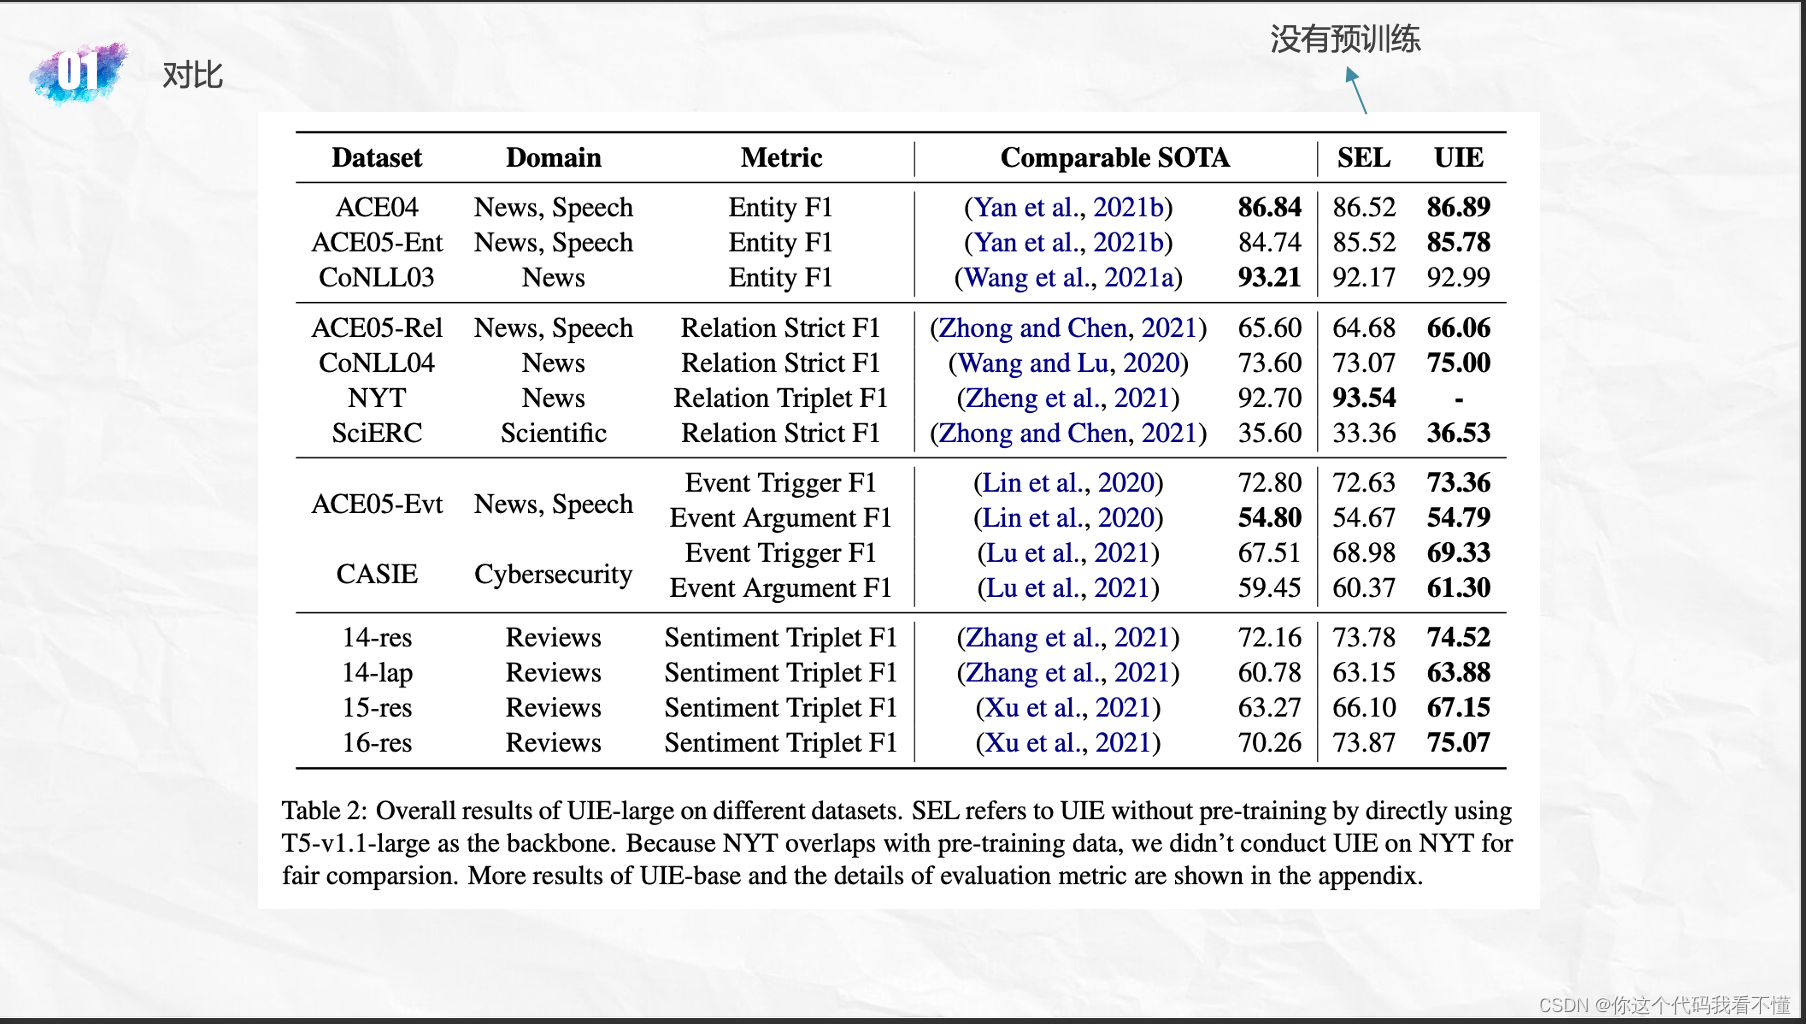
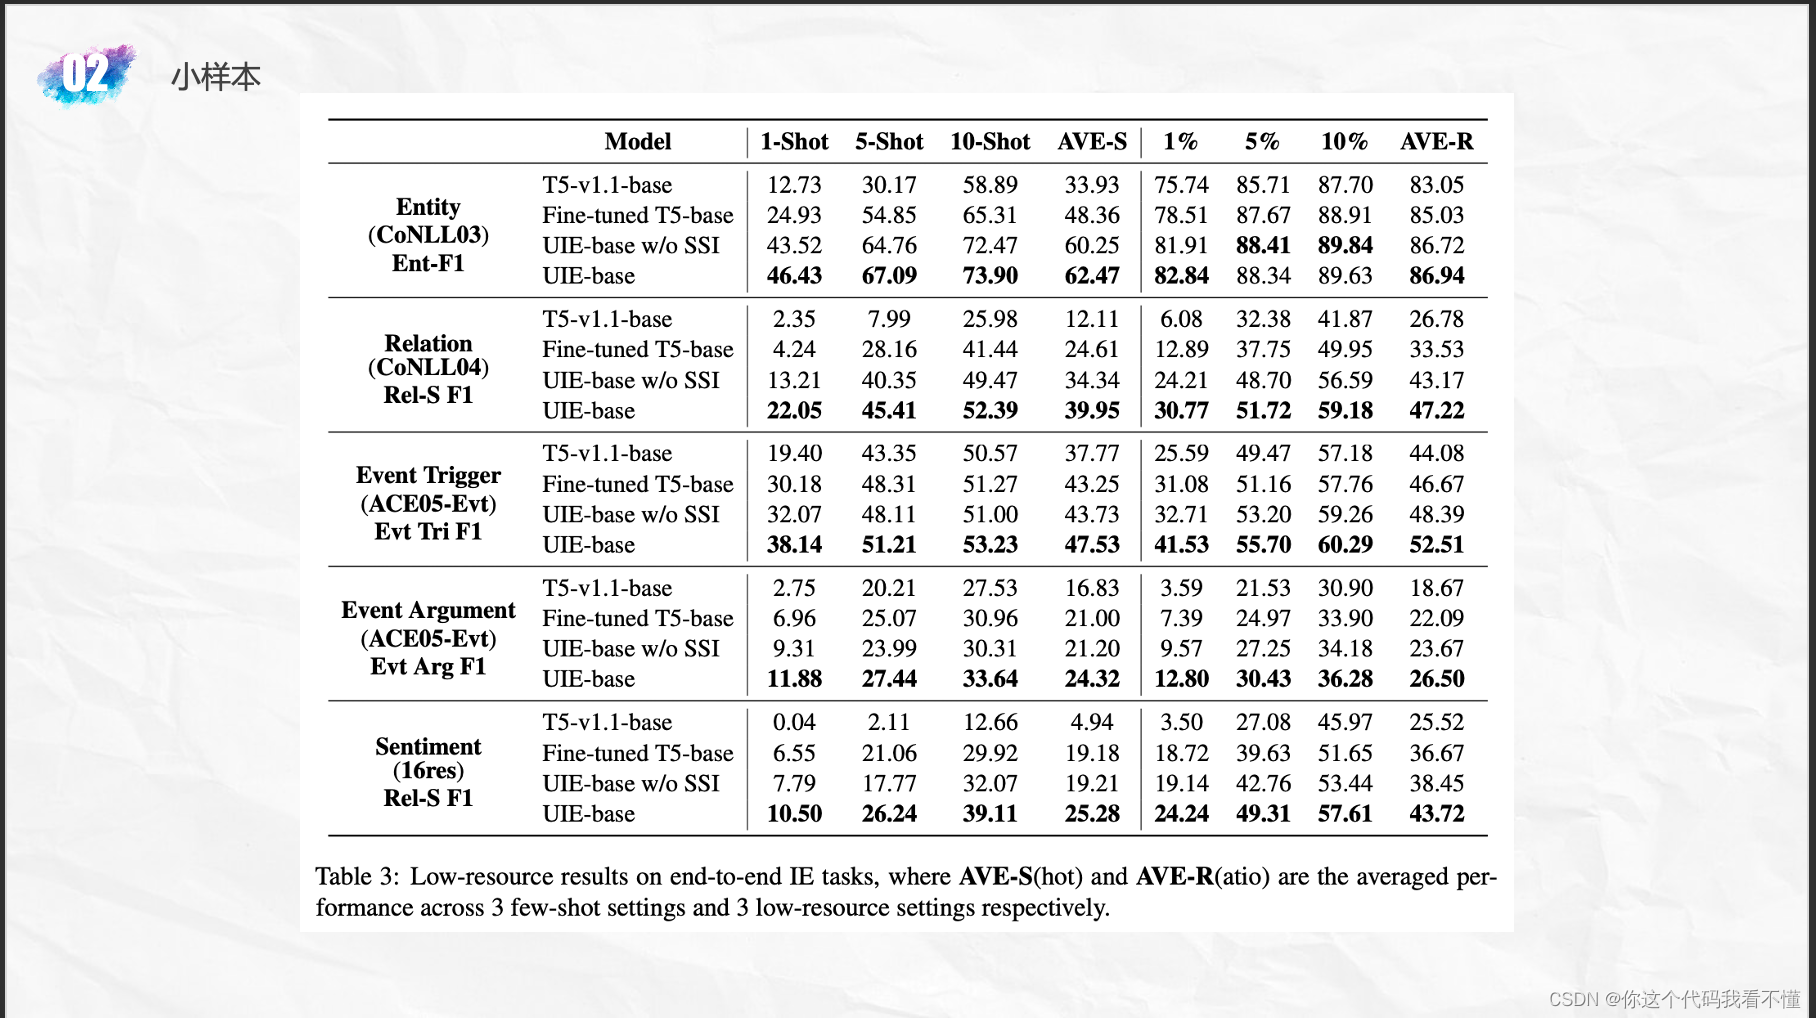
Unified Structure Generation for Universal Information Extraction
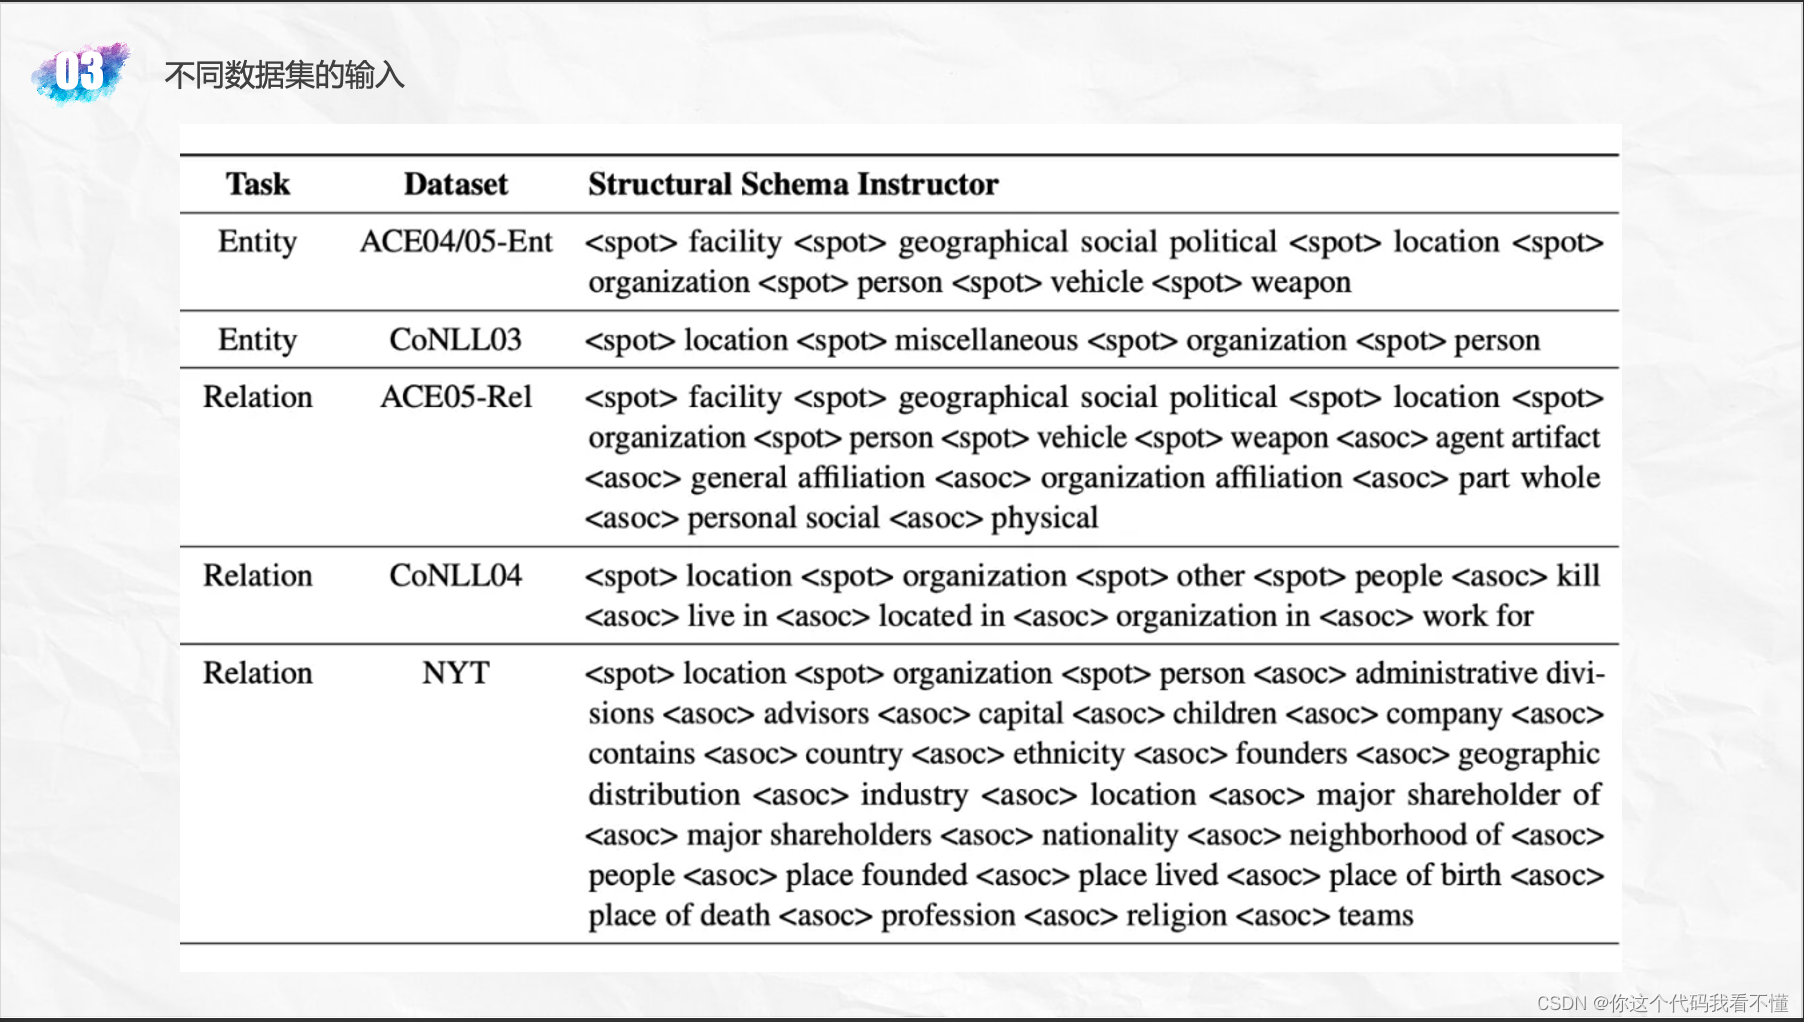
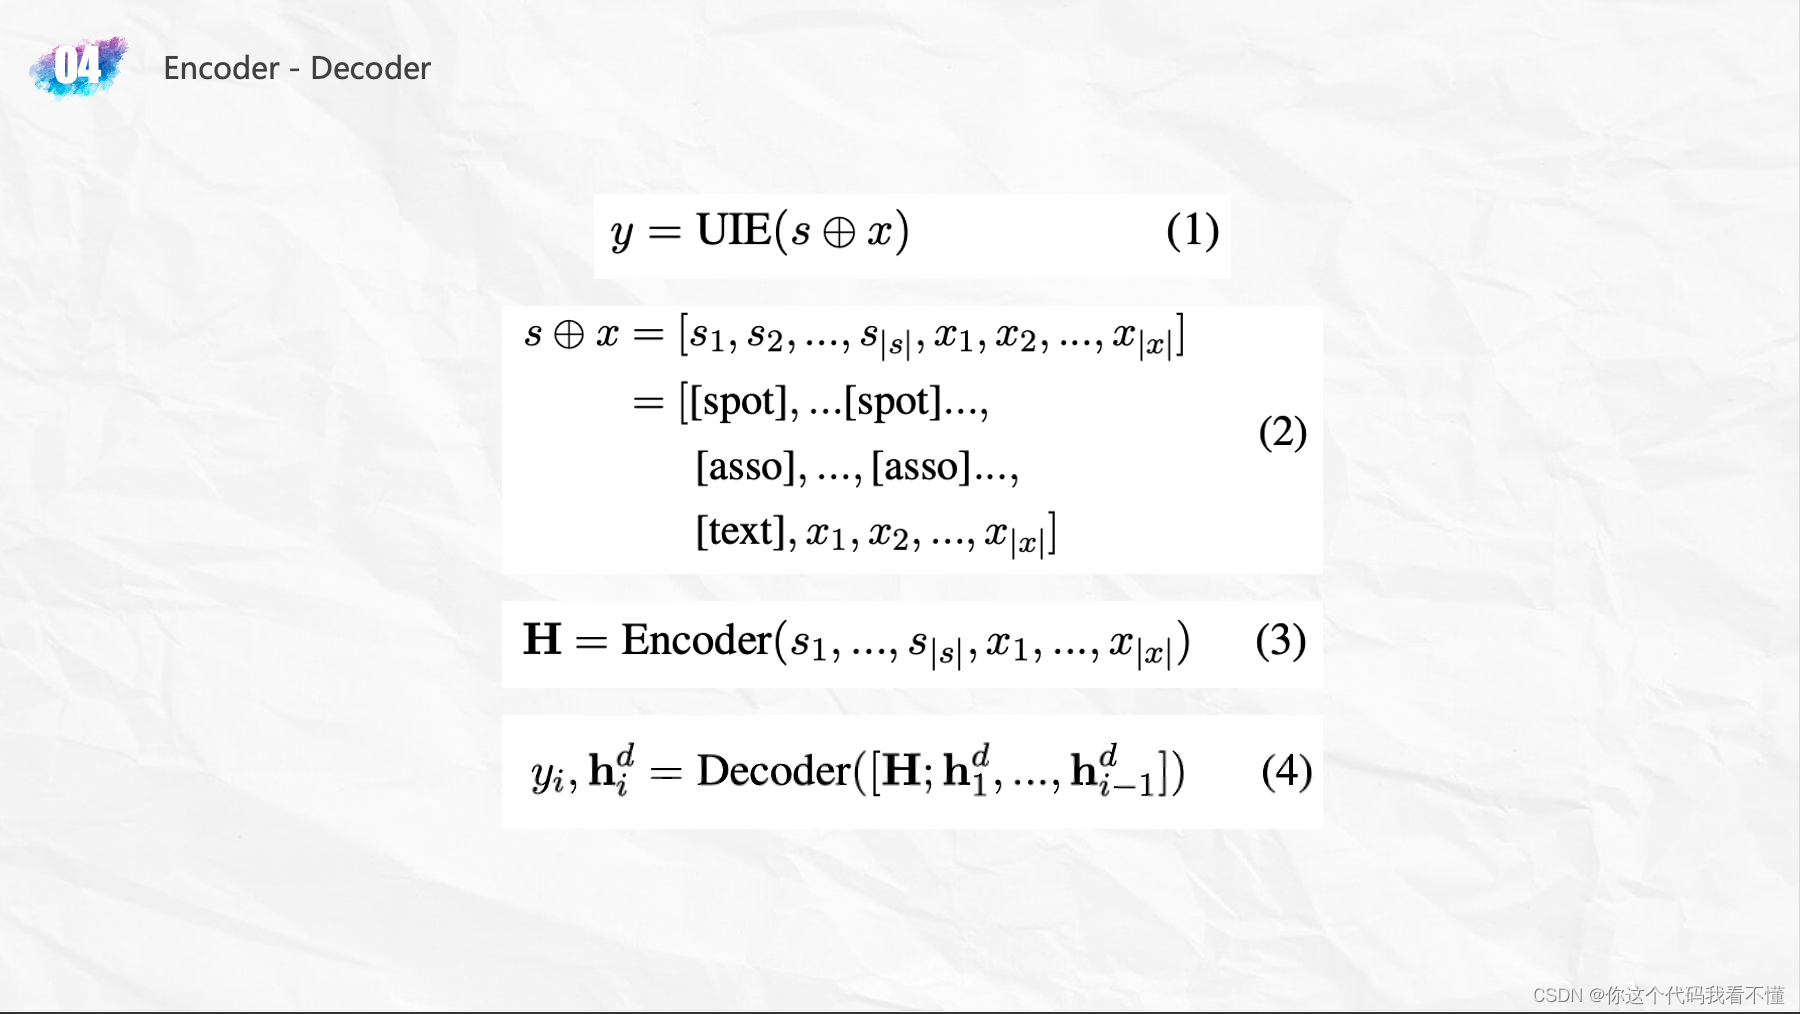
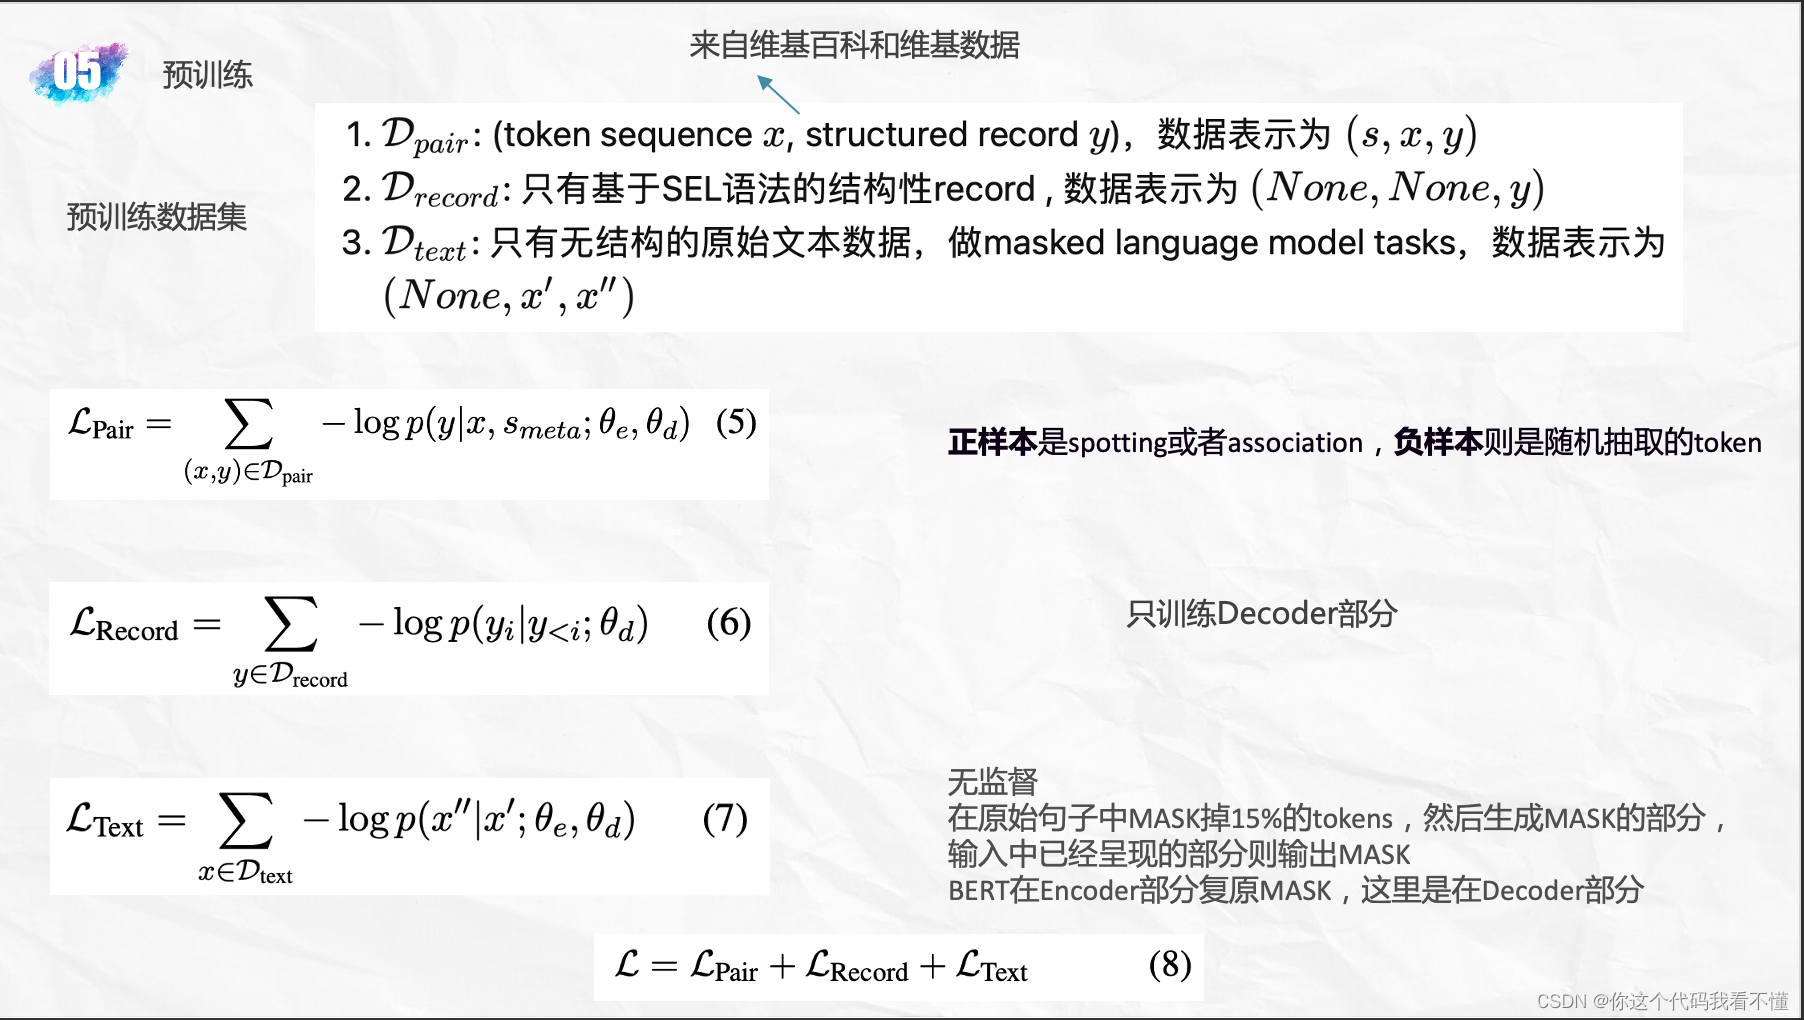
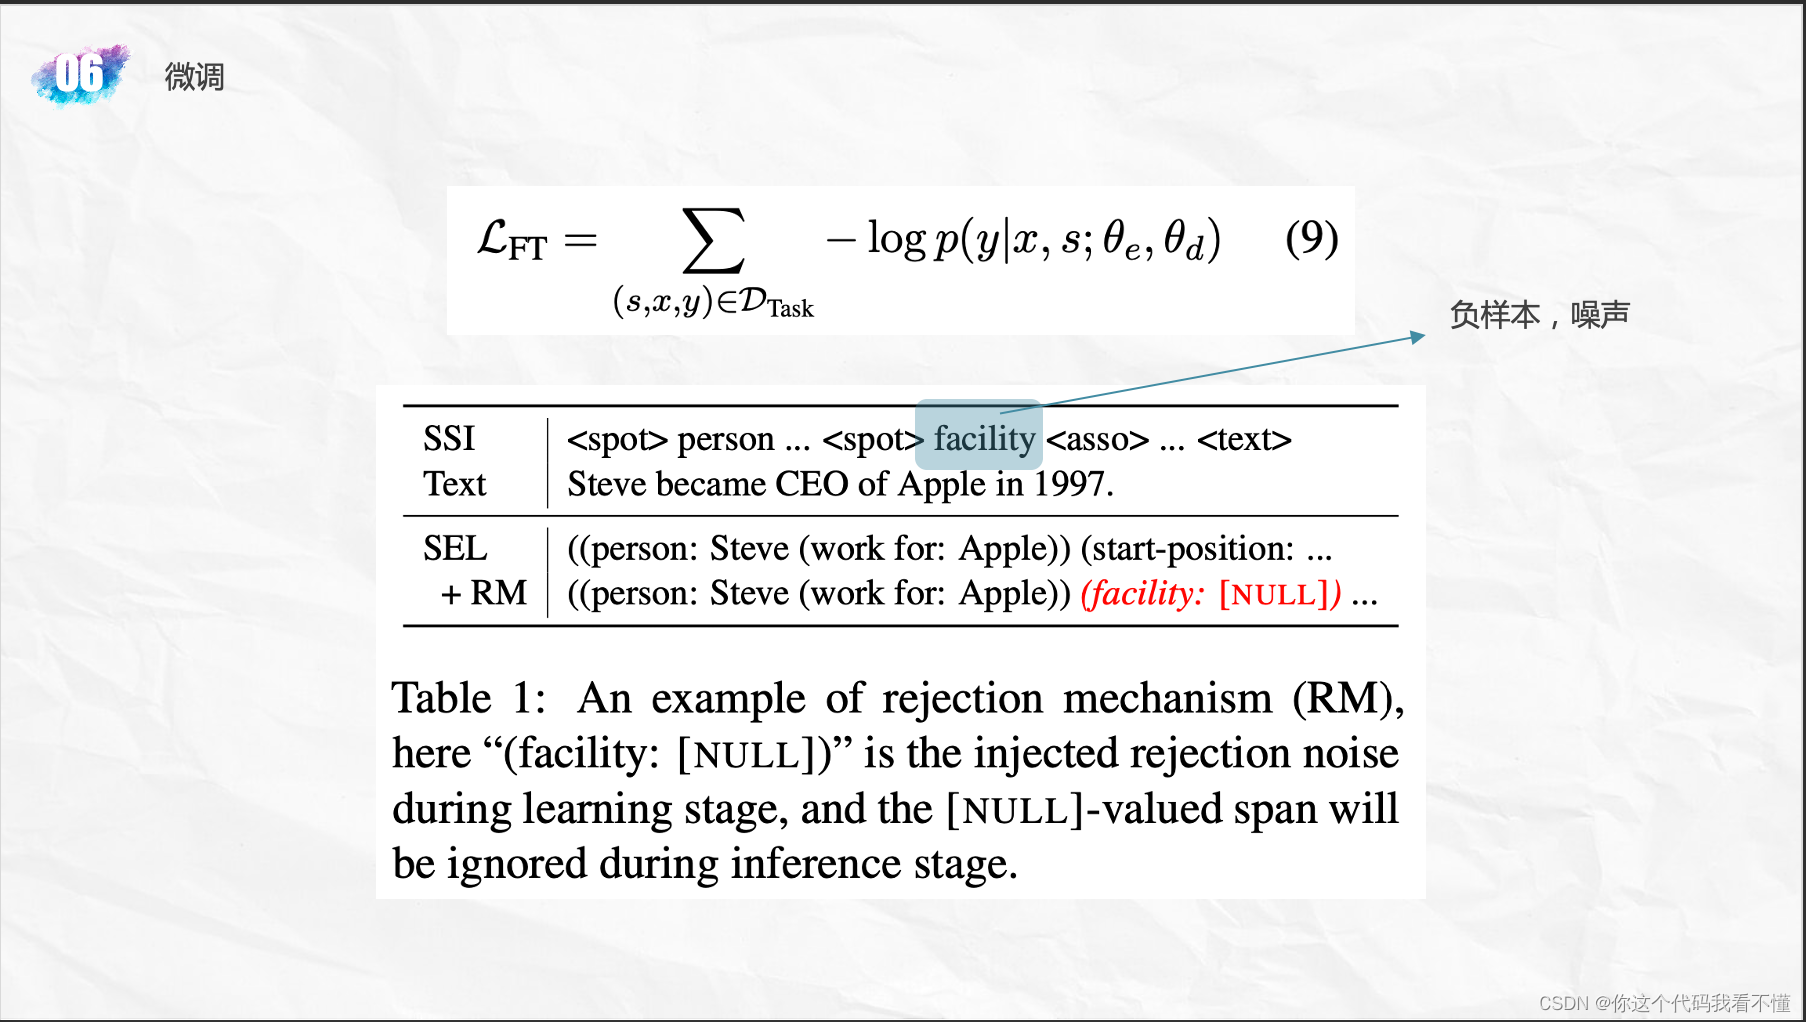

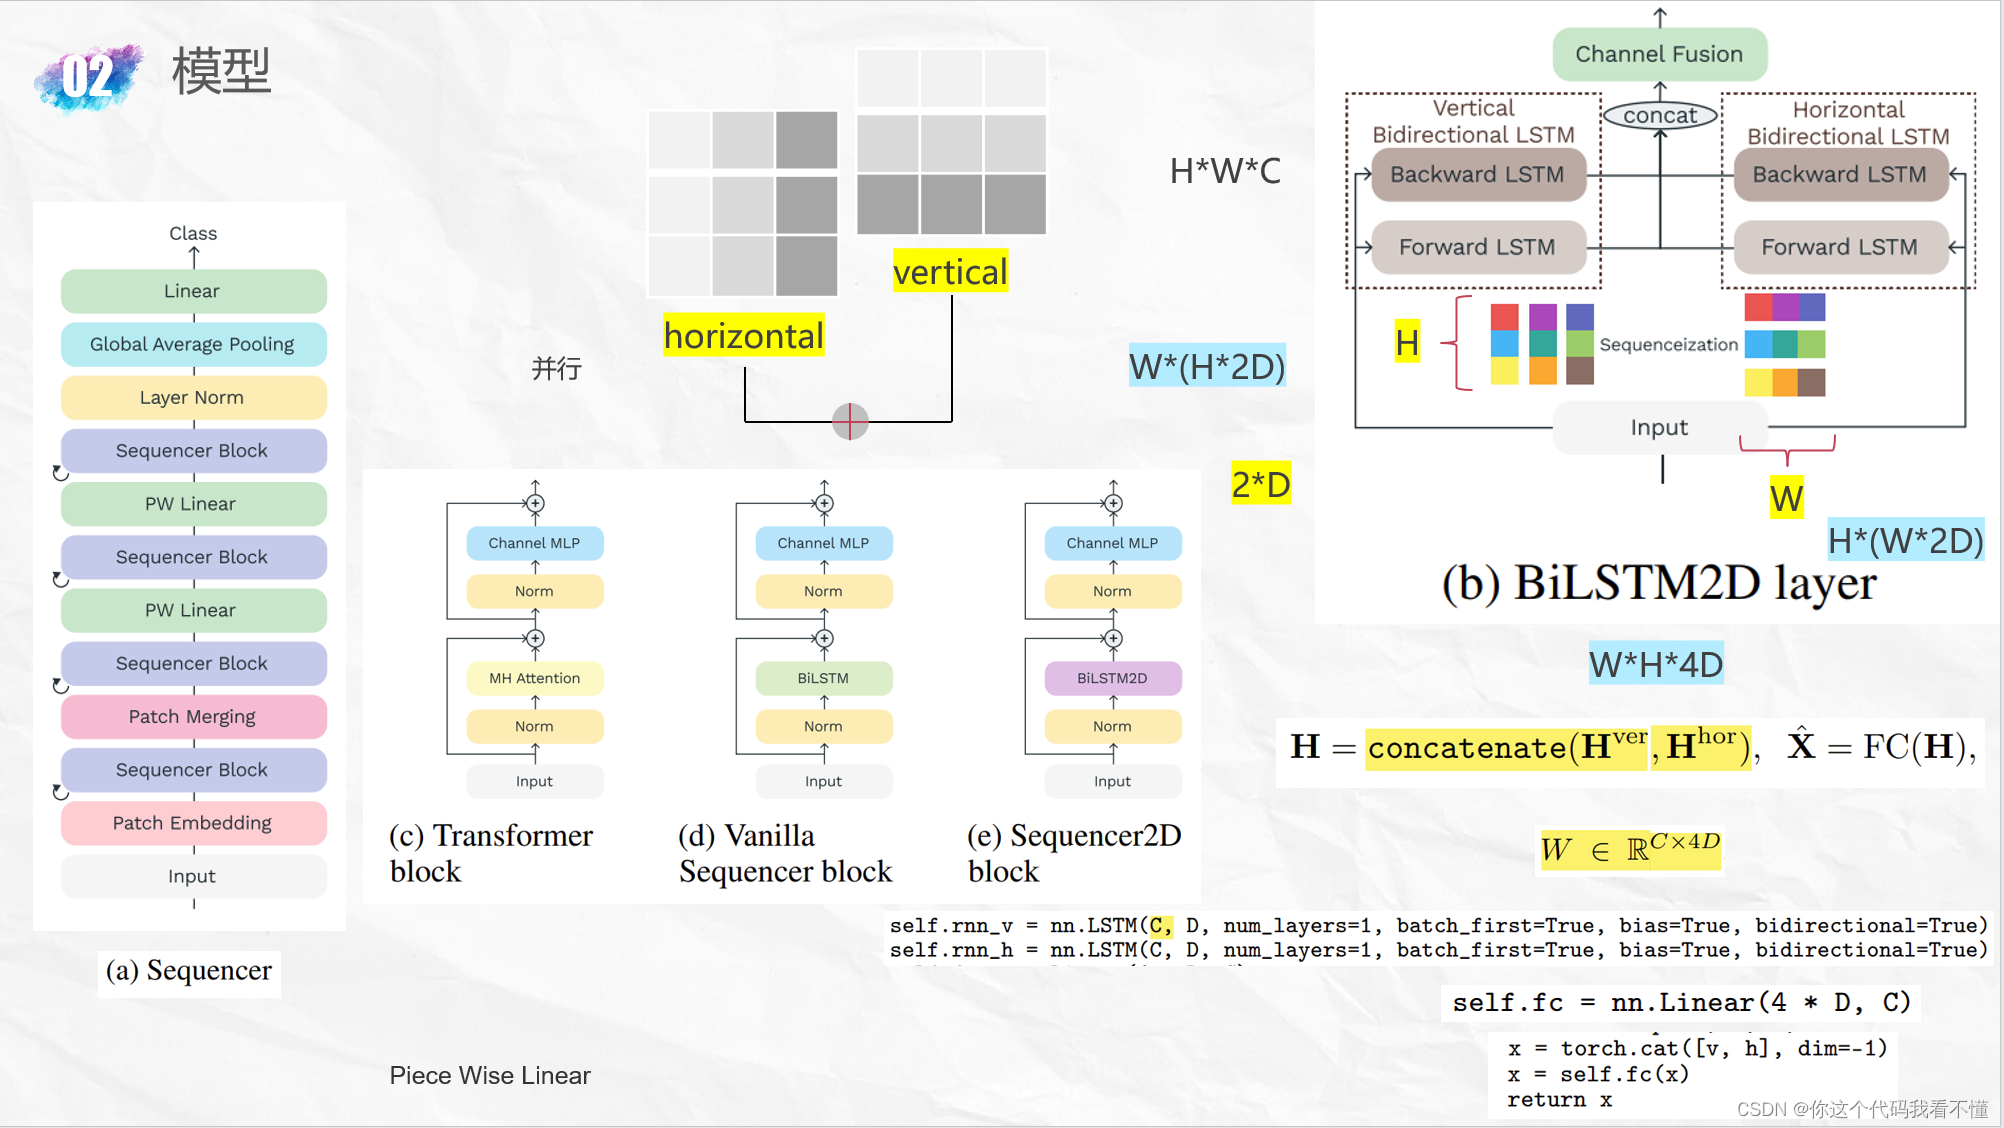
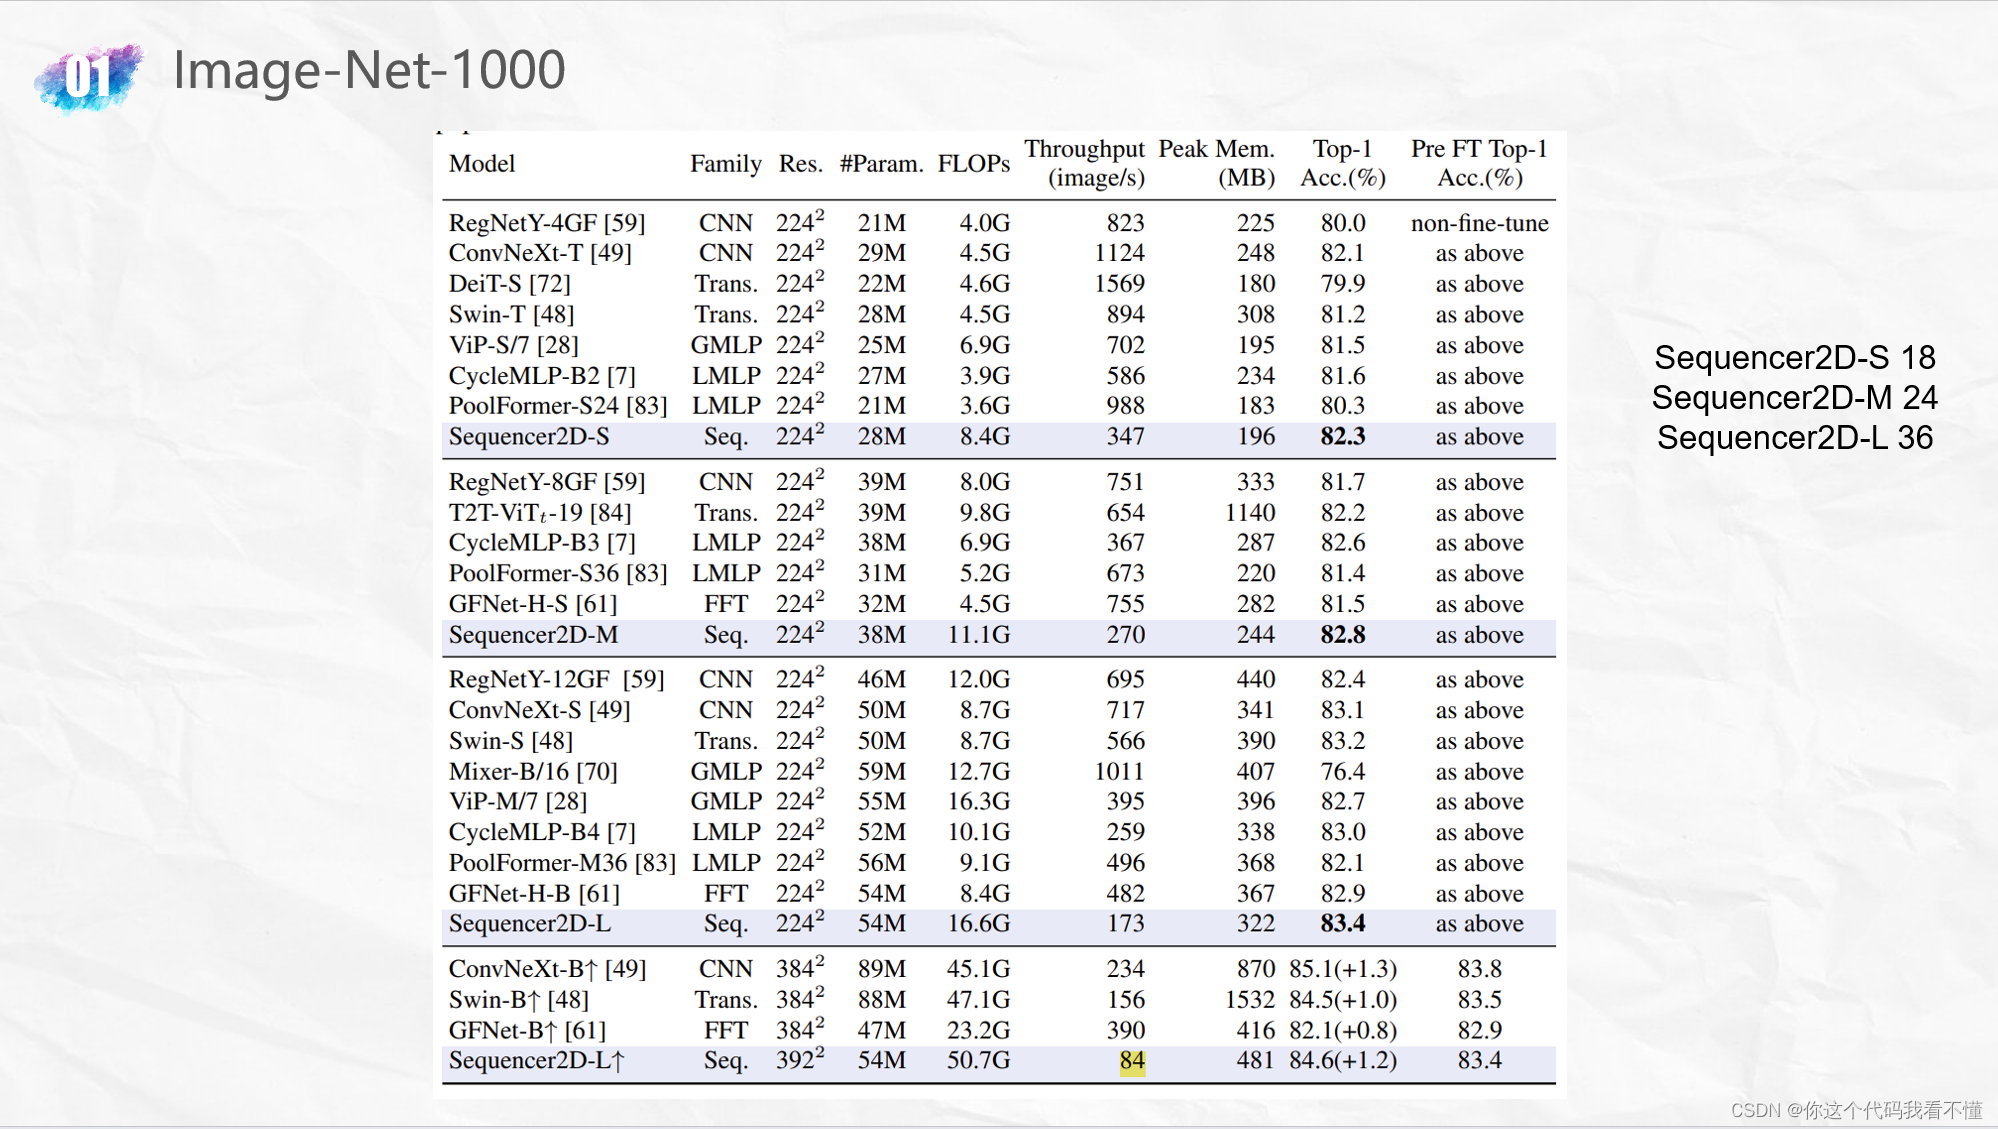
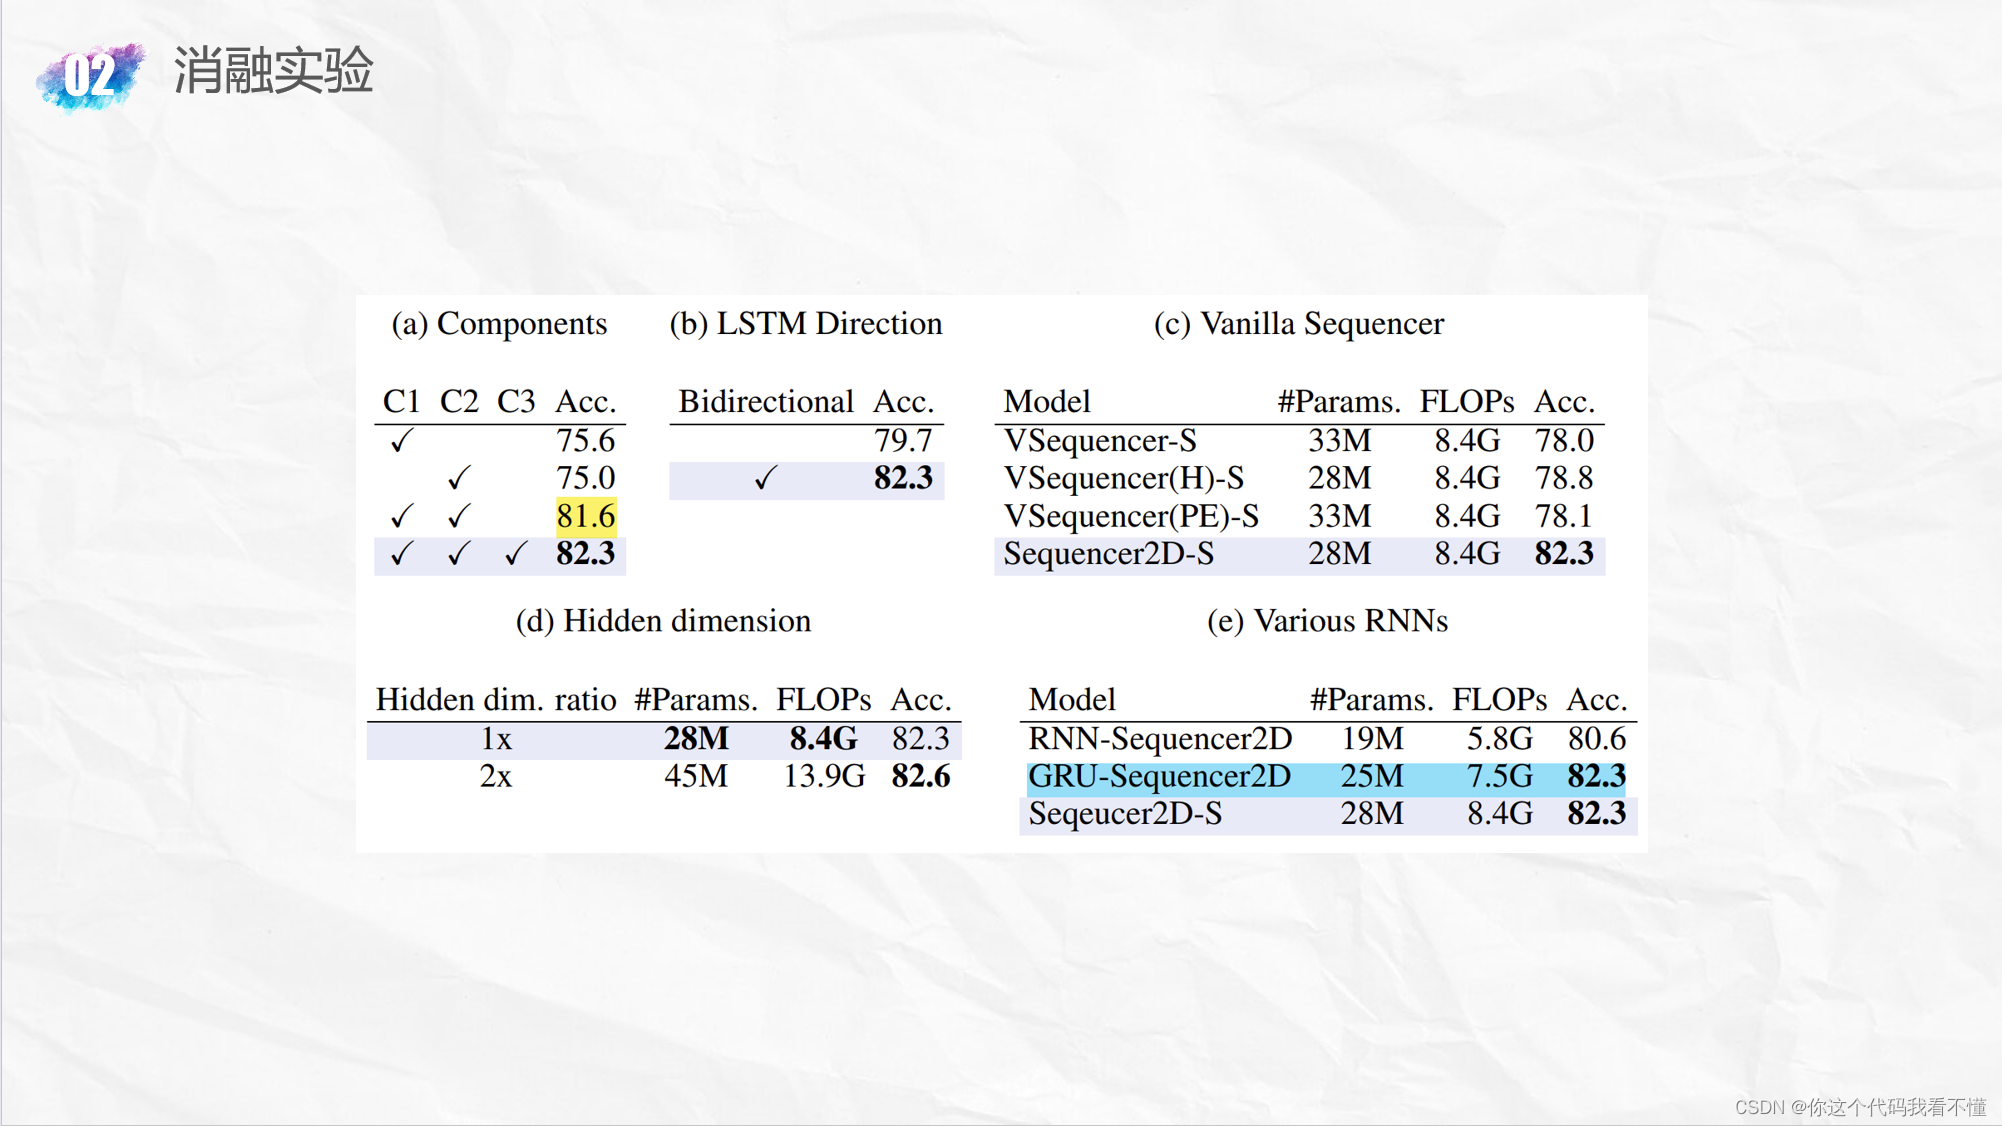
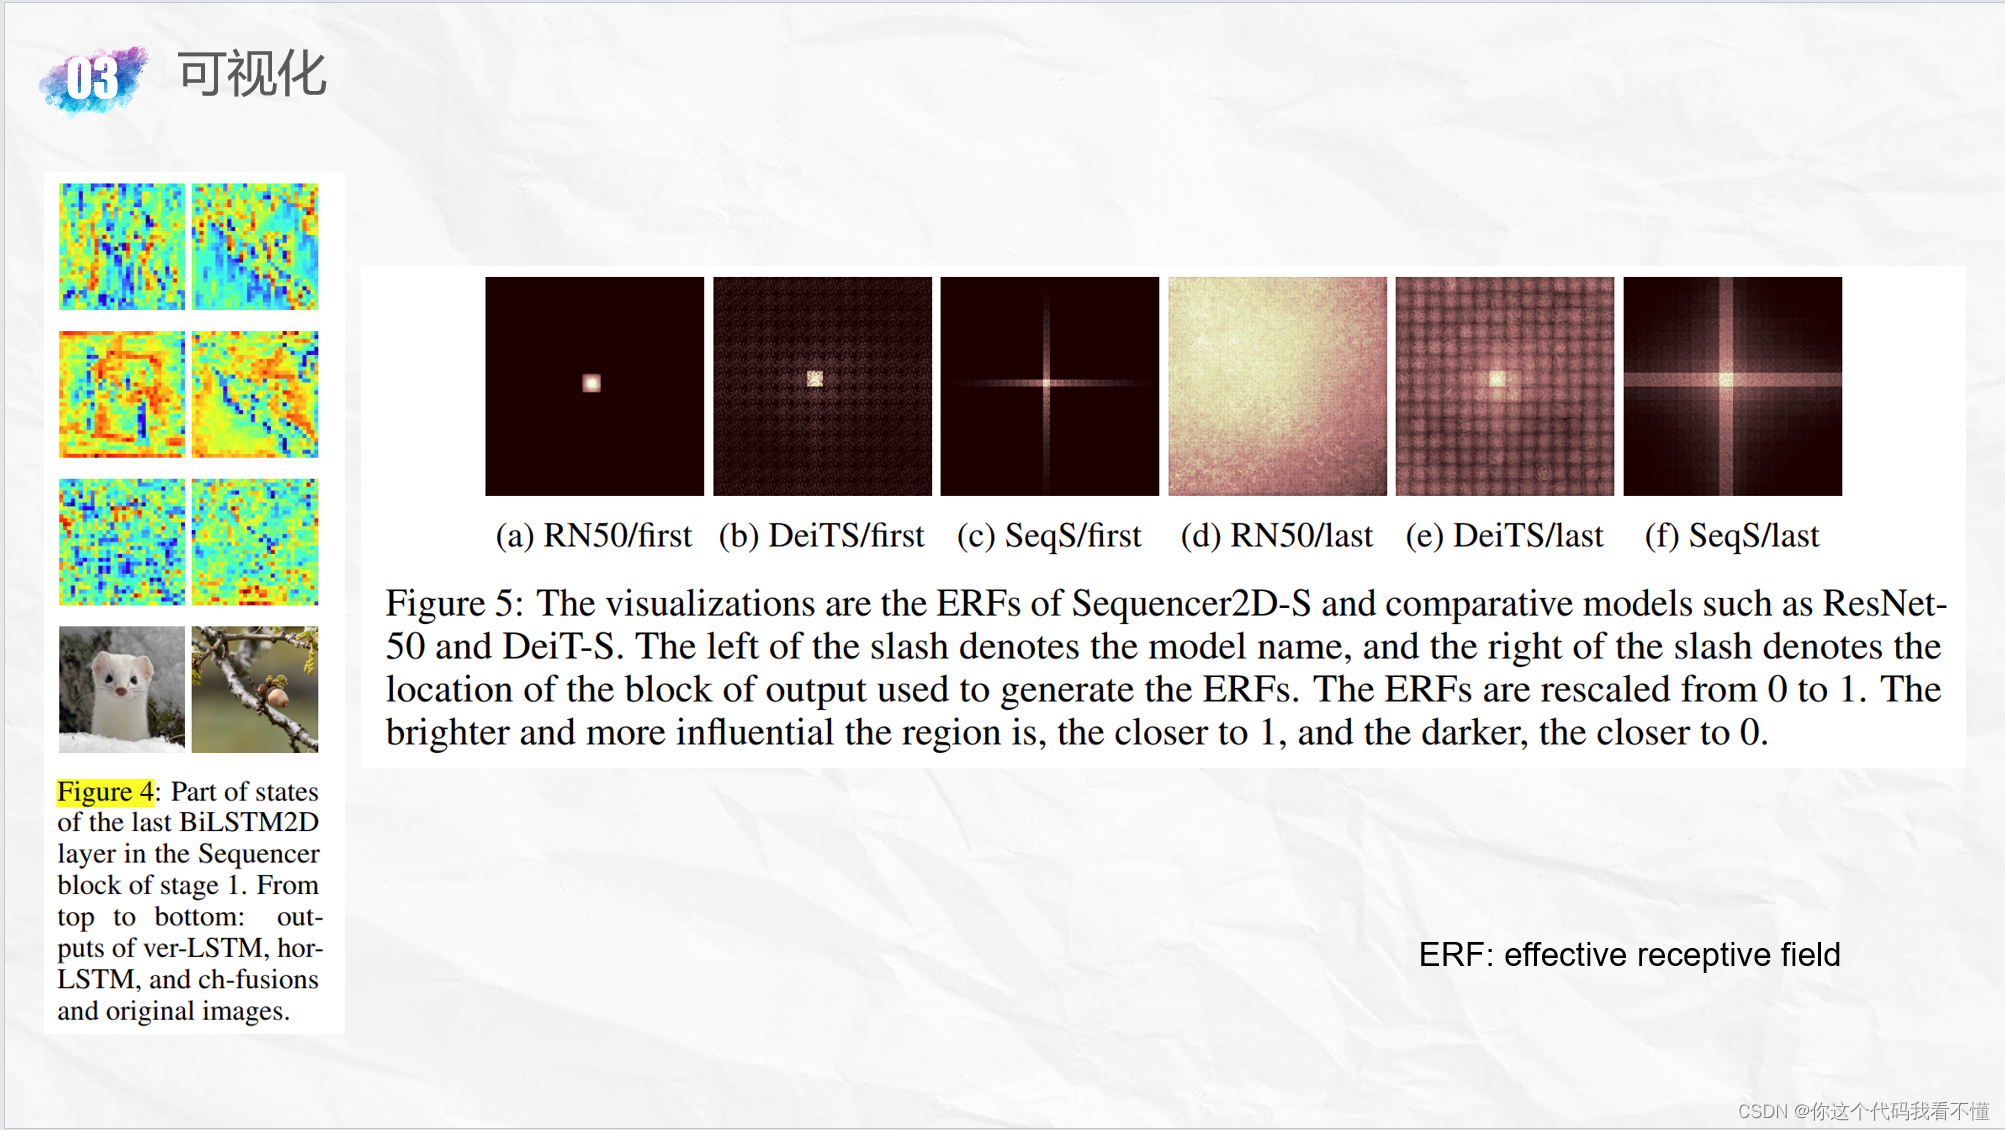
Sequencer: Deep LSTM for Image Classification
a m a x + b m a x ⇒ ( a + b ) m a x a_{max}+b_{max} \Rightarrow (a+b)_{max} amax+bmax⇒(a+b)max
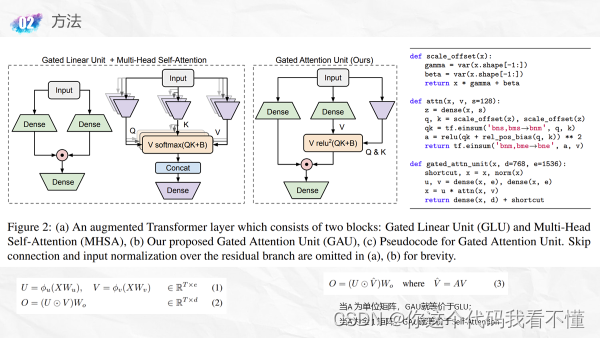
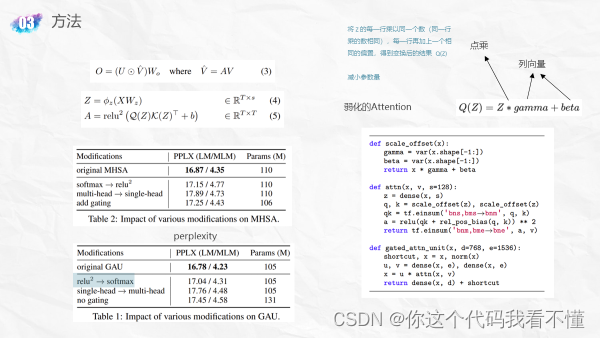
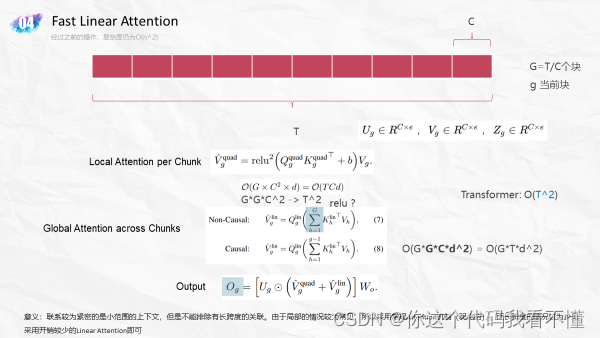
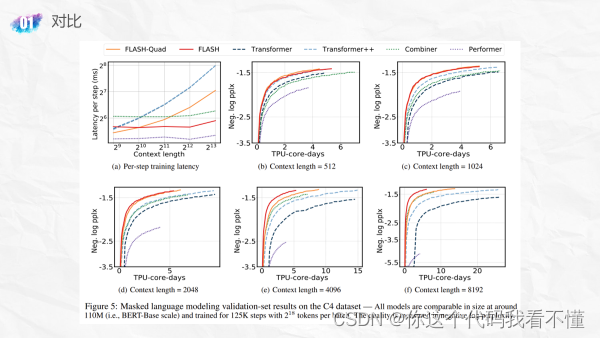
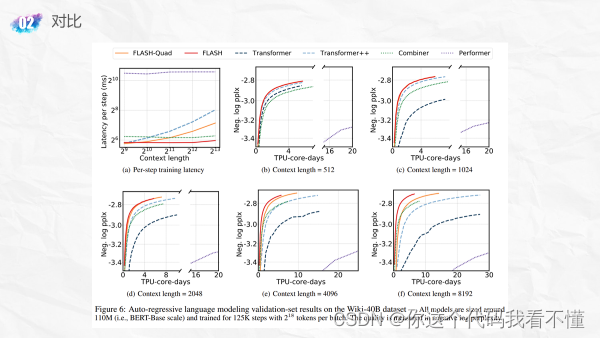
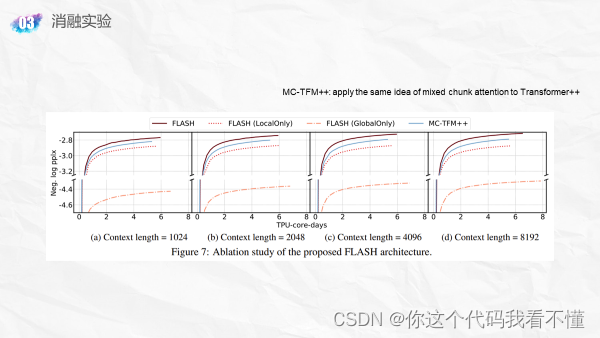
Transformer Quality in Linear Time
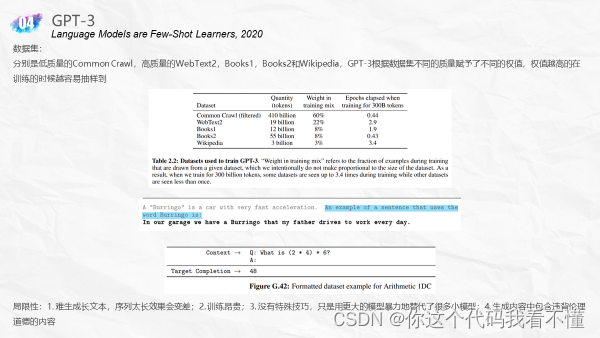
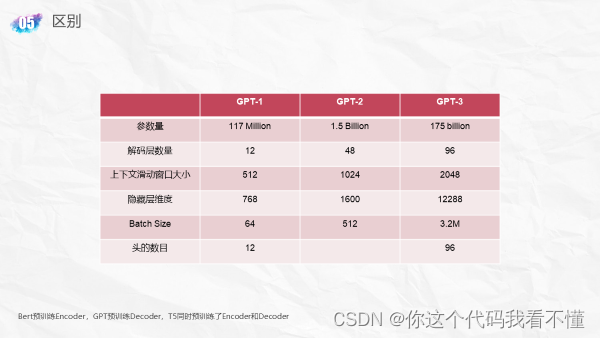
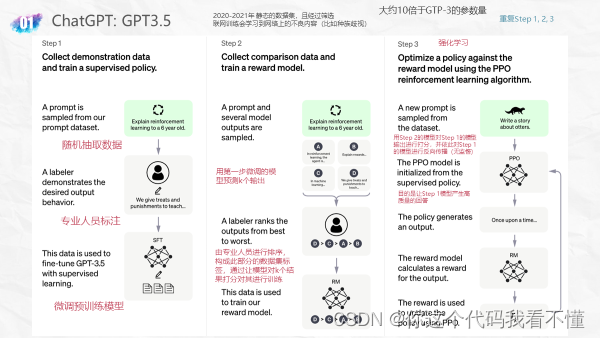
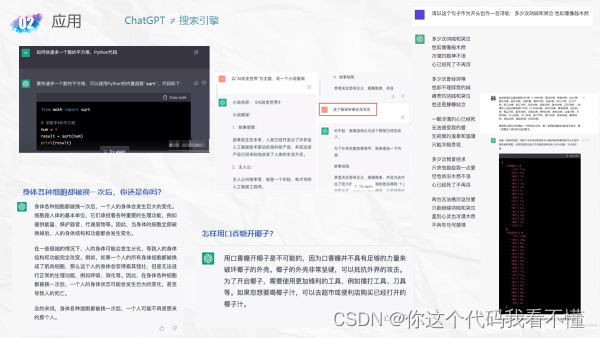
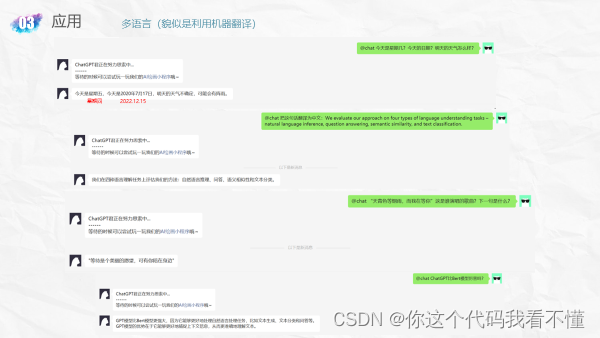
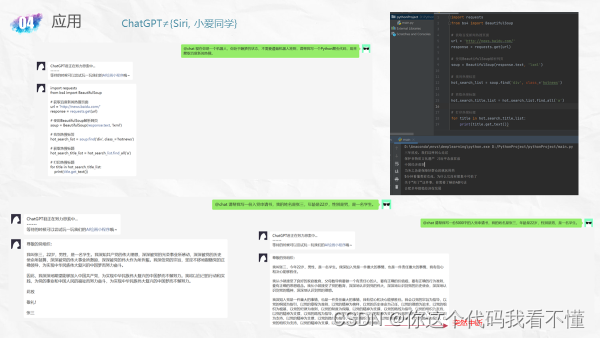
ChatGPT
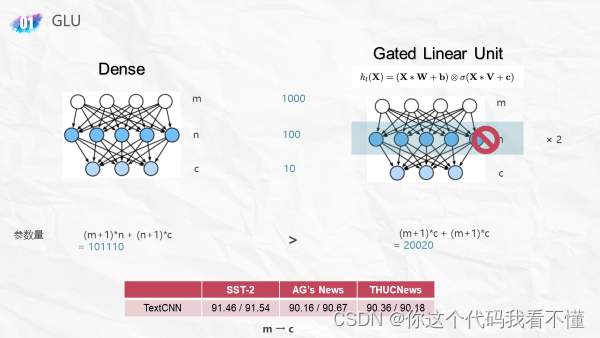
n
×
d
n \times d
n×d
Decoder模块的n相当于为1……
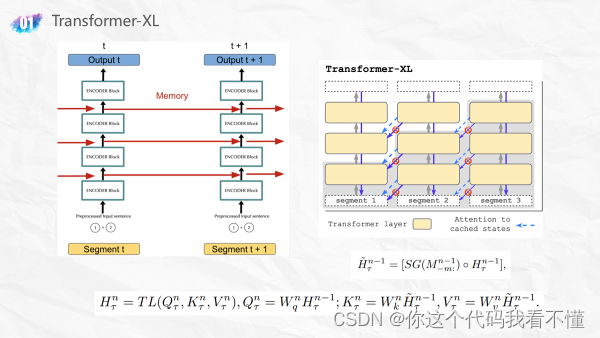
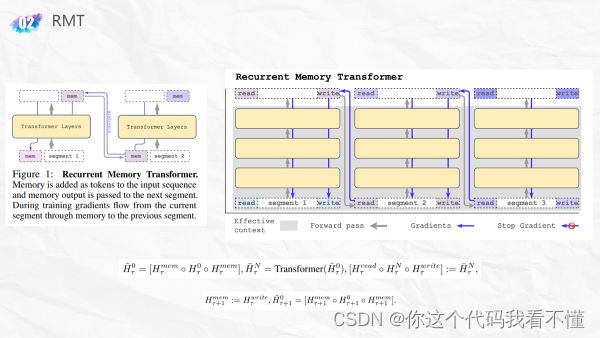
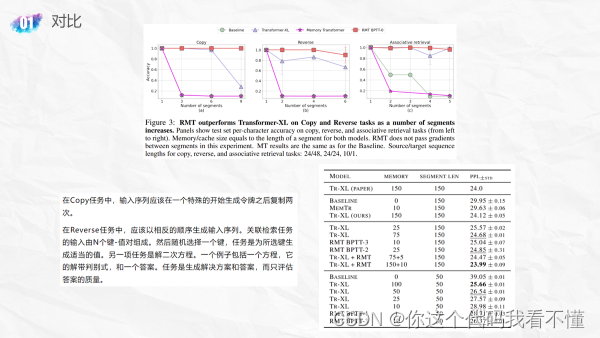
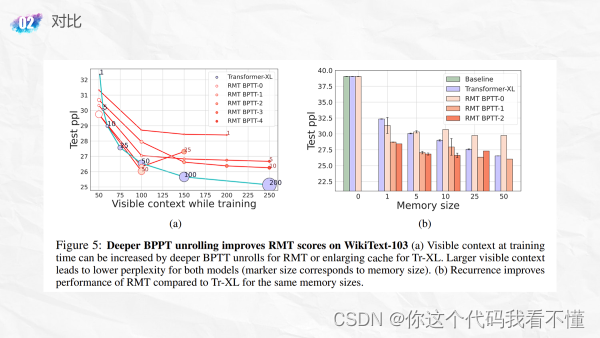
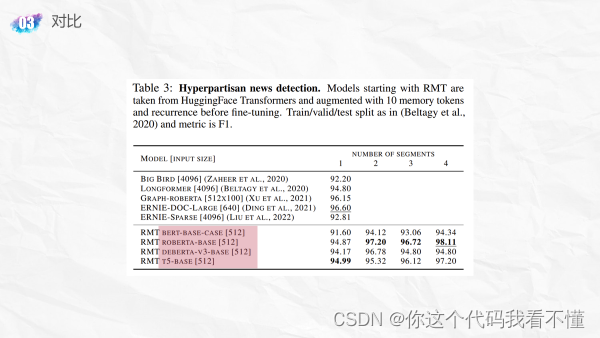
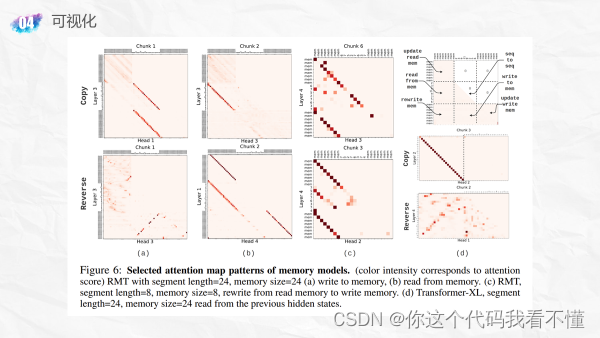
Recurrent Memory Transformer
Diffusion+
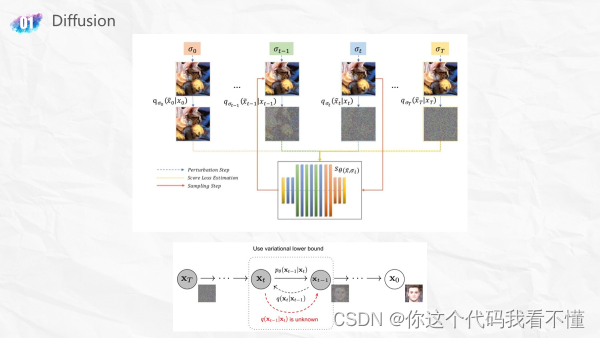
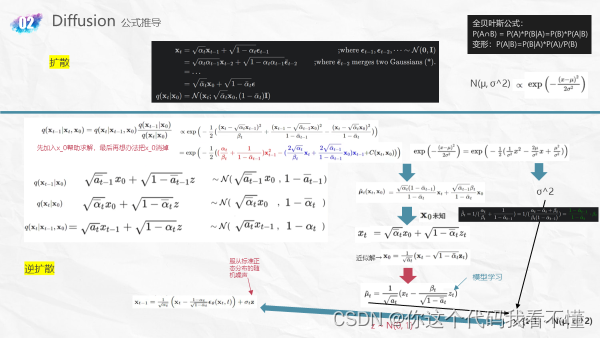
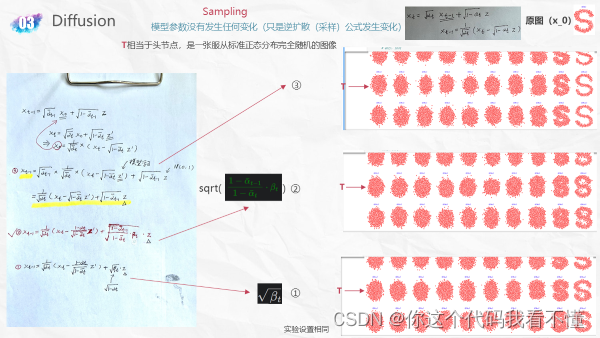
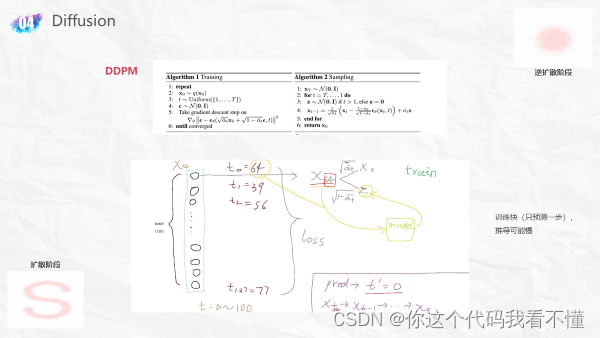
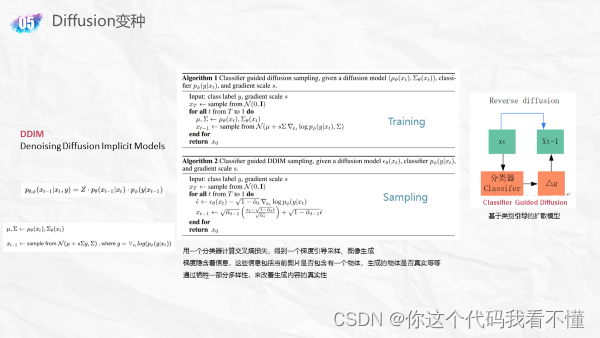
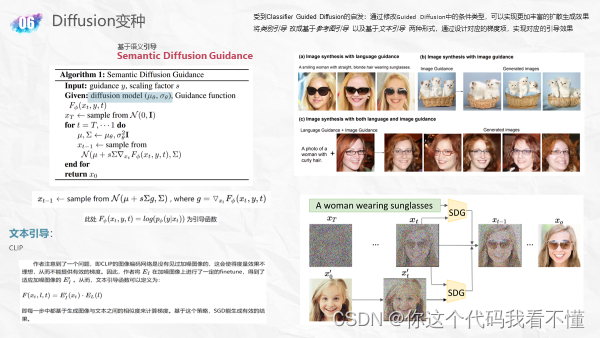
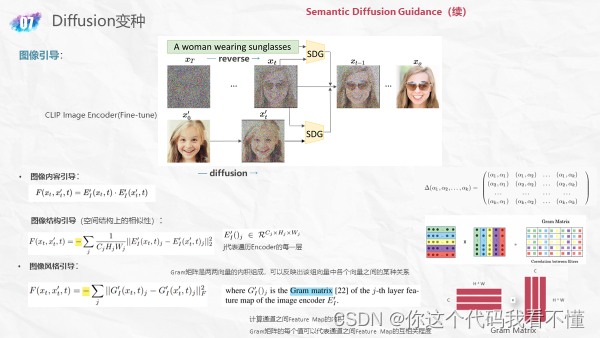
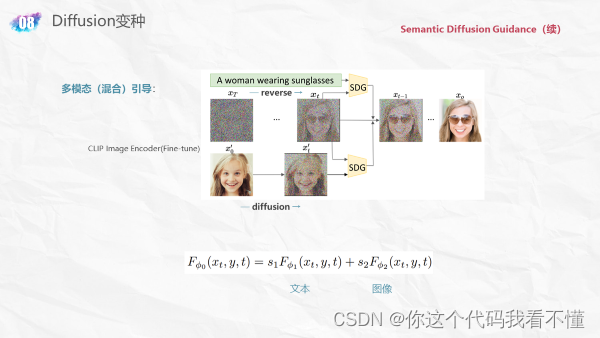
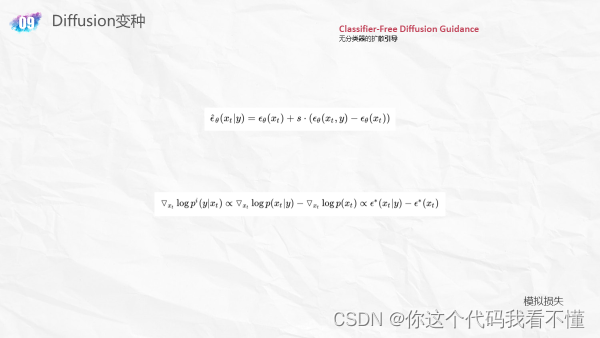
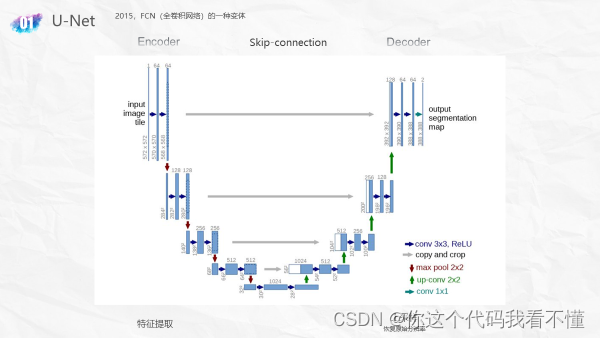
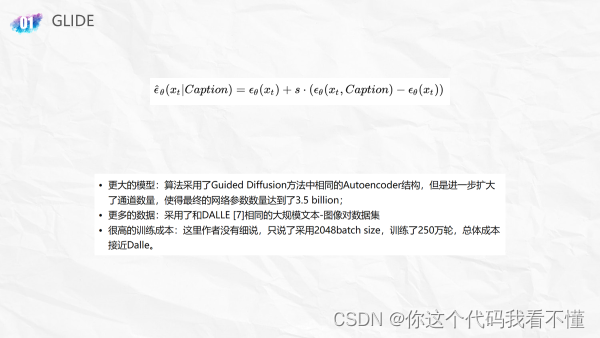
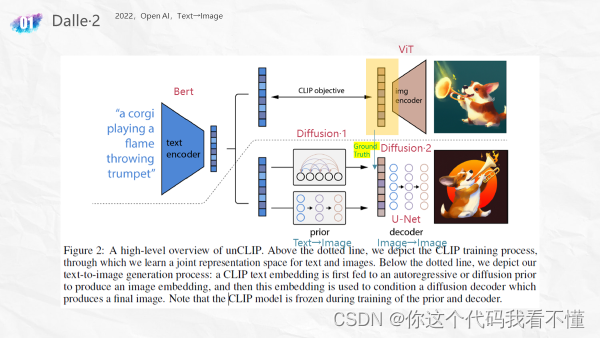
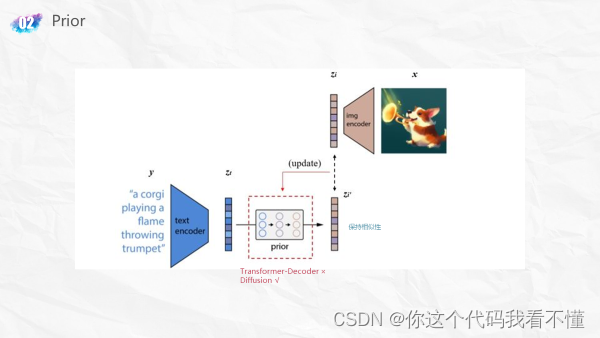
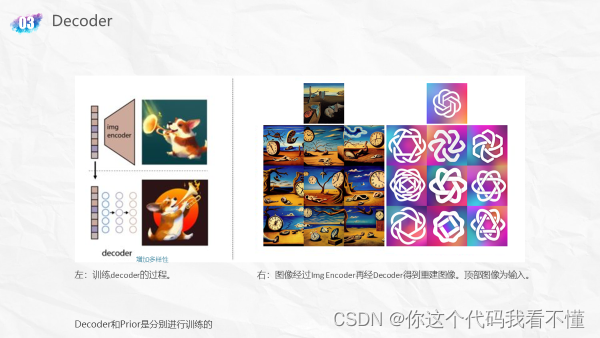
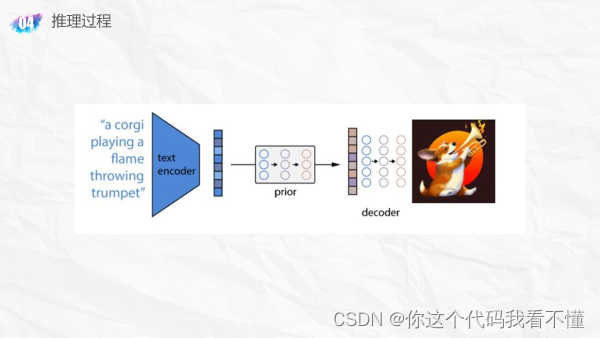
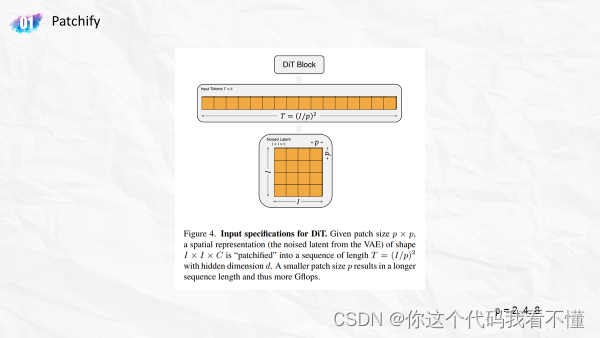
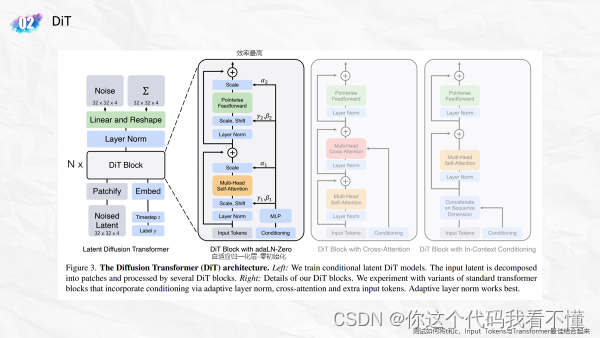
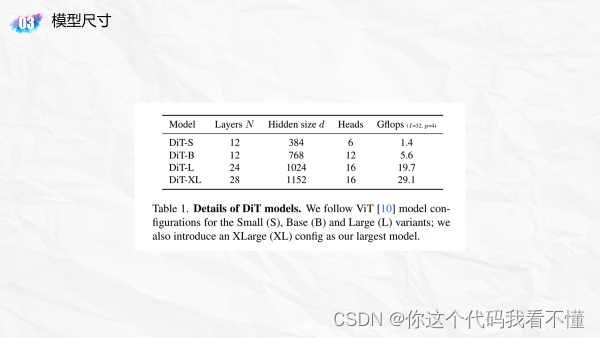
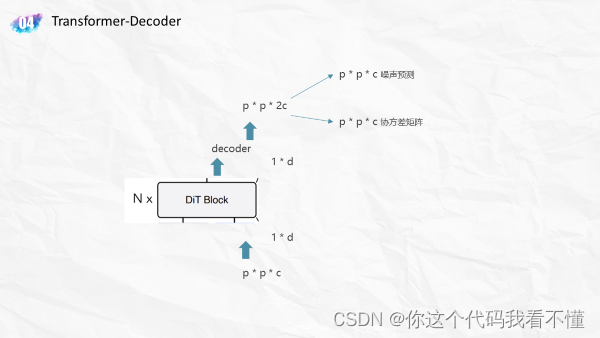
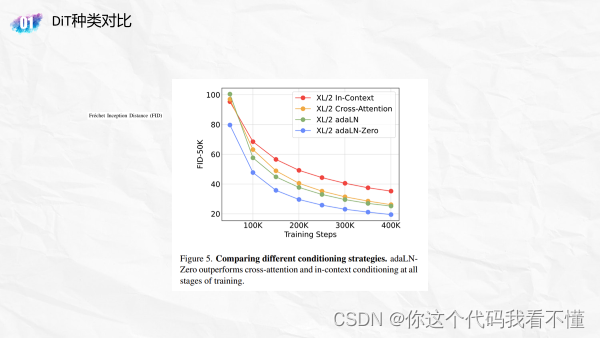
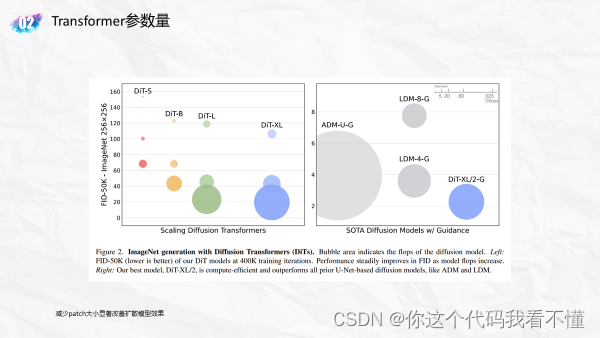
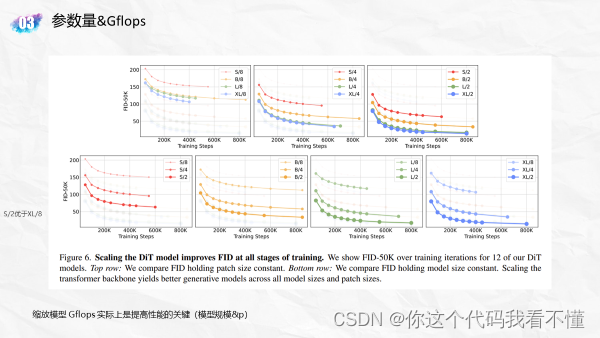
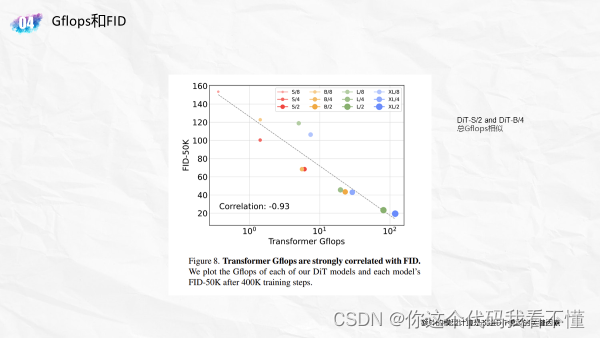
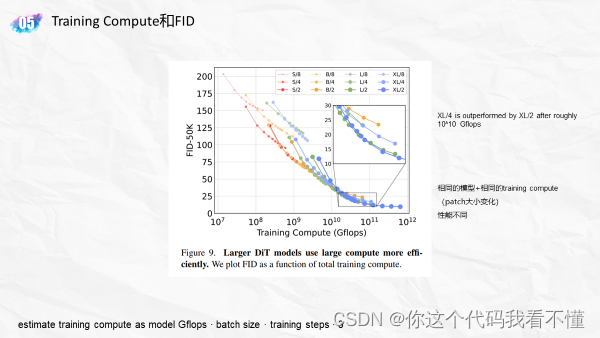
Scalable Diffusion Models with Transformers
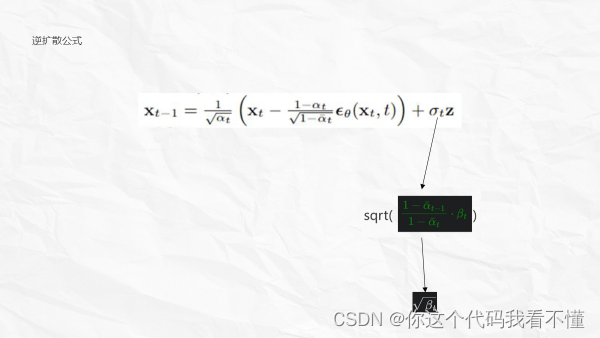
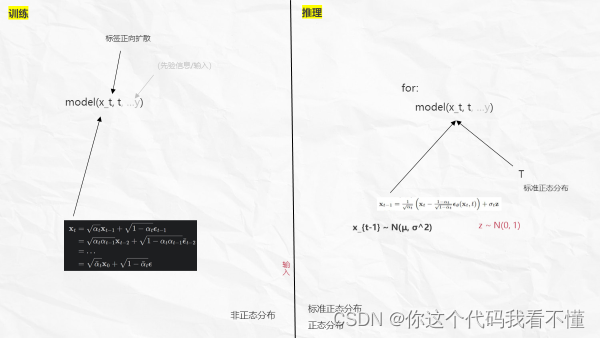
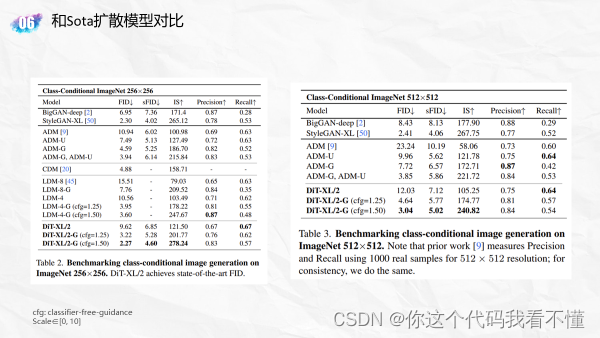
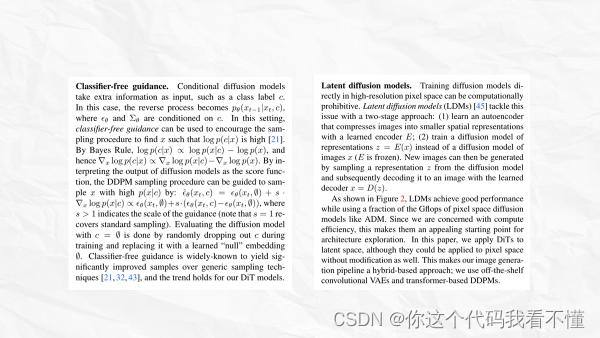
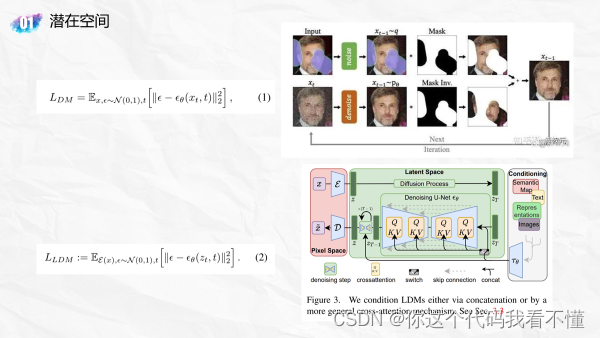
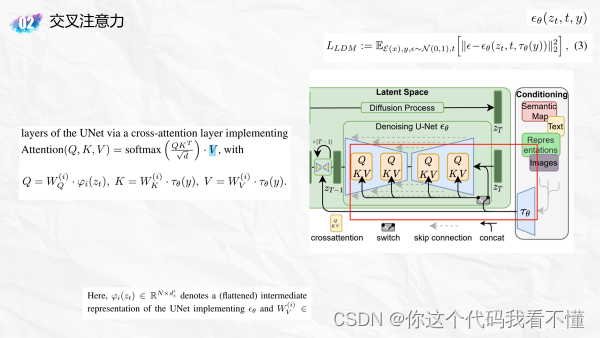
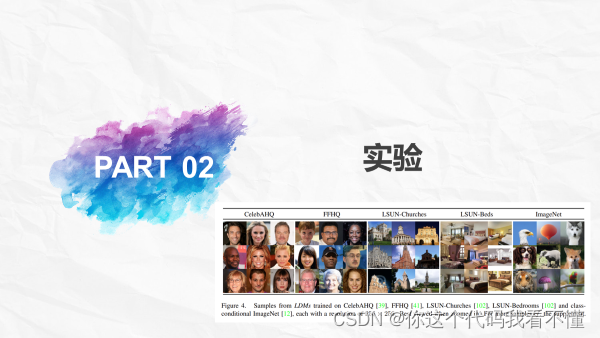
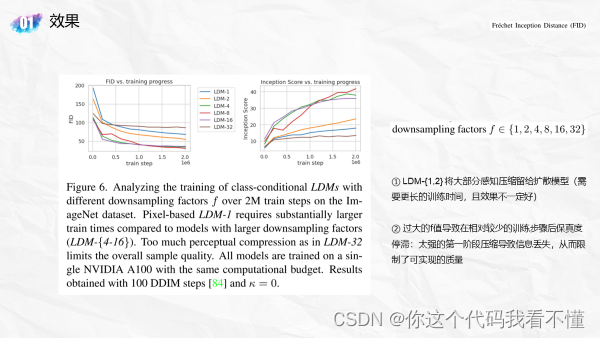
High-Resolution Image Synthesis with Latent Diffusion Models
👉 Previous
自然语言处理NLP文本分类顶会论文阅读笔记(一)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献4条内容

所有评论(0)