JdbcTemplate通过rewriteBatchedStatements参数实现批量插入 大数据量实现秒级导入
·
JdbcTemplate
- 它是spring框架提供的一个对象,这个对象对原始的jdbc api做了简单封装,提供了很多可以操作关系型数据库的api。
- 它的好处就是通过sql+参数的形式进行模板化了编程,比如还有HibernateTemplate,RedisTemplate,JmsTemplate等等
rewriteBatchedStatements参数
- MySQL Jdbc驱动在默认情况下会逐条执行一组sql语句,那么性能就不会好
- 当在url上指定rewriteBatchedStatements=true, 驱动才会帮你批量执行sql,如
jdbc:mysql://ip:port/db_name?useUnicode=true&characterEncoding=UTF-8&rewriteBatchedStatements=true
- 这个参数对INSERT/UPDATE/DELETE都有效
- 驱动所做的事就是把多条sql语句累积起来再一次性发出去,比如发送10次insert 请求变成发送一次请求,内容为"insert into
t (…) values (…) , (…), (…)"
创建JdbcTemplate对象
public static JdbcTemplate connectDataSource(ConnectVo dataBaseInfo) throws SQLException {
    DruidDataSource dataSource = new DruidDataSource();
    String url = "";
    switch (dataBaseInfo.getDbType())
    {
        case "DS_MYSQL":
            url = String.format("jdbc:mysql://%s:%s/%s?useSSL=false&useUnicode=true&characterEncoding=UTF-8&rewriteBatchedStatements=true", dataBaseInfo.getIp(), dataBaseInfo.getPort(), dataBaseInfo.getSchemal());
            break;
        case "DS_ORACLE":
            url = String.format("jdbc:oracle:thin:@%s:%s/%s", dataBaseInfo.getIp(), dataBaseInfo.getPort(), dataBaseInfo.getSchemal());
            break;
        case "DS_SQLSERVER":
            url = String.format("jdbc:sqlserver://%s:%s;DatabaseName=%s", dataBaseInfo.getIp(), dataBaseInfo.getPort(), dataBaseInfo.getSchemal());
            break;
        case "DS_HIVE":
            url = String.format("jdbc:hive2://%s:%s/%s", dataBaseInfo.getIp(), dataBaseInfo.getPort(), dataBaseInfo.getSchemal());
            break;
        default:
            break;
    }

    dataSource.setUrl(url);
    dataSource.setDriverClassName(dataBaseInfo.getDriver());
    dataSource.setUsername(dataBaseInfo.getUser());
    dataSource.setPassword(dataBaseInfo.getPassword());
    //初始化时建立物理连接的个数,初始化发生在显示调用init方法,或者第一次getConnection时
    dataSource.setInitialSize(1);
    //获取连接时最大等待时间,单位毫秒,配置了maxWait之后,缺省启用公平锁,并发效率会有所下降,
    // 如果需要可以通过配置useUnfairLock属性为true使用非公平锁
    dataSource.setMaxWait(6000);
    dataSource.setTimeBetweenEvictionRunsMillis(60000);
    dataSource.setMinEvictableIdleTimeMillis(300000);
    dataSource.setTestWhileIdle(true);
    dataSource.setTestOnBorrow(false);
    dataSource.setTestOnReturn(false);
    dataSource.init();

    return new JdbcTemplate(dataSource);
}
@Data
public class ConnectVo {

    //MYSQL、ORACLE、HIVE
    private String dbType;

    /**
     * IP
     */
    private String ip;

    /**
     * 端口
     */
    private String port;

    /**
     * SCHEMA
     */
    private String schemal;

    /**
     * 驱动
     */
    private String driver;

    /**
     * 用户名
     */
    private String user;

    /**
     * 密码
     */
    private String password;


}
测试实例
StopWatch stopWatch = new StopWatch();
stopWatch.start("方式一:batchUpdate(final String... sql)");
String[] insertArray = new String[10000];
for(int i =0;i<10000;i++){
    StringBuffer sb = new StringBuffer("insert into test_jdbc_batch(id,name,age) values('");
    sb.append(UUID.randomUUID().toString()).append("','zhangdan',12)");
    insertArray[i] = sb.toString();
}
jdbcTemplate.batchUpdate(insertArray);
stopWatch.stop();
stopWatch.start("方式二:batchUpdate(String sql, List<Object[]> batchArgs)");
List<Object[]> list = new ArrayList<>(10000);
for(int i =0;i<10000;i++){
    Object[] object = new Object[]{UUID.randomUUID().toString(),"lisi",15};
    list.add(object);
}
jdbcTemplate.batchUpdate("insert into test_jdbc_batch(ID, NAME, AGE) VALUES (?,?,?)",list);
stopWatch.stop();
stopWatch.start("方式三:execute(final String sql)一条一条的插入");
for(int i =0;i<10000;i++){
    StringBuffer sb = new StringBuffer("insert into test_jdbc_batch(id,name,age) values('");
    sb.append(UUID.randomUUID().toString()).append("','zhangdan',12)");
    jdbcTemplate.execute(String.valueOf(sb));
}
stopWatch.stop();


System.out.println(stopWatch.prettyPrint());
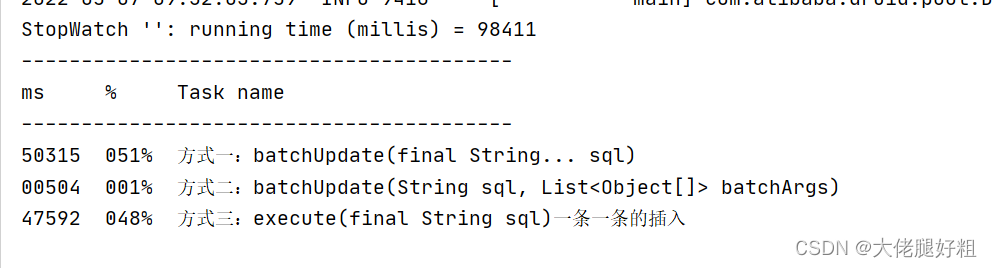
以上三种方式,通过Stopwatch 对三种方式进行计时,可以看出batchUpdate(final String… sql)=execute(final String sql)一条一条的插入的时间,1万条大约在50秒;而通过batchUpdate(String sql, List<Object[]> batchArgs)方式,实现了不到1秒就插入了

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献7条内容

所有评论(0)