Python爬虫学习——Requests入门二(五)
·
Python爬虫学习
前言
使用Requests获取百度翻译的结果
一、介绍
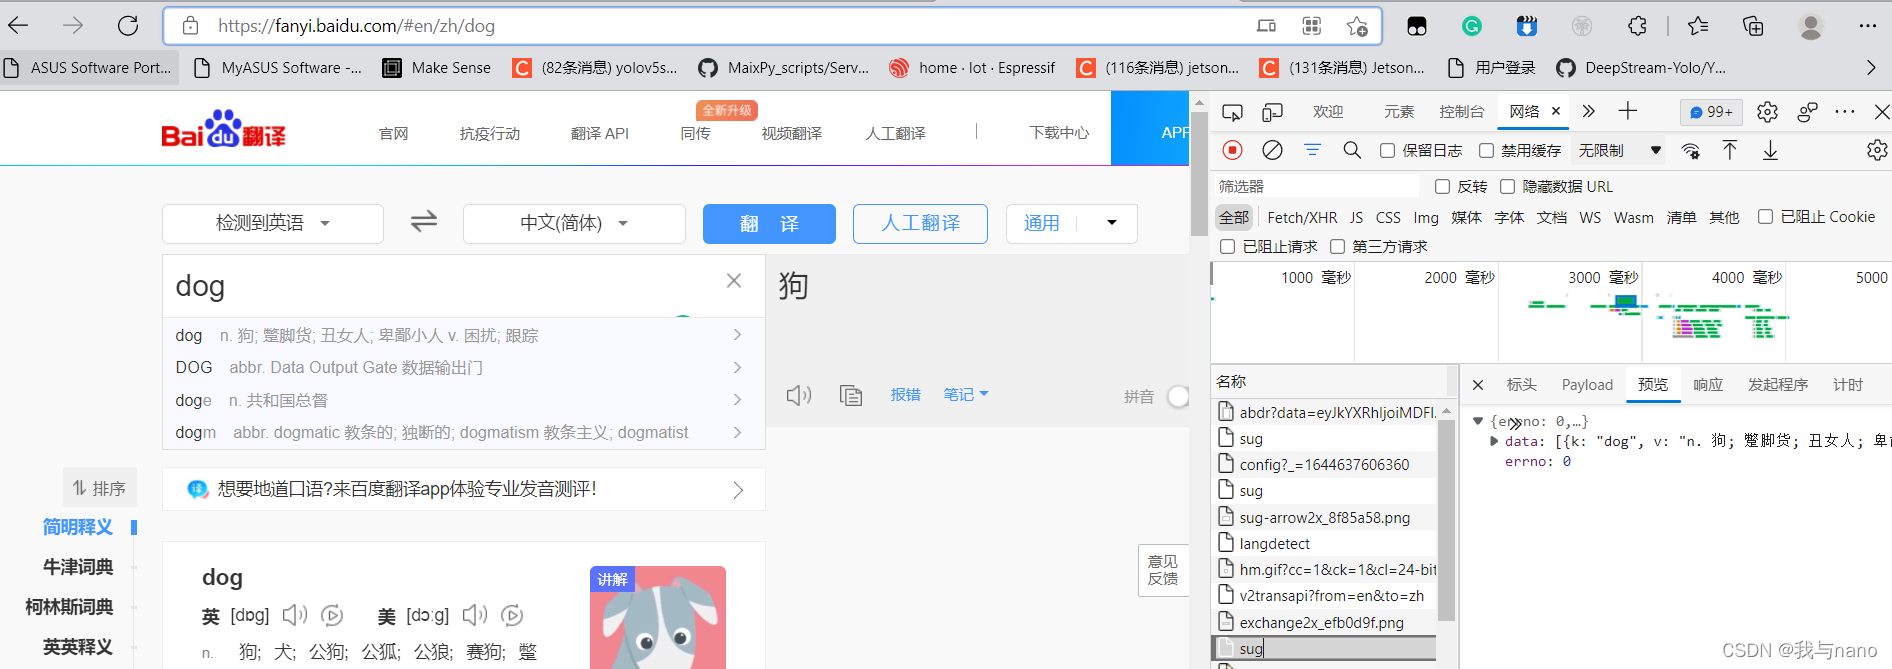
找到sug,你会看到相关信息,说明我们可以通过这个url获取到相关信息
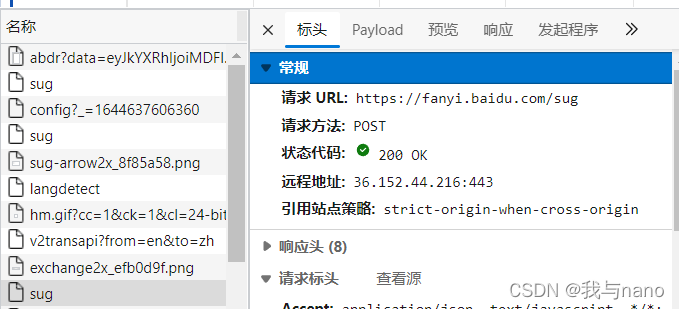
可以看到它的请求方法是post
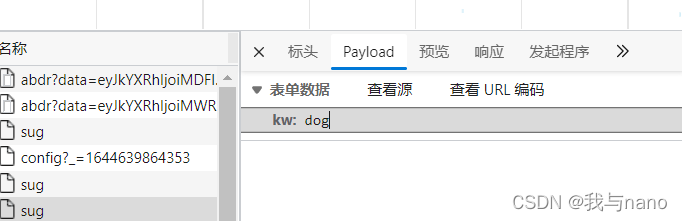
在Payload中可以看到要识别的单词(参数名字叫KW)
二、代码实现
import requests #导入requests
query=input("输入你想要翻译的内容")
url="https://fanyi.baidu.com/sug"
dat={"kw":query}  #标志
resp=requests.post(url,data=dat)
print(resp.text)
因为请求方法是post所以这里也使用requests.post

可以看到会出现一些乱码
在响应头看数据类型
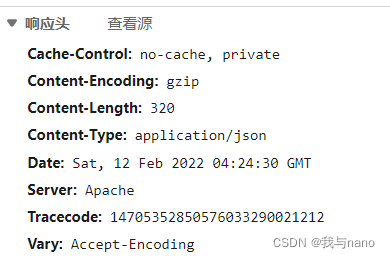
可以看到是json类型
import requests #导入requests
query=input("输入你想要翻译的内容")
url="https://fanyi.baidu.com/sug"
dat={"kw":query}
resp=requests.post(url,data=dat )
print(resp.json())#将服务器返回的内容直接处理成json(字典)

注意:发送post请求,发送的数据必须放在字典中,通过data参数进行传递
resp=requests.post(url,data=dat )

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献8条内容

所有评论(0)