机器学习sklearn-决策树
目录
1.相关概念
1.1 定义
分类决策树模型是一种描述对实例进行分类的树形结构.决策树由结点(node)和有向边( directed edge)组成.结点有两种类型:内部结点(internal node)和叶结点(leaf node)、内部结点表示一个特征或属性,叶结点表示一个类。
决策树的损失函数通常是正则化的极大似然函数。
1.2 生成过程
决策树的生成是一个递归过程.在决策树基本算法中,有三种情形会导致递归返回: (1)当前结点包含的样本全属于同一类别,无需划分;(2)当前属性集为空,或是所有样本在所有属性上取值相同,无法划分;(3)当前结点包含的样本集合为空,不能划分。在第(2)种情形下,我们把当前结点标记为叶结点,并将其类别设定为该结点所含样本最多的类别;在第(3)种情形下,同样把当前结点标记为叶结点,但将其类别设定为其父结点所含样本最多的类别.注意这两种情形的处理实质不同:情形(2)是在利用当前结点的后验分布,而情形(3)则是把父结点的样本分布作为当前结点的先验分布。
1.3 剪枝
剪枝(pruning)是决策树学习算法对付“过拟合”的主要手段.在决策树学习中,为了尽可能正确分类训练样本,结点划分过程将不断重复,有时会造成决策树分支过多,这时就可能因训练样本学得“太好”了,以致于把训练集自身的一些特点当作所有数据都具有的一般性质而导致过拟合。因此,可通过主动去掉一些分支来降低过拟合的风险。
决策树剪枝的基本策略有“预剪枝”(prepruning)和“后剪枝”(post-pruning)[Quinlan,1993].预剪枝是指在决策树生成过程中,对每个结点在划分前先进行估计,若当前结点的划分不能带来决策树泛化性能提升,则停止划分并将当前结点标记为叶结点;后剪枝则是先从训练集生成一棵完整的决策树,然后自底向上地对非叶结点进行考察,若将该结点对应的子树替换为叶结点能带来决策树泛化性能提升,则将该子树替换为叶结点。
1.4 连续值的处理
由于连续属性的可取值数目不再有限,因此,不能直接根据连续属性的可取值来对结点进行划分。此时,连续属性离散化技术可派上用场。最简单的策略是采用二分法(bi-partition)对连续属性进行处理,这正是C4.5决策树算法中采用的机制「Quinlan,1993]。
1.5 节点相关概念
1.6 决策树要解决的核心问题
1.7 sklearn中的决策树
sklearn中决策树的类都在”tree“这个模块之下。

2 分类树
2.1 重要参数

2.2 建立一棵树
import pandas as pd
from sklearn import tree
from sklearn.datasets import load_wine                                  #从数据模块导入红酒数据
from sklearn.model_selection import train_test_split              #从模型选择模块导入训练,测试数据

#导入数据
wine=load_wine()

#划分测试集 训练集
X_train,X_test,Y_train,Y_test=train_test_split(wine.data,wine.target,test_size=0.3) #30%测试集 70%训练集 注意顺序

#建立模型
clf=tree.DecisionTreeClassifier(criterion='entropy') #以信息熵为参数
clf.fit(X_train,Y_train) #利用数据集进行训练
score=clf.score(X_test,Y_test) #进行测试 返回预测的准确度
print(score)
2.3 绘制出决策树。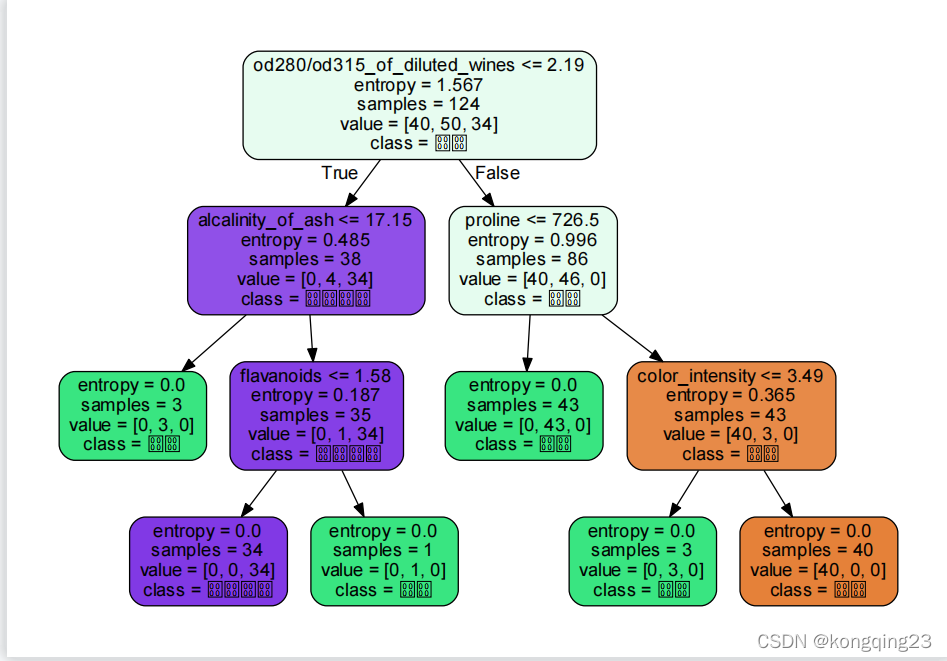
在使用graphviz绘制时,可能出现中文乱码的问题。本人经过多次尝试给出一个可行的方案。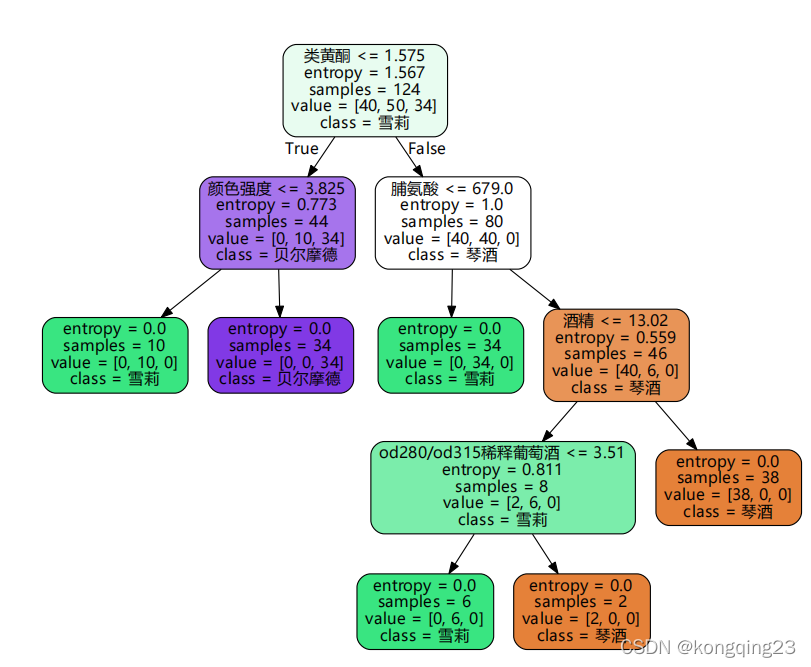
#画出一棵树
feature_name =['alcohol', 'malic_acid', 'ash', 'alcalinity_of_ash', 'magnesium', 'total_phenols', 'flavanoids', 'nonflavanoid_phenols', 'proanthocyanins', 'color_intensity', 'hue', 'od280/od315_of_diluted_wines', 'proline']
#第一个参数为训练好的树 第二个参数为特征名 第三个参数用于给分类命令 filled用于填充颜色 rounded用于改变形状
dot_data=tree.export_graphviz(clf,
                                                   feature_names=feature_name,
                                                   class_names=["琴酒","雪莉","贝尔摩德"],
                                                   filled=True,rounded=True)
with open('Tree.dot', encoding='utf-8') as f:
    dot_grapth = f.read()
dot = graphviz.Source(dot_grapth.replace("helvetica", "MicrosoftYaHei"))
# 解决中文乱码replace("helvetica", "MicrosoftYaHei")或者 replace("helvetica", "simHei")
dot.view()
2.4 查看特征重要性

上图为10个特征的重要性。为了更方便观察,可以利用zip将其与特征对应起来。

#查看特征重要性
# print(clf.feature_importances_)
print(*zip(feature_name,clf.feature_importances_))
2.5 多次训练构建最优树
clf=tree.DecisionTreeClassifier(criterion='entropy',random_state=50) #以信息熵为参数2.6 剪枝参数
在不加限制的情况下,一棵决策树会生长到衡量不纯度的指标最优,或者没有更多的特征可用为止。这样的决策树 往往会过拟合,这就是说,它会在训练集上表现很好,在测试集上却表现糟糕。我们收集的样本数据不可能和整体 的状况完全一致,因此当一棵决策树对训练数据有了过于优秀的解释性,它找出的规则必然包含了训练样本中的噪 声,并使它对未知数据的拟合程度不足。
max_depth:
限制树的最大深度,超过设定深度的树枝全部剪掉。这是用得最广泛的剪枝参数,在高维度低样本量时非常有效。决策树多生长一层,对样本量的需求会增加一倍,所 以限制树深度能够有效地限制过拟合。在集成算法中也非常实用。实际使用时,建议从=3开始尝试,看看拟合的效果再决定是否增加设定深度。
max_features & min_impurity_decrease:
max_features限制分枝时考虑的特征个数,超过限制个数的特征都会被舍弃。和max_depth异曲同工,max_features是用来限制高维度数据的过拟合的剪枝参数,但其方法比较暴力,是直接限制可以使用的特征数量而强行使决策树停下的参数,在不知道决策树中的各个特征的重要性的情况下,强行设定这个参数可能会导致模型学习不足。如果希望通过降维的方式防止过拟合,建议使用PCA,ICA或者特征选择模块中的降维算法。
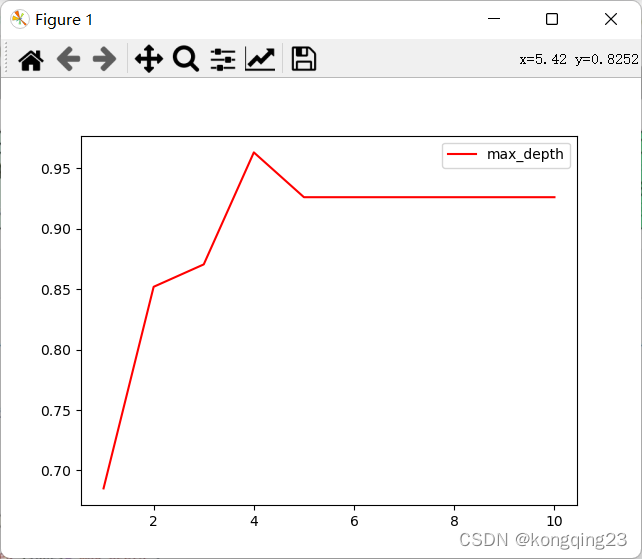
观察上图,在max_depth取4时,模型表现性最好。
from math import trunc
import pandas as pd
from sklearn import tree
from sklearn.datasets import load_wine                                  #从数据模块导入红酒数据
from sklearn.model_selection import train_test_split              #从模型选择模块导入训练,测试数据
import graphviz
import matplotlib.pyplot as plt

#导入数据
wine=load_wine()

#划分测试集 训练集
X_train,X_test,Y_train,Y_test=train_test_split(wine.data,wine.target,test_size=0.3) #30%测试集 70%训练集 注意顺序

test = []
for i in range(10):
    clf = tree.DecisionTreeClassifier(max_depth=i+1
                                                        ,criterion="entropy"
                                                        ,random_state=20
                                                        ,splitter="random")
    clf = clf.fit(X_train, Y_train)
    score = clf.score(X_test, Y_test)
    test.append(score)
plt.plot(range(1,11),test,color="red",label="max_depth")
plt.legend()
plt.show()
ps:剪枝参数并不一定会使效果变得更好。
2.7 目标权重参数
class_weight & min_weight_fraction_leaf:
2.8 重要属性和接口
属性是在模型训练之后,能够调用查看的模型的各种性质。对决策树来说,最重要的是feature_importances_,能 够查看各个特征对模型的重要性。sklearn中许多算法的接口都是相似的,比如说我们之前已经用到的fifit和score,几乎对每个算法都可以使用。除了这两个接口之外,决策树最常用的接口还有apply和predict。apply中输入测试集返回每个测试样本所在的叶子节点的索引,predict输入测试集返回每个测试样本的标签。所有接口中要求输入X_train和X_test的部分,输入的特征矩阵必须至少是一个二维矩阵(至少两个特征)。 sklearn不接受任何一维矩阵作为特征矩阵被输入。
3.回归树
3.1 衡量分支的指标
1)输入"mse"使用均方误差mean squared error(MSE),父节点和叶子节点之间的均方误差的差额将被用来作为特征选择的标准,这种方法通过使用叶子节点的均值来最小化L2损失。
2)输入“friedman_mse”使用费尔德曼均方误差,这种指标使用弗里德曼针对潜在分枝中的问题改进后的均方误差。
3)输入"mae"使用绝对平均误差MAE(mean absolute error),这种指标使用叶节点的中值来最小化L1损失,属性中最重要的依然是feature_importances_,接口依然是apply, fifit, predict, score最核心。
在回归树中,MSE不只是我们的分枝质量衡量指标,也是我们最常用的衡量回归树回归质量的指标,当我们在使用交叉验证,或者其他方式获取回归树的结果时,我们往往选择均方误差作
3.2 交叉验证
3.3 对带有噪声的正弦信号进行回归拟合
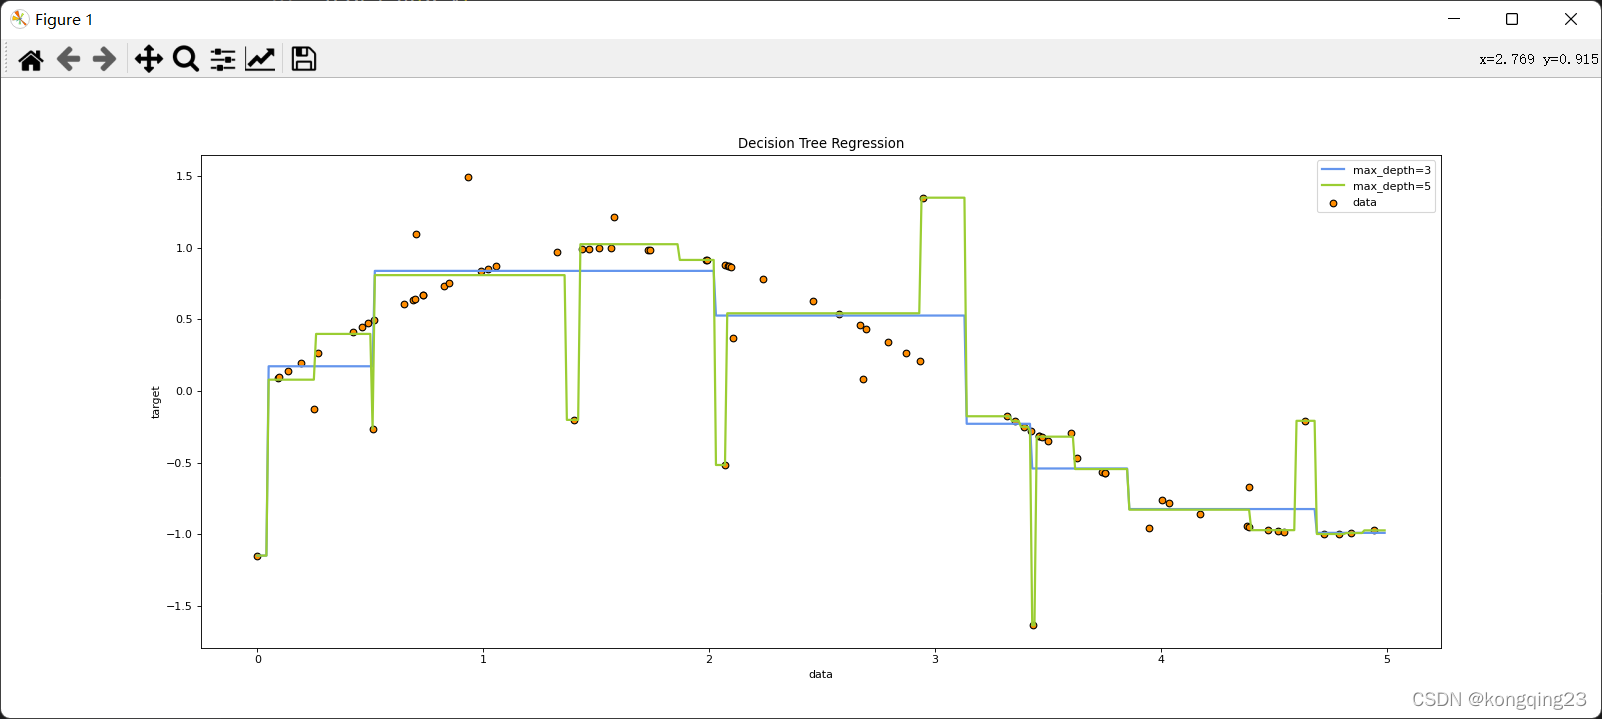
观察上图,在max_depth=5时,它从训练数据中学了很多细节,包括噪声的呈现,从而使模型偏离真实的正弦曲线,形成过拟合;而max_depth=3时,针对训练集效果虽然不如max_depth=5时,但显然泛化性更好。
from sklearn.datasets import  load_boston
from  sklearn.model_selection import  cross_val_score
from sklearn.tree import DecisionTreeRegressor
import numpy as np
import matplotlib.pyplot as plt


#创建一条含有噪声的正弦曲线
rng=np.random.RandomState(1)#随机数种子
X = np.sort(5 * rng.rand(80,1), axis=0) # 生成80,1二维数据 原数据0-1 *5之后0-5 排序之后作为横坐标数据
y = np.sin(X).ravel()                              #y只能是一维数据 用ravel进行降维
y[::5] += 3 * (0.5 - rng.rand(16))          #添加噪声 生成16个随机数(80/5)0.5减以后数值在-0.5到0.5之间 *3扩大-1.5-1.5

#实例化
regr_1 = DecisionTreeRegressor(max_depth=3)
regr_2 = DecisionTreeRegressor(max_depth=5)
regr_1.fit(X, y)
regr_2.fit(X, y)
#测试集 np.newaxis升维
X_test = np.arange(0.0, 5.0, 0.01)[:, np.newaxis]
y_1 = regr_1.predict(X_test) #predict得到x对应结果y
y_2 = regr_2.predict(X_test)

#绘图
plt.figure(figsize=(20,8),dpi=80)
plt.scatter(X, y, edgecolor="black",c="darkorange", label="data")
plt.plot(X_test, y_1, color="cornflowerblue",label="max_depth=3", linewidth=2)
plt.plot(X_test, y_2, color="yellowgreen", label="max_depth=5", linewidth=2)
plt.xlabel("data")
plt.ylabel("target")
plt.title("Decision Tree Regression")
plt.legend(loc='best')
plt.show()
4.泰坦尼克号生存者预测
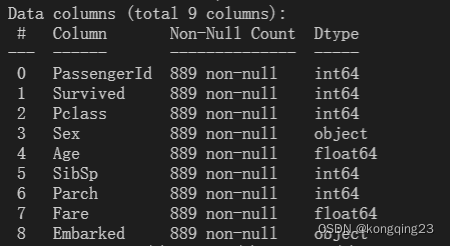
查看数据。
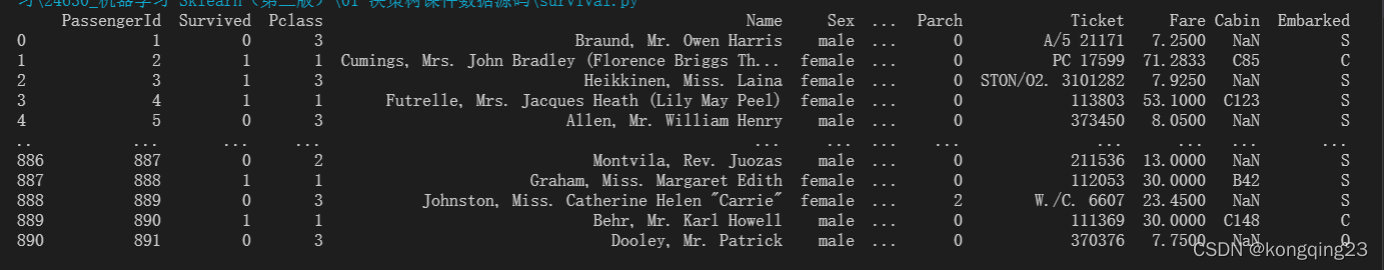
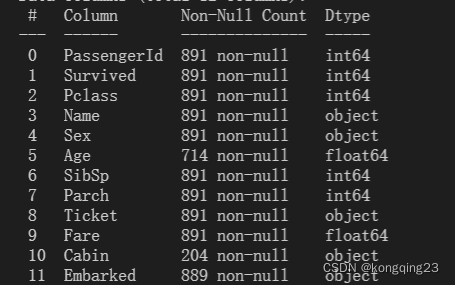
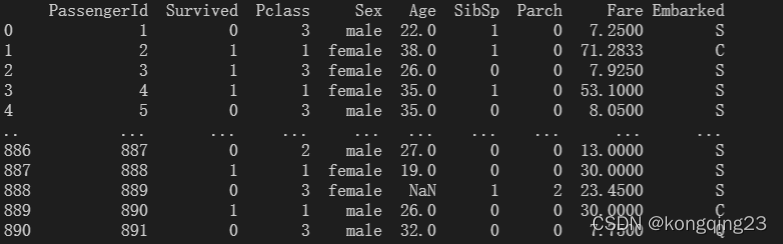
删除不需要的列数据并完成年龄nan的填充。
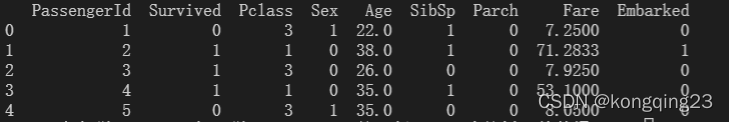
将Embarked和Sex转换为数字。
划分训练集测试集时索引会被随机打乱,修正索引。
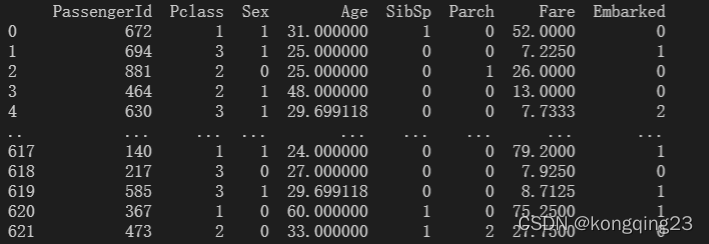 在修正索引时,需要注意获取元素个数时,由于是元组对象,需要使用shape[0]。
实例化模型,查看准确度。
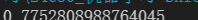
准确率并不是很高,交叉验证查看平均准确度。
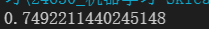
10次交叉验证均值在0.74左右,尝试进行调参提高准确度。
在不同的max_depth下观察模型的拟合情况。
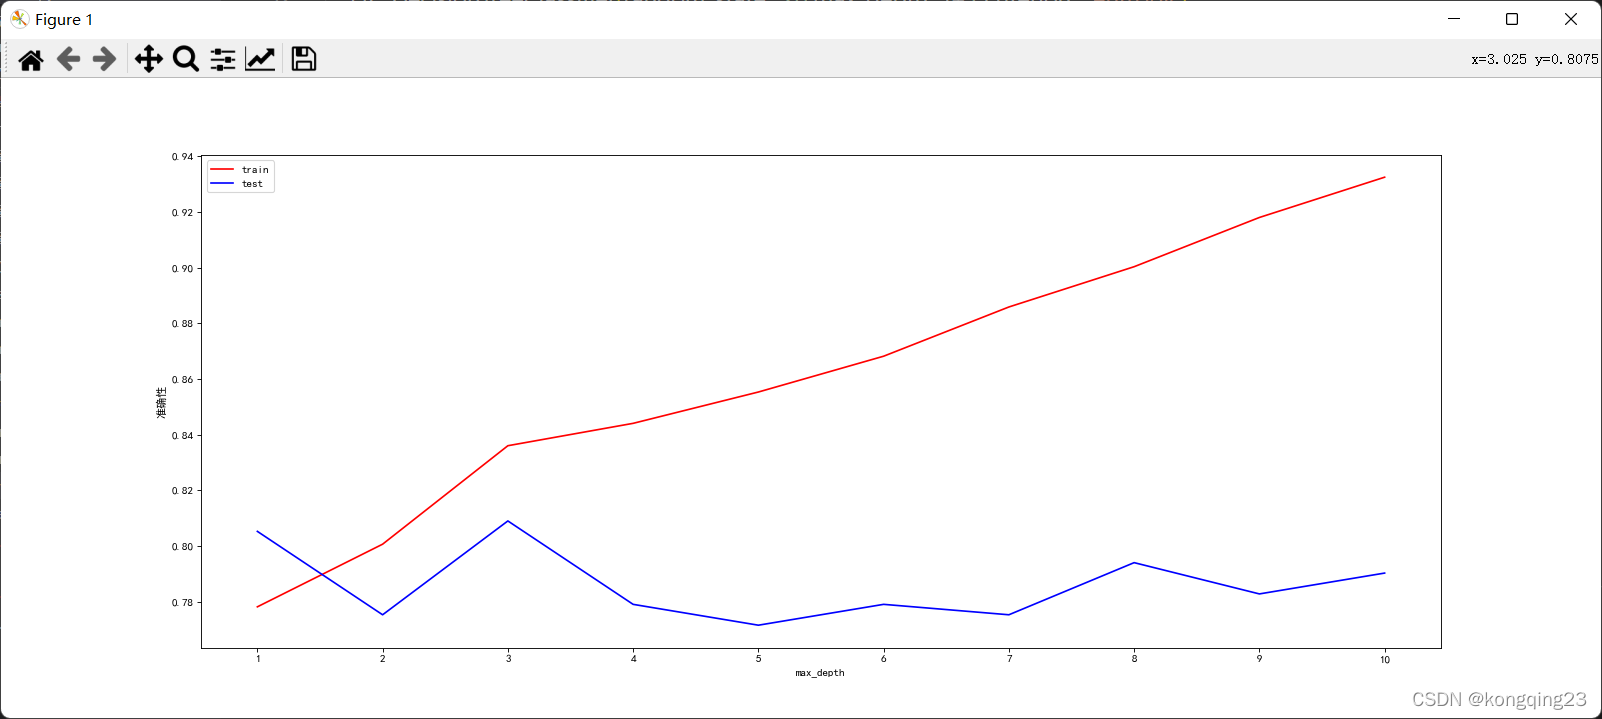
可以发现在最大深度为3时,效果最好。
利用网格搜索帮助我们同时调整多个参数。网格搜索本质是一种枚举技术。ps:基尼系数边界为0.5,熵边界为1。

网格搜索比较耗时,且得到的参数不一定是最佳的参数,如果你参数给的给多,反而可能会使准确性降低。
5.决策树的优缺点
参考资料
1.西瓜书
2.菜菜的sklearn课堂

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)