机器学习sklearn-支持向量机1
·
目录
相关概念
支持向量机的分类方法,是在这组分布中找出一个超平面作为决策边界,使模型在数据上的
分类误差尽量接近于小,尤其是在未知数据集上的分类误差(泛化误差)尽量小。
边际很小的情况,是一种模型在训练集上表现很好,却在测
试集上表现糟糕的情况,所以会
“
过拟合
”
。
所以我们在找寻决策边界的时候,希望边际越大越好。
支持向量机,就是通过找出边际最大的决策边界,来对数据进行分类的分类器。
也因此,支持向量分类器又叫做最大边际分类器。这个过程在二维平面中看起来十分简单,但将上述过程使用数学表达出来,就不是一件简单的事情 了。
在几何中,超平面是一个空间的子空间,它是维度比所在空间小一维的空间。 如果数据空间本身是三维的,则其超平面是二维平面,而如果数据空间本身是二维的,则其超平面是一维的直线。
在二分类问题中,如果一个超平面能够将数据划分为两个集合,其中每个集合中包含单独的一个类别,我们就说这个超平面是数据的“
决策边界”。
和逻辑回归中的过程一样,
SVM
也是通过最小化损失函数来求解一个用于后续模型使用的重要
信息:决策边界。
线性SVM决策过程的可视化
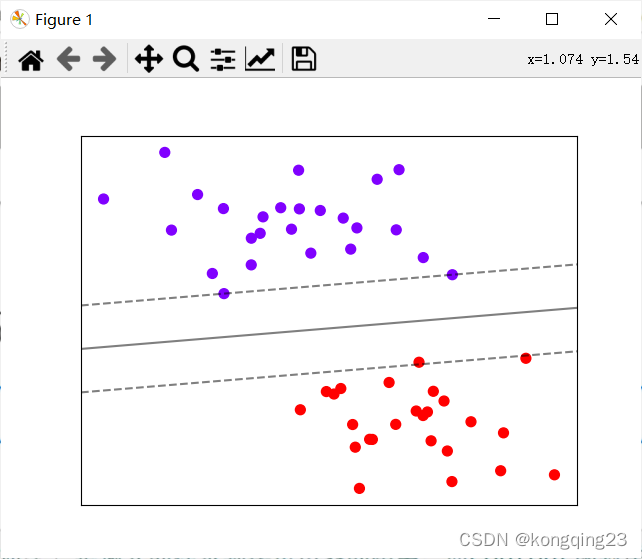
from sklearn.datasets import make_blobs
from sklearn.svm import SVC
import matplotlib.pyplot as plt
import numpy as np

def plot_svc_decision_function(model,ax=None):
    #判断是否有画图对象
    if ax is None:
        ax = plt.gca()
        xlim = ax.get_xlim()
        ylim = ax.get_ylim()
    #在最大值和最小值之间形成30个规律的数据
    x = np.linspace(xlim[0],xlim[1],30)
    y = np.linspace(ylim[0],ylim[1],30)
    # 我们将使用这里形成的二维数组作为我们contour函数中的X和Y
    # 使用meshgrid函数将两个一维向量转换为特征矩阵
    # 核心是将两个特征向量广播,以便获取y.shape * x.shape这么多个坐标点的横坐标和纵坐标
    Y,X = np.meshgrid(y,x)
    xy = np.vstack([X.ravel(), Y.ravel()]).T
    # 其中ravel()是降维函数,vstack能够将多个结构一致的一维数组按行堆叠起来
    # xy就是已经形成的网格,它是遍布在整个画布上的密集的点
    P = model.decision_function(xy).reshape(X.shape)
    # 重要接口decision_function,返回每个输入的样本所对应的到决策边界的距离
    # 然后再将这个距离转换为axisx的结构,这是由于画图的函数contour要求Z的结构必须与X和Y保持一致
    ax.contour(X, Y, P,colors="k",
               levels=[-1,0,1],#画3条等高线 分别是Z为-1 0 1的三条线
               alpha=0.5,
               linestyles=["--","-","--"])#3条线不同形式
    ax.set_xlim(xlim)
    ax.set_ylim(ylim)

X,y=make_blobs(n_samples=50,centers=2,random_state=0,cluster_std=0.6)
plt.scatter(X[:,0],X[:,1],c=y,s=50,cmap='rainbow')
clf=SVC(kernel='linear').fit(X, y)
plot_svc_decision_function(clf)

plt.xticks([])
plt.yticks([])
plt.show()

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)