Python基础与大数据应用(三)
1、大数据最基本特点数据体量巨大。
2、pandas 是 Python的一个数据分析包,主要有 Series 和 DataFrame 两种类型的数据对象。
3、字典中的键可以是 Python 中的任意不可变数据,如整数、字符串、元组等。字典中的键不允许重复。
4、在Python中,所有数据类型都被视为对象,如字符串、列表、字典、元组等内置数据类型都具有和对象相似的语法和用法。
5、Python提供了两种实现循环的语句,分别是 for 和 while 。
6、matplotlib 是 Python 中最常用的可视化工具之一。
7、数据分析是指利用合适的工具在统计学理论的支撑下,对数据进行一定程度的处理,然后结合具体业务分析数据,进行监控、定位、分析、解决问题。达到高效决策、提高经营效率,发现业务机会点,从而占有优势。
数据分析可以把隐藏在大量数据背后的信息提炼出来,总结出数据的内在规律。
数据分析究竟在分析什么:
(1)总体概览指标:总体概览指标又称统计绝对数,是反映某一数据整体规模大小,总量多少的指标。
(2)对比性指标:说明现象之间数量对比关系的指标,常见的就是同比、环比、差比这几个指标。
(3)集中趋势指标:用来反映某一现象在一定时间段内所达到的一般水平,通常用平均指标来表示。
(4)离散程度指标:用来表示总体分布的离散(波动)情况的指标,如果这个指标较大,则说明数据波动较大,反之则说明数据相对比较稳定。
(5)相关性指标:反映数据整体内的变量之间存在什么关系,一个变化会引起另一个怎么变化,我们把用来反映这种关系的指标交做相关系数,相关系数常用r来表示。
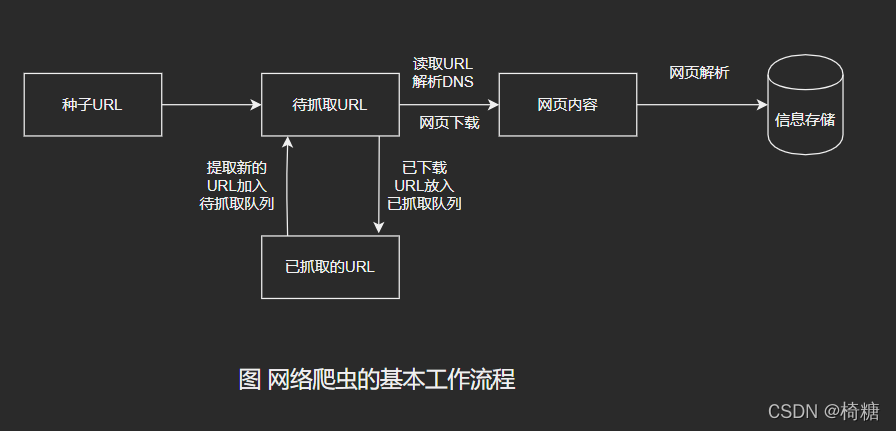
8、网络爬虫的基本工作流程如下:
(1)首先选取一部分精心挑选的种子URL;
(2)将这些 URL 放入待抓取 URL 队列;
(3)从待抓取 URL 队列中取出待抓取的 URL ,解析 DNS ,并且得到主机的 IP ,将 URL 对应的网页下载下来,然后进行解析,存储到已下载网页库中。此外,还要将这些 URL 放进已抓取 URL 队列。
(4)分析已抓取 URL 队列中的 URL ,提取其中待抓取的 URL ,将其放入待抓取 URL 队列,从而进入下一个循环。
9、请编程,实现100分制成绩转换为A、B、C、D、E五级等级制成绩。100分制与五级等级制的对应关系:90分及以上为A,80~89分为B,70~79分为C,60~69分为D,60分以下为E。
(1)根据IPO程序设计模式分析如下。
I:一个输入数据,即学生的成绩。
O:A、B、C、D、E中的一个。
P:90分及以上为A,80~89分为B,70~79分为C,60~69分为D,60分以下为E。
(2)算法设计(控制流图如下)
(3)编写程序
#ch9.py
#100分制与五级等级制成绩的转换

score = float(input("请输入成绩: "))
if score >=90:
          grade='A'
elif score >=80:
          grade='B'
elif score >=70:
          grade='C'
elif score >=60:
          grade='D'
else:
          grade='E'

print("等级为:",grade)
(4)调试程序
请输入成绩:98
等级为:A
请输入成绩:88
等级为:B
请输入成绩:78
等级为:C
请输入成绩:68
等级为:D
请输入成绩:58
等级为:E
对于分支结构程序的调试,应注意至少每个分支都被执行一次,因此所提供的调试数据要分布在每个分支里。
10、创建一个模块,包含一个判断水仙花的函数。
水仙花数也被称为超完全数字不变数、自恋数、自幂数、阿姆斯壮数或阿姆斯特朗数。水仙花数是指一个3位数,它的每个位上的数字的3次幂之和等于它本身(如1^3+5^3+3^3=153)。
#水仙花数模块
#模块名:ch10.py
def narcissistic_number(x):
    z=x
    series=[]
    while x:         #取每一位数字存入列表中
        i=x%10
        series.append(i)
        x=x//10
        y=0
        for i in series:       #判断是不是水仙花数
              y=y+i**3
        if y==z:
            return False
if__name__== "__main__":
    print(narcissistic_number(153))
    print(narcissistic_number(161))
11、大数据分析流程
熟悉工具---明确目的---获取数据---熟悉数据---处理数据---分析数据---得出结论---验证结论---展示结论

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)